【DCU性能测试】使用CUDA Sample bandwidthTest测试海光DCU显存带宽
·
前言
显存带宽是衡量GPU计算性能的关键指标之一,直接影响模型训练和推理的效率。本文在海光BW1100 DCU上使用NVIDIA CUDA Samples中的bandwidthTest工具进行显存带宽测试,验证DCU在内存带宽方面的能力。
测试环境
| 项目 | 配置 |
|---|---|
| 硬件平台 | 海光BW1100 |
| GPU | BW1101 |
| 操作系统 | Ubuntu 22.04 |
| 容器镜像 | pytorch:2.9.0-ubuntu22.04-dtk26.04-py3.10 |
| DTK版本 | 26.04 |
| CUDA Samples | v12.5 |
测试准备
1. 拉取容器镜像
docker pull harbor.sourcefind.cn:5443/dcu/admin/base/pytorch:2.9.0-ubuntu22.04-dtk26.04-py3.10
2. 下载CUDA Samples
wget -O v12.5.tar.gz https://codeload.github.com/NVIDIA/cuda-samples/tar.gz/refs/tags/v12.5
tar -xzf v12.5.tar.gz
3. 启动容器
docker run -it \
  --network=host \
  --name bandwidthTest \
  --privileged \
  --device=/dev/kfd \
  --device=/dev/dri \
  --device=/dev/mkfd \
  --cap-add=SYS_PTRACE \
  --security-opt seccomp=unconfined \
  -u root \
  -v /opt/hyhal/:/opt/hyhal/:ro \
  -v /data:/bandwidthTest \
  -v /data/home/cuda-samples-12.5/:/cuda-samples-12.5 \
  -w /cuda-samples-12.5/Samples/1_Utilities/bandwidthTest \
  harbor.sourcefind.cn:5443/dcu/admin/base/pytorch:2.9.0-ubuntu22.04-dtk26.04-py3.10 bash
关键参数说明:
--device=/dev/kfd --device=/dev/dri --device=/dev/mkfd:映射DCU设备节点-v /opt/hyhal/:/opt/hyhal/:ro:只读挂载海光HAL库-w:设置容器启动后直接进入bandwidthTest目录
4. 配置环境
source /opt/dtk-26.04/env.sh
source /opt/dtk-26.04/cuda/env.sh
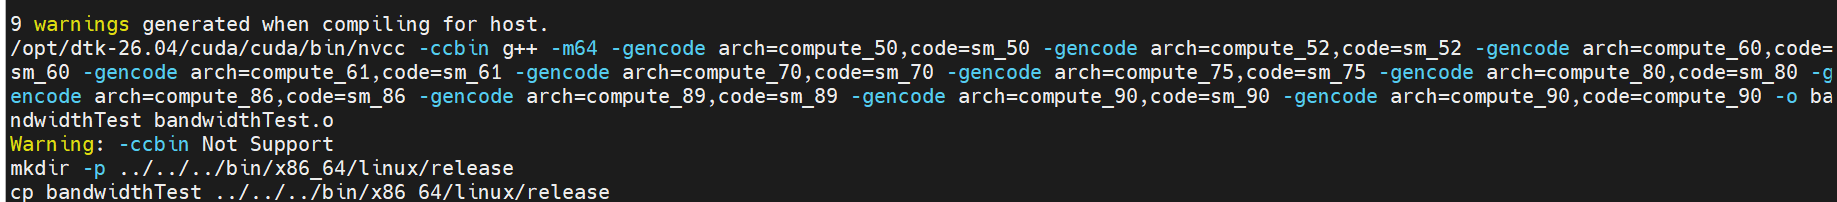
5. 编译bandwidthTest
cd Samples/1_Utilities/bandwidthTest/
make clean
make

编译完成后执行:
./bandwidthTest
测试结果
[CUDA Bandwidth Test] - Starting...
Running on...
 Device 0: BW1101 gfx938:sramecc+:xnack-
 Quick Mode

 Host to Device Bandwidth, 1 Device(s)
 PINNED Memory Transfers
   Transfer Size (Bytes)        Bandwidth(GB/s)
   32000000                     21.9

 Device to Host Bandwidth, 1 Device(s)
 PINNED Memory Transfers
   Transfer Size (Bytes)        Bandwidth(GB/s)
   32000000                     37.9

 Device to Device Bandwidth, 1 Device(s)
 PINNED Memory Transfers
   Transfer Size (Bytes)        Bandwidth(GB/s)
   32000000                     1293.8

Result = PASS
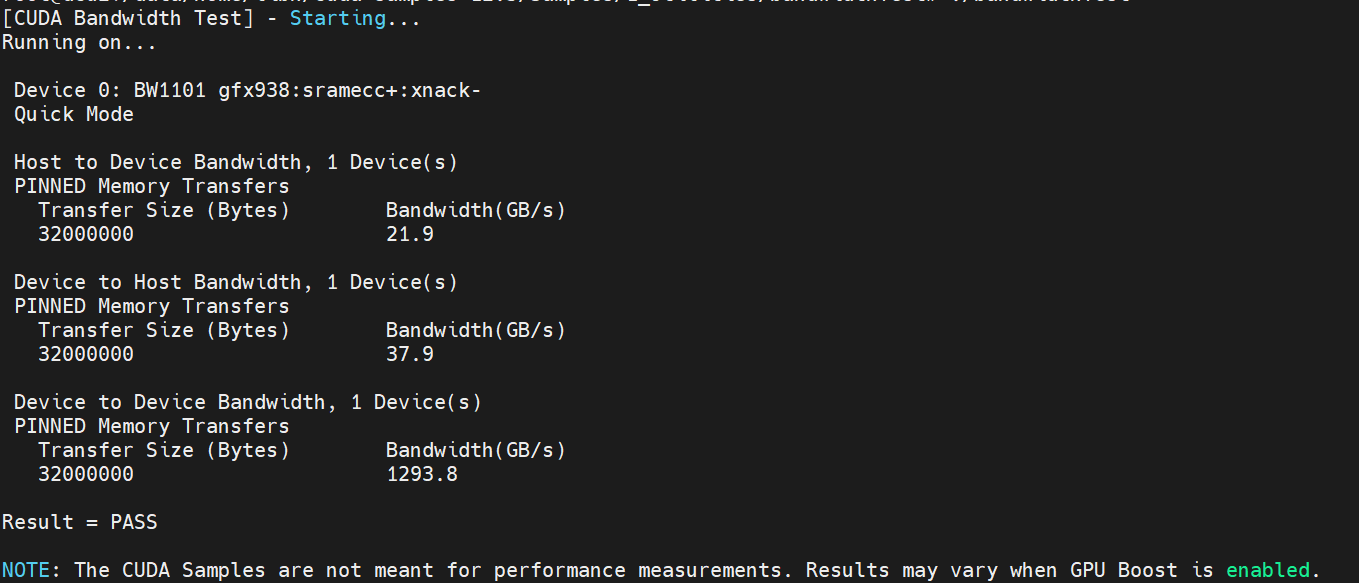
bandwidthTest会分别测试以下三种传输模式:
- Host to Device (H2D):CPU内存 → GPU显存,带宽 21.9 GB/s
- Device to Host (D2H):GPU显存 → CPU内存,带宽 37.9 GB/s
- Device to Device (D2D):GPU显存内部拷贝,带宽 1293.8 GB/s
结果分析
1. D2D带宽表现优异
Device to Device带宽达到1293.8 GB/s,这反映了DCU显存内部的高带宽能力。在大模型训练中,权重更新、梯度同步等操作大量依赖D2D拷贝,高D2D带宽意味着这些操作不会成为性能瓶颈。
2. H2D与D2H带宽差异
H2D为21.9 GB/s,D2H为37.9 GB/s,D2H略高于H2D约73%。这种差异在GPU架构中较为常见,可能与数据传输的DMA引擎调度策略有关。对于推理场景,模型加载阶段主要受H2D带宽影响,21.9 GB/s的带宽对于常规模型加载是足够的。
3. 实际应用影响
- 训练场景:大模型训练中,DDP多卡通信、梯度同步主要依赖D2D带宽,1293.8 GB/s的高带宽对分布式训练友好
- 推理场景:模型权重加载受H2D带宽限制,对于7B级别模型(约14GB参数),理论加载时间约0.64秒,可接受
- 数据预处理:数据从CPU到GPU的传输受H2D带宽影响,批量数据加载时需注意pipeline设计
总结
海光BW1100 DCU在bandwidthTest测试中表现良好,D2D带宽达到1293.8 GB/s,展现了显存内部的高带宽能力,对大模型训练场景友好。H2D/D2H带宽分别为21.9/37.9 GB/s,满足常规模型加载和数据传输需求。
在实际使用中,建议关注数据传输pipeline的设计,尽量减少CPU-GPU之间的频繁数据拷贝,充分利用DCU高D2D带宽的优势。
相关链接
- CUDA Samples: https://github.com/NVIDIA/cuda-samples/releases/tag/v12.5
- 海光DCU开发者社区: https://developer.sourcefind.cn/
作者注:本文涉及的内容仍处于持续学习与验证阶段,个人理解仅供参考。如有疏漏或更好的实践经验,欢迎大家补充讨论。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献2条内容

所有评论(0)