zookeeper概述和原理
1、zookeeper概述
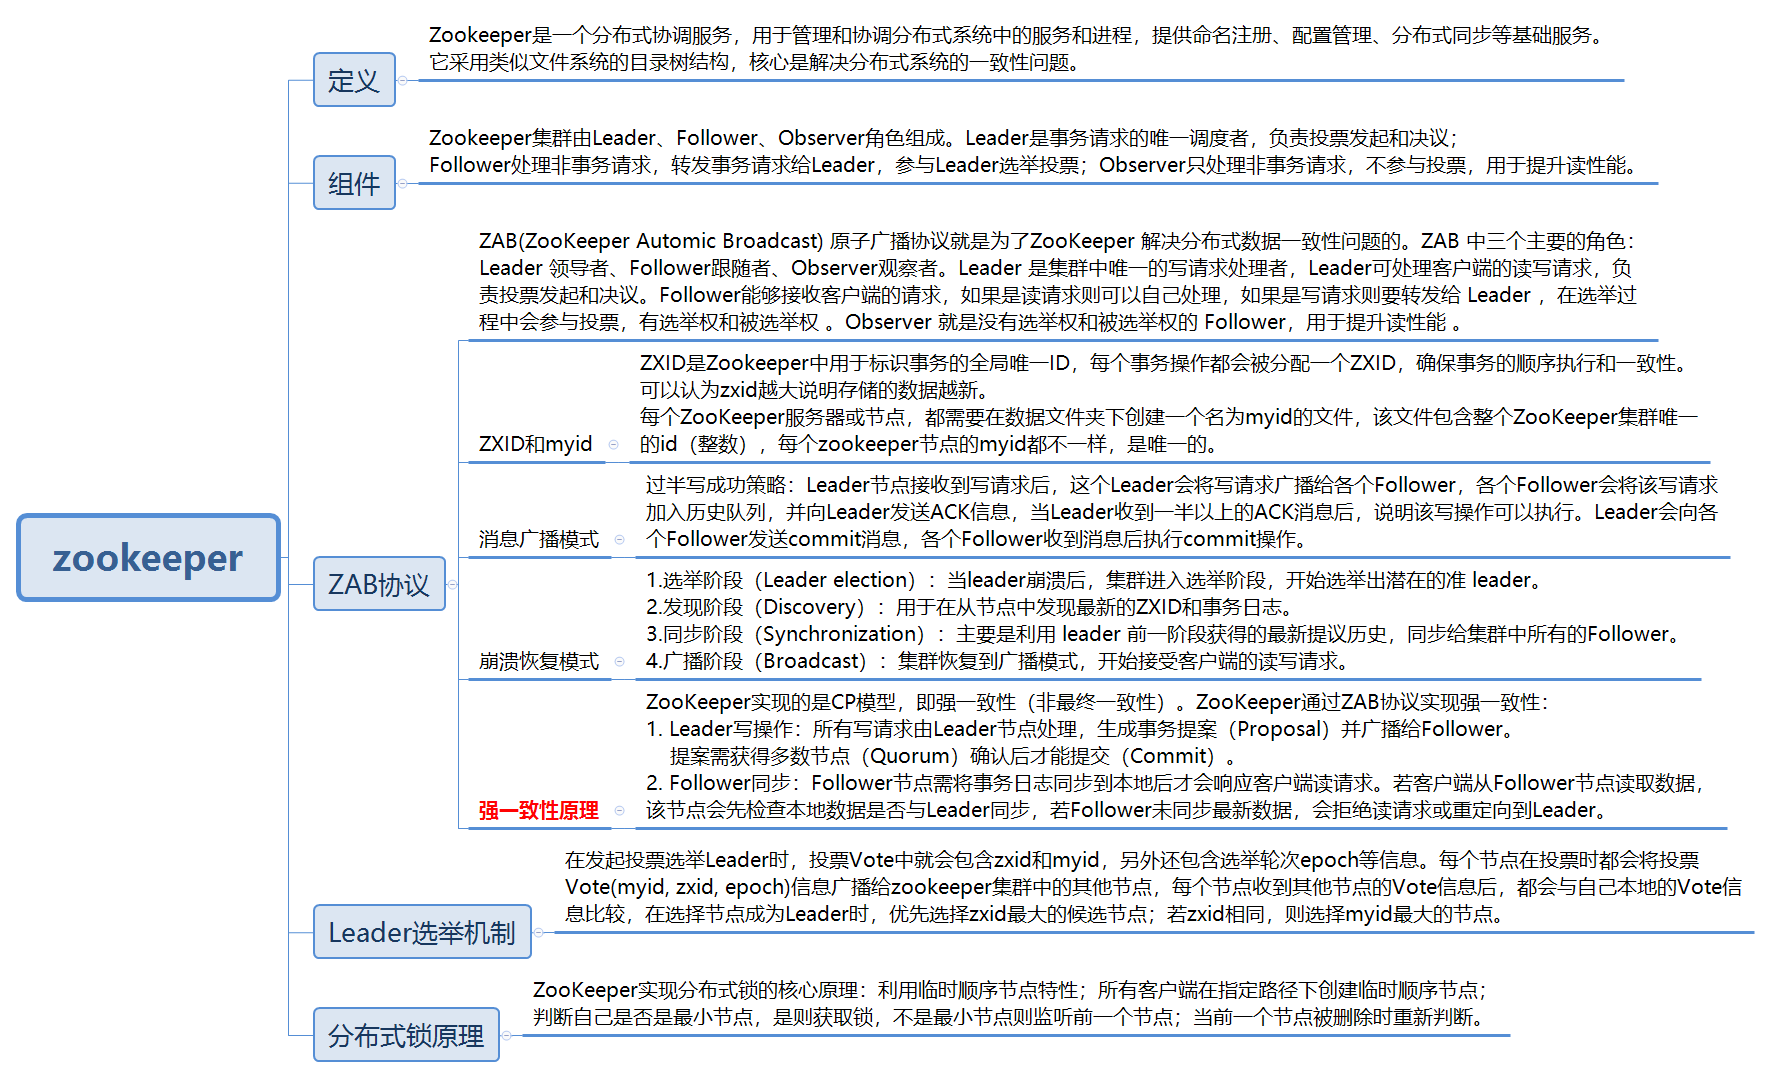
Zookeeper是一个分布式协调服务,用于管理和协调分布式系统中的服务和进程,提供命名注册、配置管理、分布式同步等基础服务。它是一个分布式的小文件存储系统,采用类似文件系统的目录树结构,核心是解决分布式系统的一致性问题。
分布式协调技术主要用来解决分布式环境当中多个进程之间的同步控制,让他们有序的去访问某种临界资源,防止造成"脏数据"的后果。

在这图中有三台机器,每台机器各跑一个应用程序。然后我们将这三台机器通过网络将其连接起来,构成一个系统来为用户提供服务,对用户来说这个系统的架构是透明的,他感觉不到我这个系统是一个什么样的架构。那么我们就可以把这种系统称作一个分布式系统。
在这个分布式系统中如何对进程进行调度,我假设在第一台机器上挂载了一个资源,然后这三个物理分布的进程都要竞争这个资源,但我们又不希望他们同时进行访问,这时候我们就需要一个协调器,来让他们有序的来访问这个资源。这个协调器就是我们经常提到的那个锁,比如说"进程-1"在使用该资源的时候,会先去获得锁,"进程1"获得锁以后会对该资源保持独占,这样其他进程就无法访问该资源,"进程1"用完该资源以后就将锁释放掉,让其他进程来获得锁,那么通过这个锁机制,我们就能保证了分布式系统中多个进程能够有序的访问该临界资源。那么我们把这个分布式环境下的这个锁叫作分布式锁。这个分布式锁也就是我们分布式协调技术实现的核心内容,那么如何实现这个分布式呢,那就是我们后面要讲的内容。
目前,在分布式协调技术方面做得比较好的就是Google的Chubby还有Apache的ZooKeeper,他们都是分布式锁的实现者。有人会问既然有了Chubby为什么还要弄一个ZooKeeper,难道Chubby做得不够好吗?不是这样的,主要是Chbby是非开源的,Google自家用。后来雅虎模仿Chubby开发出了ZooKeeper,也实现了类似的分布式锁的功能,并且将ZooKeeper作为一种开源的程序捐献给了Apache,那么这样就可以使用ZooKeeper所提供锁服务。而且在分布式领域久经考验,它的可靠性,可用性都是经过理论和实践的验证的。所以我们在构建一些分布式系统的时候,就可以以这类系统为起点来构建我们的系统,这将节省不少成本,而且bug也将更少。
ZooKeeper是一种为分布式应用所设计的高可用、高性能且一致的开源协调服务,它提供了一项基本服务:分布式锁服务。由于ZooKeeper的开源特性,后来我们的开发者在分布式锁的基础上,摸索了出了其他的使用方法:配置维护、组服务、分布式消息队列、分布式通知/协调等。
前面提到了那么多的服务,比如分布式锁、配置维护、组服务等,那它们是如何实现的呢?ZooKeeper在实现这些服务时,首先它设计一种新的数据结构——Znode,然后在该数据结构的基础上定义了一些原语,也就是一些关于该数据结构的一些操作。有了这些数据结构和原语还不够,因为我们的ZooKeeper是工作在一个分布式的环境下,我们的服务是通过消息以网络的形式发送给我们的分布式应用程序,所以还需要一个通知机制——Watcher机制。那么总结一下,ZooKeeper所提供的服务主要是通过:数据结构+原语+watcher机制,三个部分来实现的。那么我就从这三个方面,给大家介绍一下ZooKeeper。
1.1、zookeeper数据模型znode
ZooKeeper拥有一个层次的命名空间,这个和标准的文件系统非常相似,如下图所示。


从图中可以看出ZooKeeper的数据模型,在结构上和标准文件系统的非常相似,都是采用这种树形层次结构,ZooKeeper树中的每个节点被称为—Znode。和文件系统的目录树一样,ZooKeeper树中的每个节点可以拥有子节点。但也有不同之处:
(1) 引用方式
Zonde通过路径引用,如同Unix中的文件路径。路径必须是绝对的,因此他们必须由斜杠字符来开头。除此以外,他们必须是唯一的,也就是说每一个路径只有一个表示,因此这些路径不能改变。在ZooKeeper中,路径由Unicode字符串组成,并且有一些限制。字符串"/zookeeper"用以保存管理信息,比如关键配额信息。
(2) Znode结构
ZooKeeper命名空间中的Znode,兼具文件和目录两种特点。既像文件一样维护着数据、元信息、ACL、时间戳等数据结构,又像目录一样可以作为路径标识的一部分。图中的每个节点称为一个Znode。 每个Znode由3部分组成:
① stat:此为状态信息, 描述该Znode的版本, 权限等信息
② data:与该Znode关联的数据
③ children:该Znode下的子节点
ZooKeeper虽然可以关联一些数据,但并没有被设计为常规的数据库或者大数据存储,相反的是,它用来管理调度数据,比如分布式应用中的配置文件信息、状态信息、汇集位置等等。这些数据的共同特性就是它们都是很小的数据,通常以KB为大小单位。ZooKeeper的服务器和客户端都被设计为严格检查并限制每个Znode的数据大小至多1M,但常规使用中应该远小于此值。
(3) 数据访问
ZooKeeper中的每个节点存储的数据要被原子性的操作。也就是说读操作将获取与节点相关的所有数据,写操作也将替换掉节点的所有数据。另外,每一个节点都拥有自己的ACL(访问控制列表),这个列表规定了用户的权限,即限定了特定用户对目标节点可以执行的操作。
(4) 节点类型
ZooKeeper中的节点有两种,分别为临时节点和永久节点。节点的类型在创建时即被确定,并且不能改变。
① 临时节点:该节点的生命周期依赖于创建它们的会话。一旦会话(Session)结束,临时节点将被自动删除,当然可以也可以手动删除。虽然每个临时的Znode都会绑定到一个客户端会话,但他们对所有的客户端还是可见的。另外,ZooKeeper的临时节点不允许拥有子节点。
② 永久节点:该节点的生命周期不依赖于会话,并且只有在客户端显示执行删除操作的时候,他们才能被删除。
(5) 顺序节点
当创建Znode的时候,用户可以请求在ZooKeeper的路径结尾添加一个递增的计数。这个计数对于此节点的父节点来说是唯一的,它的格式为"%10d"(10位数字,没有数值的数位用0补充,例如"0000000001")。当计数值大于232-1时,计数器将溢出。
(6) 观察
客户端可以在节点上设置watch,我们称之为监视器。当节点状态发生改变时(Znode的增、删、改)将会触发watch所对应的操作。当watch被触发时,ZooKeeper将会向客户端发送且仅发送一条通知,因为watch只能被触发一次,这样可以减少网络流量。
1.2、zookeeper中的时间、节点属性和操作
1、zookeeper中的时间
ZooKeeper有多种记录时间的形式,其中包含以下几个主要属性:
(1) Zxid
Leader会广播已经被deliver的Proposal消息。在发出一个Proposal消息前,Leader会分配给Proposal一个单调递增的唯一id,称之为zxid(个人理解Zxid就是一个用来唯一标识proposal的id)。
致使ZooKeeper节点状态改变的每一个操作都将使节点接收到一个Zxid格式的时间戳,并且这个时间戳全局有序。也就是说,每个对节点的改变都将产生一个唯一的Zxid。如果Zxid1的值小于Zxid2的值,那么Zxid1所对应的事件发生在Zxid2所对应的事件之前。实际上,ZooKeeper的每个节点维护着三个Zxid值,分别为:cZxid、mZxid、pZxid。
① cZxid: 是节点的创建时间所对应的Zxid格式时间戳。
② mZxid:是节点的修改时间所对应的Zxid格式时间戳。
实现中Zxid是一个64为的数字,它高32位是epoch用来标识leader关系是否改变,每次一个leader被选出来,它都会有一个新的epoch,低32位是个递增计数。
(2) 版本号
对节点的每一个操作都将致使这个节点的版本号增加。每个节点维护着三个版本号,他们分别为:
① version:节点数据版本号
② cversion:子节点版本号
③ aversion:节点所拥有的ACL(访问控制列表)版本号
2、zookeeper节点属性
通过前面的介绍可以了解到,一个节点自身拥有表示其状态的许多重要属性,如下图所示。

Znode节点属性结构
3、zookeeper服务中的操作
在ZooKeeper中有9个基本操作,如下图所示:

ZooKeeper类方法描述
更新ZooKeeper操作是有限制的。delete或setData必须明确要更新的Znode的版本号,我们可以调用exists找到。如果版本号不匹配,更新将会失败。
更新ZooKeeper操作是非阻塞式的。因此客户端如果失去了一个更新(由于另一个进程在同时更新这个Znode),他可以在不阻塞其他进程执行的情况下,选择重新尝试或进行其他操作。
尽管ZooKeeper可以被看做是一个文件系统,但是处于便利,摒弃了一些文件系统地操作原语。因为文件非常的小并且是整体读写的,所以不需要打开、关闭或是寻地的操作。
1.3、watch触发器
(1) watch概述
ZooKeeper可以为所有的读操作设置watch,这些读操作包括:exists()、getChildren()及getData()。watch事件是一次性的触发器,当watch的对象状态发生改变时,将会触发此对象上watch所对应的事件。watch事件将被异步地发送给客户端,并且ZooKeeper为watch机制提供了有序的一致性保证。理论上,客户端接收watch事件的时间要快于其看到watch对象状态变化的时间。
(2) watch类型
ZooKeeper所管理的watch可以分为两类:
① 数据watch(data watches):getData和exists负责设置数据watch
② 孩子watch(child watches):getChildren负责设置孩子watch
我们可以通过操作返回的数据来设置不同的watch:
① getData和exists:返回关于节点的数据信息
② getChildren:返回孩子列表
因此
① 一个成功的setData操作将触发Znode的数据watch
② 一个成功的create操作将触发Znode的数据watch以及孩子watch
③ 一个成功的delete操作将触发Znode的数据watch以及孩子watch
(3) watch注册与触发
watch设置操作及相应的触发器如下图所示。

① exists操作上的watch,在被监视的Znode创建、删除或数据更新时被触发。
② getData操作上的watch,在被监视的Znode删除或数据更新时被触发。在被创建时不能被触发,因为只有Znode一定存在,getData操作才会成功。
③ getChildren操作上的watch,在被监视的Znode的子节点创建或删除,或是这个Znode自身被删除时被触发。可以通过查看watch事件类型来区分是Znode,还是他的子节点被删除:NodeDelete表示Znode被删除,NodeDeletedChanged表示子节点被删除。
Watch由客户端所连接的ZooKeeper服务器在本地维护,因此watch可以非常容易地设置、管理和分派。当客户端连接到一个新的服务器时,任何的会话事件都将可能触发watch。另外,当从服务器断开连接的时候,watch将不会被接收。但是,当一个客户端重新建立连接的时候,任何先前注册过的watch都会被重新注册。
(4) 需要注意的几点
Zookeeper的watch实际上要处理两类事件:
① 连接状态事件(type=None, path=null)
这类事件不需要注册,也不需要我们连续触发,我们只要处理就行了。
② 节点事件
节点的建立,删除,数据的修改。它是one time trigger,我们需要不停的注册触发,还可能发生事件丢失的情况。
上面2类事件都在Watch中处理,也就是重载的process(Event event)
节点事件的触发,通过函数exists,getData或getChildren来处理这类函数,有双重作用:
① 注册触发事件
② 函数本身的功能
函数的本身的功能又可以用异步的回调函数来实现,重载processResult()过程中处理函数本身的的功能。
2、zookeeper集群服务
Zookeeper是一个由多个Server组成的集群,该集群有一个Leader,多个Follower。客户端可以连接任意ZooKeeper服务节点来读写数据,如下图所示。

ZK集群中每个Server,都保存一份数据副本。Zookeeper使用简单的同步策略,通过以下两条基本保证来实现数据的一致性:
① 全局串行化所有的写操作
② 保证同一客户端的指令被FIFO执行(以及消息通知的FIFO)
所有的读请求由Zk Server 本地响应,所有的更新请求将转发给Leader,由Leader实施。
2.1、zookeeper运行模式
ZooKeeper服务有两种不同的运行模式。一种是"独立模式"(standalone mode),即只有一个ZooKeeper服务器。这种模式较为简单,比较适合于测试环境,甚至可以在单元测试中采用,但是不能保证高可用性和恢复性。在生产环境中的ZooKeeper通常以"复制模式"(replicated mode)运行于一个计算机集群上,这个计算机集群被称为一个"集合体"(ensemble)。

Zookeeper的集群模式
ZooKeeper通过复制来实现高可用性,只要集合体中半数以上的机器处于可用状态,它就能够提供服务。例如,在一个有5个节点的集合体中,每个Follower节点的数据都是Leader节点数据的副本,也就是说我们的每个节点的数据视图都是一样的,这样就可以有五个节点提供ZooKeeper服务。并且集合体中任意2台机器出现故障,都可以保证服务继续,因为剩下的3台机器超过了半数。
注意:6个节点的集合体也只能够容忍2台机器出现故障,因为如果3台机器出现故障,剩下的3台机器没有超过集合体的半数。出于这个原因,一个集合体通常包含奇数台机器。
从概念上来说,ZooKeeper它所做的就是确保对Znode树的每一个修改都会被复制到集合体中超过半数的 机器上。如果少于半数的机器出现故障,则最少有一台机器会保存最新的状态,那么这台机器就是我们的Leader。其余的副本最终也会更新到这个状态。如果 Leader挂了,由于其他机器保存了Leader的副本,那就可以从中选出一台机器作为新的Leader继续提供服务。
3、ZAB协议
ZooKeeper 在解决分布式数据一致性问题时并没有直接使用 Paxos ,而是专门定制了一致性协议叫做 ZAB(ZooKeeper Automic Broadcast) 原子广播协议。Zab协议有两种模式,它们分别是恢复模式和广播模式。
ZAB 中三个主要的角色:Leader 领导者、Follower跟随者、Observer观察者。
- Leader 是集群中唯一的写请求处理者,Leader可处理客户端的读写请求,负责投票发起和决议。
- Follower能够接收客户端的请求,如果是读请求则可以自己处理,如果是写请求则要转发给 Leader ,在选举过程中会参与投票,有选举权和被选举权 。
- Observer 就是没有选举权和被选举权的 Follower,用于提升读性能 。
ZooKeeper 采用全局递增的事务id来标识,所有 proposal(提议)在被提出时都加上了ZooKeeper Transaction Id。ZXID(ZooKeeper Transaction ID)是Zookeeper中用于标识事务的全局唯一ID,每个事务操作(如创建、删除节点等)都会被分配一个ZXID,确保事务的顺序执行和一致性。
ZXID是64位Long类型的整数,由两部分组成:
- Epoch(时代号):高32位,标识Leader的任期,从1开始,每次Leader选举后Epoch的值都会递增,用于区分不同Leader任期内的事务。每次Leader选举后都会将该值更新到所有节点(Leader、Follower)的zxid的epoch。
- Counter(计数器):低32位,在当前Epoch内自增,记录该任期内的事务序号,从0开始每次事务操作加1。每次epoch变化,都将低32位的counter重置为0,这样保证了zxid的全局递增性。
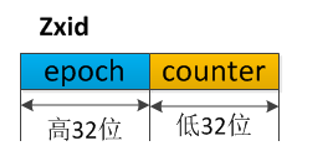
可以认为zxid越大说明存储的数据越新。
每个ZooKeeper服务器或节点,都需要在数据文件夹下创建一个名为myid的文件,该文件包含整个ZooKeeper集群唯一的id(整数),每个zookeeper节点的myid都不一样,是唯一的。例如,某ZooKeeper集群包含三台服务器,hostname分别为zk1、zk2和zk3,其myid文件中的值分别为1、2和3,则在配置文件中其id与hostname必须一一对应,如下所示。在该配置文件中,server.后面的数据即为myid。
server.1=zk1:2888:3888
server.2=zk2:2888:3888
server.3=zk3:2888:3888
在发起投票选举Leader时,投票Vote中就会包含zxid和myid,另外还包含选举轮次epoch等信息。每个节点在投票时都会将投票Vote(myid, zxid, epoch)信息广播给zookeeper集群中的其他节点,每个节点收到其他节点的Vote信息后,都会与自己本地的Vote信息比较,在选择节点成为Leader时,优先选择zxid最大的候选节点;若zxid相同,则选择myid最大的节点。
3.1、消息广播模式
正常工作时Zab协议会一直处于广播模式。Zookeeper集群收到一个操作事务的写请求时,处理过程大致如下图所示,消息广播机制通过该过程保证事务的顺序一致性。
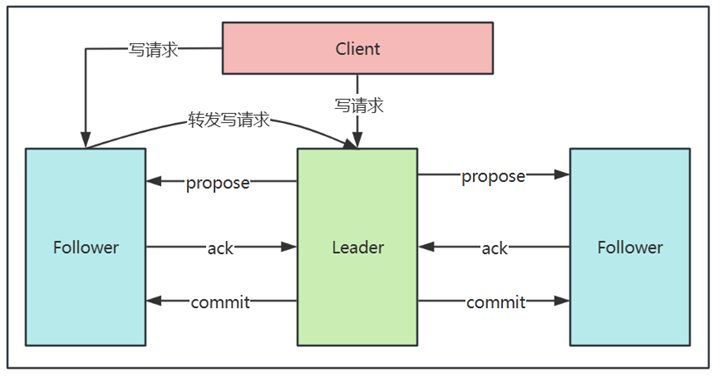
- leader从客户端收到一个写请求。
- leader生成一个新的事务并为这个事务生成一个唯一的ZXID。
- leader将这个事务发送给所有的follower节点,将带有 zxid 的消息作为一个提案(proposal)分发给所有 follower。
- follower节点将收到的事务请求加入到历史队列(history queue)中,当 follower 接收到 proposal,先将 proposal 写到磁盘,写磁盘成功后再向 leader 返回一个 ACK。
- 当leader收到大多数follower(超过一半)的ack消息,leader会向follower发送commit请求(leader自身也要提交这个事务)。
- 当follower收到commit请求时,会判断该事务的ZXID是不是比历史队列中的任何事务的ZXID都小,如果是,则提交事务,如果不是,则等待比它更小的事务的commit(保证顺序性)。
- leader将处理结果返回给客户端,客户端才会收到一个更新成功的响应。
过半写成功策略:Leader节点接收到写请求后,这个Leader会将写请求广播给各个Follower,各个Follower会将该写请求加入历史队列,并向Leader发送ACK信息,当Leader收到一半以上的ACK消息后,说明该写操作可以执行。Leader会向各个Follower发送commit消息,各个Follower收到消息后执行commit操作。
广播模式类似一个简单的两阶段提交:Leader发起一个请求,收集ack选票,最终提交。
这里要注意以下几点:
- Leader并不需要得到Observer的ACK,即Observer无投票权。
- Leader不需要得到所有Follower的ACK,只要收到过半的ACK即可,同时Leader本身对自己有一个ACK。
- Observer虽然无投票权,但仍须同步Leader的数据从而在处理读请求时可以返回尽可能新的数据。
另外,Follower/Observer也可以接受写请求,此时:
- Follower/Observer接受写请求以后,不能直接处理,而需要将写请求转发给Leader处理。
- 除了多了一步请求转发,其它流程与直接写Leader无任何区别。
- Leader处理写请求是通过上面的消息广播模式,实质上最后所有的zookeeper节点都要执行写操作,这样数据才会一致。
而对于读请求,Leader/Follower/Observer都可直接处理读请求,从本地内存中读取数据并返回给客户端即可。由于处理读请求不需要各个服务器之间的交互,因此Follower/Observer越多,整体可处理的读请求量越大,读性能越好。
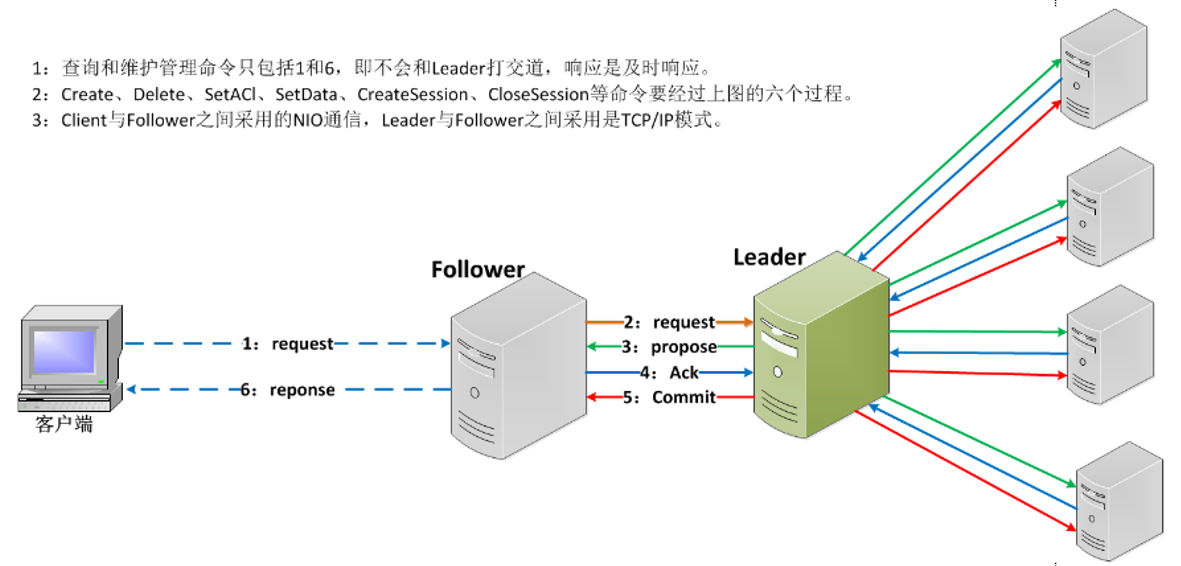
Zookeeper数据流动图
广播协议在所有的通讯过程中使用TCP的FIFO信道,通过使用该信道,使保持有序性变得非常的容易。通过FIFO信道,消息被有序的deliver。只要收到的消息一被处理,其顺序就会被保存下来。
3.2、崩溃恢复模式
正常工作时Zab协议会一直处于广播模式,直到Leader故障或失去了指定数量的Followers,此时ZAB协议处于崩溃恢复模式。为了保证进度,恢复过程中必须选举出一个新Leader,并且最终让所有的zkServer拥有一个正确的状态。当服务启动或者在Leader崩溃后,Zab就进入了恢复模式,当Leader被选举出来,且大多数follower完成了和leader的状态同步以后,恢复模式就结束了。状态同步保证了leader和follower具有相同的系统状态。
恢复模式大致可以分为四个阶段:选举、发现、同步、广播。
- 选举阶段(Leader election):当leader崩溃后,集群进入选举阶段,开始选举出潜在的准 leader,然后进入下一个阶段。
- 发现阶段(Discovery):用于在从节点中发现最新的ZXID和事务日志。准Leader接收所有Follower发来各自的最新epoch值。Leader从中选出最大的epoch,基于此值加1,生成新的epoch分发给各个Follower。各个Follower收到全新的epoch后,返回ACK给Leader,带上各自最大的ZXID和历史提议日志。Leader选出最大的ZXID,并更新自身历史日志,此时Leader就用拥有了最新的提议历史。(注意:每次epoch变化时,ZXID的低32位从0开始计数)。
- 同步阶段(Synchronization):主要是利用 leader 前一阶段获得的最新提议历史,同步给集群中所有的Follower。只有当超过半数Follower同步成功,这个准Leader才能成为正式的Leader。这之后,follower 只会接收 zxid 比自己的 lastZxid 大的提议。
- 广播阶段(Broadcast):集群恢复到广播模式,开始接受客户端的读写请求。
3.3、一致性保证
为了达到ZooKeeper所需要的一致性,ZooKeeper采用了Zab协议。Zab做了如下几条保证,来达到ZooKeeper要求的一致性。
(a) Zab要保证同一个leader的发起的事务要按顺序被apply,同时还要保证只有先前的leader的所有事务都被apply之后,新选的leader才能在发起事务。
(b) 一些已经Skip的消息,需要仍然被Skip。
对于第一条保证主要是为了保证每个Server的数据视图的一致性。对于第二条保证,它是如何实现的?为了能够实现,Skip已经被skip的消息。Zxid是由 epoch和counter组成的,如下图所示。每当Leader发生变换时,epoch位就加1,counter位置为0。Leader会广播已经被deliver的Proposal消息。在发出一个Proposal消息前,Leader会分配给Proposal一个单调递增的唯一id,称之为zxid(个人理解Zxid就是一个用来唯一标识proposal的id)。

假设ZK集群由三台机器组成,Server1、Server2、Server3。Server1为Leader,他生成了三条 Proposal,P1、P2、P3。但是在发送完P1之后,Server1就挂了。如下图所示。

Server1挂掉之后,Server3被选举成为 Leader,因为在Server3里只有一条Proposal—P1。所以,Server3在P1的基础之上又发出了一条新Proposal—P2', 由于Leader发生了变换,epoch要加1,所以epoch由原来的0变成了1,而counter要置0。那么,P2'的Zxid为10。如下图所示。

Server2发送完P2'之后,它也挂了。此时Server1已经重启恢复,并再次成为了Leader。那么,Server1将发送还没有被deliver的Proposal—P2和P3。由于Server2中P2'的Zxid为10,而Leader-Server1中P2和P3的Zxid分别为02和03,P2'的epoch位高于P2和P3。所以此时Leader-Server1的P2和P3及其之后所有的proposal都会被拒绝,那么我们Zab的第二条保证也就实现了。如下图所示。

4、zookeeper实现分布式锁
ZooKeeper实现分布式锁的核心原理:
- 利用临时顺序节点特性
- 所有客户端在指定路径下创建临时顺序节点
- 判断自己是否是最小节点,是则获取锁
- 不是最小节点则监听前一个节点
- 当前一个节点被删除时重新判断
以下是完整实现代码:
import org.apache.zookeeper.*;
import org.apache.zookeeper.data.Stat;
import java.io.IOException;
import java.util.Collections;
import java.util.List;
import java.util.concurrent.CountDownLatch;

public class DistributedLock implements Watcher {
    private ZooKeeper zk;
    private String lockPath;
    private String currentPath;
    private String waitPath;
    private CountDownLatch latch;

    public DistributedLock(String zkAddress, String lockPath) throws IOException {
        this.lockPath = lockPath;
        this.zk = new ZooKeeper(zkAddress, 3000, this);
    }

    public void lock() throws Exception {
        // 创建临时顺序节点
        currentPath = zk.create(lockPath + "/lock-",
            null,
            ZooDefs.Ids.OPEN_ACL_UNSAFE,
            CreateMode.EPHEMERAL_SEQUENTIAL);

        // 获取所有子节点并排序
        List<String> children = zk.getChildren(lockPath, false);
        Collections.sort(children);

        // 判断当前节点是否是最小节点
        String currentNode = currentPath.substring(currentPath.lastIndexOf('/') + 1);
        int index = children.indexOf(currentNode);

        if (index == 0) {
            // 获取锁成功
            return;
        } else {
            // 监听前一个节点
            waitPath = lockPath + "/" + children.get(index - 1);
            Stat stat = zk.exists(waitPath, true);
            if (stat != null) {
                latch = new CountDownLatch(1);
                latch.await();
            }
        }
    }

    public void unlock() throws Exception {
        zk.delete(currentPath, -1);
        zk.close();
    }

    @Override
    public void process(WatchedEvent event) {
        if (event.getType() == Event.EventType.NodeDeleted &&
            event.getPath().equals(waitPath)) {
            latch.countDown();
        }
    }
}
public class LockExample {
    public static void main(String[] args) {
        try {
            DistributedLock lock = new DistributedLock("localhost:2181", "/locks");

            // 获取锁
            lock.lock();
            System.out.println("获取锁成功,执行业务逻辑");

            // 模拟业务处理
            Thread.sleep(5000);

            // 释放锁
            lock.unlock();
            System.out.println("释放锁成功");
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
使用说明:
- 需要先启动ZooKeeper服务
- 添加ZooKeeper客户端依赖(maven中加org.apache.zookeeper)
- 创建DistributedLock实例时传入ZooKeeper地址和锁路径
- 调用lock()获取锁,unlock()释放锁
- 业务代码放在lock()和unlock()之间
这个实现解决了惊群效应问题,通过只监听前一个节点的方式减少通知数量。使用时要注意处理各种异常情况,确保锁最终能被释放。
5、zookeeper如何保证一致性和高可用性
一、zookeeper保证强一致性的原理
ZooKeeper实现的是CP模型,即强一致性(非最终一致性)。
ZooKeeper通过ZAB协议(ZooKeeper Atomic Broadcast)实现强一致性:
1. Leader写操作:
- 所有写请求由Leader节点处理,生成事务提案(Proposal)并广播给Follower。
- 提案需获得多数节点(Quorum)确认后才能提交(Commit)。
2. Follower同步:
- Follower节点需将事务日志同步到本地后才会响应客户端读请求。
- 若客户端从Follower节点读取数据,该节点会先检查本地数据是否与Leader同步,若Follower未同步最新数据,会拒绝读请求或重定向到Leader。
ZooKeeper 通过其分布式架构、复制机制和基于共识的选举协议来保证高可用性。其核心原理如下:
二、保证高可用性的原理
1、分布式架构:
- ZooKeeper 集群由多个服务器节点组成(通常称为 ensemble)。
- 数据和服务分布在集群中的多个节点上,避免了单点故障。
2、数据复制:
- ZooKeeper 维护一个内存数据库,包含整个数据树(znode 层次结构)和事务日志。
- 所有写操作都由 Leader 节点处理。
- Leader 将写操作(事务)复制(Replicate) 到集群中的 Follower(和 Observer)(Observer 不参与选举,只接收数据副本以提高读性能)。
- 每个节点在本地磁盘上存储数据的副本和事务日志。
3、读写分离:
- 写操作 (Write): 必须由 Leader 处理,以确保所有节点的状态变更顺序一致。Leader 将变更提议发送给所有 Follower/Observer,并在收到多数派 (Quorum) 的确认后才提交变更。
- 读操作 (Read): 可以由任何节点(Leader、Follower、Observer)独立处理,无需与其他节点协调。这大大提高了读吞吐量和可用性。
4、基于 Zab 协议的一致性保证:
- ZooKeeper 使用自行设计的 Zab (ZooKeeper Atomic Broadcast) 协议。
- Zab 是一个崩溃恢复 (Crash Recovery) 和原子广播 (Atomic Broadcast) 协议。
- 崩溃恢复: 确保在 Leader 故障后能够选举出新的 Leader,并安全地恢复状态。
- 原子广播: 确保所有已提交的事务(写操作)按照相同的顺序被复制到所有可用的节点上。这保证了顺序一致性。
- Leader 提交: Leader 只有在收到集群中多数派 (Quorum) 节点的 Ack 后,才会提交一个事务并通知 Follower 提交。这保证了数据不会在多数派未持久化的情况下丢失。
5、容错性:
- 只要集群中超过半数的节点存活并能相互通信(即达到 Quorum),集群就能继续提供服务(读和写)。
- 例如:对于一个 3 节点的集群(Quorum = 2),可以容忍 1 个节点故障;5 节点集群(Quorum = 3),可以容忍 2 个节点故障。
三、Leader 故障与选举过程(基于 FastLeaderElection)
当 Follower 检测到与 Leader 的心跳超时(或新节点加入集群初始化时),集群会进入 Leader 选举状态。核心算法是 FastLeaderElection:
1、状态变更: 检测到 Leader 失联的 Follower 会将自己的状态变为 LOOKING,表明它要发起或参与新一轮选举。
2、广播投票: 每个 LOOKING 状态的节点都会构建一张选票 (Vote),包含:
- proposedLeader:它认为应该成为新 Leader 的节点 ID(myid)。初始时,每个节点都投票给自己。
- proposedZxid:它所知道的(本地的)最大事务 ID (zxid)。这个 ID 是全局单调递增的,代表了数据的新旧程度。
- proposedEpoch:它所知道的(本地的)选举轮次 (epoch)。每次新的选举会递增 epoch。
3、接收投票与比较: 每个节点将它的选票广播给集群中的所有其他节点(包括非 LOOKING 状态的节点),同时也接收其他节点的选票。
4、投票决策: 当一个节点收到一张来自其他节点的选票时,它会将这张选票 (Vote v) 与它当前认为最优的选票 (Vote currentVote) 进行比较。比较规则是优先级递减:
- 比较 proposedZxid: zxid 更大的选票胜出(表示该节点拥有更新的数据)。
- 如果 zxid 相等,比较 proposedLeader (server id): server id 更大的选票胜出(这是一个打破平局的机制,通常配置为更大的数字表示更强的机器)。
- 如果都相等,则保留 currentVote。
如果 v 比 currentVote 更优,节点会将自己的 currentVote 更新为 v,并将这个新的最优选票广播出去。
5、统计选票: 节点会统计它收到的所有选票(包括自己发出的)。对于收到的每张选票,它只看其 (proposedLeader, proposedEpoch) 是否与自己当前的 currentVote 匹配。
6、达成多数派: 如果某个节点发现,对于它当前的 currentVote (Vote = (leader, zxid, epoch)),集群中有超过半数的节点(达到 Quorum) 投给了相同的 (leader, epoch),那么:
- 该节点确定投票结束。
- 如果 leader 是它自己,它将自己的状态变为 LEADING,成为新的 Leader。
- 如果 leader 是其他节点,它将自己的状态变为 FOLLOWING(或 OBSERVING),成为新 Leader 的从节点。
7、新 Leader 同步: 新 Leader 会与所有 Follower/Observer 进行数据同步,确保它们的数据是最新的。完成后,集群恢复正常的读写服务。
四、节点个数要求与奇偶性
1、最小节点数: 为了保证高可用(能容忍至少 1 个节点故障),最小集群规模是 3 个节点。
2、为什么需要奇数个节点(推荐)? 核心原因是为了避免脑裂并能可靠地形成多数派 (Quorum)。
- Quorum 定义: Quorum 是集群中正常运作所需的最小节点数,计算公式为 Quorum = floor(N/2) + 1,其中 N 是集群总节点数。
- 容忍故障数: 集群能容忍的故障节点数为 F = N - Quorum(即小于 Quorum 的节点宕机不影响集群工作)。
- 脑裂风险(偶数节点潜在劣势)。
想象一个 4 节点集群,网络分区导致分成两个各包含 2 个节点的子集群(2-2 分区)。此时,两个子集群都无法单独达到 Quorum=3,整个集群将完全不可用(进入自我保护状态,拒绝写请求)。而一个 3 节点集群如果发生网络分区(2-1),2 个节点那一侧能形成 Quorum=2(因为 Quorum=2),继续保持服务,1 个节点那一侧无法服务。虽然发生了分区,但至少有一个分区能继续工作。奇数节点的设计让网络分区后更有可能(虽然不是绝对保证,取决于分区大小)保留一个能形成 Quorum 的子集继续工作。
3 节点和 4 节点都只能容忍 1 个节点故障,4 节点并没有提高容错能力(F=1 vs F=1),但它需要多消耗一台服务器资源。
必须奇数吗? 不是必须,但强烈推荐。 你可以使用偶数节点(如 2 或 4)。
2 节点: Quorum = 2。只要有一个节点故障,整个集群就不可用(存活数 1 < 2)。这完全失去了高可用性,仅用于测试或开发。
4 节点: 如上所述,它能容忍 1 个故障,但相比 3 节点没有提高容错能力却增加了成本和潜在的可用性风险(如 2-2 网络分区导致完全不可用),资源利用率低且不如奇数节点健壮。
结论: 生产环境强烈建议使用奇数个节点(3, 5, 7)。这能以最经济的节点数量获得最佳的容错能力和避免脑裂的能力。偶数节点通常没有实际优势。
总结:
ZooKeeper 通过分布式复制架构、基于 Zab 协议的顺序一致性保证(由 Leader 处理写并通过 Quorum 机制复制)、以及任何节点可处理读操作来实现高可用。当 Leader 故障时,集群通过 FastLeaderElection 算法(优先选择数据最新 zxid 最大、其次 server id 最大的节点)选举出新的 Leader。集群要求至少 3 个节点才能提供高可用(容忍单点故障),并强烈推荐使用奇数个节点(3, 5, 7),因为这样能以最少的节点资源达到所需的容错能力(容忍 (N-1)/2 个故障),并且能更有效地避免网络分区导致的脑裂或完全不可用问题。
Zookeeper在写入操作上保证强一致性(C),在读取操作上提供顺序一致性而非强一致性。其设计更倾向于CP系统,在网络分区时优先保证数据一致性而可能牺牲可用性。
关键特性分析:
1、写入流程
- 所有写请求必须通过Leader节点处理,确保数据强一致性。
- 写入需等待多数节点(Quorum)确认,期间若Leader宕机会触发选举,导致服务短暂不可用。
2、读取行为
- 默认情况下,读操作可能返回非最新数据(如连接未同步的Follower节点)
- 通过sync方法可强制同步最新数据,但会降低性能
3、选举机制
- Leader选举期间(通常毫秒级)服务不可用,体现CP特性
- 采用ZAB协议保证选举结果唯一性,避免脑裂问题
ZooKeeper的CAP特性分析:
在分布式系统中,CAP理论指出系统无法同时满足以下三个特性:
- C一致性 (Consistency):所有节点同时看到相同的数据
- A可用性 (Availability):每个请求都能获得响应(不保证最新数据)
- P分区容错 (Partition tolerance):在网络分区时系统仍能运作
ZooKeeper的核心定位:CP系统
1、一致性优先(C)
1.强一致性保证:
- 写操作必须通过Leader节点,并使用ZAB协议实现原子广播
- 需要获得多数节点(Quorum)确认后才提交
- 所有节点按相同顺序执行写操作(线性一致性)
2.数据同步机制:
  Client->>Leader: 写请求
  Leader->>Follower1: 提案广播
  Leader->>Follower2: 提案广播
  Follower1-->>Leader: ACK
  Follower2-->>Leader: ACK
  Leader->>Leader: 收到多数ACK后提交
  Leader->>Follower1: 提交通知
  Leader->>Follower2: 提交通知
  Leader-->>Client: 写操作成功
2、分区容错(P)
1.网络分区处理:
- 当发生网络分区时,只有包含多数节点(Quorum)的分区可以继续工作
- 少数节点分区自动停止服务,避免"脑裂"导致数据不一致
- 分区检测通过心跳机制实现(默认2秒)
2.容错能力:
|
节点总数 |
容错能力 |
Quorum大小 |
|
3 |
1节点故障 |
2 |
|
5 |
2节点故障 |
3 |
|
7 |
3节点故障 |
4 |
3、可用性牺牲(A)
1.Leader选举期间服务中断:
- Leader故障时触发选举(通常200ms-5s)
- 选举期间暂停所有写操作
- 读操作可能返回旧数据(取决于连接的节点)
2.网络分区时的可用性限制:
- 当分区导致无Quorum时(如5节点集群分裂为2-3)
- 少数分区(2节点)完全不可用
- 多数分区(3节点)可提供服务但性能下降
与AP系统对比:
|
特性 |
ZooKeeper (CP) |
Eureka (AP) |
|
数据一致性 |
强一致性 |
最终一致性 |
|
网络分区处理 |
牺牲少数分区可用性 |
所有分区保持可用 |
|
读性能 |
本地快速读 |
本地快速读 |
|
写延迟 |
需Quorum确认(较高) |
无需确认(极低) |
|
适用场景 |
分布式锁、配置中心 |
服务注册与发现 |
ZooKeeper是典型的CP系统:
- 强一致性保证:通过ZAB协议和Quorum机制
- 分区容错性:优先保证多数分区正常运行
- 选择性可用性:在网络分区或Leader选举期间部分服务不可用
- 适用场景:
- 分布式协调服务(锁、选举)
- 配置管理中心
- 命名服务
- 需要强一致性的元数据存储
- 不适用场景:
- 高可用服务注册发现(考虑Eureka/Nacos,Nacos支持CP/AP切换,默认是AP)
- 海量数据存储(考虑ETCD)
- 跨地域分布式系统(高延迟影响性能)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 23
 0
- 0


 已为社区贡献5条内容

所有评论(0)