基于 LangChain + LangGraph+Playwright 的智能化、零代码Web UI自动化测试平台
项目简介
自动化UI测试Agent是一款基于 FastAPI + Vue3 + LangChain /LangGraph+Playwright +标准Skills 的企业级Web UI自动化测试平台,具有以下特点:
零代码测试:只需输入URL即可自动生成测试用例
AI驱动:基于大语言模型智能分析页面元素和需求文档
Agent架构:标准的「大模型 + 思考决策逻辑 + 外部工具集」架构
技能扩展:遵循企业级标准化技能目录规范,支持插件化扩展
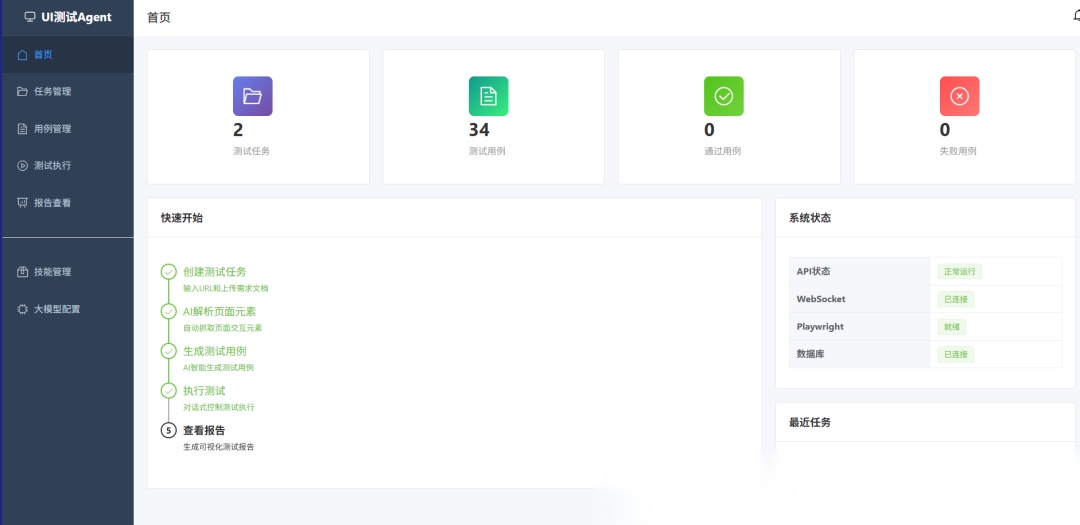
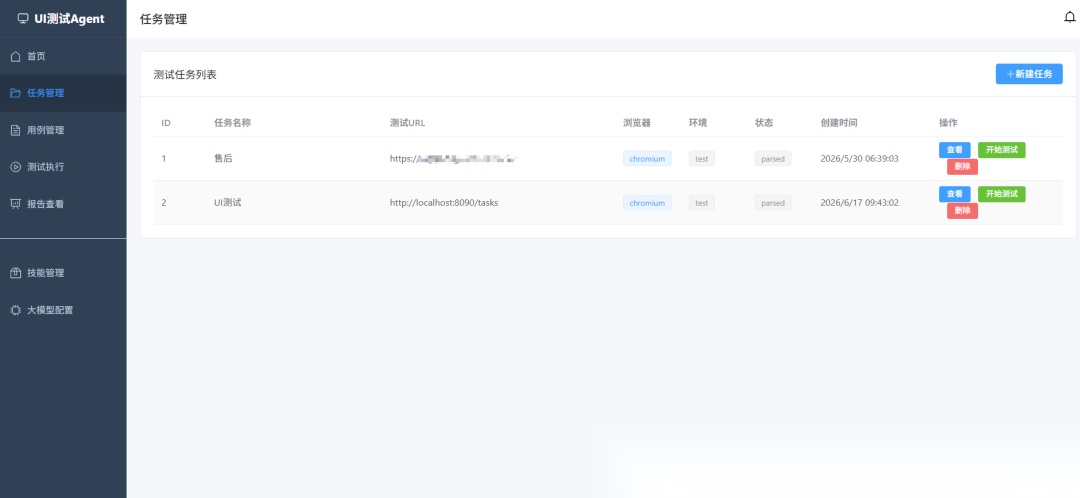
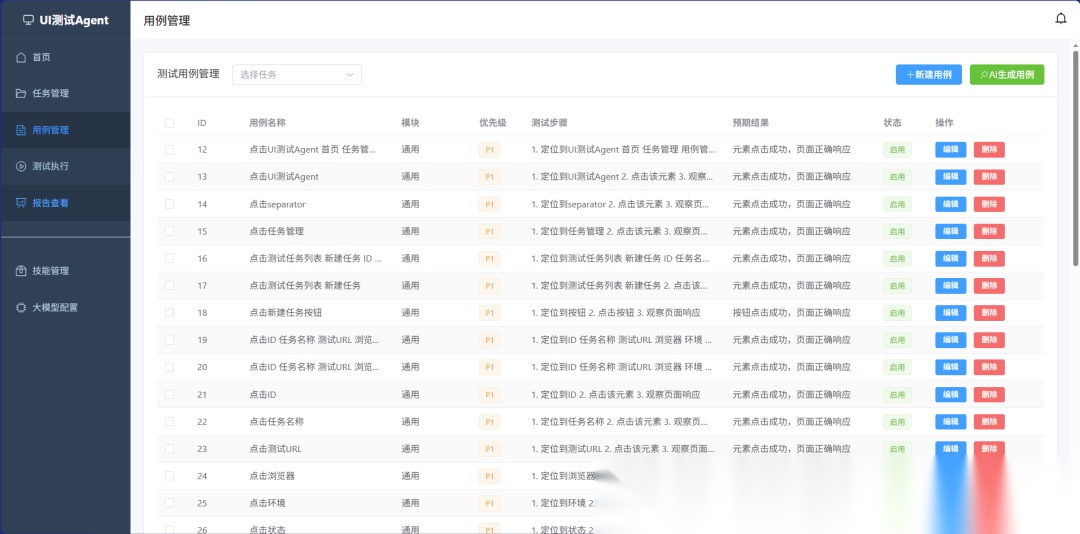
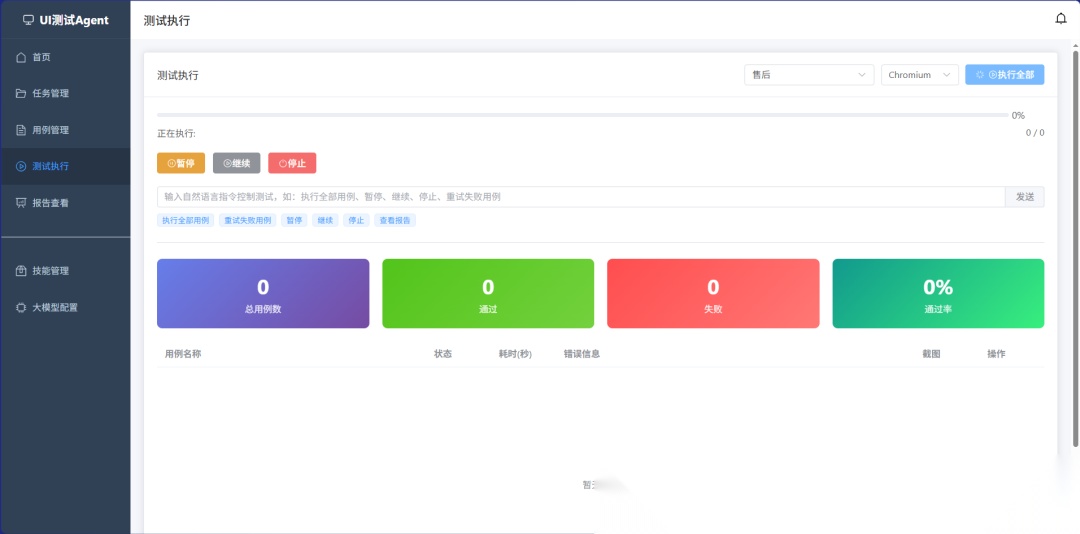
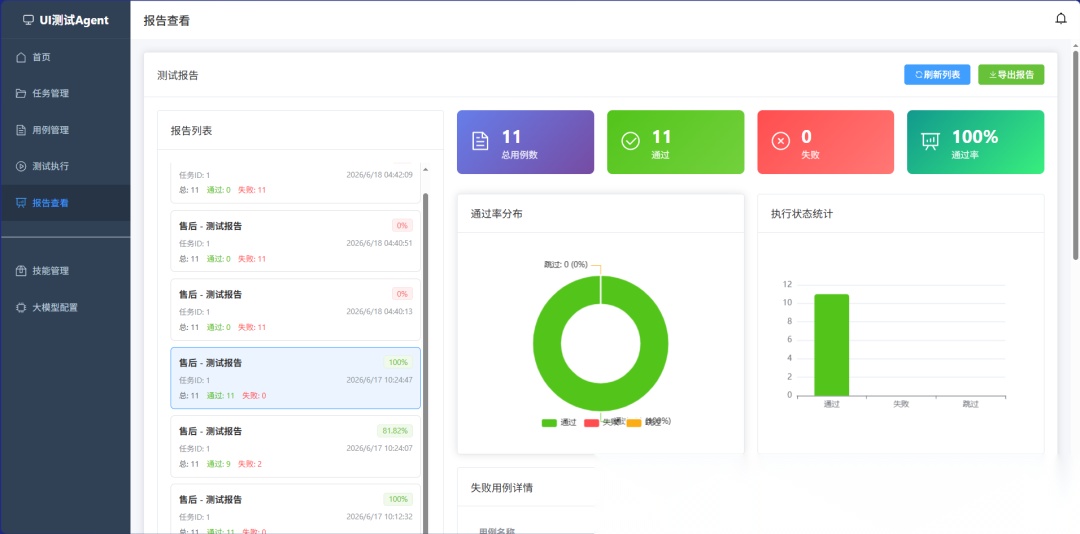
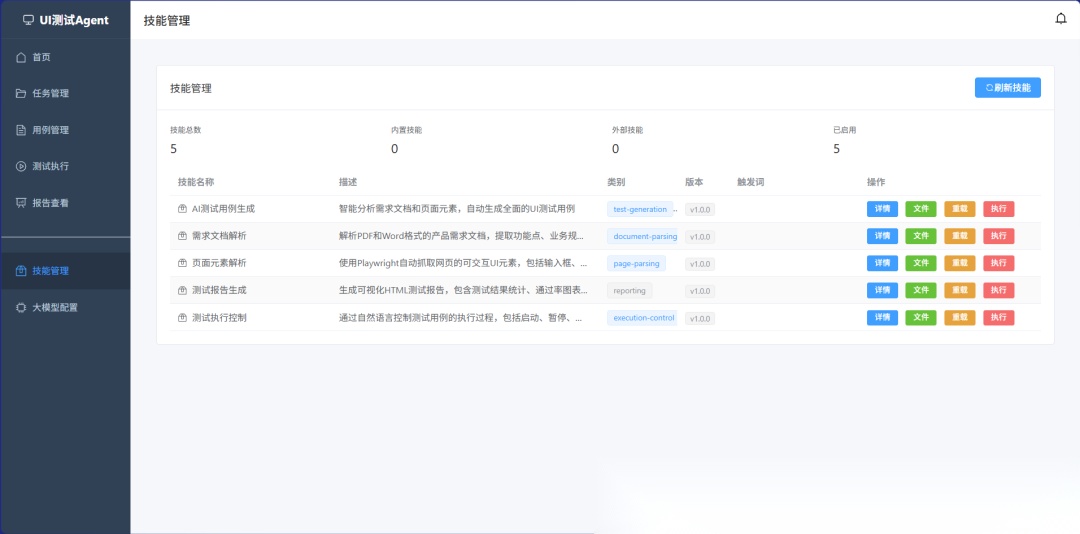
可视化管理:提供完整的任务、用例、执行和报告管理界面
后端技术栈
| 技术 | 版本 | 说明 |
|---|---|---|
| Python | 3.11+ | 编程语言 |
| FastAPI | 0.109.0 | 高性能Web框架 |
| Uvicorn | 0.27.0 | ASGI服务器 |
| SQLAlchemy | 2.0.25 | 异步ORM框架 |
| LangChain | 1.3.9 | LLM应用开发框架 |
| LangGraph | 1.2.5 | 状态机工作流引擎 |
| langchain-openai | 1.3.2 | OpenAI兼容接口 |
| Playwright | 1.41.0 | 自动化测试工具 |
| SQLite | 内置 | 轻量级数据库 |
前端技术栈
| 技术 | 版本 | 说明 |
|---|---|---|
| Vue | 3.4+ | 前端框架 |
| Element Plus | 2.6+ | UI组件库 |
| Pinia | 2.1+ | 状态管理 |
| Vue Router | 4.3+ | 路由管理 |
| ECharts | 5.5+ | 图表库 |
| Vite | 5.4+ | 构建工具 |
功能特性
核心功能
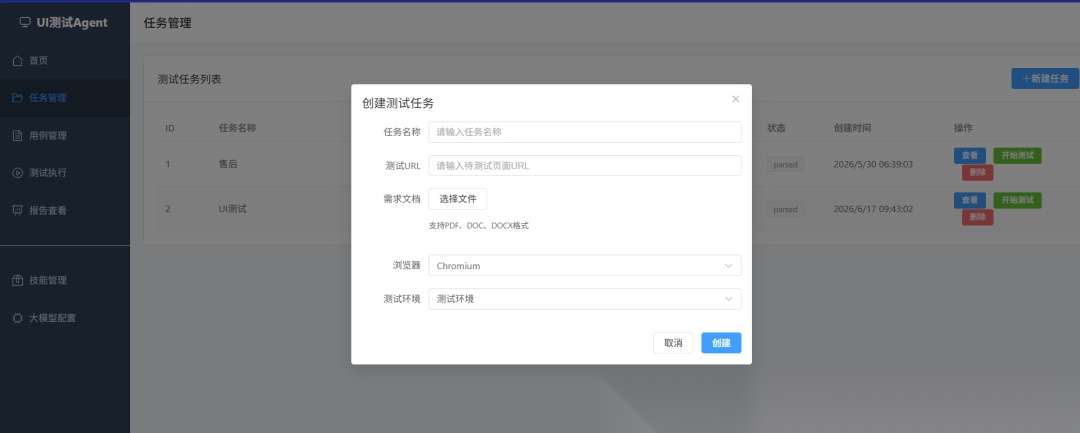
任务管理:创建、编辑、删除测试任务,支持URL和文档导入
页面解析:自动抓取页面元素,识别可交互元素(按钮、输入框、选择框等)
用例生成:基于页面元素和需求文档智能生成测试用例
测试执行:支持批量执行测试用例,实时显示进度(WebSocket推送)
报告生成:自动生成详细的测试报告,包含统计图表和截图
扩展功能
技能管理:标准化技能目录规范,支持自定义技能扩展
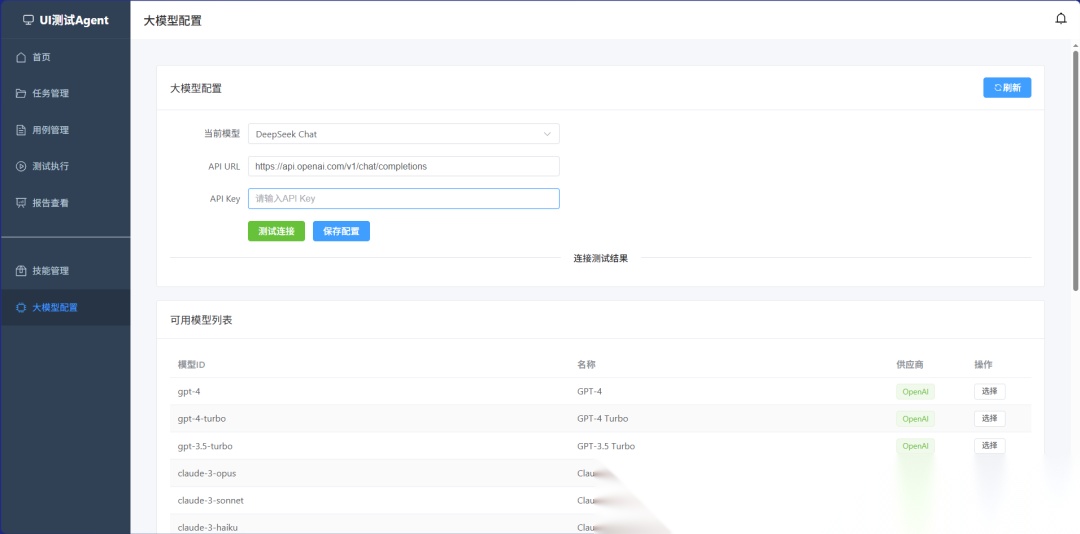
大模型配置:支持多模型切换和API配置
自动技能发现:启动时自动扫描技能目录,动态注册工具
项目结构
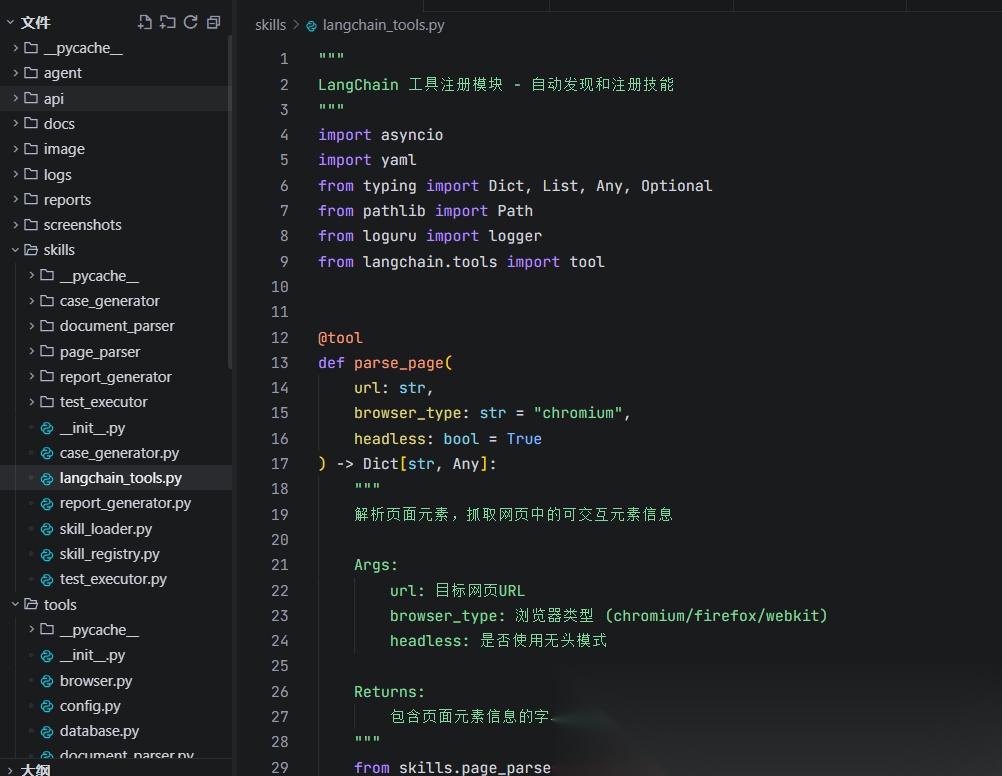
ai_uitest_agent/
├── agent/                    # Agent核心模块
│   ├── __init__.py
│   ├── core.py               # 代理核心逻辑
│   └── langgraph_agent.py    # LangGraph状态机代理
├── api/                      # API接口模块
│   ├── __init__.py
│   ├── routes.py             # REST API路由
│   ├── schemas.py            # 数据模型定义
│   ├── websocket.py          # WebSocket处理
│   └── websocket_manager.py  # WebSocket连接管理
├── skills/                   # 技能模块(标准化结构)
│   ├── __init__.py
│   ├── langchain_tools.py    # LangChain工具注册
│   ├── page_parser/          # 页面解析器技能
│   │   ├── SKILL.md
│   │   ├── metadata.yaml
│   │   └── scripts/run.py
│   ├── document_parser/      # 文档解析器技能
│   │   ├── SKILL.md
│   │   ├── metadata.yaml
│   │   └── scripts/run.py
│   ├── case_generator/       # 用例生成器技能
│   │   ├── SKILL.md
│   │   ├── metadata.yaml
│   │   └── scripts/run.py
│   ├── test_executor/        # 测试执行器技能
│   │   ├── SKILL.md
│   │   ├── metadata.yaml
│   │   └── scripts/run.py
│   └── report_generator/     # 报告生成器技能
│       ├── SKILL.md
│       ├── metadata.yaml
│       └── scripts/run.py
├── tools/                    # 工具模块
│   ├── __init__.py
│   ├── browser.py            # 浏览器操作工具
│   ├── config.py             # 配置管理
│   ├── database.py           # 数据库操作
│   ├── document_parser.py    # 文档解析工具
│   └── logger.py             # 日志管理
├── ui/                       # 前端模块
│   ├── src/
│   │   ├── api/              # API调用封装
│   │   ├── router/           # 路由配置
│   │   ├── stores/           # 状态管理
│   │   ├── views/            # 页面组件
│   │   ├── App.vue           # 根组件
│   │   └── main.js           # 入口文件
│   ├── index.html
│   ├── package.json
│   └── vite.config.js
├── .env                      # 环境变量配置
├── main.py                   # 应用入口
├── requirements.txt          # Python依赖
└── uitest_agent.db           # SQLite数据库文件
已实现的技能
| 技能名称 | 描述 | 工具名 |
|---|---|---|
| 页面解析器 | 抓取网页可交互元素 | parse_page |
| 文档解析器 | 解析PDF/Word需求文档 | parse_document |
| 用例生成器 | 智能生成测试用例 | generate_cases |
| 测试执行器 | 执行测试用例 | execute_tests |
| 报告生成器 | 生成测试报告 | generate_report |
测试根据URL/需求文档 自动生成用例核心代码
class CaseGenerator:
def __init__(self):
self.priority_levels = ["P0", "P1", "P2"]
async def generate_cases(
self,
url: str,
page_elements: List[Dict[str, Any]],
document_data: Optional[Dict[str, Any]] = None,
requirements: List[str] = None
) -> List[Dict[str, Any]]:
logger.info("Generating test cases...")
cases = []
cases.extend(self._generate_normal_cases(page_elements))
cases.extend(self._generate_validation_cases(page_elements))
cases.extend(self._generate_boundary_cases(page_elements))
if document_data and document_data.get("structured"):
structured = document_data["structured"]
if structured.get("functional_points"):
cases.extend(self._generate_from_functional_points(
structured["functional_points"],
page_elements
))
cases = self._deduplicate_cases(cases)
cases = self._assign_priorities(cases)
logger.info(f"Generated {len(cases)} test cases")
return cases
def _generate_normal_cases(self, elements: List[Dict]) -> List[Dict]:
cases = []
for elem in elements:
if elem.get("tag") == "input":
cases.append({
"name": f"输入框{elem.get('name') or elem.get('placeholder')}正常输入",
"module": self._get_module(elem),
"priority": "P1",
"preconditions": f"打开目标页面,找到输入框{elem.get('name') or elem.get('placeholder')}",
"steps": f"1. 点击输入框\n2. 输入有效数据\n3. 检查输入内容是否正确显示",
"expected_results": "输入内容正确显示,无格式错误",
"element_selector": elem.get("selector", "")
})
elif elem.get("tag") == "button" or (elem.get("tag") == "a" and elem.get("text")):
cases.append({
"name": f"点击{elem.get('text') or elem.get('name')}按钮",
"module": self._get_module(elem),
"priority": "P1",
"preconditions": f"页面加载完成,按钮{elem.get('text') or elem.get('name')}可见",
"steps": f"1. 定位到按钮\n2. 点击按钮\n3. 观察页面响应",
"expected_results": "按钮点击成功,页面正确响应",
"element_selector": elem.get("selector", "")
})
elif elem.get("tag") == "select":
cases.append({
"name": f"下拉框{elem.get('name')}选择操作",
"module": self._get_module(elem),
"priority": "P1",
"preconditions": f"下拉框{elem.get('name')}可见",
"steps": f"1. 点击下拉框\n2. 选择选项\n3. 验证选择结果",
"expected_results": "下拉框选择成功,显示所选内容",
"element_selector": elem.get("selector", "")
})
elif elem.get("tag") == "textarea":
cases.append({
"name": f"文本域{elem.get('name') or elem.get('placeholder')}输入",
"module": self._get_module(elem),
"priority": "P1",
"preconditions": f"文本域{elem.get('name') or elem.get('placeholder')}可见",
"steps": f"1. 点击文本域\n2. 输入多行文本\n3. 验证输入内容",
"expected_results": "文本域输入成功,内容正确显示",
"element_selector": elem.get("selector", "")
})
elif elem.get("tag") == "div" and (elem.get("role") or elem.get("text")):
element_name = elem.get("text") or elem.get("role") or "DIV元素"
cases.append({
"name": f"点击{element_name}",
"module": self._get_module(elem),
"priority": "P1",
"preconditions": f"页面加载完成,{element_name}可见",
"steps": f"1. 定位到{element_name}\n2. 点击该元素\n3. 观察页面响应",
"expected_results": "元素点击成功,页面正确响应",
"element_selector": elem.get("selector", "")
})
return cases
def _generate_validation_cases(self, elements: List[Dict]) -> List[Dict]:
cases = []
for elem in elements:
if elem.get("tag") == "input":
input_name = elem.get("name") or elem.get("placeholder") or "输入框"
cases.append({
"name": f"{input_name}必填校验",
"module": self._get_module(elem),
"priority": "P0",
"preconditions": f"找到必填输入框{input_name}",
"steps": f"1. 留空{input_name}\n2. 尝试提交\n3. 检查提示信息",
"expected_results": "显示必填提示,不允许提交",
"element_selector": elem.get("selector", "")
})
cases.append({
"name": f"{input_name}格式校验",
"module": self._get_module(elem),
"priority": "P1",
"preconditions": f"找到输入框{input_name}",
"steps": f"1. 输入格式错误的数据\n2. 尝试提交\n3. 检查格式错误提示",
"expected_results": "显示格式错误提示",
"element_selector": elem.get("selector", "")
})
return cases
def _generate_boundary_cases(self, elements: List[Dict]) -> List[Dict]:
cases = []
for elem in elements:
if elem.get("tag") == "input":
input_name = elem.get("name") or elem.get("placeholder") or "输入框"
cases.append({
"name": f"{input_name}边界值-超长输入",
"module": self._get_module(elem),
"priority": "P2",
"preconditions": f"找到输入框{input_name}",
"steps": f"1. 输入超长字符(1000+字符)\n2. 检查系统响应",
"expected_results": "系统正确处理超长输入,不崩溃",
"element_selector": elem.get("selector", "")
})
cases.append({
"name": f"{input_name}边界值-特殊字符",
"module": self._get_module(elem),
"priority": "P2",
"preconditions": f"找到输入框{input_name}",
"steps": f"1. 输入特殊字符(<>\"'&等)\n2. 检查系统响应",
"expected_results": "特殊字符被正确转义或过滤",
"element_selector": elem.get("selector", "")
})
return cases
def _generate_from_functional_points(
self,
functional_points: List[str],
elements: List[Dict]
) -> List[Dict]:
cases = []
for point in functional_points:
cases.append({
"name": f"功能点: {point}",
"module": "功能验证",
"priority": "P0",
"preconditions": "系统已登录,页面已加载",
"steps": f"1. 进入相关功能页面\n2. 执行{point}\n3. 验证结果",
"expected_results": f"{point}功能正常工作",
"element_selector": ""
})
return cases
def _get_module(self, element: Dict) -> str:
if element.get("id"):
return element.get("id").split("-")[0] if "-" in element.get("id") else "通用"
if element.get("name"):
return element.get("name").split("-")[0] if "-" in element.get("name") else "通用"
return "通用"
def _deduplicate_cases(self, cases: List[Dict]) -> List[Dict]:
seen = set()
unique_cases = []
for case in cases:
key = case.get("name", "")
if key not in seen:
seen.add(key)
unique_cases.append(case)
return unique_cases
def _assign_priorities(self, cases: List[Dict]) -> List[Dict]:
priority_keywords = {
"P0": ["必填", "校验", "验证", "登录", "核心", "必选"],
"P1": ["正常", "常规", "点击", "输入", "选择"],
"P2": ["边界", "特殊", "超长", "异常"]
}
for case in cases:
name = case.get("name", "")
priority = "P1"
for p_level, keywords in priority_keywords.items():
if any(kw in name for kw in keywords):
priority = p_level
break
case["priority"] = priority
return cases
case_generator = CaseGenerator()
开源地址:
https://gitee.com/fxlysm/ai_uitest_agent.git
# 若定制,可联系我
当前为离职状态,若广大的深圳朋友们如果有测试开发/自动化/测试管理岗位,请推荐一下,谢谢!
效果图
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
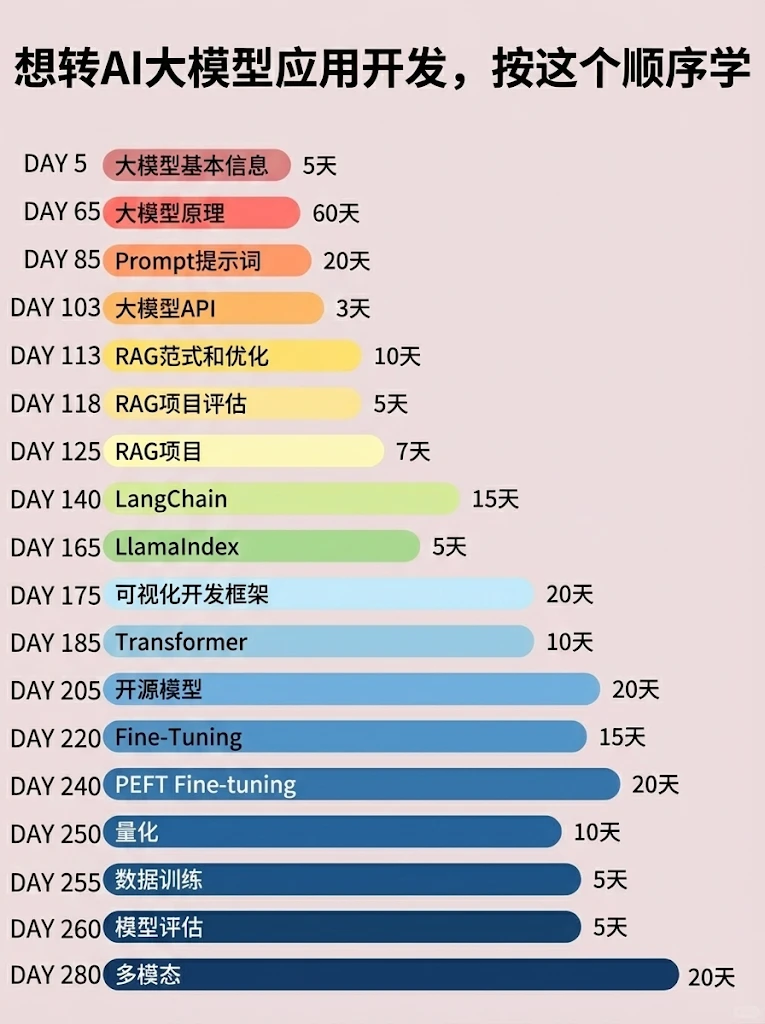
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 7
 0
- 0


 已为社区贡献64条内容

所有评论(0)