专题二滑动窗口
4-26第一次订改优化
专题二滑动窗口
双指针沿数组正向/逆向的特殊单调性( 值限制、位限制等 )的同向移动。
此类型关键在于 思路的优化迭代在保证r不回退的前提下与[l]的陆续弹出。
辅助:哈希表 解决不定的计数问题(像滑动窗口中的是否出窗口完全)。
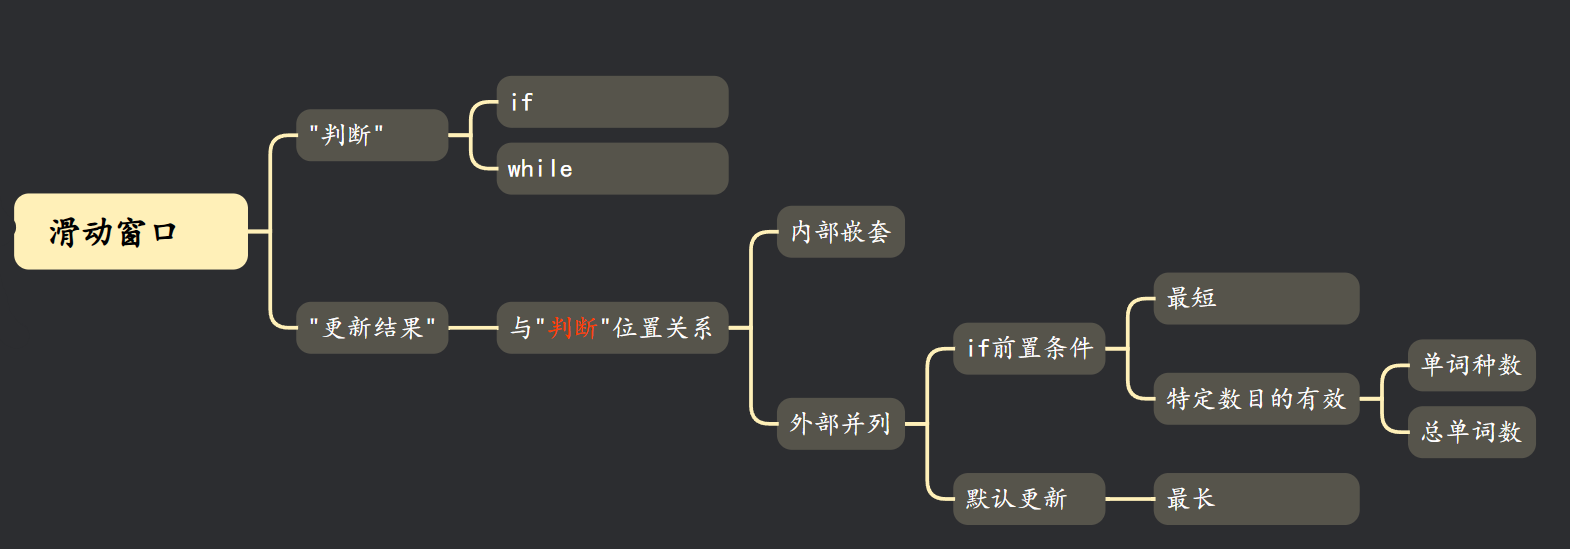
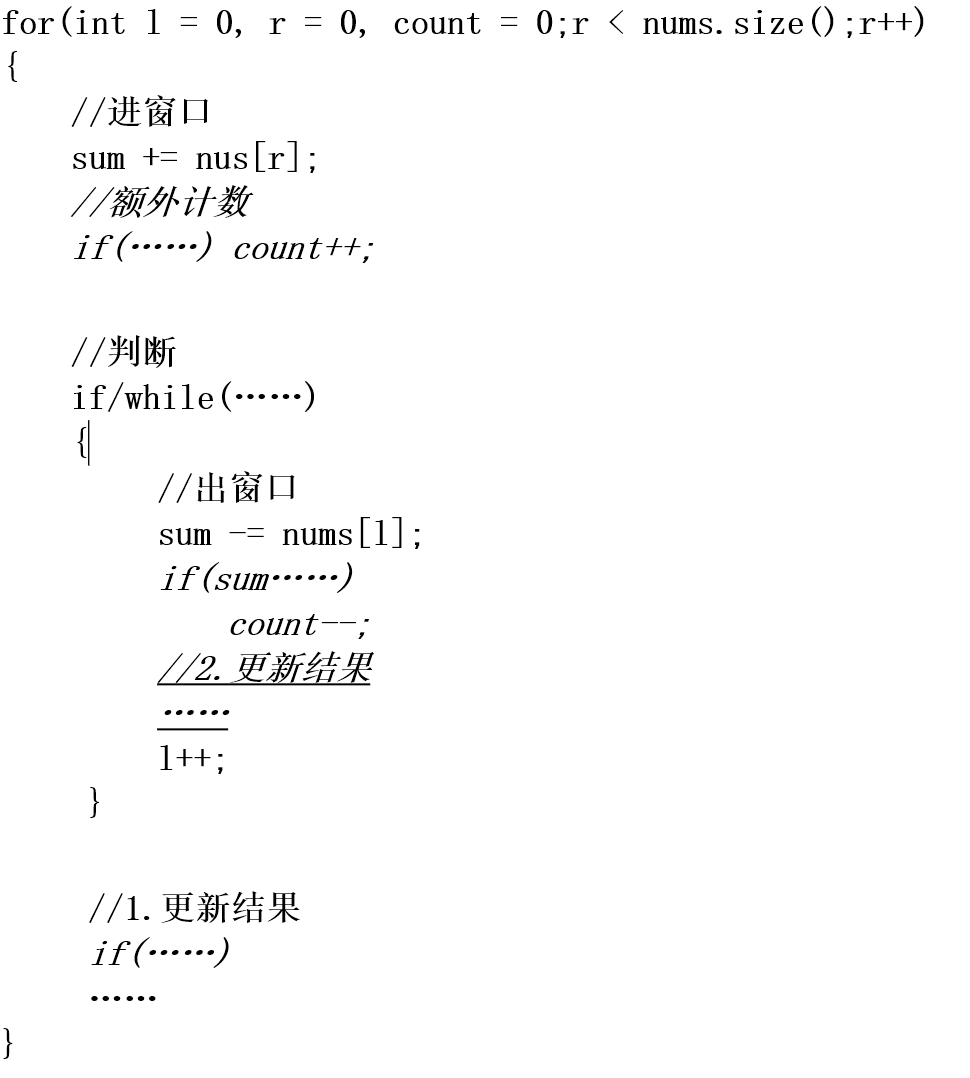
虽然十分不提倡"模板"的解题使用但模板恰恰反应了解决此类问题的核心本质:
第一步:定义r与l维护区间for后r++。
第二步:更新结果的位置选取 (l的陆续弹出)。 //但此陆续弹出不一定指单次循环仅弹出一个。关键在于哈希表的灵活应用。
第三步:返回的最后结果的特殊情况判断。
1.两数和大于值的最小长度
"更新结果"位于"判断"内部的场景
由于求的是最小长度与目标值比较
所以“判断”时选取while内嵌套if的"更新结果"
给定一个含有 n 个正整数的数组和一个正整数 target 。
找出该数组中满足其总和大于等于 target 的长度最小的 子数组 [numsl, numsl+1, ..., numsr-1, numsr] ,并返回其长度。如果不存在符合条件的子数组,返回 0 。
以r与l维护区间以弹出和入窗口。
class Solution {
public:
    int minSubArrayLen(int target, vector<int>& nums) {
        int len = INT_MAX;
        for(int l = 0, r = 0, sum = 0;r < nums.size();r++)
        {
            sum += nums[r];

            while(sum >= target)
            {
                len = r - l + 1<len? r - l + 1:len;
                sum -= nums[l++];
            }
        }
        if(len == INT_MAX) return 0;
        return len;
    }
};
2.无重复字符串的最小长度
bug
l++连续窗口情景
给定一个字符串 s ,请你找出其中不含有重复字符的 最长 子串 的长度。
输入: s = "abcabcbb"
输出: 3
解释: 因为无重复字符的最长子串是
"abc"所以其长度为 3。注意 "bca" 和 "cab" 也是正确答案。
class Solution
{
public:
    int lengthOfLongestSubstring(string s)
    {
        if(s.size() == 0) return 0;//特殊情况的判断
        int len = 1;
        unordered_map<char, int> m;
        for(int l = 0, r = 0;r < s.size();r++)
        {
            m[s[r]]++;
            while(m[s[r]] >= 2)
                m[s[l++]]--;
            len = r - l + 1 > len ? r - l + 1:len;
        }
        return len;
    }
};
思路:滑动窗口+哈希表
简化r的回溯过程 l 的跳跃前进。
r遇到重复固定 l前进至掠过重复元素期间哈希表计数--。
3.将x减到0的最小操作数
l++连续出窗口的情景
1.while内控制的数组下标越界行为。
2.更新结果内部l++吗? ①若是0那么++出错。 ②此处是"出窗口"的性质吗? 不是,是"更新结果"的性质。
给你一个整数数组 nums 和一个整数 x 。每一次操作时,你应当移除数组 nums 最左边或最右边的元素,然后从 x 中减去该元素的值。请注意,需要 修改 数组以供接下来的操作使用。
如果可以将 x 恰好 减到 0 ,返回 最小操作数 ;否则,返回 -1 。
利用:正难则反的编程思想。将原问题转换为求数组中间连续区域的最大长度len后以size()减去len即可。
class Solution {
public:
int minOperations(vector<int>& nums, int x) {
int len = -1;
int sum = 0;
for(auto e:nums)
{
sum += e;
}
sum -= x;
for(int l = 0, r = 0, t = 0;r < nums.size();r++)
{
t += nums[r];
while(l < nums.size() && t > sum)
t -= nums[l++];
if(t == sum)
len = r - l + 1 > len ? r - l + 1:len;
// 不能l++为什么?
// 1.若是0那么++出错
// 2.此处是"出窗口"的性质吗?不是,是"更新结果"的性质。
}
if(len == -1)
return -1;
return nums.size() - len;
}
};4.水果成篮
count计数情景
你正在探访一家农场,农场从左到右种植了一排果树。这些树用一个整数数组 fruits 表示,其中 fruits[i] 是第 i 棵树上的水果 种类 。
你想要尽可能多地收集水果。然而,农场的主人设定了一些严格的规矩,你必须按照要求采摘水果:
- 你只有 两个 篮子,并且每个篮子只能装 单一类型 的水果。每个篮子能够装的水果总量没有限制。
- 你可以选择任意一棵树开始采摘,你必须从 每棵 树(包括开始采摘的树)上 恰好摘一个水果 。采摘的水果应当符合篮子中的水果类型。每采摘一次,你将会向右移动到下一棵树,并继续采摘。
- 一旦你走到某棵树前,但水果不符合篮子的水果类型,那么就必须停止采摘。
给你一个整数数组 fruits ,返回你可以收集的水果的 最大 数目。
简言之:找一最长区域使得区域内的数据的种数为2/1。
为什么使用哈希表 不可以使用三/四指针 因为:难以保证[left]数据弹出的完全性。
class Solution {
public:
    int totalFruit(vector<int>& f) {
        unordered_map<int,int> m;
        int len = 1;
        for(int l = 0, r = 0, count = 0;r < f.size();r++)
        {
            m[f[r]]++;
            if(m[f[r]] == 1) count++;
            while(count > 2)//取消冗余判断 "l < f.size()"
            {
                m[f[l]]--;
                if(m[f[l]] == 0) count--;
                l++;
            }                     //抓核心
            if(count == 2 || m[f[l]] == f.size())  len = r - l + 1 > len? r - l + 1:len;
        }                //bug {1,1}情景下count == 1
        return len;
    }
};
left的单次弹出与哈希表关联。
5.找到字符串子串中所有异位串
给定两个字符串 s 和 p,找到 s 中所有 p 的 异位词 的子串,返回这些子串的起始索引。不考虑答案输出的顺序。
输入: s = "abab", p = "ab"
输出: [0,1,2]
解释:
起始索引等于 0 的子串是 "ab", 它是 "ab" 的异位词。
起始索引等于 1 的子串是 "ba", 它是 "ab" 的异位词。
起始索引等于 2 的子串是 "ab", 它是 "ab" 的异位词。
利用滑动窗口维护区间 哈希表记录 zero记录滑动次数
哈希表、zero:记载完全滑动。
6.串联所有单词的字串(hard)唯一一个第二次写依旧没有写出的
count计数型 不过计数的是单词总的数目
单词种数->总单词数
在了解了思路之后写不出来的原因:
1.未深入理解算法本质 模板套用未完全套用
2.缺失标记量 原有标记量难以实现模板逻辑
3.优化不足(指某个逻辑判断这么做会增大代码逻辑复杂度)
4.打草严格依据r+=len进行单次的l弹出逻辑
给定一个字符串 s 和一个字符串数组 words。 words 中所有字符串 长度相同。
s 中的 串联子串 是指一个包含 words 中所有字符串以任意顺序排列连接起来的子串。
- 例如,如果
words = ["ab","cd","ef"], 那么"abcdef","abefcd","cdabef","cdefab","efabcd", 和"efcdab"都是串联子串。"acdbef"不是串联子串,因为他不是任何words排列的连接。
返回所有串联子串在 s 中的开始索引。你可以以 任意顺序 返回答案。
示例 1:
输入:s = "barfoothefoobarman", words = ["foo","bar"]
输出:[0,9]
解释:因为 words.length == 2 同时 words[i].length == 3,连接的子字符串的长度必须为 6。
子串 "barfoo" 开始位置是 0。它是 words 中以 ["bar","foo"] 顺序排列的连接。
子串 "foobar" 开始位置是 9。它是 words 中以 ["foo","bar"] 顺序排列的连接。
输出顺序无关紧要。返回 [9,0] 也是可以的。
class Solution
{
public:
    vector<int> findSubstring(string s, vector<string>& words)
    {
        map<string, int> m2;
        vector<int> ret;
        for(auto e: words)
        {
            m2[e]++;
        }
        int len = words[0].size();
        for(int i = 0;i < len ;i++)
        {
            map<string, int> m1; //原串纳入
            // for(int l = i, r = i;r <= s.size()-(len*words.size()); r += len)
            for(int l = i, r = i,zero = 0;r < s.size(); r += len)
            {
                //进窗口
                m1[s.substr(r, len)]++;
                if(m1[s.substr(r, len)] <= m2[s.substr(r, len)])//符合条件进入zero++
                    zero++;
                //出窗口 同时维护zero的值
                if(r - l + 1 > len*words.size())
                {
                    //zero更新-- 哈希退出(--) l变动

                    //有效字符的推出
                    if(m1[s.substr(l, len)] <= m2[s.substr(l, len)])
                        zero--;
                    m1[s.substr(l, len)]--;
                    // zero--;//代表有效字符啊
                    l+=len;
                }

                if(zero == words.size()) //长度符合
                    ret.push_back(l);
            }
        }
        return ret;
    }
};7.最小覆盖子串(hard)
需要逻辑优化策略
超出内存限制:
你遇到的内存超限问题,主要原因是 findSubstring 中频繁调用 substr 创建大量临时字符串,结合你给出的极长输入 s(几十万个 'a' 后跟少量字母),导致内存迅速耗尽。
"每轮循环都会调用 substr(r, len) 产生一个新字符串对象。"与"m1 和 m2 的键都是 string 类型,每次插入或查找都会复制该字符串"这些字符串会放在哪里? 它们不会在每个循环/出作用域后销毁吗? 怎么还会占大量内存呢?
string word = s.substr(r, len);  // 发生了什么?
substr 返回的 string 对象内部
栈上:string对象的控制信息(指针、大小、容量)约24-32字节
堆上:实际的字符数据通过 new char[] 分配
关键误区:对象销毁 ≠ 内存立即释放
for(int r = i; r < s.size(); r += len) {
    m1[s.substr(r, len)]++;     // 第1步:创建临时string
                                // 第2步:拷贝到m1的键(又分配一次堆内存)
                                // 第3步:临时string销毁,释放其堆内存

    // 问题:释放的内存通常不会还给操作系统,而是保留在程序的堆池中
}
给定两个字符串 s 和 t,长度分别是 m 和 n,返回 s 中的 最短窗口 子串,使得该子串包含 t 中的每一个字符(包括重复字符)。如果没有这样的子串,返回空字符串 ""。
测试用例保证答案唯一。
示例 1:
输入:s = "ADOBECODEBANC", t = "ABC"
输出:"BANC"
解释:最小覆盖子串 "BANC" 包含来自字符串 t 的 'A'、'B' 和 'C'。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 11
 0
- 0


 已为社区贡献1条内容

所有评论(0)