从零开始的推荐系统学习(一)——召回篇
文章目录
作为一个零基础想要转入搜广推的科班生,写一点东西作为学习的思考,大家共勉。学习参考主要来自 B战@ShusenWang的推荐系统公开课以及互联网大厂推荐算法实战这本书。二者讲的都非常好,强烈推荐作为想入行者的参考。
由于我本人作为某软件工程研一,可谓完全没有AI相关经验,所以本文完全基于我自己通俗的理解,力求只要你稍微有一点DL或者ML基础都可以看懂。如果没有,可以先看看李宏毅或者吴恩达的深度学习入门课程,能让学生对于深度学习的绝大多数领域都有一定了解。
推荐系统基础
通常的,我们将推荐系统分为四个阶段:召回,粗排,精排,重排。
召回的目的是从几亿个物品的数据库中通过多个召回通道过滤出用户可能喜欢的几千个物品,由于召回的候选量过大,往往使用统计学的方法过滤而非神经网络;再通过排序(粗排、精排)过滤出几百个候选项,到排序阶段,数据量较小,可以考虑通过神经网络对物品的特征进行分析来得到精确的推荐结果;重排主要考虑多样性抽样,插入广告,打散顺序等等,负责把最终的结果推送给用户。
召回
推荐系统的召回分为两类,包括DNN出现之前的传统统计学召回算法例如协同过滤、矩阵分解等。下文一二三节进行了简要的介绍;后面的部分是现代召回的主流方法:向量化召回。所谓向量化召回,就是将召回问题建模成向量空间内的近邻搜索问题。
向量化召回的基本步骤如下:
(1)训练一个模型M,将用户Q中的每个实例q和物料T中的每个实例t都映射到同一个向量空间。
(2)将T中几十万、上百万个实例喂入模型M,映射成向量。再把这几十万、上百万个向量灌入Faiss或Milvus这样的向量数据库,建立索引。
(3)在线服务时,对于一个Q类的实例q,通过模型M将其映射成向量 。再在向量数据库中,通过近似最近邻(ANN)搜索算法,查找与 最近的K个T类的邻居向量 。这些邻居向量对应的作为召回结果返回。
最后是序列化召回。协同过滤和向量召回的方法通常将用户的历史行为汇总成一个静态的表示(比如一个向量),然后基于这个表示进行推荐。但是,用户的行为其实是有时间顺序的,而且这个顺序往往包含了重要的信息。
比如,一个用户先浏览了跑鞋,然后看了运动服,接着又看了健身器材,这个顺序告诉我们这个用户可能对健身运动感兴趣。如果我们只是简单地把这些行为加起来或者平均,就丢失了这种时间顺序的信息。
序列召回就是要利用用户行为的时间顺序信息来进行推荐。它的基本想法是:用户的当前兴趣不仅取决于他过去喜欢什么,还取决于他最近在做什么,以及这些行为的顺序。
一、基于物品的协同过滤(ItemCF)
原理:基于物品相似度的推荐,假如A喜欢item1,item2与item1相似,可以认为A很可能也喜欢item2
用户对新
i
t
e
m
item
item的兴趣可以用有交互记录的
i
t
e
m
j
item_j
itemj如下量化:
∑
j
l
i
k
e
(
u
s
e
r
,
i
t
e
m
j
)
∗
s
i
m
(
i
t
e
m
,
i
t
e
m
j
)
\sum_j{like(user, item_j)}*sim(item,item_j)
j∑like(user,itemj)∗sim(item,itemj)
物品相似度的计算
两个物品的受众重合度越高,可认为两个物品越相似;设喜欢
i
1
i_1
i1的用户群体为w1,喜欢i2的用户群体为w2,二者交集
v
=
w
1
∩
w
2
v=w_1\cap w_2
v=w1∩w2,那么则有:
s
i
m
(
i
1
,
i
2
)
=
∣
v
∣
∣
w
1
∣
∗
∣
w
2
∣
sim(i_1,i_2)=\frac{\vert v \vert}{\sqrt{\vert w_1 \vert*\vert w_2 \vert}}
sim(i1,i2)=∣w1∣∗∣w2∣∣v∣
(2)是个简易的公式,并没有考虑到用户对于物品的喜欢程度,如果考虑喜欢程度的话需要使用下面的公式:
sim
(
i
1
,
i
2
)
=
∑
v
∈
V
like
(
v
,
i
1
)
⋅
like
(
v
,
i
2
)
∑
u
1
∈
W
1
like
2
(
u
1
,
i
1
)
⋅
∑
u
2
∈
W
2
like
2
(
u
2
,
i
2
)
\operatorname{sim}\left(i_{1}, i_{2}\right)=\frac{\sum_{v \in \mathcal{V}} \operatorname{like}\left(v, i_{1}\right) \cdot \operatorname{like}\left(v, i_{2}\right)}{\sqrt{\sum_{u_{1} \in \mathcal{W}_{1}} \operatorname{like}^{2}\left(u_{1}, i_{1}\right)} \cdot \sqrt{\sum_{u_{2} \in \mathcal{W}_{2}} \operatorname{like}^{2}\left(u_{2}, i_{2}\right)}}
sim(i1,i2)=∑u1∈W1like2(u1,i1)⋅∑u2∈W2like2(u2,i2)∑v∈Vlike(v,i1)⋅like(v,i2)
其实这就是标准的余弦相似度,物品向量为i1=[like(u1,i1),like(u2,i1),…],代表不同用户对同一物品的喜欢程度
cosine
(
i
1
,
i
2
)
=
i
1
⋅
i
2
∥
i
1
∥
∥
i
2
∥
\text{cosine}(\mathbf{i_1}, \mathbf{i_2}) = \frac{\mathbf{i_1}\cdot\mathbf{i_2}}{\|\mathbf{i_1}\|\|\mathbf{i_2}\|}
cosine(i1,i2)=∥i1∥∥i2∥i1⋅i2
从工程上讲,我们需要离线维护两个索引,以便减少计算量:
- 用户->物品:记录用户最近交互的物品(n)
- 物品->物品:也就是相似度矩阵(可以是一个稀疏矩阵,不需要维护所有的关系,只保留最高k个即可
dict[int,list[int,float]])
线上做召回时只需要根据这两个索引,计算出nk个物品中最可能感兴趣的1000?个物品作为召回结果
二、Swing模型
Swing模型在ItemCF基础上做出了这样的假设:两个物品受众重合度高,并不一定是由于他们相似,而是由于某个小圈子正好同时关注了二者,又或者只是他们太热门导致手中重合。因此需要对相似度计算进行加权,排除小圈子的影响,找到真正本质相似的物品
例如CS2和EVA并不相似,但可能有一个微信群分享了这二者,导致这个小圈子的人都与二者互动。如果系统认为这二者相似,可能会把EVA推荐给喜欢CS2的FPS爱好者,然而事实上这种推荐是没有道理的
我们把喜欢物品I的用户记为
U
i
U_i
Ui,喜欢物品J的用户记为
U
j
U_j
Uj,物品ij修正的相似度如下
s
i
m
(
i
,
j
)
=
∑
u
∈
U
i
∩
U
j
∑
v
∈
U
i
∩
U
j
1
α
+
o
v
e
r
l
a
p
(
u
,
v
)
sim(i, j) = \sum_{u \in U_i \cap U_j} \sum_{v \in U_i \cap U_j} \frac{1}{\alpha + overlap(u,v)}
sim(i,j)=u∈Ui∩Uj∑v∈Ui∩Uj∑α+overlap(u,v)1
其中
o
v
e
r
l
a
p
(
u
,
v
)
=
∣
I
u
∩
I
v
∣
overlap(u,v)=|I_{u} \cap I_{v}|
overlap(u,v)=∣Iu∩Iv∣即为两个用户共同喜欢的物品个数,若重合度过高,则他们可能来自某个圈子,需要降低这些用户的权重;
α
\alpha
α为超参数,需要调节.
三、基于用户的协同过滤(UserCF)
UserCF的原理同样很符合直觉,假设两个用户的喜好相似,其中A喜欢某个物品,而B没有交互记录,那么B很有可能也喜欢这个物品
初学者可能会有这样的疑问,“UserCF认为相似的人喜好相同,但是Swing又认为相似的小圈子需要降低权重,这不是矛盾的嘛?”
然而事实上,这两个方法关注的是不同的东西,Swing还是基于ItemCF的,也就是说它关注的是两个物品是不是真的相似;而UserCF是关注用户是不是喜好相似的。这二者并不矛盾。并且由于是多项式累加,相似度并没有降低,而是增加的幅度变慢,也即降低权重。
具体实现
类似于ItemCF,用户对某个新物品item的喜好程度可以量化为
∑
j
s
i
m
(
u
s
e
r
,
u
s
e
r
j
)
∗
l
i
k
e
(
i
t
e
m
,
u
s
e
r
j
)
\sum_j{sim(user, user_j)}*like(item,user_j)
j∑sim(user,userj)∗like(item,userj)
设
u
1
u_1
u1喜欢的物品集合为
J
1
J_1
J1,
u
2
u_2
u2喜欢的物品集合为
J
2
J_2
J2,二者交集
I
=
J
1
∩
J
2
I=J_1\cap J_2
I=J1∩J2,那么则有:
s
i
m
(
u
1
,
u
2
)
=
∣
I
∣
∣
J
1
∣
∗
∣
J
2
∣
=
∑
l
∈
I
1
∣
J
1
∣
⋅
∣
J
2
∣
sim(u_1,u_2)=\frac{\vert I \vert}{\sqrt{\vert J_1 \vert*\vert J_2 \vert}}=\frac{\sum_{l \in I}1}{\sqrt{|J_1| \cdot |J_2|}}
sim(u1,u2)=∣J1∣∗∣J2∣∣I∣=∣J1∣⋅∣J2∣∑l∈I1
类似于Swing,UserCF也需要对相似度进行加权。很可能存在某些热门物品(例如某些突发的时政新闻),大多数用户都会产生交互,然而这些用户并无相似之处。于是我们需要降低热门物品对相似度贡献的权重:
s
i
m
(
u
1
,
u
2
)
=
∑
l
∈
I
1
log
(
1
+
n
l
)
∣
J
1
∣
⋅
∣
J
2
∣
\mathrm{sim}(u_1, u_2) = \frac{\sum_{l \in I} \frac{1}{\log(1 + n_l)}}{\sqrt{|J_1| \cdot |J_2|}}
sim(u1,u2)=∣J1∣⋅∣J2∣∑l∈Ilog(1+nl)1
其中
n
l
n_l
nl为喜欢物品L的用户个数,反应物品的热门程度。
从工程上讲,与ItemCF正好对偶,我们需要建立两个离线索引:
- 用户->用户:也就是相似度矩阵(稀疏矩阵,记录最相似的k个用户)
- 用户->物品:记录用户最近感兴趣的物品(n)
四、离散特征
特征工程
特征工程在推荐系统中是最重要的部分,对于算法工程师来说,现在End to End 的DNN已经能够自动化提取特征,但是数据挖掘同样很重要,这里暂时按下不表。
Embedding
Embedding是深度学习推荐算法的基石,所谓Embedding就是将高维稀疏的类别特征映射为一个稠密向量。
说人话就是,把userid这种离散的数字转化成一个具体的特征向量
Embedding的概念出自于NLP领域的word2vec,每个word对应一个向量,向量之间还可以运算,例如 北京 − 中国 ≈ 巴黎 − 法国 北京-中国\approx巴黎-法国 北京−中国≈巴黎−法国。类似的我们有item2vec,利用神经网络“无中生有”地将一个Item转化为Vector。
Embedding层参数的大小与类别数量有关,或者说Embedding矩阵与one-hot向量是如下的关系:
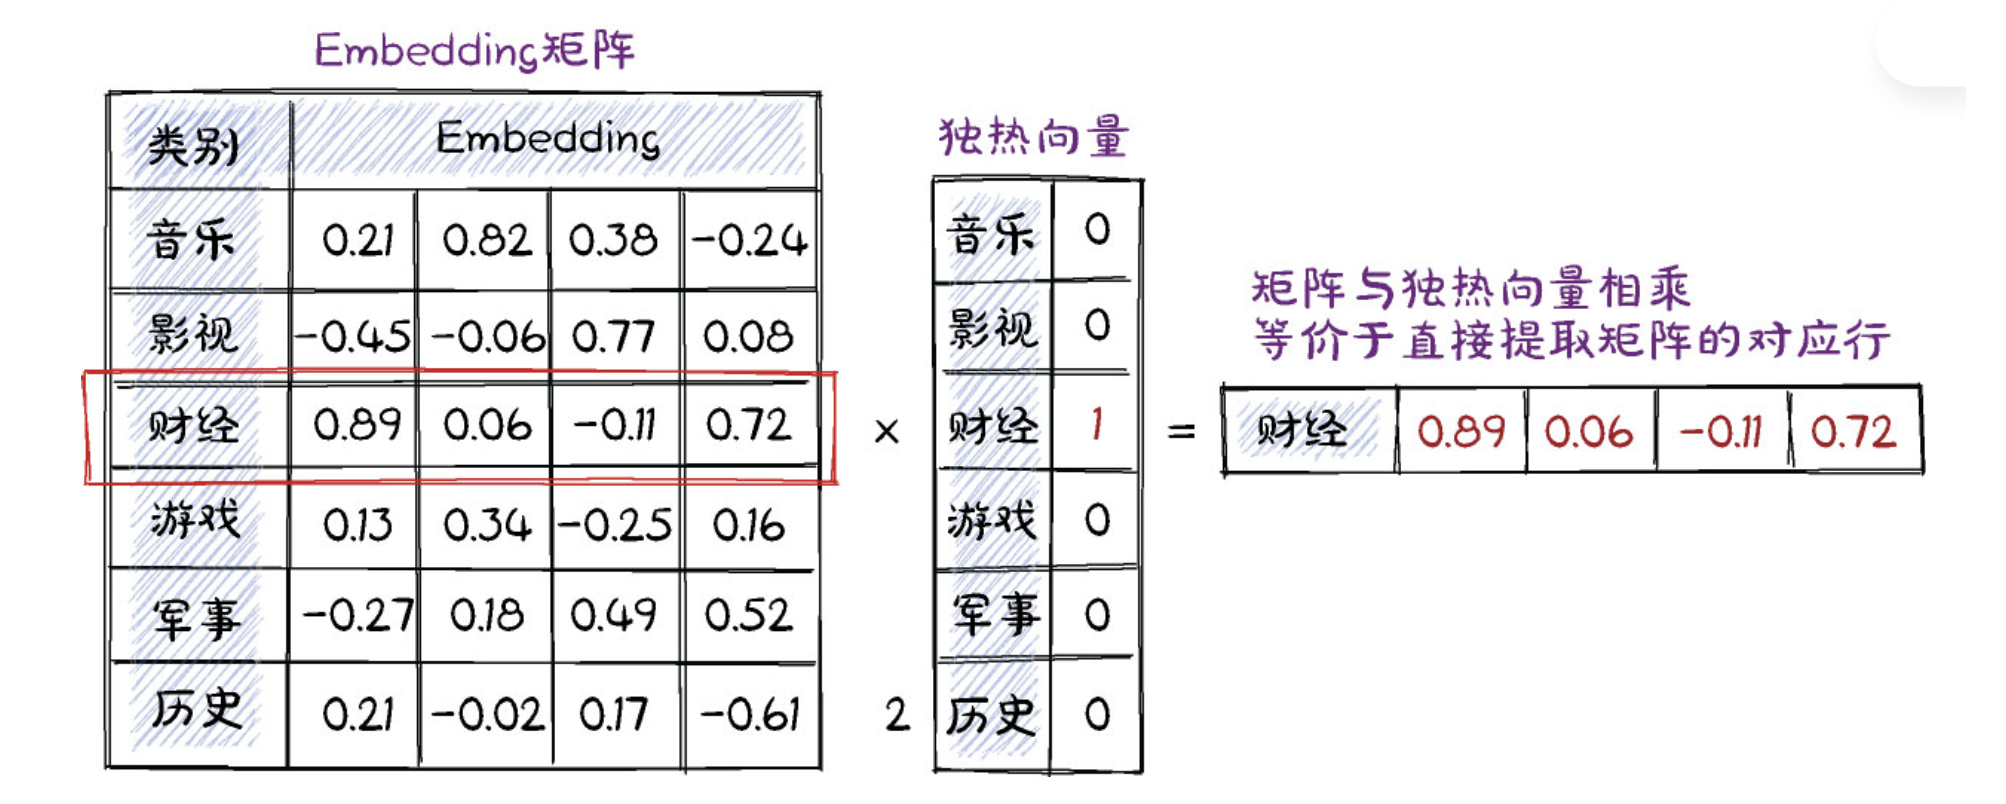
也就是说Embedding层参数书目为:特征向量维数*类别数目。
现代深度学习框架如Pytorch中已经内置了相当好用的Embedding层可以直接调用,使得我们可以轻松得进行SGD来训练。但在这里简要提一个细节:
对于用户ID,物品ID这样极其稀疏的特征,构建一个上亿维的one-hot编码来进行矩阵乘法是完全不合理的,因为实际上这个乘法只是选择embedding矩阵中的某一列提取,所以事实上Pytorch这类框架在前向传播时只是选择对应的几列输出,在反向传播时并不会对整个矩阵计算梯度,而是稀疏更新,只有少数几列参数被修改,其余的列保持不变。
五、双塔模型
模型原理
双塔即用户塔和物品塔,利用用户特征和物品特征来进行推荐的一种模型。用户塔(User Tower专注于理解用户——处理用户的历史行为、人口统计学特征、上下文信息等,最终输出一个代表用户兴趣的向量。物品塔(Item Tower则专精于刻画物品——整合物品的ID、类别、属性、内容特征等,输出一个表征物品特性的向量。最终两者在同一个向量空间中计算相似度比如余弦相似度。
首先来看用户塔和物品塔该怎么设计,以用户特征为例,包含离散的特征(UserID,城市,性别等),低维的特征可以直接使用One-hot编码转化成向量,高维离散特征通过Embedding层转化为向量(注意Embedding是一对一的,一个特征对应一个Embedding层);连续特征经过简单的归一化、分桶等处理即可。最后我们将这些向量和数值拼接起来,最后经过NN(若干全连接层和池化层)组成用户表征向量。
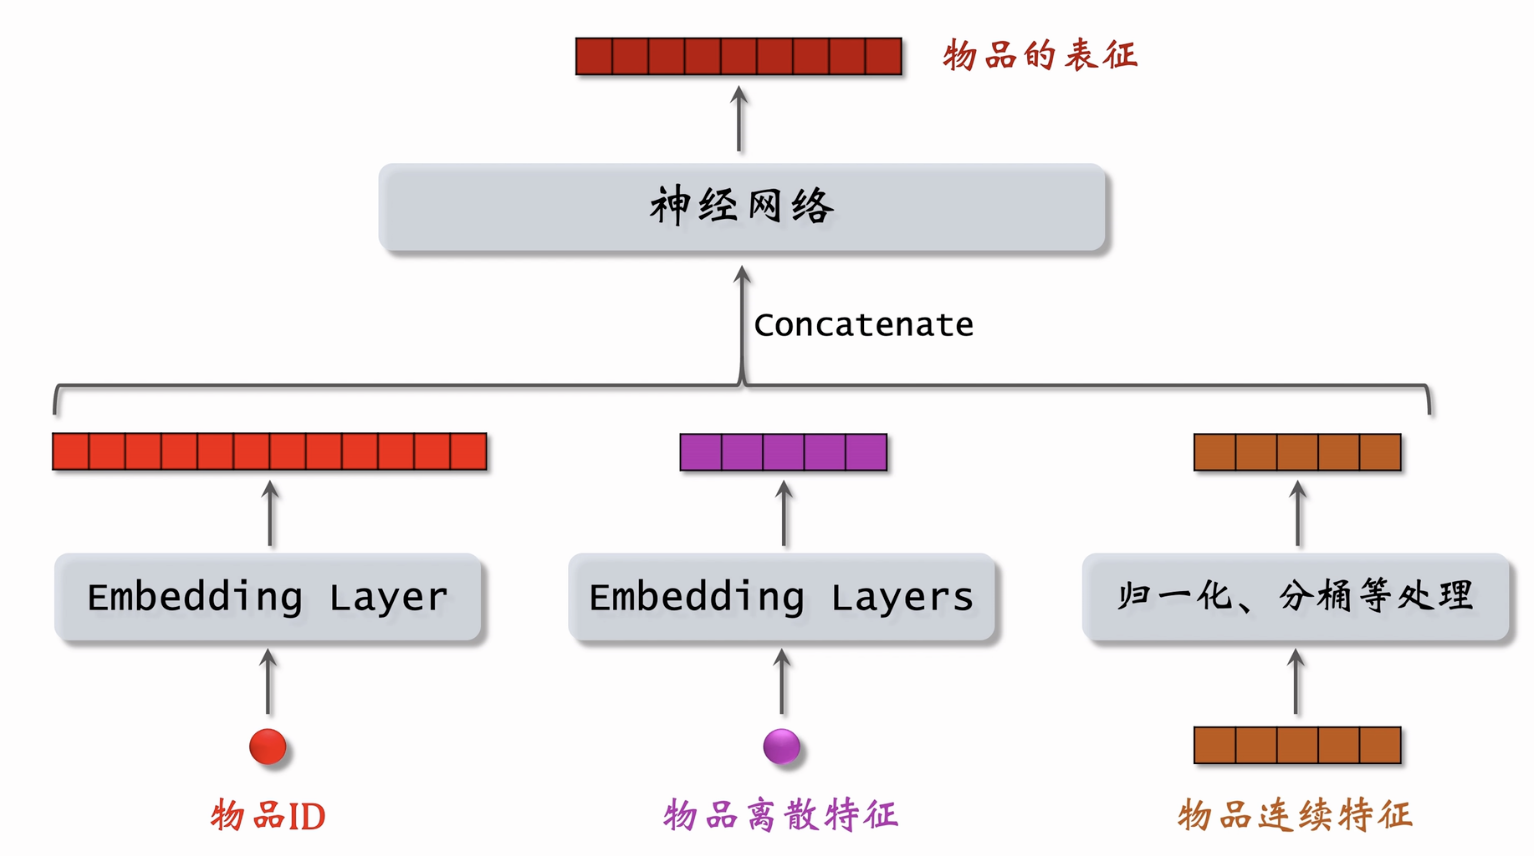
Ps:离散特征值数值大小没有意义的特征,例如UserID,这个数值大小并没有特别的含义;连续特征数值大小有意义,可直接参与计算,比如年龄,但是需要归一化,将分布在25-80岁归一到均值为0,方差为1.
得到两座塔后,便可以根据用户向量和物料向量的余弦相似度来预估兴趣。
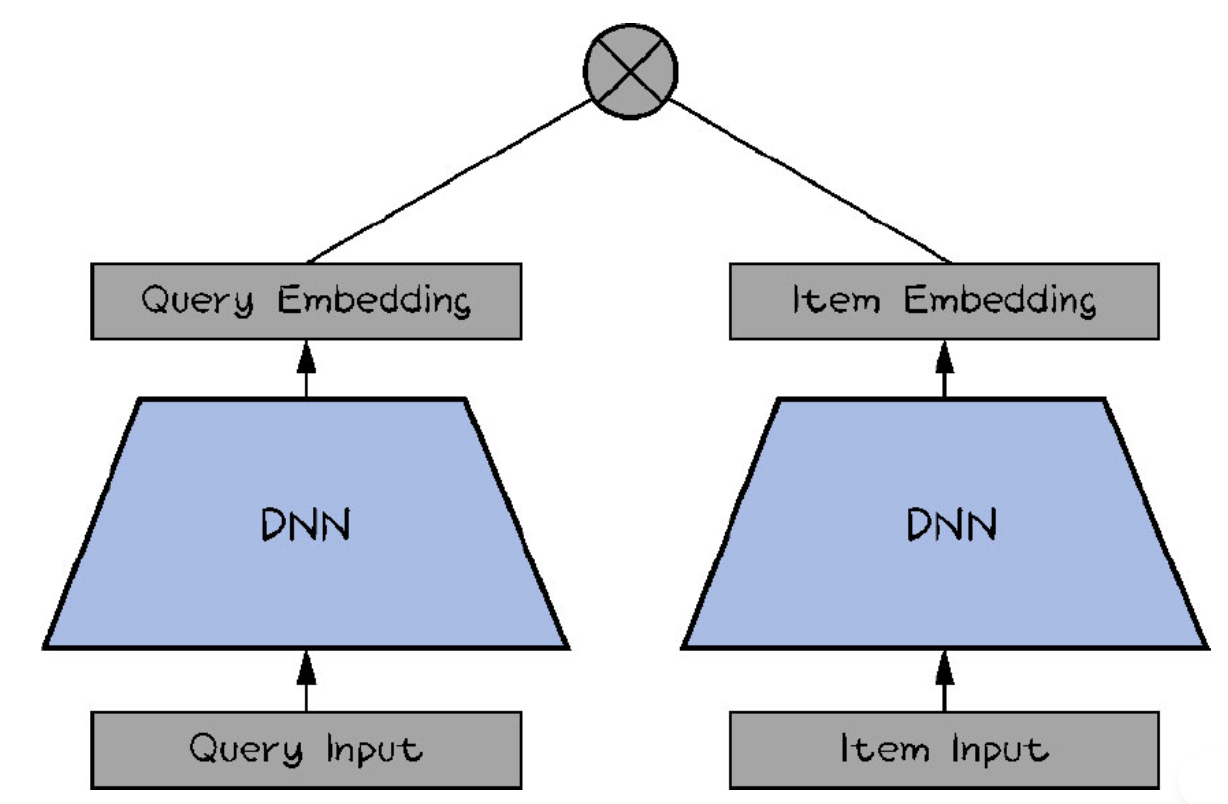
双塔模型的特点在于双,两座塔之间应当是完全解耦的,不允许出现跨塔的信息交流;单座塔的结构具体如何并没有严格的要求,可以很复杂,可以把一座塔理解为一个DNN。
训练方法
双塔模型的训练主要分为三种:
- PointWise:把推荐问题当作 二分类问题,独立看待每个正样本、负样本
- PairWise:每次取一对正负样本
- ListWise:每次取一个正样本,多个负样本
PointWise
把召回看作二元分类任务,对于正样本鼓励 c o s < a , b > cos<a,b> cos<a,b>接近1,负样本鼓励 c o s < a , b > cos<a,b> cos<a,b>接近-1,正负样本数量接近1:2、1:3
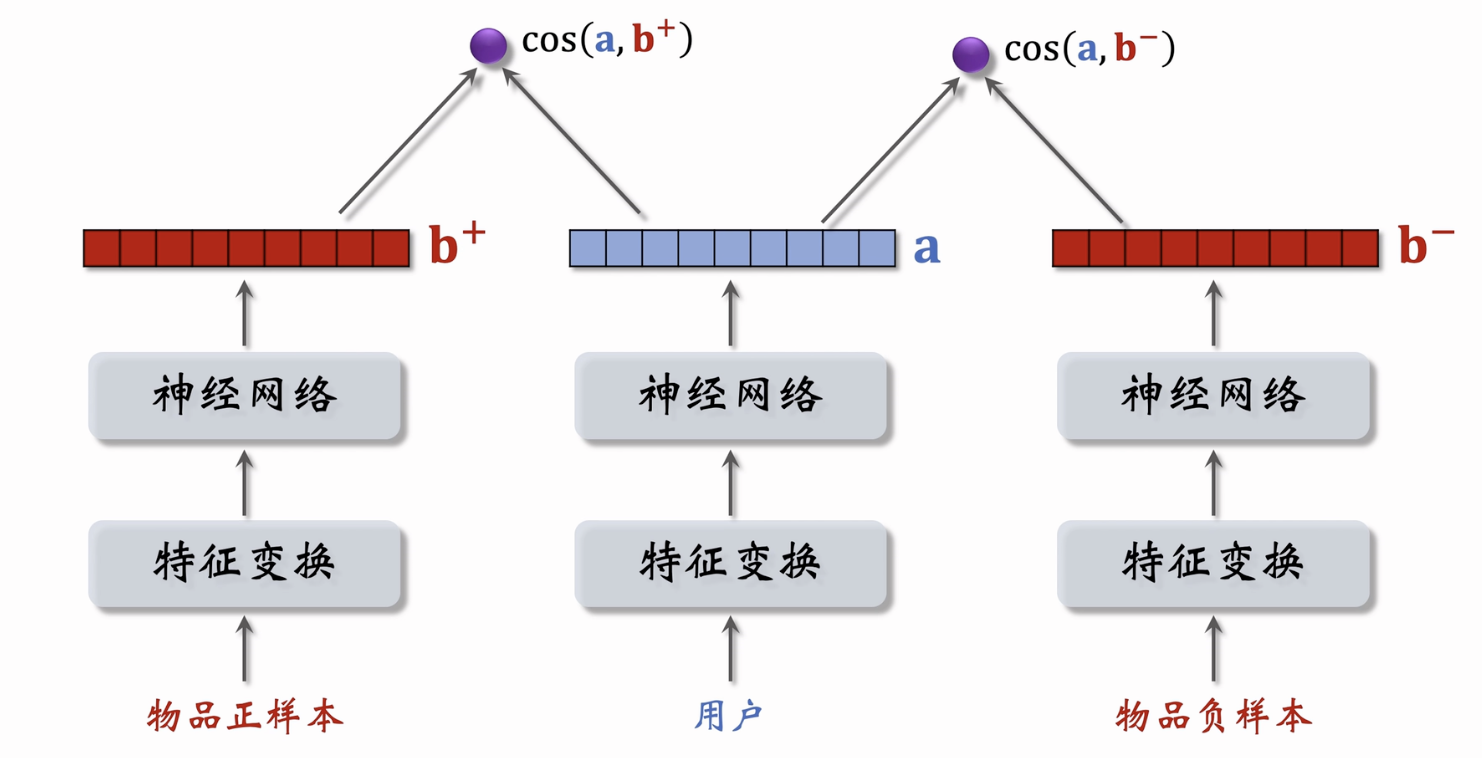
PairWise
每次同时取一个正样本
b
+
b^+
b+和负样本
b
−
b^-
b−,鼓励
c
o
s
<
a
,
b
+
>
cos<a,b^+>
cos<a,b+>大于
c
o
s
<
a
,
b
−
>
cos<a,b^->
cos<a,b−>,于是我们可以定义损失函数为:
L
(
a
,
b
+
,
b
−
)
=
−
m
a
x
(
0
,
c
o
s
<
a
,
b
+
>
−
c
o
s
<
a
,
b
−
>
+
m
)
\mathcal{L}(a,b^+,b^-)=-max(0,cos<a,b^+>-cos<a,b^->+m)
L(a,b+,b−)=−max(0,cos<a,b+>−cos<a,b−>+m)
其中m为超参数,因为我们希望差距越大越好。或者我们可以用logsitic的损失函数:
L
(
a
,
b
+
,
b
−
)
=
−
e
σ
∗
(
c
o
s
<
a
,
b
+
>
−
c
o
s
<
a
,
b
−
>
)
\mathcal{L}(a,b^+,b^-)=-e^{\sigma*(cos<a,b^+>-cos<a,b^->)}
L(a,b+,b−)=−eσ∗(cos<a,b+>−cos<a,b−>)
ListWise
每次取一个正样本,多个负样本,使得模型经过softmax层后输出正样本
i
+
i^+
i+ 的概率
P
(
i
+
∣
u
)
P(i^+|u)
P(i+∣u) 越大越好;负样本
i
−
i^-
i− 的概率越小越好。理想情况下:
P
(
i
+
∣
u
)
=
1
,
P
(
i
−
∣
u
)
=
0
P(i^+|u) = 1, \quad P(i^-|u) = 0
P(i+∣u)=1,P(i−∣u)=0,我们直接使用交叉熵作为损失函数:
L
=
−
∑
i
p
(
i
∣
u
)
log
q
(
i
∣
u
)
L = - \sum_i p(i|u) \log q(i|u)
L=−i∑p(i∣u)logq(i∣u)
因为理想模型只在正样本上为 1,所以公式简化为:
C
r
o
s
s
E
n
t
r
o
p
y
L
o
s
s
(
y
i
,
p
i
)
=
−
log
p
i
,
i
=
−
log
(
exp
(
cos
(
a
i
,
b
i
)
)
∑
j
=
1
n
exp
(
cos
(
a
i
,
b
j
)
)
)
\mathrm{CrossEntropyLoss}(\mathbf{y}_{i}, \mathbf{p}_{i}) = - \log p_{i,i} = - \log \left( \frac{\exp(\cos(\mathbf{a}_{i}, \mathbf{b}_{i}))}{\sum_{j=1}^{n} \exp(\cos(\mathbf{a}_{i}, \mathbf{b}_{j}))} \right)
CrossEntropyLoss(yi,pi)=−logpi,i=−log(∑j=1nexp(cos(ai,bj))exp(cos(ai,bi)))
当然损失函数还有很多,我们最后再来讨论常用的损失函数以及应用场景
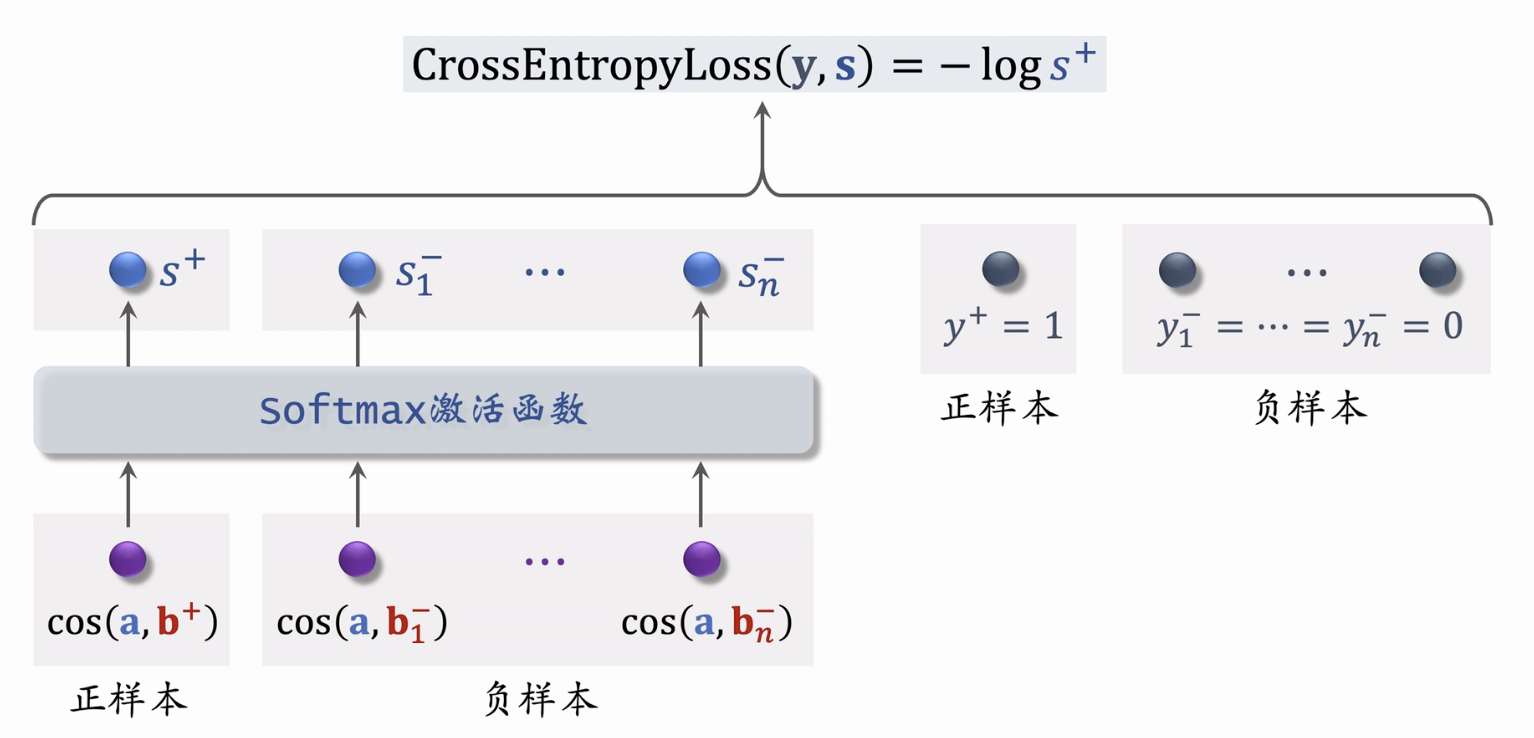
事实上,使用softmax来做多分类是召回阶段最主流的做法,Youtube DNN、MIND、YouTube Top K RL召回在训练时都将问题建模为类别数为物品库容量的超大规模多分类问题,而排序阶段模型如DIN等的输出多是sigmoid或softmax(2)激活的二分类问题。
原因或许在于召回阶段主要是希望能够快速过滤掉不相关的物料,listwise能够快速地拉开正负样本之间的差距。
正负样本的选择
正样本:曝光且有点击的物料(用户明确感兴趣的)。
正样本的选择不怎么容易出错,我们只需要注意降低热门物品的权重,欠采样热门物品,过采样冷门物品即可。
负样本的选择大有门道,首先我们要明白召回阶段的目的——在上亿候选集中过滤掉用户明显不感兴趣的内容,负样本应该是不感兴趣的物品,并且应该广泛使得模型达到“开眼界”的效果。
先来看一个常见的八股:为什么不能只选择曝光未点击作为召回阶段负样本?
因为曝光的样本已经是经过优中选优的样本了,这就带来data dismatch的问题,这些物料并不是用户明显不喜欢的物料,也就是样本选择偏差问题。相反,几亿条物料中大部分都是用户不会感兴趣的,随机采样用作负样本才能让模型“长见识”。
当然,需要强调的是“只”字,在另外一些实践中,“曝光未点击”样本也可能认为是认为是Hard Negative(下面会讲到),能够提升模型对细节的分辨能力。具体效果如何与实践有关,工业界对此没有统一的态度。
那么具体该如何选择呢?
Easy Negative(简单负样本)
简单负样本主要来自随机抽样,但是要考虑冷门物品的长尾效应。热门物品只占很小一部分,也就是说负样本中大部分都是冷门物品,导致模型很容易产生冷门物品就是负样本的偏见。也就是说在负样本中应当过采样热门物品,或者说将选取概率与曝光率成正相关。
In-Batch负采样
在用户空间足够大的情况下,我们可以做出这样的假设:用户只会和极少部分物品交互,用户数目足够多, batch 足够大并且这些用户来自不同兴趣群体,那么当前 batch 中,其他用户喜欢的物品,大概率不是我喜欢的物品。因为其他用户的正样本≈ 随机抽样的物品,可以用来当作负样本,并且符合真实分布,解决了长尾效应。
但是这里存在一个矫枉过正的问题,交互物品大概率会是热门物品,导致负样本中都是热门物品,导致召回结果全是小众宝藏。常见的做法是训练时预估物品兴趣时引入惩罚项 − log P i -\log{P_i} −logPi(P_i为物品被抽样的概率,召回时不需要这个惩罚项)。具体可以查看Youtube的这篇论文Sampling-bias-corrected neural modeling for large corpus item recommendations
Hard Negative(困难负样本)
简单负样本的问题在于,随机负样本都与正样本相差太大,如果全部使用简单负样本,模型很容易偷懒认为只需要分辨粗粒度的差别就够了,没有动力注意细节。因此我们需要加上一些困难的样本,例如被召回的但是没有进入排序阶段的样本,至于曝光未点击的样本由于太过接近流程末端,一般效果还是比较鸡肋。
注意在数量上,负样本还是应该以Easy Negative为主,Facebook的经验是将比例维持在Easy:Hard=100:1。
双塔模型的召回
训练好模型后,双塔模型可以通过各自的网络(tower),把不同模态的数据映射到同一个隐空间,模型学会了让:喜欢item的用户向量接近;不喜欢 item 的用户向量远离。
通常离线时通过训练好的网络把物料特征离线全部计算出来,保存到向量数据库中(如Faiss、HnswLib等)并建立索引加速查找,线上实时根据用户画像计算出用户向量a,用a作为query调用向量数据库做最近邻查找,返回TopK作为召回结果。
模型更新
全量更新:在先前模型的基础上(不是重新从零训练模型)利用最近一段时间(天/周级别)的数据更新整个MLP
增量更新:用户兴趣会实时变化,实时收集数据做流式处理(分钟/小时级别),对模型做online learning,锁住全连接层,只更新UserID Embedding
注意:全量更新不会使用增量更新的模型训练,可以这么理解,全量更新相当于1.0->2.0这样的更新,增量更新是因为用户使用产品的时候可能现在想看游戏,一会又想看美女,需要进行实时的微调,相当于1.0->1.1这样的补丁;所以2.0是基于1.0更新的而不是1.13.
Q:能不能只做增量更新?
A:不能,短时间的数据一定会是有偏差的,不能代表用户整体的画像
Q:为什么增量更新需要锁住全连接层,不都要进行一次完整的反向传播么?
A:可以从两个方向考虑。
一是代价:Embedding层有几亿个参数,全连接层可能只有几千几百万参数,看似开销差不多,但是注意我们前面提及的Embedding层的稀疏更新,一个Epoch只有几千个用户 → embedding 层只更新几千行,但如果你更新 MLP,就得反向传播+更新所有权重矩阵(每次几百万参数同步);
二是意义:明确增量更新的意义只是捕获用户当前兴趣的关注点,这是一个即时的易变的不稳定的数据,如果你拿这种“短期偏样本”去更新 MLP 层,梯度方向会剧烈波动,模型会出现“遗忘旧规律”、“追热点”等问题。这就是增量学习中常见的 catastrophic forgetting(灾难性遗忘)。
六、其它召回通道
我们还可以根据某些标签建立倒排的索引,比如,关注的作者,地理位置,可能感兴趣的人等等
还有缓存召回,把之前精排通过的但是没有曝光的缓存起来作为一条召回通道,当然也需要一些LRU或者过期的机制处理缓存
七、曝光过滤
如果用户看过某些物料,则不再把这些物料曝光给该用户。一般需要记录一个月左右的曝光记录,如果将召回物品一个个比较需要O(nr)的时间复杂度,并且需要消耗很多的内存来存储信息,我们通常使用bloom filter的方法。
Bloom Filter的宗旨是“宁可错杀,不可放过”,使用一个m维的二进制向量bit,对每个物料使用k个Hash函数映射出k个值,检查k个bit[i]是否为1,并置1;若k个位置的值都是1,认为该物料可能曝光过;反之认为该物料一定没曝光过。
Bloom Filter 的关键性能指标是 误判率(False Positive Rate, FPR)。
记:
- m = bit 数组长度
- n = 插入的元素数量
- k = 哈希函数个数
插入一个元素时,每次哈希将一个 bit 置 1。
若假设哈希均匀独立,则一个 bit 被置 1 的概率为:
p
=
1
−
(
1
−
1
m
)
k
n
≈
1
−
e
−
k
n
/
m
p = 1 - \left(1 - \frac{1}{m}\right)^{kn} \approx 1 - e^{-kn/m}
p=1−(1−m1)kn≈1−e−kn/m
对一个查询元素,若它不在集合中,则每个 hash 命中的位置被置 1 的概率都是 p,
所有 k 个位置都为 1 的概率(即误判概率)为:
FPR
=
p
k
=
(
1
−
e
−
k
n
/
m
)
k
\text{FPR} = p^k = \left(1 - e^{-kn/m}\right)^k
FPR=pk=(1−e−kn/m)k
为了让 FPR 最小,可以对 k 求导,得到最优值:
k
=
m
n
ln
2
k = \frac{m}{n} \ln 2
k=nmln2
此时最小误判率为:
FPR
m
i
n
=
(
1
2
)
k
\text{FPR}_{min} = \left( \frac{1}{2} \right)^k
FPRmin=(21)k
bloom filter有个显而易见的问题,只支持插入,不支持删除;工业中完全没有必要记录用户所有的交互集合,而是只用记录最近一个月的,这种情况下我们可以考虑如下方法:
多层 Bloom Filter(Sliding Bloom Filter)
思路:用多个 Bloom Filter 来表示不同时间段的数据。
假设我们只关心最近 30 天的曝光记录,可以这样做:
| 时间段 | 过滤器 |
|---|---|
| 最近 0–10 天 | BF_A |
| 最近 10–20 天 | BF_B |
| 最近 20–30 天 | BF_C |
- 每天轮转一次;
- 查询时同时查 3 个 filter;
- 超过 30 天的 Bloom Filter 丢弃并重建。
优点:简单稳定,容易实现(只维护少量 Bloom Filter 实例);
缺点:时间粒度有限,切换瞬间可能略有误差。
Time-decayed Bloom Filter(时间衰减 Bloom Filter)
思路:在 Bloom Filter 的 bit 上附加时间衰减信息。
例如:每个 bit 不再是 1/0,而是记录“上次被设置的时间戳”;查询时:如果时间差 > 阈值,就当作 0;
这种方案的好处是:
- 不需要多个 Bloom Filter;
- 自然支持滑动时间窗口。
缺点:实现复杂;空间占用比普通 Bloom Filter 大(因为要记录时间戳)。
Stable Bloom Filter(稳定布隆过滤器)
论文:Deng & Rafiei, 2006: “Approximately Detecting Duplicates for Streaming Data Using Stable Bloom Filters”
核心思想:
控制 Bloom Filter 的“填满率”,当 bit 位太多被置 1 时,就随机清除一部分位。
即:
- 每插入一个新元素,就随机选择一部分位置清零;
- 从而保持“稳定的误判率”。
特点:不需要显式删除;“旧数据”会自然被遗忘。非常适合持续流式数据(如推荐曝光流、日志流)。但这显然违背了”不可放过“的原则,导致一些被曝光过的还是判定为未曝光。
写在最后
以上介绍了主流且为大厂主力的模型,还有一些模型例如序列式的DIN,既可以用作召回也可以用作排序;还有生成式召回的TIGER;端到端(即省略中间召回排序步骤,直接生成推荐结果)的OneRec等等。这些模型由于涉及较多DL的内容,我会在后续开设单独的篇章来介绍。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 49
 0
- 0


 已为社区贡献2条内容

所有评论(0)