悲观锁、乐观锁与分布式锁(Lua、Redisson、WatchDog、multiLock)深度解析
在数字化时代,高并发场景无处不在——电商秒杀时的库存争抢、社交平台的消息推送、金融系统的资金交易,都离不开对共享资源的高效管控。而“锁”作为并发编程的核心技术,正是解决资源竞争、保障数据一致性的关键。从单机并发到分布式集群,锁的形态也随之演进,衍生出悲观锁、乐观锁与分布式锁三大核心机制。今天,我们就逐一拆解这三大锁的本质,理清它们的适用场景与实战要点。
一、单机并发的“保守派”:悲观锁
默认认为每次操作共享资源时,必然会发生并发冲突。因此,在操作资源前会先“上锁”,彻底阻断其他线程的访问,直到自身操作完成并释放锁,其他线程才能继续执行。这种思路类似日常生活中使用公共储物柜:开门后先锁上柜门,操作物品期间绝不允许他人干扰,本质是“先保障安全,再执行操作”。
1.1 核心特性与适用场景
悲观锁这种“小心翼翼”的性格,决定了它有两个最明显的特点:一是数据肯定不会乱(强一致性),二是同一时间能处理的操作不算多(低并发效率)。什么时候该用它,其实很好判断:要是你的业务里,改数据的操作特别多,而且很多人会同时改同一个数据(比如抢同一商品),那用悲观锁就对了,能最大程度避免数据搞混。比如:
- 电商系统的库存扣减:秒杀活动中,成千上万的用户同时抢购同一商品,库存数据的准确性直接影响交易成败,冲突概率极高,必须用悲观锁严格管控。
- 金融系统的转账业务:用户A向用户B转账时,需先扣减A的余额再增加B的余额,整个过程必须原子化,不允许其他线程插入操作,否则可能出现余额异常。
1.2 常见实现方式
1.2.1 数据库层面:行锁/表锁
这是开发里最常用的悲观锁用法。拿大家熟悉的MySQL数据库(InnoDB引擎)来说,比如你要改某件商品的库存,执行
SELECT 库存 FROM 商品表 WHERE 商品ID=1001 FOR UPDATE,这句代码就相当于给“商品ID=1001”这一行数据上了把“专属锁”——别人想改这行的库存、价格都得等着,直到你改完并确认(事务提交),或者放弃修改(事务回滚),这把锁才会打开。但这里有个超容易踩的坑(举例):如果你的查询条件没用到“索引”(可以理解为数据库的“快速查找目录”),比如你查“商品名称=智能手机”,但没给“商品名称”建索引,数据库就没法快速定位到具体哪一行,只能把整个“商品表”都锁了。这时候不管是改“智能手机”还是“平板电脑”的库存,所有人都得排队,系统处理速度会一下子变慢,这就是没建索引导致的麻烦。
1.2.2 synchronized关键字
作为Java内置的悲观锁,synchronized 无需手动管理锁的生命周期。当线程进入被修饰的方法或代码块时,会自动获取对象锁,其他线程只能阻塞等待。它的优势是简单易用,JVM会自动优化锁升级(从偏向锁到轻量级锁再到重量级锁),适配不同并发场景。
以下代码是单机秒杀优惠券的核心实现,核心解决 “库存超卖” 和 “一人一单” 两个秒杀核心问题,同时用到了synchronized悲观锁保证并发安全。
public Result seckillVoucher(Long voucherId) {
        //1.查询优惠劵信息
        SeckillVoucher voucher = seckillVoucherService.getById(voucherId);
        //2.判断秒杀是否开始
        if (voucher.getBeginTime().isAfter(LocalDateTime.now())) {
            return Result.fail("秒杀尚未开始!");
        }
        //3.判断优惠劵是否结束
        if (voucher.getEndTime().isBefore(LocalDateTime.now())) {
            return Result.fail("秒杀已经结束!");
        }
        //4.判断库存是否充足
        if (voucher.getStock() < 1) {
            //库存不足
            return Result.fail("库存不足!");
        }
        //5.扣减库存
        boolean success = seckillVoucherService.update().setSql("stock = stock - 1")
                .eq("voucher_id",voucherId)
                .gt("stock",0)
                .update();
        if (!success){
            return Result.fail("库存不足!");
        }
        Long userId = UserHolder.getUser().getId();
        synchronized (userId.toString().intern()) {
            //拿到当前对象的代理对象(事务)
            IVoucherOrderService proxy = (IVoucherOrderService)AopContext.currentProxy();
            return proxy.createVoucherOrder(voucherId);
        }
    }

    @Transactional
    public Result createVoucherOrder(Long voucherId) {
        //一人一单
        Long userId = UserHolder.getUser().getId();

        int count = query().eq("user_id", userId).eq("voucher_id", voucherId).count();
        if (count > 0) {
            //用户已经购买过了
            return Result.fail("用户已经购买过了");
        }
        //6.创建订单
        VoucherOrder voucherOrder = new VoucherOrder();
        long orderId = redisIdWorker.nextId("order");
        voucherOrder.setId(orderId);
        voucherOrder.setUserId(userId);
        voucherOrder.setVoucherId(voucherId);
        save(voucherOrder);
        //7.返回订单id
        return Result.ok(orderId);
    }
}
部分代码解释:
synchronized (userId.toString().intern()):给 “当前用户 ID” 加锁,不是给整个方法加锁!作用:只限制同一用户并发秒杀(防止一人多单),不同用户可以同时秒杀(不影响并发性能)。AopContext.currentProxy():获取当前服务的代理对象(因为createVoucherOrder加了@Transactional事务,代理对象才能保证事务生效)。- 调用
createVoucherOrder创建订单(把下单逻辑抽离,保证事务完整性)。
1.2.3 ReentrantLock
这是Java并发包提供的可重入悲观锁,相比synchronized更灵活:支持尝试获取tryLock()、可中断获取锁、设置锁超时时间等。但需手动通过lock()和unlock()管理,且必须在finally块中释放锁,避免死锁。
import java.util.concurrent.locks.ReentrantLock;
public class SeckillService {
    //初始化ReentrantLock,默认非公平锁(可传true设为公平锁)
    private final ReentrantLock lock = new ReentrantLock();
    //模拟库存
    private int stock = 100;
    //秒杀扣减库存方法
    public boolean deductStock() {
        //1.尝试获取锁,设置3秒超时(避免无限等待)
        try {
            //tryLock返回boolean:成功获取返回true,超时返回false
            if(lock.tryLock(3, TimeUnit.SECONDS)) {
                //2.成功获取锁,执行业务逻辑
                if(stock > 0) {
                    stock--;
                    System.out.println("扣减成功,剩余库存:" + stock);
                    return true;
                }else{
                    System.out.println("库存不足");
                    return false;
                }
            }else{
                //3.超时未获取到锁,返回失败(避免线程阻塞)
                System.out.println("获取锁超时,秒杀失败");
                return false;
            }
        }catch(InterruptedException e) {
            //4.支持中断:当线程被中断时响应,避免死等
            System.out.println("线程被中断,秒杀失败");
            //Thread.currentThread().interrupt(); 就是重新把线程的 “中断标识” 设为 “被中断” 状态,让线程的整个生命周期都能正确感知到 “曾被中断” 的信号,保证中断响应的连贯性。
            Thread.currentThread().interrupt(); // 恢复中断标识
            return false;
        }finally{
            //5.必须在finally中释放锁,确保异常时也能释放
            //isHeldByCurrentThread()判断当前线程是否持有锁,确保安全释放,规避死锁风险
            if(lock.isHeldByCurrentThread()){
                lock.unlock();
            }
        }
    }
}
这里举个例子说一下 Thread.currentThread().interrupt();
比如你在排队(线程阻塞),有人拍你肩膀(中断):
- 你回头看(抛出
InterruptedException),此时 JVM 会默认 “你已经处理了中断”,把 “被拍过” 的标记擦掉;- 但你可能需要告诉后续同事 “我刚才被打扰了”(恢复标识),让后续流程(比如停止后续工作)能感知到这个状态。
1.3 优缺点总结
优点:理解和使用都很简单,就像用锁锁门一样直接,能百分百保证操作过程中数据不会乱;尤其在很多人同时改同一个数据时,表现很稳定,不会出现反复重试改数据的情况。
缺点:大家都要抢同一把锁,没抢到的就得排队等着(线程阻塞),频繁排队切换会拖慢系统速度;而且如果多个线程互相拿着对方要的锁不放,还会出现“死锁”,导致谁都没法继续操作,得专门设计办法避免。
二、单机并发的“激进派”:乐观锁
默认并发操作不会发生冲突,因此操作资源前不上锁,直接执行业务逻辑,仅在提交数据时校验“这段时间内资源是否被其他线程修改”。若未被修改则提交成功;若已被修改则触发重试或返回失败。
2.1 核心特性与适用场景
乐观锁最明显的特点是:不用锁也能让多个操作同时进行,查数据的时候速度特别快。它的适用场景和悲观锁正好反过来:主要是查数据的操作多,改数据的操作少,很少出现大家抢着改同一个数据的情况。乐观锁查数据的核心是 “为后续修改做准备”—— 读数据时同步获取版本号 / 时间戳,修改时校验 “读 - 改” 过程中数据是否被篡改,而非单纯为了 “读” 而用。常见的例子有:
电商商品详情页:100个用户里99个都是看看图片和介绍,只有1个会下单改库存,抢着改的情况几乎没有,用乐观锁就不会因为锁的问题拖慢大家看页面的速度。
用户个人资料管理:咱们平时大多是看自己的昵称、头像,很少去修改,这种“多看少改”的情况用乐观锁就很合适。
文章阅读统计:一篇文章可能有几千人看,但编辑修改的次数很少,用乐观锁统计阅读量,能让更多人同时流畅阅读。
2.2 常见实现方法
乐观锁不用依赖底层的锁机制,而是靠业务逻辑设计出来的,常用的有两种方法:
2.2.1 版本号法
这是最常用的方法。简单说就是在数据库的表里面加一个“版本号”字段,比如叫version,一开始值是1。操作的时候分三步:① 查数据的时候,把这个版本号一起查出来(比如查用户信息时,不光查昵称、ID,还查版本号);② 改数据的时候,要带上刚才查到的版本号当条件(比如改昵称时,加上“版本号等于1”这个条件,同时把版本号改成2);③ 改完之后看有没有改成功:如果说“影响了1行数据”,就说明没人动过;如果说“影响了0行”,就说明有人改了,得重新查数据再试一次。
核心逻辑:查询时获取版本号,修改时用“WHERE 版本号=查询到的版本号”做条件,同时将版本号+1。若有其他线程先修改,版本号已变化,当前修改会失败,通过重试机制解决冲突,适合读多写少场景。
2.2.2 CAS法(比较并替换)
这是硬件层面支持的一种原子操作,简单理解就是“先比后换”。它有三个关键信息:要改的数据在哪(内存地址)、我认为这个数据现在的值是多少(预期值)、我想把它改成什么(新值)。操作逻辑就是:“看看那个地址里的数据是不是我认为的预期值,如果是,就改成新值,算成功;不是的话就不改,算失败”。Java里的AtomicInteger这些类就是用了这个方法,比如给数字自增1的时候,不用锁也能保证不会算错。
//扣减库存
boolean success = seckillVoucherService.update().setSql("stock = stock - 1")
                .eq("voucher_id",voucherId)
                .gt("stock",0)
                .update();
if (!success){
   return Result.fail("库存不足!");
}比较条件:
.gt("stock", 0),这是CAS的"Compare"部分交换操作:
.setSql("stock = stock - 1"),这是CAS的"Swap"部分原子执行:整个
update()操作 ,数据库保证原子性
底层生成的SQL:
UPDATE seckill_voucher
SET stock = stock - 1
WHERE voucher_id = 123 AND stock > 0;  -- 这就是CAS!
2.3 优缺点总结
优点:无锁竞争,线程无需阻塞,并发性能极高;不存在死锁风险,实现灵活。
缺点:如果很多人同时改同一个数据(冲突多),会反复重试改数据,白白浪费电脑CPU资源;有个“ABA坑”——数据先被改成B又改回A,会误以为没动过,得额外想办法防;只能在单台服务器上用,多台服务器集群就管不住了。
三、分布式集群的“守护者”:分布式锁
随着业务增长,单机系统逐渐演进为分布式集群,此时悲观锁和乐观锁就“失灵”了——它们仅能管控单个JVM或数据库实例内的并发,无法跨节点同步锁状态。例如:集群部署的电商系统中,两个节点同时处理同一商品的库存扣减,单机锁无法感知对方的操作,必然导致库存超卖。而分布式锁的核心价值,就是在分布式环境中实现跨节点的共享资源互斥访问。
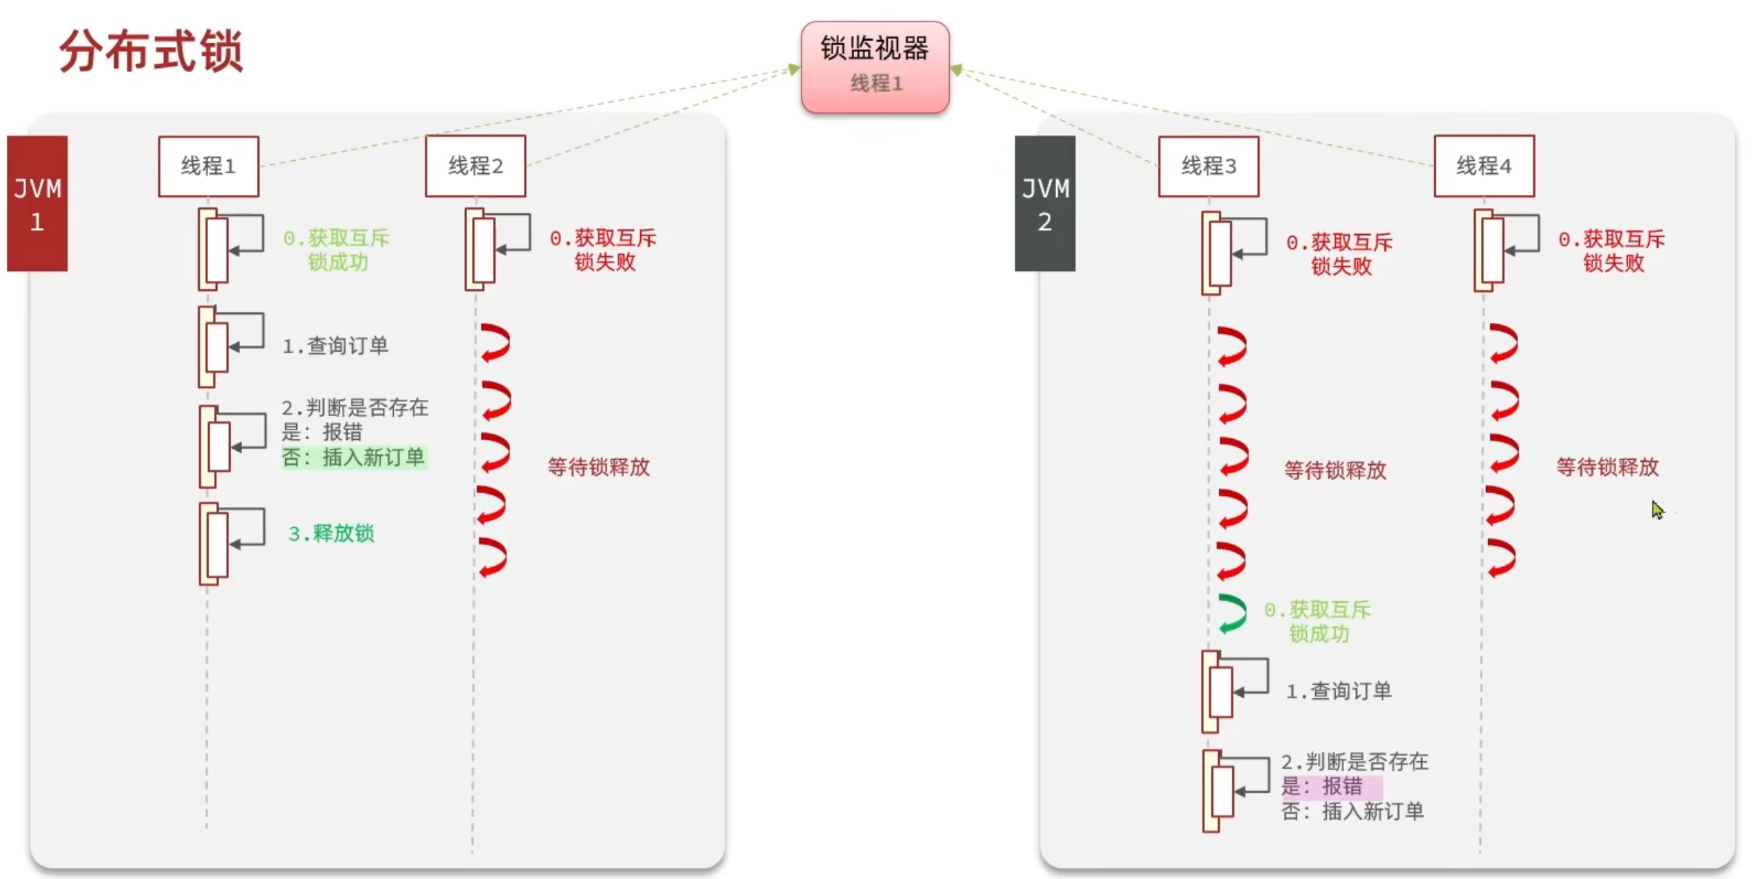
那么什么是分布式锁?
分布式锁:满足分布式系统或集群模式下多进程可见并且互斥的锁。
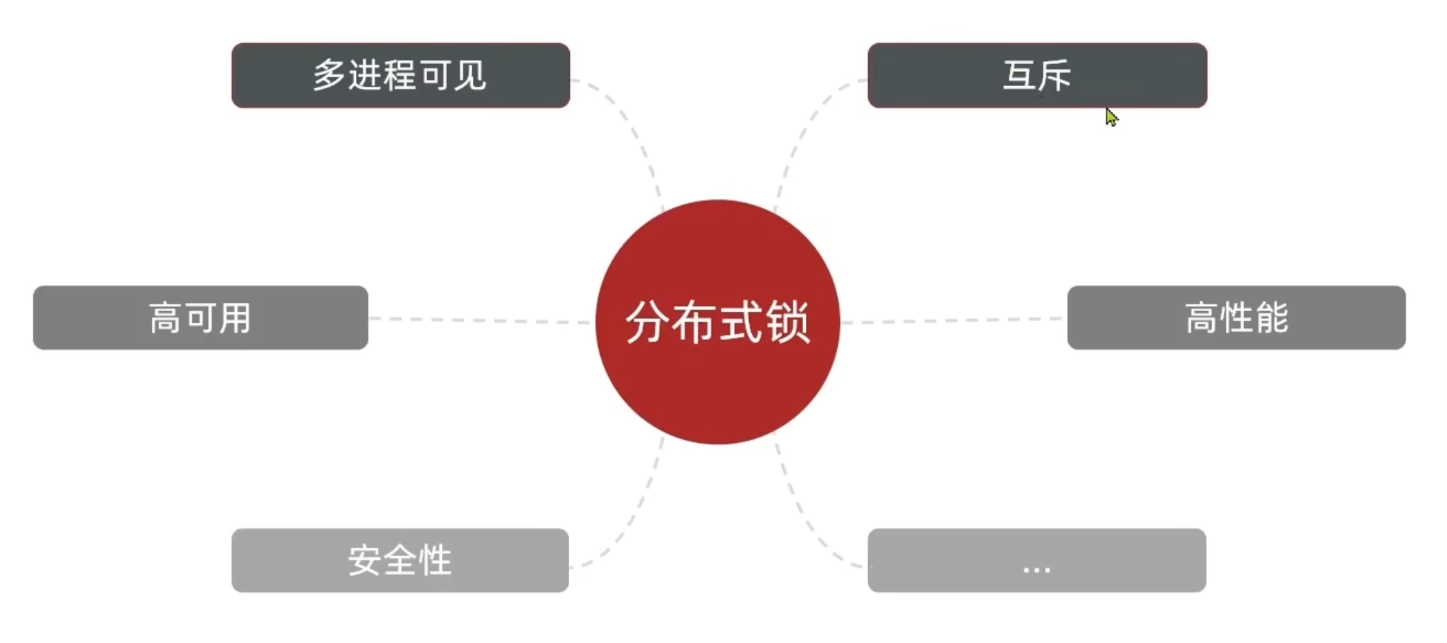
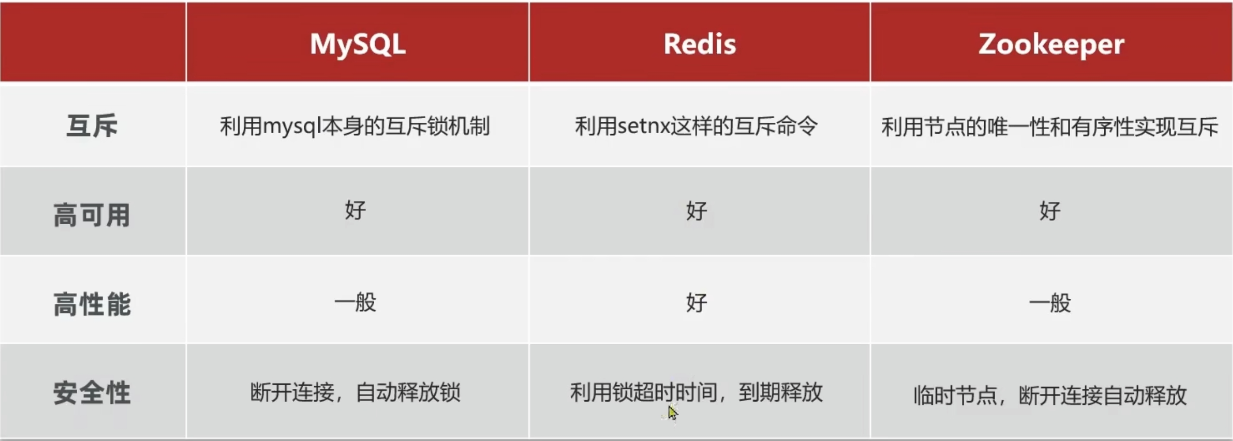
3.1 分布式锁的实现
分布式锁的核心是实现多进程之间互斥,而满足这一点的方式有很多,常见的有三种:
3.2 基于Redis的分布式锁
实现分布式锁时需要实现的两个基本方法:
1.获取锁:
- 互斥:确保只能有一个线程获取锁
- 非阻塞:尝试一次,成功返回true,失败返回false
# 添加锁,NX是互斥,EX是设置超时时间
SET lock thread1 NX EX 10
2.释放锁:
- 手动释放
- 超时释放:获取锁时添加一个超时时间
# 释放锁,删除即可
DEL key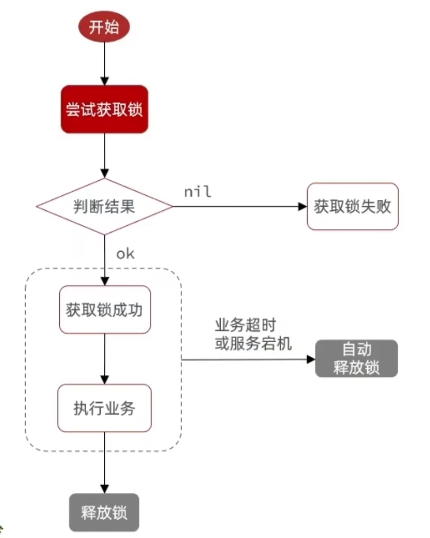
案例:基于Redis实现分布式锁初级版本
需求:定义一个类,实现下面接口,利用Redis实现分布式锁功能
public interface ILock {
    /**
     * 尝试获取锁
     * @param timeoutSec 锁持有的超时时间,过期后自动释放
     * @return true代表获取锁成功;false代表获取锁失败
     */
    boolean tryLock(long timeoutSec);

    /**
     * 释放锁
     */
    void unlock();
}
接口实现:
public class SimpleRedisLock implements ILock{
    private String name;
    private StringRedisTemplate stringRedisTemplate;
    public SimpleRedisLock(String name, StringRedisTemplate stringRedisTemplate) {
        this.name = name;
        this.stringRedisTemplate = stringRedisTemplate;
    }

    private static final String KEY_PREFIX = "lock:";

    @Override
    public boolean tryLock(long timeoutSec) {
        //获取线程标识
        String threadId = Thread.currentThread().getId();
        //获取锁
        Boolean success = stringRedisTemplate.opsForValue().setIfAbsent(KEY_PREFIX + name, threadId + "", timeoutSec, TimeUnit.SECONDS);
        return Boolean.TRUE.equals(success); //插箱,避免空指针异常
    }

    @Override
    public void unlock() {
        //释放锁
        stringRedisTemplate.delete(KEY_PREFIX + name);
}
业务代码:
@Service
public class VoucherOrderServiceImpl extends ServiceImpl<VoucherOrderMapper, VoucherOrder> implements IVoucherOrderService {
    @Resource
    private StringRedisTemplate stringRedisTemplate;
    @Resource
    private ISeckillVoucherService seckillVoucherService;
    @Resource
    private RedisIdWorker redisIdWorker;
    @Override
    public Result seckillVoucher(Long voucherId) {
        //1.查询优惠劵信息
        SeckillVoucher voucher = seckillVoucherService.getById(voucherId);
        //2.判断秒杀是否开始
        if (voucher.getBeginTime().isAfter(LocalDateTime.now())) {
            return Result.fail("秒杀尚未开始!");
        }
        //3.判断优惠劵是否结束
        if (voucher.getEndTime().isBefore(LocalDateTime.now())) {
            return Result.fail("秒杀已经结束!");
        }
        //4.判断库存是否充足
        if (voucher.getStock() < 1) {
            //库存不足
            return Result.fail("库存不足!");
        }
        //5.扣减库存
        boolean success = seckillVoucherService.update().setSql("stock = stock - 1")
                .eq("voucher_id",voucherId)
                .gt("stock",0)
                .update();
        if (!success){
            return Result.fail("库存不足!");
        }
        Long userId = UserHolder.getUser().getId();
        //创建锁对象
        SimpleRedisLock lock = new SimpleRedisLock("order:" + userId, stringRedisTemplate);
        //获取锁
        boolean isLock = lock.tryLock(1200);
        //判断是否获取锁成功
        if (!isLock) {
            //获取锁失败,返回错误或重试
            return Result.fail("不允许重复下单");
        }
        try {
            //拿到当前对象的代理对象(事务)
            IVoucherOrderService proxy = (IVoucherOrderService)AopContext.currentProxy();
            return proxy.createVoucherOrder(voucherId);
        } finally {
            //释放锁
            lock.unlock();
        }
    }

    @Transactional
    public Result createVoucherOrder(Long voucherId) {
        //一人一单
        Long userId = UserHolder.getUser().getId();
        int count = query().eq("user_id", userId).eq("voucher_id", voucherId).count();
        if (count > 0) {
            //用户已经购买过了
            return Result.fail("用户已经购买过了");
        }
        //6.创建订单
        VoucherOrder voucherOrder = new VoucherOrder();
        long orderId = redisIdWorker.nextId("order");
        voucherOrder.setId(orderId);
        voucherOrder.setUserId(userId);
        voucherOrder.setVoucherId(voucherId);
        save(voucherOrder);
        //7.返回订单id
        return Result.ok(orderId);
    }
}
Redis分布式锁误删问题(有点极端的情况)
如下图,线程1首先成功获取锁并进入业务处理阶段,但由于其业务执行时间过长,超过了Redis锁预设的过期时间(TTL),导致锁被Redis服务器自动释放(即“超时释放锁”)。此时,一直在等待的线程2误以为锁已可用便成功获取并开始执行业务,形成了线程1和线程2同时访问临界资源(指在并发环境下,如多线程、多进程,一次仅允许一个执行单元(线程或进程)访问的共享资源)的局面,破坏了锁的互斥性。更严重的是,当线程1最终完成业务并尝试释放锁时,它释放的实则是线程2持有的锁,此时线程3又获取到了锁,这进一步加剧了系统的混乱状态。
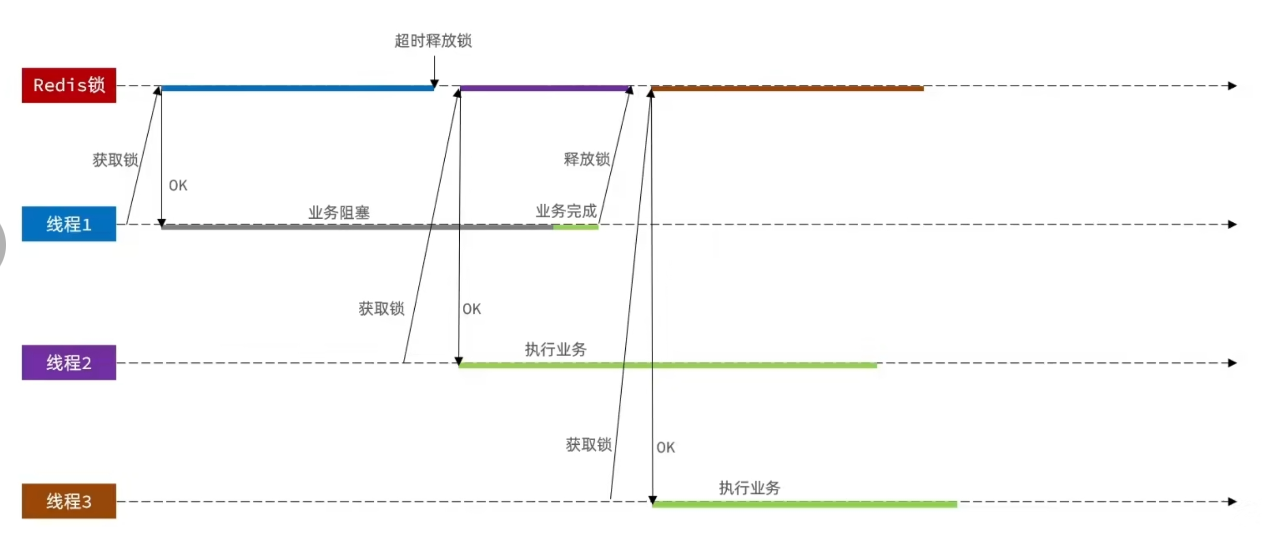
解决办法:在释放锁时,需要验证当前锁的值(例如,一个由当前线程生成的唯一UUID)是否与自己设置的一致。
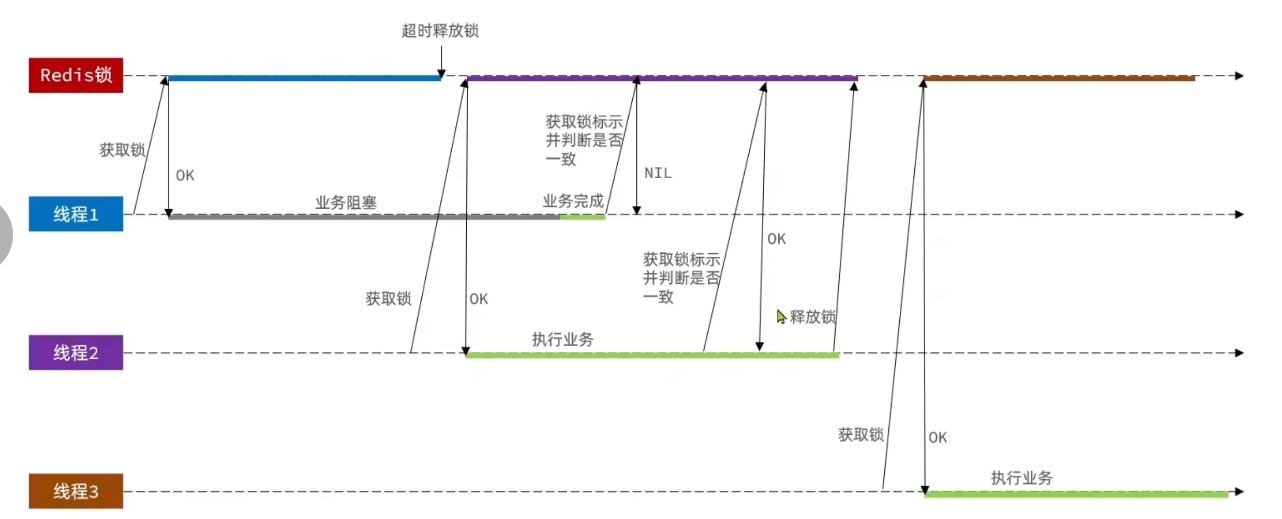
案例:改进Redis的分布式锁(锁误删)
修改之前的分布式锁实现,满足:
1.在获取锁时存入线程标识(可以用UUID表示),UUID是用来区分不同服务器的(jvm)
2.在释放锁时先获取锁中的线程标识,判断是否与当前标识一致,如果一致则释放锁,如果不一致则不释放锁
public class SimpleRedisLock implements ILock{
    private String name;
    private StringRedisTemplate stringRedisTemplate;

    public SimpleRedisLock(String name, StringRedisTemplate stringRedisTemplate) {
        this.name = name;
        this.stringRedisTemplate = stringRedisTemplate;
    }
    private static final String KEY_PREFIX = "lock:";
    private static final String ID_PREFIX = UUID.randomUUID().toString(true) + "-";
    @Override
    public boolean tryLock(long timeoutSec) {
        //获取线程标识
        String threadId = ID_PREFIX + Thread.currentThread().getId();
        //获取锁
        Boolean success = stringRedisTemplate.opsForValue().setIfAbsent(KEY_PREFIX + name, threadId, timeoutSec, TimeUnit.SECONDS);
        return Boolean.TRUE.equals(success); //插箱,避免空指针异常
    }

    @Override
    public void unlock() {
        //获取线程标识
        String threadId = ID_PREFIX + Thread.currentThread().getId();
        //获取锁中的标识
        String id = stringRedisTemplate.opsForValue().get(KEY_PREFIX + name);
        //判断标识是否一致
        if (threadId.equals(id)) {
            //释放锁
            stringRedisTemplate.delete(KEY_PREFIX + name);
        }

    }
}
3.3 分布式锁的原子性问题(超级极端)
线程1在持有锁执行业务时发生阻塞(如GC暂停),图中是在释放锁的时候发生阻塞(垃圾回收),导致锁因超时被Redis自动释放;线程2随后成功获取锁并开始执行业务,此时线程1从阻塞中恢复,在不知情的情况下错误地释放了本属于线程2的锁;最终线程3趁虚而入获得锁,彻底破坏了锁的互斥性和数据的原子性。因为判断锁标识和释放锁的两个操作不是真的原子性,是在java代码中判断的,就会出现阻塞问题。
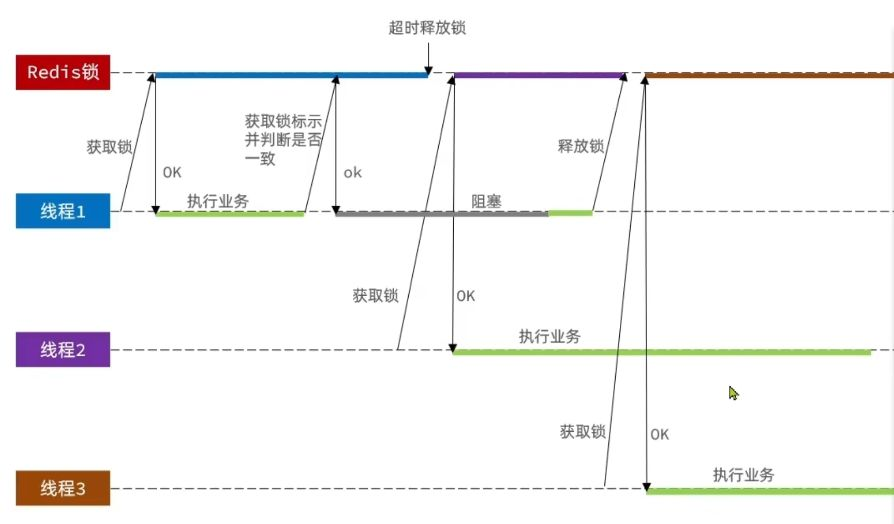
3.3.1 Redis的Lua脚本解决多条命令原子性问题
Redis 本身提供了一系列原子命令,但当你需要顺序执行多个命令,并且要求这些命令作为一个不可分割的单元来执行时,单纯使用多个命令就无法保证原子性了。
Lua 脚本的价值就在于:它可以将这多步操作封装成一个原子操作。Redis 会保证整个 Lua 脚本在执行时不会被任何其他命令打断
Redis提供了Lua脚本功能,在一个脚本中编写多条Redis命令,确保多条命令执行时的原子性。Lua语言基础语法参考:https://www.runoob.com/lua/lua-tutorial.html
这里重点介绍Redis提供的调用函数,语法如下:
# 执行redis命令
redis.call('命令名称', 'key', '其它参数', ...)
例如,执行set name jack,则脚本是这样的:
redis.call('set', 'name', 'jack')例如,执行set name Rose,再执行get name,则脚本如下:
# 先执行 set name jack
redis.call('set', 'name', 'jack')
# 再执行 get name
local name = redis.call('get', 'name')
# 返回结果
return name
写好脚本以后,需要Redis命令来调用脚本,调用脚本的常见命令如下:
EVAL "您的Lua脚本代码" 键的数量 [键1 键2 ...] [参数1 参数2 ...]无键和参数示例:
# 执行 set name jack
EVAL "redis.call('set', 'name', 'jack')" 0

# 先执行 set name jack,再执行 get name 并返回结果
EVAL "redis.call('set', 'name', 'jack'); local name = redis.call('get', 'name'); return name" 0
有键和参数示例:如果脚本中的key、value不想写死,可以作为参数传递。key类型参数会放入KEYS数组,其他参数会让如ARGV数组,在脚本中可以从KEYS和ARGV数组获取这些参数:
# 示例1:设置指定键的字符串值
# 脚本功能:执行 SET 命令,将键设置为指定的值
# EVAL "Lua脚本代码" [键的数量] [具体的键] [具体的参数]
EVAL "return redis.call('set', KEYS[1], ARGV[1])" 1 username "张三"
# 执行效果等价于Redis命令:SET username "张三"
释放锁的业务流程是这样的:①获取锁中的线程标识;②判断是否与指定的标识(当前线程标识)一致;③如果一致则释放锁(删除);④如果不一致则什么都不做。
如果用Lua脚本来表示则是这样的:
-- 获取锁中的标识,比较线程标识与锁中的标识是否一致
if(redis.call('get',KEYS[1]) == ARGV[1]) then
    -- 一致,释放锁 del key
    return redis.call('del',KEYS[1])
end
-- 不一致,则直接返回
return 0
业务实现:
public class SimpleRedisLock implements ILock{
    private String name;
    private StringRedisTemplate stringRedisTemplate;

    public SimpleRedisLock(String name, StringRedisTemplate stringRedisTemplate) {
        this.name = name;
        this.stringRedisTemplate = stringRedisTemplate;
    }
    private static final String KEY_PREFIX = "lock:";
    private static final String ID_PREFIX = UUID.randomUUID().toString(true) + "-";
    private static final DefaultRedisScript<Long> UNLOCK_SCRIPT;
    //类加载的时候初始化一次,静态代码块只会被执行一次,不会浪费IO资源
    static {
        UNLOCK_SCRIPT = new DefaultRedisScript<>();
        UNLOCK_SCRIPT.setLocation(new ClassPathResource("unlock.lua"));
        UNLOCK_SCRIPT.setResultType(Long.class);
    }
    @Override
    public boolean tryLock(long timeoutSec) {
        //获取线程标识
        String threadId = ID_PREFIX + Thread.currentThread().getId();
        //获取锁
        Boolean success = stringRedisTemplate.opsForValue().setIfAbsent(KEY_PREFIX + name, threadId, timeoutSec, TimeUnit.SECONDS);
        return Boolean.TRUE.equals(success); //插箱,避免空指针异常
    }
    @Override
    public void unlock() {
        //调用lua脚本
        stringRedisTemplate.execute(UNLOCK_SCRIPT,
                Collections.singletonList(KEY_PREFIX + name),
                ID_PREFIX + Thread.currentThread().getId());
    }
}
3.4 分布式锁——Redisson功能
基于setnx实现的分布式锁存在下面的问题:
- 不可重入:同一线程在已经持有锁的情况下,再次请求获取同一把锁时会失败。这在方法递归调用或嵌套调用场景下会造成死锁。
- 不可重试:获取锁时若竞争失败立即返回
false,缺乏重试机制,在高并发场景下可能导致大量请求瞬间失败。- 超时释放:为避免死锁设置的锁超时时间,若业务执行时间超过超时时间,会导致锁提前释放,其他线程乘虚而入,存在安全隐患。
- 主从一致性:在Redis主从集群中,锁信息异步复制到从节点存在延迟。若主节点在锁信息同步前宕机,从节点升级为新主后,锁状态丢失,导致多个客户端同时持有锁。
Redisson是一个在 Redis 基础上实现的 Java 驻内存数据网格(In-Memory Data Grid)。它为使用者提供了一系列分布式的、可扩展的 Java 对象和服务,其宗旨是促进使用者对 Redis 的关注分离,从而让使用者能够将精力更集中地放在处理业务逻辑上。
简单来说:它让你像使用本地 Java 对象(如 Map, List, Lock)一样,轻松地在分布式环境下使用这些数据结构,而无需关心底层的 Redis 命令和序列化等复杂细节。
3.4.1 Redisson入门
1.引入依赖
        <dependency>
            <groupId>org.redisson</groupId>
            <artifactId>redisson</artifactId>
            <version>3.13.6</version>
        </dependency>
2.配置Redisson客户端
@Configuration
public class RedissonConfig {
    @Bean
    public RedissonClient redissonClient(){
        //配置类
        Config config = new Config();
        //添加redis地址,这里添加了单点的地址,也可以使用config.useClusterServers()添加集群地址
        config.useSingleServer().setAddress("redis://192.168.142.135:6379").setPassword("密码");
        //创建RedissonClient对象(创建客户端)
        return Redisson.create(config);
    }
}
3.使用Redisson的分布式锁
@Resource
private RedissonClient redissonClient;
@Test
void testRedisson() throws InterruptedException{
    //获取锁(可重入),可指定锁的名称
    RLock lock = redissonClient.getLock("lock:order:" + userId);
    //尝试获取锁,参数分别是:获取锁的最大等待时间(期间会重试),锁自动释放时间,时间单位
    boolean isLock = lock.tryLock();
    //判断是否获取锁成功
    if (isLock) {
        try {
            System.out.println("执行业务");
        } finally {
            //释放锁
            lock.unlock();
        }
    }
}
3.4.2 Redisson可重入锁原理
可重入锁记录:在Redis中采用Hash结构存储锁,Key是锁名,Field是客户端ID+线程ID,Value是重入次数。这解决了“不可重入”问题。
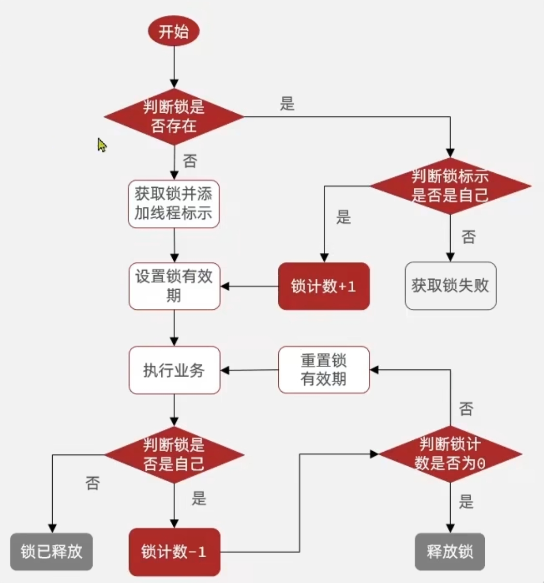
获取锁的Lua脚本:
local key = KEYS[1]     -- 锁的key
local threadId = ARGV[1] -- 线程唯一标识
local releaseTime = ARGV[2] -- 锁的自动释放时间

-- 1. 判断锁是否存在
if(redis.call('exists', key) == 0) then
    -- 不存在:获取锁,设置重入次数=1,设置有效期
    redis.call('hset', key, threadId, '1')
    redis.call('expire', key, releaseTime)
    return 1 -- 成功
end

-- 2. 锁已存在,判断是否自己的锁
if(redis.call('hexists', key, threadId) == 1) then
    -- 是自己的锁:重入次数+1,重置有效期
    redis.call('hincrby', key, threadId, '1')
    redis.call('expire', key, releaseTime)
    return 1 -- 成功
end

return 0 -- 获取锁失败(锁被其他线程占用)
代码解释:
| Lua代码 | Redis命令 | 作用说明 |
|---|---|---|
|
|
| 检查键是否存在 |
|
|
| 设置Hash字段值 |
|
|
| 设置键过期时间 |
|
|
| 检查Hash字段是否存在 |
|
|
| Hash字段值递增 |
释放锁的Lua脚本:
local key = KEYS[1];        -- 锁的key
local threadId = ARGV[1];    -- 线程唯一标识
local releaseTime = ARGV[2];  -- 锁的自动释放时间

-- 判断当前锁是否还是被自己持有
if (redis.call('HEXISTS',key,threadId)==0) then
    return nil;              -- 如果已经不是自己,则直接返回
end;

-- 是自己的锁,则重入次数-1
local count = redis.call('HINCRBY',key,threadId,-1);

-- 判断重入次数是否已经为0
if (count > 0) then
    -- 大于0说明不能释放锁,重置有效期然后返回
    redis.call('EXPIRE',key,releaseTime);
    return nil;
else
    -- 等于0说明可以释放锁,直接删除
    redis.call('DEL',key);
    return nil;
end;
注:return nil表示空值/无意义结果,能清晰传达“脚本执行完毕,但不需要关心返回值”。
@SpringBootTest
@Slf4j
public class RedissonTest {
    @Resource
    private RedissonClient redissonClient;
    private RLock lock;
    //在每个 @Test测试方法执行之前,该方法都会自动运行一次
    @BeforeEach
    void setUp(){
        lock = redissonClient.getLock("order");
    }
    @Test
    void method1() {
        //尝试获取锁
        boolean isLock = lock.tryLock();
        if(!isLock){
            log.error("获取锁失败....1");
            return;
        }
        try {
            log.info("获取锁成功....1");
            method2();  // 在锁内调用method2,演示可重入
            log.info("开始执行业务....1");
        } finally {
            log.warn("准备释放锁....1");
            lock.unlock();
        }
    }
    void method2(){
        boolean isLock = lock.tryLock();  // 同一线程再次获取同一把锁
        if(!isLock){
            log.error("获取锁失败....2");
            return;
        }
        try {
            log.info("获取锁成功....2");
            log.info("开始执行业务....2");
        } finally {
            log.warn("准备释放锁....2");
            lock.unlock();
        }
    }
}
3.4.3 Redisson的锁重试和WatchDog机制(超时释放)
在深入流程图之前,先了解两个基石机制,这有助于理解图中的复杂判断:
Watchdog(看门狗):一个后台守护线程,在锁未被显式设置超时时间时,会自动定期(默认每10秒)为锁续期,防止业务未完成锁却过期了。解决了“超时释放”问题。
订阅与发布(Pub/Sub):当某个线程获取锁失败时,它不会盲目循环重试,而是订阅一个“锁释放”的频道。当锁被释放时,会收到通知,然后再尝试获取。这减少了无效的轮询,实现了“可重试”且高效。
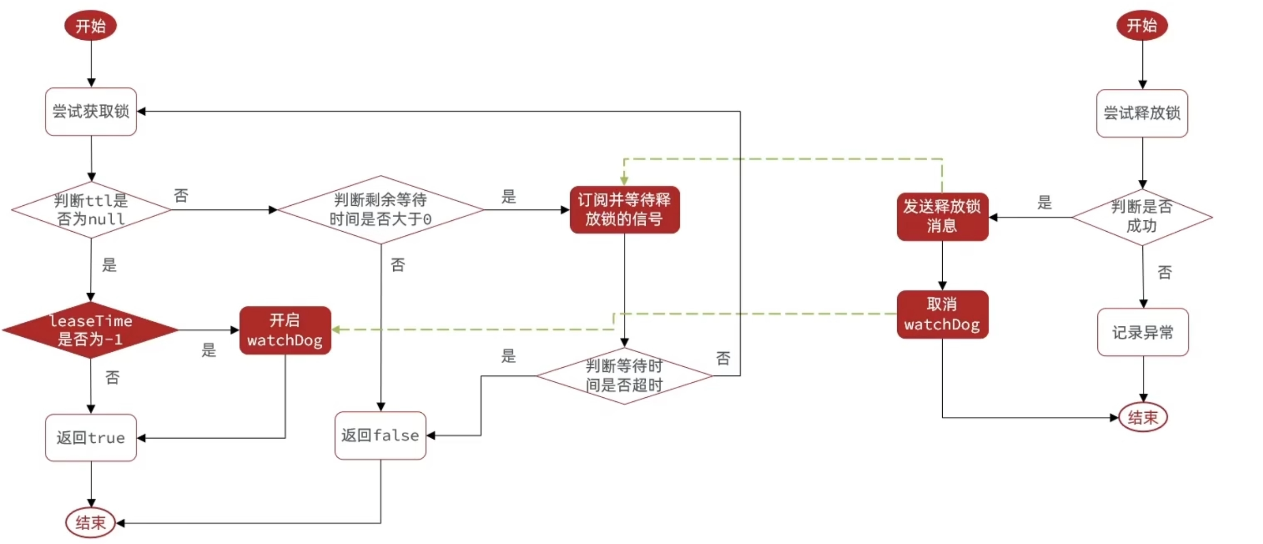
左侧流程解读:
尝试获取锁:线程调用
lock()或tryLock()方法,Redisson会首先执行Lua脚本,尝试在Redis中创建锁。
如果锁不存在(TTL为null):流程走向“设置锁并设置TTL”。这里有一个关键点:如果用户没有指定超时时间,Redisson会使用一个默认的很长的超时时间(如30秒),并同时“开启Watchdog”。Watchdog会之后自动续期,保证锁不会因为业务执行时间长而超时。利用watchDog,每隔一段时间(leaseTime/3),重置超时时间,重置后的超时时间 = 初始设置的锁超时时间(leaseTime)。
如果锁已存在(TTL不为null):表示锁被其他线程持有。流程进入等待环节。
等待与重试机制:如果锁已被占用,线程不会立即失败。
判断剩余等待时间(如果调用的是
tryLock(waitTime, leaseTime, unit)则会有等待时间)。如果还有等待时间,线程会订阅一个与锁对应的频道,然后阻塞等待。
当锁被释放时,释放锁的线程会向这个频道发布一条消息。正在等待的线程收到消息后,会跳回第一步重新尝试获取锁。
如果在指定的等待时间内一直没有收到信号,则最终返回
false。这一步的精妙之处在于:通过Pub/Sub机制避免了无效的轮询,大大减轻了Redis的压力。
右侧流程解读:
尝试释放锁:线程调用
unlock()方法,Redisson会执行一个Lua脚本。这个脚本会检查:
当前线程是否是锁的持有者(通过客户端ID+线程ID判断)。
如果是,则将重入次数减1。
如果重入次数减为0,则直接删除(DEL)Redis中的锁Key。
后续清理工作:
取消Watchdog:如果释放成功,后台的看门狗线程会被终止,不再进行续期。
发布释放消息:通过Redis的Pub/Sub功能,向所有订阅了该锁频道的线程发送一条“锁已释放”的消息。这会唤醒所有正在等待这个锁的线程,让他们重新参与竞争。这一步与获取流程的“订阅”步骤完美衔接。
异常处理:如果释放失败(例如,线程尝试释放一个不属于自己的锁),会记录异常并返回
false。
3.4.4 Redisson的multiLock原理
主节点负责读、写,从节点通常只读不可写,但是会进行主从同步,从节点相当于主节点的一个有延迟的“副本”。
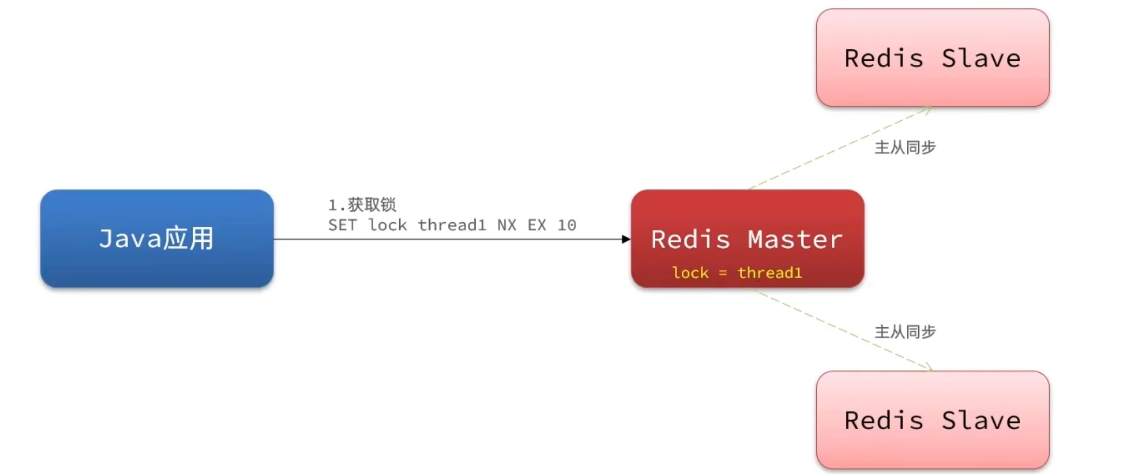 当Java应用成功从主节点Master获取锁后,主节点会异步地将锁数据同步到从节点Slave;然而,若在主节点数据同步完成前发生故障,从节点晋升为新主节点时,锁状态可能丢失,导致另一个应用也能成功获取同一把锁,从而破坏互斥性,引发数据不一致。
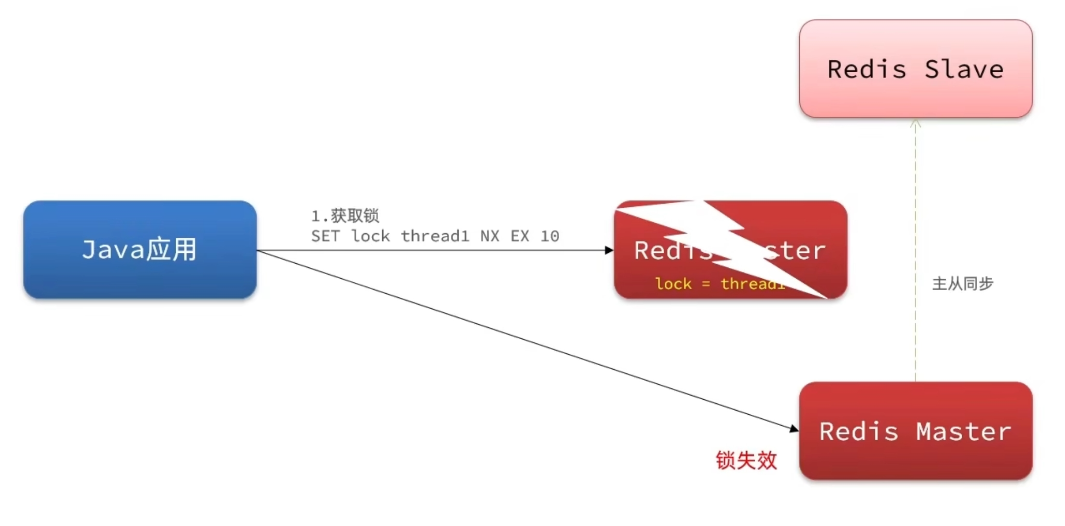
RedLock算法:解决在简单Redis主从架构下分布式锁可能因主节点宕机而失效的问题。
RedLock算法的核心思想是:不再依赖单一的Redis主从集群,而是同时向多个独立的Redis节点申请锁,只要超过半数的节点成功,就认为获取锁成功。这就像“不要把所有鸡蛋放在同一个篮子里”。
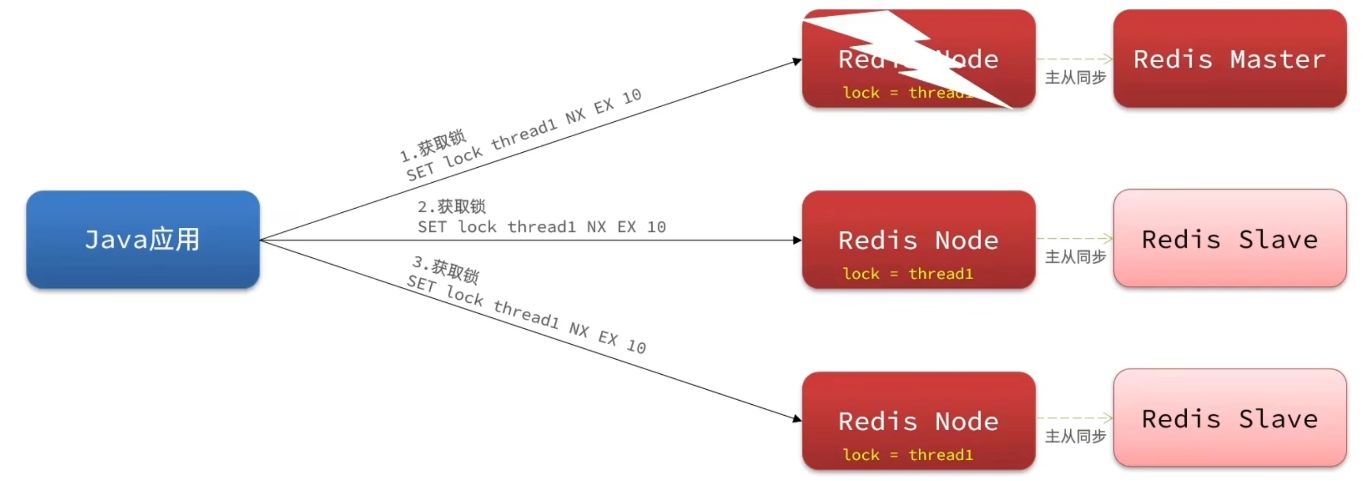
multiLock实现:它与RedLock算法目标相似,都是通过组合多个锁来提升可靠性,但实现方式和适用场景有区别。
Redisson MultiLock(联锁)核心机制
Redisson MultiLock 机制的核心在于通过将多个独立的
RLock对象组合成一个逻辑上的“大锁”。应用必须同时成功获取这个“大锁”中所包含的所有底层锁,整个加锁操作才算成功。其工作流程分为三步:首先,为多个独立的Redis节点或资源创建多个
RLock对象,并将它们组合成一个RedissonMultiLock实例;接着,应用会尝试按顺序获取所有底层锁,这是一个“全有或全无”的操作——只要其中任意一个锁获取失败,整个操作便会立即失败,并且会自动释放那些已经获取成功的锁,以确保原子性;
最后,当业务逻辑执行完毕后,会一次性释放所有底层锁,从而完成整个资源的原子性释放。这种机制主要被用于需要原子性地同时占用多个资源的场景,有效避免了在复杂业务中因逐个获取锁而可能产生的死锁问题。
简单来说,MultiLock 确保了对多个资源的操作是“绑定”在一起的,要么全部锁定成功,要么一个都不锁,从而保证了跨资源操作的原子性。
@Configuration
public class RedissonConfig {
    @Bean
    public RedissonClient redissonClient(){
        //配置
        Config config = new Config();
        config.useSingleServer().setAddress("redis://192.168.142.135:6379").setPassword("密码");
        //创建RedissonClient对象
        return Redisson.create(config);
    }
    @Bean
    public RedissonClient redissonClient2(){
        //配置
        Config config = new Config();
        config.useSingleServer().setAddress("redis://192.168.142.135:6380").setPassword("密码");
        //创建RedissonClient对象
        return Redisson.create(config);
    }
    @Bean
    public RedissonClient redissonClient3(){
        //配置
        Config config = new Config();
        config.useSingleServer().setAddress("redis://192.168.142.135:6381").setPassword("密码");
        //创建RedissonClient对象
        return Redisson.create(config);
    }
}
@SpringBootTest
@Slf4j
public class RedissonTest {
@Resource
private RedissonClient redissonClient;
@Resource
private RedissonClient redissonClient2;
@Resource
private RedissonClient redissonClient3;
private RLock lock;
//在每个 @Test测试方法执行之前,该方法都会自动运行一次
@BeforeEach
void setUp(){
RLock lock1 = redissonClient.getLock("order");
RLock lock2 = redissonClient.getLock("order");
RLock lock3 = redissonClient.getLock("order");
//创建联锁 multiLock
lock = redissonClient.getMultiLock(lock1,lock2,lock3);
}
@Test
void method1() throws InterruptedException {
//尝试获取锁
boolean isLock = lock.tryLock(1L, TimeUnit.SECONDS);
if(!isLock){
log.error("获取锁失败....1");
return;
}
try {
log.info("获取锁成功....1");
method2(); // 在锁内调用method2,演示可重入
log.info("开始执行业务....1");
} finally {
log.warn("准备释放锁....1");
lock.unlock();
}
}
void method2(){
boolean isLock = lock.tryLock(); // 同一线程再次获取同一把锁
if(!isLock){
log.error("获取锁失败....2");
return;
}
try {
log.info("获取锁成功....2");
log.info("开始执行业务....2");
} finally {
log.warn("准备释放锁....2");
lock.unlock();
}
}
}
四、总结:锁的本质是“权衡”
悲观锁、乐观锁、分布式锁的核心价值,都是在并发场景中平衡“数据一致性”与“系统性能”:
悲观锁以“牺牲部分性能”为代价,换取“强一致性”,是单机高冲突场景的首选;
乐观锁以“容忍重试开销”为代价,换取“高并发性能”,是单机低冲突场景的最优解;
分布式锁则是在集群架构下,通过“跨节点协同”实现“全局一致性”,是分布式场景的必备工具。
没有绝对最优的锁,只有最适配业务的锁。掌握三大锁的核心原理,结合架构场景和并发特征灵活选型,才能在保障数据安全的同时,最大化系统的并发能力。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 38
 0
- 0


 已为社区贡献1条内容

所有评论(0)