【Redis主从复制:搭建高可用架构的第一步】
💡 摘要:是否担心单点Redis故障导致服务完全中断?是否想实现读写分离提升系统性能?Redis主从复制(Replication)是构建高可用架构的基础,它提供了数据冗余、故障恢复和读扩展能力。通过主从复制,你可以确保即使主节点宕机,从节点仍然可以提供服务。
本文将深入解析Redis主从复制的完整机制,从工作原理到实战搭建,从同步过程到故障处理。你将学会如何配置主从复制、监控复制状态、处理故障转移,以及优化复制性能。无论你是要提升系统可用性还是扩展读性能,主从复制都是必须掌握的核心技术!
一、主从复制概述
1. 为什么需要主从复制?
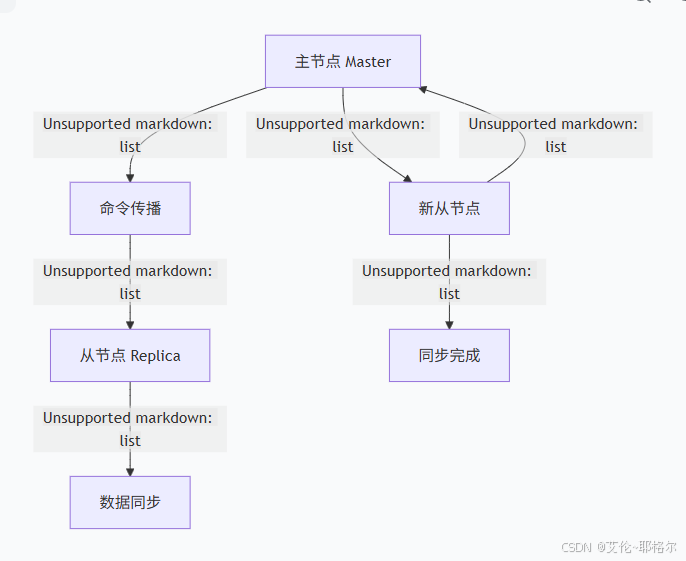
在主从架构中:
-
主节点(Master):处理写操作和读操作
-
从节点(Slave/Replica):复制主节点数据,处理读操作
核心价值:
-
🛡️ 数据冗余:多副本保障数据安全
-
⚡ 读写分离:扩展读性能,分担主节点压力
-
🔄 故障恢复:主节点故障时从节点可提升为主节点
-
📊 数据备份:可在从节点执行备份而不影响主节点
2. 复制工作原理
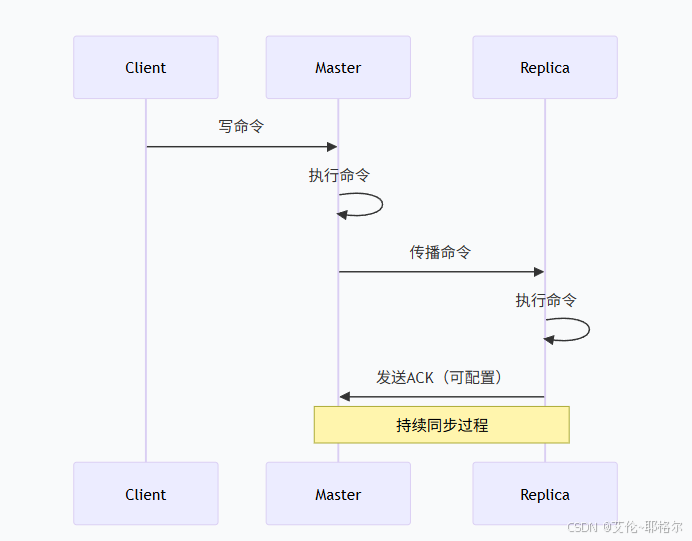
3. 复制流程时序图
二、主从复制配置实战
1. 环境准备
准备至少两个Redis实例(可以同一机器不同端口):
bash
# 启动两个Redis实例
redis-server --port 6379 --daemonize yes  # 主节点
redis-server --port 6380 --daemonize yes  # 从节点
2. 配置主从复制
方法一:配置文件方式
主节点配置(redis-master.conf):
conf
port 6379
daemonize yes
pidfile /var/run/redis_6379.pid
logfile "/var/log/redis_6379.log"
dbfilename dump_6379.rdb
从节点配置(redis-replica.conf):
conf
port 6380
daemonize yes
pidfile /var/run/redis_6380.pid
logfile "/var/log/redis_6380.log"
dbfilename dump_6380.rdb
replicaof 127.0.0.1 6379  # 关键配置:指定主节点
方法二:运行时动态配置
redis
# 在从节点上执行 replicaof 命令
127.0.0.1:6380> REPLICAOF 127.0.0.1 6379
OK

# 查看复制状态
127.0.0.1:6380> INFO replication
方法三:启动参数配置
bash
# 启动时直接指定主节点
redis-server --port 6380 --replicaof 127.0.0.1 6379
3. 验证复制状态
在主节点检查:
redis
127.0.0.1:6379> INFO replication
# Replication
role:master
connected_slaves:1
slave0:ip=127.0.0.1,port=6380,state=online,offset=1234,lag=0
在从节点检查:
redis
127.0.0.1:6380> INFO replication
# Replication
role:slave
master_host:127.0.0.1
master_port:6379
master_link_status:up  # 状态为up表示复制正常
4. 测试数据同步
redis
# 在主节点写入数据
127.0.0.1:6379> SET key1 "value1"
OK
127.0.0.1:6379> INCR counter
(integer) 1

# 在从节点读取数据(应该同步成功)
127.0.0.1:6380> GET key1
"value1"
127.0.0.1:6380> GET counter
"1"
三、复制机制深度解析
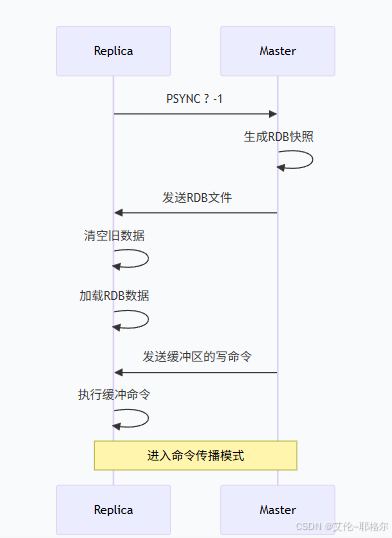
1. 全量同步(Full Synchronization)
当从节点第一次连接或长时间断开后重新连接时,会触发全量同步:
2. 部分同步(Partial Resynchronization)
基于复制偏移量和复制积压缓冲区:
redis
# 查看复制偏移量
127.0.0.1:6379> INFO replication
master_repl_offset:123456  # 主节点复制偏移量
slave_repl_offset:123456   # 从节点复制偏移量

# 查看复制积压缓冲区
127.0.0.1:6379> CONFIG GET repl-backlog-size
1) "repl-backlog-size"
2) "1048576"  # 默认1MB
3. 复制配置优化
conf
# redis.conf 复制相关配置

# 复制积压缓冲区大小
repl-backlog-size 64mb

# 积压缓冲区存活时间
repl-backlog-ttl 3600

# 从节点超时时间
repl-timeout 60

# 主节点无磁盘同步(diskless replication)
repl-diskless-sync yes
repl-diskless-sync-delay 5

# 从节点只读模式
replica-read-only yes

# 主节点写入最小从节点数
min-replicas-to-write 1
min-replicas-max-lag 10
四、高级复制特性
1. 级联复制(Replica Chaining)
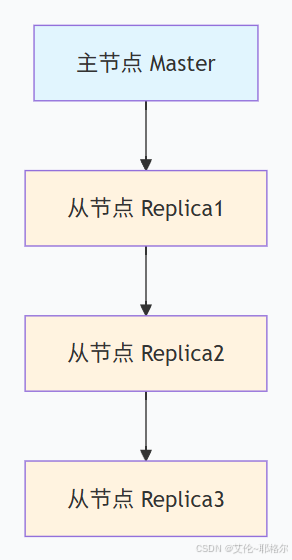
配置方式:
redis
# Replica2 复制 Replica1
127.0.0.1:6381> REPLICAOF 127.0.0.1 6380

# 查看级联复制状态
127.0.0.1:6380> INFO replication
role:slave
master_host:127.0.0.1
master_port:6379
connected_slaves:1
slave0:ip=127.0.0.1,port=6381,state=online
2. 复制过滤(Replication Filtering)
conf
# 只复制特定的数据库
replicaof 127.0.0.1 6379
# 复制所有数据库(默认)
# replica-db 0
# replica-db 1

# 或者使用命令动态配置
127.0.0.1:6380> CONFIG SET replica-db 0
3. 延迟从节点(Delayed Replica)
bash
# 启动延迟从节点(延迟60秒)
redis-server --port 6382 --replicaof 127.0.0.1 6379 --replica-delay 60
应用场景:
-
🎯 防止人为误操作(有恢复时间窗口)
-
🛡️ 保护 against 某些类型的软件bug
-
📊 数据审计和回滚
五、监控与故障处理
1. 关键监控指标
redis
# 查看详细的复制信息
127.0.0.1:6379> INFO replication

# 监控指标说明:
# connected_slaves:已连接的从节点数量
# master_repl_offset:主节点复制偏移量
# repl_backlog_active:复制积压缓冲区是否激活
# repl_backlog_size:积压缓冲区大小
# repl_backlog_first_byte_offset:积压缓冲区起始偏移量
2. 复制状态监控脚本
python
import redis
import time
import logging

class ReplicationMonitor:
    def __init__(self, master_host='localhost', master_port=6379):
        self.master = redis.Redis(host=master_host, port=master_port)
        self.replicas = []

    def add_replica(self, host, port):
        """添加从节点到监控列表"""
        replica = redis.Redis(host=host, port=port)
        self.replicas.append((host, port, replica))

    def check_replication_health(self):
        """检查复制健康状态"""
        master_info = self.master.info('replication')

        results = {
            'master_offset': master_info['master_repl_offset'],
            'replicas': []
        }

        for host, port, replica in self.replicas:
            try:
                replica_info = replica.info('replication')
                status = {
                    'host': host,
                    'port': port,
                    'role': replica_info['role'],
                    'master_link_status': replica_info.get('master_link_status', 'down'),
                    'slave_repl_offset': replica_info.get('slave_repl_offset', 0),
                    'lag': master_info['master_repl_offset'] - replica_info.get('slave_repl_offset', 0),
                    'status': 'healthy' if replica_info.get('master_link_status') == 'up' else 'unhealthy'
                }
                results['replicas'].append(status)
            except redis.ConnectionError:
                results['replicas'].append({
                    'host': host, 'port': port, 'status': 'unreachable'
                })

        return results

# 使用示例
monitor = ReplicationMonitor()
monitor.add_replica('localhost', 6380)
monitor.add_replica('localhost', 6381)

health = monitor.check_replication_health()
print(f"Master offset: {health['master_offset']}")
for replica in health['replicas']:
    print(f"Replica {replica['host']}:{replica['port']} - {replica['status']}")
3. 常见故障处理
复制中断恢复
bash
# 检查从节点状态
redis-cli -p 6380 info replication | grep master_link_status

# 如果状态为down,尝试重新同步
redis-cli -p 6380 replicaof no one  # 先取消复制
redis-cli -p 6380 replicaof 127.0.0.1 6379  # 重新设置主节点

# 或者直接重启从节点
redis-cli -p 6380 shutdown
redis-server /path/to/redis-replica.conf
网络分区处理
python
def handle_network_partition(master_host, replica_hosts):
    """处理网络分区场景"""
    master = redis.Redis(host=master_host)

    for host in replica_hosts:
        try:
            replica = redis.Redis(host=host)
            replica_info = replica.info('replication')

            # 如果从节点认为自己是主节点(脑裂)
            if replica_info['role'] == 'master':
                print(f"Replica {host} became master, demoting...")
                replica.replicaof(master_host, 6379)

        except redis.ConnectionError:
            print(f"Replica {host} is unreachable")
六、生产环境最佳实践
1. 安全配置
conf
# 主节点认证
requirepass "your_strong_password"

# 从节点配置主节点密码
masterauth "your_strong_password"

# 禁用危险命令
rename-command FLUSHALL ""
rename-command FLUSHDB ""
rename-command CONFIG ""

# 网络安全
bind 192.168.1.100  # 绑定内网IP
2. 性能优化
conf
# 调整复制积压缓冲区大小
repl-backlog-size 128mb

# 启用无盘复制(适合网络速度快的情况)
repl-diskless-sync yes
repl-diskless-sync-delay 5

# 优化持久化配置(根据需求选择)
appendonly yes
appendfsync everysec

# 调整内核参数(Linux)
# echo never > /sys/kernel/mm/transparent_hugepage/enabled
# echo 'vm.overcommit_memory = 1' >> /etc/sysctl.conf
3. 高可用架构建议
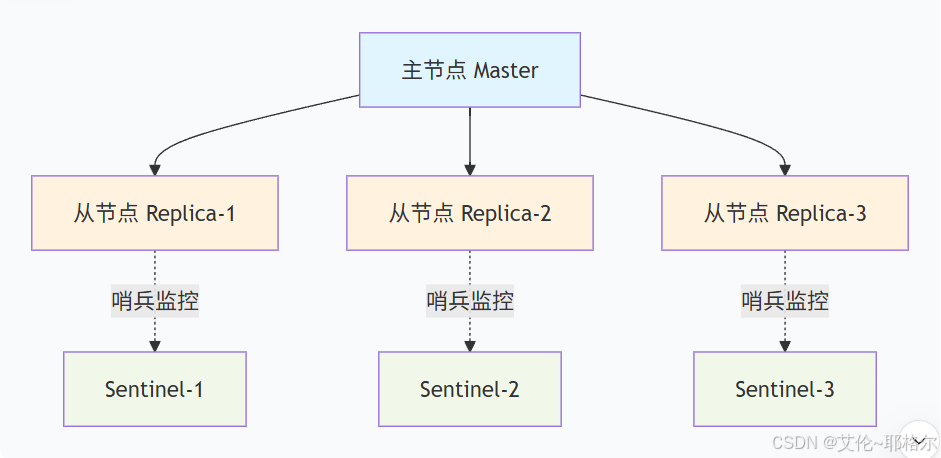
七、常见问题解答 (FAQ)
Q1: 主从复制会影响主节点性能吗?
A: 会有一定影响,特别是在全量同步时。建议在从节点较多时使用级联复制架构。
Q2: 从节点可以接受写操作吗?
A: 默认情况下从节点是只读的(replica-read-only yes),不能接受写操作。
Q3: 复制延迟如何监控?
A: 通过比较主节点的master_repl_offset和从节点的slave_repl_offset来监控复制延迟。
Q4: 网络断开后重新连接会发生什么?
A: 如果断开时间较短,会进行部分同步;如果断开时间较长或复制积压缓冲区不足,会触发全量同步。
Q5: 如何安全地升级从节点?
A: 可以先关闭从节点,升级后重新启动,它会自动重新同步数据。
Q6: 主从复制和集群有什么区别?
A: 主从复制提供数据冗余和读扩展,Redis集群提供数据分片和写扩展。
Q7: 从节点可以有自己的从节点吗?
A: 可以,这就是级联复制(Replica Chaining)。
八、总结
Redis主从复制是构建高可用架构的基石:
核心价值:
-
🛡️ 数据安全:多副本保障数据不丢失
-
⚡ 性能扩展:读写分离提升读性能
-
🔄 高可用:故障时快速恢复服务
-
📊 运维友好:方便备份和数据分析
关键知识点:
-
同步机制:全量同步 + 部分同步
-
配置方式:配置文件、运行时命令、启动参数
-
监控指标:复制偏移量、连接状态、延迟时间
-
故障处理:重新同步、重启、网络恢复
最佳实践:
-
✅ 至少配置2个从节点确保高可用
-
✅ 监控复制延迟和连接状态
-
✅ 合理设置复制积压缓冲区大小
-
✅ 使用哨兵或集群实现自动故障转移
主从复制只是Redis高可用架构的第一步,结合哨兵(Sentinel)和集群(Cluster)可以构建更加健壮的分布式系统。掌握主从复制,为你后续学习更高级的Redis特性打下坚实基础!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 18
 0
- 0


 已为社区贡献5条内容

所有评论(0)