hadoop的安装、配置与管理(手把手教程、安装、配置)
|
实训目的 及要求 |
一、实验目的本实验旨在掌握在 CentOS 7 操作系统上安装和配置 Hadoop 分布式文件系统(HDFS)及相关组件的基本方法,理解 Hadoop 生态系统的基本架构,并能够成功搭建一个简单的 Hadoop 集群。 二、实验要求1. 熟悉 Hadoop 生态系统的基本概念,如 HDFS、YARN、MapReduce。 2. 在 CentOS 7 上安装并配置 Hadoop,包括单节点模式和伪分布模式。 3. 配置 SSH 免密登录,以便 Hadoop 集群能够正常运行。 4. 格式化 NameNode,并启动 Hadoop 分布式文件系统。 5. 运行 JPS 命令,验证 Hadoop 相关进程是否正常运行。 6. 通过 Web UI(默认端口 50070)访问 Hadoop NameNode 状态页面,确保 Hadoop 运行正常。 |
|
实验内容 |
实验准备: 登录平台:https://kooedx.eduplus.net/lab/VM_Blueprint,登录方式为手机号验证码登录。 环境:U+平台虚拟环境 软件配置:Centos7四台(node、node1、node2、node3),四台环境都需要配置。 实验注意:
提交要求:实训报告命名方式:学号+姓名
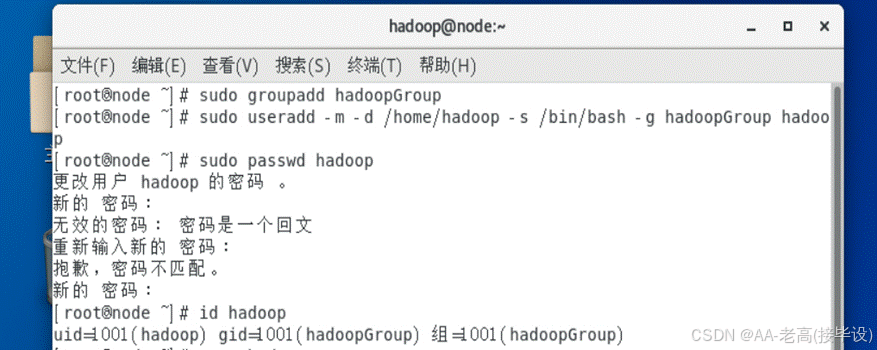
要求:创建用户组 hadoopGroup,并创建 hadoop 用户,指定 home 目录和用户组。
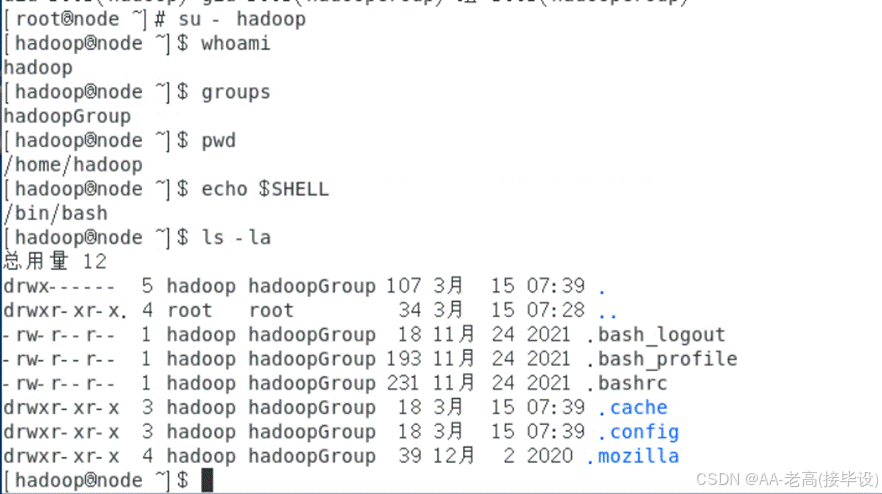
要求:切换到新创建的 hadoop 用户,并验证用户环境是否正确。
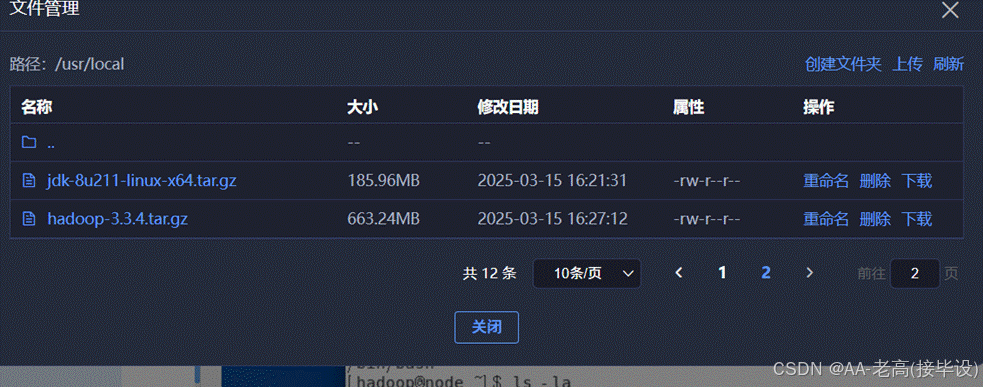
要求:使用 WinSCP 连接 CentOS,并上传 JDK 和 Hadoop 安装包到 /usr/local 目录。
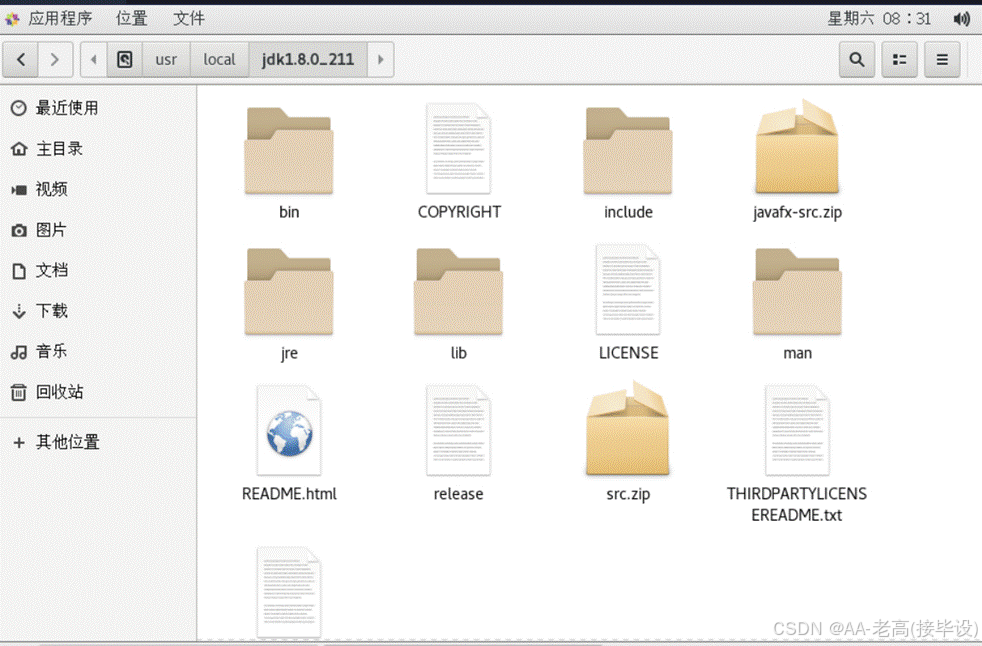
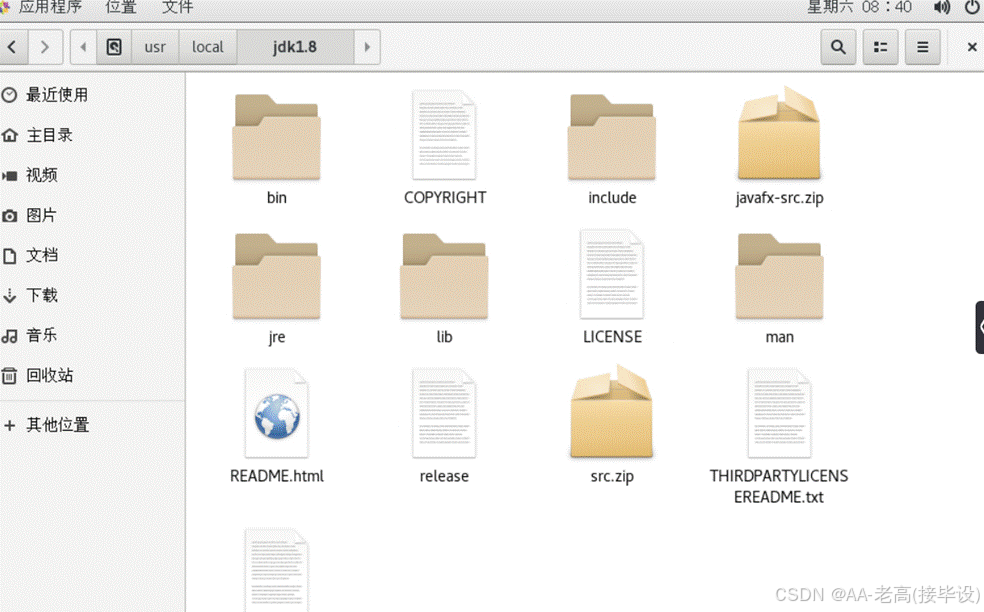
要求:在 /usr/local 目录下解压 JDK 安装包,并检查解压后的文件列表。
要求:将解压后的 JDK 目录重命名为 jdk1.8,并检查修改后的目录结构。
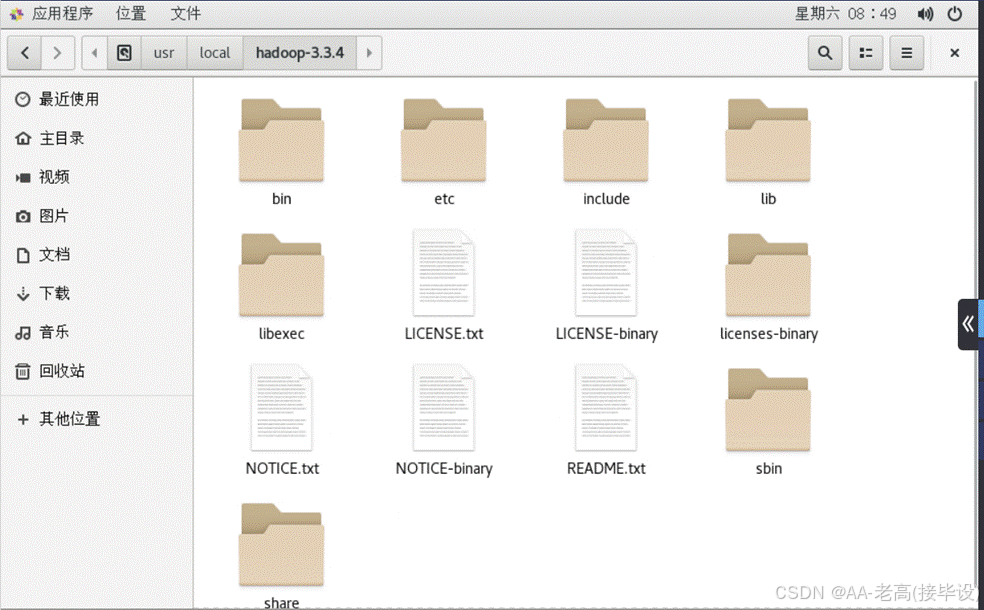
要求:在 /usr/local 目录下解压 Hadoop 安装包,并检查解压后的文件列表
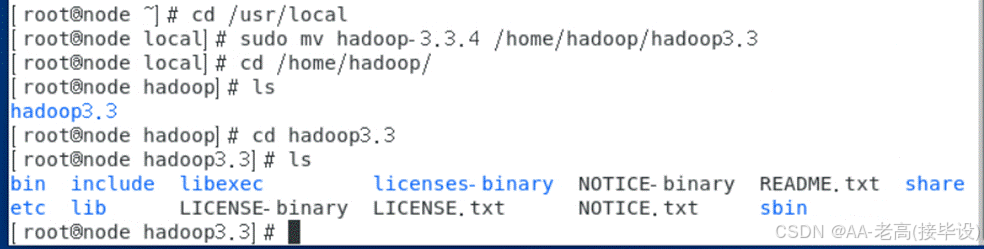
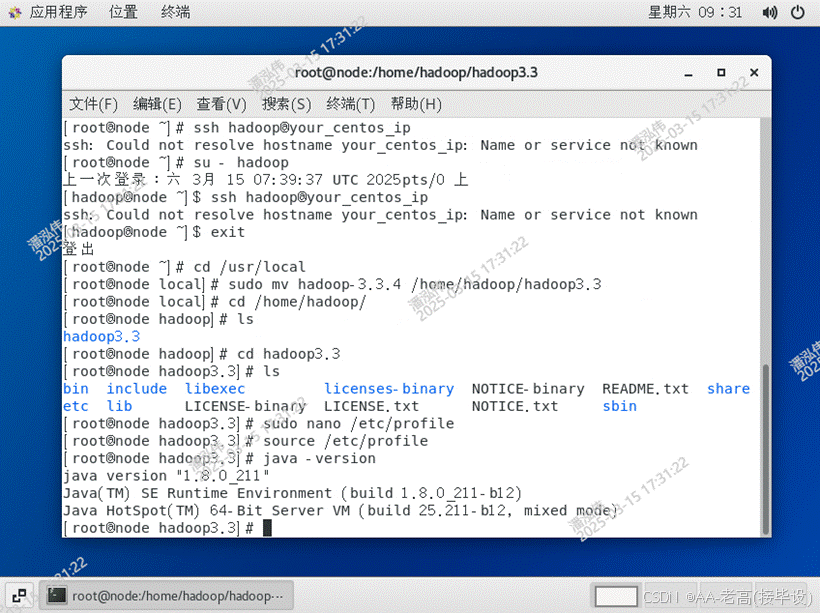
要求:将 Hadoop 目录移动到 /home/hadoop/ 并重命名为 hadoop3.3,验证操作是否成功。
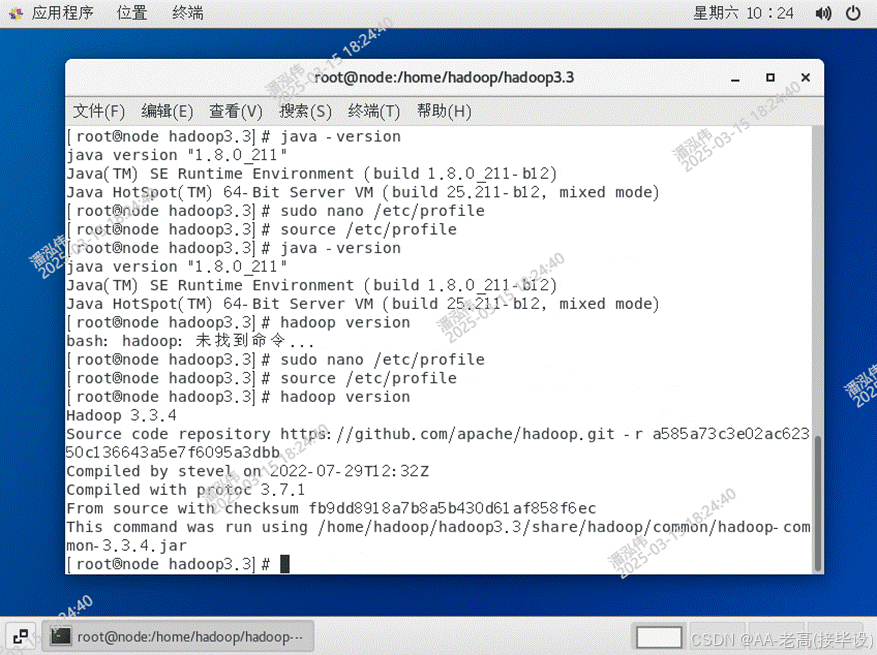
要求:修改 /etc/profile 文件,添加 JDK 环境变量,并使用 source 命令生效。 要求:运行 java -version 命令,检查 JDK 是否安装成功。
要求:修改 /etc/profile 文件,添加 Hadoop 相关环境变量,并使其生效。运行 hadoop 命令,检查 Hadoop 是否正确配置。
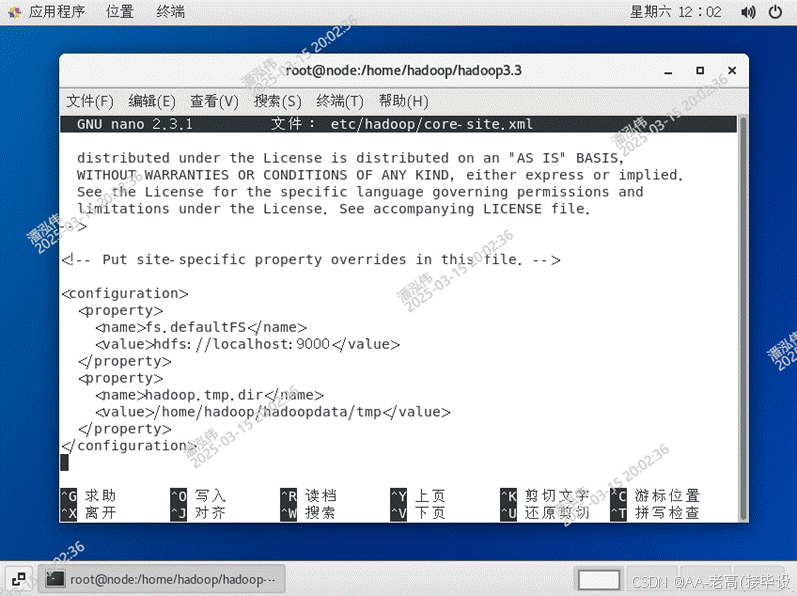
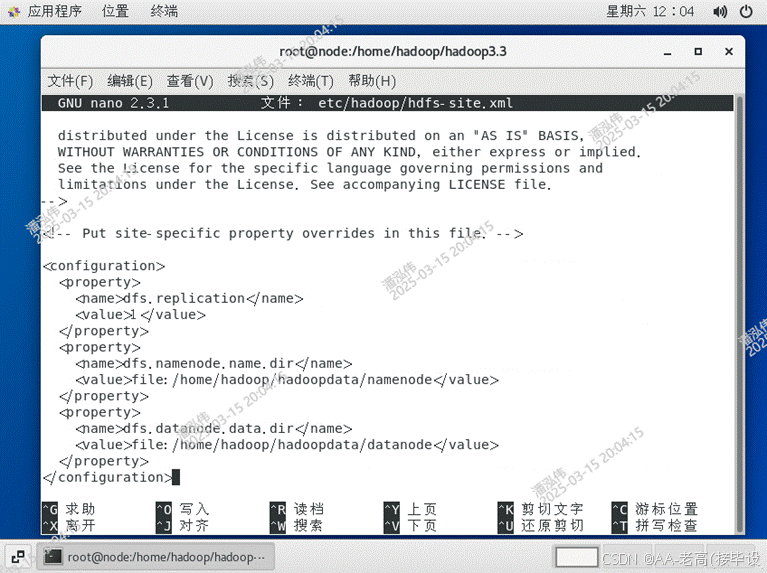
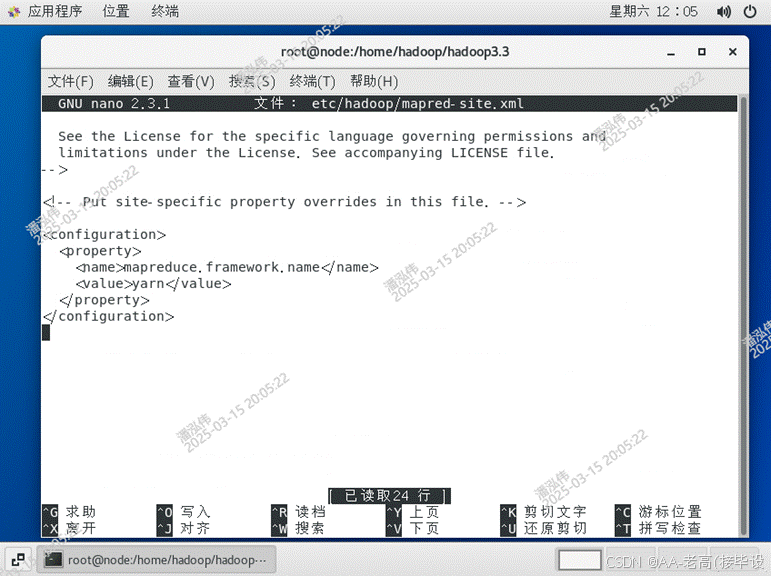
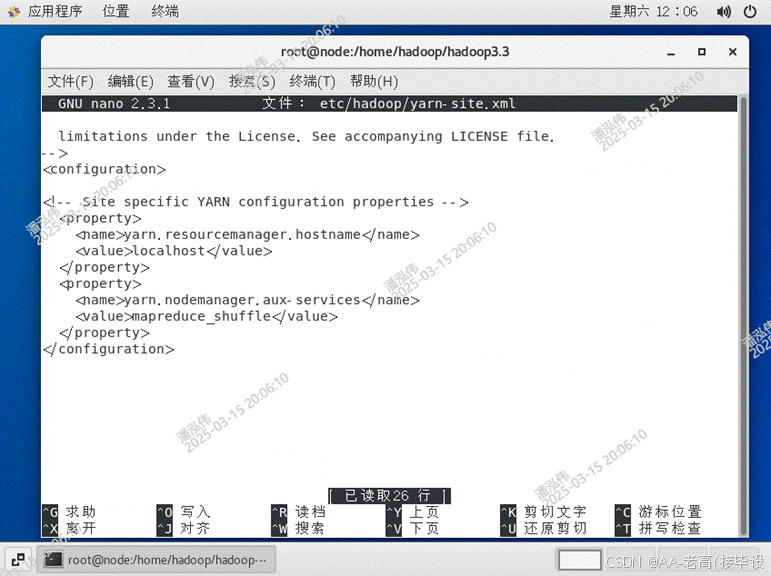
要求:修改 hadoop-env.sh,yarn-env.sh,mapred-env.sh 等文件,设置 JAVA_HOME 路径。修改 core-site.xml,hdfs-site.xml,mapred-site.xml,yarn-site.xml 配置文件,设置 Hadoop 相关参数。
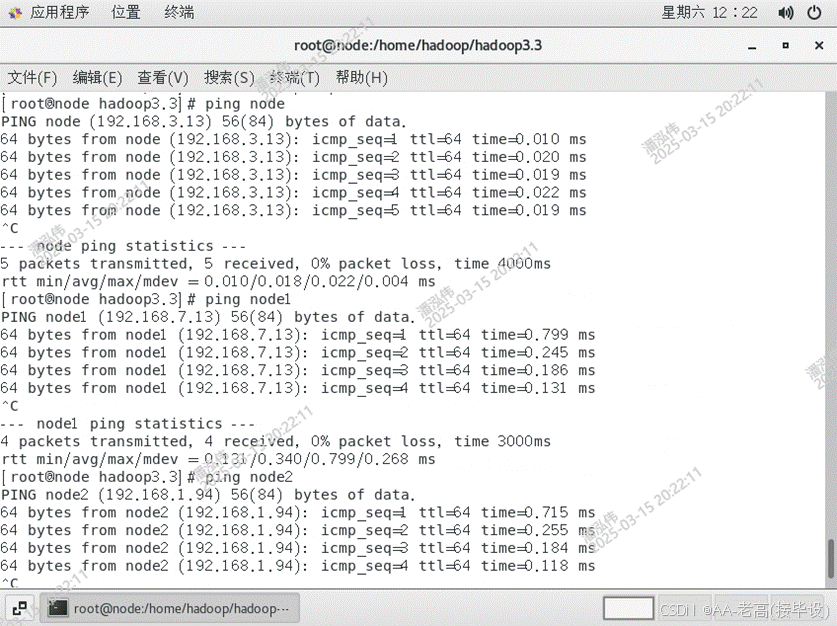
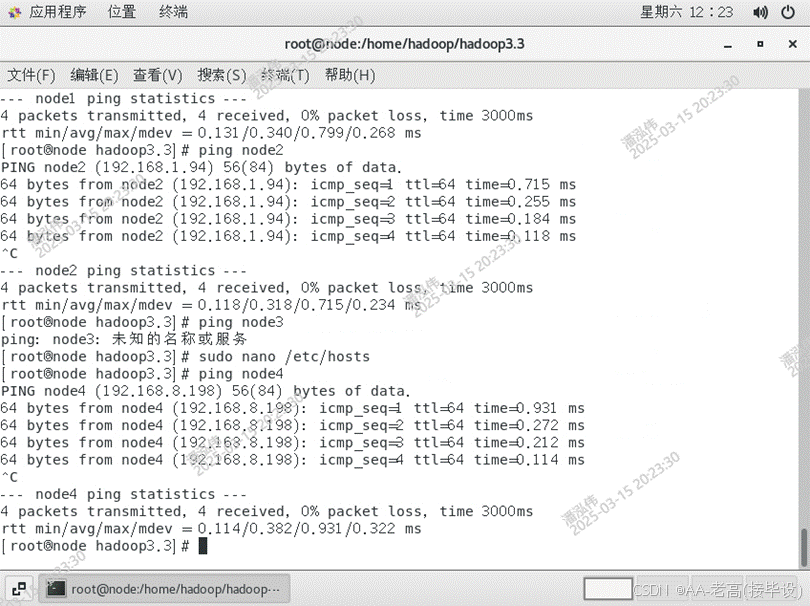
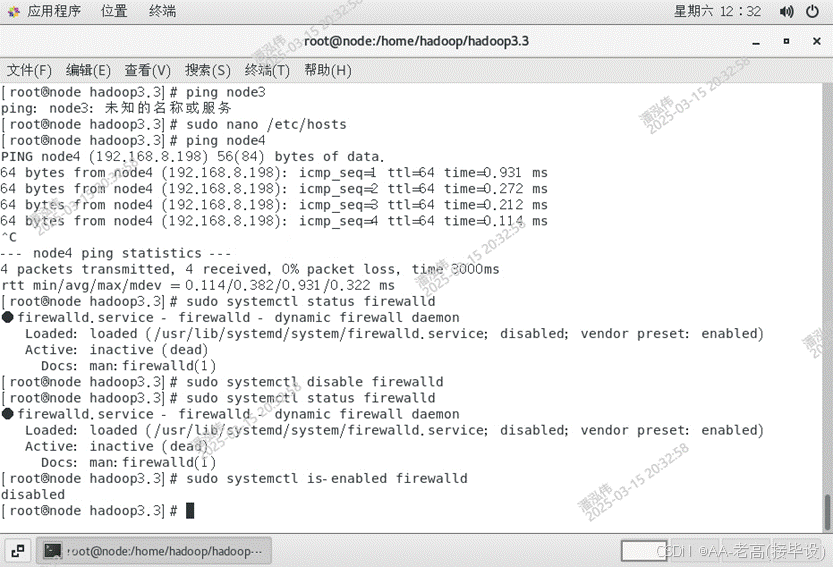
要求:编辑 /etc/hosts 文件,配置 Hadoop 集群节点的 hostname 和 IP 地址。 使用 ping 命令验证各节点网络(node、node1、node2、node3)连通性。
要求:停止防火墙,并设置开机不自动启动,以避免 Hadoop 运行受阻。
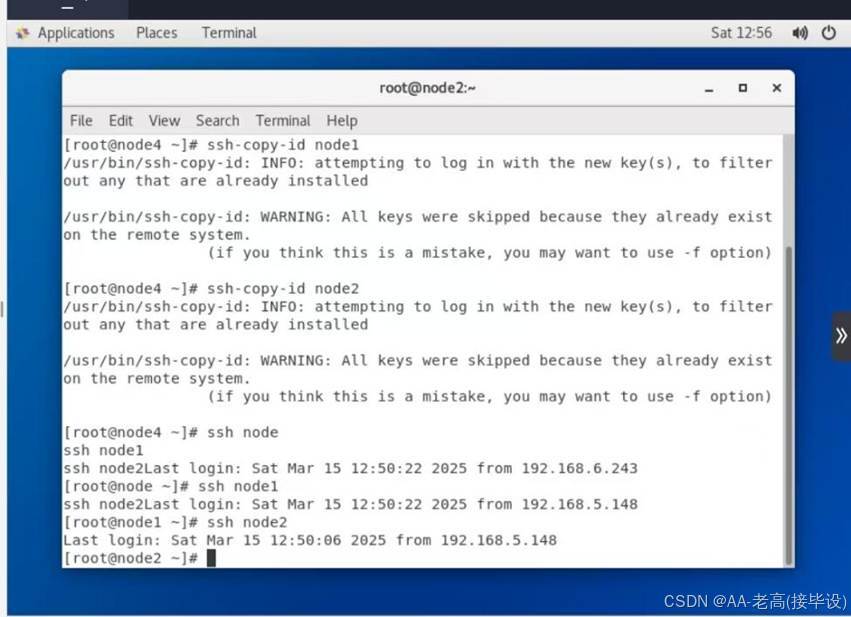
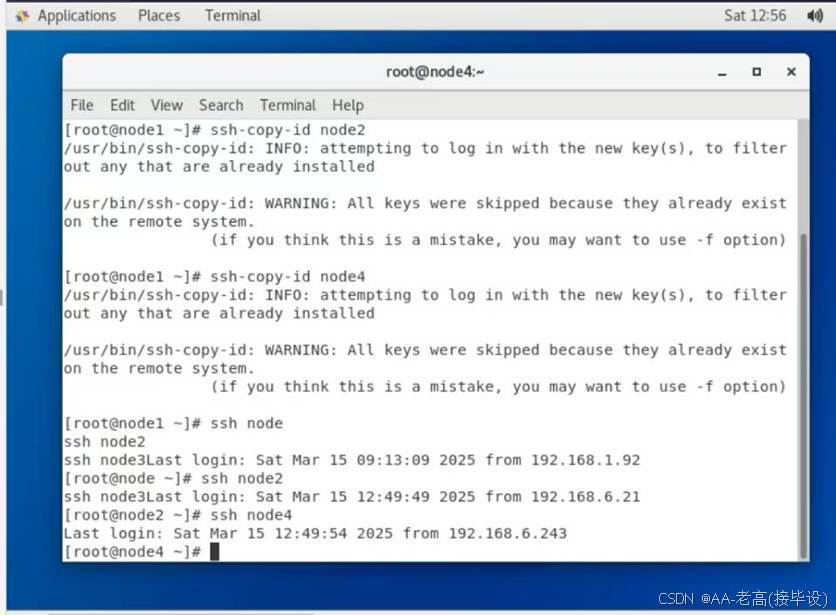
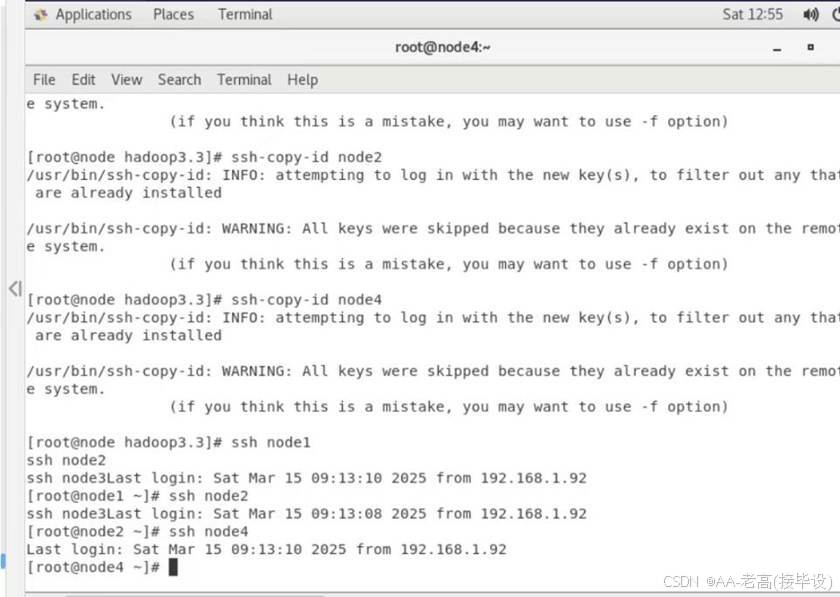
要求:生成 SSH 密钥,node、node1、node2、node3四台机子在虚拟环境不能远程复制,需要每一台进行配置免密登录。
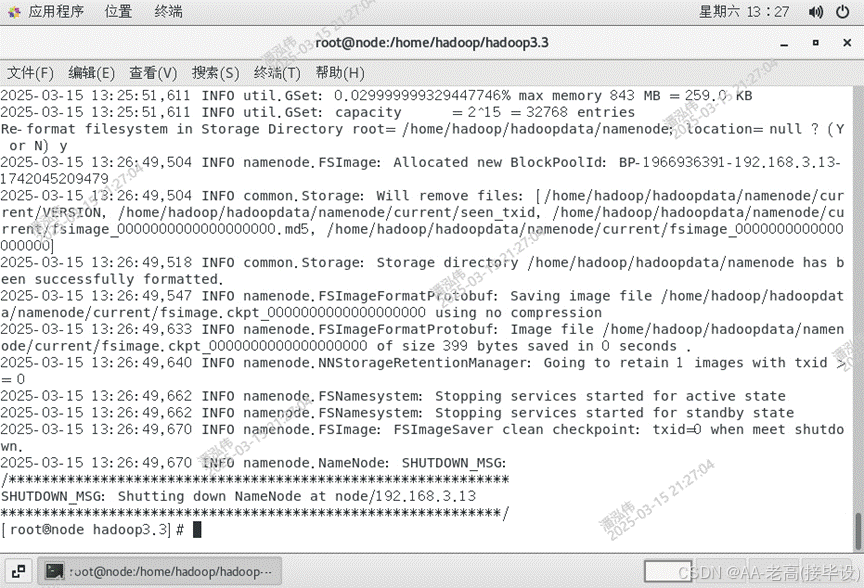
要求:执行格式化命令,初始化 HDFS,并检查是否成功。~
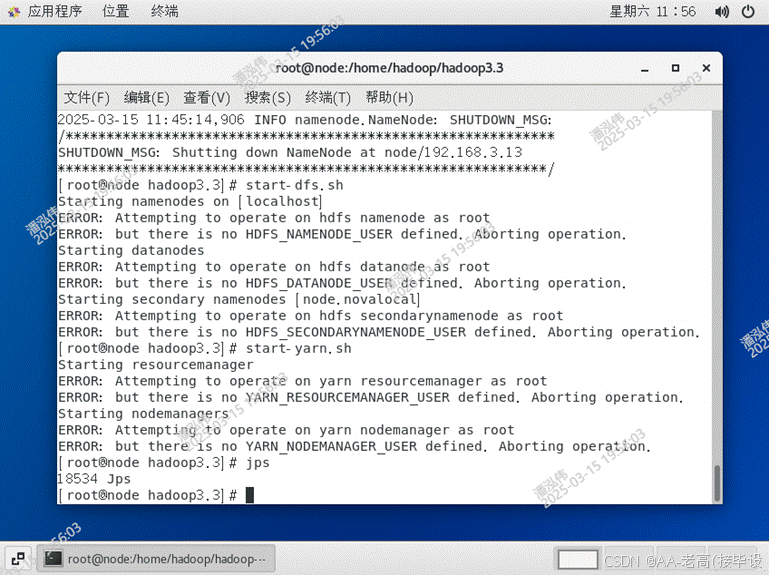
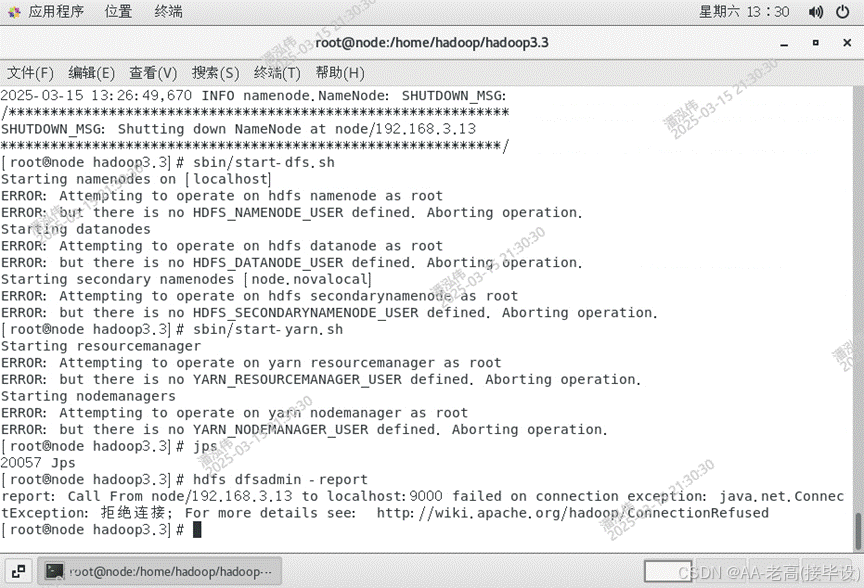
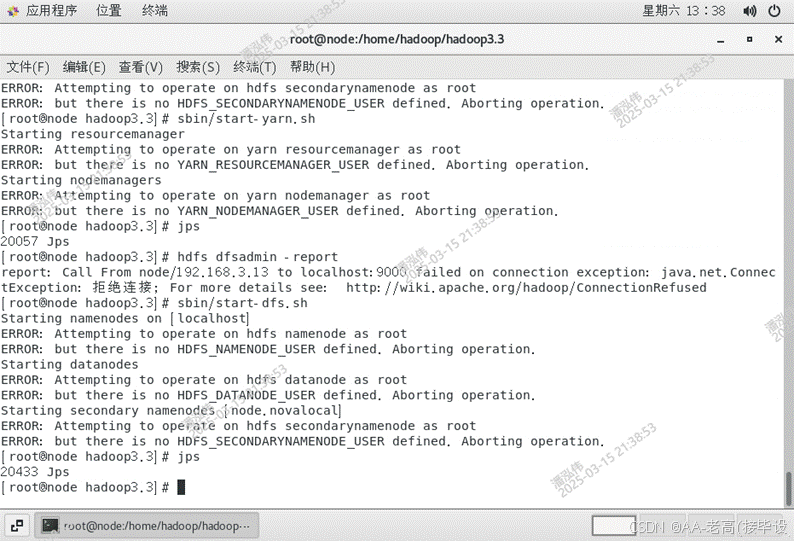
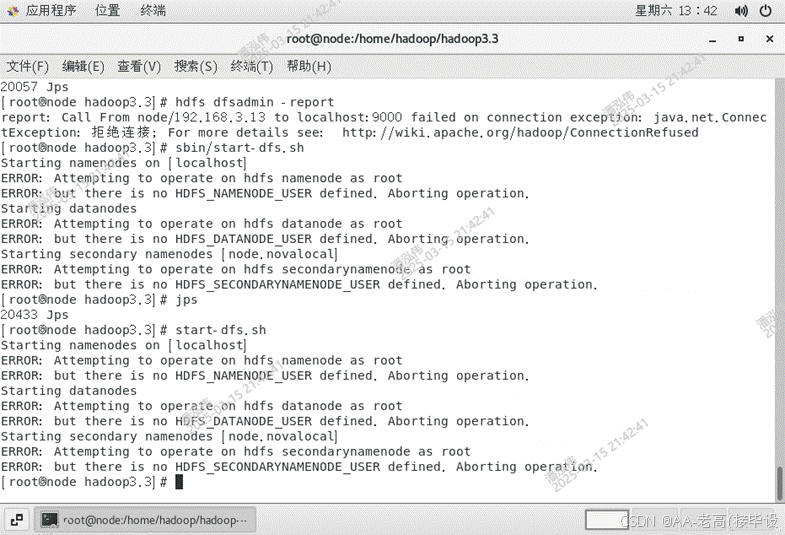
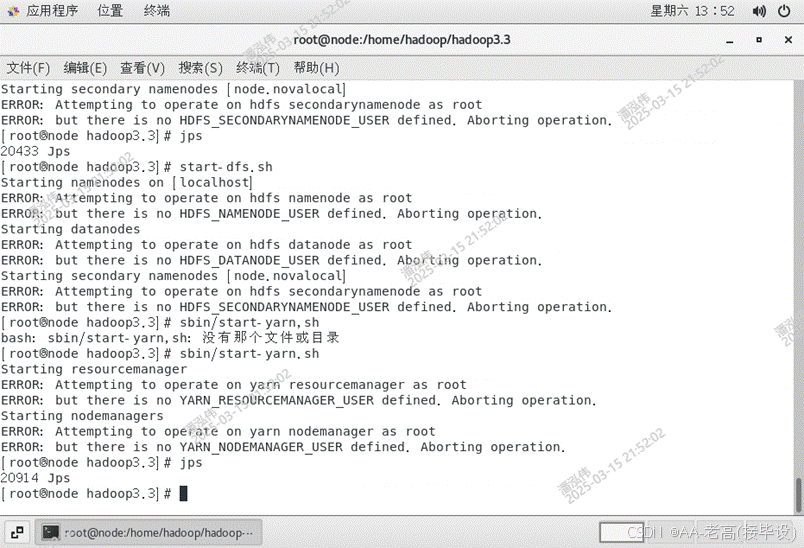
要求:运行 start-dfs.sh 启动 HDFS,并使用 jps 命令检查 HDFS 进程是否正常运行(截图)。
node、node1、node2、node3四台进程如课本28页图2-35所示。(截图)
通告web浏览器验证HDFS的启动状况,课本29页图2-36所示(截图)。
要求:运行 start-yarn.sh 启动 YARN,并使用 jps 命令检查 YARN 进程。ResourceManager 节点启动(截图)
访问 Hadoop Web UI 界面,课本29页图2-37所示(截图)。
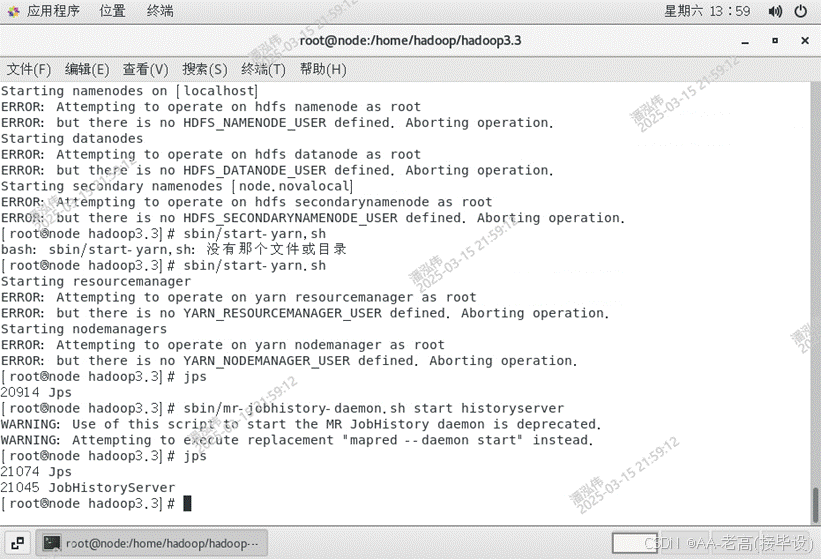
要求:运行 mr-jobhistory-daemon.sh start historyserver 启动 JobHistory Server。并使用 jps 命令检查JobHistoryServe进程。(截图)
访问 Web 界面,课本30页图2-38所示(截图)。 |


北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献7条内容

所有评论(0)