zookeeper集群的选举机制以及数据一致性
一、zookeeper集群
zookeeper的设计目标就是高可用性,那么也就意味着,在使用zookeeper的时候一般都是使用集群而不是单点模式,下面展示zookeeper的集群模式:
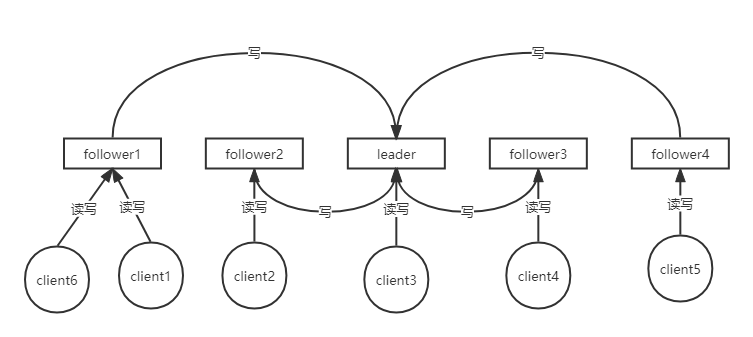
可以看到,zookeeper的集群是主从集群,客户端可以随意与任何zookeeper服务节点进行连接,并且各个客户端都可以进行读写操作,这是一个和redis主从集群的区别,redis的主从集群,如果客户端是写操作,那么只能连接redis的主节点才可以。zookeeper的每个客户端是随机连接到zookeeper服务节点的,并且每个客户端都可以进行读写操作,读操作都是在客户端连接的zookeeper节点进行操作;而写操作是有区别的,如果该客户端连接的是leader节点,那么直接进行写操作;如果该客户端连接的是follower节点,那么zookeeper的服务节点会自动将该写操作转到leader节点进行;zookeeper的集群为主从集群,那么也就意味着主节点只有一个,那么当主节点挂了以后,该zookeeper集群则会处于不可用状态,既然zookeeper的设计目的是高可用,也就意味着当主节点挂了以后,zookeeper会有一定的方式来快速的选出主节点,让服务恢复可用状态(根据zookeeper的官方文档中给出的压测报告,7台zookeeper服务器,选主耗时大概200ms)
二、选举机制
选举的两个重要指标——
zxid:指的是当前节点的事物id,通俗点说就是当前节点完成的数据同步情况,该值越大,越能说明该节点的数据同步情况越完整,丢失数据的情况越小或者丢失数据越少。
myid:这个是在我们创建zk集群的时候给它的赋值。
zookeeper的follower(从)节点和leader(主)节点是通过心跳,来查看服务是否可用。在这其中,只要有有一台follower节点发现leader(主)节点挂掉,他就开始向其它follower节点发送选主请求,整个集群进入选主流程,不再向外提供服务。
先假设现在有4个zookeeper节点:
node1——myid:1
node2——myid:2
node3——myid:3
node4——myid:4
这四个节点选主流程主要分为以下两种情况 :
1.初始启动:在启动阶段时,此时各个服务节点的zxid都为0,只与myid有关。假设启动顺序为node1->node2->node3->node4,当启动动1和2的时候,该zookeeper集群是不可用状态,因为zookeeper的选主必须是过半服务节点同意(包含自己),最低需要启动三个节点才可以进行选举,因此只有node1和node2启动的时候,此时只有两台服务,不满足条件,当第三台节点启动以后,才满足了选主的最低条件,然后进入到选举流程,因为node3的myid最大,所以此时3号节点为leader,然后启动node4,由于此时已经选举出3位leader节点并且过半通过,则不再选取新的主节点。则该集群的leader节点为node3。
2.运行过程中:初始启动过程中的leader(node3)节点挂掉,假设此时只有node4节点发现leader已经挂掉,node1和node2的zxid都是10,node4的zxid为9,选主的时候需要比较zxid和myid,需要注意他们的优先级,zxid为第一优先级,myid为第二优先级,选举流程大致分为以下几步:
1)node4节点给自己投票,然后将自己的zxid和myid发送给node1和node2节点;
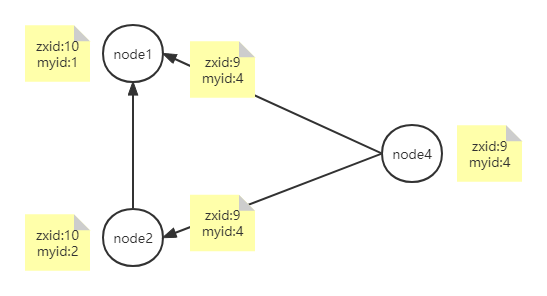
2)node1和node2通过比较zxid和myid,发现node4不能成为leader节点,将各自的zxid和myid发送给node4,然后node4接收到以后,发现node1和node2都比自己适合成为leader节点,会给它们进行投票;
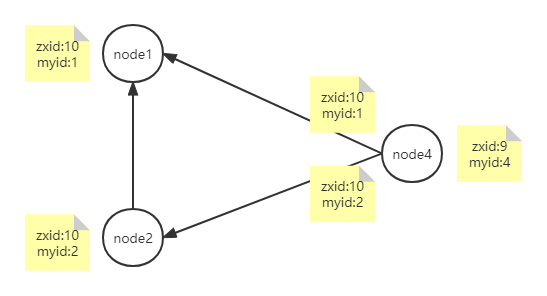
3)node1和node2反驳完node4的选主请求以后,开始进行各自的选主流程,起过程与node4的过程一致,通过上面的优先级,我们可以知道最终node2会成为leader节点,那么以node2为例说一下接下来的流程。node2首先给自己投票,然后将自己zxid和myid推送给node1和node4,此时会发现node2适合成为主节点,则会给node2节点进行投票,最终选出node2成为主节点,zookeeper集群恢复成可用状态;
三、数据一致性
zookeeper服务一般上是以集群状态提供服务,多个zookeeper节点之间的数据一致性是通过zap(原子广播)协议来保证的。zookeeper的数据一致性为最终一致性,需要注意的是它不是实时的,比如node1,node2,node3,其中node3为leader,node1和node2为follower,当node1进行节点创建以后,leader节点肯定为实时更新,但是follower节点不一定为实时更新,因为只要过半通过就算节点已经创建成功,可能会有的节点当前的数据还不是最终态,但是它的更新指令是存在,只是可能还没执行。我们的客户端如果想要读取最终态的数据,那么可以通过使用上面的sync命令,来获取最终数据。
流程图——
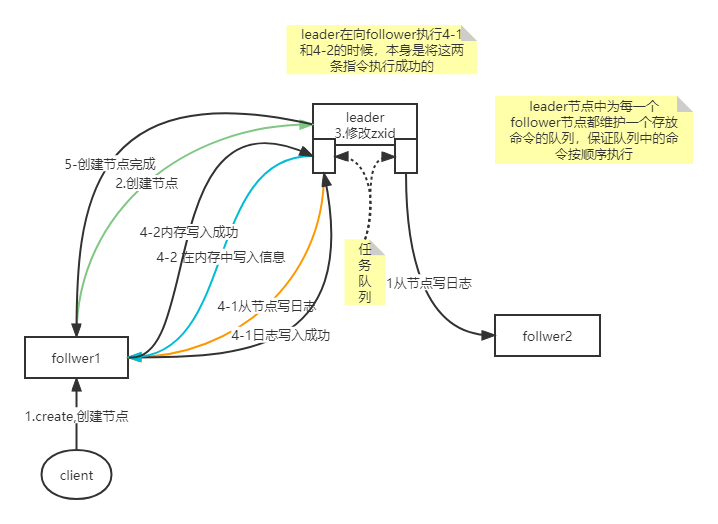
1)首先由客户端发送创建节点的指令给到zookeeper集群的节点,假设发送到zookeeper集群的follower1节点;
2)follower1节点发现是写操作节点,则将该指令通过2888端口转发到leader节点执行;
3)leader节点更新自己zxid信息,也就是事务id信息;
4)leader节点先将创建节点信息同步到log日志中,然后在follower1和follower2各自的队列中放入创建节点写日志的指令,当follower节点接收到指令以后,执行写日志操作,写入日志成功以后,告诉leader写入完成;leader会判断目前是否已经有过半的节点(包含自己)已经写入完成,如果完成,则先在自己的内存中创建节点,然后将在follower对应的节点中加入在内存中创建节点的指令,然后follower接收到指令以后进行内存操作,操作完成以后告诉leader写入完成,同样需要过半完成;
5)将创建结束的消息返回给调用的follower,然后返回给客户端,节点创建结束。
(上面步骤中的第四步其实就是对原子广播协议的一个大致解释,原子广播协议可以看成两部分,首先原子就代表这只有成功或者失败,没有中间状态;而广播就是并不意味着所有节点都完成相关操作才算完成,只要过半数节点是成功的,那么本次操作就算成功完成了。在第四步中提到的队列就是对最终一致性的一个解释,leader会将所有指令按照顺序放入每个follower对应的队列中,每个follower按顺序去执行队列中的指令,达到一个最终一致性的结果)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 33
 0
- 0


 已为社区贡献2条内容

所有评论(0)