最新基准测试:Kafka、Pulsar-和-RabbitMQ-哪个最快,2024年最新分享面经
Disk 1
dd if=/dev/zero of=/mnt/data-1/test bs=1M count=65536 oflag=direct
65536+0 records in
65536+0 records out
68719476736 bytes (69 GB) copied, 210.278 s, 327 MB/s
Disk 2
dd if=/dev/zero of=/mnt/data-2/test bs=1M count=65536 oflag=direct
65536+0 records in
65536+0 records out
68719476736 bytes (69 GB) copied, 209.594 s, 328 MB/s
OS 调优
此外,对于所比较的三个系统,为了获得更好的延迟性能,我们使用 tune -adm 的延迟性能配置文件对操作系统进行了调优,它会禁用磁盘和网络调度器的任何动态调优机制,并使用性能调控器进行 CPU 频率调优。它将每个内核的 p-state 固定在可能的最高频率上,并将 I/O 调度器设置为 deadline,从而提供一个可预测的磁盘请求延迟上限。最后,它还优化内核中的电源管理服务质量(QoS),这是为了提高性能,而不是省电。
内存
与 OMB 中的默认实例相比,i3en.2xlarge测试实例物理内存几乎是前者的一半(64 GB vs. 122 GB)。优化 Kafka 和 RabbitMQ 使其与测试实例兼容非常简单。两者都主要依赖于操作系统的页面缓存,随着新实例的出现,页面缓存会自动缩小。
然而,Pulsar 代理以及 BookKeeper bookie 都依赖于堆外 / 直接内存缓存,为了使这两个独立进程可以在i3en.2xlarge实例上良好地运行,我们调整了 JVM 堆 / 最大直接内存大小。具体来说,我们将堆大小从每个 24 GB(原始的 OMB 配置)减半为每个 12 GB,在两个进程和操作系统之间按比例划分了可用物理内存。
在测试中,当目标吞吐量比较高时,我们遇到了java.lang.OutOfMemoryError: Direct buffer memory错误,如果堆大小再低一点,就会导致 bookie 完全崩溃。这是使用堆外内存的系统所面临的典型的内存调优问题。虽然直接字节缓冲区是避免 Java GC 的一个有吸引力的选项,但是大规模使用是一个颇具挑战性的做法。
5、吞吐量测试
我们开始测量的第一件事是,在网络、磁盘、CPU 和内存资源数量相同的情况下,每个系统可以实现的峰值稳定吞吐量。我们将稳定峰值吞吐量定义为消费者在不增加积压的情况下可以跟得上的最高平均生产者吞吐量。
fsync 的效果
如前所述,Apache Kafka 的默认建议配置是使用底层操作系统指定的页面缓存刷新策略(而不是同步地 fsync 每个消息)flush/fsync 到磁盘,并依赖复制来实现持久性。从根本上说,这提供了一种简单而有效的方法来分摊 Kafka 生产者所使用的不同批次大小的成本,在各种情况下都可以实现最大可能的吞吐量。如果 Kafka 被配置为每次写时 fsync,那么我们就会因强制进行 fsync 系统调用而人为地妨碍了性能,并且没有获得任何额外的好处。
也就是说,考虑到我们将要讨论这两种情况的结果,我们仍然有必要了解在 Kafka 中每次写时 fsync 的影响。各种生产者批次大小对 Kafka 吞吐量的影响如下所示。吞吐量随着批次大小的增加而增加,直到到达“最佳点”,即批次大小足以让底层磁盘完全饱和。在批次大小较大时,将 Kafka 上的每条消息 fsync 到磁盘(图 2 中的橙色条)可以产生类似的结果。注意,这些结果仅在所述实验平台的 SSD 上得到了验证。Kafka 确实在所有批次大小上都充分利用了底层磁盘,在批次大小较小时最大化 IOPS,在批次大小较大时最大化磁盘吞吐量,甚至在强制 fsync 每条消息时也是如此。
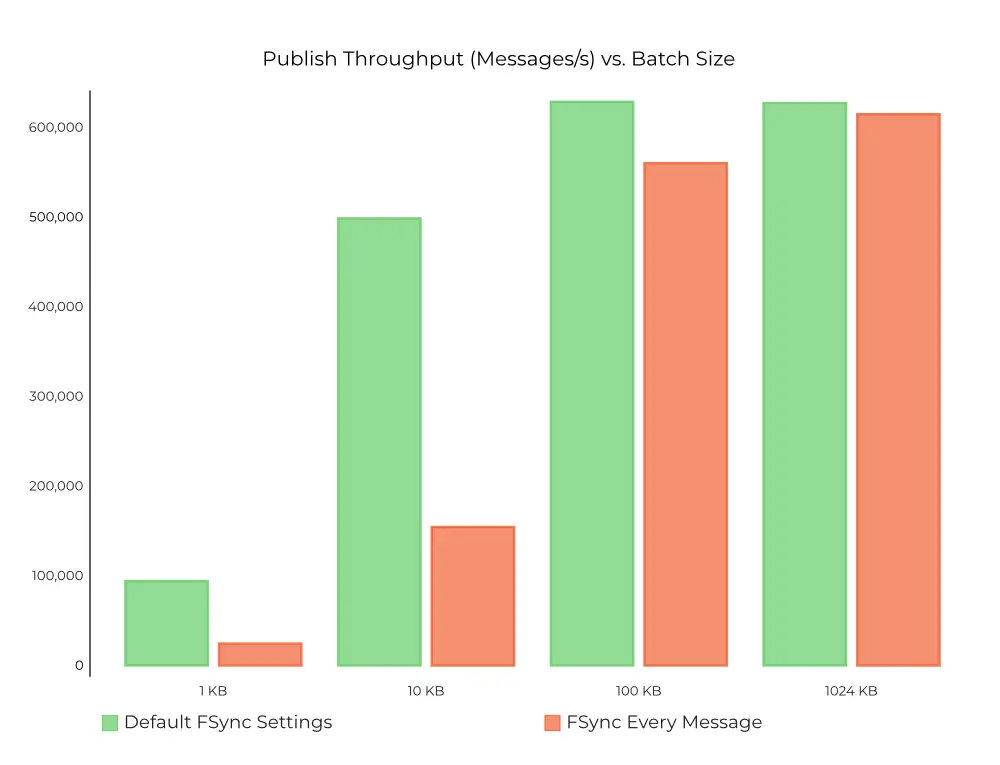
图 2:批次大小对 Kafka 吞吐量(每秒消息数)的影响,绿条表示 fsync=off(默认),橙条表示 fsync 每条消息
从上图可以明显看出,使用默认的 fsync 设置(绿条)可以让 Kafka 代理更好地管理 page flush,从而提供更好的总体吞吐量。特别是,在生产者批次大小较小(1 KB 和 10 KB)时,使用默认同步设置的吞吐量比 fsync 每条消息的吞吐量高 3 到 5 倍。然而,批次较大(100 KB 和 1 MB)时,fsync 的成本被均摊了,吞吐量与默认 fsync 设置相当。
Pulsar 在生产者上实现了类似的批次,并在 bookie 间对产生的消息进行 quoro 风格的复制。BookKeeper bookie 在应用程序级实现分组提交 / 同步到磁盘,以最大化磁盘吞吐量。在默认情况下(由 bookie 配置journalSyncData=true控制),BookKeeper 会将写入 fsync 到磁盘。
为了覆盖所有的情况,我们测试 Pulsar 时在 BookKeeper 上设置了journalSyncData=false,并与 Kafka 的默认(建议)设置(不对每条消息进行 fsync)进行了比较。但是,我们在 BookKeeper bookie 上遇到了大量延迟和不稳定性,表明存在与 flush 相关的队列等待。我们还用 Pulsar 提供的工具pulsar-perf验证到了同样的行为。据我们所知,在咨询了 Pulsar 社区后,这似乎是一个 Bug,所以我们选择从我们的测试中排除它。尽管如此,考虑到我们可以看到磁盘在journalSyncData=true时吞吐量达到最大,我们相信它无论如何都不会影响最终结果。
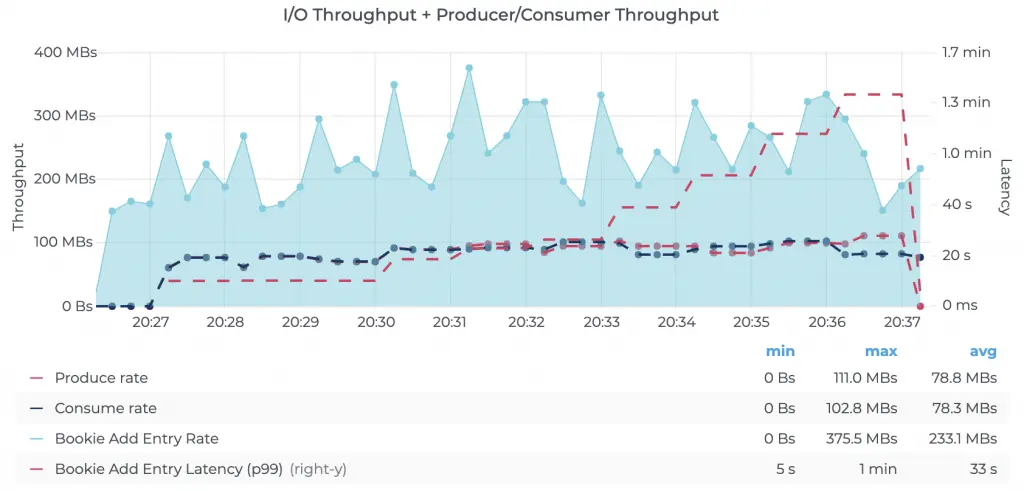
图 3:Pulsar 在 BookKeeper 设置了journalSyncData=true时,吞吐量明显下降,并且出现了延迟峰值
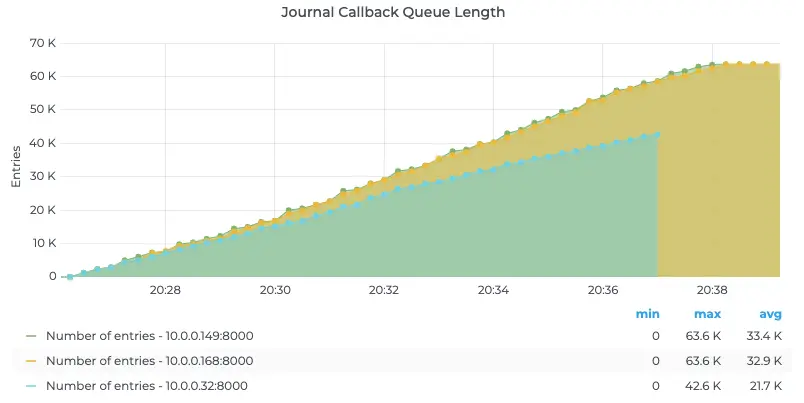
图 4:BookKeeper journal 回调队列在journalSyncData=false设置下的增长情况
当且仅当消息尚未被消费时,RabbitMQ 会使用一个持久队列将消息持久化到磁盘。然而,与 Kafka 和 Pulsar 不同,RabbitMQ 不支持“回放”队列来再次读取较旧的消息。从持久性的角度来看,在我们的基准测试中,消费者与生产者保持同步,因此,我们没有注意到任何写入磁盘的操作。我们还在一个三代理集群中使用了镜像队列,使 RabbitMQ 提供与 Kafka 和 Pulsar 相同的可用性保证。
测试设置
本实验按照以下原则和预期保证进行设计:
-
为了实现容错,消息复制 3 份(具体配置见下文);
-
为了优化吞吐量,我们启用了所有三个系统的批处理。我们的批处理是 1MB 数据最多 10 毫秒;
-
为 Pulsar 和 Kafka 的一个主题配置了 100 个分区;
-
RabbitMQ 不支持主题分区。为了匹配 Kafka 和 Pulsar 的设置,我们声明了一个 direct exchange(相当于主题)和链接队列(相当于分区)。关于这个设置的更多细节见下文。
OMB 使用一个自动速率发现算法。该算法通过以多个速率探测积压来动态地获取目标生产者的吞吐量。在许多情况下,我们看到速率在每秒 2 条消息到每秒 50 万条消息之间剧烈波动。这严重影响了实验的可重复性和准确性。在我们的实验中,我们没有使用该特性,而是显式地配置了目标吞吐量,并按每秒 10K、50K、100K、200K、500K 和 100 万条生产者消息的顺序稳步提高目标吞吐量,四个生产者和四个消费者都使用 1 KB 的消息。然后,我们观察了每个系统在不同配置下提供稳定端到端性能的最大速率。
吞吐量结果
我们发现,Kafka 在我们所比较的系统中吞吐量最高。考虑到它的设计,产生的每个字节都只在一个编码路径上写入磁盘一次,而这个编码路径已经被世界各地的数千个组织优化了近十年。我们将在下面更详细地研究每个系统的这些结果。
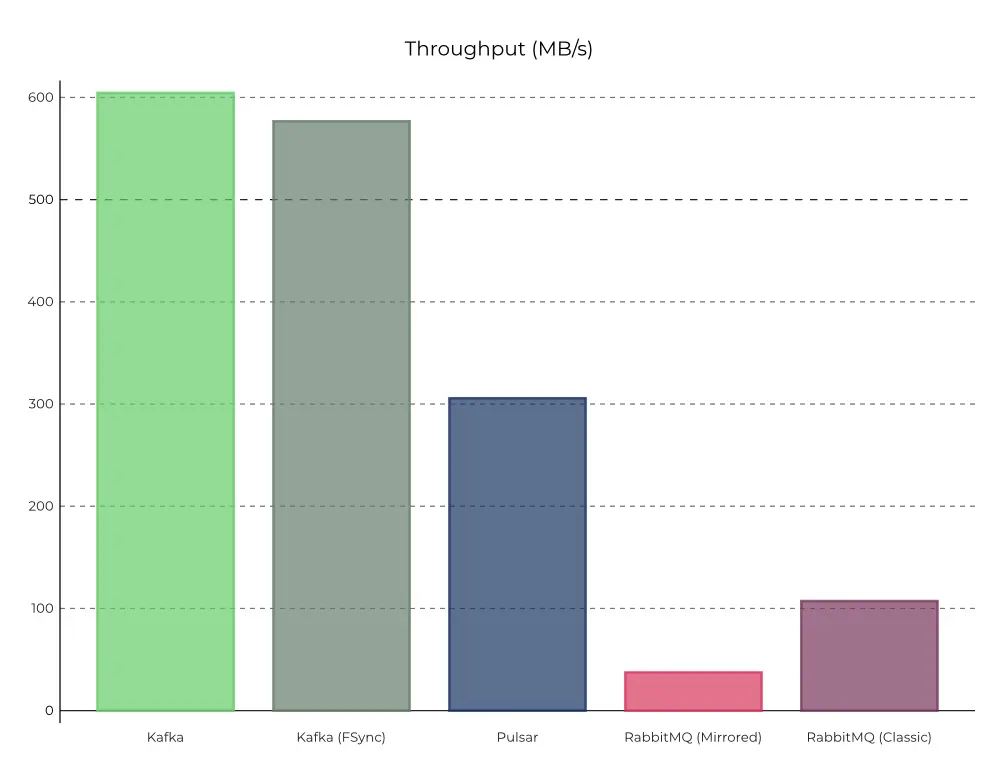
图 5:比较这三个系统的峰值稳定吞吐量:100 个主题分区,1 KB 消息,使用 4 个生产者和 4 个消费者
我们将 Kafka 配置为batch.size=1MB和linger.ms=10,以便生产者可以有效地对发送给代理的写操作进行批处理。此外,我们在生产者中配置了acks=all和min.insync.replicas=2,确保在向生产者返回确认之前每条消息至少复制到两个代理。我们发现,Kafka 能够有效地最大限度地使用每个代理上的磁盘——这是存储系统的理想结果。
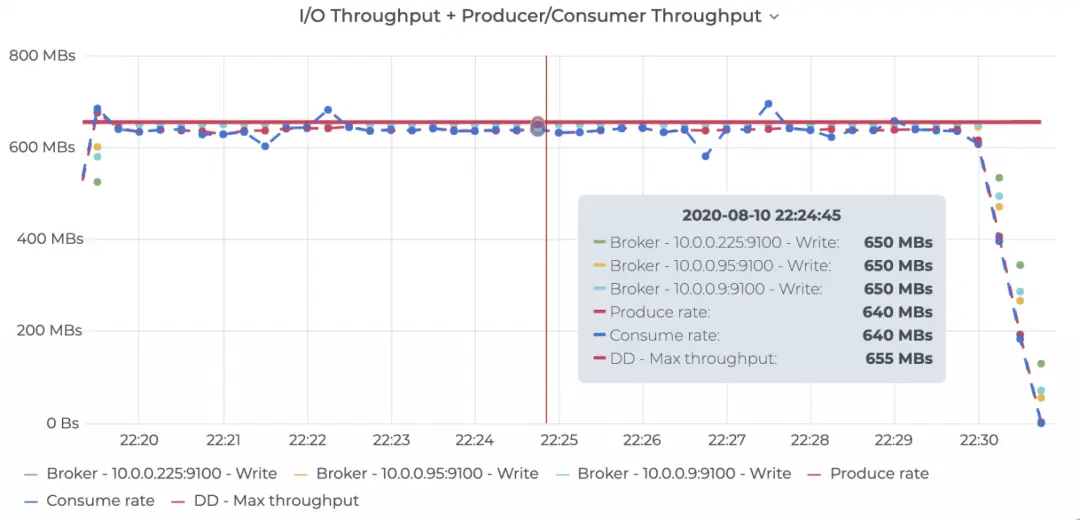
图 6:使用默认推荐 fsync 设置的 Kafka 性能。该图显示了 Kafka 代理上的 I/O 利用率和相应的生产者 / 消费者吞吐量(来源:Prometheus 节点指标)。
我们还采用另一种配置对 Kafka 进行了基准测试,即在确认写操作之前使用flush.messages=1和flush.ms=0在所有副本上将每条消息 fsync 到磁盘。结果如下图所示,非常接近默认配置。
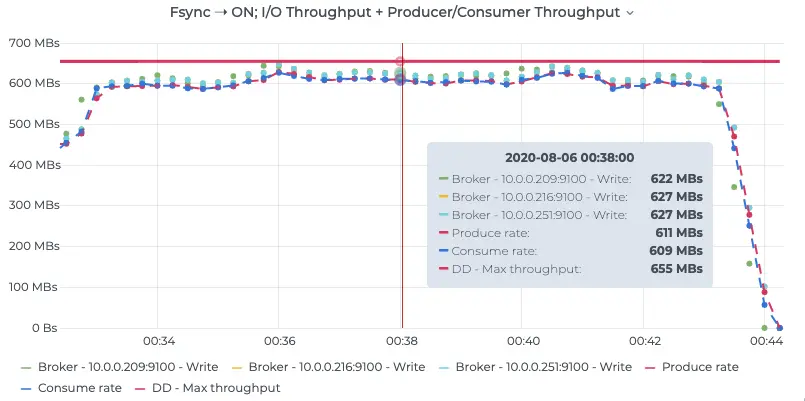
图 7:Prometheus 节点指标显示 Kafka 代理上的 I/O 利用率以及相应的生产者 / 消费者吞吐量。
在生产请求排队方面,Pulsar 的生产者与 Kafka 的工作方式不同。具体来说,它内部有每个分区的生产者队列,以及对这些队列的大小限制,对来自给定生产者的所有分区的消息数量设置了上限。为了避免 Pulsar 生产者在发送消息的数量上遇到瓶颈,我们将每个分区和全局限制均设置为无穷大,同时匹配基于 1 MB 字节的批处理限制。
.batchingMaxBytes(1048576) // 1MB
.batchingMaxMessages(Integer.MAX_VALUE)
.maxPendingMessagesAcrossPartitions(Integer.MAX_VALUE);
我们还为 Pulsar 提供了更高的基于时间的批处理限制,即batchingMaxPublishDelayMs=50,以确保批处理主要是由字节限制引起的。我们通过不断增加这个值,直到它对 Pulsar 最终达到的峰值稳定吞吐量没有可测量的影响。对于复制配置,我们使用了ensemble blesize =3、writeQuorum=3、ackQuorum=2,这与 Kafka 的配置方式相当。在 BookKeeper 的设计中,bookie 将数据写入 journal 和 ledger 中,我们注意到,峰值稳定吞吐量实际上是 Kafka 所能达到的吞吐量的一半。我们发现,这种基本的设计选择对吞吐量有深远的负面影响,直接影响了开销。一旦 BookKeeper bookie 的 journal 磁盘完全饱和,Pulsar 的生产者速率就会被限制在那个点上。
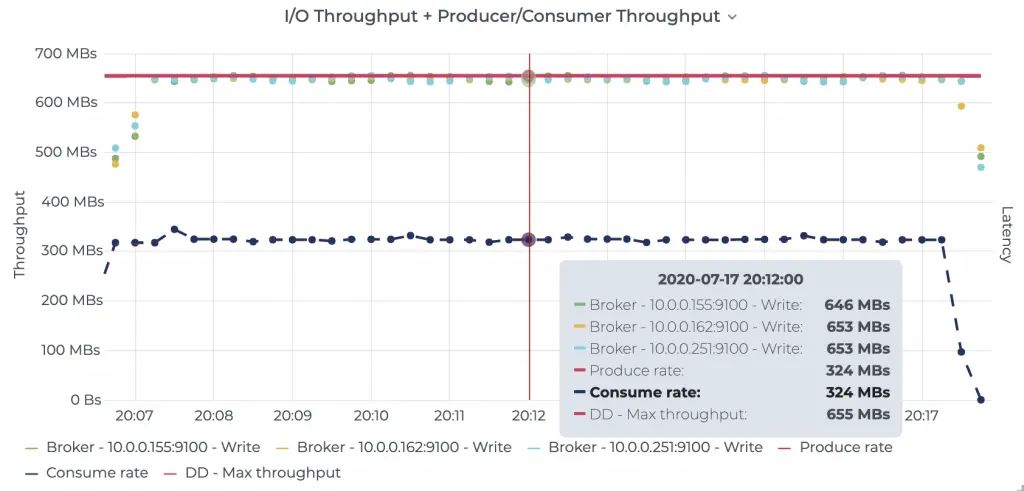
图 8:Prometheus 节点指标显示了 BookKeeper journal 磁盘达到极限和最终在 BookKeeper bookie 上测得的吞吐量。
为了进一步验证这一点,我们还配置 BookKeeper 在 RAID 0 配置 中使用两个磁盘,这为 BookKeeper 提供了将 journal 和 ledger 写操作分到两个磁盘上的机会。我们观察到,Pulsar 最大限度地利用了磁盘的联合吞吐量(~650 MB/s),但峰值稳定吞吐量仍然限制在 ~340 MB/s。
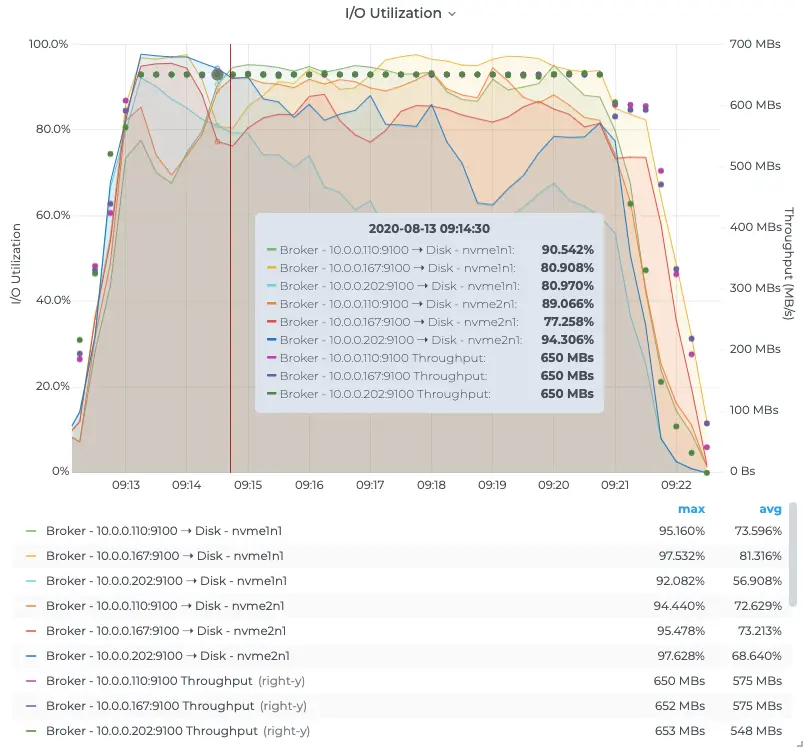
图 9:Prometheus 节点指标显示,BookKeeper journal 磁盘在 RAID 0 配置下仍然达到极限
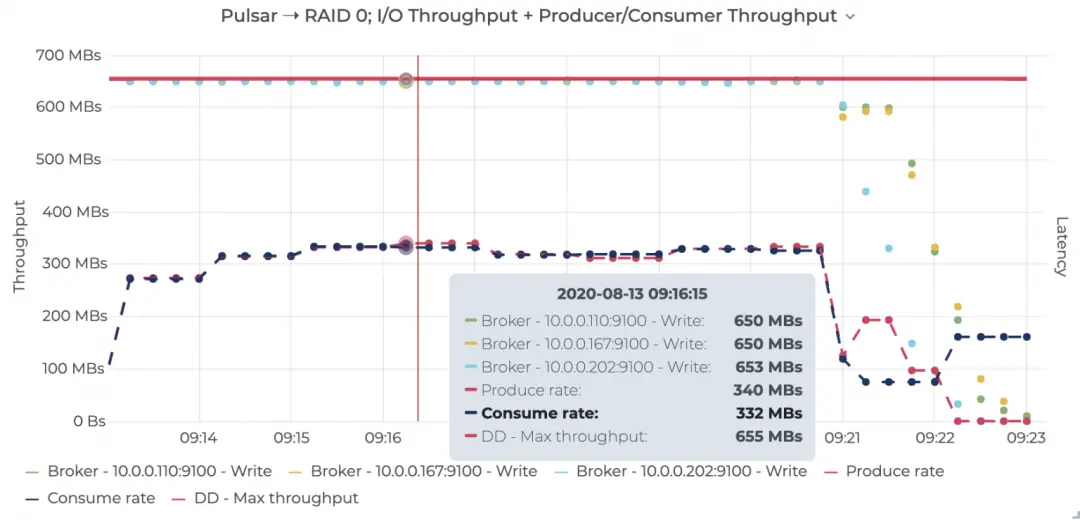
图 10:Prometheus 节点指标显示,RAID 0 磁盘已达到极限,以及最终在 Pulsar 代理上测得的吞吐量。
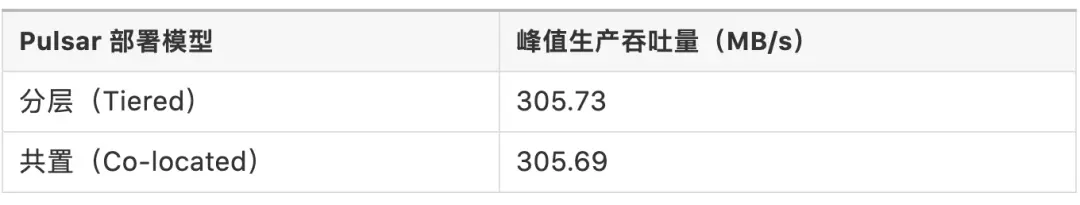
Pulsar 有一个分层架构,将 BookKeeper bookie(存储)与 Pulsar 代理(存储的缓存 / 代理)分开。出于完整性考虑,我们也在分层部署中运行了上述吞吐量测试,将 Pulsar 代理移到了另外三个计算优化的c5n.2xlarge实例上(8 vCores, 21 GB RAM, Upto 25 Gbps network transfer, EBS-backed storage)。BookKeeper 节点仍在存储优化的i3en.2xlarge实例上。这使得在这个特殊的设置中,Pulsar 和 BookKeeper 总共有 6 个实例 / 资源,比 Kafka 和 RabbitMQ 多了 2 倍 的 CPU 资源和 33% 的内存。
即使在高吞吐量下,系统也主要受到 I/O 限制,而且我们没有发现这种设置带来任何提升。该特定运行的完整结果见下表。事实上,Pulsar 的两层架构似乎只是增加了开销——两个 JVM 占用了更多的内存、两倍的网络传输以及系统架构中更多的移动部件。我们预计,当网络受到限制时(不像我们的测试提供了过剩的网络带宽),Pulsar 的两层架构将以两倍的速度耗尽网络资源,进而降低性能。
与 Kafka 和 Pulsar 不同的是,RabbitMQ 在主题中没有分区的概念。相反,RabbitMQ 使用 exchange 将消息路由到链接队列,使用头属性(header exchange)、路由键(direct 和 topic exchange)或绑定(fanout exchange),消费者可以从中处理消息。为了匹配工作负载的设置,我们声明了一个 direct exchange(相当于主题)和链接队列(相当于分区),每个队列专用于为特定的路由键提供服务。端到端,我们让所有生产者用所有路由键(轮询)生成消息,让消费者专门负责每个队列。我们还按照社区建议的最佳实践 优化了 RabbitMQ:
-
启用复制(将队列复制到集群中的所有节点)
-
禁用消息持久化(队列仅在内存中)
-
启用消费者自动应答
-
跨代理的负载均衡队列
-
24 个队列,因为在 RabbitMQ 中,每个队列使用一个专用的内核(8 个 vCPUx 3 个代理)
RabbitMQ 在复制开销方面表现不佳,这严重降低了系统的吞吐量。我们注意到,在此工作负载期间,所有节点都是 CPU 密集型的(见下图右侧 y 轴绿线),几乎没有留出任何余地来代理任何其他消息。
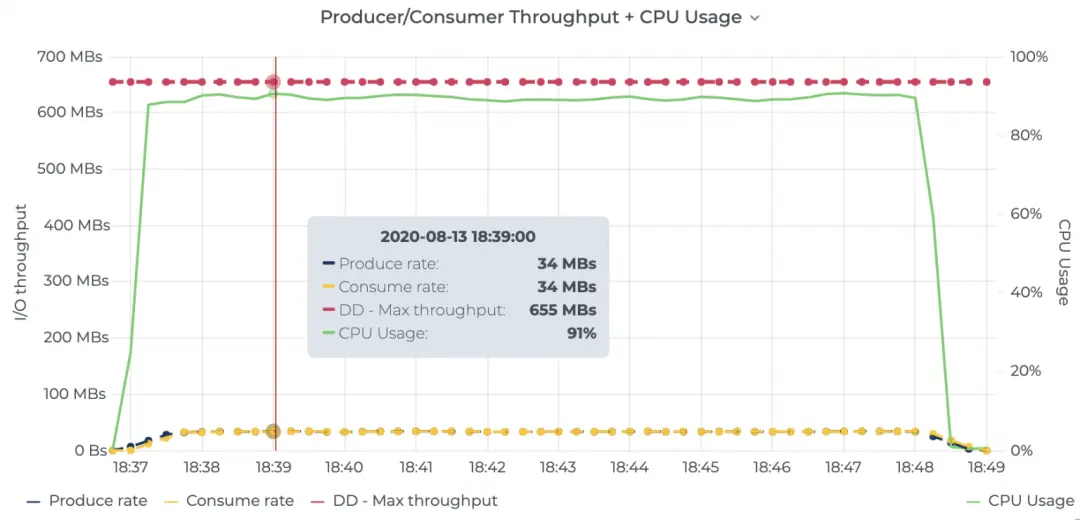
图 11:RabbitMQ 吞吐量 + CPU 使用率。
6、延迟测试
自我介绍一下,小编13年上海交大毕业,曾经在小公司待过,也去过华为、OPPO等大厂,18年进入阿里一直到现在。
深知大多数软件测试工程师,想要提升技能,往往是自己摸索成长或者是报班学习,但对于培训机构动则几千的学费,着实压力不小。自己不成体系的自学效果低效又漫长,而且极易碰到天花板技术停滞不前!
因此收集整理了一份《2024年软件测试全套学习资料》,初衷也很简单,就是希望能够帮助到想自学提升又不知道该从何学起的朋友,同时减轻大家的负担。
既有适合小白学习的零基础资料,也有适合3年以上经验的小伙伴深入学习提升的进阶课程,基本涵盖了95%以上软件测试开发知识点,真正体系化!
由于文件比较大,这里只是将部分目录大纲截图出来,每个节点里面都包含大厂面经、学习笔记、源码讲义、实战项目、讲解视频,并且后续会持续更新
如果你觉得这些内容对你有帮助,可以添加V获取:vip1024b (备注软件测试)
一个人可以走的很快,但一群人才能走的更远。不论你是正从事IT行业的老鸟或是对IT行业感兴趣的新人,都欢迎扫码加入我们的的圈子(技术交流、学习资源、职场吐槽、大厂内推、面试辅导),让我们一起学习成长!
注软件测试)**
[外链图片转存中…(img-8jLCtlCM-1712778739350)]
一个人可以走的很快,但一群人才能走的更远。不论你是正从事IT行业的老鸟或是对IT行业感兴趣的新人,都欢迎扫码加入我们的的圈子(技术交流、学习资源、职场吐槽、大厂内推、面试辅导),让我们一起学习成长!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 20
 0
- 0


 已为社区贡献8条内容

所有评论(0)