linux工具——神奇的正则表达式
Hi, 我是小萝卜算子
近来有小伙伴私信我,说grep配合正则更无敌,但是正则总记不住,能不能整一个简单的参考,有需求必须安排一章
一、介绍
正则表达式是对字符串和特殊字符操作的一种逻辑公式,做开发的或多或少都接触过正则,其在检索匹配和替换领域能发挥超乎寻常的作用,掌握好正则表达式往往能达到事半功倍的效果,详情请看下文
二、常用字符
匹配符 (只列出常用的)
| ^: 匹配字符串开始,在方括号内标识非,即排除 $: 匹配字符串结束 []: 匹配括号中的任一字符 [a-z] 匹配a-z ; [^A-Z] 不匹配A-Z; . : 匹配除换行符之外所有的数据 \d(D): 匹配(非)数字 \w(W): 匹配(非)数字、字母以及下滑线 \s(S) : 匹配(非)空格、换行符 \r -- \n -- \t: 回车 -- 换行 -- 制表符 \b(B): 匹配单词的(非)边界 |
eg:
匹配以a或者b或者c开头的数据
echo 'abcd' | grep -P '^(a|b|c)'
因为是单字符所以还可改为
echo 'abcd' | grep -P '^[abc]'
限定符
| {n}: 次数=n {n,}: 次数>=n {n,m}: m>=次数>=n *: 次数>=0 +: 次数>=1 ?: 0或者1(跟在限定符后表示非贪婪) |
eg:
匹配最少连续三个ab组成的字符
echo 'mmababcdabababnn' | grep -P '(ab){3,}'
可以看出前面连续两个ab组成的字符没被匹配到
echo 'mmababcdabababnn' | grep -oP 'm+?'
m+是贪婪模式,尽可能多的匹配m数量,但是加了个?,则表示非贪婪
无敌的小括号
| ( ): 分组 (?:pattern): 非获取分组 (?=pattern): 非获取匹配,正向肯定预查 (?!pattern): 非获取匹配,正向否定预查 (?<=pattern): 非获取匹配,反向肯定预查 (?<!pattern): 非获取匹配,反向否定预查 |
eg:
获取版本号
如 version1.23.4
echo 'version1.23.4' | grep -oP "(?<=version)[\d.]+"
(?<=version) 反向肯定预查,代表以version开头,但是并不获取此数据
特殊的字符
| \ :转义字符 | :或 a|b |
eg:
获取 包含 * 或者 ^ 或者 + 的数据
echo "sdf*sdf^ssdfs\$sdf" | grep -P '(\^|\*|\$)'
当然更简洁的还是使用[]
echo "sdf*sdf^ssdfs\$sdf" | grep -P '[\^*$]'
因为在[]内 ^ 有特殊意义,所以要转义,如果放在后面,则可省略转义
echo "sdf*sdf^ssdfs\$sdf" | grep -P '[*^$]'
三、应用实例
注:以下例子是用的grep + perl, 其他的正则可能会有些微差别
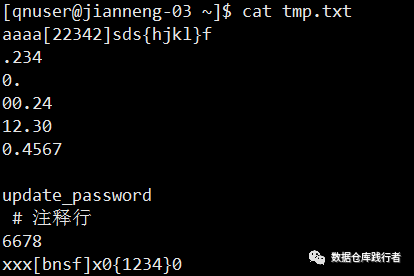
新建文本 tmp.txt 内容如下:
1:获取全数字内容 (纯数字)
cat tmp.txt | grep -oP '^[\d]+$'

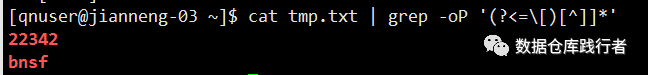
2:获取方括号内容--非获取匹配(爬虫之类的html 标签之间内容也是类似)
cat tmp.txt | grep -oP '(?<=\[)[^]]*'
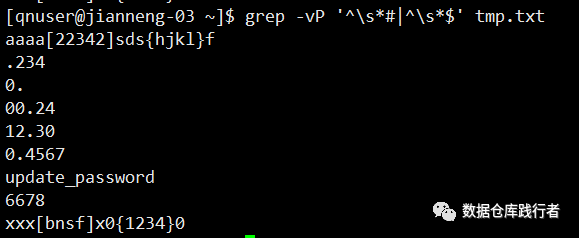
3:查出所有非空行(全空格也排除)和非注释行
sed '/^\s*#/d;/^\s*$/d' tmp.txt
sed -e '/^\s*#/d' -e '/^\s*$/d' tmp.txt
sed '/^\s*#\|^\s*$/d' tmp.txt
awk '!/^\s*#|^\s*$/' tmp.txt
grep -vP '^\s*#|^\s*$' tmp.txt
4:找出正数部分为5位及以内,小数部分为3位及以内的数据(此为线上真实例子)
cat tmp.txt | grep -oP '^(0|[1-9]\d{0,4})(\.\d{1,3})?$'

5:找出带下划线的数据,并转成驼峰(比较常用)
sed -n 's/_\(.\)/\u\1/gp' tmp.txt
update_password 修改为 updatePassword

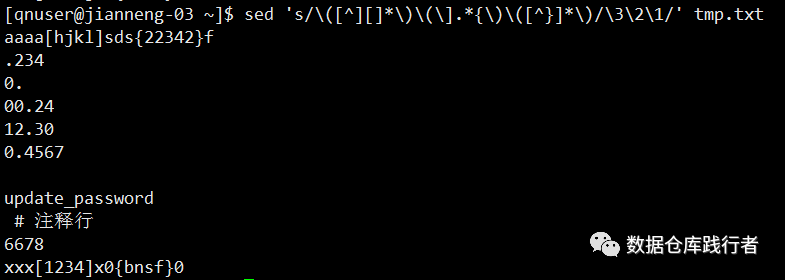
6:交换方括号和大括号内容并输出(主要想让大家了解分组的用法)
sed 's/\([^][]*\)\(\].*{\)\([^}]*\)/\3\2\1/' tmp.txt
四、密码校验详解(手把手教大家)
需求:对用户输入的密码进行校验,要求只能含有数字,小写字母,大写字母
而且必须包含三种类型中的最少两种,且长度在6--10位
正常版:
| 1: 首先想到只能含有数字大小写字母,且6到10位 根据前面介绍的正则情况,可以限定 ^[\da-zA-Z]{6,10}$ 2: 要求含3种类型中的至少两种,比如含有数字和小写字母,但是因为顺序不定所以可罗列为:[\d].*[a-z]|[a-z].*[\d] |
那么把所有要求的情况展示出来,最终的结果是
echo 'password' | grep -P '[\da-zA-Z]{6,10}' | grep -P '[\d].*[a-z]|[a-z].*[\d]|[\d].*[A-Z]|[A-Z].*[\d]|[A-Z].*[a-z]|[a-z].*[A-Z]'简洁版:
| 有没有觉得上面的方式有点怪怪的 首先是分两步验证 其次是如果情况很多的话罗列起来是不是很吓人,而且容易遗漏 有没有一种简单又实用的正则呢 答案当然是肯定的,这里就用到了零宽断言 当然基本要求还是固定的 ^[\da-zA-Z]{6,10}$ 判断是否包含小写字母和数字则可 (?=.*[\d])(?=.*[a-z])不用区分先后顺 |
那么完整的结构为
echo 'password' | grep -P '(?=.*[\d])(?=.*[a-z])|(?=.*[A-Z])(?=.*[a-z])|(?=.*[\d])(?=.*[A-Z])^[\da-zA-Z]{6,10}$'是不是很神奇呢!!!
其实掌握正则很简单,就是 匹配字符+限定符,以尽可能少的字符达到想要的结果,熟能生巧,想彻底掌握,还是需要多多练习哇。。。
推荐阅读:
Hey!
我是小萝卜算子
欢迎关注:数据仓库践行者
分享是最好的学习,这里记录我对数据仓库的实践的思考和总结
每天学习一点点
知识增加一点点
思考深入一点点
在成为最厉害最厉害最厉害的道路上
很高兴认识你

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献8条内容

所有评论(0)