sparksql优化的奇技淫巧(一次惊掉下巴的优化)
先给看效果:
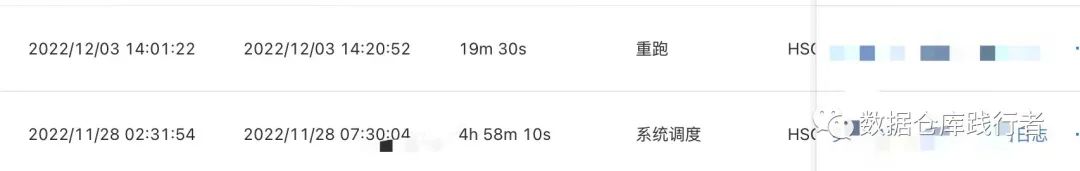
刚重跑的,知道能加快,但没想到能加快这么多
先说下数据量吧,每天20亿+
这次的优化灵感,来自于牛逼的群友们
源于群里一个同学的疑惑,看图:
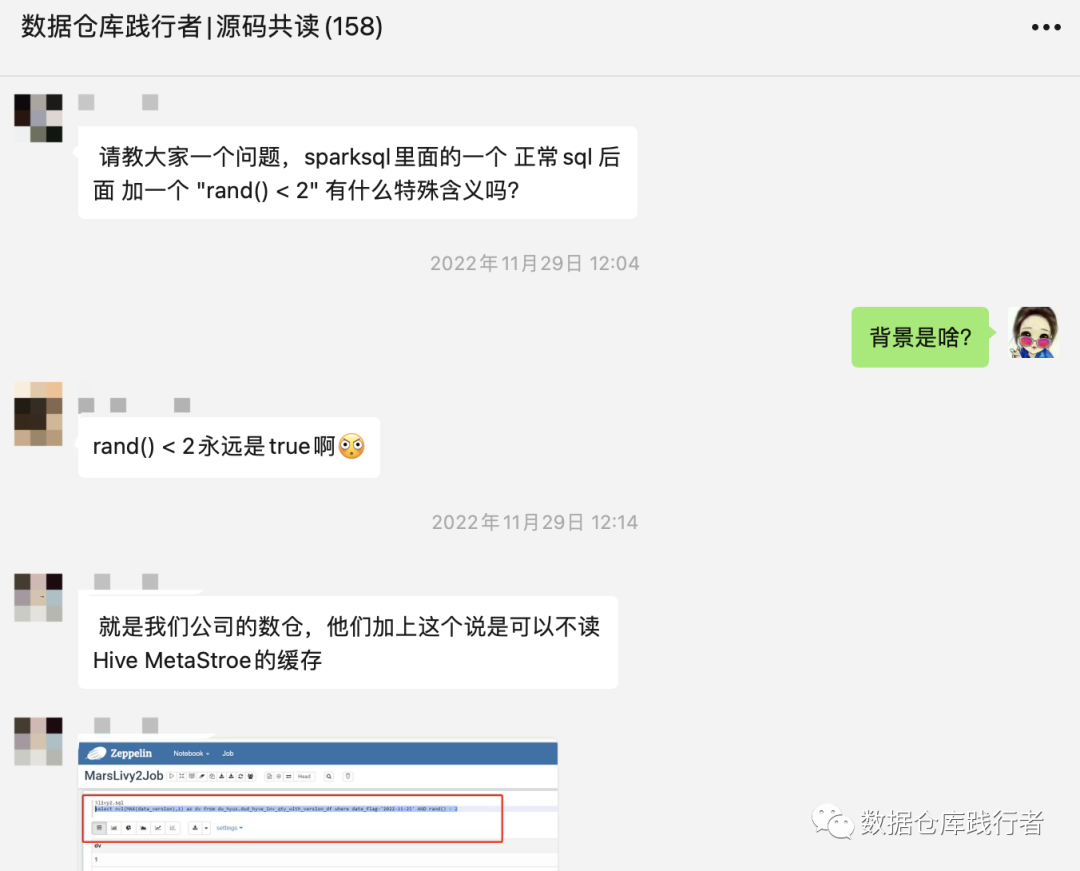
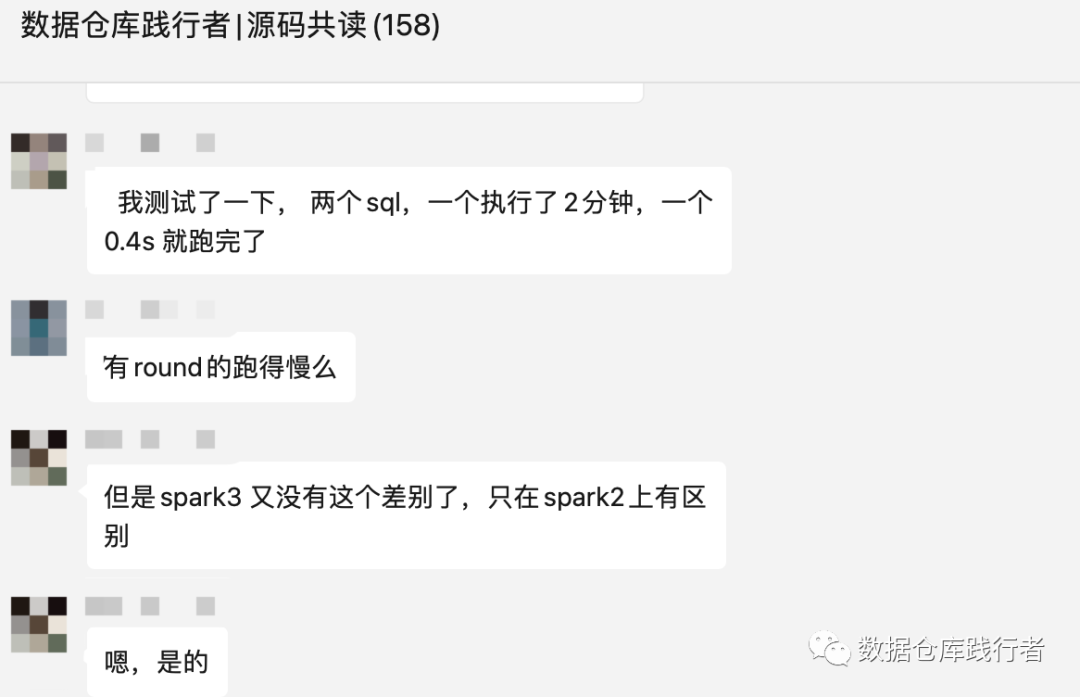
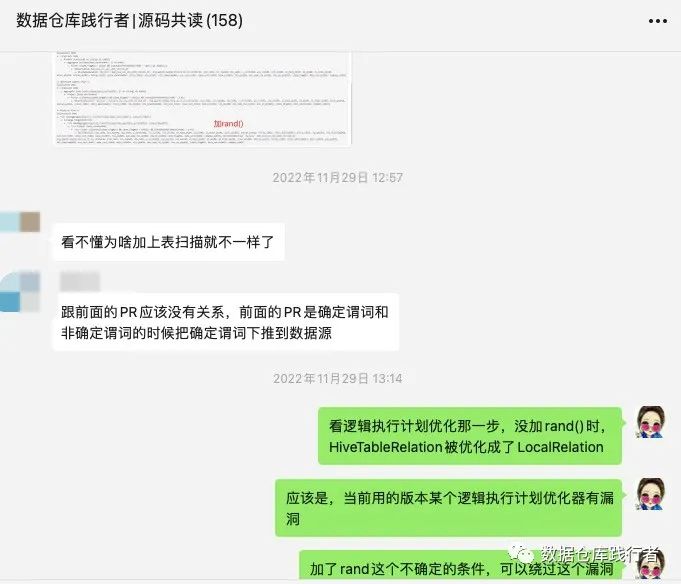
只能说,以后大家看到一个看似没用的条件的时候,千万不要随便删除,这个条件很有可能起到了优化的大作用。
由于群里的同学公司用的spark版本比较早,我们知道原因就好,暂且不细去追究。
可是,这个思路提醒了我,我们有个任务,也可以用这个方法来优化,并且走的是另外一个原理。
之前有写一篇 SparkSql不同写法的一些坑(性能优化) 里面的第二种情况:
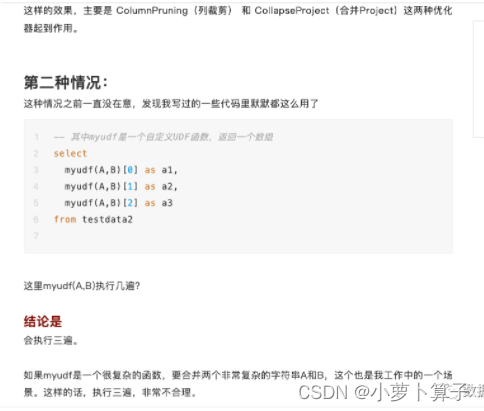
myudf是自定义的函数,如果我们这么用的话,这个函数会执行三遍。
这样在某些情况下是非常低效的,比如我们现在的数据,一个超大超复杂各种嵌套的json串,需要写udf从中解析出对应的数据,有的还需要输出排序的结果,并且字段巨多(小100个),那就得执行100次。
我们或许会想到要这样写:
select
   atmp[0] as a1,
   atmp[1] as a2,
   atmp[2] as a3
   ...
   atmp[100] as a100
 from
 (select
   myudf(A,B) as atmp
 from testdata2
 ) tmp
在sparksql branch3.3 这样改写完全没问题,会判断出自定义的函数是昂贵的计算,默认不给合并;
但在3.3以下的版本中,CollapseProject(合并Project) 优化器会合并,导致最终的计算还是:
select
myudf(A,B)[0] as a1,
myudf(A,B)[1] as a2,
myudf(A,B)[2] as a3
...
myudf(A,B)[100] as a100
from testdata2
这样的过程。
我们公司的spark目前还没完全把3.3版本的一些优化给合并过来,所以就会出现这样的问题。
之前的做法是:
SET spark.sql.optimizer.excludedRules=org.apache.spark.sql.catalyst.optimizer.CollapseProject;
把CollapseProject优化器关掉,其实关优化器,也会有其他问题:一个写表的逻辑,sql是很复杂的,如果关掉,可能其他需要用到该优化器的模块就没办法用了。
现就没必要关了,把rand()<2这样的条件给用上,写法如下:
select
   if(helpcol<2,atmp[0],xxx) as a1,
   atmp[1] as a2,
   atmp[2] as a3
   ...
   atmp[100] as a100
 from
 (select
   myudf(A,B) as atmp,
   rand() as helpcol
 from testdata2
 ) tmp
上面写法的重点是,加一个 非deterministic(不确定)的辅助列,并且在外层引用这个列。这里用的是rand()函数,内查询用rand() as helpcol ,外查询用if(helpcol<2,atmp[0],xxx) as a1, 并且只用到一列上就可以,这个只是保证外查询和内查询有这个非deterministic的重合列,这样在这个模块的查询语句中CollapseProjet优化器就失效了。
ps:关于表达式的确定性(deterministic)的理解,可以看这篇
Spark sql Expression的deterministic属性
下面看这种用法执行计划上的效果:
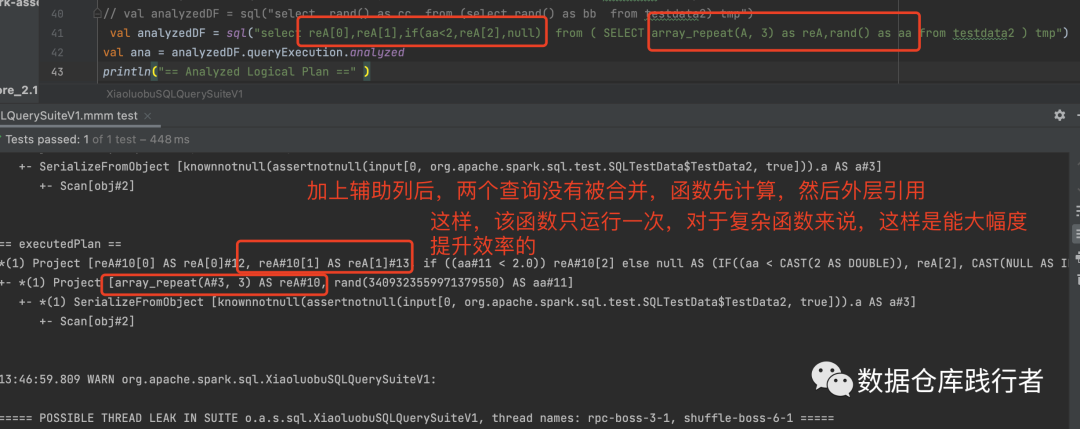
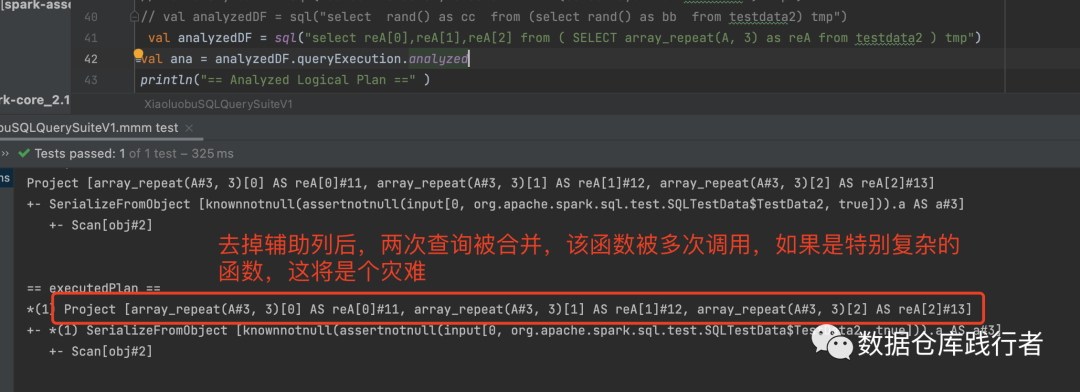
在我们的这个案例上,运行时长的效果怎么样呢?
真的是惊掉下巴!!!
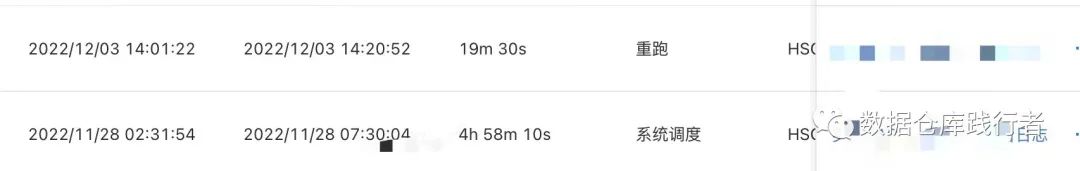
还能说什么呢?
你可能会有疑惑:我是怎么知道这么写可以呢?
哈哈,因为我对sparksql够熟悉啊
这个优化还有其他的解决方案吗?
有啊,写udtf函数,但我不想写udtf,因为udf更简单,哈哈哈哈
关于udtf为什么能做到优化?之前有写一篇udtf函数的原理,虽然是hive版本的,但是spark也适用,差不多一个原理:
你真的了解Lateral View explode吗?--源码复盘
Hey!
我是小萝卜算子
欢迎关注:数据仓库践行者
分享是最好的学习,这里记录我对数据仓库的实践的思考和总结
每天学习一点点
知识增加一点点
思考深入一点点
在成为最厉害最厉害最厉害的道路上
很高兴认识你

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献8条内容

所有评论(0)