Unity学习shader笔记[九十一]Compute Shader 入门
和 Unity3D Shader系列之Compute Shader基础及图像灰度化
谈起compute shader,我们要先了解一个概念,叫GPGPU(General-purpose computing on graphics processing units)。根据Wikipedia的介绍

它是利用处理图形任务的图形处理器来计算原本由中央处理器处理的通用计算任务。 这些通用计算任务通常与图形处理没有任何关系。
那么,专门为图形任务所设计的图形处理器是如何怎么能处理通用计算任务的呢?这不是在抢CPU的饭碗么?的确,早期的显卡是没有这种功能的。在很久很久以前,那时老黄还没成立NVIDIA,显卡市场还是Voodoo称霸的时候,显卡里有两种单元,一种专门处理顶点,叫做vertex unit,另一种专门处理像素,称作pixel unit。
然而,随着渲染场景越来越复杂(想想游戏史,是不是游戏看起来越来越逼真了?),这种模式不利于负载均衡,而且这时候人们也希望显卡能做一些通用计算的需求,图形渲染不再是唯一的需求,所以GPGPU在这时开始浮出水面。到了2006年底及2007年初,老黄拿出了他的GeForce 8800 GTX,AMD也拿出了Radeon HD 2800,unified shaders的时代来临了。
什么叫unified shaders?之前专门处理顶点的vertex unit我们需要为它写vertex shader,专门处理像素的pixel unit我们需要为它写pixel shader,到了unified shaders时代,不管vertex shader也好,pixel shader也好,显卡都会用一种unit来处理,这时,GPGPU变成了可能。
现在回到compute shader,它是一种运行在显卡上却不在普通渲染管线上的程序,利用它可以做大型并行的GPGPU算法,以此来获得比CPU快很多倍的计算能力。不过在获得这种能力之前,我们先来看看如何使用这种shader。
首先是C#脚本,用于掌控全局
public Texture inputTex;
public ComputeShader computeShader;
public RawImage image;

void Start(){
        RenderTexture t = new RenderTexture(inputTex.width,inputTex.height,24);
        t.enableRandomWrite = true;
        t.Create();
        image.texture = t;
        image.SetNativeSize();

        int kernel = computeShader.FindKernel("Gray");
        computeShader.SetTexture(kernel,"inputTexture",inputTex);
        computeShader.SetTexture(kernel,"outputTexture",t);
        computeShader.Dispatch(kernel,inputTex.width / 8, inputTex.height / 8,1);
}
其次是compute shader,所有的计算都放在这里
// Each #kernel tells which function to compile; you can have many kernels
#pragma kernel Gray

Texture2D inputTexture;
// Create a RenderTexture with enableRandomWrite flag and set it
// with cs.SetTexture
RWTexture2D<float4> outputTexture;


[numthreads(8,8,1)]
void Gray (uint3 id : SV_DispatchThreadID)
{
    float r = inputTexture[id.xy].r;
    float g = inputTexture[id.xy].g;
    float b = inputTexture[id.xy].b;

    float res = r * 0.299 + g * 0.587 + b * 0.114;
    outputTexture[id.xy] = float4(res,res,res,1);
}
这里我实现的功能是将一张彩色图转成灰阶图,虽然体现不出GPU的强大并行计算能力,但能起到如何使用compute shader的作用
首先我们为要输出的灰阶图准备一个地方,名叫t,t的属性enableRandomWrite必须为true,这样才能将数据写入。然后通过FindKernel方法找kernel,里面传入的string就是compute shader中#pragma kernel Gray定义的名字Gray,当然你想起什么名字就起什么名字,可以随便改的,不过相应的void Gray (uint3 id : SV_DispatchThreadID)这个地方的名字要一致。然后用SetTexture方法将数据设置好,由于inputTexture是读取数据用的,所以对应在compute shader里面的变量类型是只读型的Texture2D,而outputTexture的输出数据用的,所以用读写型的RWTexture2D。有朋友可能要问了,RWTexture2D这个怎么没见过啊。原来,unity中的compute shader是遵循DirectX 11语法的,所以这个RWTexture2D是HLSL里的类型,详见微软文档 RWTexture2D
最后到了调用Dispatch方法的时候,也意味着整段程序都设置完毕,要开始工作了。从文档里可以看出需要传四个参数进去,分别是kernelIndex、threadGroupsX、threadGroupsY、threadGroupsZ,这些是什么意思呢?
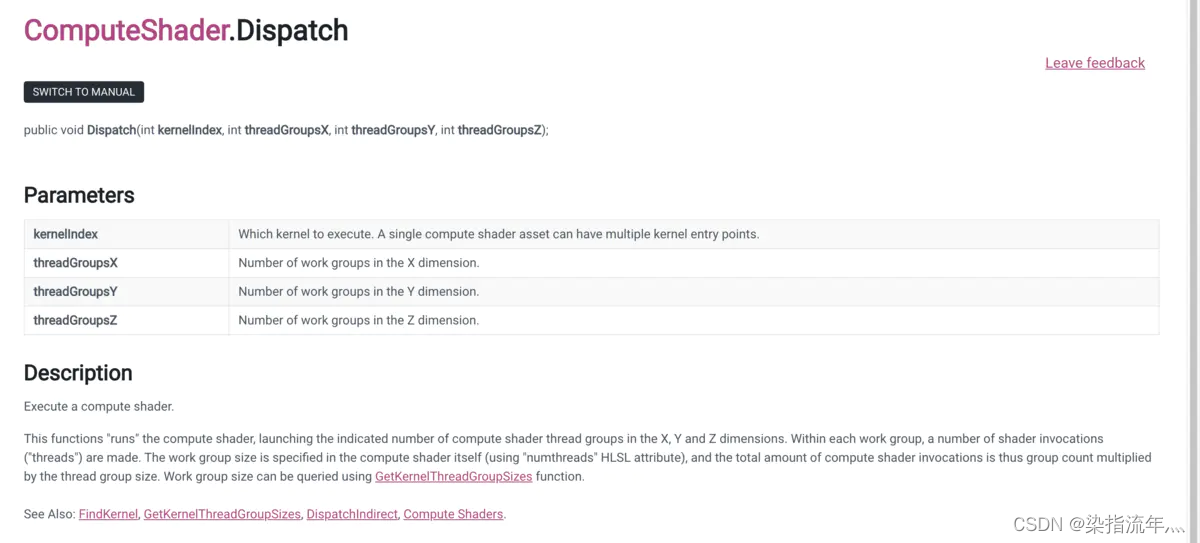
kernelIndex很好解释,就是刚刚FindKernel方法返回的值。
其余的参数,从浅层次上讲,
就是要让threadGroupsX * numthreads.x = 图片宽,threadGroupsY * numthreads.y = 图片高,threadGroupsZ大部分时间下都是1。
这里的numthreads就是compute shader里的[numthreads(8,8,1)]。
另外有个限制条件是在shader model 5的平台下numthreads.x *numthreads.y * numthreads.z <= 1024,numthreads.z <= 64,(在shader model 4.5的平台下这个数字是768,numthreads.z <=1,再往下的shader model则不支持compute shader了)。
还有要注意的是由于架构问题,一个线程组里有几个线程需要结合硬件,NVIDIA的架构下最好是32的倍数个线程,AMD架构下最好为64的倍数个线程。
更进一步,我们来看微软文档里的一张图。
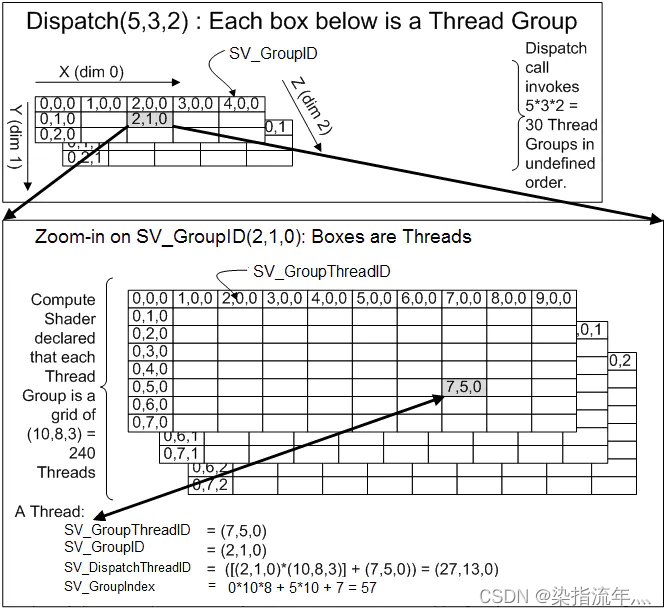
threadGroupsX、threadGroupsY、threadGroupsZ代表着你要开多少组线程,每个线程组里面有多少个线程是由numthreads里的参数决定的。
拿我写的这段代码举例,Dispatch的时候开了128 * 128 * 1组的线程组,每组线程组里面有8 * 8 * 1个线程,128 * 8 = 1024,这里我用的图片的长和宽都是1024,即每个线程都在处理图片上的某一个像素。
void Gray (uint3 id : SV_DispatchThreadID)这边的id即为每个线程的index。那如果numthreads设为[numthreads(64,4,1)],那么Dispatch的时候可以设为Dispatch(kernel,inputTex.width / 64, inputTex.height / 4,1);。
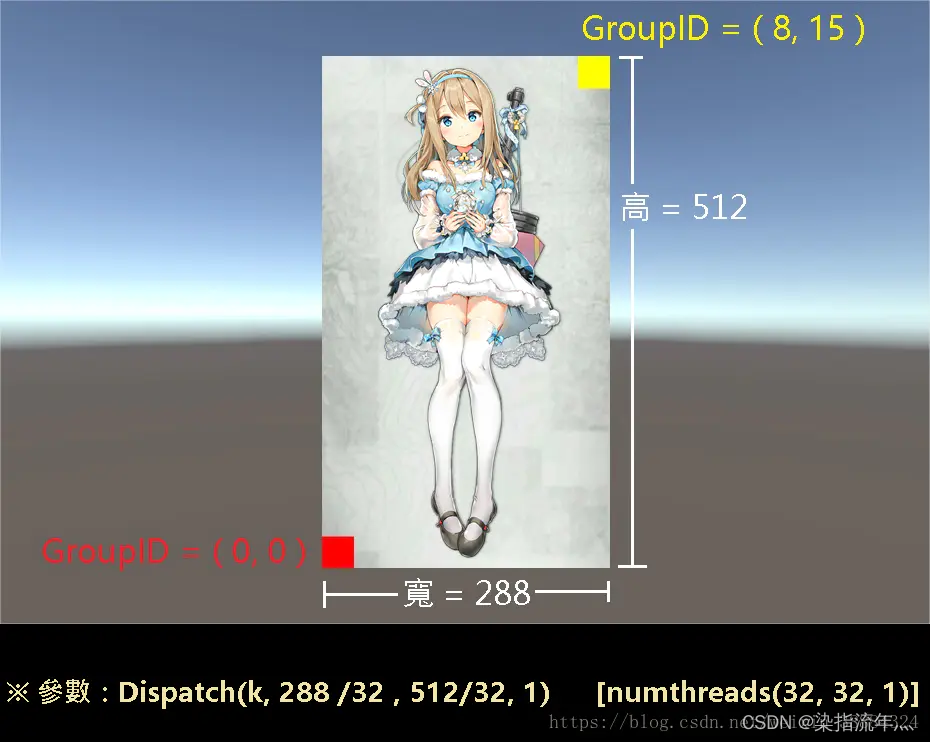
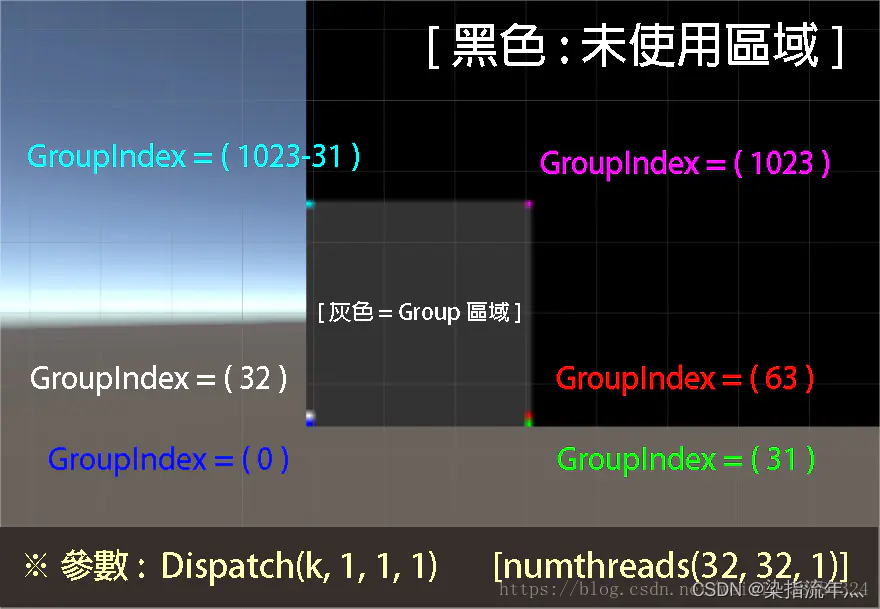
文档图片2中还提到了SV_GroupThreadID,SV_GroupID,SV_GroupIndex,这些也是用来索引线程的,具体关系看彥霖大佬的图就明白了。
Group ID 一看就懂 :
Group Thread ID 一看就懂 :

Group Index 一看就懂 :
接下来我们来看如何用compute shader进行简单计算任务,而不是处理贴图。代码如下
CS脚本
public ComputeShader csBuffer;
ComputeBuffer buffer;
struct MyInt{
        public int val;
        public int index;
    };

void Start()
    {

            CSFib();

    }

public void CSFib(){
        MyInt[] total = new MyInt[32];
        buffer = new ComputeBuffer(32,8);
        int kernel = csBuffer.FindKernel("Fibonacci");
        csBuffer.SetBuffer(kernel,"buffer",buffer);
        csBuffer.Dispatch(kernel,1,1,1);
        buffer.GetData(total);
        for (int i = 0; i < total.Length; i++)
        {
            Debug.Log(total[i].val);
        }

    }

    private void OnDestroy() {
            buffer.Release();
    }
compute shader
#pragma kernel Fibonacci

struct MyInt{
    int val;
    int index;
};

RWStructuredBuffer<MyInt> buffer;

int Fib(int n){
    int a = 0;
    int b = 1;
    int res = 0;
    for(int i=0;i<n;i++){
        res = a + b;
        a = b;
        b = res;
    }
    return a;
}

[numthreads(32,1,1)]
void Fibonacci (uint3 id : SV_DispatchThreadID)
{
    buffer[id.x].val = Fib(id.x);
    buffer[id.x].index = id.x;

}
菲波那切数列我想大家都应该知道吧?那么用GPU来算菲波那切数列就是以上代码在实现的内容了。
为了让大家看看在compute shader中如何使用自定义结构体,我舍弃了int类型而使用了自定义结构体MyInt,其中val存菲波那切数列中每一项的值,index存的是值所对应的索引。
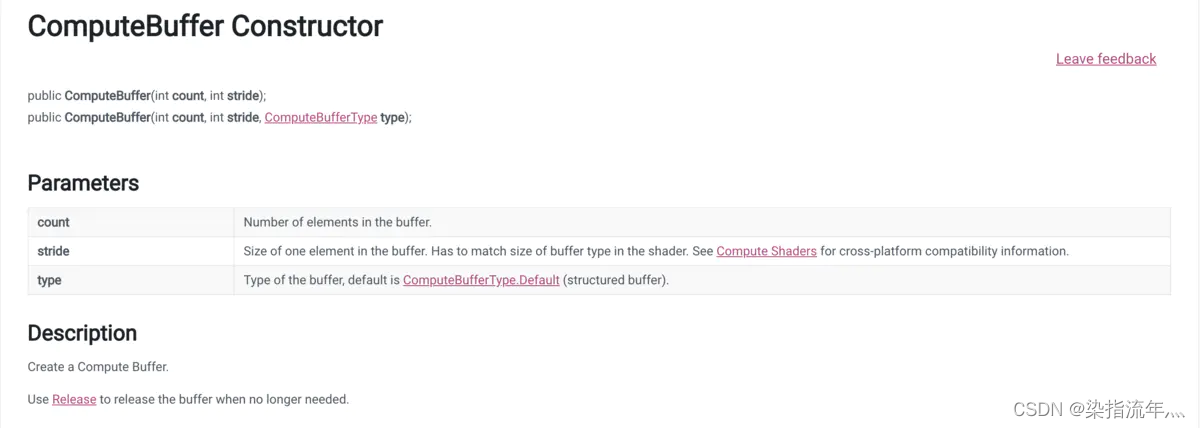
这里多出来了一个ComputeBuffer类型的buffer,用于存储计算得到的值,可以看到后面要用
GetData方法把数值从GPU里面拿出来。
在new这个ComputeBuffer的时候我们需要传入两个参数,从文档上来看第一个是count,我需要输出32个菲波那切数列,就填32;第二个是stride,代表每个元素的长度,由于自定义结构体MyInt有两个int类型的属性,所以这里的stride为8。
其余内容通过上面的讲解,我想应该不难理解了。
当然,compute shader能做的远远不止这些,来看看大佬们把compute shader玩出了什么花样。
简单案例
灰度化图像

#pragma kernel CSMain

Texture2D<float4> inputTex;
RWTexture2D<float4> outputTex;

[numthreads(8,8,1)]
void CSMain (uint3 id : SV_DispatchThreadID)
{
    float r = inputTex[id.xy].r;
    float g = inputTex[id.xy].g;
    float b = inputTex[id.xy].b;
	float a = inputTex[id.xy].a;

	float gray = dot(inputTex[id.xy].rgb, float3(0.299, 0.587, 0.114));
	outputTex[id.xy] = float4(gray, gray, gray, a);
}
using UnityEngine;
using UnityEngine.UI;

public class GrayDemo : MonoBehaviour
{
    private ComputeShader m_GrayComputeShader;

    private RawImage m_GrayImg;

    private void Start()
    {
        m_GrayImg = GameObject.Find("Canvas/RawImg-ComputeShader").GetComponent<RawImage>();

        Texture2D inputTexture = Resources.Load<Texture2D>("flower_art_0EN071");

        RenderTexture rt = new RenderTexture(inputTexture.width, inputTexture.height, 24);
        rt.enableRandomWrite = true;
        rt.Create();

        m_GrayImg.texture = rt;
        m_GrayImg.rectTransform.SetSizeWithCurrentAnchors(RectTransform.Axis.Horizontal, rt.width);
        m_GrayImg.rectTransform.SetSizeWithCurrentAnchors(RectTransform.Axis.Vertical, rt.height);

        m_GrayComputeShader = Resources.Load<ComputeShader>("ComputeShader/Gray");
        int kernal = m_GrayComputeShader.FindKernel("CSMain");
        m_GrayComputeShader.SetTexture(kernal, "inputTex", inputTexture);
        m_GrayComputeShader.SetTexture(kernal, "outputTex", rt);

        m_GrayComputeShader.Dispatch(kernal, 1024/8, 768/8, 1);
    }
}
其他
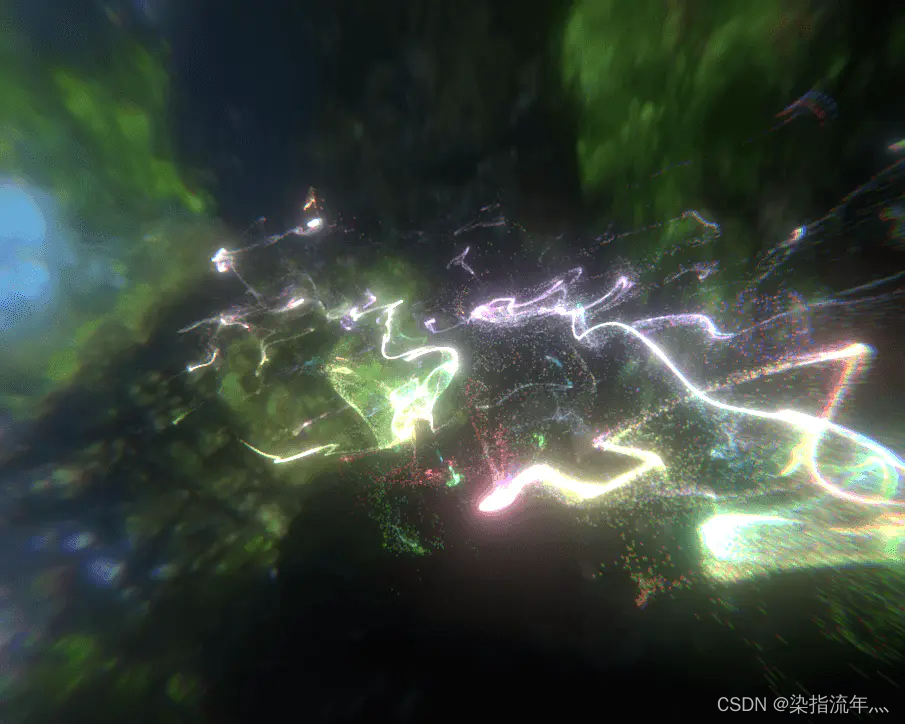
GPU粒子系统
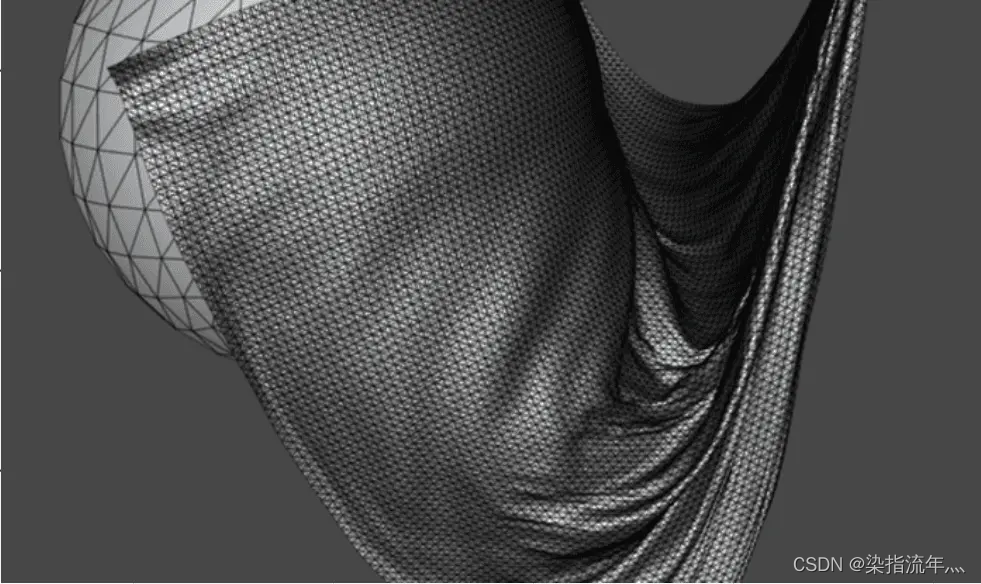
GPU布料系统
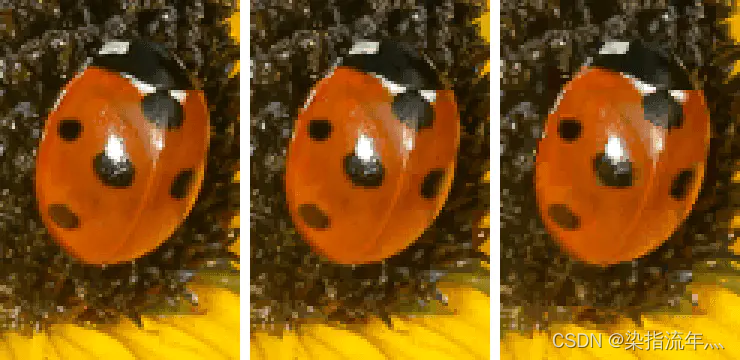
图片压缩
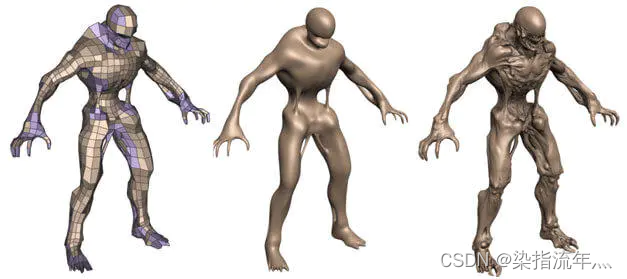
模型曲面细分
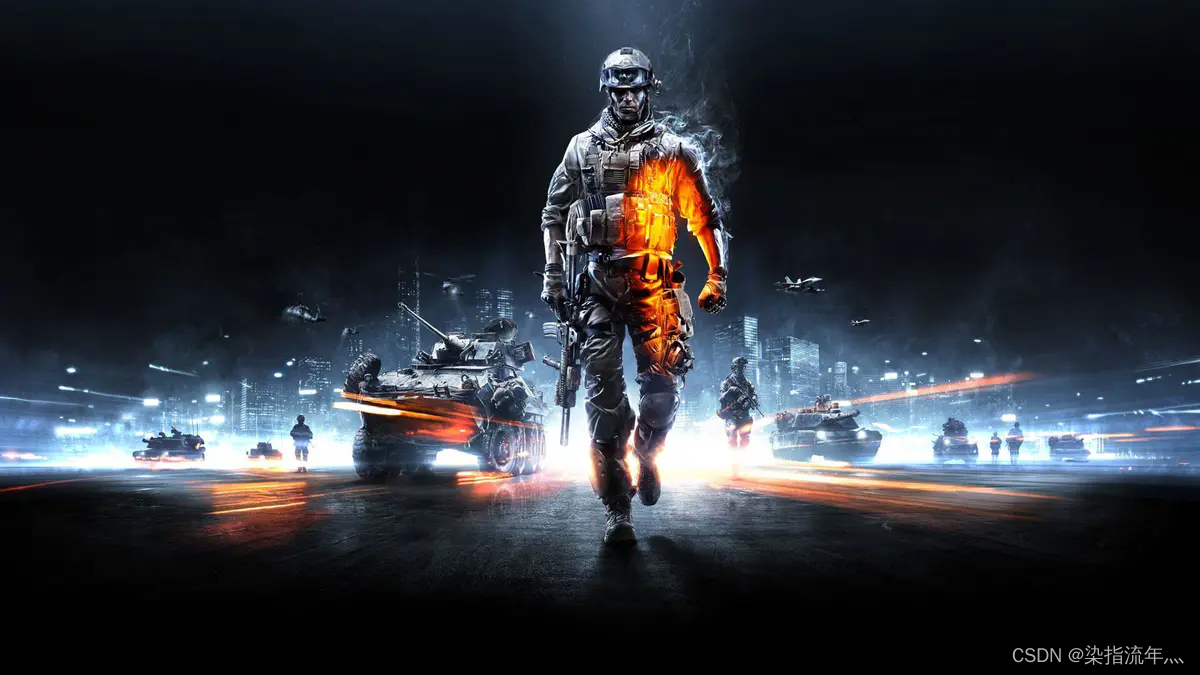
战地3中使用compute shader对点光源、探照灯等进行剔除
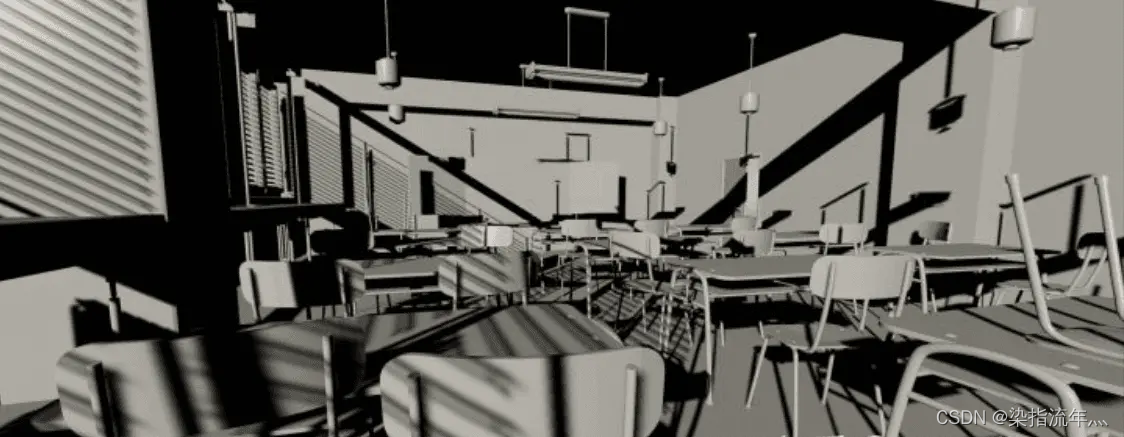
知乎大V MaxwellGeng实现的GPU Occlusiong Culling,他使用了Hiz的方法,对Cluster进行遮挡剔除

刺客信条大革命,在这部游戏中使用了GPUDRP技术,并在Siggraph 2015: Advances in Real-Time Rendering in Games course中发表
工程地址

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献9条内容

所有评论(0)