pgpool+watchdog流复制集群下 主从切换 在线恢复 读写分离 负载均衡 高可用 配置
版本环境:
| pgpool | 4.3.3 |
| postgresql | 14.0 |
主机环境:
| 192.168.1.200 | psql-master |
| 192.168.1.201 | psql-slave |
| 192.168.1.222 | VIP |
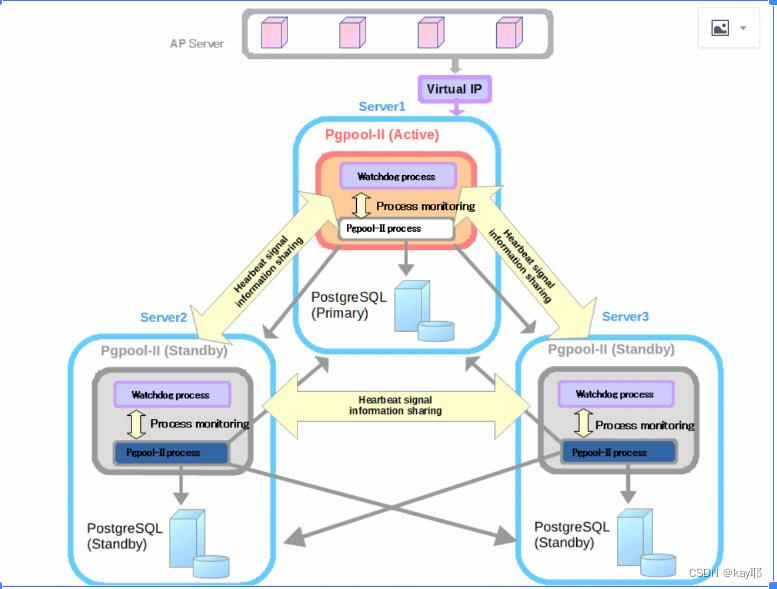
pgpool工作原理图:
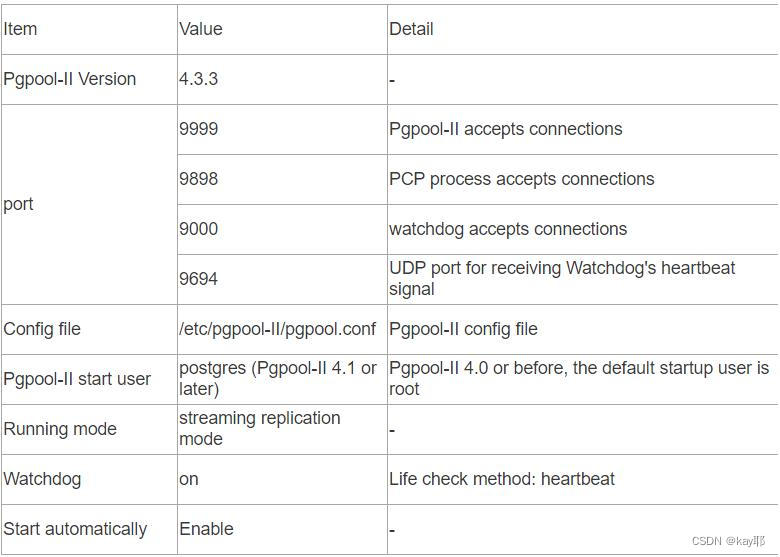
Pgpool-II version and Configuration(端口情况)
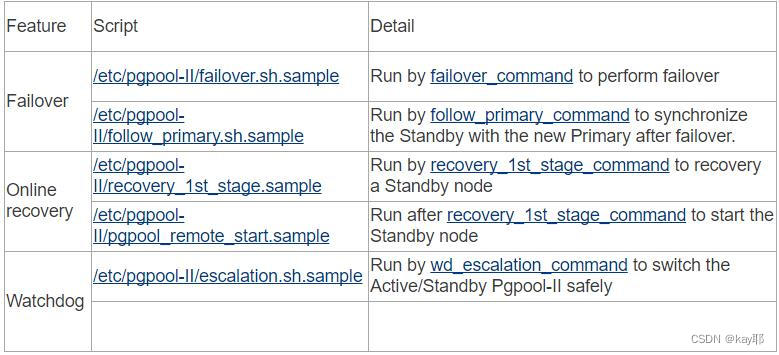
Various sample scripts included in rpm package(pgpool自带脚本)
预环境配置:
配置本地域名解析:
[all service]# vim /etc/hosts

添加
192.168.1.200	psql-master
192.168.1.201	psql-slave
192.168.1.222	VIP
下载tar.gz包:
下载postgresql:http://www.postgresql.org/ftp/source/http://www.postgresql.org/ftp/source/
下载pgpoll:https://www.pgpool.net/mediawiki/index.php/Downloads
防火墙配置:(大家可以根据实际情况调整端口)
防火墙配置:
[all service]# systemctl  stop  firewalld.service
[all service]# systemctl  enable  firewalld.service
[all service]# systemctl  status  firewalld.service

或者
[all service]# firewall-cmd --permanent --zone=public --add-port=9999/tcp --add-port=9898/tcp --add-port=9000/tcp
[all service]# firewall-cmd --permanent --zone=public --add-port=9694/udp
[all service]# firewall-cmd --reload
[all service]# firewall-cmd --permanent --zone=public --add-service=postgresql
[all service]# firewall-cmd --reload
[all service]# firewall-cmd --get-services

云服务器则需要将9999、9898、9000、9604加入安全组
用户管理:
(建议在单独的用户帐户下运行Pgpool-II,但是因为pgpool主要用于pgsql数据库的管理,推荐使用postgres用户管理)
[all service]# groupadd postgres
[all service]# useradd -g postgres postgres
配置主机互信关系
(postgres用户下操作):(在pgpoll运行过程中需要主机间相互通信)
[all service]# ssh-keygen -t rsa
[all service]# ssh-copy-id  pgsql-slave
[all service]# ssh-copy-id  pgsql-master
[all service]# cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys
[all service]# chmod 600 ~/.ssh/authorized_keys
[all service]# ssh postgres@pgsql-slave    //测试是否成功互通
[all service]# ssh postgres@pgsql-master   //测试是否成功互通
安装部署:
安装部署postgresql:
编译安装postgres及部署postgresql主从流复制
参考源码包部署postgresql文档与pg主从流复制和归档配置文档
pgsql主从流复制---postgresql主从流复制和归档配置
创建所需数据库用户:(由于安全原因,我们创建了一个用户repl仅用于复制目的,以及一个用户pgpool用于Pgpool-II的流复制延迟检查和健康检查。)
[postgres@pgsql-master ~]$ psql -U postgres -p 5432
psql (14.0)
Type "help" for help.

postgres=# SET password_encryption = 'md5';
postgres=# CREATE ROLE pgpool WITH LOGIN;
postgres=# CREATE ROLE repl WITH REPLICATION LOGIN;
postgres=# \password pgpool
postgres=# \password repl
postgres=# \password postgres
postgres=# GRANT pg_monitor TO pgpool;   //如果要在 SHOW POOL NODES命令结果中显示“replication_state”和“replication_sync_state”列,角色pgpool 需要是 PostgreSQL 超级用户或pg_monitor组( Pgpool -II 4.1 或更高版本)。将pg_monitor 授予pgpool:
检查pg_hba.conf访问列表:
[all servers]$ vim /usr/local/pgsql/data/pg_hba.conf
//如没有,添加,也可以添加具体ip

host    all                  all            192.168.1.0/24        md5
host    replication          all            192.168.1.0/24        md5

host    all                  pgpool         0.0.0.0/0             md5
host    all                  postgres       0.0.0.0/0             md5
pgpool编译安装部署:
[all servers]# su - root
[all servers]# tar xf pgpool-II-4.3.3.tar.gz
[all servers]# cd pgpool-II-4.3.1
[all servers]# ./configure  --prefix=/usr/local/pgpool-II-4.3.3   --with-openssl
[all servers]# make && sudo make install
安装相关pgpool函数:
 pgpool-regclass:  如果你在使用 PostgreSQL 9.4,可以不装
[all servers]# cd /usr/local/pgpool-II-4.3.3/src/sql/pgpool-regclass
[all servers]# make && make install
[all servers]# psql -f pgpool-regclass.sql template1

  pgpool-recovery:  pgpool在线恢复会使用函数
[all servers]# cd /usr/local/pgpool-II-4.3.3/src/sql/pgpool-recovery
[all servers]# make && sudo make install
[all servers]# psql -f pgpool-recovery.sql template1

insert_lock:
如果你在复制模式中使用了本机复制和 insert_lock ,强烈推荐建立 pgpool_catalog.insert_lock 表,用于互斥。 到现在为止,insert_lock 还能够工作。但是,在这种情况下,pgpool-II 需要锁定插入的目标表。 这种行为和 pgpool-II 2.2 和 2.3 系列类似。由于表锁与 VACUUM 冲突,所以 INSERT 操作可能因而等待很长时间。
[all servers]# cd /usr/local/pgpool-II-4.3.3/src/sql
[all servers]# make && make install
[all servers]# psql -f insert_lock.sql template1
配置环境变量:
[all servers]# vim  /etc/profile
export PGPOOL_HOME=/usr/local/pgpool
export PATH=$PATH:/usr/local/pgpool//bin
[all servers]# source /etc/profile
更改权限和所属组:
[all servers]# chmod 750 /usr/local/pgpool/ -R
[all servers]# chown postgres.postgres /usr/local/pgpool/ -R
创建.pgpass文件
为了允许repl用户在不指定密码的情况下进行流复制和在线恢复,并使用postgres执行pg_rewind,我们在postgres用户的主目录中创建.pgpass文件,并将每个PostgreSQL服务器 上的权限更改为 600 。
[all servers]# su - postgres
[all servers]$ vi /var/lib/pgsql/.pgpass
server1:5432:replication:repl:<repl user password>
server2:5432:replication:repl:<repl user password>
server3:5432:replication:repl:<repl user password>
server1:5432:postgres:postgres:<postgres user password>
server2:5432:postgres:postgres:<postgres user password>
server3:5432:postgres:postgres:<postgres user password>
[all servers]$ chmod 600  /var/lib/pgsql/.pgpass   //需要注意的是,此文件位置与官方自带的shell脚本的位置相呼应,如果要更改,需要同时更改shell执行脚本
创建pgpool_node_id文件:
Pgpool-II 4.2 开始所有配置将一样通过/etc/pgpool/下面的pgpool_node_id 区分节点
[postgres@pgsql-master ~]$echo 0 > /usr/local/pgpool/etc/pgpool_node_id
[postgres@pgsql-slave ~]$echo 1 > /usr/local/pgpool/etc/pgpool_node_id
pgpool-II的配置:
由于从Pgpool-II 4.2 开始,所有主机上的所有配置参数都相同,您可以在任何 pgpool 节点上编辑 pgpool.conf 并将编辑后的 pgpool.conf 文件复制到其他pgpool 节点。
pgpool.conf基础配置
[postgres@pgsql-master ~]$ cp /usr/local/pgpool/etc/pgpool.conf.sample /usr/local/pgpool/etc/pgpool.conf
[postgres@pgsql-master ~]$ vim /usr/local/pgpool/etc/pgpool.conf

backend_clustering_mode = 'streaming_replication'  # Pgpool-II有几种集群模式。要设置集群模式,可以使用backend_clustering_mode 。在此配置示例中,使用流复制模式。

listen_addresses = '*'    #  为了允许 Pgpool-II 接受所有传入的连接,我们设置listen_addresses = '*'
port = 9999              # 指定 Pgpool-II 监听的端口号。

#客户端认证配置,同时需要对etc文件夹下的pool_passwd,pool.conf,pcp.conf进行配置
enable_pool_hba = on
pool_passwd = 'pool_passwd'

#负载均衡开关,会根据后端信息中的weight选项来决定权重
load_balance_mode = on

# 在sr_check_user 和sr_check_password 中指定复制延迟检查用户和密码。我们将 sr_check_password留空,并在 pool_passwd中创建条目。从Pgpool-II 4.0 开始,这些参数留空,Pgpool-II将首先尝试从pool_passwd文件中获取该特定用户的密码,然后再使用空密码。
sr_check_user = 'pgpool'
sr_check_password = ''

#  启用健康检查,以便Pgpool-II执行故障转移。此外,如果网络不稳定,即使后端运行正常,健康检查也会失败,可能会出现故障转移或退化操作。为了防止这种健康检查的错误检测,我们设置health_check_max_retries = 3。以与sr_check_user和sr_check_password相同的方式指定health_check_user和health_check_password。
health_check_period = 5
health_check_timeout = 30
health_check_user = 'pgpool'
health_check_password = ''
health_check_max_retries = 3

#指定PostgreSQL后端信息。可以通过在参数名称末尾添加一个数字来指定多个后端
backend_hostname0 = 'pgsql-master'
backend_port0 = 5432
backend_weight0 = 1             #用于负载均衡
backend_data_directory0 = '/usr/local/pgsql/data'
backend_flag0 = 'ALLOW_TO_FAILOVER'     #允许故障转移
backend_hostname1 = 'pgsql-slave'
backend_port1 = 5432
backend_weight1 = 1
backend_data_directory1 = '/usr/local/pgsql/data'
backend_flag1 = 'ALLOW_TO_FAILOVER'        #允许故障转移

#要在SHOW POOL NODES 命令结果 中显示“replication_state”和“replication_sync_state”列,需要backend_application_name参数。在这里,我们在这些参数中指定每个后端的主机名。(Pgpool-II 4.1 或更高版本)
backend_application_name0 = 'pgsql-master'
backend_application_name1 = 'pgsql-slave'

#故障转移配置,同时我们还要配置两个脚本
failover_command = '/etc/pgpool-II/failover.sh %d %h %p %D %m %H %M %P %r %R %N %S'
follow_primary_command = '/etc/pgpool-II/follow_primary. sh %d %h %p %D %m %H %M %P %r %R


# Pgpool-II 在线恢复配置,同时我们还要配置两个脚本
recovery_user = 'postgres'
recovery_password = ''
recovery_1st_stage_command = 'recovery_1st_stage'

#日志记录配置
log_destination = 'stderr'
logging_collector = on
log_directory = '/usr/local/pgpool/log'    //记得创建日志路径
log_filename = 'pgpool-%Y-%m-%d_%H%M%S.log'
log_truncate_on_rotation = on
log_rotation_age = 1d
log_rotation_size = 100MB
创建日志记录路径
[all servers]$ mkdir /usr/local/pgpool/log
[all servers]$ chown postgres:postgres /usr/local/pgpool/log
故障转移脚本配置
在failover_command 参数 中指定故障转移后要执行的 failover.sh 脚本。如果我们使用 3 个 PostgreSQL 服务器,我们需要指定 follow_primary_command 在主节点故障转移后运行。我们又有两个 PostgreSQL 服务器,follow_primary_command 设置不是必需的。
[all servers]$ cp -p /usr/local/pgpool/etc/failover.sh{.sample,}
[all servers]$ cp -p /usr/local/pgpool/etc/follow_primary.sh{.sample,}
[all servers]$ chown postgres:postgres /usr/local/pgpool/etc/{failover.sh,follow_primary.sh}

[all servers]$ vim /usr/local/pgpool/etc/failover.sh
...
PGHOME=/usr/local/pgsql
...

[all servers]$ vim /usr/local/pgpool/etc/follow_primary.sh
...
PGHOME=/usr/local/pgsql
PCP_USER=pgpool
...
由于follow_primary.sh脚本必须在不输入密码的情况下执行PCP命令,所以我们需要在每台服务器的Pgpool -II启动用户(postgres用户) 的主目录下 创建.pcppass
[all servers]$ echo 'localhost:9898:pgpool:<pgpool user password>' > ~/.pcppass
[all servers]$ chmod 600 ~/.pcppass
在线恢复脚本配置:
在线恢复示例脚本recovery_1st_stage 和pgpool_remote_start 安装在/usr/local/pgpool/etc/中。将这些文件复制到主服务器 (pg-master) 的数据目录。
[pgsql-master]$ su - root
[pgsql-master]# cp -p /usr/local/pgpool/etc/recovery_1st_stage.sample /usr/local/pgsql/data/recovery_1st_stage
[pgsql-master]# cp -p /usr/local/pgpool/etc/pgpool_remote_start.sample /usr/local/pgsql/data/pgpool_remote_start
[pgsql-master]# chown postgres:postgres /usr/local/pgsql/data/{recovery_1st_stage,pgpool_remote_start}

#根据 PostgreSQL 安装目录更改PGHOME

[pgsql-master]# vim /usr/local/pgsql/data/recovery_1st_stage
...
PGHOME=/usr/local/pgsql
...

[pgsql-master]# vim /usr/local/pgsql/data/pgpool_remote_start
.. .
PGHOME=/usr/local/pgsql
...
为了使用在线恢复功能,我们需要安装 在PostgreSQL服务器 server1的 template1 上。 pgpool_remote_startpgpool_switch_xlogpgpool_recovery
[pgsql-master]# su - postgres
[pgsql-master]$ psql template1 -c "CREATE EXTENSION pgpool_recovery"
pool_hba.conf配置
pool_hba.conf文件的格式非常接近 PostgreSQL的pg_hba.conf格式。这里我们可以直接将 PostgreSQL 的 pg_hba.conf复制过来
[all servers]$cp /usr/local/pgsql/data/pg_hba.conf /usr/local/pgpool/etc/pool_hba.confpcp.conf配置
[all servers]$ cp /usr/local/pgpool/etc/pcp.conf.sample /usr/local/pgpool/etc/pcp.conf  //此账户密码用于连接pgpool管理
[all servers]$ echo 'pgpool:'`pg_md5 PCP password` >> /usr/local/pgpool/etc/pcp.conf
pool_passwd配置:
[all servers]$ cp /usr/local/pgpool/etc/pool_passwd.sample  /usr/local/pgpool/etc/pool_passwd
[all servers]$ /usr/local/pgpool/bin/pg_md5  -p -m  -u  postgres   /usr/local/pgpool/etc/pool_passwd
[all servers]$ /usr/local/pgpool/bin/pg_md5  -p -m  -u pgpool  /usr/local/pgpool/etc/pool_passwd
[all servers]$ /usr/local/pgpool/bin/pg_md5  -p -m  -u  repl   /usr/local/pgpool/etc/pool_passwd
watchdog看门狗配置:
[postgres@pgsql-master ~]$ vim /usr/local/pgpool/etc/pgpool.conf
use_watchdog = on     #启动功能
Vdelegate_IP = '192.168.1.222'    虚拟ip

#为了启动/关闭虚拟 IP 并发送 ARP 请求,我们设置了 if_up_cmd、if_down_cmd和arping_cmd。此示例中使用的网络接口是“ens33”。由于执行if_up/down_cmd或 arping_cmd命令需要 root 权限,因此在这些命令上使用 setuid 或允许 Pgpool-II启动用户、postgres用户(Pgpool-II 4.1 或更高版本)在没有密码的情况下 运行sudo命令。
if_up_cmd = '/usr/bin/sudo /sbin/ip addr add $_IP_$/24 dev ens33 label ens33:0'
if_down_cmd = '/usr/bin/sudo /sbin/ip addr del $_IP_$/24 dev ens33'
arping_cmd = '/usr/bin/sudo /usr/sbin/arping -U $_IP_$ -w 1 -I ens33'
if_cmd_path = '/sbin'
arping_path = '/usr/sbin'

#配置节点信息:
hostname0 = 'pgsql-master'
wd_port0 = 9000
pgpool_port0 = 9999

hostname1 = 'pgsql-slave'
wd_port1 = 9000
pgpool_port1 = 9999

#指定 lifecheck wd_lifecheck_method的方法 和 lifecheck 间隔wd_interval。在这里,我们使用心跳方法来执行看门狗生命检查。
wd_lifecheck_method = 'heartbeat'
wd_interval = 10


#指定发送和接收心跳信号的所有Pgpool-II节点信息
heartbeat_hostname0 = 'pgsql-master'
heartbeat_port0 = 9694
heartbeat_device0 = ''

heartbeat_hostname1 = 'pgsql-slave'
heartbeat_port1 = 9694
heartbeat_device1 = ''

wd_heartbeat_keepalive = 2   #心跳间隔
wd_heartbeat_deadtime = 30   #检测故障时间

#当Watchdog进程异常终止时,虚拟IP可能在旧的和新的活动pgpool节点上都“启动”。为了防止这种情况,请配置wd_escalation_command以在启动新的活动pgpool节点上的虚拟IP之前关闭其他pgpool节点上的虚拟IP。需要配置脚本使用
wd_escalation_command = '/usr/local/pgpool/etc/escalation.sh'
配置sudo权限:
[all servers]$su - root
[all servers]#vim /etc/sudoers
添加
postgres ALL=NOPASSWD:/sbin/ip
postgres ALL=NOPASSWD:/usr/sbin/arping
配置 escalation.sh脚本
[all servers]$ cp -p /usr/local/pgpool/etc/escalation.sh{.sample,}
[all servers]$ chown postgres:postgres /usr/local/pgpool/etc/escalation.sh
[all servers]$ vi /usr/local/pgpool/etc/escalation.sh
...
PGPOOLS=(pgsql-master pgsql-slave)
VIP=192.168.1.222
DEVICE=ens33
...
server1 上pgpool.conf 的配置完成。将pgpool.conf复制 到其他Pgpool -II节点
[pgsql-master]$ scp -p /usr/local/pgpool/etc/pgpool.conf postgres@pgsql-slave:/usr/local/pgpool/etc/pgpool.conf 启动数据库和pgpool
[all servers]$ pg_ctl -D /usr/local/pgsql/data start     #启动数据库
[all servers]$ pgpool     #启动
[all servers]$ pgpool -n -D > /tmp/pgpool.log 2>&1 &  #后台启动并输出日志
[all servers]$ pgpool stop     #等待所有连接关闭
[all servers]$ pgpool -m fast stop    #强制关闭
设置postgresql备用服务器(可能需要一点时间)
首先,我们应该使用Pgpool-II在线恢复功能 设置PostgreSQL备用服务器。确保pcp_recovery_node命令使用的recovery_1st_stage和pgpool_remote_start 脚本位于PostgreSQL主服务器 ( server1 ) 的数据库集群目录中。
[pgsql-master]$ pcp_recovery_node -h 192.168.1.222 -p 9898 -U pgpool -n 1
密码:
pcp_recovery_node -- 命令成功
执行pcp_recovery_node命令后,验证PostgreSQL备用服务器启动情况
# psql -h 192.168.1.222 -p 9999 -U pgpool postgres -c "show pool_nodes"
Password for user pgpool
 node_id | hostname | port | status | pg_status | lb_weight |  role   | pg_role | select_cnt | load_balance_node | replication_delay | replication_state | replication_sync_state | last_status_change
---------+----------+------+--------+-----------+-----------+---------+---------+------------+-------------------+-------------------+-------------------+------------------------+---------------------
 0       | pgsql-master  | 5432 | up     | up        | 0.5  | primary | primary | 0          | false             | 0                 |                   |                        | 2021-10-19 07:00:57
 1       | pgsql-slave  | 5432 | up     | up        | 0.5  | standby | standby | 0          | true              | 0                 | streaming         | async                  | 2021-10-19 07:00:57
(2 rows)
测试:
切换主备watchdog
使用pcp_watchdog_info确认看门狗状态。首先启动的Pgpool-II服务器作为LEADER运行。
# pcp_watchdog_info -h 192.168.1.222 -p 9898 -U pgpool
Password:
2 2 YES pgsql-master:9999 Linux pgsql-master pgsql-master

server1:9999 Linux pgsql-master pgsql-master 9999 9000 4 LEADER 0 MEMBER  #LEADER
server2:9999 Linux pgsql-slave pgsql-slave 9999 9000 7 STANDBY 0 MEMBER # standby停止活动服务器pgsql-master,然后pgsql-slave。要停止pgsql-master,我们可以停止Pgpool-II 服务或关闭整个系统。在这里,我们停止Pgpool-II服务。
[pgsql-master]# pgpool -m fast stop
# pcp_watchdog_info -p 9898 -h 192.168.1.222 -U pgpool
Password:
3 3 YES pgsql-slave:9999 Linux pgsql-slave pgsql-slave

server2:9999 Linux pgsql-slave pgsql-slave 9999 9000 4 LEADER 0 MEMBER    #  LEADER
server1:9999 Linux pgsql-master pgsql-master 9999 9000 10 SHUTDOWN 0 MEMBER #已经停止启动我们已经停止的 Pgpool-II ,并验证pgsql-master作为备用服务器运行。
[server1]# pgpool -n -d > /tmp/pgpool.log 2>&1 &
# pcp_watchdog_info -p 9898 -h 192.168.1.222 -U pgpool
Password:
3 3 YES pgsql-slave:9999 Linux pgsql-slave pgsql-slave

server2:9999 Linux pgsql-slave pgsql-slave 9999 9000 4 LEADER 0 MEMBER    #  LEADER
server1:9999 Linux pgsql-master pgsql-master 9999 9000 10 STANDBY 0 MEMBER # STANDBY
故障转移:
# psql -h 192.168.1.222 -p 9999 -U pgpool postgres -c "show pool_nodes"
Password for user pgpool:
 node_id | hostname | port | status | pg_status | lb_weight |  role   | pg_role | select_cnt | load_balance_node | replication_delay | replication_state | replication_sync_state | last_status_change
---------+----------+------+--------+-----------+-----------+---------+---------+------------+-------------------+-------------------+-------------------+------------------------+---------------------
 0       | server1  | 5432 | up     | up        | 0.5  | primary | primary | 0          | false             | 0                 |                   |                        | 2021-10-19 07:08:14
 1       | server2  | 5432 | up     | up        | 0.5  | standby | standby | 0          | false             | 0                 | streaming         | async                  | 2021-10-19 07:08:14

(2 rows)
手动停止pgsql-master,再查看:
[pgsql-master]$ pg_ctl -D /usr/local/pgsql/data -m immediate stop
[pgsql-master]$  psql -h 192.168.1.222 -p 9999 -U pgpool postgres -c "show pool_nodes"
Password for user pgpool:
 node_id | hostname | port | status | pg_status | lb_weight |  role   | pg_role | select_cnt | load_balance_node | replication_delay | replication_state | replication_sync_state | last_status_change
---------+----------+------+--------+-----------+-----------+---------+---------+------------+-------------------+-------------------+-------------------+------------------------+---------------------
 0       | pgsql-master  | 5432 | down   | down      | 0.5  | standby | unknown | 0          | false             | 0                 |                   |                        | 2021-10-19 07:10:01
 1       | pgsql-slave  | 5432 | up     | up        | 0.5  | primary | primary | 0          | false             | 0                 |                   |                        | 2021-10-19 07:10:01

(2 rows)

[pgsql-slave]# psql -h pgsql-slave -p 5432 -U pgpool postgres -c "select pg_is_in_recovery()"
pg_is_in_recovery
-------------------
f
#备库已经成为主库
在线恢复
在这里,我们使用Pgpool-II在线恢复功能来恢复pgsql-master(旧的主服务器)作为备用服务器。在恢复旧的主服务器之前,请确保 当前主服务器pgsql-slave的数据库集群目录中存在recovery_1st_stage和pgpool_remote_start脚本。
# pcp_recovery_node -h 192.168.1.222 -p 9898 -U pgpool -n 0
密码:
pcp_recovery_node -- 命令成功
然后验证pgsql-slave是否作为备用服务器启动。
# psql -h 192.168.1.222 -p 9999 -U pgpool postgres -c "show pool_nodes"
Password for user pgpool:
node_id | hostname | port | status | lb_weight |  role   | select_cnt | load_balance_node | replication_delay | replication_state | replication_sync_state | last_status_change
---------+----------+------+--------+-----------+-----------+---------+---------+------------+-------------------+-------------------+-------------------+------------------------+---------------------
 0       | pgsql-master  | 5432 | up     | up        | 0.5  | standby | standby | 0          | true              | 0                 | streaming         | async                  | 2021-10-19 07:14:06
 1       | pgsql-slave  | 5432 | up     | up        | 0.5  | primary | primary | 0          | false             | 0                 |                   |                        | 2021-10-19 07:10:01

(2 rows)

#备库已经恢复
测试读写分离+负载均衡
测试之前,可以考虑修改文件pgpool.conf中的如下参数:
#开启这些开关后,会在数据库和日志页面详细的展示pgpool收到客户端请求后的请求分发日志
[all servers]$ vim /usr/local/pgpool/etc/pgpool.conf
log_statement=all
log_per_node_statement =on
client_min_messages =log
log_min_messages = info

[all servers]$ pgpool reload   #重载生效
开启4个窗口分别进行如下操作:
[pgsql-master]$ psql -U postgres -h 192.168.1.222 -p 9999 -d test

#create table test(id int);
#insert into test values(1);
#select * from test;
pgsql+pgpool常见问题:
watchdog节点故障后不转移:
如果看门狗节点数为偶数,则需要开启enable_consensus_with_half_votes参数,比如我们的实验中为两台,则需要打开这个参数,同时,建议集群数量为奇数最优,否则容易脑裂。
recover在线恢复异常:
recover的两个脚本需要进行一定的修改,才能很好的使用,本版本脚本原理依然是依据
pg_basebackup进行流复制。所以解决的方案有两个:1、修改测试官方shell脚本;2、先进行主从流复制集群的方式尽心搭建,然后加入pgpool集群中
关于负载均衡
经过测试,pgpool并不会直接将所有的select请求分发给从服务器,是根据weight的权重进行分配的,这一点,可以根据负载均衡的测试进行观察,在实际生产环境中,可以根据进行合理的资源调配
为主服务器和后备服务器创建复制槽(该步非必做项):
select * frompg_create_physical_replication_slot('pgsql_master');
select * frompg_create_physical_replication_slot('pgsql_slave');
创建后查询复制槽
select * from pg_replication_slots;
复制槽(replicationslot)的作用是:
1.在流复制中,当一个备节点断开连接时,备节点通过hot_standby_feedback提供反馈数据数据会丢失。当备节点重新连接时,它可能因为被主节点发送清理记录而引发查询冲突。复制槽即使在备节点断开时仍然会记录下备节点的xmin(复制槽要需要数据库保留的最旧事务ID)值,从而确保不会有清理冲突。
2.当一个备节点断开连接时,备节点需要的WAL文件信息也丢失了。如果没有复制槽,当备节点重连时,可能已经丢弃了所需要的WAL文件,因此需要完全重建备节点。而复制槽确保这个节点保留所有下游节点需要的WAL文件。
要配置slave使用这个槽,在后备机的recovery.conf中应该配置primary_slot_name,如下:
$ vi $PGDATA/recovery.conf
primary_slot_name = 'pgsql_master'
standby_mode = 'on'
recovery_target_timeline = 'latest'
primary_conninfo = 'user=replicator password=123456 host=192.168.1.200 port=5432 application_name= pgsql_slave'
trigger_file = '/tmp/postgresql.trigger.5432'
---删除复制槽
slave在使用primary_slot_name 参数时是无法删除replication slots
postgres=# SELECT * FROM pg_drop_replication_slot('pgsql_master');
postgres=# SELECT * FROM pg_drop_replication_slot('pgsql_slave');

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)