计算机毕业设计选题推荐:基于大数据的农作物适宜性数据可视化分析(Hadoop+PySpark 全栈)
精彩专栏推荐订阅:在下方主页👇🏻👇🏻👇🏻👇🏻
💖🔥作者主页:计算机毕设木哥🔥 💖
一、项目介绍
农业种植越来越依赖土壤养分与气候条件的综合判断,传统查表或经验选种很难把氮磷钾、温湿雨和作物标签放在同一套视图里对照。不同作物对酸碱度、降雨和养分的偏好差异大,缺少可视化分析手段时,适宜性结论往往停留在零散统计。本文通过开发一个基于大数据的农作物适宜性数据可视化分析系统,用以帮助解决多源环境指标与作物标签难以联动分析、适宜性规律不易直观呈现的问题。
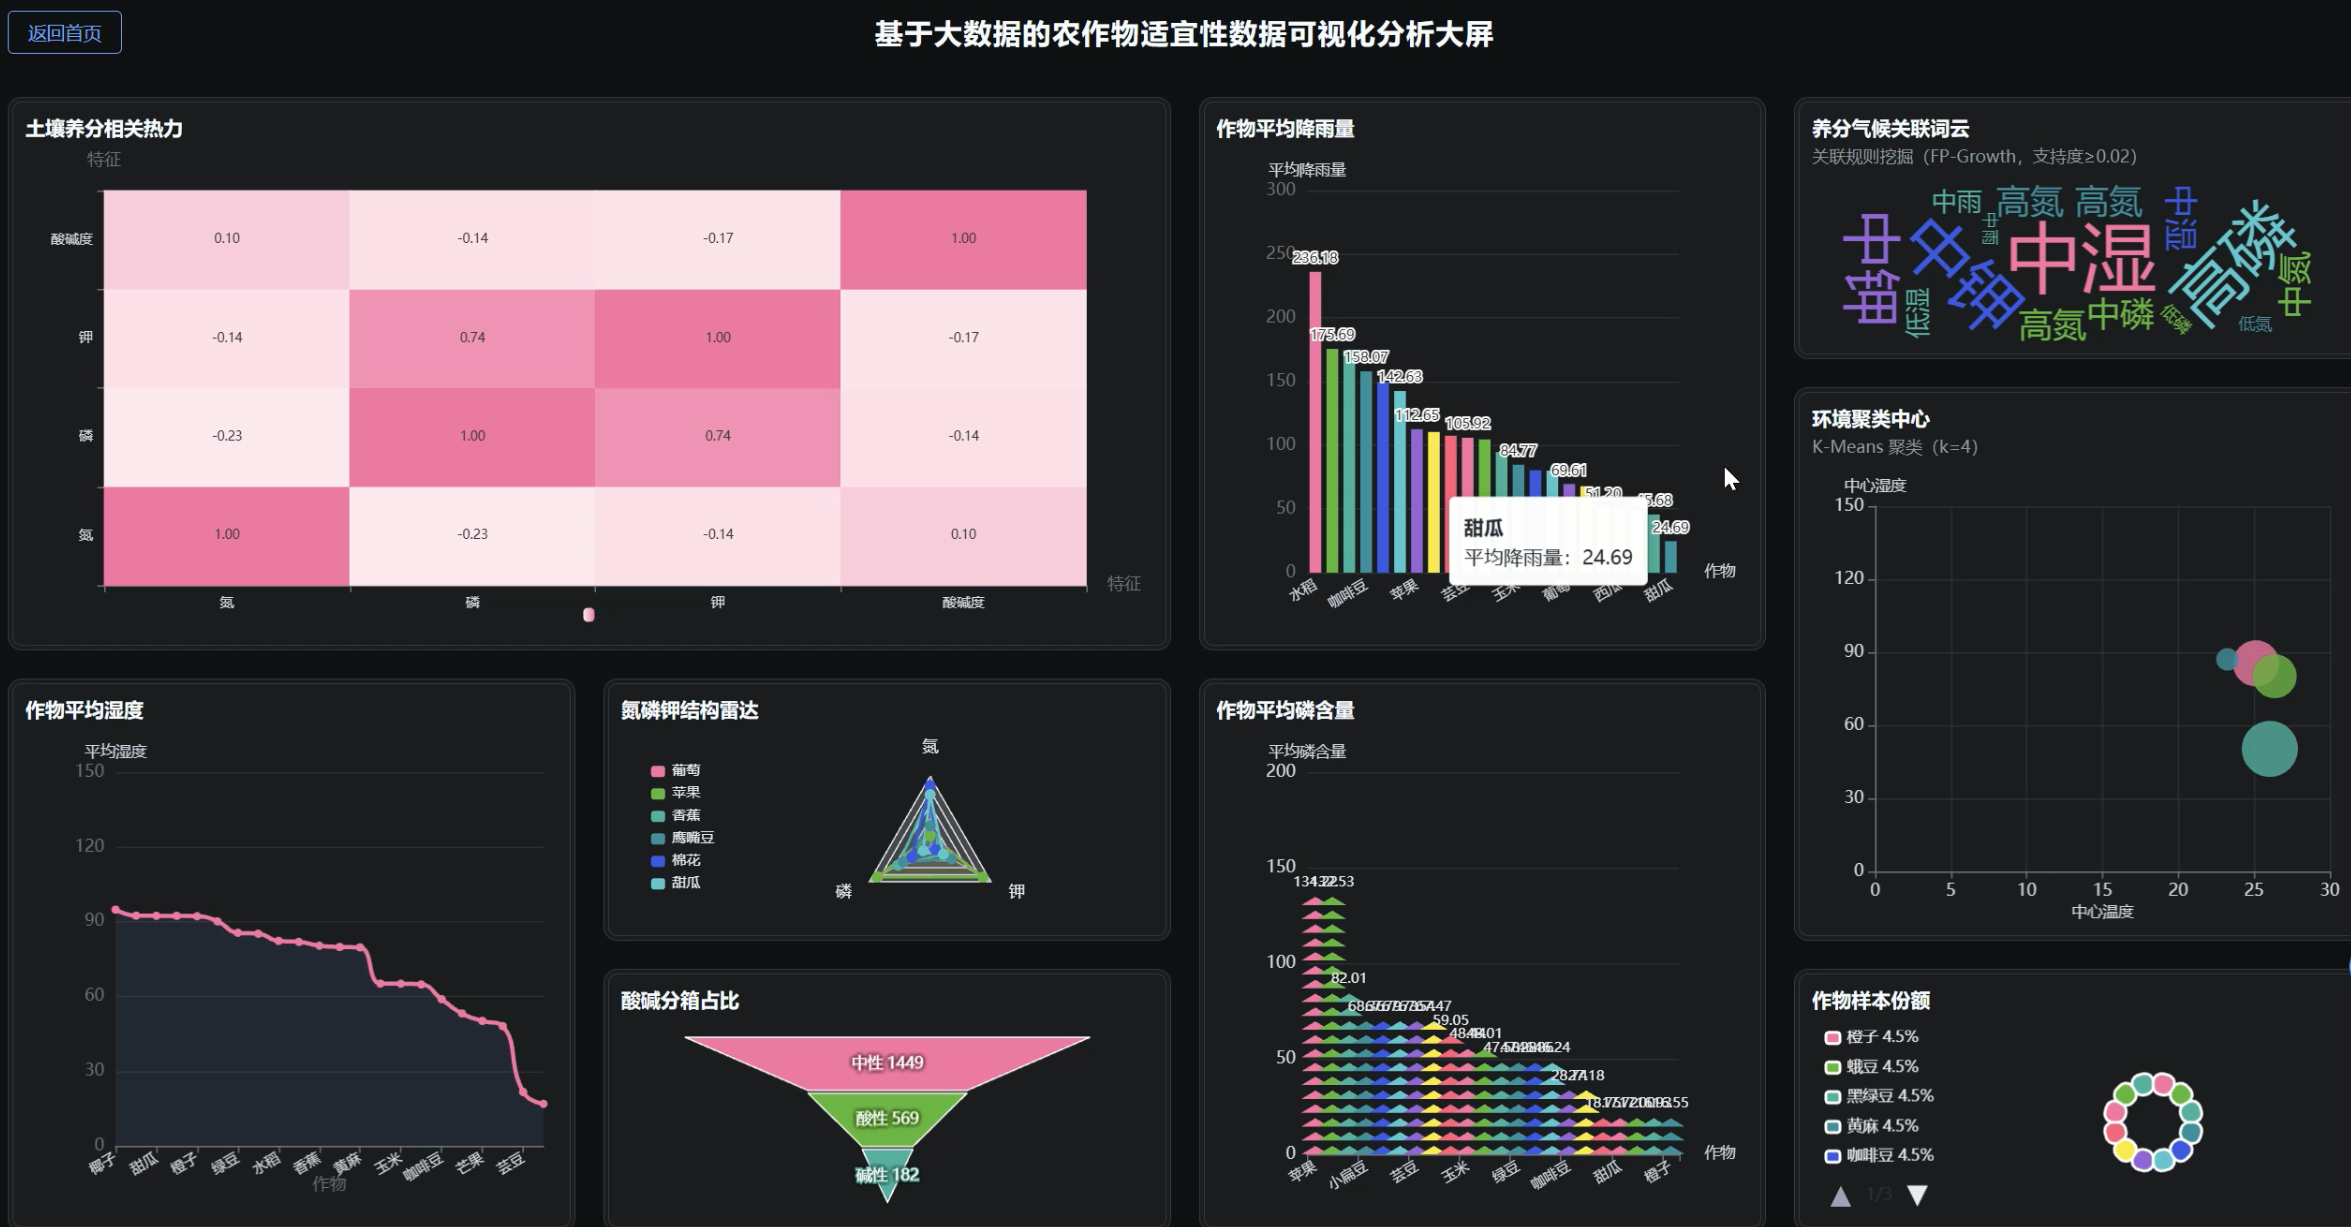
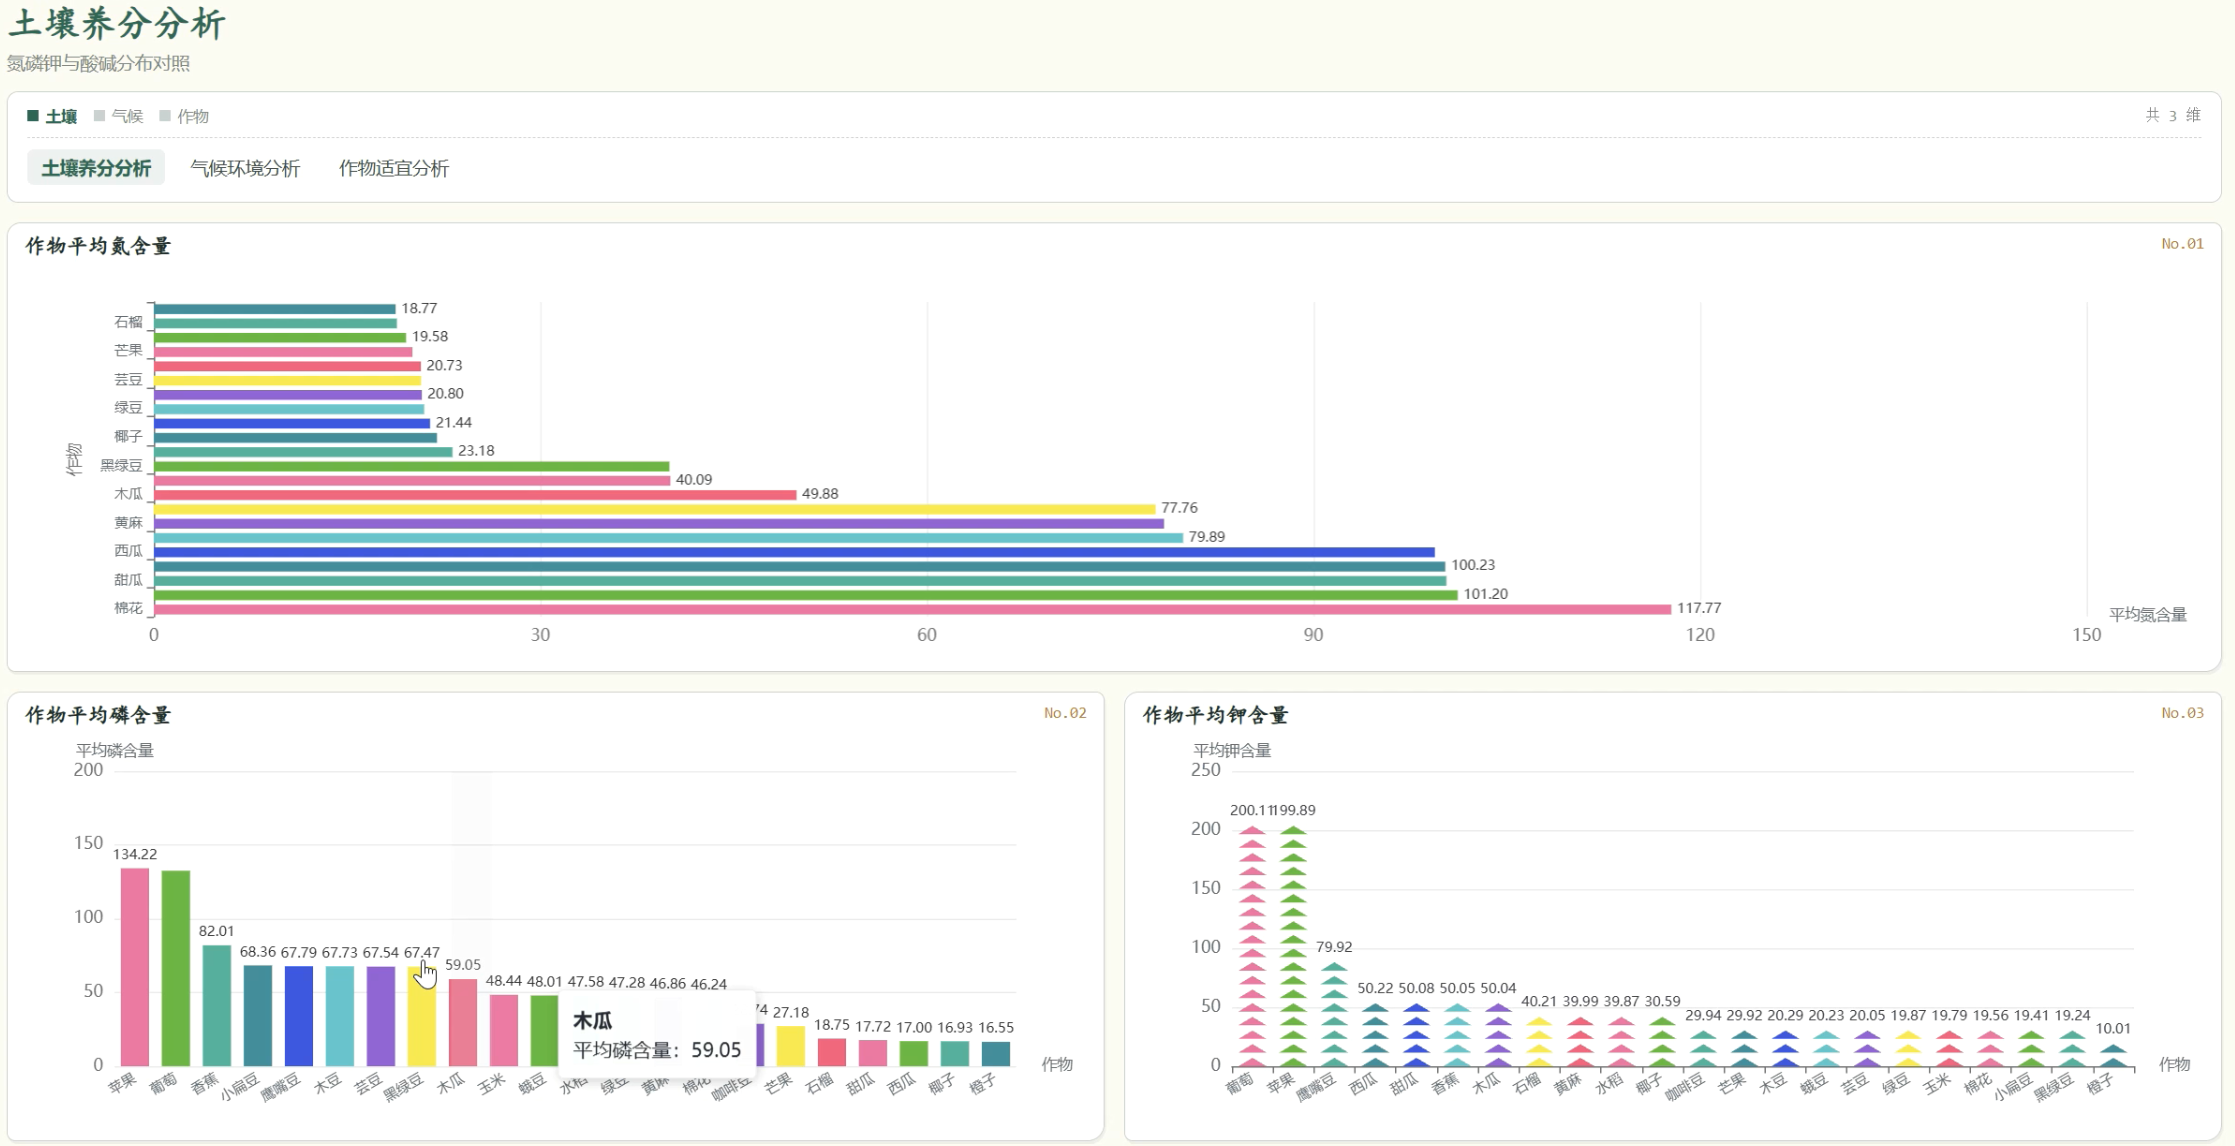
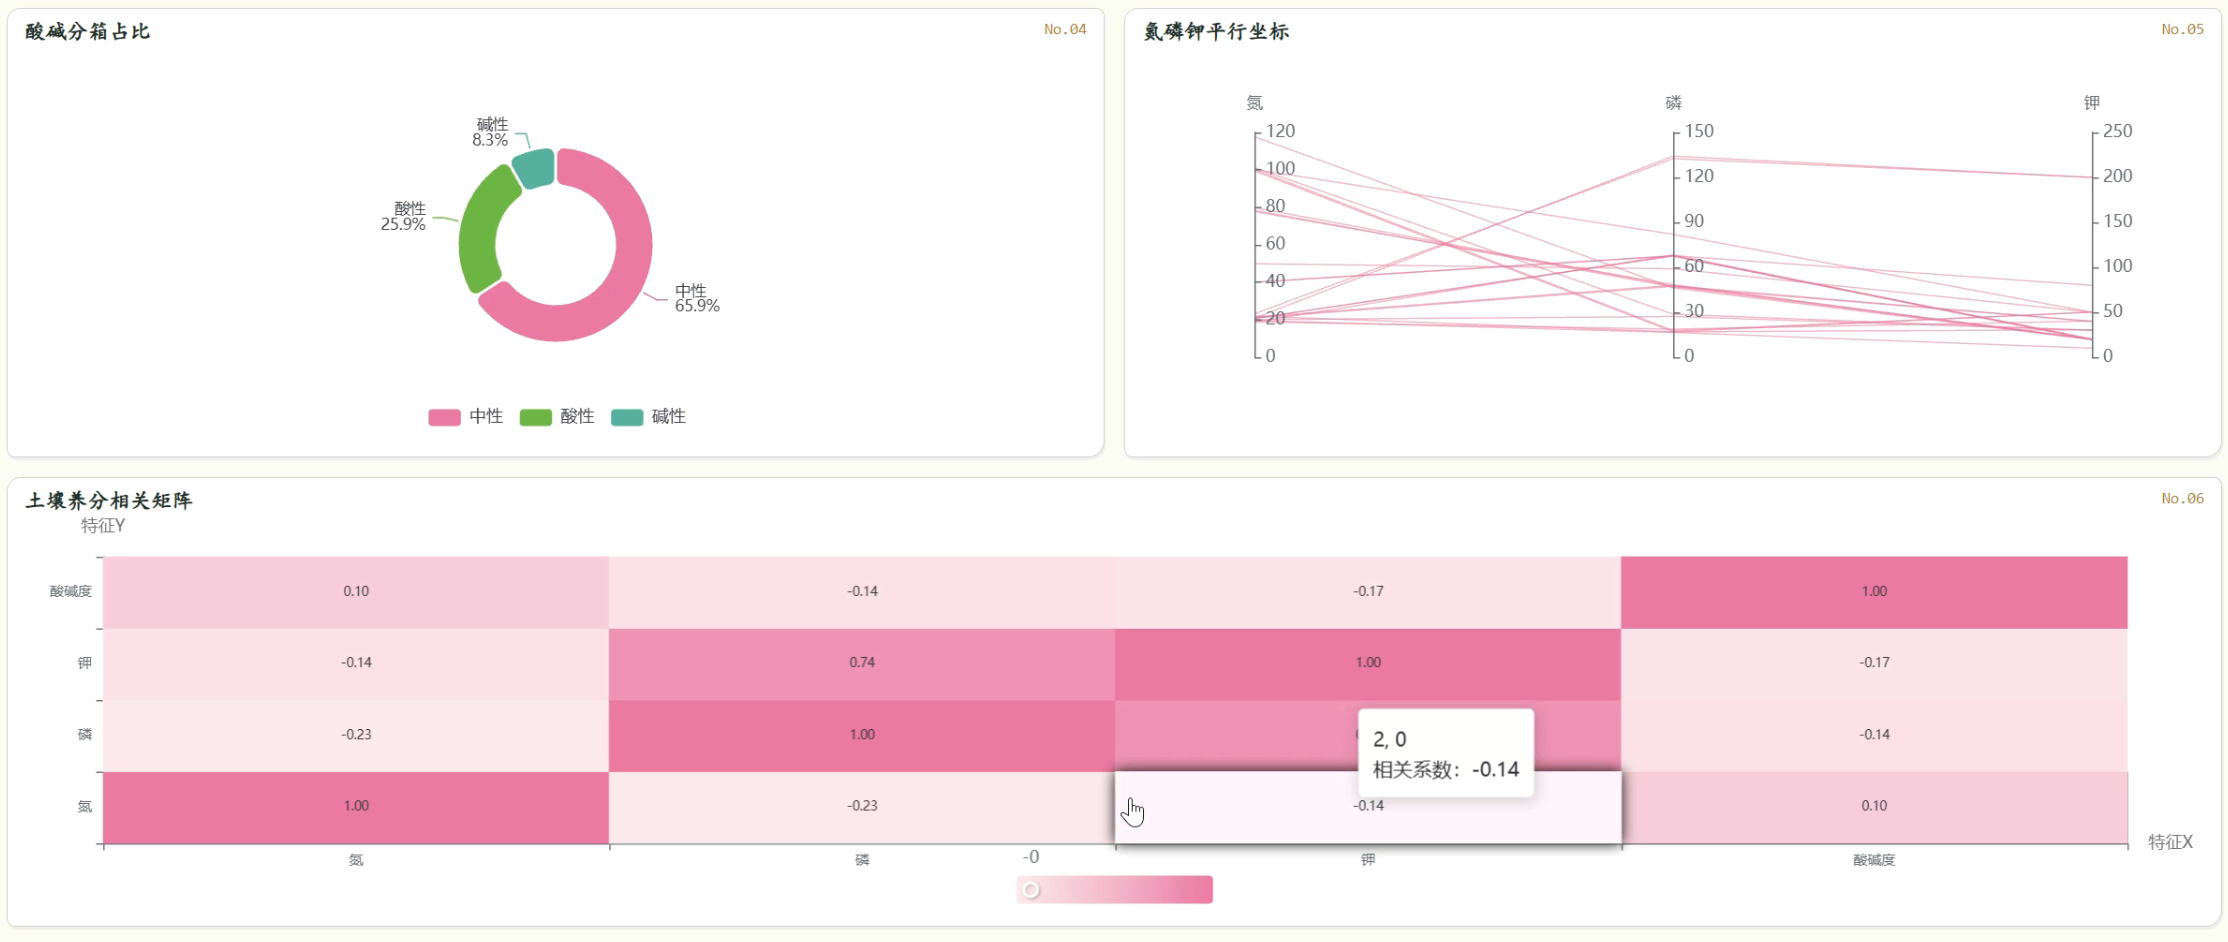
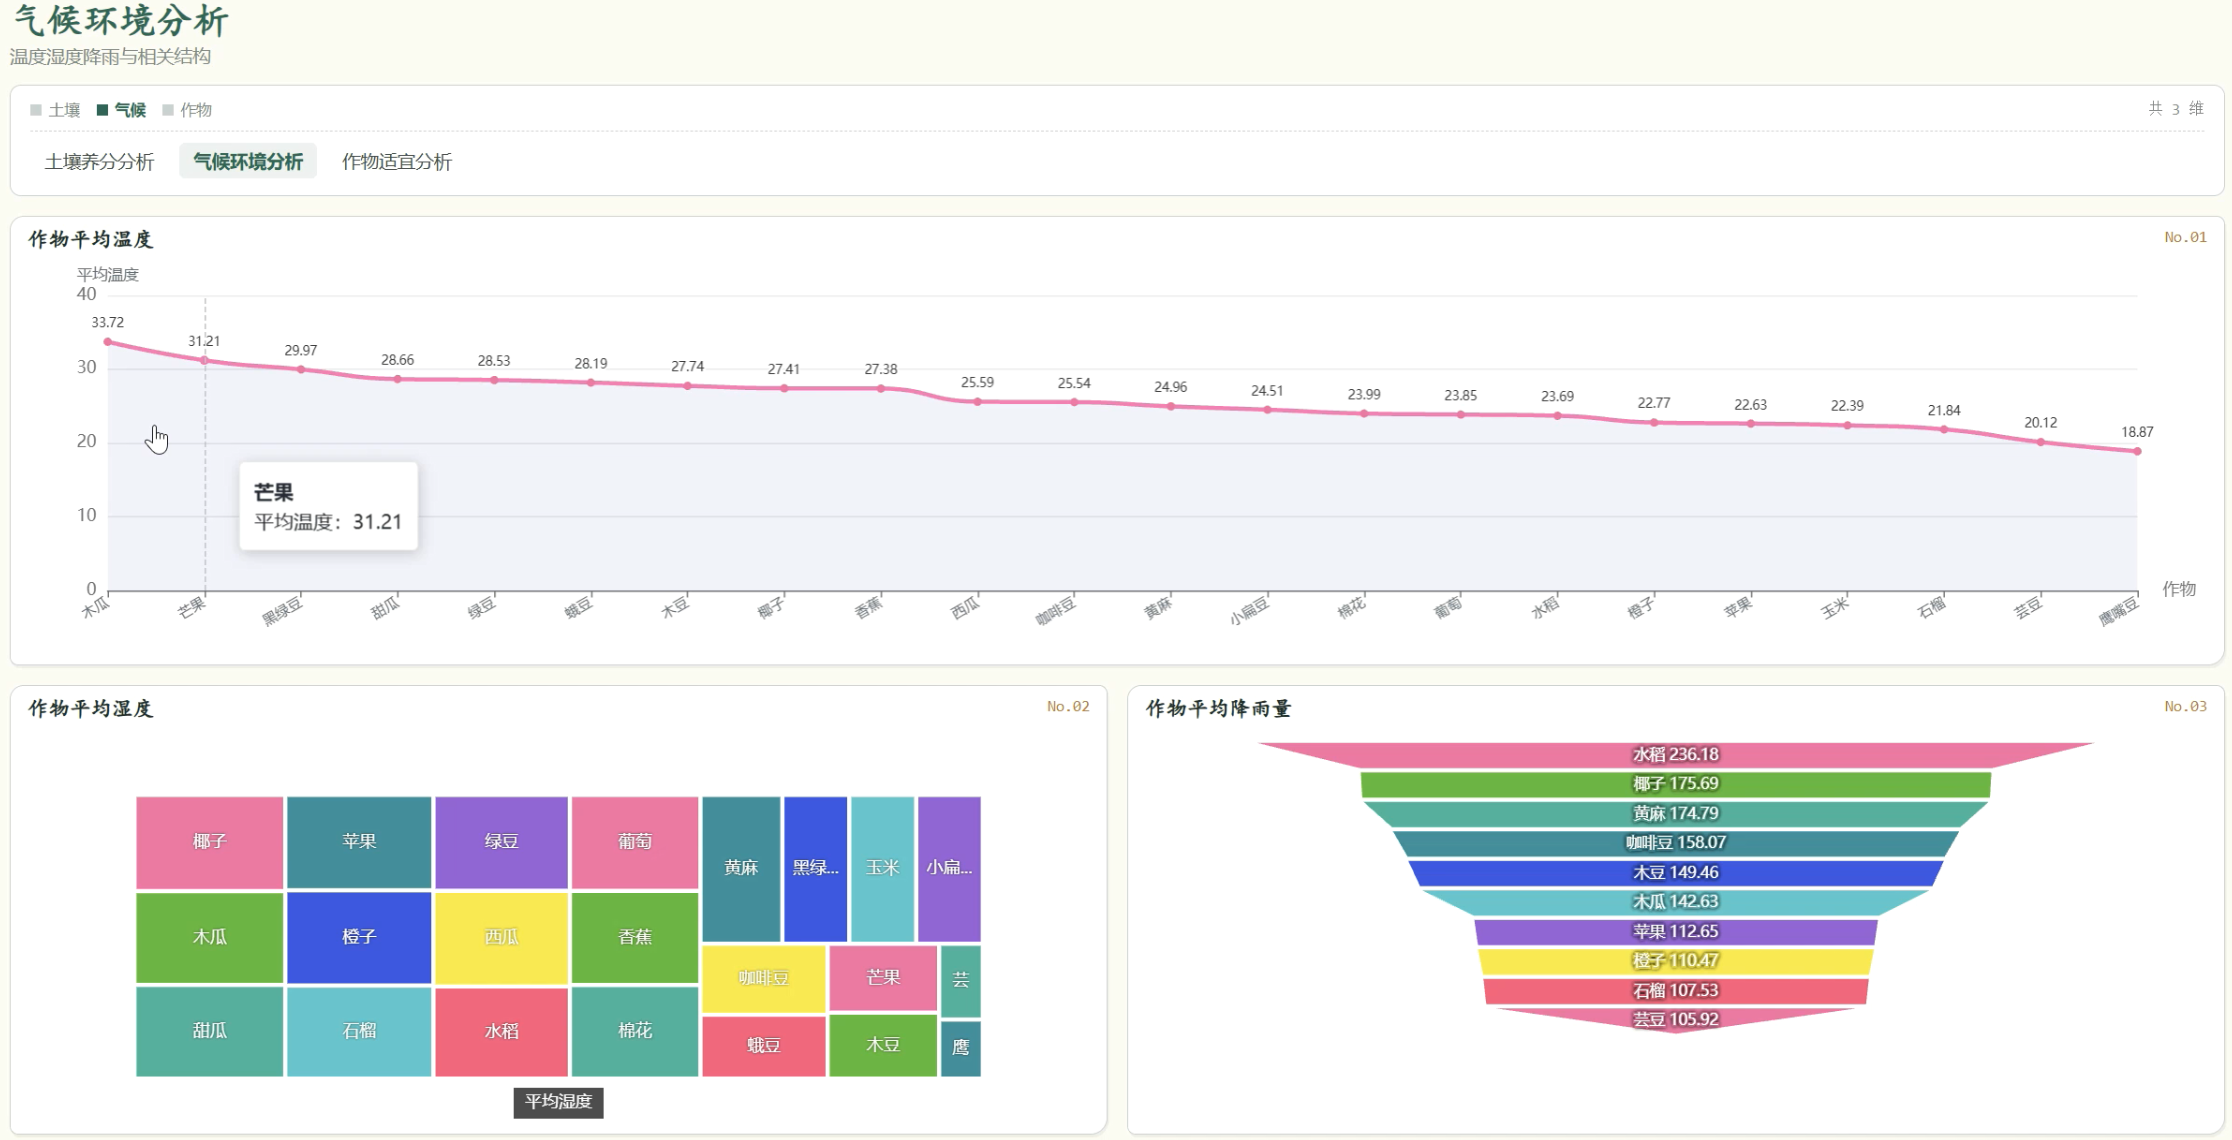
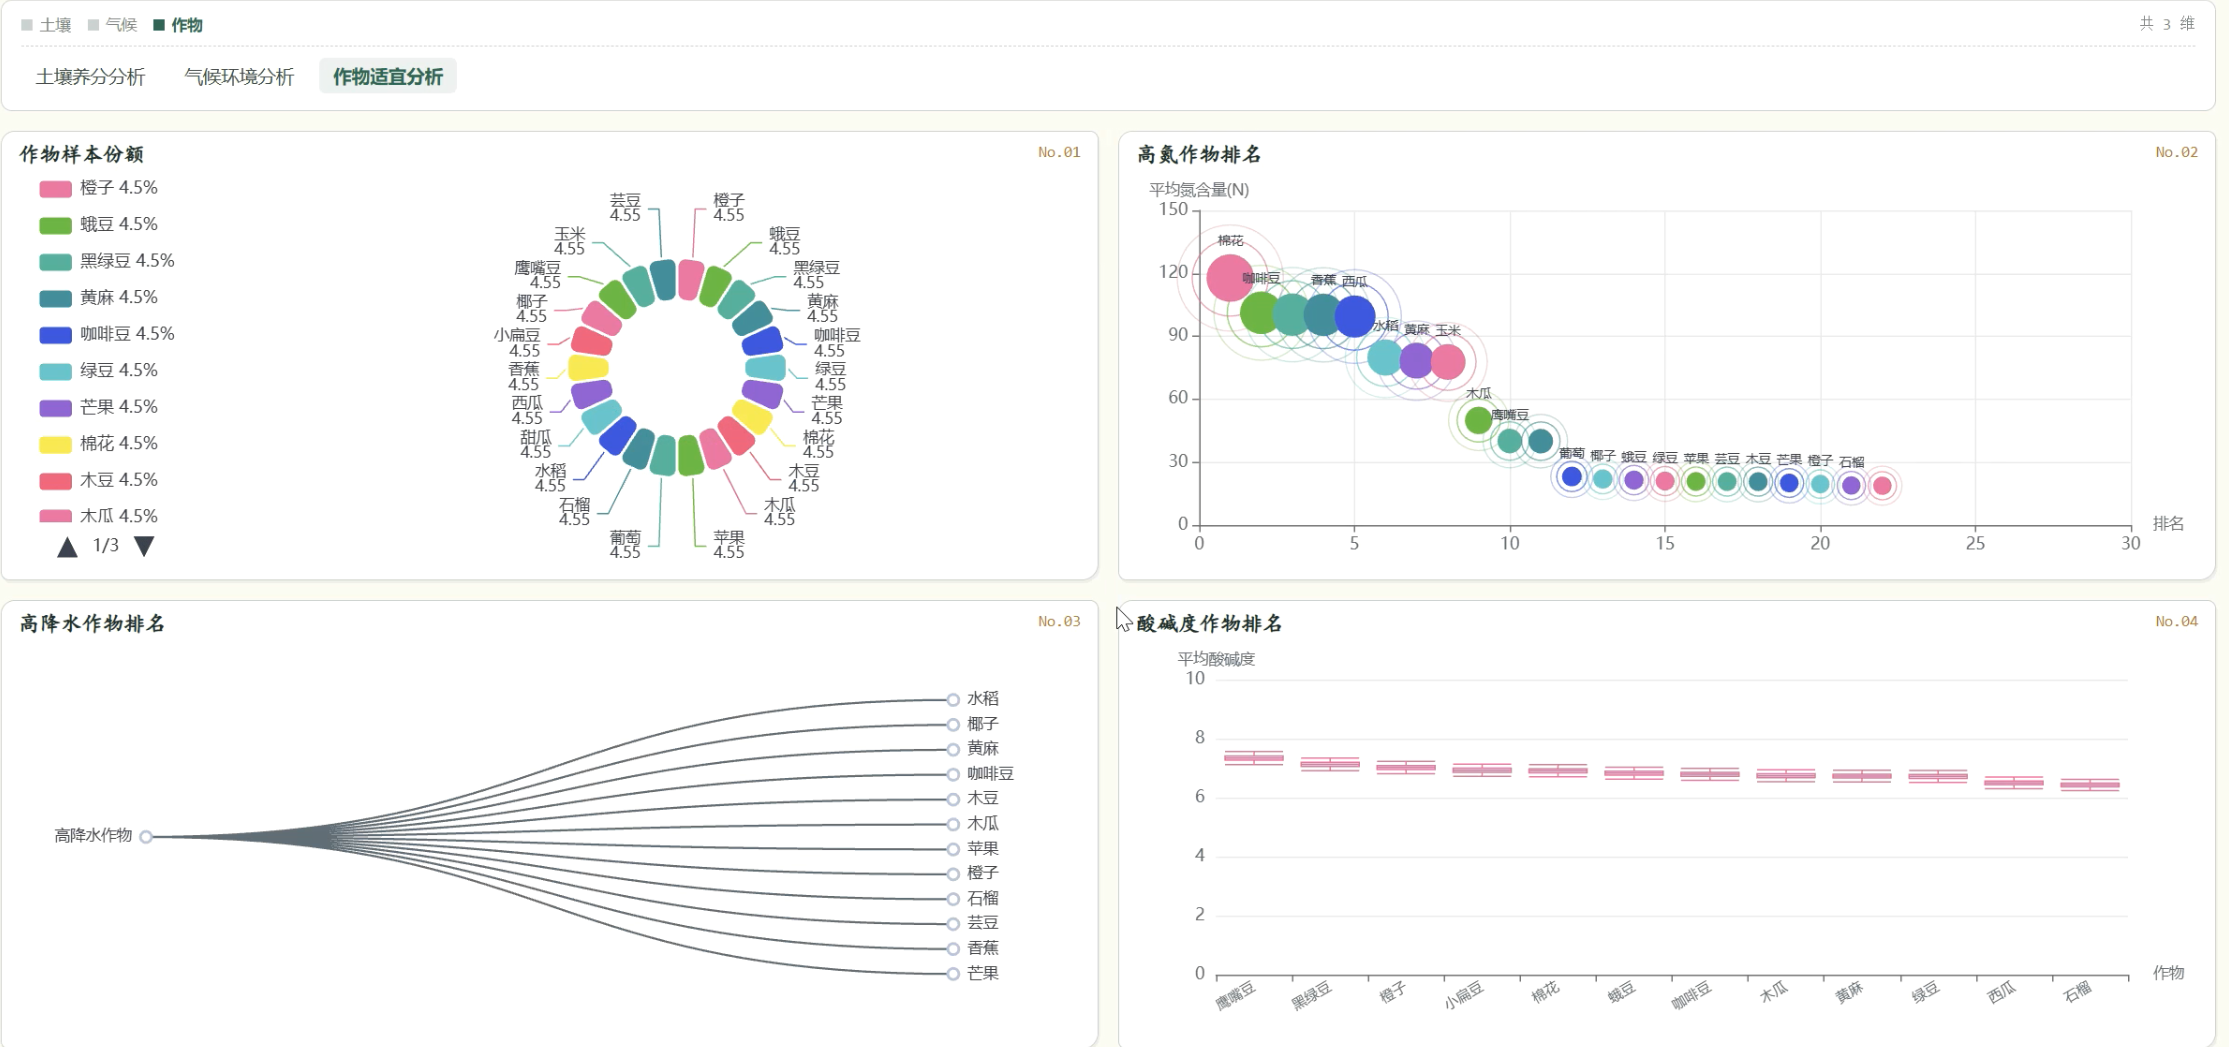
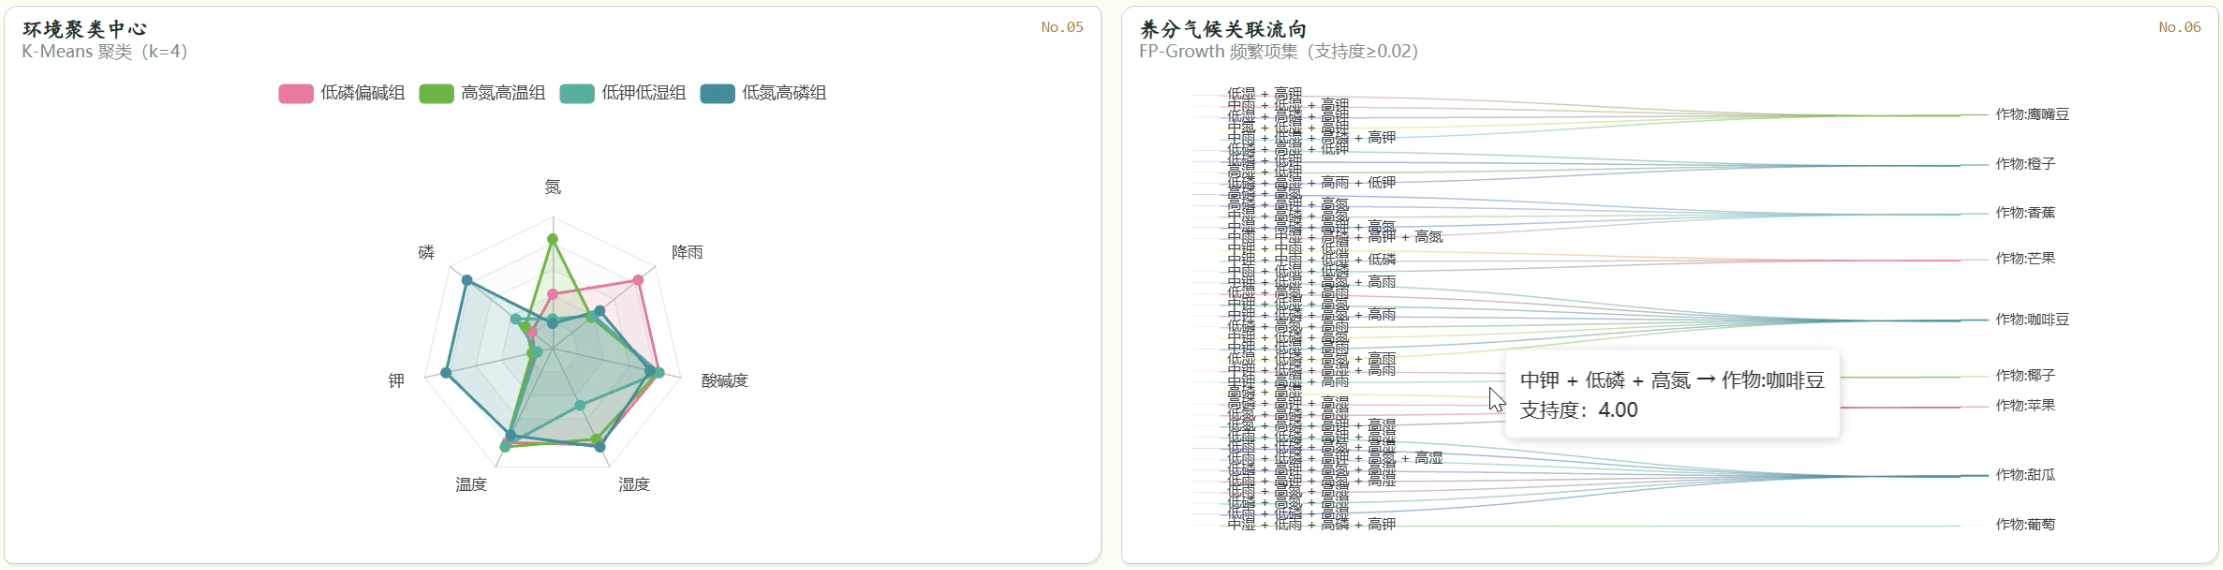
系统采用 Hadoop HDFS 存储、PySpark 3.3.2 完成预处理与 18 项分析计算,K-Means 做环境聚类分群、FP-Growth 挖掘养分气候共现规则;Web 端以 Django 2.0 封装分析接口,Vue2 与 ECharts 5 展示土壤养分、气候环境、作物适宜三个维度分析页和单屏数据大屏,MySQL 管理作物推荐明细。功能上覆盖氮磷钾均值对比、酸碱与降雨分箱、温湿散点、相关矩阵、高氮高雨适宜排名、聚类中心与关联流向等结果,并支持推荐数据的增删改查。
经过系统测试,本网站能把 Spark 分析结果稳定映射到图表与接口,满足农业从业者、种植规划人员和计算机专业学习者查看环境—作物关联、对比适宜条件、维护样本数据的需求,对把大数据处理与可视化分析落到具体作物适宜性场景有一定参考意义。
二、视频展示
三、开发环境
- 大数据技术:Hadoop、Spark、Hive
- 开发技术:Python、Django框架、Vue、Echarts
- 软件工具:Pycharm、DataGrip、Anaconda
- 可视化 工具 Echarts
四、系统展示
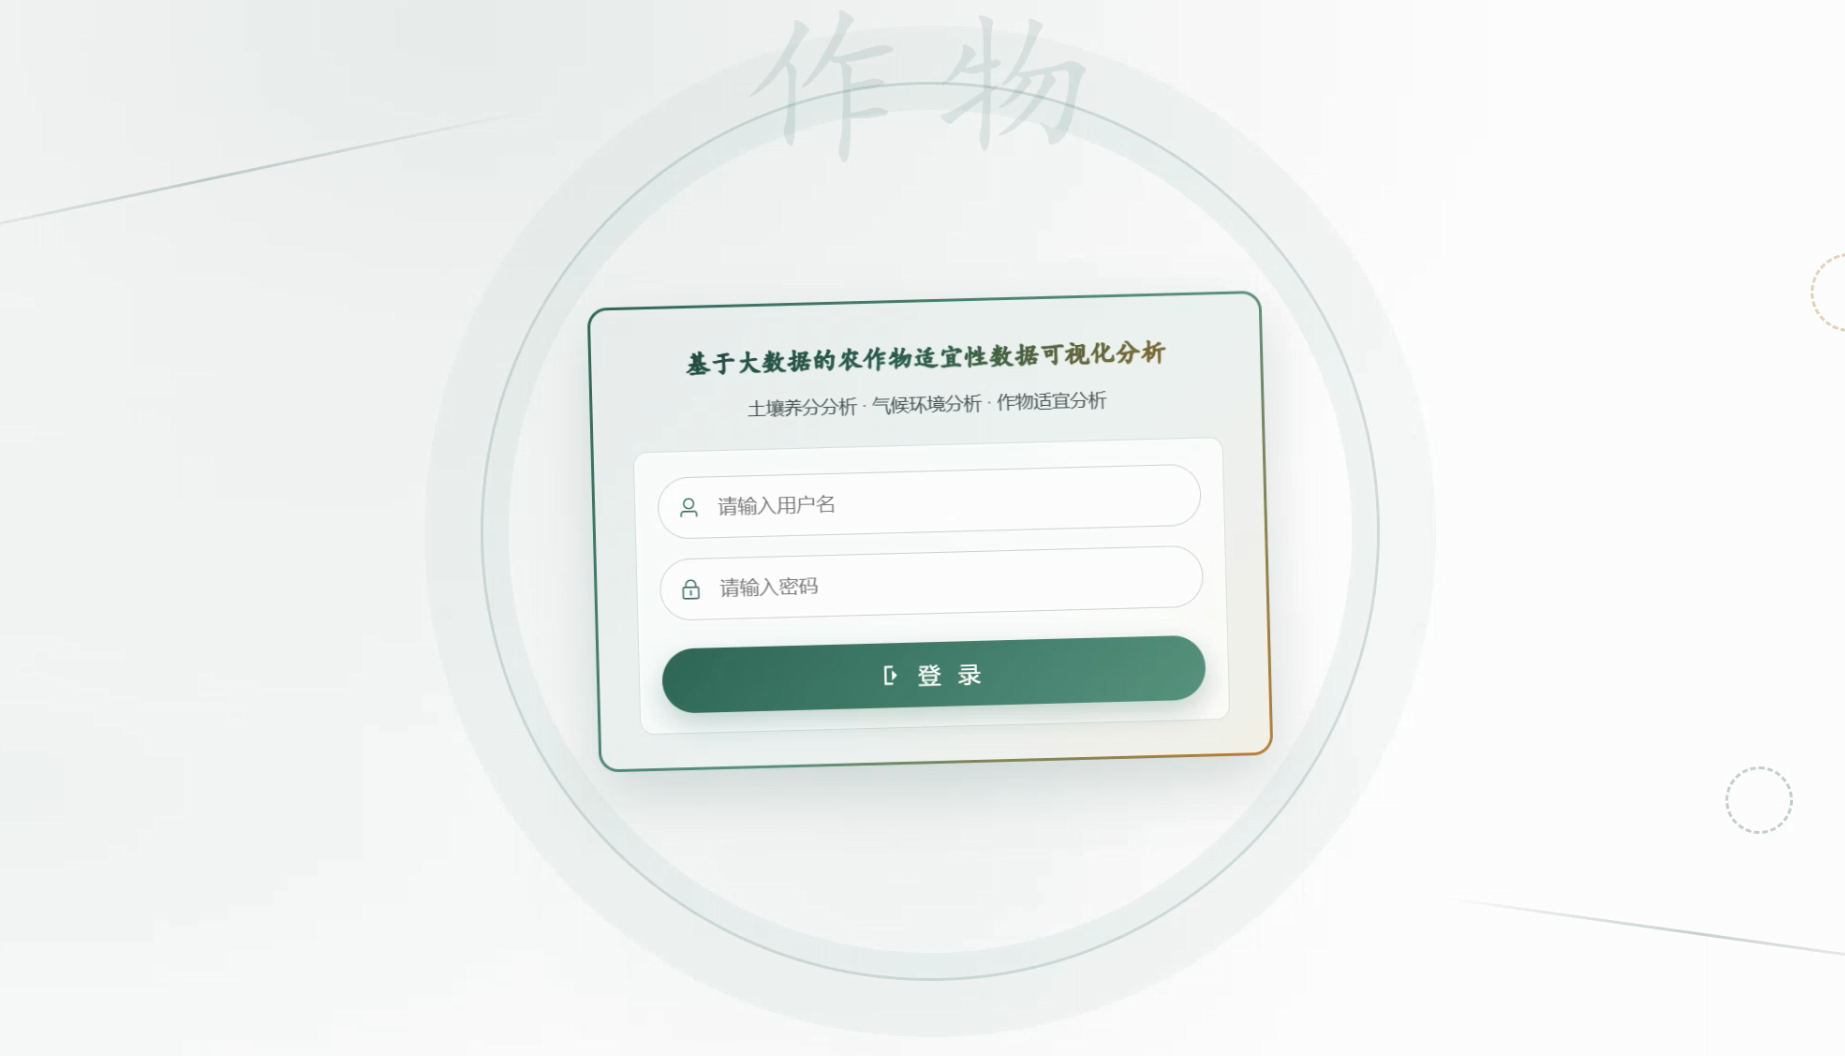
系统页面模块展示:
五、代码展示
// admin/src/views/crop_fitness_analysis_v.vue(节选)
initKmeans() {
  this.fetchAnalysis('env_kmeans_clusters').then((rows) => {
    const fields = [
      { key: 'center_n', name: '氮' }, { key: 'center_p', name: '磷' },
      { key: 'center_k', name: '钾' }, { key: 'center_temp', name: '温度' },
      { key: 'center_humidity', name: '湿度' }, { key: 'center_ph', name: '酸碱度' },
      { key: 'center_rainfall', name: '降雨' }
    ]
    const indicators = fields.map((f) => ({
      name: f.name,
      max: Math.max(...rows.map((r) => Number(r[f.key] || 0)), 1) * 1.2
    }))
    const series = rows.map((r) => ({
      name: String(r.cluster_name || '未命名组'),
      values: fields.map((f) => Number(r[f.key] || 0))
    }))
    const opt = buildRadar(indicators, series, { radius: '55%', center: ['50%', '58%'] })
    this.applyOpt(chart, opt, this.kmeansConfig)
  })
},

initFp() {
  this.fetchAnalysis('nutrient_climate_fpgrowth').then((rows) => {
    const top = [...rows]
      .sort((a, b) => Number(b.support || 0) * Number(b.lift || 0) -
                       Number(a.support || 0) * Number(a.lift || 0))
      .slice(0, 40)
    const nodes = Object.keys(nameSet).filter(Boolean).map((n) => ({ name: n }))
    const links = top.map((r) => ({
      source: String(r.antecedent || ''),
      target: String(r.consequent || ''),
      value: Number(r.support || 0) * 100
    })).filter((l) => l.source && l.target && l.source !== l.target)
    const opt = buildSankey(nodes, links, { name: '支持度' })
    this.applyOpt(chart, opt, this.fpConfig)
  })
}
六、项目文档展示

七、项目总结
本文围绕「基于大数据的农作物适宜性数据可视化分析」课题,完成了从数据预处理、Spark 分布式分析到 Web 可视化展示的全链路建设。以 Crop_recommendation 数据集为基础,经清洗与中文化映射后上传 HDFS,利用 PySpark 完成 18 项分析计算,其中 K-Means 对氮磷钾及温湿雨等七维特征做环境聚类分群,FP-Growth 挖掘养分档位与作物标签的共现关联,其余分析涵盖土壤养分均值对比、酸碱与降雨分箱、温湿散点及相关矩阵、高氮高雨适宜排名等维度。
系统后端采用 Django 封装 18 路分析接口,MySQL 存储预处理明细;前端以 Vue2 与 ECharts 构建土壤养分、气候环境、作物适宜三个分析页及单屏数据大屏,并支持作物推荐数据的增删改查。测试表明,分析结果可稳定映射至图表与接口,便于从土壤、气候、适宜性三个角度对照查看作物环境偏好。
本课题将大数据处理与可视化分析落到具体农业场景,对种植规划参考与计算机专业毕设实践均有一定意义。后续可在更大样本、地域分区或预测模型方向继续扩展。
大家可以帮忙点赞、收藏、关注、评论啦 👇🏻
💖🔥作者主页:计算机毕设木哥🔥 💖

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 11
 0
- 0


 已为社区贡献2条内容

所有评论(0)