为什么 WAIC 2026 ,所有 AI 算力厂商都在讲“超节点“?一文看懂背后的技术逻辑
在今年 WAIC 2026 上,有一个现象非常明显:
无论是华为昇腾、阿里云、新华三,还是锐捷、曙光、壁仞、燧原、沐曦等厂商,几乎都把**超节点(Super Node)**放在了展台最核心的位置。
这不禁让人思考一个问题:
为什么超节点会突然成为 AI 算力行业的共同方向?
结合现场观察以及行业发展趋势,本文尝试从技术角度聊聊背后的原因。
一、超节点到底是什么?
简单来说,超节点并不是一种新的 GPU。
它是一种新的算力组织方式。
传统服务器通常由几张 GPU 组成,而超节点通过高速互联网络,把几十张、几百张,甚至上千张 GPU 组成一个统一的计算单元。
对于上层训练任务来说,这些 GPU 更像是一台大型计算机,而不是大量独立的设备。
因此,超节点的核心目标并不是提升单卡性能,而是提升整个集群的协同效率。
二、为什么今年大家都开始做超节点?
主要有三个原因。
1. 单卡性能提升越来越困难
近年来,GPU 制程不断演进,先进封装、HBM、高速互联等技术持续升级。
但与此同时,研发成本和制造成本也越来越高。
继续提升单卡性能,已经不是唯一的优化方向。
相比之下,提升整个集群的协同效率,往往能够带来更高的整体收益。
2. 大模型训练越来越依赖集群
随着大模型参数规模不断增长,训练任务越来越依赖数百张甚至数千张 GPU。
此时,GPU 本身的算力只是基础。
GPU 与 GPU 之间的数据通信效率,开始直接影响整体训练效率。
因此,今年各家厂商都把重点放在了超节点建设上。
3. AI 算力竞争已经进入"系统时代"
过去几年,行业讨论更多的是:
-
GPU 性能
-
显存容量
-
带宽
-
制程工艺
而今年 WAIC 可以明显感受到,行业开始讨论:
-
GPU 如何互联?
-
超节点如何部署?
-
集群如何扩展?
-
系统如何稳定运行?
竞争对象已经从单卡,逐渐演变为整个算力系统。
三、三家代表厂商,三种不同思路
虽然大家都在做超节点,但侧重点并不相同。
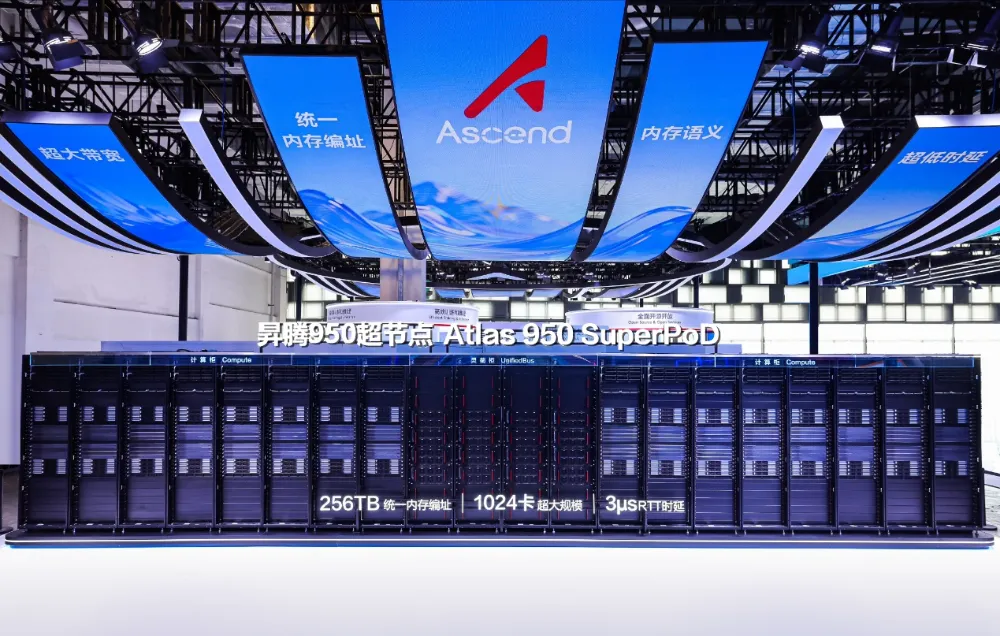
华为更关注规模。
昇腾 Atlas 950 SuperPoD 将单机柜提升至 1,024 张算力卡,并规划更大规模集群。
代表的是超大规模训练能力。
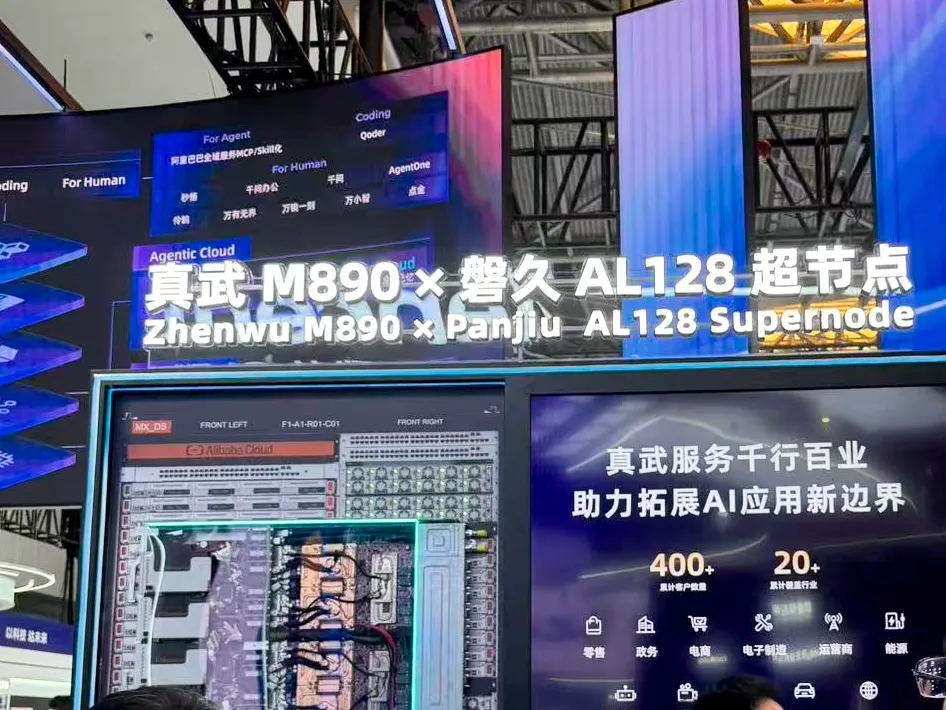
阿里云更关注标准化。
通过灵骏真武 M890,把超节点作为标准算力单元向公有云开放。
代表的是降低使用门槛。
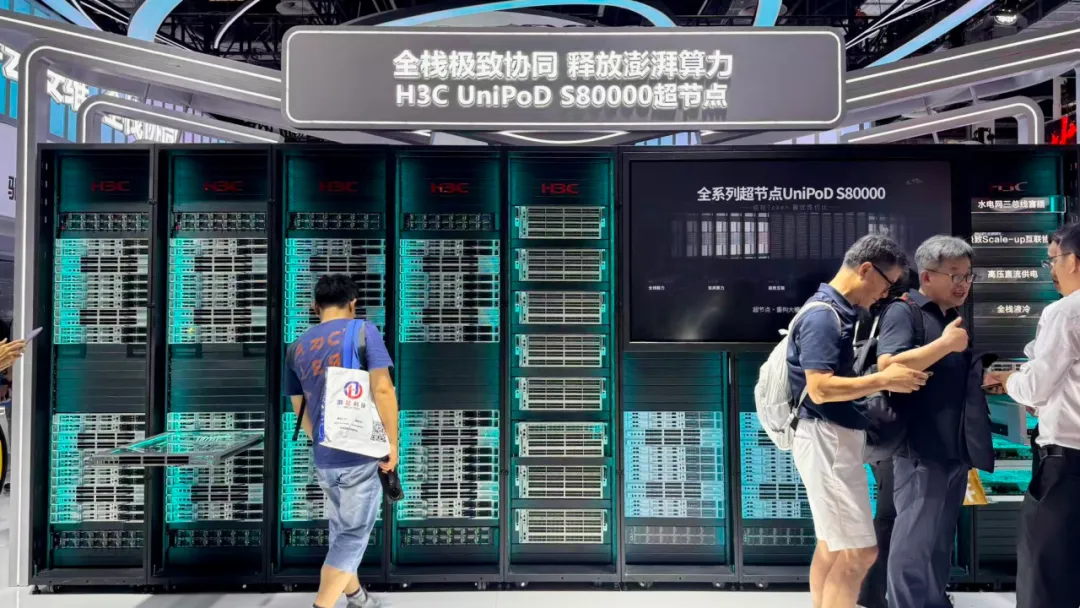
新华三更关注弹性。
提供从 32 卡到 1,024 卡不同规格方案,希望覆盖不同规模客户需求。
代表的是灵活部署能力。
虽然实现路径不同,但目标一致:
让 GPU 从单卡计算,逐渐演变为集群计算。
四、真正的挑战,其实不是"连起来"
今年逛展过程中,还有一个问题让我印象很深。
大家都在讨论:
如何建设超节点。
但很少有人讨论:
如何长期稳定运行超节点。
随着 GPU 数量不断增加,系统复杂度也同步提升。
例如:
-
GPU 掉线;
-
高速互联异常;
-
液冷系统故障;
-
电源及供电异常;
-
节点间通信异常。
这些问题在单机时代影响有限。
但在千卡级超节点中,都可能放大为整个训练任务中断。
因此,超节点真正的挑战,不只是部署,而是持续运行。
五、为什么运维能力会越来越重要?
目前不少超节点产品仍处于 POC 测试或小批量交付阶段。
行业关注重点更多放在产品能力和交付能力上。
但随着未来越来越多千卡、万卡集群投入使用,稳定运行能力的重要性会越来越高。
包括:
-
故障快速定位;
-
GPU 模块快速更换;
-
液冷系统巡检;
-
备件保障;
-
集群恢复效率。
这些能力,将直接影响 AI 集群的可用率和整体运营成本。
作为长期服务 GPU 服务器运维的企业,我们比很多人更关注超节点"如何长期稳定运行"这个问题。
写在最后
今年 WAIC 给我最大的感受,并不是某一家厂商发布了哪款产品。
而是整个行业的发展方向已经发生了变化。
过去,比的是:
GPU 能不能更强。
现在,比的是:
如何让更多 GPU 高效协同,并长期稳定运行。
我认为,超节点并不是终点,而是 AI 算力进入系统化竞争阶段的重要标志。
未来,随着超节点逐步落地,行业竞争的重点也将从峰值算力,逐步延伸到系统可靠性、运维能力以及长期稳定运行能力。
欢迎大家交流讨论:你认为超节点时代,最大的技术挑战是什么?

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)