存量 DGX/HGX集群故障频发,批量芯片维修如何挽回算力损失
·
现阶段大量 DGX、HGX、MGX 商用算力集群常年不间断高负荷运转,硬件故障集中显现。单张故障显卡直接报废会产生高额资产损失,集群停机还会中断模型训练任务,加重企业运营负担。本文围绕四大主流算力平台,梳理批量故障标准化处理方案,详解维核智算面向整机集群的整套维修落地模式。
一、四大算力平台故障特点,维修价值差异明显
市面上主流 AI 超算分为 DGX、HGX、MGX、EGX 四类架构,硬件故障高发点位各有区别,维修处理思路需针对性区分:
- DGX 整机平台:一体化原厂超算,故障多集中在 SXM 模组、板卡供电线路,单卡故障容易影响整机算力调度;
- HGX 模组平台:OEM 配套服务器,常见 BGA 底层虚焊、HBM 显存通道报错,需要开展芯片级深度维修;
- MGX 模块化服务器:硬件拆装便捷,故障多为 SXM 触点氧化、电容损毁等轻度硬件问题;
- EGX 边缘算力设备:运行负载偏低,故障发生率低,以设备识别异常为主。
不少机房运维未区分平台差异统一处理,要么直接报废硬件,要么选择简易维修,长期拉高整体运维开销。
二、三种故障处置方案成本对比
结合机房实际运维数据,三种处理方式的成本、效率差距清晰:
- 直接报废:单卡高额资产完全损失,集群算力缺口难以快速填补,持续产生停机损耗;
- 官方换货:受相关管制限制,国内很难申请官方维修、置换服务,基本无法落地;
- 第三方芯片级维修:成本仅为全新显卡的 10%-30%,常规交付周期15天,H 系列修复率 98%、B 系列 92%,有效减少硬件资产损耗。
对于持有数十上百张 GPU 的大型算力集群,批量维修的成本优势会更加突出。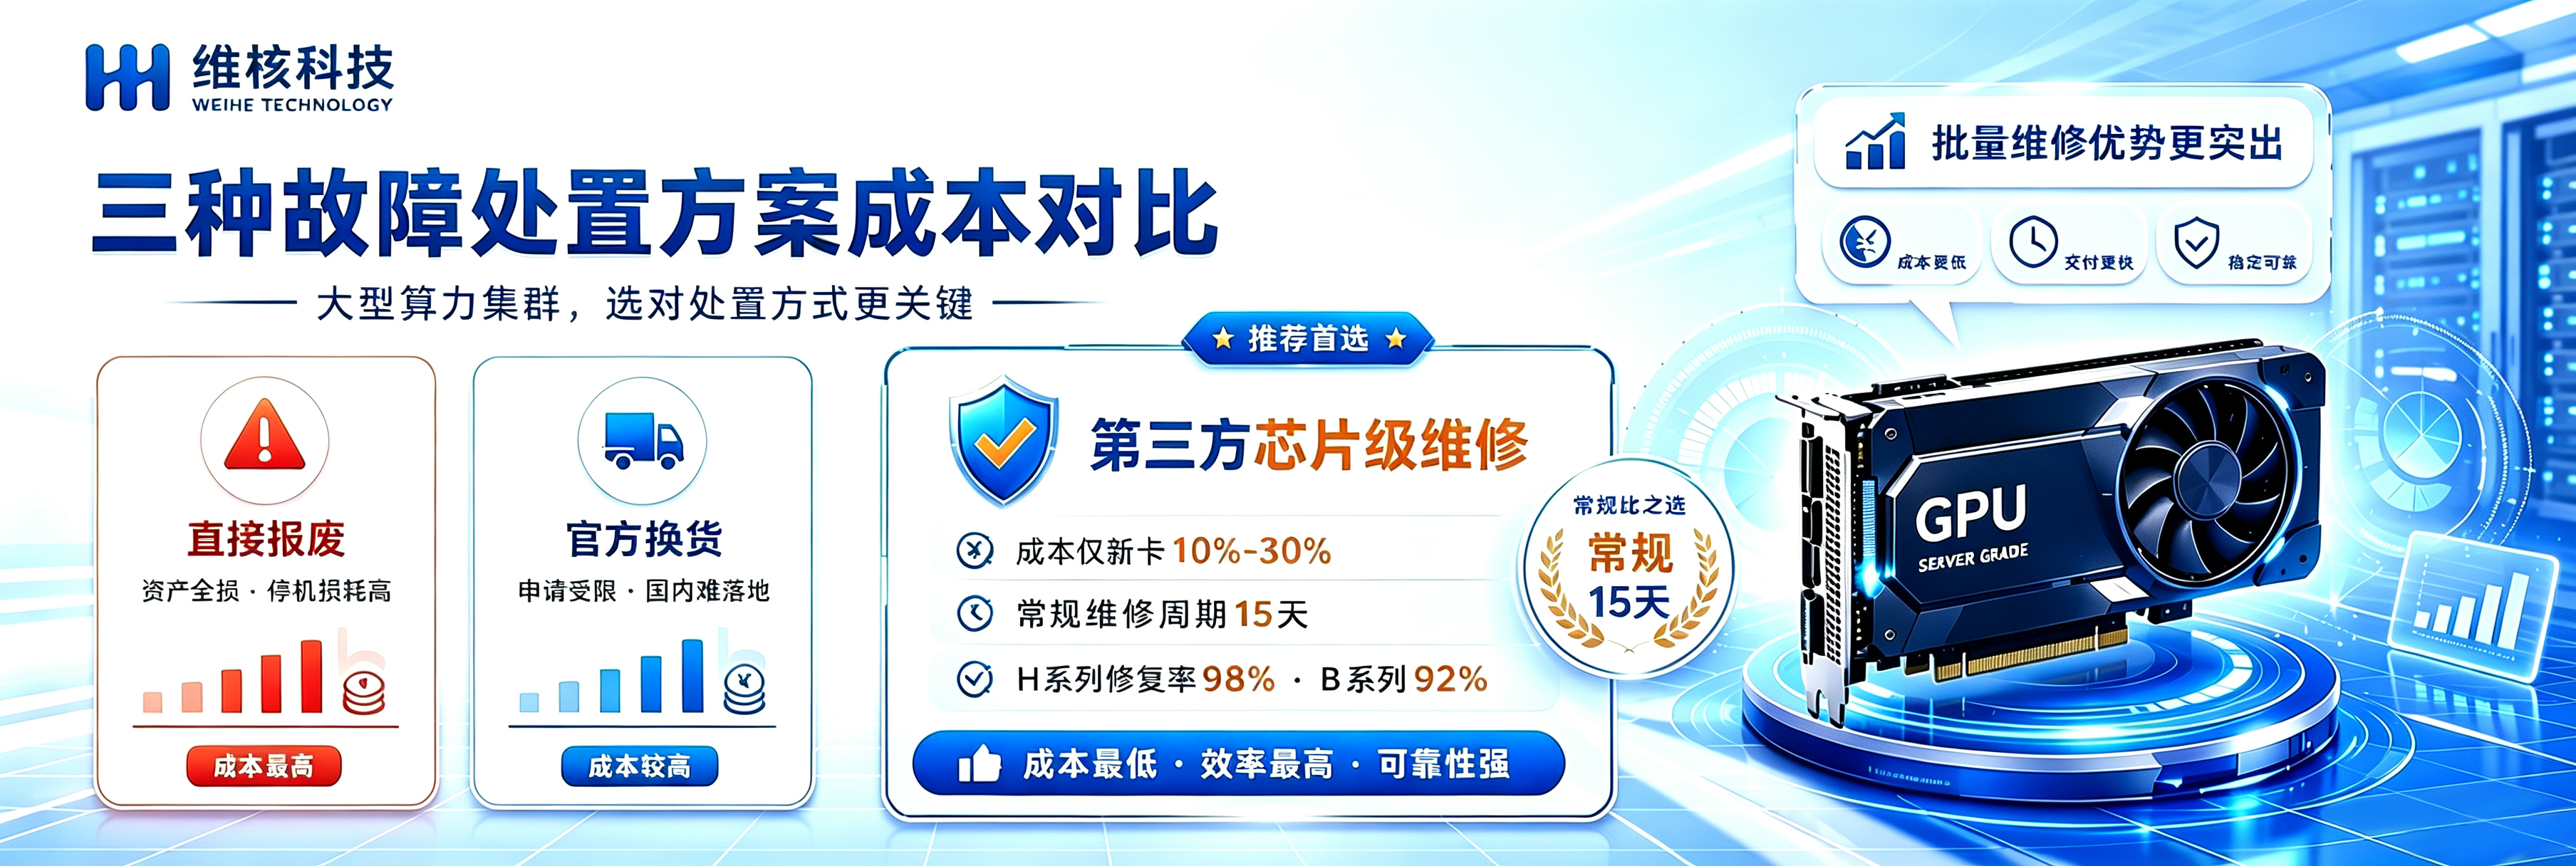
三、维核智算适配整机集群的批量维修服务流程
针对 DGX、HGX 多卡服务器批量故障,我们搭建专属集群维保全流程:
- 线上批量预检:运维统一提交多卡 SN 编码、集群 DCGM 运行日志,工程师批量区分软件报错与硬件损坏,提前告知无修复价值板卡,减少不必要物流成本;
- 分组建档检测:多卡入库分组登记建档,借助热成像、3D X-Ray 完成无损检测,单卡单独出具故障明细,同步统一报价方案;
- 无尘车间分批次修复:按照故障类型分组加工,统一完成 BGA 植球、合规元器件更换、SXM 接口修复,严格把控各项工艺标准;
- 集中老化验收:修复完成后批量进行满载压力测试与恒温老化验证,统一归档全套检测、老化记录;
- 分批发货配套质保:所有维修显卡标准提供 3 个月质保,批量订单建立专属对接群,实时同步各环节维修进度。
四、机房专属配套增值服务
- 批量维保长期合约:大型机房可签订年度维保协议,多卡集中寄修享受合作优惠,统一归档硬件维修资料;
- 应急加急通道:核心训练集群算力紧缺时,订单优先排产处理,快速补齐算力资源;
- 长期免费远程诊断:合作机房随时上传集群运行日志,线上协助排查硬件告警,避免盲目寄卡。
服务咨询
DGX/HGX/MGX 服务器出现掉卡、ECC 显存报错、算力衰减等故障,欢迎评论区交流学习

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 19
 0
- 0


 已为社区贡献4条内容

所有评论(0)