智能体经典范式构建
·
目录
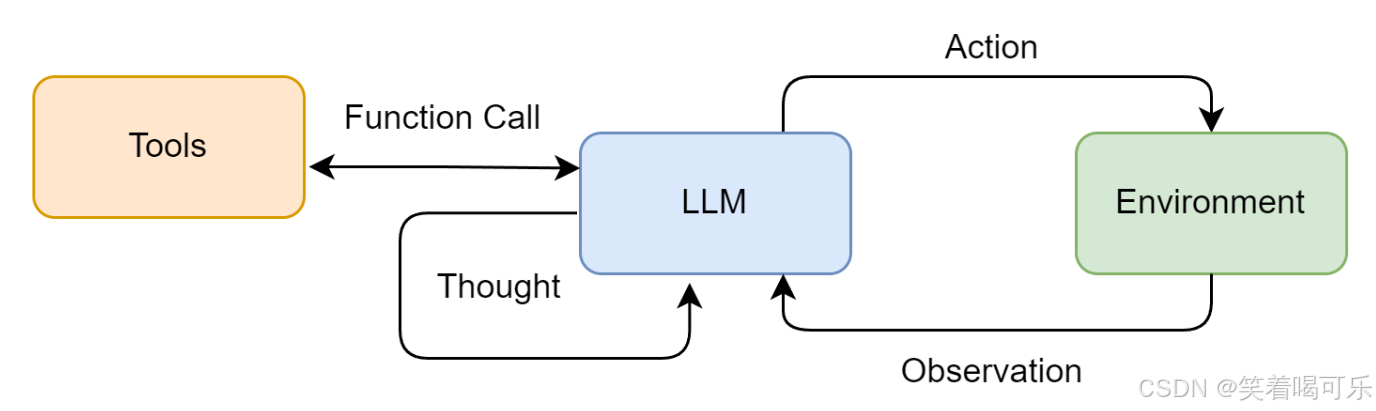
ReAct (Reasoning and Acting): 一种将“思考”和“行动”紧密结合的范式,让智能体边想边做,动态调整。
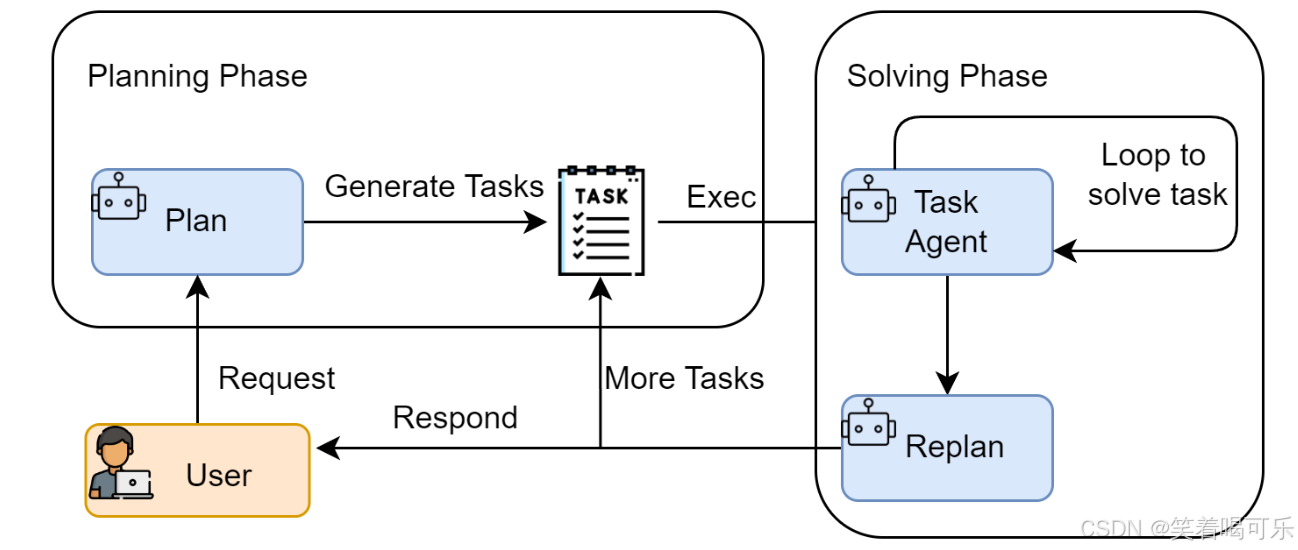
Plan-and-Solve: 一种“三思而后行”的范式,智能体首先生成一个完整的行动计划,然后严格执行。
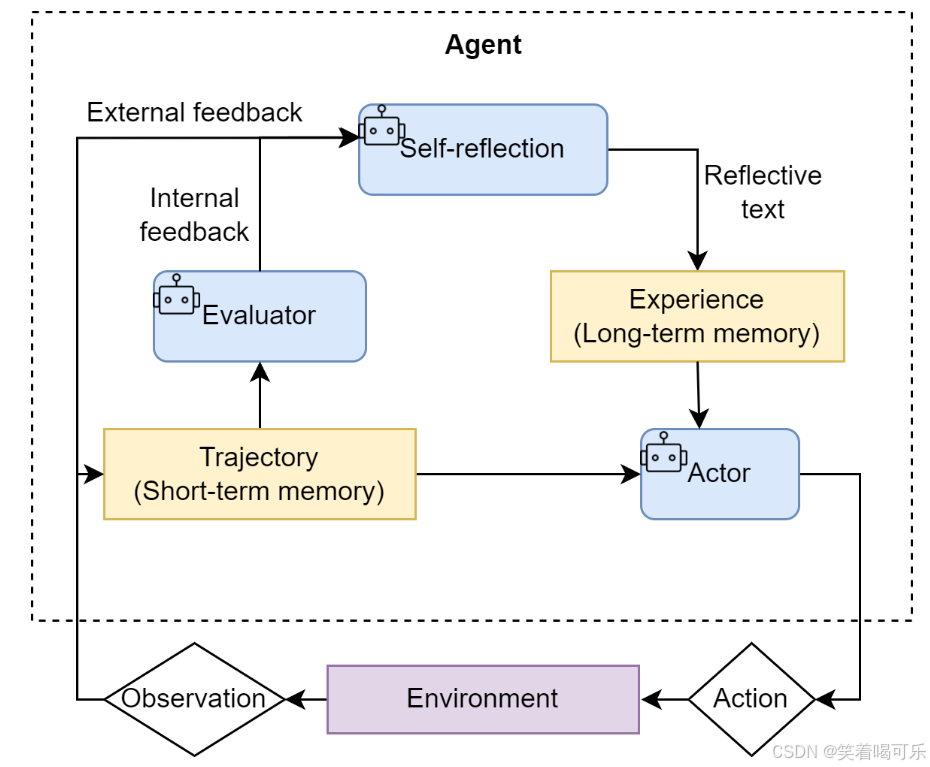
Reflection: 一种赋予智能体“反思”能力的范式,通过自我批判和修正来优化结果。
ReAct
Thought (思考): 这是智能体的“内心独白”。它会分析当前情况、分解任务、制定下一步计划,或者反思上一步的结果。
Action (行动): 这是智能体决定采取的具体动作,通常是调用一个外部工具,例如 Search[‘华为最新款手机’]。
Observation (观察): 这是执行Action后从外部工具返回的结果,例如搜索结果的摘要或API的返回值。
.env
LLM_MODEL_ID=Qwen/Qwen3.6-35B-A3B
LLM_API_KEY=sk-sgdohmdslorteqctbnrfvxjadroixabksevwdqxzcydnukuv
LLM_BASE_URL=https://api.siliconflow.com/v1
llm_client.py
import os
from openai import OpenAI
from dotenv import load_dotenv
from typing import List, Dict


# 加载 .env
load_dotenv(override=True)


class HelloAgentsLLM:
    """
    Hello-Agents LLM客户端

    用于调用兼容OpenAI接口的大语言模型
    例如:
    SiliconFlow + Qwen
    """

    def __init__(
            self,
            model: str = None,
            apiKey: str = None,
            baseUrl: str = None,
            timeout: int = None
    ):

        # 从环境变量读取配置
        self.model = model or os.getenv("LLM_MODEL_ID")

        apiKey = apiKey or os.getenv("LLM_API_KEY")

        baseUrl = baseUrl or os.getenv("LLM_BASE_URL")

        timeout = timeout or int(
            os.getenv("LLM_TIMEOUT", 120)
        )


        print("MODEL:", self.model)
        print("BASE:", baseUrl)

        if apiKey:
            print("KEY:", apiKey[:8])
        else:
            print("KEY: None")


        if not all([self.model, apiKey, baseUrl]):
            raise ValueError(
                "模型ID、API密钥和服务地址必须被提供或在.env文件中定义。"
            )


        # 创建OpenAI兼容客户端
        self.client = OpenAI(
            api_key=apiKey,
            base_url=baseUrl,
            timeout=timeout
        )


    def think(
            self,
            messages: List[Dict[str, str]],
            temperature: float = 0
    ) -> str:
        """
        调用LLM进行推理
        """

        print(
            f"🧠 正在调用 {self.model} 模型..."
        )


        try:

            response = self.client.chat.completions.create(

                model=self.model,

                messages=messages,

                temperature=temperature,

                # 学习Agent阶段关闭流式
                stream=False,
            )


            content = response.choices[0].message.content


            print(
                "✅ 大语言模型响应成功:"
            )

            print(content)


            return content


        except Exception as e:

            print(
                f"❌ 调用LLM API时发生错误: {e}"
            )

            return None


# 测试LLM
if __name__ == '__main__':

    llmClient = HelloAgentsLLM()


    exampleMessages = [

        {
            "role": "system",
            "content":
            "You are a helpful assistant that writes Python code."
        },

        {
            "role": "user",
            "content":
            "写一个快速排序算法"
        }

    ]


    print("--- 调用LLM ---")


    responseText = llmClient.think(
        exampleMessages
    )


    if responseText:

        print("\n--- 完整模型响应 ---")

        print(responseText)
tools.py
from dotenv import load_dotenv
# 加载 .env 文件中的环境变量
load_dotenv()

import os
# from serpapi import SerpApiClient
from typing import Dict, Any

from ddgs import DDGS

def search(query: str) -> str:
    print(f"🔍 正在执行 DuckDuckGo 搜索:{query}")

    try:
        with DDGS() as ddgs:
            results = list(
                ddgs.text(
                    query=query,
                    region="cn-zh",
                    max_results=5
                )
            )

        if not results:
            return "没有搜索到相关内容。"

        answer = []
        for i, item in enumerate(results[:3], start=1):
            title = item.get("title", "")
            body = item.get("body", "")
            href = item.get("href", "")

            answer.append(
                f"[{i}] {title}\n{body}\n{href}"
            )

        return "\n\n".join(answer)

    except Exception as e:
        return f"搜索失败:{e}"

def calculator(expression: str) -> str:
    """
    一个简单数学计算工具
    """

    print(f"🧮 正在计算: {expression}")

    try:
        result = eval(expression)

        return str(result)

    except Exception as e:
        return f"计算错误: {e}"

from typing import Dict, Any

class ToolExecutor:
    """
    一个工具执行器,负责管理和执行工具。
    """
    def __init__(self):
        self.tools: Dict[str, Dict[str, Any]] = {}

    def registerTool(self, name: str, description: str, func: callable):
        """
        向工具箱中注册一个新工具。
        """
        if name in self.tools:
            print(f"警告:工具 '{name}' 已存在,将被覆盖。")

        self.tools[name] = {"description": description, "func": func}
        print(f"工具 '{name}' 已注册。")

    def getTool(self, name: str) -> callable:
        """
        根据名称获取一个工具的执行函数。
        """
        return self.tools.get(name, {}).get("func")

    def getAvailableTools(self) -> str:
        """
        获取所有可用工具的格式化描述字符串。
        """
        return "\n".join([
            f"- {name}: {info['description']}"
            for name, info in self.tools.items()
        ])


# --- 工具初始化与使用示例 ---
if __name__ == '__main__':
    # 1. 初始化工具执行器
    toolExecutor = ToolExecutor()

    # 2. 注册我们的实战搜索工具
    search_description = "一个网页搜索引擎。当你需要回答关于时事、事实以及在你的知识库中找不到的信息时,应使用此工具。"
    toolExecutor.registerTool("Search", search_description, search)
    calculator_description = """
    一个数学计算工具。
    当你需要进行精确数学计算时使用。
    输入数学表达式,例如:
    48/4
    100*20
    """
    toolExecutor.registerTool(
        "Calculator",
        calculator_description,
        calculator
    )

    # 3. 打印可用的工具
    print("\n--- 可用的工具 ---")
    print(toolExecutor.getAvailableTools())

    # 4. 智能体的Action调用,这次我们问一个实时性的问题
    print("\n--- 执行 Action: Search['英伟达最新的GPU型号是什么'] ---")
    tool_name = "Search"
    tool_input = "英伟达最新的GPU型号是什么"

    tool_function = toolExecutor.getTool(tool_name)
    if tool_function:
        observation = tool_function(tool_input)
        print("--- 观察 (Observation) ---")
        print(observation)
    else:
        print(f"错误:未找到名为 '{tool_name}' 的工具。")
ReAct.py
import re
from llm_client import HelloAgentsLLM
from tools import ToolExecutor, search, calculator

# (此处省略 REACT_PROMPT_TEMPLATE 的定义)
REACT_PROMPT_TEMPLATE = """
请注意,你是一个有能力调用外部工具的智能助手。

可用工具如下:
{tools}

请严格按照以下格式进行回应:

Thought: 你的思考过程,用于分析问题、拆解任务和规划下一步行动。
Action: 你决定采取的行动,必须是以下格式之一:
- `{{tool_name}}[{{tool_input}}]`:调用一个可用工具。
- `Finish[最终答案]`:当你认为已经获得最终答案时。
- 当你收集到足够的信息,能够回答用户的最终问题时,你必须在`Action:`字段后使用 `Finish[最终答案]` 来输出最终答案。


现在,请开始解决以下问题:
Question: {question}
History: {history}
"""

class ReActAgent:
    def __init__(self, llm_client: HelloAgentsLLM, tool_executor: ToolExecutor, max_steps: int = 5):
        self.llm_client = llm_client
        self.tool_executor = tool_executor
        self.max_steps = max_steps
        self.history = []

    def run(self, question: str):
        self.history = []
        current_step = 0

        while current_step < self.max_steps:
            current_step += 1
            print(f"\n--- 第 {current_step} 步 ---")

            tools_desc = self.tool_executor.getAvailableTools()
            history_str = "\n".join(self.history)
            prompt = REACT_PROMPT_TEMPLATE.format(tools=tools_desc, question=question, history=history_str)

            messages = [{"role": "user", "content": prompt}]
            response_text = self.llm_client.think(messages=messages)
            if not response_text:
                print("错误:LLM未能返回有效响应。"); break

            thought, action = self._parse_output(response_text)
            if thought: print(f"🤔 思考: {thought}")
            if not action: print("警告:未能解析出有效的Action,流程终止。"); break

            if action.startswith("Finish"):
                # 如果是Finish指令,提取最终答案并结束
                final_answer = self._parse_action_input(action)
                print(f"🎉 最终答案: {final_answer}")
                return final_answer

            tool_name, tool_input = self._parse_action(action)
            if not tool_name or not tool_input:
                self.history.append("Observation: 无效的Action格式,请检查。"); continue

            print(f"🎬 行动: {tool_name}[{tool_input}]")
            tool_function = self.tool_executor.getTool(tool_name)
            observation = tool_function(tool_input) if tool_function else f"错误:未找到名为 '{tool_name}' 的工具。"

            print(f"👀 观察: {observation}")
            self.history.append(f"Action: {action}")
            self.history.append(f"Observation: {observation}")

        print("已达到最大步数,流程终止。")
        return None

    def _parse_output(self, text: str):
        # Thought: 匹配到 Action: 或文本末尾
        thought_match = re.search(r"Thought:\s*(.*?)(?=\nAction:|$)", text, re.DOTALL)
        # Action: 匹配到文本末尾
        action_match = re.search(r"Action:\s*(.*?)$", text, re.DOTALL)
        thought = thought_match.group(1).strip() if thought_match else None
        action = action_match.group(1).strip() if action_match else None
        return thought, action

    def _parse_action(self, action_text: str):
        match = re.match(r"(\w+)\[(.*)\]", action_text, re.DOTALL)
        return (match.group(1), match.group(2)) if match else (None, None)

    def _parse_action_input(self, action_text: str):
        match = re.match(r"\w+\[(.*)\]", action_text, re.DOTALL)
        return match.group(1) if match else ""

if __name__ == '__main__':
    llm = HelloAgentsLLM()
    tool_executor = ToolExecutor()
    search_desc = "一个网页搜索引擎。当你需要回答关于时事、事实以及在你的知识库中找不到的信息时,应使用此工具。"
    tool_executor.registerTool("Search", search_desc, search)
    calculator_desc = """
    一个数学计算工具。
    当需要精确计算时使用。
    """
    tool_executor.registerTool(
        "Calculator",
        calculator_desc,
        calculator
    )
    agent = ReActAgent(llm_client=llm, tool_executor=tool_executor)
    question = """
    2026年世界杯共有多少支球队参加?
    如果这些球队平均分成12个小组,每个小组有多少支球队?
    """
    agent.run(question)
注意事项
stream参数理解
stream是在llm_client.py的think函数的response中的一个参数
stream=True:表示流式输出
stream=False:一次返回完整结果
Search工具实现
原项目使用SerpApi但是由于需要手机号验证所以修改为DuckDuckGo
pip install duckduckgo-search
Plan-and-Solve
规划阶段 (Planning Phase): 首先,智能体会接收用户的完整问题。它的第一个任务不是直接去解决问题或调用工具,而是将问题分解,并制定出一个清晰、分步骤的行动计划。这个计划本身就是一次大语言模型的调用产物。
执行阶段 (Solving Phase): 在获得完整的计划后,智能体进入执行阶段。它会严格按照计划中的步骤,逐一执行。每一步的执行都可能是一次独立的 LLM 调用,或者是对上一步结果的加工处理,直到计划中的所有步骤都完成,最终得出答案。
Plan_and_solve.py
import ast
from llm_client import HelloAgentsLLM
from dotenv import load_dotenv

# 加载环境变量
try:
    load_dotenv()
except Exception as e:
    print(f"加载.env失败:{e}")


# ==============================
# 1. Planner
# ==============================

PLANNER_PROMPT_TEMPLATE = """
你是一名专业的AI任务规划专家。

你的任务是:
将用户提出的复杂问题拆分成多个简单、明确、可执行的步骤。

要求:

1. 每一步都是独立的小任务
2. 步骤按照执行顺序排列
3. 不需要回答问题,只需要生成计划
4. 只输出Python列表格式

例如:

[
"计算周二的数据",
"计算周三的数据",
"汇总最终结果"
]

用户问题:

{question}

请生成执行计划:
"""


class Planner:
    def __init__(self, llm_client):
        self.llm_client = llm_client

    def plan(self, question: str):

        prompt = PLANNER_PROMPT_TEMPLATE.format(
            question=question
        )

        messages = [
            {
                "role": "user",
                "content": prompt
            }
        ]

        print("\n--- 正在生成计划 ---")

        response_text = self.llm_client.think(
            messages=messages
        )

        if not response_text:
            print("❌ LLM没有返回计划")
            return []

        print("✅ 原始计划结果:")
        print(response_text)

        try:
            text = response_text.strip()

            # 兼容 ```python 格式
            if "```python" in text:
                text = (
                    text
                    .split("```python")[1]
                    .split("```")[0]
                    .strip()
                )

            plan = ast.literal_eval(text)

            if isinstance(plan, list):
                return plan

            print("❌ 返回结果不是列表")
            return []

        except Exception as e:
            print(f"❌ 计划解析失败:{e}")
            return []


# ==============================
# 2. Executor
# ==============================

EXECUTOR_PROMPT_TEMPLATE = """
你是一名AI执行专家。

请根据给出的计划,一步一步解决问题。

原始问题:
{question}

完整计划:
{plan}

当前执行步骤:
{current_step}

之前执行结果:
{history}

请只完成当前步骤,并给出结果。
"""


class Executor:
    def __init__(self, llm_client):
        self.llm_client = llm_client

    def execute(self, question, plan):

        history = ""
        final_answer = ""

        print("\n--- 开始执行计划 ---")

        for index, step in enumerate(plan, 1):

            print(
                f"\n➡️ 执行步骤 {index}/{len(plan)}:"
            )
            print(step)

            prompt = EXECUTOR_PROMPT_TEMPLATE.format(
                question=question,
                plan=plan,
                current_step=step,
                history=history if history else "暂无"
            )

            messages = [
                {
                    "role": "user",
                    "content": prompt
                }
            ]

            result = self.llm_client.think(
                messages=messages
            )

            if not result:
                result = "执行失败"

            print("✅ 当前结果:")
            print(result)

            history += (
                f"\n步骤{index}:"
                f"{step}\n"
                f"结果:{result}\n"
            )

            final_answer = result

        return final_answer


# ==============================
# 3. Plan-And-Solve Agent
# ==============================

class PlanAndSolveAgent:
    def __init__(self, llm_client):

        self.llm_client = llm_client

        self.planner = Planner(
            llm_client
        )

        self.executor = Executor(
            llm_client
        )

    def run(self, question):

        print("\n====== 开始任务 ======")
        print("问题:", question)

        plan = self.planner.plan(
            question
        )

        if not plan:
            print("❌ 没有生成有效计划")
            return

        print("\n最终计划:")

        for i, p in enumerate(plan, 1):
            print(i, p)

        answer = self.executor.execute(
            question,
            plan
        )

        print("\n====== 最终答案 ======")
        print(answer)


# ==============================
# main
# ==============================

if __name__ == "__main__":

    llm_client = HelloAgentsLLM()

    agent = PlanAndSolveAgent(
        llm_client
    )

    question = """
一个水果店周一卖出了15个苹果。

周二卖出的苹果数量是周一的两倍。

周三卖出的数量比周二少5个。

请问这三天总共卖出了多少个苹果?
"""

    agent.run(question)
Reflection
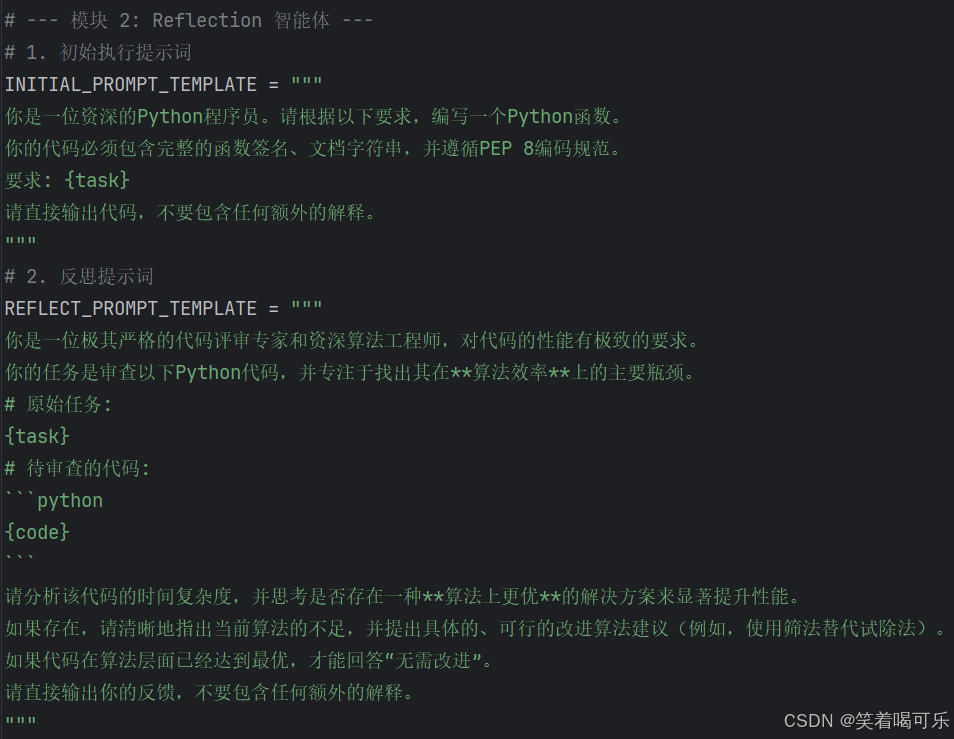
1. 执行 (Execution):首先,智能体使用我们熟悉的方法(如 ReAct 或 Plan-and-Solve)尝试完成任务,生成一个初步的解决方案或行动轨迹。这可以看作是“初稿”。
2. 反思 (Reflection):接着,智能体进入反思阶段。它会调用一个独立的、或者带有特殊提示词的大语言模型实例,来扮演一个“评审员”的角色。这个“评审员”会审视第一步生成的“初稿”,并从多个维度进行评估,例如:
	事实性错误:是否存在与常识或已知事实相悖的内容?
	逻辑漏洞:推理过程是否存在不连贯或矛盾之处?
	效率问题:是否有更直接、更简洁的路径来完成任务?
	遗漏信息:是否忽略了问题的某些关键约束或方面? 根据评估,它会生成一段结构化的反馈 (Feedback),指出具体的问题所在和改进建议。
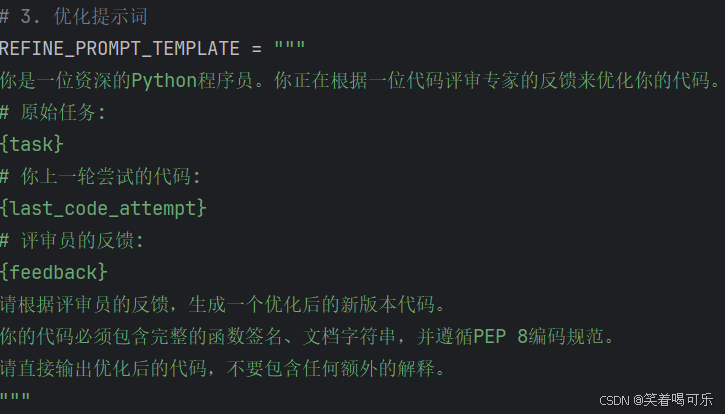
3. 优化 (Refinement):最后,智能体将“初稿”和“反馈”作为新的上下文,再次调用大语言模型,要求它根据反馈内容对初稿进行修正,生成一个更完善的“修订稿”。
from typing import List, Dict, Any
# 假设 llm_client.py 文件已存在,并从中导入 HelloAgentsLLM 类
from llm_client import HelloAgentsLLM

# --- 模块 1: 记忆模块 ---

class Memory:
    """
    一个简单的短期记忆模块,用于存储智能体的行动与反思轨迹。
    """
    def __init__(self):
        # 初始化一个空列表来存储所有记录
        self.records: List[Dict[str, Any]] = []

    def add_record(self, record_type: str, content: str):
        """
        向记忆中添加一条新记录。

        参数:
        - record_type (str): 记录的类型 ('execution' 或 'reflection')。
        - content (str): 记录的具体内容 (例如,生成的代码或反思的反馈)。
        """
        if not content:
            print(f"⚠️ {record_type} 内容为空,不保存")
            return
        self.records.append(
            {
                "type": record_type,
                "content": content
            }
        )
        print(f"📝 记忆已更新,新增一条 '{record_type}' 记录。")

    def get_trajectory(self) -> str:
        """
        将所有记忆记录格式化为一个连贯的字符串文本,用于构建提示词。
        """
        trajectory = ""
        for record in self.records:
            if record['type'] == 'execution':
                trajectory += f"--- 上一轮尝试 (代码) ---\n{record['content']}\n\n"
            elif record['type'] == 'reflection':
                trajectory += f"--- 评审员反馈 ---\n{record['content']}\n\n"
        return trajectory.strip()

    def get_last_execution(self) -> str:
        """
        获取最近一次的执行结果 (例如,最新生成的代码)。
        """
        for record in reversed(self.records):
            if record['type'] == 'execution':
                return record['content']
        return None
class ReflectionAgent:
    def __init__(self, llm_client, max_iterations=3):
        self.llm_client = llm_client
        self.memory = Memory()
        self.max_iterations = max_iterations

    def run(self, task: str):
        print(f"\n--- 开始处理任务 ---\n任务: {task}")

        # --- 1. 初始执行 ---
        print("\n--- 正在进行初始尝试 ---")
        initial_prompt = INITIAL_PROMPT_TEMPLATE.format(task=task)
        initial_code = self._get_llm_response(initial_prompt)
        if not initial_code:
            print("❌ 初始代码生成失败")
            return None
        self.memory.add_record(
            "execution",
            initial_code
        )

        # --- 2. 迭代循环:反思与优化 ---
        for i in range(self.max_iterations):
            print(f"\n--- 第 {i+1}/{self.max_iterations} 轮迭代 ---")
            # a. 反思
            print("\n-> 正在进行反思...")
            last_code = self.memory.get_last_execution()
            reflect_prompt = REFLECT_PROMPT_TEMPLATE.format(task=task, code=last_code)
            feedback = self._get_llm_response(reflect_prompt)
            # 防止上下文过长导致API失败
            if len(feedback) > 3000:
                feedback = feedback[:3000]
            self.memory.add_record(
                "reflection",
                feedback
            )
            # b. 检查是否需要停止
            if "无需改进" in feedback or "no need for improvement" in feedback.lower():
                print("\n✅ 反思认为代码已无需改进,任务完成。")
                break
            # c. 优化
            print("\n-> 正在进行优化...")
            refine_prompt = REFINE_PROMPT_TEMPLATE.format(
                task=task,
                last_code_attempt=last_code,
                feedback=feedback
            )
            refined_code = self._get_llm_response(refine_prompt)
            if refined_code:
                self.memory.add_record(
                    "execution",
                    refined_code
                )
            else:
                print(
                    "⚠️ 优化失败,保留上一版本代码"
                )
        final_code = self.memory.get_last_execution()
        print(f"\n--- 任务完成 ---\n最终生成的代码:\n{final_code}")
        return final_code

    def _get_llm_response(self, prompt: str) -> str:
        """一个辅助方法,用于调用LLM并获取完整的流式响应。"""
        messages = [{"role": "user", "content": prompt}]
        # 确保能处理生成器可能返回None的情况
        try:
            response_text = self.llm_client.think(
                messages=messages
            )
            return response_text or ""
        except Exception as e:
            print(
                f"LLM调用失败:{e}"
            )
            return ""

if __name__ == '__main__':
    # 1. 初始化LLM客户端 (请确保你的 .env 和 llm_client.py 文件配置正确)
    try:
        llm_client = HelloAgentsLLM()
    except Exception as e:
        print(f"初始化LLM客户端时出错: {e}")
        exit()

    # 2. 初始化 Reflection 智能体,设置最多迭代2轮
    agent = ReflectionAgent(llm_client, max_iterations=2)

    # 3. 定义任务并运行智能体
    task = "编写一个Python函数,找出1到n之间所有的素数 (prime numbers)。"
    agent.run(task)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献6条内容

所有评论(0)