图神经网络学习笔记3:无监督学习VGAE
任务:
利用 VGAE 对 Cora 数据集进行无监督特征提取(表征学习),并基于提取的特征进行节点聚类。
-
输入:图数据(无标签)。
-
VGAE 训练:让模型学习如何把节点压缩成向量 $z$(Embedding)。
-
下游任务:
-
拿着这个 $z$,跑一个 K-Means 算法。
-
或者画个 t-SNE 图看它们是不是聚在一起了。
-
(注意:VGAE 本身不出分类结果,是 K-Means 出的结果)。
-
和节点分类的区别:
-
节点分类 (Node Classification):通常指有监督学习。
-
训练时:你需要喂给模型一部分标签。模型直接输出“这是第几类”。
-
目的:让预测的类别 = 真实的类别。
-
例子:你之前的那个 GCN 任务。
-
-
VGAE 的任务:是无监督学习。
-
训练时:模型完全没见过标签。它不知道什么是“类别”。
-
目的:模型只是想把图原本的结构(邻接矩阵 $A$)还原出来。
-
结果:为了还原结构,模型被迫把相似的节点在潜在空间里放得更近。其“副作用”是节点自动分开了。
-
一句话总结:普通的 GCN 是老师教(有监督分类),告诉学生这个是 A 类,那个是 B 类;而 VGAE是学生自习(无监督聚类),学生们通过观察谁和谁关系好(引用关系),自动形成了不同的小圈子。
VGAE:
1.什么是VGAE:
VGAE (Variational Graph Auto-Encoder),即变分图自编码器,是图神经网络 (GNN) 与变分自编码器 (VAE) 的结合体。
简单来说,它是一个“压缩-生成”系统:
-
编码 (Encode):把复杂的图(节点特征 + 邻接矩阵)压缩成低维的潜在向量。
-
解码 (Decode):利用这些潜在向量,尝试还原出原始的图结构(比如预测两个节点是否有边)。
它不仅是一个特征提取器,更是一个生成式模型。
2. 为什么 VGAE更好:
(1) 从“死记硬背”到“理解分布” (与GNN最核心的区别)
-
普通 GNN (AE):是确定性的。它把一个细胞映射为一个固定的坐标点(例如
[0.5, 0.2])。如果输入数据有一点噪音(比如测序时的 Dropout),这个坐标可能就会剧烈偏移,导致聚类错误。 -
VGAE:是概率性的。它把一个细胞映射为一个正态分布。它输出的是均值和方差。
-
它告诉我们:“我不确定这个细胞在哪,但它大概率在这个圈子里。”
-
优势:这种对不确定性的建模,使得 VGAE 对噪音极具鲁棒性。这对于充满噪音的生物学数据至关重要。
-
(2) 解决“无标签”困境
普通 GCN 做分类通过计算 Pred 和 Label 的差异来优化。没有 Label 就无法训练。
VGAE 通过计算 “输入图” 和 “重构图” 的差异来优化。自给自足,不需要任何人造标签,非常适合探索未知数据。
(3) 生成能力
因为学习到了数据的分布,VGAE 还可以用来预测缺失的边(比如推断潜在的细胞通讯),甚至生成新的图结构,这是普通分类模型做不到的。
3.VGAE基本原理:
VGAE 的工作流程可以拆解为三个关键步骤:
Step 1: 编码器 (Encoder) —— “分叉”
普通的 GCN 输出一个向量,而 VGAE 的 Encoder 在最后一层会分叉,输出两个向量:
mu均值:预测节点在潜在空间的中心。
log(sigma)对数方差:预测节点的不确定性范围。
# === 伪代码逻辑 ===
# hidden = GCN(features)
# mu = GCN_mu(hidden)       # 算均值
# logstd = GCN_std(hidden)  # 算方差

# === 真实代码 (PyG 实现) ===
class VariationalGCNEncoder(torch.nn.Module):
    def __init__(self, in_channels, out_channels):
        super().__init__()
        self.conv1 = GCNConv(in_channels, 2 * out_channels) # 公共层
        # <--- 关键分叉点 --->
        self.conv_mu = GCNConv(2 * out_channels, out_channels)      # 均值头
        self.conv_logstd = GCNConv(2 * out_channels, out_channels)  # 方差头

    def forward(self, x, edge_index):
        x = self.conv1(x, edge_index).relu()
        # 返回两个向量
        return self.conv_mu(x, edge_index), self.conv_logstd(x, edge_index)
Step 2: 重参数化
我们需要从分布中采样一个z传给解码器。但直接采样会导致梯度断裂,无法反向传播。
VGAE 使用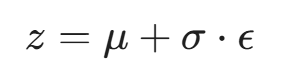 ,其中
 是从标准正态分布中采样的随机噪音。而均值和方差仍然参与计算,梯度可以顺滑地传回去。
# === 伪代码逻辑 ===
# epsilon = random_normal()
# z = mu + sigma * epsilon  <--- 这样 mu 和 sigma 都有梯度了

# === 真实代码 (PyG 内部实现原理) ===
# 注:当你调用 model.encode() 时,PyG 的 VGAE 类内部会自动执行这一步
# 你不需要自己手写,但它的源码逻辑长这样:
def reparametrize(self, mu, logstd):
    if self.training:
        # 1. 算出标准差 sigma (把 log 还原)
        std = torch.exp(logstd)
        # 2. 从标准正态分布采样 epsilon
        eps = torch.randn_like(std)
        # 3. 移花接木:合成 z
        return mu + eps * std
    else:
        # 测试时通常直接取均值
        return mu
Step 3: 损失函数
VGAE 的 Loss 由两部分组成,相互制约:
(Loss = 重构得像不像 (Recon) + 分布长得标不标准 (KL))
- 重构损失—— “复印机”
原理:这是在链路预测里学过的。模型拿到潜在向量z后,计算每两个节点 (z_i, z_j)的点积(相似度)。
目标:如果原图中节点 i 和 j 是连着的(有边),那么z_i和z_j的点积应该很大(接近 1);如果没有边,应该很小(接近 0)。
本质:这就是一个巨大的二分类问题。它保证了潜在空间保留了原始的图结构信息。
- KL 散度—— “模具”
原理:KL 散度是用来衡量两个概率分布之间距离的标尺。
目标:我们希望学出来的分布尽可能接近标准正态分布N(0, 1)。
本质:这是一个正则化项。它强迫所有的节点向量尽量往坐标原点靠拢,并且形成一个个圆球,不要飞得太远或变得太扁。
# === 真实代码 (训练循环中) ===
# 1. 编码并采样
z = model.encode(data.x, data.edge_index)

# 2. 计算总 Loss
# model.recon_loss: 算出 z 还原回的图和原图 edge_index 差多少
# model.kl_loss: 算出 z 的分布和标准正态分布差多少
loss = model.recon_loss(z, data.edge_index) + (1 / data.num_nodes) * model.kl_loss()
为什么要用这么复杂的 Loss?
如果只有重构损失,模型为了让还原的误差最小,它会把每个节点的方差设为 0(退化成点),然后把每个点扔到空间里相距十万八千里的地方,互不干扰。这个潜在空间是离散的,聚类效果差,因为模型没有动力把相似的点拉近,只要能区分开就行。
如果只有 KL 散度 ,模型为了满足 KL 约束,会把所有节点的均值都设为0,方差都设为1,丢失了所有图结构信息,什么都分不出来。
重构损失保留各自的“个性”。KL散度保证整体的“纪律”。
完整代码:
这是在kaggle notebook 运行的
# Cora数据集,在kaggle notebook上运行
# 假设我们完全不知道每篇论文属于哪个领域,我们要训练一个 VGAE,把这些论文“压缩”到二维平面上。
#如果画出来的点图,相同颜色的点自动聚在了一起,说明 VGAE 成功“学会”了潜在的类别结构!
#!pip install -q ogb torch_geometric
import torch
import torch.nn.functional as F
from torch_geometric.nn import GCNConv, VGAE
from torch_geometric.datasets import Planetoid
import matplotlib.pyplot as plt
from sklearn.manifold import TSNE

# 1. 加载数据
dataset = Planetoid(root='/tmp/Cora', name='Cora')
data = dataset[0]

# 2. 定义变分编码器 (Variational Encoder)
#普通 GCN 输出一个 z,VGAE 的 Encoder 必须输出两个东西:均值和对数方差。
class VariationalGCNEncoder(torch.nn.Module):
    def __init__(self, in_channels, out_channels):
        super().__init__()
        # 第一层:公共层 (提取基础特征)
        # 把 1433 维降到 2 倍的输出维度,为了后面分叉
        self.conv1 = GCNConv(in_channels, 2 * out_channels)

        # === 关键点:分叉 ===
        # VGAE 需要两个头:一个算均值 mu,一个算方差 log_std
        self.conv_mu = GCNConv(2 * out_channels, out_channels)
        self.conv_logstd = GCNConv(2 * out_channels, out_channels)

    def forward(self, x, edge_index):
        x = self.conv1(x, edge_index).relu()

        # 输出两个东西!
        mu = self.conv_mu(x, edge_index)
        logstd = self.conv_logstd(x, edge_index)
        return mu, logstd

# 3. 初始化 VGAE 模型
# PyG 已经帮我们把 "重参数化(Reparameterization)" 和 "解码器(Decoder)" 封装在 VGAE 类里了
# 我们只需要把写好的 Encoder 传进去
out_channels = 16  # 压缩到 16 维
encoder = VariationalGCNEncoder(data.num_features, out_channels)
model = VGAE(encoder)  # <--- 核心在这里

device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
model = model.to(device)
data = data.to(device)

print("模型初始化完成!VGAE 准备就绪。")

#4.循环训练
#重构误差+KL散度
optimizer = torch.optim.Adam(model.parameters(), lr=0.01)

def train():
    model.train()
    optimizer.zero_grad()

    # 1. 编码 (Encode)
    # model.encode 会自动调用我们在 Encoder 里写的 forward
    # 并且自动完成 "重参数化" (z = mu + sigma * epsilon)
    z = model.encode(data.x, data.edge_index)

    # 2. 计算 Loss
    # PyG 的 VGAE 类内置了这两个 Loss 函数,直接调用即可
    loss = model.recon_loss(z, data.edge_index) + (1 / data.num_nodes) * model.kl_loss()
    #model.recon_loss(z, edge_index): 试图让 z 还原回图结构。
    #model.kl_loss(): 试图让 z 服从正态分布。

    loss.backward()
    optimizer.step()
    return float(loss)

print("开始无监督训练...")
for epoch in range(1, 201):
    loss = train()
    if epoch % 20 == 0:
        print(f'Epoch: {epoch:03d}, Loss: {loss:.4f}')


#5.可视化
@torch.no_grad()
def plot_points(colors):
    model.eval()
    # 拿到潜在向量 z
    z = model.encode(data.x, data.edge_index)
    z = z.cpu().numpy()

    # 使用 t-SNE 降维到 2D
    tsne = TSNE(n_components=2, random_state=42)
    z_2d = tsne.fit_transform(z)

    # 画图
    plt.figure(figsize=(10, 8))
    # c=colors: 根据真实标签上色 (仅用于验证,训练时没用到)
    plt.scatter(z_2d[:, 0], z_2d[:, 1], c=colors, cmap='tab10', s=20)
    plt.colorbar()
    plt.title('VGAE Latent Space Visualization (Unsupervised)')
    plt.show()

# 这里的 data.y 只是用来上色验证的,模型没见过它
plot_points(data.y.cpu())
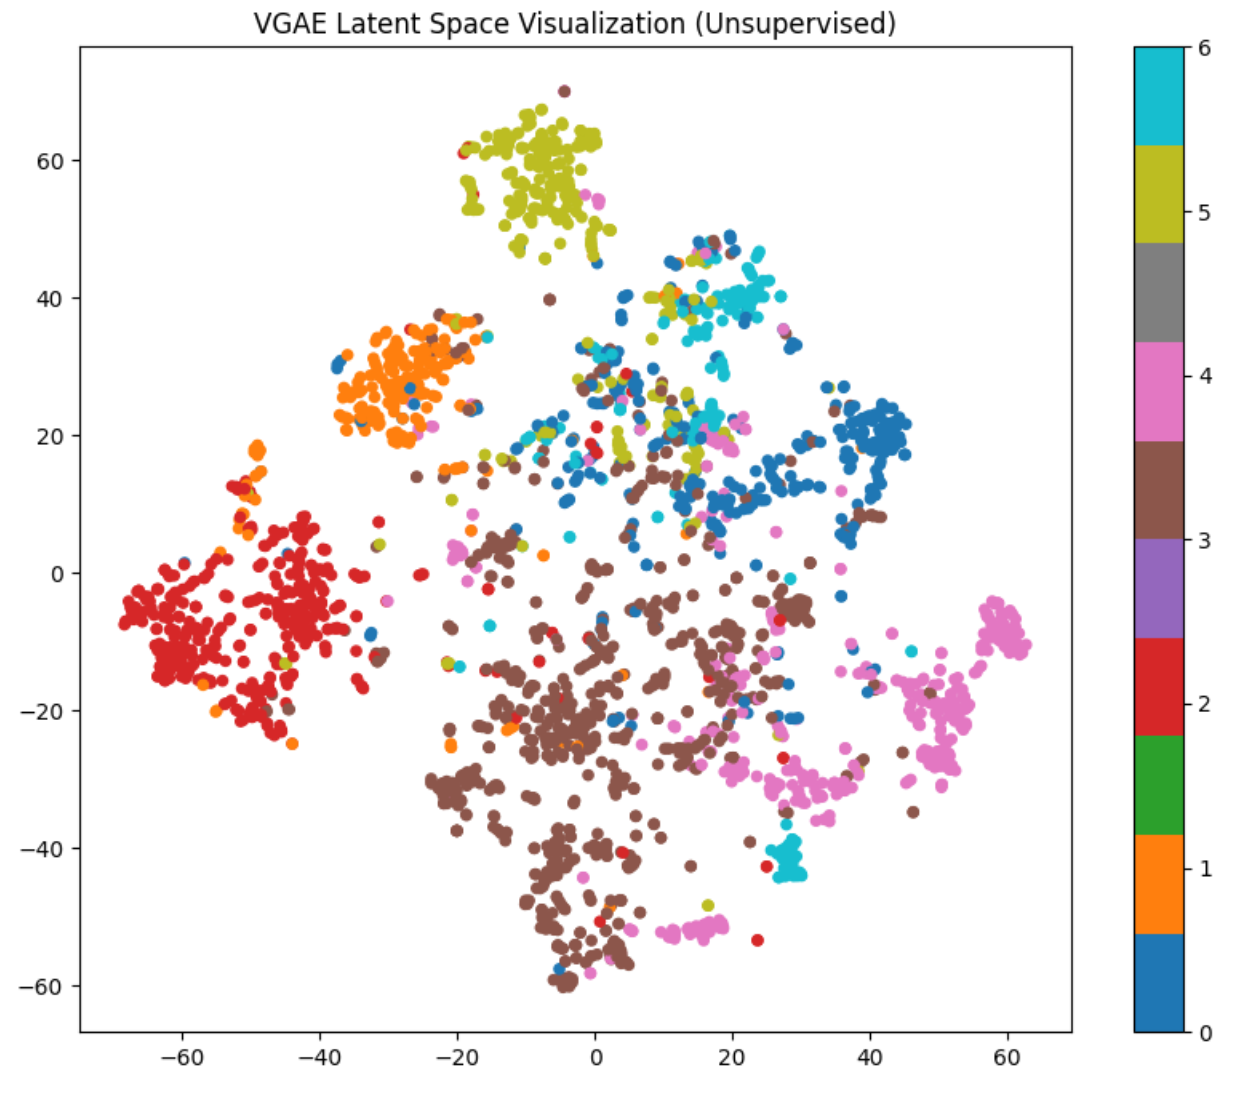
得到抱团聚类很清晰的彩色散点图

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)