FedStar通过结构知识共享解决图联邦学习Non-IID难题
一、背景
近年来,图神经网络(GNN)和联邦学习(FL)的结合——即联邦图学习(FGL),正成为学术界和工业界的热点研究方向。想象一下,多家医院希望共同训练一个疾病传播预测模型,但无法共享患者隐私数据;或多家社交平台希望提升推荐系统性能,但不能交换用户信息。这些场景正是FGL的用武之地。
然而,现实世界中的图数据往往是非独立同分布(Non-IID) 的。不同医院的病历图特征各异,不同社交平台的用户属性差异巨大。这种数据的异质性导致传统联邦学习方法效果大打折扣,有时甚至比单独训练还要差!
今天要介绍的这篇论文《Federated Learning on Non-IID Graphs via Structural Knowledge Sharing》提出了一个开创性的解决方案——FedStar框架,论文发现尽管不同领域图数据的节点特征(如用户年龄、兴趣标签、分子原子类型)差异巨大,但它们的结构特性却存在惊人的相似性!
举个直观的例子:
-
社交网络中,总有“人气王”(高度数节点)和“边缘人”(低度数节点)
-
分子结构中,某些原子扮演“连接枢纽”的角色
蛋白质相互作用网络中,关键蛋白往往是连接多个模块的桥梁
这种跨领域共享的结构模式成为了解决问题的关键线索!
二、什么是结构信息
本篇论文中结构信息主要包括:
-
节点度数:每个节点有多少个邻居。论文中使用 Degree-based Structure Embedding(DSE) 来捕获这种局部结构信息,比如将度数转化为 one-hot 编码。
-
随机游走扩散概率:节点在随机游走中返回自身的概率,反映了节点在图中的“角色”或“位置”。论文中使用 Random Walk-based Structure Embedding(RWSE) 来捕获这种全局结构信息。
1.1 DSE
DSE 是一个一维向量,其维数为 k1(其中k1为预设的最大节点度数),表示对节点度数的一种独热编码(one-hot encoding):
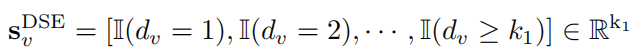
举个例子,如节点的度数为2,k1=5,[0,1,0,0,0]
1.2 RWSE
RWSE 是一个向量,其维数为 k2,表示节点在随机游走中返回自身的概率序列
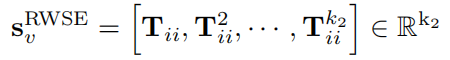
-
T =
是随机游走转移矩阵:
-
A 是图的邻接矩阵(二元值,1 表示有边);
-
D是度矩阵(对角矩阵,对角线为节点的度数)。
-
Tij表示从节点 i 到节点 j 的一步转移概率。
-
-
i 是节点 v 在图中的索引。
-
k2 是 RWSE 的维数,表示考虑的最大随机游走步数。
-
表示从节点 v 出发,经过 k 步随机游走返回自身的概率。
1.3 将DSE和RWSE拼接得到最终的结构向量
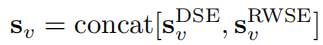
三、整体结构图
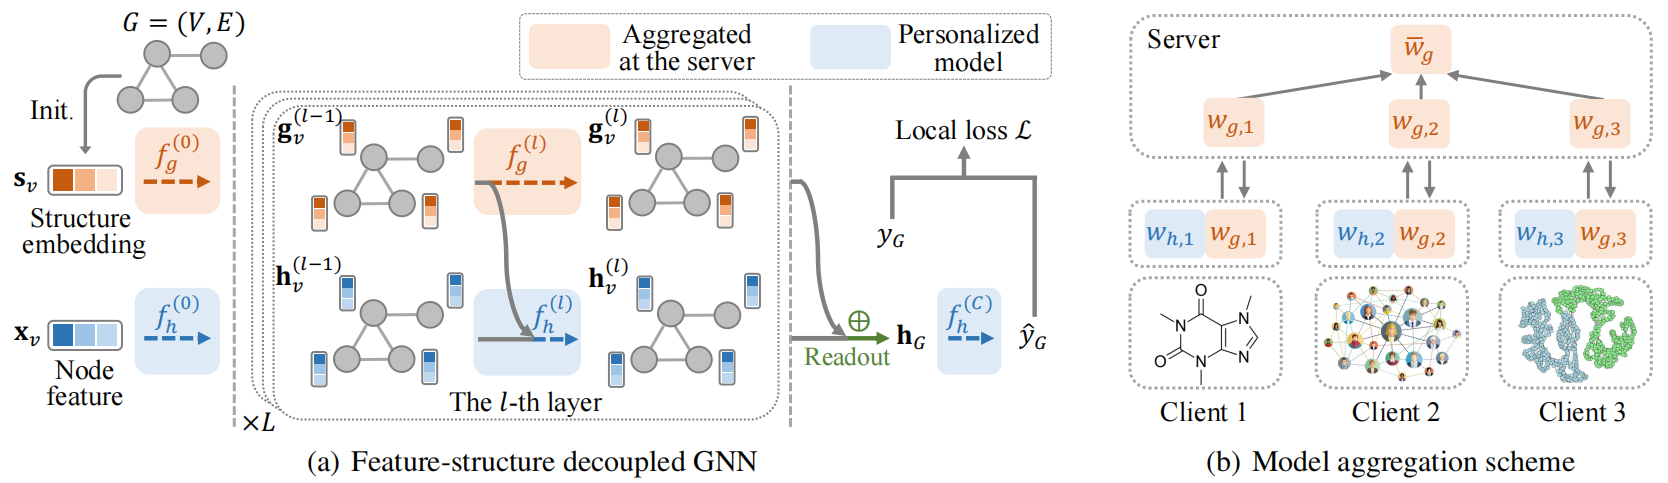
FedStar框架的核心是使用结构和特征分离的编码器,其中结构编码器实现知识共享,特征编码器用于本地模型更新。
对于每个客户端,结构向量和特征向量分别输入(双通道输入)。结构向量按照联邦学习的一般流程,先在本地训练,然后在服务器中聚合,更新,并分发到各个客户端中;特征向量和更新后的结构向量聚合后用于本地模型的更新。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 28
 0
- 0


 已为社区贡献1条内容

所有评论(0)