英伟达 H200 解禁之后,算力格局会发生什么变化?
特朗普政府宣布允许英伟达等公司向中国出售AI芯片,但将从中抽取25%的分成,并表示这一安排也将适用于AMD、英特尔等其他芯片公司。此举标志着特朗普政府对华AI芯片出口政策的显著转变, H200 级别产品可能迎来新的出口政策调整,美国商务部正在重新评估对完整 Hopper 架构 GPU 的限制条款。虽然具体细则尚未完全公开,但这一消息在产业链内引发了广泛讨论,也让不少数据中心与AI基础设施团队重新关注 Hopper 系列在实际部署层面的价值。
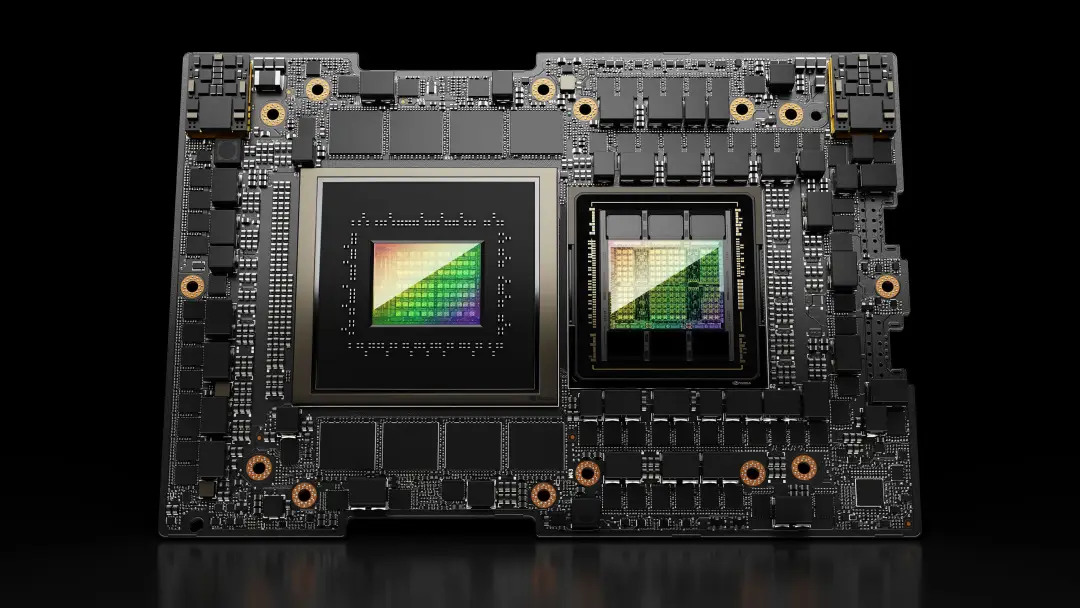
从技术趋势上看,H200 并不是一个孤立的产品,而是 Hopper 架构演进中的关键一环。Hopper 架构在 Ampere 基础上引入了更成熟的 Transformer Engine、多精度混合计算机制以及更大容量的 HBM3 显存体系,本质上是为大模型推理与中高强度训练场景做的结构级优化。
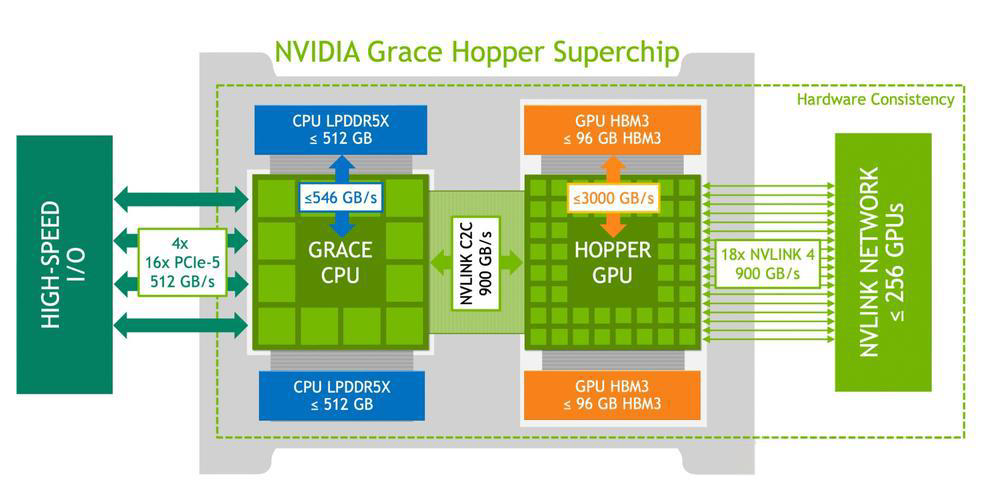
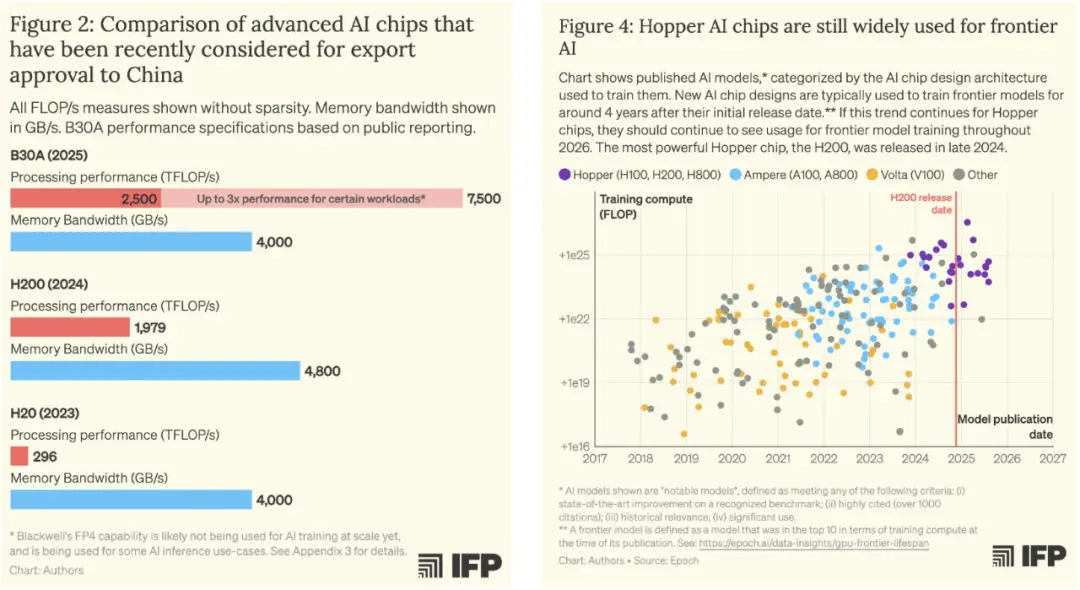
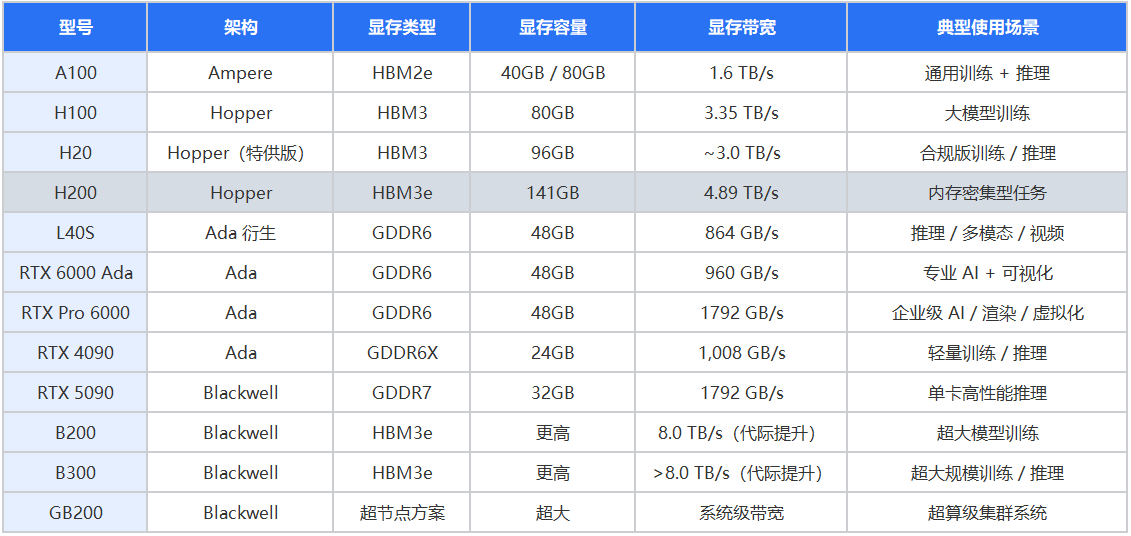
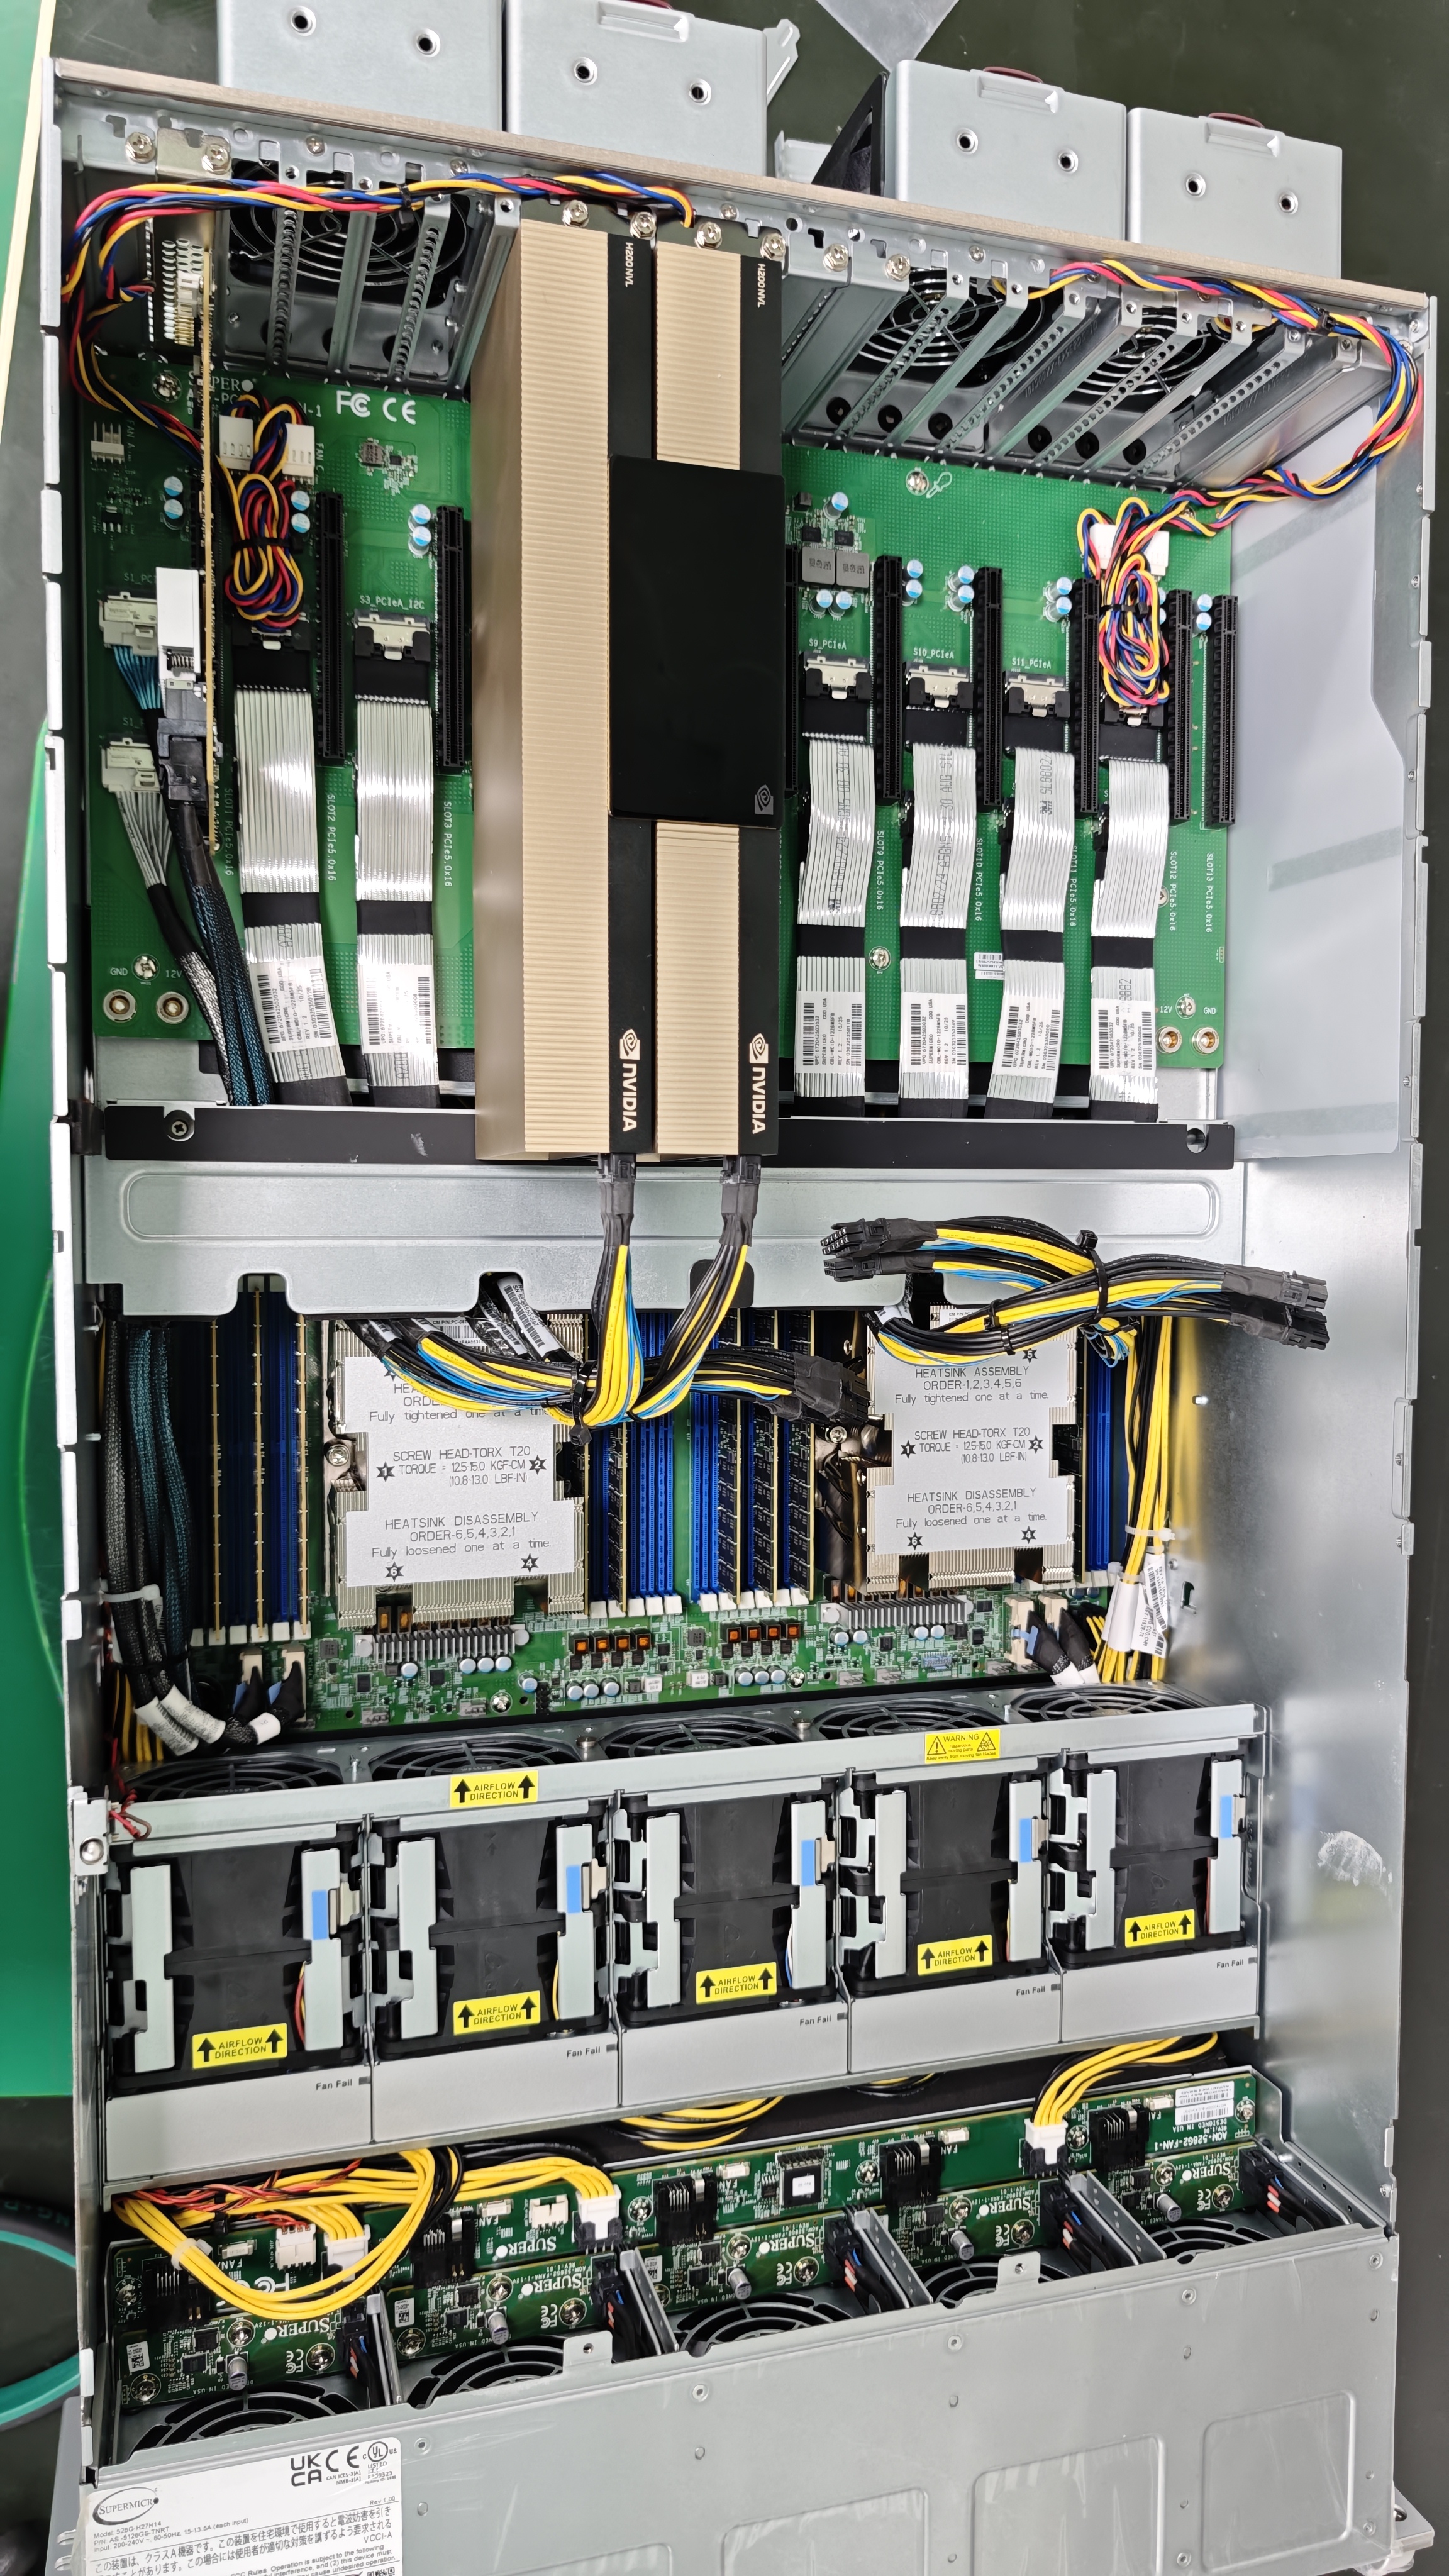
H200 在 H100 基础上进一步提升了显存带宽和容量规格,使得大 batch 推理、多路并发模型服务和部分训练任务的稳定性显著增强,对内存密集型 Workload 的适配度更高。相较于同系列的H20,H200性能是其6倍,非常适合训练和推理。
从应用特性来看,Hopper 系列的核心优势并不只是峰值算力,而是其在 FP8 / FP16 / BF16 等混合精度下的吞吐稳定性,以及对 Transformer 结构的计算单元亲和性。这使得它在 NLP、推荐系统、多模态推理等场景中具备较高的性价比,也在一定程度上解释了为什么 H200 逐渐成为云厂商和大型算力中心的关注重点。
随着 Hopper 架构逐步落地,英伟达也同步推进了新一代 Blackwell 架构产品线。从工程层面来看,Blackwell 并不是简单的算力堆叠,而是围绕超大模型训练场景,对互联结构、显存一致性访问以及多 GPU 协同机制做了系统级重构。以B200、B300为代表的新一代产品,在 NVLink 带宽、单节点多卡逻辑拓扑和系统级调度能力上都进行了明显增强,更偏向“超节点”级别的整体算力设计思路,而不再只是传统意义上的单卡性能迭代。
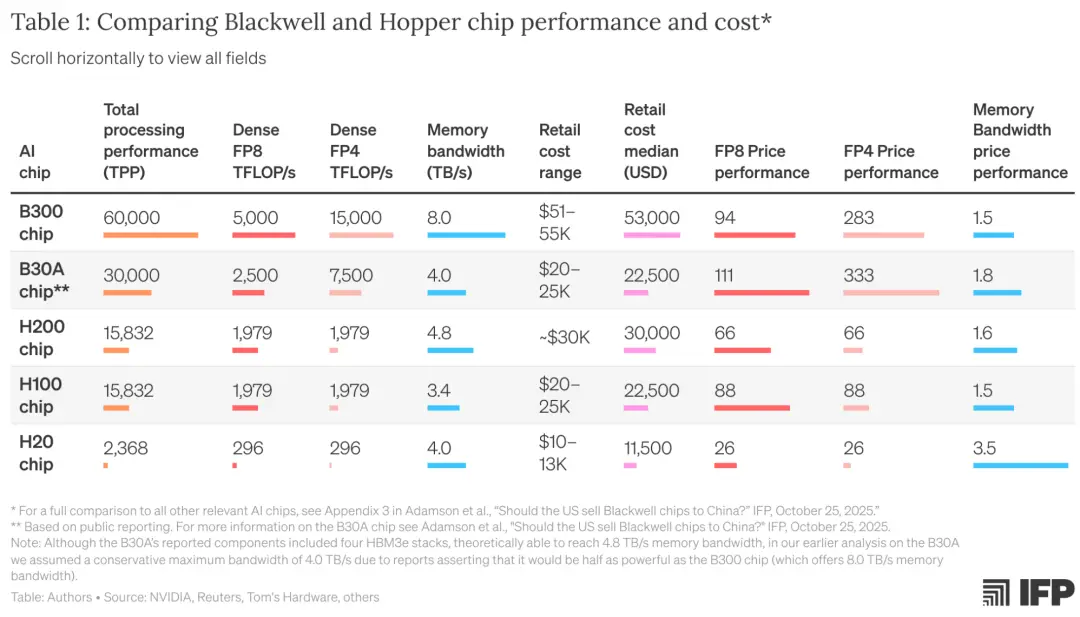
在选型层面,目前常被对比的产品大致可以分为三代代表:
●Ampere 代表:A100
●Hopper 代表:H100、H200、L40S
●专业级系列:RTX 6000 Ada、RTX Pro 6000
●消费级高端卡:RTX 4090、RTX 5090(新一代消费级旗舰)
●Blackwell 代表:B200、B200、GB200(面向超大规模训练)
从更长周期来看,另一条同样值得关注的主线是国产 GPU 体系的持续演进。近两年在通用计算架构、自研指令集扩展、内存一致性互联、AI 编译器栈等方面,国产芯片已经开始形成相对完整的技术闭环。虽然在单卡峰值算力、生态成熟度上仍与国际主流厂商存在差距,但在特定行业场景(政务、科研、部分行业模型部署)中,国产 GPU 在能效比、可控性和产业协同层面已具备越来越清晰的应用空间。
整体来看,H200 相关政策变化更多影响的是供应链节奏和部署选择,但从技术路线角度,行业已经进入了“架构代际差异”大于“单卡型号差异”的新阶段。Hopper 与 Blackwell 的演进,本质是围绕大模型时代的系统级计算重构,而国产 GPU 的持续推进,则为市场提供了另一条更具弹性的长期技术路径。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献4条内容

所有评论(0)