【机器学习|学习笔记】集成学习之Bagging算法详解?代表算法有 随机森林(Random Forest)
·
【机器学习|学习笔记】集成学习之Bagging算法详解?代表算法有 随机森林(Random Forest)
【机器学习|学习笔记】集成学习之Bagging算法详解?代表算法有 随机森林(Random Forest)
欢迎铁子们点赞、关注、收藏!
祝大家逢考必过!逢投必中!上岸上岸上岸!upupup
大多数高校硕博生毕业要求需要参加学术会议,发表EI或者SCI检索的学术论文会议论文。详细信息可关注VX “
学术会议小灵通”或参考学术信息专栏:https://blog.csdn.net/2401_89898861/article/details/148877490
前言
- Bagging 是集成学习的经典方法之一,代表算法有 随机森林(Random Forest),它通过并行地训练多个弱模型来提升整体性能。
下面我们结合机器学习发展背景,理论 + Python 实战,一步步深入讲解 Bagging 的原理、流程与实现。
✅ 一、为什么提出 Bagging?
在机器学习发展早期,单个模型(如决策树)容易过拟合、泛化能力差。Bagging(Bootstrap Aggregating)是为了解决这个问题提出的:
- 📌 通过在不同样本子集上训练多个模型,然后进行投票或平均,从而减少方差,提高稳定性。
📚 二、Bagging 的原理详解
✅ Bagging 的核心步骤:
- Bootstrap 采样:从原始数据中有放回采样出多个训练集;
- 并行训练多个弱模型(如决策树);
- 集成预测:分类任务用多数投票;回归任务用均值。
✅ 为什么有效?
- 降低模型方差;
- 对于不稳定模型(如决策树、KNN)尤其有效;
- 并行训练,无依赖性。
🔬 三、数学角度(泛化误差)
- Bagging 主要通过减小模型的方差:
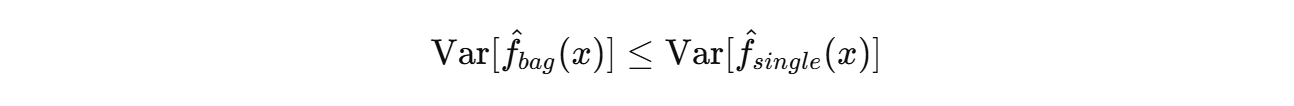
- 但不能降低偏差(Bias);
- 适合高方差、低偏差模型,如决策树。
🧪 四、Python 实现 Bagging:手写 & sklearn
✅ 1. 使用 sklearn 的 BaggingClassifier
from sklearn.ensemble import BaggingClassifier
from sklearn.tree import DecisionTreeClassifier
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# 创建数据集
X, y = make_classification(n_samples=1000, n_features=20, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, stratify=y)

# 使用 BaggingClassifier
bagging = BaggingClassifier(
    base_estimator=DecisionTreeClassifier(),
    n_estimators=50,
    max_samples=0.8,
    max_features=1.0,
    bootstrap=True,
    n_jobs=-1,
    random_state=42
)
bagging.fit(X_train, y_train)
y_pred = bagging.predict(X_test)

print(f"Bagging Accuracy: {accuracy_score(y_test, y_pred):.4f}")
✅ 2. 手动实现简化版 Bagging
import numpy as np
from sklearn.tree import DecisionTreeClassifier
from sklearn.utils import resample

# 手动 Bagging 实现(简版)
def manual_bagging(X_train, y_train, X_test, n_estimators=10):
    preds = []
    for _ in range(n_estimators):
        X_samp, y_samp = resample(X_train, y_train, replace=True)
        clf = DecisionTreeClassifier()
        clf.fit(X_samp, y_samp)
        preds.append(clf.predict(X_test))
    # 多数投票
    return np.round(np.mean(preds, axis=0)).astype(int)

# 预测 & 评估
y_pred_manual = manual_bagging(X_train, y_train, X_test, n_estimators=10)
print("Manual Bagging Accuracy:", accuracy_score(y_test, y_pred_manual))
🧠 五、Bagging 与 Random Forest 的关系
| 项目 | Bagging | Random Forest |
|---|---|---|
| 基分类器 | 任意,如决策树 | 决策树(通常) |
| 特征选择 | 全部特征 or 随机子集 | 每个节点随机选部分特征 |
| 提高策略 | 数据集扰动 | 数据 + 特征扰动 |
| 是否防止过拟合 | 是 | 更强(降低相关性) |
- ➡️ 所以 Random Forest 是 Bagging + 特征扰动(Random Subspace) 的进化版本。
📊 六、可视化:Bagging 如何降低波动?
- 你可以绘制多个单棵树的预测 vs Bagging 的整体预测,看到 Bagging 更平滑、更稳定。
import matplotlib.pyplot as plt

# 示例:模型波动 vs Bagging
plt.figure(figsize=(10, 4))
for i in range(5):
    y_sample_pred = manual_bagging(X_train, y_train, X_test, n_estimators=1)
    plt.plot(y_sample_pred[:100], label=f"Tree {i+1}", alpha=0.6)

plt.plot(np.mean([manual_bagging(X_train, y_train, X_test, 1) for _ in range(5)], axis=0)[:100], label='Bagging Avg', color='black', linewidth=2)
plt.title("Individual Tree Predictions vs Bagging Ensemble")
plt.legend()
plt.show()
✅ 七、总结:Bagging 的优缺点
| 优点 | 缺点 |
|---|---|
| 降低方差,提高稳定性 | 无法降低偏差 |
| 并行训练,速度快 | 无法解释模型 |
| 抗噪性好,鲁棒性强 | 模型冗余,体积大 |
🧭 Bonus:何时使用 Bagging?
- 当模型对训练数据波动敏感(如决策树、KNN);
- 当需要更稳定的输出;
- 当你想要更强的泛化能力;
- 当你可以并行训练多个模型(多核/GPU)。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 15
 0
- 0


 已为社区贡献10条内容

所有评论(0)