让工业机器人更加敏捷:NVIDIA Isaac Manipulator与Vention MachineMotion AI的完美融合
让工业机器人更加敏捷:NVIDIA Isaac Manipulator与Vention MachineMotion AI的完美融合
文章目录
- 让工业机器人更加敏捷:NVIDIA Isaac Manipulator与Vention MachineMotion AI的完美融合
- 引言:工业自动化的智能化革命
- 第一章:工业机器人的现实挑战与AI驱动的解决方案
- 第二章:NVIDIA Isaac Manipulator技术架构深度解析
- 第三章:Vention MachineMotion AI - 边缘智能的工业化实现
- 第四章:系统集成架构与协同机制
- 第五章:随机箱拣选系统 - 实际应用案例深度解析
- 第六章:部署指南与最佳实践
- 结论与展望
引言:工业自动化的智能化革命
在第四次工业革命的浪潮中,工业自动化正经历着前所未有的变革。传统的机器人系统虽然在重复性任务中表现出色,但面对现代制造业日益复杂和动态的生产环境,其局限性愈发明显。如何让工业机器人变得更加智能、敏捷和适应性强,成为了制造业数字化转型的核心挑战。
NVIDIA作为AI计算领域的领导者,与工业自动化专家Vention携手,为这一挑战提供了革命性的解决方案。通过将NVIDIA Isaac Manipulator的先进AI能力与Vention MachineMotion AI的边缘控制技术深度融合,两家公司共同打造了一个能够显著提升工业机器人敏捷性和智能化水平的综合平台。
本文将深入探讨这一创新技术组合如何重新定义工业机器人的能力边界。我们将从技术架构、核心组件、实际应用案例等多个维度,全面解析NVIDIA Isaac Manipulator与Vention MachineMotion AI的集成优势。通过丰富的代码示例、详细的技术分析和实用的部署指南,本文旨在为工业自动化从业者提供一个完整的技术参考,帮助他们在智能制造的道路上迈出坚实的步伐。
文章结构概览
本文共分为六个主要章节,每个章节都深入探讨了这一技术组合的不同方面:
第一章将介绍工业机器人面临的现实挑战,以及AI驱动的解决方案如何应对这些挑战。我们将分析传统机器人系统的局限性,并展示智能化技术如何为工业自动化带来新的可能性。
第二章将深入解析NVIDIA Isaac Manipulator的技术架构和核心组件,包括cuMotion、nvblox、FoundationPose和FoundationStereo等关键技术。我们将通过详细的技术说明和代码示例,展示这些组件如何协同工作以实现高性能的机器人操作。
第三章将重点介绍Vention MachineMotion AI的特性和优势,探讨其如何通过边缘计算和远程管理能力,为工业机器人提供强大的控制和监管功能。
第四章将详细分析两个系统的集成架构,展示感知层、规划控制层和执行控制层如何协同工作,实现端到端的智能自动化解决方案。
第五章将通过具体的应用案例,如随机箱拣选系统,展示这一技术组合在实际工业环境中的应用效果和性能表现。
第六章将提供详细的部署指南和最佳实践,帮助读者在自己的项目中成功实施这一技术解决方案。
通过这一系统性的技术解析,读者将获得对NVIDIA Isaac Manipulator与Vention MachineMotion AI集成技术的全面理解,并掌握在实际项目中应用这些技术的实用知识和技能。
第一章:工业机器人的现实挑战与AI驱动的解决方案
1.1 现代制造业的复杂性挑战
随着全球制造业向智能化、个性化和柔性化方向发展,工业机器人面临着前所未有的挑战。传统的预编程机器人系统虽然在标准化生产线上表现出色,但在面对现代制造业的复杂需求时,其局限性日益凸显。
1.1.1 动态环境适应性不足
现代工厂环境充满了不确定性和变化。产品规格的频繁调整、生产线的灵活重配置、以及多品种小批量生产模式的普及,都要求机器人具备更强的环境适应能力。传统机器人系统依赖于精确的预编程路径和固定的工作环境,难以应对这种动态变化。
当生产线需要处理不同尺寸、形状或材质的产品时,传统机器人往往需要重新编程或物理调整,这不仅耗时耗力,还可能导致生产中断。更为严重的是,在处理不规则物体或应对意外障碍物时,传统系统缺乏实时感知和决策能力,容易发生碰撞或操作失误。
1.1.2 感知能力的局限性
精确的环境感知是机器人智能操作的基础。然而,传统工业机器人的感知系统往往依赖于简单的传感器和预设的环境模型,难以应对复杂的视觉场景和动态变化的工作环境。
在实际应用中,工业环境中的光照变化、物体遮挡、表面反射等因素都会影响传感器的性能。传统的2D视觉系统在处理重叠物体、透明材料或复杂几何形状时经常出现识别错误。而简单的深度传感器虽然能提供3D信息,但在精度和稳定性方面往往无法满足精密操作的要求。
1.1.3 运动规划的复杂性
高效的运动规划是机器人操作的核心。在复杂的工业环境中,机器人需要在避免碰撞的同时,找到最优的运动路径。传统的运动规划算法往往计算复杂度高,难以实现实时性能,特别是在处理高自由度机器人和复杂障碍物环境时。
此外,传统系统通常采用保守的安全策略,通过增大安全距离来避免碰撞,这虽然提高了安全性,但也降低了操作效率。在空间受限的工业环境中,这种保守策略可能导致机器人无法完成某些精密操作任务。
1.2 AI驱动的智能化解决方案
面对这些挑战,AI技术为工业机器人带来了革命性的改进。通过深度学习、计算机视觉、实时感知和智能决策等技术,现代AI驱动的机器人系统能够实现前所未有的智能化水平。
1.2.1 深度学习赋能的感知能力
现代AI技术,特别是深度学习,为机器人提供了强大的感知能力。通过训练大规模神经网络,机器人能够准确识别和定位各种物体,即使在复杂的视觉环境中也能保持高精度。
深度学习模型能够从大量数据中学习物体的特征表示,具备良好的泛化能力。这意味着机器人可以识别训练过程中未见过的物体变体,大大提高了系统的适应性。同时,多模态感知技术的发展使得机器人能够融合视觉、触觉、力觉等多种感知信息,形成更加全面和准确的环境理解。
1.2.2 GPU加速的实时计算
GPU并行计算技术的发展为AI算法的实时执行提供了强大的硬件支持。相比传统的CPU计算,GPU能够同时处理大量并行任务,特别适合深度学习推理和复杂的几何计算。
在机器人应用中,GPU加速使得复杂的感知算法、运动规划算法和控制算法能够在毫秒级时间内完成计算,满足实时控制的严格要求。这种计算能力的提升不仅改善了系统的响应速度,还使得更复杂的AI算法能够在实际应用中得到部署。
1.2.3 边缘计算的分布式智能
边缘计算技术的发展使得AI处理能力能够部署在接近数据源的位置,减少了数据传输延迟,提高了系统的实时性和可靠性。在工业机器人应用中,边缘AI设备能够在本地完成大部分感知和决策任务,只在必要时与云端系统进行通信。
这种分布式智能架构不仅提高了系统的响应速度,还增强了系统的鲁棒性。即使在网络连接不稳定或中断的情况下,机器人仍能继续执行基本的操作任务。同时,边缘计算还有助于保护敏感的生产数据,满足工业环境对数据安全的严格要求。
1.3 NVIDIA Isaac Manipulator:AI机器人技术的集大成者
NVIDIA Isaac Manipulator代表了AI驱动机器人技术的最新发展成果。作为一个综合性的软件平台,它集成了多项前沿技术,为工业机器人提供了完整的AI解决方案。
1.3.1 统一的软件架构
Isaac Manipulator采用模块化的软件架构,将感知、规划、控制等功能组织成独立但协调的组件。这种设计使得开发者能够根据具体应用需求灵活配置系统,同时也便于系统的维护和升级。
平台提供了标准化的接口和通信协议,使得不同组件之间能够无缝协作。开发者可以轻松地集成第三方硬件和软件,构建定制化的机器人解决方案。这种开放性和灵活性是传统封闭式机器人系统所无法比拟的。
1.3.2 端到端的优化
Isaac Manipulator的一个重要特点是其端到端的优化能力。从感知到执行的整个流程都经过了精心设计和优化,确保各个环节之间的协调配合。这种整体优化方法能够最大化系统的整体性能,而不是仅仅优化单个组件。
平台还提供了丰富的仿真和测试工具,使得开发者能够在虚拟环境中验证和优化算法,大大降低了开发成本和风险。通过仿真到现实的迁移技术,在虚拟环境中训练的模型能够直接应用到真实的机器人系统中。
1.4 Vention MachineMotion AI:边缘智能的工业化实现
Vention MachineMotion AI作为专门为工业应用设计的边缘控制平台,为AI驱动的机器人系统提供了强大的硬件基础和控制能力。
1.4.1 工业级的可靠性
MachineMotion AI平台专门针对工业环境的严苛要求进行了设计。它具备出色的环境适应性,能够在高温、高湿、强电磁干扰等恶劣条件下稳定运行。平台采用了冗余设计和故障自恢复机制,确保系统的高可用性。
工业级的可靠性不仅体现在硬件设计上,还体现在软件架构中。平台提供了完善的错误处理和异常恢复机制,能够在出现故障时快速诊断问题并采取相应的应对措施,最大限度地减少生产中断。
1.4.2 灵活的部署模式
MachineMotion AI支持多种部署模式,从单机控制到分布式网络,都能提供相应的解决方案。这种灵活性使得平台能够适应不同规模和复杂度的工业应用场景。
平台还支持热插拔和在线升级功能,使得系统维护和升级能够在不中断生产的情况下进行。这对于连续生产的工业环境来说具有重要意义,能够显著降低维护成本和生产损失。
1.5 技术融合的协同效应
NVIDIA Isaac Manipulator与Vention MachineMotion AI的结合,不仅仅是两个独立系统的简单叠加,而是形成了强大的协同效应。
1.5.1 算法与硬件的深度优化
两个平台的深度集成使得AI算法能够充分利用硬件的计算能力。Isaac Manipulator的算法经过了针对NVIDIA GPU架构的专门优化,能够在MachineMotion AI平台上发挥最佳性能。
这种硬件软件协同设计的方法,使得系统能够在保持高性能的同时,实现更低的功耗和更小的体积。这对于空间和能耗都有严格限制的工业应用来说具有重要意义。
1.5.2 从云到边缘的无缝连接
集成平台支持从云端到边缘的无缝数据流和控制流。复杂的模型训练和优化可以在云端进行,而实时的推理和控制则在边缘设备上执行。这种混合架构既保证了系统的实时性,又充分利用了云端的计算资源。
平台还提供了完善的远程监控和管理功能,使得工程师能够远程诊断问题、更新软件和优化参数。这种远程管理能力对于分布在不同地理位置的工业设施来说具有重要价值。
通过这种技术融合,NVIDIA Isaac Manipulator与Vention MachineMotion AI为工业机器人带来了前所未有的智能化水平,为制造业的数字化转型提供了强有力的技术支撑。在接下来的章节中,我们将深入探讨这一技术组合的具体实现和应用。
第二章:NVIDIA Isaac Manipulator技术架构深度解析
2.1 Isaac Manipulator平台概述
NVIDIA Isaac Manipulator是一个革命性的软件平台,专门为简化和加速AI驱动机器人操作器的部署而设计。作为NVIDIA在机器人技术领域多年积累的集大成者,Isaac Manipulator整合了计算机视觉、运动规划、深度学习和GPU加速计算等多项前沿技术,为工业机器人提供了一个统一、高效的开发和部署平台。
2.1.1 平台设计理念
Isaac Manipulator的设计理念围绕着"简化复杂性"这一核心目标。传统的机器人系统开发往往需要集成来自不同供应商的多个软件组件,这不仅增加了系统的复杂性,还可能导致性能瓶颈和兼容性问题。Isaac Manipulator通过提供一个统一的软件栈,将感知、规划、控制等关键功能整合在一个平台中,大大简化了开发和部署过程。
平台采用模块化的架构设计,每个模块都经过精心优化,既能独立工作,又能与其他模块无缝协作。这种设计使得开发者能够根据具体应用需求灵活配置系统,同时也为未来的功能扩展留下了充足的空间。
2.1.2 GPU加速的核心优势
Isaac Manipulator的一个显著特点是其对GPU加速技术的深度利用。与传统的CPU-based机器人系统相比,GPU的并行计算能力为复杂的AI算法提供了强大的计算支持。这种计算能力的提升不仅体现在处理速度上,更重要的是使得原本无法实时执行的复杂算法成为可能。
在机器人应用中,GPU加速特别适合以下几类计算任务:
并行图像处理:深度学习模型的推理过程涉及大量的矩阵运算,GPU的并行架构能够同时处理数千个计算单元,大大提高了图像识别和物体检测的速度。
几何计算:运动规划和碰撞检测涉及复杂的几何计算,GPU能够并行处理多个可能的路径和碰撞检测查询,实现实时的运动规划。
仿真计算:在开发和测试阶段,GPU加速的仿真能够快速验证算法的性能,加速开发周期。
2.2 cuMotion:革命性的GPU加速运动规划
cuMotion是Isaac Manipulator平台的核心组件之一,专门负责机器人的运动规划和轨迹生成。作为业界首个完全GPU加速的运动规划库,cuMotion在性能和功能方面都实现了重大突破。
2.2.1 技术原理与架构
cuMotion采用了基于采样的运动规划算法,结合GPU的并行计算能力,能够同时探索数千条可能的运动路径。传统的运动规划算法通常采用串行计算方式,逐一评估可能的路径,这种方法虽然能够找到可行解,但计算时间往往无法满足实时应用的要求。
cuMotion的创新之处在于其并行化的路径搜索策略。算法将搜索空间划分为多个子区域,每个GPU核心负责探索一个子区域内的路径。通过这种并行搜索方式,cuMotion能够在毫秒级时间内找到优化的运动轨迹。
2.2.2 核心功能特性
实时轨迹优化:cuMotion不仅能够快速找到可行的运动路径,还能够对轨迹进行实时优化。算法考虑了机器人的动力学约束、关节限制和安全要求,生成平滑、高效的运动轨迹。
动态障碍物处理:在工业环境中,障碍物的位置可能会发生变化。cuMotion能够实时更新环境模型,动态调整运动规划,确保机器人能够安全地避开移动的障碍物。
多目标优化:cuMotion支持多目标优化,能够同时考虑路径长度、执行时间、能耗等多个优化目标,生成符合实际应用需求的运动轨迹。
2.2.3 代码示例:cuMotion基础配置
以下代码展示了如何在Python环境中配置和使用cuMotion进行运动规划:
import numpy as np
from isaac_manipulator import cuMotion, RobotModel
import torch

class cuMotionPlanner:
    """
    cuMotion运动规划器封装类
    提供简化的接口用于机器人运动规划
    """

    def __init__(self, robot_config_path, world_config_path):
        """
        初始化cuMotion规划器

        Args:
            robot_config_path (str): 机器人配置文件路径
            world_config_path (str): 环境配置文件路径
        """
        # 加载机器人模型配置
        self.robot_model = RobotModel.from_config(robot_config_path)

        # 初始化cuMotion规划器
        self.motion_planner = cuMotion.MotionPlanner(
            robot_model=self.robot_model,
            world_config=world_config_path,
            device='cuda',  # 使用GPU加速
            batch_size=1024,  # 并行处理的轨迹数量
            max_iterations=1000,  # 最大迭代次数
            convergence_threshold=0.01  # 收敛阈值
        )

        # 配置规划参数
        self.planning_config = {
            'interpolation_steps': 100,  # 轨迹插值步数
            'collision_check_resolution': 0.01,  # 碰撞检测分辨率
            'smoothing_weight': 0.1,  # 平滑权重
            'velocity_scaling': 0.8,  # 速度缩放因子
            'acceleration_scaling': 0.6  # 加速度缩放因子
        }

    def plan_trajectory(self, start_pose, goal_pose, obstacles=None):
        """
        规划从起始位姿到目标位姿的轨迹

        Args:
            start_pose (np.ndarray): 起始关节角度 [7,]
            goal_pose (np.ndarray): 目标关节角度 [7,]
            obstacles (list): 障碍物列表,可选

        Returns:
            dict: 包含轨迹信息的字典
        """
        # 转换为GPU张量
        start_tensor = torch.tensor(start_pose, dtype=torch.float32, device='cuda')
        goal_tensor = torch.tensor(goal_pose, dtype=torch.float32, device='cuda')

        # 更新环境中的障碍物
        if obstacles is not None:
            self.motion_planner.update_obstacles(obstacles)

        # 执行运动规划
        planning_result = self.motion_planner.plan(
            start_state=start_tensor,
            goal_state=goal_tensor,
            **self.planning_config
        )

        # 检查规划是否成功
        if planning_result.success:
            trajectory = {
                'joint_positions': planning_result.trajectory.cpu().numpy(),
                'joint_velocities': planning_result.velocities.cpu().numpy(),
                'joint_accelerations': planning_result.accelerations.cpu().numpy(),
                'timestamps': planning_result.timestamps.cpu().numpy(),
                'planning_time': planning_result.planning_time,
                'trajectory_length': planning_result.trajectory_length,
                'collision_free': planning_result.collision_free
            }
            return trajectory
        else:
            raise RuntimeError(f"运动规划失败: {planning_result.error_message}")

    def plan_cartesian_trajectory(self, start_pose, goal_pose, waypoints=None):
        """
        规划笛卡尔空间轨迹

        Args:
            start_pose (np.ndarray): 起始末端执行器位姿 [7,] (位置+四元数)
            goal_pose (np.ndarray): 目标末端执行器位姿 [7,]
            waypoints (list): 中间路径点,可选

        Returns:
            dict: 包含轨迹信息的字典
        """
        # 转换为GPU张量
        start_cartesian = torch.tensor(start_pose, dtype=torch.float32, device='cuda')
        goal_cartesian = torch.tensor(goal_pose, dtype=torch.float32, device='cuda')

        # 处理中间路径点
        if waypoints is not None:
            waypoints_tensor = torch.tensor(waypoints, dtype=torch.float32, device='cuda')
        else:
            waypoints_tensor = None

        # 执行笛卡尔空间规划
        cartesian_result = self.motion_planner.plan_cartesian(
            start_pose=start_cartesian,
            goal_pose=goal_cartesian,
            waypoints=waypoints_tensor,
            max_deviation=0.01,  # 最大偏差
            step_size=0.005,  # 步长
            jump_threshold=2.0  # 跳跃阈值
        )

        if cartesian_result.success:
            return {
                'cartesian_path': cartesian_result.cartesian_path.cpu().numpy(),
                'joint_trajectory': cartesian_result.joint_trajectory.cpu().numpy(),
                'fraction_achieved': cartesian_result.fraction_achieved,
                'planning_time': cartesian_result.planning_time
            }
        else:
            raise RuntimeError(f"笛卡尔轨迹规划失败: {cartesian_result.error_message}")

# 使用示例
def main():
    """
    cuMotion使用示例
    """
    # 初始化规划器
    planner = cuMotionPlanner(
        robot_config_path="config/ur5e_robot.yaml",
        world_config_path="config/factory_world.yaml"
    )

    # 定义起始和目标关节角度
    start_joints = np.array([0.0, -1.57, 1.57, -1.57, -1.57, 0.0, 0.0])
    goal_joints = np.array([1.57, -1.0, 1.0, -2.0, -1.57, 1.57, 0.0])

    try:
        # 规划关节空间轨迹
        trajectory = planner.plan_trajectory(start_joints, goal_joints)

        print(f"轨迹规划成功!")
        print(f"规划时间: {trajectory['planning_time']:.3f} 秒")
        print(f"轨迹长度: {trajectory['trajectory_length']:.3f} 米")
        print(f"轨迹点数: {len(trajectory['joint_positions'])}")

        # 规划笛卡尔空间轨迹
        start_cartesian = np.array([0.5, 0.0, 0.5, 0.0, 0.0, 0.0, 1.0])  # x,y,z,qx,qy,qz,qw
        goal_cartesian = np.array([0.3, 0.3, 0.4, 0.0, 0.0, 0.707, 0.707])

        cartesian_traj = planner.plan_cartesian_trajectory(start_cartesian, goal_cartesian)
        print(f"笛卡尔轨迹规划成功! 完成度: {cartesian_traj['fraction_achieved']:.2%}")

    except RuntimeError as e:
        print(f"规划失败: {e}")

if __name__ == "__main__":
    main()
2.3 nvblox:实时3D环境感知与建图
nvblox是Isaac Manipulator平台中负责环境感知和3D建图的核心组件。它能够实时处理深度传感器数据,构建精确的3D环境模型,为机器人的导航和操作提供关键的空间信息。
2.3.1 技术架构与特性
nvblox采用了基于体素的3D重建技术,结合GPU并行计算,能够实时处理高分辨率的深度数据。与传统的点云处理方法相比,体素化表示具有更好的内存效率和计算性能。
实时性能:nvblox能够以30Hz的频率处理深度图像,实时更新3D环境模型。这种实时性能对于动态工业环境中的机器人操作至关重要。
高精度建图:系统支持毫米级的建图精度,能够准确捕捉工业环境中的细节特征,为精密操作提供可靠的空间信息。
动态物体处理:nvblox具备动态物体检测和处理能力,能够区分静态环境和移动物体,确保环境模型的准确性。
2.3.2 代码示例:nvblox环境建图
import numpy as np
import torch
from isaac_manipulator import nvblox
import cv2

class EnvironmentMapper:
    """
    基于nvblox的环境建图器
    实时构建和更新3D环境模型
    """

    def __init__(self, voxel_size=0.01, device='cuda'):
        """
        初始化环境建图器

        Args:
            voxel_size (float): 体素大小,单位米
            device (str): 计算设备
        """
        self.voxel_size = voxel_size
        self.device = device

        # 初始化nvblox映射器
        self.mapper = nvblox.Mapper(
            voxel_size=voxel_size,
            device=device,
            max_integration_distance=5.0,  # 最大积分距离
            truncation_distance=0.1,  # 截断距离
            weight_threshold=1e-4  # 权重阈值
        )

        # 配置传感器参数
        self.camera_intrinsics = {
            'fx': 525.0,  # 焦距x
            'fy': 525.0,  # 焦距y
            'cx': 320.0,  # 主点x
            'cy': 240.0,  # 主点y
            'width': 640,  # 图像宽度
            'height': 480  # 图像高度
        }

        # 初始化TSDF(截断符号距离函数)层
        self.tsdf_layer = nvblox.TsdfLayer(voxel_size, device)
        self.color_layer = nvblox.ColorLayer(voxel_size, device)
        self.occupancy_layer = nvblox.OccupancyLayer(voxel_size, device)

    def integrate_depth_image(self, depth_image, camera_pose, color_image=None):
        """
        集成深度图像到3D模型中

        Args:
            depth_image (np.ndarray): 深度图像 [H, W]
            camera_pose (np.ndarray): 相机位姿 [4, 4]
            color_image (np.ndarray): 彩色图像 [H, W, 3],可选
        """
        # 转换为GPU张量
        depth_tensor = torch.tensor(depth_image, dtype=torch.float32, device=self.device)
        pose_tensor = torch.tensor(camera_pose, dtype=torch.float32, device=self.device)

        if color_image is not None:
            color_tensor = torch.tensor(color_image, dtype=torch.uint8, device=self.device)
        else:
            color_tensor = None

        # 创建相机对象
        camera = nvblox.Camera(
            intrinsics=self.camera_intrinsics,
            pose=pose_tensor
        )

        # 集成深度数据
        self.mapper.integrate_depth(
            depth_image=depth_tensor,
            camera=camera,
            tsdf_layer=self.tsdf_layer
        )

        # 如果有彩色图像,同时集成颜色信息
        if color_tensor is not None:
            self.mapper.integrate_color(
                color_image=color_tensor,
                camera=camera,
                color_layer=self.color_layer
            )

        # 更新占用栅格
        self.mapper.update_occupancy(
            tsdf_layer=self.tsdf_layer,
            occupancy_layer=self.occupancy_layer
        )

    def extract_mesh(self, min_weight=1e-4):
        """
        从TSDF层提取三角网格

        Args:
            min_weight (float): 最小权重阈值

        Returns:
            dict: 包含顶点和面的网格数据
        """
        mesh = self.mapper.extract_mesh(
            tsdf_layer=self.tsdf_layer,
            min_weight=min_weight
        )

        return {
            'vertices': mesh.vertices.cpu().numpy(),
            'faces': mesh.faces.cpu().numpy(),
            'colors': mesh.colors.cpu().numpy() if mesh.has_colors else None
        }

    def get_occupancy_map(self, height_slice=0.5, resolution=0.05):
        """
        获取指定高度的占用栅格地图

        Args:
            height_slice (float): 切片高度
            resolution (float): 栅格分辨率

        Returns:
            np.ndarray: 2D占用栅格地图
        """
        occupancy_map = self.mapper.get_occupancy_slice(
            occupancy_layer=self.occupancy_layer,
            height=height_slice,
            resolution=resolution
        )

        return occupancy_map.cpu().numpy()

    def check_collision(self, points, safety_margin=0.05):
        """
        检查给定点是否与环境发生碰撞

        Args:
            points (np.ndarray): 待检查的点 [N, 3]
            safety_margin (float): 安全边距

        Returns:
            np.ndarray: 碰撞检查结果 [N,],True表示碰撞
        """
        points_tensor = torch.tensor(points, dtype=torch.float32, device=self.device)

        collision_results = self.mapper.check_collision(
            points=points_tensor,
            tsdf_layer=self.tsdf_layer,
            safety_margin=safety_margin
        )

        return collision_results.cpu().numpy()

# 使用示例
def demonstrate_mapping():
    """
    演示nvblox环境建图功能
    """
    # 初始化建图器
    mapper = EnvironmentMapper(voxel_size=0.01)

    # 模拟深度相机数据流
    for frame_id in range(100):
        # 生成模拟深度图像(实际应用中从相机获取)
        depth_image = np.random.rand(480, 640) * 2.0  # 0-2米深度

        # 生成模拟相机位姿
        camera_pose = np.eye(4)
        camera_pose[0, 3] = frame_id * 0.01  # x方向移动
        camera_pose[2, 3] = 1.0  # 高度1米

        # 集成深度数据
        mapper.integrate_depth_image(depth_image, camera_pose)

        # 每10帧提取一次网格
        if frame_id % 10 == 0:
            mesh = mapper.extract_mesh()
            print(f"帧 {frame_id}: 提取到 {len(mesh['vertices'])} 个顶点")

    # 获取最终的占用栅格地图
    occupancy_map = mapper.get_occupancy_map(height_slice=0.5)
    print(f"占用栅格地图大小: {occupancy_map.shape}")

    # 碰撞检查示例
    test_points = np.array([[0.5, 0.0, 0.5], [1.0, 1.0, 1.0]])
    collisions = mapper.check_collision(test_points)
    print(f"碰撞检查结果: {collisions}")

if __name__ == "__main__":
    demonstrate_mapping()
2.4 FoundationPose:强大的6D姿态估计
FoundationPose是Isaac Manipulator平台中的姿态估计组件,专门负责准确识别和定位物体的6D姿态(3D位置 + 3D旋转)。这一组件采用了先进的深度学习技术,能够处理各种复杂的视觉场景。
2.4.1 零样本学习能力
FoundationPose的一个突出特点是其零样本学习能力。传统的姿态估计系统通常需要针对每个特定物体进行训练,这不仅耗时耗力,还限制了系统的通用性。FoundationPose通过在大规模合成数据集上的预训练,获得了强大的泛化能力,能够直接处理未见过的物体。
这种零样本能力的实现依赖于几个关键技术:
大规模合成数据训练:研发团队使用Isaac Sim生成了超过500万张合成图像,涵盖了各种物体、光照条件和背景环境。这种大规模的数据训练使得模型能够学习到物体的通用特征表示。
几何先验知识:模型集成了丰富的几何先验知识,能够理解物体的3D结构和空间关系,即使面对新的物体形状也能进行合理的姿态推断。
多模态融合:FoundationPose同时利用RGB图像和深度信息,通过多模态融合提高姿态估计的准确性和鲁棒性。
2.4.2 代码示例:FoundationPose姿态估计
import numpy as np
import torch
import cv2
from isaac_manipulator import FoundationPose
from typing import Dict, List, Tuple, Optional

class PoseEstimator:
    """
    基于FoundationPose的6D姿态估计器
    支持零样本物体姿态估计
    """

    def __init__(self, model_path: str, device: str = 'cuda'):
        """
        初始化姿态估计器

        Args:
            model_path (str): FoundationPose模型路径
            device (str): 计算设备
        """
        self.device = device

        # 加载FoundationPose模型
        self.pose_estimator = FoundationPose.load_model(
            model_path=model_path,
            device=device
        )

        # 配置估计参数
        self.estimation_config = {
            'confidence_threshold': 0.7,  # 置信度阈值
            'nms_threshold': 0.5,  # 非极大值抑制阈值
            'max_detections': 10,  # 最大检测数量
            'refinement_iterations': 5,  # 精化迭代次数
            'use_symmetry': True,  # 是否使用对称性
            'temporal_smoothing': True  # 是否使用时序平滑
        }

        # 初始化物体跟踪器
        self.object_tracker = FoundationPose.ObjectTracker(
            max_age=30,  # 最大跟踪帧数
            min_hits=3,  # 最小命中次数
            iou_threshold=0.3  # IoU阈值
        )

    def estimate_pose(self, rgb_image: np.ndarray, depth_image: np.ndarray,
                     camera_intrinsics: Dict, object_mesh: Optional[str] = None) -> List[Dict]:
        """
        估计场景中物体的6D姿态

        Args:
            rgb_image (np.ndarray): RGB图像 [H, W, 3]
            depth_image (np.ndarray): 深度图像 [H, W]
            camera_intrinsics (Dict): 相机内参
            object_mesh (str): 物体网格文件路径,可选

        Returns:
            List[Dict]: 检测到的物体姿态列表
        """
        # 预处理输入数据
        rgb_tensor = torch.tensor(rgb_image, dtype=torch.float32, device=self.device) / 255.0
        depth_tensor = torch.tensor(depth_image, dtype=torch.float32, device=self.device)

        # 构建相机参数
        camera_params = {
            'fx': camera_intrinsics['fx'],
            'fy': camera_intrinsics['fy'],
            'cx': camera_intrinsics['cx'],
            'cy': camera_intrinsics['cy']
        }

        # 执行姿态估计
        with torch.no_grad():
            estimation_results = self.pose_estimator.estimate(
                rgb_image=rgb_tensor,
                depth_image=depth_tensor,
                camera_params=camera_params,
                object_mesh=object_mesh,
                **self.estimation_config
            )

        # 处理估计结果
        detected_objects = []
        for detection in estimation_results.detections:
            if detection.confidence > self.estimation_config['confidence_threshold']:
                object_info = {
                    'object_id': detection.object_id,
                    'class_name': detection.class_name,
                    'confidence': detection.confidence.item(),
                    'pose_matrix': detection.pose_matrix.cpu().numpy(),  # 4x4变换矩阵
                    'position': detection.position.cpu().numpy(),  # [x, y, z]
                    'orientation': detection.orientation.cpu().numpy(),  # 四元数 [x, y, z, w]
                    'bounding_box_2d': detection.bbox_2d.cpu().numpy(),  # 2D边界框
                    'bounding_box_3d': detection.bbox_3d.cpu().numpy(),  # 3D边界框
                    'pose_uncertainty': detection.uncertainty.cpu().numpy()  # 姿态不确定性
                }
                detected_objects.append(object_info)

        return detected_objects

    def track_objects(self, current_detections: List[Dict]) -> List[Dict]:
        """
        跟踪检测到的物体

        Args:
            current_detections (List[Dict]): 当前帧的检测结果

        Returns:
            List[Dict]: 跟踪结果
        """
        # 更新跟踪器
        tracked_objects = self.object_tracker.update(current_detections)

        # 为每个跟踪的物体添加跟踪信息
        for obj in tracked_objects:
            obj['track_id'] = obj.get('track_id', -1)
            obj['track_age'] = obj.get('track_age', 0)
            obj['velocity'] = obj.get('velocity', np.zeros(6))  # 6D速度

        return tracked_objects

    def refine_pose(self, rgb_image: np.ndarray, depth_image: np.ndarray,
                   initial_pose: np.ndarray, object_mesh: str,
                   camera_intrinsics: Dict) -> Dict:
        """
        精化物体姿态估计

        Args:
            rgb_image (np.ndarray): RGB图像
            depth_image (np.ndarray): 深度图像
            initial_pose (np.ndarray): 初始姿态 [4, 4]
            object_mesh (str): 物体网格文件路径
            camera_intrinsics (Dict): 相机内参

        Returns:
            Dict: 精化后的姿态信息
        """
        # 转换输入数据
        rgb_tensor = torch.tensor(rgb_image, dtype=torch.float32, device=self.device) / 255.0
        depth_tensor = torch.tensor(depth_image, dtype=torch.float32, device=self.device)
        pose_tensor = torch.tensor(initial_pose, dtype=torch.float32, device=self.device)

        # 执行姿态精化
        refined_result = self.pose_estimator.refine_pose(
            rgb_image=rgb_tensor,
            depth_image=depth_tensor,
            initial_pose=pose_tensor,
            object_mesh=object_mesh,
            camera_intrinsics=camera_intrinsics,
            max_iterations=self.estimation_config['refinement_iterations']
        )

        return {
            'refined_pose': refined_result.pose.cpu().numpy(),
            'refinement_error': refined_result.error.item(),
            'convergence_achieved': refined_result.converged,
            'iteration_count': refined_result.iterations
        }

# 使用示例
def demonstrate_pose_estimation():
    """
    演示FoundationPose姿态估计功能
    """
    # 初始化姿态估计器
    estimator = PoseEstimator(
        model_path="models/foundation_pose.pth",
        device='cuda'
    )

    # 模拟相机内参
    camera_intrinsics = {
        'fx': 525.0, 'fy': 525.0,
        'cx': 320.0, 'cy': 240.0
    }

    # 模拟输入图像(实际应用中从相机获取)
    rgb_image = np.random.randint(0, 255, (480, 640, 3), dtype=np.uint8)
    depth_image = np.random.rand(480, 640) * 2.0  # 0-2米深度

    try:
        # 执行姿态估计
        detections = estimator.estimate_pose(
            rgb_image=rgb_image,
            depth_image=depth_image,
            camera_intrinsics=camera_intrinsics
        )

        print(f"检测到 {len(detections)} 个物体:")
        for i, obj in enumerate(detections):
            print(f"物体 {i+1}:")
            print(f"  类别: {obj['class_name']}")
            print(f"  置信度: {obj['confidence']:.3f}")
            print(f"  位置: {obj['position']}")
            print(f"  方向: {obj['orientation']}")

        # 跟踪物体
        tracked_objects = estimator.track_objects(detections)
        print(f"跟踪到 {len(tracked_objects)} 个物体")

    except Exception as e:
        print(f"姿态估计失败: {e}")

if __name__ == "__main__":
    demonstrate_pose_estimation()
2.5 FoundationStereo:高精度立体视觉
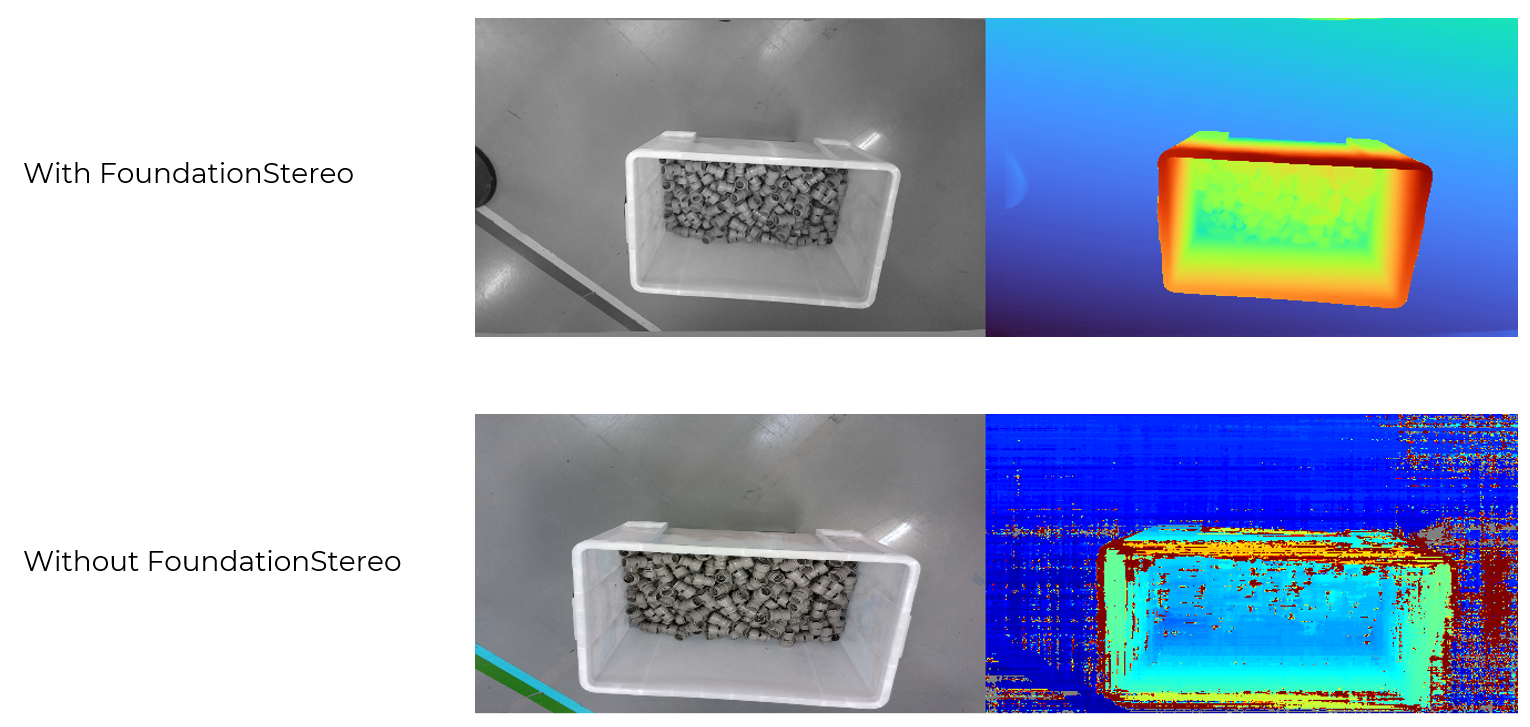
FoundationStereo是Isaac Manipulator平台中负责立体视觉处理的组件,专门用于从立体图像对中提取高质量的深度信息。这一组件在CVPR 2025获得了最佳论文提名,体现了其在学术界的认可度。
2.5.1 技术创新与优势
FoundationStereo的核心创新在于其对经济型传感器的深度优化。传统的立体视觉算法往往需要高精度的标定和昂贵的硬件设备才能获得满意的结果。FoundationStereo通过深度学习技术,能够显著改善Intel RealSense等经济型传感器的深度质量。
大规模合成数据训练:FoundationStereo在包含数百万立体图像对的大规模合成数据集上进行训练,学习了丰富的立体匹配模式和深度推理规则。
多尺度特征融合:算法采用多尺度特征提取和融合策略,能够同时捕捉细节特征和全局结构信息,提高深度估计的准确性。
边缘保持技术:FoundationStereo特别注重深度图像的边缘保持,能够准确重建物体边界,这对于精密的机器人操作至关重要。
2.5.2 代码示例:FoundationStereo深度估计
import numpy as np
import torch
import cv2
from isaac_manipulator import FoundationStereo
from typing import Dict, Tuple

class StereoDepthEstimator:
    """
    基于FoundationStereo的立体深度估计器
    提供高质量的深度图像生成
    """

    def __init__(self, model_path: str, device: str = 'cuda'):
        """
        初始化立体深度估计器

        Args:
            model_path (str): FoundationStereo模型路径
            device (str): 计算设备
        """
        self.device = device

        # 加载FoundationStereo模型
        self.stereo_model = FoundationStereo.load_model(
            model_path=model_path,
            device=device
        )

        # 配置估计参数
        self.estimation_config = {
            'max_disparity': 192,  # 最大视差
            'disparity_step': 1,  # 视差步长
            'confidence_threshold': 0.8,  # 置信度阈值
            'edge_threshold': 0.1,  # 边缘阈值
            'smoothness_weight': 0.1,  # 平滑权重
            'occlusion_handling': True,  # 遮挡处理
            'subpixel_refinement': True  # 亚像素精化
        }

        # 初始化后处理器
        self.post_processor = FoundationStereo.PostProcessor(
            median_filter_size=5,  # 中值滤波器大小
            bilateral_filter_d=9,  # 双边滤波器直径
            bilateral_sigma_color=75,  # 颜色空间标准差
            bilateral_sigma_space=75  # 坐标空间标准差
        )

    def estimate_depth(self, left_image: np.ndarray, right_image: np.ndarray,
                      camera_params: Dict) -> Dict:
        """
        从立体图像对估计深度

        Args:
            left_image (np.ndarray): 左图像 [H, W, 3]
            right_image (np.ndarray): 右图像 [H, W, 3]
            camera_params (Dict): 相机参数

        Returns:
            Dict: 深度估计结果
        """
        # 预处理图像
        left_tensor = self._preprocess_image(left_image)
        right_tensor = self._preprocess_image(right_image)

        # 执行立体匹配
        with torch.no_grad():
            stereo_result = self.stereo_model.estimate(
                left_image=left_tensor,
                right_image=right_tensor,
                **self.estimation_config
            )

        # 转换视差到深度
        disparity = stereo_result.disparity.cpu().numpy()
        confidence = stereo_result.confidence.cpu().numpy()

        # 计算深度图
        baseline = camera_params['baseline']  # 基线距离
        focal_length = camera_params['focal_length']  # 焦距

        # 避免除零错误
        valid_mask = (disparity > 0) & (confidence > self.estimation_config['confidence_threshold'])
        depth_map = np.zeros_like(disparity)
        depth_map[valid_mask] = (baseline * focal_length) / disparity[valid_mask]

        # 后处理
        if self.estimation_config.get('post_processing', True):
            depth_map = self.post_processor.process(depth_map, confidence)

        return {
            'depth_map': depth_map,
            'disparity_map': disparity,
            'confidence_map': confidence,
            'valid_mask': valid_mask,
            'processing_time': stereo_result.processing_time
        }

    def _preprocess_image(self, image: np.ndarray) -> torch.Tensor:
        """
        预处理输入图像

        Args:
            image (np.ndarray): 输入图像

        Returns:
            torch.Tensor: 预处理后的图像张量
        """
        # 转换为浮点数并归一化
        image_float = image.astype(np.float32) / 255.0

        # 转换为张量并移动到GPU
        image_tensor = torch.tensor(image_float, device=self.device)

        # 调整维度顺序 [H, W, C] -> [C, H, W]
        image_tensor = image_tensor.permute(2, 0, 1)

        # 添加批次维度 [C, H, W] -> [1, C, H, W]
        image_tensor = image_tensor.unsqueeze(0)

        return image_tensor

    def calibrate_stereo_camera(self, calibration_images: List[Tuple[np.ndarray, np.ndarray]],
                               chessboard_size: Tuple[int, int]) -> Dict:
        """
        标定立体相机

        Args:
            calibration_images (List): 标定图像对列表
            chessboard_size (Tuple): 棋盘格大小

        Returns:
            Dict: 标定结果
        """
        # 准备标定点
        pattern_points = np.zeros((chessboard_size[0] * chessboard_size[1], 3), np.float32)
        pattern_points[:, :2] = np.mgrid[0:chessboard_size[0], 0:chessboard_size[1]].T.reshape(-1, 2)

        object_points = []  # 3D点
        left_image_points = []  # 左图像点
        right_image_points = []  # 右图像点

        for left_img, right_img in calibration_images:
            # 转换为灰度图
            left_gray = cv2.cvtColor(left_img, cv2.COLOR_BGR2GRAY)
            right_gray = cv2.cvtColor(right_img, cv2.COLOR_BGR2GRAY)

            # 查找棋盘格角点
            left_found, left_corners = cv2.findChessboardCorners(left_gray, chessboard_size)
            right_found, right_corners = cv2.findChessboardCorners(right_gray, chessboard_size)

            if left_found and right_found:
                object_points.append(pattern_points)
                left_image_points.append(left_corners)
                right_image_points.append(right_corners)

        # 执行立体标定
        image_size = left_gray.shape[::-1]

        ret, left_camera_matrix, left_dist_coeffs, right_camera_matrix, right_dist_coeffs, \
        rotation_matrix, translation_vector, essential_matrix, fundamental_matrix = \
            cv2.stereoCalibrate(
                object_points, left_image_points, right_image_points,
                None, None, None, None, image_size,
                flags=cv2.CALIB_FIX_INTRINSIC
            )

        # 计算立体校正参数
        R1, R2, P1, P2, Q, roi_left, roi_right = cv2.stereoRectify(
            left_camera_matrix, left_dist_coeffs,
            right_camera_matrix, right_dist_coeffs,
            image_size, rotation_matrix, translation_vector
        )

        return {
            'left_camera_matrix': left_camera_matrix,
            'right_camera_matrix': right_camera_matrix,
            'left_dist_coeffs': left_dist_coeffs,
            'right_dist_coeffs': right_dist_coeffs,
            'rotation_matrix': rotation_matrix,
            'translation_vector': translation_vector,
            'rectification_R1': R1,
            'rectification_R2': R2,
            'projection_P1': P1,
            'projection_P2': P2,
            'disparity_to_depth_Q': Q,
            'baseline': abs(translation_vector[0]),
            'focal_length': P1[0, 0],
            'calibration_error': ret
        }

# 使用示例
def demonstrate_stereo_depth():
    """
    演示FoundationStereo深度估计功能
    """
    # 初始化深度估计器
    estimator = StereoDepthEstimator(
        model_path="models/foundation_stereo.pth",
        device='cuda'
    )

    # 模拟立体图像对
    left_image = np.random.randint(0, 255, (480, 640, 3), dtype=np.uint8)
    right_image = np.random.randint(0, 255, (480, 640, 3), dtype=np.uint8)

    # 相机参数
    camera_params = {
        'baseline': 0.12,  # 12cm基线
        'focal_length': 525.0  # 焦距
    }

    try:
        # 估计深度
        depth_result = estimator.estimate_depth(
            left_image=left_image,
            right_image=right_image,
            camera_params=camera_params
        )

        print(f"深度估计完成:")
        print(f"  处理时间: {depth_result['processing_time']:.3f} 秒")
        print(f"  有效像素比例: {np.mean(depth_result['valid_mask']):.2%}")
        print(f"  平均深度: {np.mean(depth_result['depth_map'][depth_result['valid_mask']]):.3f} 米")
        print(f"  深度范围: {np.min(depth_result['depth_map'][depth_result['valid_mask']]):.3f} - "
              f"{np.max(depth_result['depth_map'][depth_result['valid_mask']]):.3f} 米")

    except Exception as e:
        print(f"深度估计失败: {e}")

if __name__ == "__main__":
    demonstrate_stereo_depth()
2.6 Isaac Manipulator集成架构
Isaac Manipulator的强大之处不仅在于其各个组件的先进性,更在于这些组件之间的深度集成和协同工作。平台采用了统一的数据流架构,确保各个组件能够高效地共享信息和协调操作。
2.6.1 数据流架构
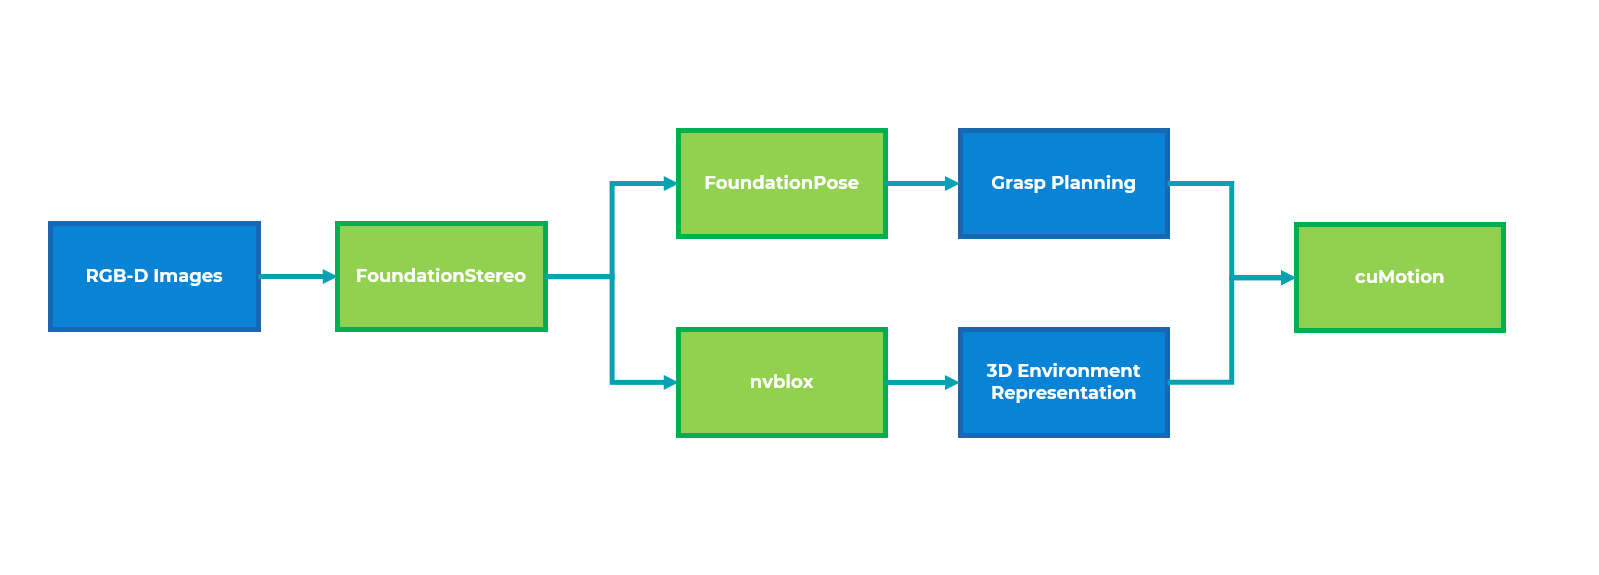
Isaac Manipulator采用了基于ROS 2的分布式架构,各个组件通过标准化的消息接口进行通信。这种设计具有以下优势:
模块化设计:每个组件都是独立的模块,可以单独开发、测试和部署,提高了系统的可维护性。
实时性保证:通过优化的消息传递机制和GPU内存管理,系统能够保证端到端的实时性能。
可扩展性:标准化的接口使得系统能够轻松集成新的组件或替换现有组件。
2.6.2 性能优化策略
Isaac Manipulator采用了多种性能优化策略,确保系统能够满足工业应用的严格要求:
GPU内存优化:通过智能的内存管理和数据复用,最大化GPU内存的利用效率。
并行计算优化:充分利用GPU的并行计算能力,将不同的计算任务分配到不同的GPU核心上。
算法融合:将多个相关的计算步骤融合到单个GPU核函数中,减少内存访问开销。
通过这些优化策略,Isaac Manipulator能够在保持高精度的同时,实现毫秒级的响应时间,满足实时工业应用的需求。
第三章:Vention MachineMotion AI - 边缘智能的工业化实现
3.1 MachineMotion AI平台概述
Vention MachineMotion AI代表了工业自动化控制技术的最新发展成果。作为一个专门为工业环境设计的边缘AI控制平台,MachineMotion AI将先进的人工智能技术与传统的工业控制系统完美融合,为现代制造业提供了一个强大、可靠且易于部署的自动化解决方案。
3.1.1 设计理念与核心价值
MachineMotion AI的设计理念围绕着"智能化、简化、标准化"三个核心原则。在智能化方面,平台集成了NVIDIA Jetson Orin的强大AI计算能力,能够在边缘设备上直接运行复杂的深度学习模型。在简化方面,平台提供了直观的低代码开发环境,使得工程师能够快速构建和部署自动化解决方案。在标准化方面,平台采用了开放的接口标准,确保与各种工业设备和系统的兼容性。
这种设计理念的核心价值在于降低工业AI应用的门槛。传统的工业AI部署往往需要深厚的技术背景和大量的开发时间,MachineMotion AI通过提供预集成的AI功能和简化的开发工具,使得普通的工业工程师也能够快速实现智能化改造。
3.1.2 技术架构特点
MachineMotion AI采用了分层的技术架构,从底层的硬件抽象到顶层的应用接口,每一层都经过精心设计以确保系统的性能和可靠性。
硬件抽象层:提供了统一的硬件接口,支持各种传感器、执行器和通信设备的接入。这一层屏蔽了硬件的复杂性,为上层应用提供了标准化的访问接口。
实时控制层:基于实时操作系统构建,确保关键控制任务的确定性执行。这一层负责处理时间敏感的控制逻辑,如运动控制、安全监控等。
AI推理层:集成了优化的深度学习推理引擎,能够高效地执行各种AI模型。这一层充分利用了NVIDIA Jetson Orin的GPU计算能力,实现了边缘AI的高性能推理。
应用服务层:提供了丰富的应用服务和API接口,支持快速的应用开发和部署。这一层包括了数据管理、设备管理、用户管理等核心服务。
3.2 NVIDIA Jetson Orin集成优势
MachineMotion AI平台的核心计算能力来自于NVIDIA Jetson Orin系列处理器。这种深度集成不仅提供了强大的计算性能,还带来了一系列独特的优势。
3.2.1 边缘AI计算能力
Jetson Orin系列处理器专门为边缘AI应用而设计,具备了出色的AI推理性能。在MachineMotion AI平台中,这种计算能力被充分利用来实现各种智能功能:
实时物体检测与识别:利用GPU的并行计算能力,系统能够实时处理高分辨率的视觉数据,准确识别和定位工业环境中的各种物体。
动态路径规划:结合Isaac Manipulator的cuMotion技术,系统能够在复杂的工业环境中实时计算最优的机器人运动路径。
预测性维护:通过分析传感器数据的模式,系统能够预测设备的维护需求,提前发现潜在的故障。
3.2.2 能效优化设计
Jetson Orin在提供强大计算能力的同时,还具备了出色的能效表现。这对于需要长期连续运行的工业设备来说具有重要意义:
动态功耗管理:处理器能够根据工作负载动态调整功耗,在保证性能的同时最小化能耗。
热管理优化:先进的热管理技术确保系统在高负载下仍能稳定运行,延长设备的使用寿命。
低功耗待机:在系统空闲时,处理器能够进入低功耗模式,进一步降低整体能耗。
3.3 核心应用场景深度解析
MachineMotion AI平台在多个工业应用场景中展现了其强大的能力和灵活性。以下是几个典型的应用场景及其技术实现。
3.3.1 基于边缘的机器人拾取和放置
这是MachineMotion AI最具代表性的应用场景之一。通过将AI推理能力部署在边缘设备上,系统能够实现真正的实时响应,大大提高了操作效率。
技术实现原理:
系统利用板载的深度相机获取工作区域的RGB-D图像,然后通过FoundationPose模型实时识别和定位目标物体。识别结果被传递给cuMotion进行路径规划,最终由MachineMotion AI控制机器人执行精确的拾取和放置操作。
性能优势:
相比传统的云端处理方案,边缘处理将延迟从数百毫秒降低到数十毫秒,这种延迟的降低对于需要快速响应的工业应用来说具有重要意义。同时,边缘处理还提高了系统的可靠性,即使在网络连接不稳定的情况下,系统仍能正常工作。
3.3.2 代码示例:边缘拾取和放置系统
import numpy as np
import torch
from typing import Dict, List, Tuple
from isaac_manipulator import cuMotion, FoundationPose
from vention_machinemotion import MachineMotionAI, RobotController

class EdgePickAndPlaceSystem:
    """
    基于边缘计算的拾取和放置系统
    集成MachineMotion AI和Isaac Manipulator
    """

    def __init__(self, config_path: str):
        """
        初始化边缘拾取和放置系统

        Args:
            config_path (str): 系统配置文件路径
        """
        # 加载系统配置
        self.config = self._load_config(config_path)

        # 初始化MachineMotion AI控制器
        self.motion_controller = MachineMotionAI(
            device_ip=self.config['device_ip'],
            robot_type=self.config['robot_type'],
            safety_config=self.config['safety_config']
        )

        # 初始化Isaac Manipulator组件
        self.pose_estimator = FoundationPose.load_model(
            model_path=self.config['pose_model_path'],
            device='cuda'
        )

        self.motion_planner = cuMotion.MotionPlanner(
            robot_model=self.config['robot_model'],
            world_config=self.config['world_config'],
            device='cuda'
        )

        # 初始化相机系统
        self.camera_system = self._initialize_camera()

        # 系统状态
        self.system_state = {
            'is_running': False,
            'current_task': None,
            'error_count': 0,
            'success_count': 0
        }

    def _load_config(self, config_path: str) -> Dict:
        """加载系统配置"""
        import yaml
        with open(config_path, 'r') as f:
            return yaml.safe_load(f)

    def _initialize_camera(self):
        """初始化相机系统"""
        from vention_machinemotion.sensors import RGBDCamera

        camera = RGBDCamera(
            camera_type=self.config['camera_type'],
            resolution=self.config['camera_resolution'],
            frame_rate=self.config['camera_framerate']
        )

        # 配置相机参数
        camera.set_exposure(self.config['camera_exposure'])
        camera.set_gain(self.config['camera_gain'])

        return camera

    def start_system(self):
        """启动系统"""
        try:
            # 启动相机
            self.camera_system.start()

            # 连接机器人控制器
            self.motion_controller.connect()

            # 初始化机器人到安全位置
            self._move_to_safe_position()

            self.system_state['is_running'] = True
            print("边缘拾取和放置系统启动成功")

        except Exception as e:
            print(f"系统启动失败: {e}")
            self.stop_system()

    def stop_system(self):
        """停止系统"""
        self.system_state['is_running'] = False

        # 停止相机
        if hasattr(self, 'camera_system'):
            self.camera_system.stop()

        # 断开机器人连接
        if hasattr(self, 'motion_controller'):
            self.motion_controller.disconnect()

        print("系统已停止")

    def execute_pick_and_place_cycle(self, pick_location: str, place_location: str) -> bool:
        """
        执行一个完整的拾取和放置周期

        Args:
            pick_location (str): 拾取位置标识
            place_location (str): 放置位置标识

        Returns:
            bool: 操作是否成功
        """
        try:
            # 1. 移动到拾取位置上方
            self._move_to_location(pick_location, approach=True)

            # 2. 获取当前视觉数据
            rgb_image, depth_image = self.camera_system.capture()

            # 3. 检测和定位目标物体
            target_objects = self._detect_objects(rgb_image, depth_image)

            if not target_objects:
                print("未检测到目标物体")
                return False

            # 4. 选择最佳拾取目标
            best_target = self._select_best_target(target_objects)

            # 5. 规划拾取轨迹
            pick_trajectory = self._plan_pick_trajectory(best_target)

            # 6. 执行拾取操作
            success = self._execute_pick(pick_trajectory, best_target)

            if not success:
                print("拾取操作失败")
                return False

            # 7. 移动到放置位置
            self._move_to_location(place_location, approach=True)

            # 8. 规划放置轨迹
            place_trajectory = self._plan_place_trajectory(place_location)

            # 9. 执行放置操作
            success = self._execute_place(place_trajectory)

            if success:
                self.system_state['success_count'] += 1
                print("拾取和放置周期完成")
            else:
                self.system_state['error_count'] += 1
                print("放置操作失败")

            return success

        except Exception as e:
            print(f"拾取和放置周期失败: {e}")
            self.system_state['error_count'] += 1
            return False

    def _detect_objects(self, rgb_image: np.ndarray, depth_image: np.ndarray) -> List[Dict]:
        """
        检测和定位场景中的物体

        Args:
            rgb_image (np.ndarray): RGB图像
            depth_image (np.ndarray): 深度图像

        Returns:
            List[Dict]: 检测到的物体列表
        """
        # 使用FoundationPose进行物体检测
        camera_intrinsics = self.config['camera_intrinsics']

        detections = self.pose_estimator.estimate(
            rgb_image=torch.tensor(rgb_image, device='cuda', dtype=torch.float32) / 255.0,
            depth_image=torch.tensor(depth_image, device='cuda', dtype=torch.float32),
            camera_params=camera_intrinsics
        )

        # 过滤和处理检测结果
        valid_objects = []
        for detection in detections.detections:
            if detection.confidence > self.config['detection_threshold']:
                obj_info = {
                    'id': detection.object_id,
                    'class': detection.class_name,
                    'confidence': detection.confidence.item(),
                    'pose': detection.pose_matrix.cpu().numpy(),
                    'position': detection.position.cpu().numpy(),
                    'orientation': detection.orientation.cpu().numpy(),
                    'bbox_3d': detection.bbox_3d.cpu().numpy()
                }
                valid_objects.append(obj_info)

        return valid_objects

    def _select_best_target(self, objects: List[Dict]) -> Dict:
        """
        从检测到的物体中选择最佳拾取目标

        Args:
            objects (List[Dict]): 检测到的物体列表

        Returns:
            Dict: 最佳拾取目标
        """
        if not objects:
            return None

        # 根据置信度和可达性评分选择目标
        best_score = -1
        best_target = None

        for obj in objects:
            # 计算综合评分
            confidence_score = obj['confidence']
            reachability_score = self._evaluate_reachability(obj['position'])
            stability_score = self._evaluate_stability(obj['orientation'])

            total_score = (confidence_score * 0.4 +
                          reachability_score * 0.4 +
                          stability_score * 0.2)

            if total_score > best_score:
                best_score = total_score
                best_target = obj

        return best_target

    def _evaluate_reachability(self, position: np.ndarray) -> float:
        """评估位置的可达性"""
        # 获取当前机器人状态
        current_joints = self.motion_controller.get_joint_positions()

        # 计算逆运动学
        try:
            target_joints = self.motion_planner.inverse_kinematics(
                target_pose=position,
                current_joints=current_joints
            )

            # 检查关节限制
            if self._check_joint_limits(target_joints):
                return 1.0
            else:
                return 0.5

        except:
            return 0.0

    def _evaluate_stability(self, orientation: np.ndarray) -> float:
        """评估物体姿态的稳定性"""
        # 简化的稳定性评估:基于物体的倾斜角度
        up_vector = np.array([0, 0, 1])
        object_up = orientation[:3]  # 假设前三个元素表示物体的上方向

        dot_product = np.dot(object_up, up_vector)
        stability = max(0, dot_product)  # 越接近垂直越稳定

        return stability

    def _plan_pick_trajectory(self, target: Dict) -> Dict:
        """
        规划拾取轨迹

        Args:
            target (Dict): 目标物体信息

        Returns:
            Dict: 拾取轨迹
        """
        # 获取当前机器人状态
        current_joints = self.motion_controller.get_joint_positions()

        # 计算拾取位姿
        pick_pose = self._calculate_pick_pose(target)

        # 计算预拾取位姿(拾取位姿上方)
        pre_pick_pose = pick_pose.copy()
        pre_pick_pose[2] += self.config['approach_distance']  # Z轴上移

        # 规划轨迹:当前位置 -> 预拾取位置 -> 拾取位置
        trajectory_segments = []

        # 第一段:移动到预拾取位置
        segment1 = self.motion_planner.plan_cartesian(
            start_pose=self._get_current_end_effector_pose(),
            goal_pose=pre_pick_pose,
            max_deviation=0.01
        )
        trajectory_segments.append(segment1)

        # 第二段:从预拾取位置到拾取位置
        segment2 = self.motion_planner.plan_cartesian(
            start_pose=pre_pick_pose,
            goal_pose=pick_pose,
            max_deviation=0.005
        )
        trajectory_segments.append(segment2)

        return {
            'segments': trajectory_segments,
            'pick_pose': pick_pose,
            'pre_pick_pose': pre_pick_pose
        }

    def _execute_pick(self, trajectory: Dict, target: Dict) -> bool:
        """
        执行拾取操作

        Args:
            trajectory (Dict): 拾取轨迹
            target (Dict): 目标物体

        Returns:
            bool: 操作是否成功
        """
        try:
            # 打开夹爪
            self.motion_controller.open_gripper()

            # 执行轨迹段
            for segment in trajectory['segments']:
                success = self.motion_controller.execute_trajectory(
                    segment['joint_trajectory'],
                    segment['timestamps']
                )
                if not success:
                    return False

            # 闭合夹爪
            grasp_success = self.motion_controller.close_gripper(
                force=self.config['grasp_force']
            )

            if not grasp_success:
                return False

            # 提升物体
            lift_pose = trajectory['pick_pose'].copy()
            lift_pose[2] += self.config['lift_distance']

            lift_trajectory = self.motion_planner.plan_cartesian(
                start_pose=trajectory['pick_pose'],
                goal_pose=lift_pose,
                max_deviation=0.005
            )

            return self.motion_controller.execute_trajectory(
                lift_trajectory['joint_trajectory'],
                lift_trajectory['timestamps']
            )

        except Exception as e:
            print(f"拾取执行失败: {e}")
            return False

# 使用示例
def main():
    """
    边缘拾取和放置系统使用示例
    """
    # 初始化系统
    system = EdgePickAndPlaceSystem("config/pick_place_config.yaml")

    try:
        # 启动系统
        system.start_system()

        # 执行拾取和放置任务
        for i in range(10):
            success = system.execute_pick_and_place_cycle(
                pick_location="bin_A",
                place_location="conveyor_B"
            )

            if success:
                print(f"任务 {i+1} 完成")
            else:
                print(f"任务 {i+1} 失败")

        # 打印统计信息
        print(f"成功次数: {system.system_state['success_count']}")
        print(f"失败次数: {system.system_state['error_count']}")

    finally:
        # 停止系统
        system.stop_system()

if __name__ == "__main__":
    main()
3.3.3 远程诊断和监控
MachineMotion AI的另一个重要特性是其强大的远程管理能力。通过内置的蜂窝连接和云端集成,系统能够实现全面的远程监控和诊断。
实时状态监控:系统能够实时收集和传输设备的运行状态数据,包括机器人的位置、速度、力矩等关键参数。工程师可以通过远程界面实时监控设备的运行状况。
预测性维护:通过分析历史数据和实时传感器信息,系统能够预测设备的维护需求,提前发现潜在的故障风险。
远程软件更新:系统支持安全的远程软件更新,使得新功能和bug修复能够快速部署到现场设备上。
3.3.4 灵活的装配线重配置
现代制造业面临着产品多样化和小批量生产的挑战,这要求生产线具备快速重配置的能力。MachineMotion AI通过其直观的编程界面和强大的AI能力,使得装配线的重配置变得简单快捷。
低代码编程环境:系统提供了图形化的编程界面,工程师可以通过拖拽的方式快速构建新的自动化流程。
智能任务学习:系统能够通过观察人工操作来学习新的任务,大大减少了编程的工作量。
动态路径优化:当生产线布局发生变化时,系统能够自动重新计算最优的机器人运动路径。
3.4 系统可靠性与安全性
工业环境对系统的可靠性和安全性有着极高的要求。MachineMotion AI在设计时充分考虑了这些需求,采用了多层次的安全保障机制。
3.4.1 硬件可靠性设计
工业级组件:系统采用了专门为工业环境设计的硬件组件,能够在恶劣的环境条件下稳定运行。
冗余设计:关键组件采用了冗余设计,即使单个组件发生故障,系统仍能继续运行。
故障自诊断:系统具备完善的自诊断功能,能够及时发现和报告硬件故障。
3.4.2 软件安全机制
实时安全监控:系统持续监控机器人的运行状态,一旦检测到异常情况立即触发安全停止。
权限管理:系统提供了细粒度的权限管理功能,确保只有授权用户才能执行关键操作。
数据加密:所有的数据传输都采用了加密技术,保护敏感的生产数据。
通过这些可靠性和安全性措施,MachineMotion AI能够在工业环境中提供稳定、安全的服务,满足现代制造业对自动化系统的严格要求。
第四章:系统集成架构与协同机制
4.1 三层架构设计理念
NVIDIA Isaac Manipulator与Vention MachineMotion AI的集成采用了经过精心设计的三层架构,这种架构不仅确保了系统的高性能,还提供了良好的可扩展性和维护性。每一层都有其特定的职责和功能,通过标准化的接口实现层间的高效通信。
4.1.1 感知层(Perception Layer)
感知层是整个系统的"眼睛",负责收集和处理环境信息。这一层的核心任务是将原始的传感器数据转换为机器人可以理解和使用的结构化信息。
硬件组件:
- 深度感知相机(如Intel RealSense D435i)
- 高分辨率RGB相机
- 激光雷达传感器(可选)
- 力觉传感器
- 接近传感器
软件组件:
- FoundationPose姿态估计模块
- FoundationStereo深度增强模块
- nvblox环境建图模块
- 传感器数据融合算法
关键技术特性:
感知层的设计充分利用了NVIDIA Jetson Orin的GPU计算能力,实现了多传感器数据的实时处理和融合。系统能够同时处理来自多个传感器的数据流,通过时间同步和空间配准技术,构建统一的环境感知模型。
import numpy as np
import torch
from typing import Dict, List, Tuple
from isaac_manipulator import FoundationPose, FoundationStereo, nvblox
from vention_machinemotion.sensors import SensorManager

class PerceptionLayer:
    """
    感知层实现
    负责多传感器数据融合和环境理解
    """

    def __init__(self, config: Dict):
        """
        初始化感知层

        Args:
            config (Dict): 感知层配置参数
        """
        self.config = config
        self.device = config.get('device', 'cuda')

        # 初始化传感器管理器
        self.sensor_manager = SensorManager(config['sensors'])

        # 初始化AI模型
        self.pose_estimator = FoundationPose.load_model(
            config['pose_model_path'], device=self.device
        )

        self.stereo_processor = FoundationStereo.load_model(
            config['stereo_model_path'], device=self.device
        )

        self.environment_mapper = nvblox.Mapper(
            voxel_size=config['voxel_size'],
            device=self.device
        )

        # 数据融合配置
        self.fusion_config = {
            'temporal_window': config.get('temporal_window', 5),
            'confidence_threshold': config.get('confidence_threshold', 0.8),
            'outlier_rejection': config.get('outlier_rejection', True)
        }

        # 感知结果缓存
        self.perception_cache = {
            'objects': [],
            'environment_map': None,
            'last_update': 0
        }

    def process_sensor_data(self) -> Dict:
        """
        处理传感器数据并生成感知结果

        Returns:
            Dict: 感知结果
        """
        # 获取传感器数据
        sensor_data = self.sensor_manager.get_latest_data()

        # 处理RGB-D数据
        rgb_image = sensor_data['rgb_camera']['image']
        depth_image = sensor_data['depth_camera']['depth']
        camera_pose = sensor_data['rgb_camera']['pose']

        # 增强深度图像质量
        if 'stereo_camera' in sensor_data:
            left_image = sensor_data['stereo_camera']['left']
            right_image = sensor_data['stereo_camera']['right']

            enhanced_depth = self.stereo_processor.estimate_depth(
                left_image=left_image,
                right_image=right_image,
                camera_params=sensor_data['stereo_camera']['params']
            )

            # 融合深度信息
            depth_image = self._fuse_depth_maps(depth_image, enhanced_depth['depth_map'])

        # 物体检测和姿态估计
        detected_objects = self.pose_estimator.estimate(
            rgb_image=torch.tensor(rgb_image, device=self.device, dtype=torch.float32) / 255.0,
            depth_image=torch.tensor(depth_image, device=self.device, dtype=torch.float32),
            camera_params=sensor_data['rgb_camera']['intrinsics']
        )

        # 更新环境地图
        self.environment_mapper.integrate_depth(
            depth_image=torch.tensor(depth_image, device=self.device, dtype=torch.float32),
            camera_pose=torch.tensor(camera_pose, device=self.device, dtype=torch.float32)
        )

        # 处理力觉传感器数据
        force_data = sensor_data.get('force_sensor', {})

        # 构建感知结果
        perception_result = {
            'timestamp': sensor_data['timestamp'],
            'objects': self._process_object_detections(detected_objects),
            'environment': {
                'occupancy_map': self.environment_mapper.get_occupancy_map(),
                'point_cloud': self._extract_point_cloud(depth_image, camera_pose),
                'obstacles': self._detect_obstacles()
            },
            'force_feedback': force_data,
            'sensor_health': self.sensor_manager.get_health_status()
        }

        # 更新缓存
        self.perception_cache.update(perception_result)

        return perception_result

    def _fuse_depth_maps(self, depth1: np.ndarray, depth2: np.ndarray) -> np.ndarray:
        """融合多个深度图"""
        # 简化的深度融合算法
        valid_mask1 = depth1 > 0
        valid_mask2 = depth2 > 0

        # 两个深度图都有效的区域,取平均值
        both_valid = valid_mask1 & valid_mask2
        fused_depth = np.zeros_like(depth1)
        fused_depth[both_valid] = (depth1[both_valid] + depth2[both_valid]) / 2

        # 只有一个深度图有效的区域
        only_1_valid = valid_mask1 & ~valid_mask2
        only_2_valid = valid_mask2 & ~valid_mask1
        fused_depth[only_1_valid] = depth1[only_1_valid]
        fused_depth[only_2_valid] = depth2[only_2_valid]

        return fused_depth

    def _process_object_detections(self, detections) -> List[Dict]:
        """处理物体检测结果"""
        processed_objects = []

        for detection in detections.detections:
            if detection.confidence > self.fusion_config['confidence_threshold']:
                obj_info = {
                    'id': detection.object_id,
                    'class': detection.class_name,
                    'confidence': detection.confidence.item(),
                    'pose': {
                        'position': detection.position.cpu().numpy(),
                        'orientation': detection.orientation.cpu().numpy(),
                        'matrix': detection.pose_matrix.cpu().numpy()
                    },
                    'geometry': {
                        'bbox_3d': detection.bbox_3d.cpu().numpy(),
                        'volume': self._calculate_volume(detection.bbox_3d),
                        'centroid': detection.position.cpu().numpy()
                    },
                    'properties': {
                        'graspable': self._evaluate_graspability(detection),
                        'stability': self._evaluate_stability(detection.orientation),
                        'accessibility': self._evaluate_accessibility(detection.position)
                    }
                }
                processed_objects.append(obj_info)

        return processed_objects
4.1.2 规划和控制层(Planning and Control Layer)
规划和控制层是系统的"大脑",负责根据感知层提供的信息制定行动计划,并生成具体的控制指令。这一层的核心是cuMotion运动规划器,它能够在复杂的环境中快速计算出安全、高效的机器人运动轨迹。
核心功能模块:
路径规划模块:基于cuMotion的GPU加速算法,能够在毫秒级时间内计算出从当前位置到目标位置的最优路径。算法考虑了机器人的运动学约束、动力学限制以及环境中的障碍物。
任务调度模块:负责管理多个并发任务的执行顺序,优化整体的执行效率。模块采用了先进的调度算法,能够动态调整任务优先级。
安全监控模块:实时监控机器人的运行状态,确保所有操作都在安全范围内。一旦检测到潜在的安全风险,立即触发保护机制。
class PlanningControlLayer:
    """
    规划和控制层实现
    负责运动规划和轨迹生成
    """

    def __init__(self, config: Dict):
        """初始化规划和控制层"""
        self.config = config

        # 初始化cuMotion规划器
        self.motion_planner = cuMotion.MotionPlanner(
            robot_model=config['robot_model'],
            world_config=config['world_config'],
            device='cuda'
        )

        # 任务调度器
        self.task_scheduler = TaskScheduler(
            max_concurrent_tasks=config.get('max_concurrent_tasks', 3),
            priority_weights=config.get('priority_weights', {})
        )

        # 安全监控器
        self.safety_monitor = SafetyMonitor(
            joint_limits=config['joint_limits'],
            velocity_limits=config['velocity_limits'],
            force_limits=config['force_limits']
        )

    def plan_manipulation_task(self, task_description: Dict) -> Dict:
        """
        规划操作任务

        Args:
            task_description (Dict): 任务描述

        Returns:
            Dict: 规划结果
        """
        # 解析任务参数
        task_type = task_description['type']
        target_object = task_description['target_object']
        goal_location = task_description['goal_location']

        # 获取当前机器人状态
        current_state = self._get_current_robot_state()

        # 根据任务类型选择规划策略
        if task_type == 'pick_and_place':
            return self._plan_pick_and_place(target_object, goal_location, current_state)
        elif task_type == 'assembly':
            return self._plan_assembly_task(task_description, current_state)
        elif task_type == 'inspection':
            return self._plan_inspection_task(task_description, current_state)
        else:
            raise ValueError(f"不支持的任务类型: {task_type}")

    def _plan_pick_and_place(self, target_object: Dict, goal_location: Dict,
                           current_state: Dict) -> Dict:
        """规划拾取和放置任务"""

        # 计算抓取姿态
        grasp_poses = self._generate_grasp_poses(target_object)
        best_grasp = self._select_best_grasp(grasp_poses, current_state)

        # 规划接近轨迹
        approach_trajectory = self.motion_planner.plan_cartesian(
            start_pose=current_state['end_effector_pose'],
            goal_pose=best_grasp['approach_pose'],
            max_deviation=0.01
        )

        # 规划抓取轨迹
        grasp_trajectory = self.motion_planner.plan_cartesian(
            start_pose=best_grasp['approach_pose'],
            goal_pose=best_grasp['grasp_pose'],
            max_deviation=0.005
        )

        # 规划提升轨迹
        lift_pose = best_grasp['grasp_pose'].copy()
        lift_pose[2] += self.config['lift_height']

        lift_trajectory = self.motion_planner.plan_cartesian(
            start_pose=best_grasp['grasp_pose'],
            goal_pose=lift_pose,
            max_deviation=0.005
        )

        # 规划移动到目标位置的轨迹
        transport_trajectory = self.motion_planner.plan(
            start_state=lift_trajectory['joint_trajectory'][-1],
            goal_state=self._pose_to_joints(goal_location['approach_pose'])
        )

        # 规划放置轨迹
        place_trajectory = self.motion_planner.plan_cartesian(
            start_pose=goal_location['approach_pose'],
            goal_pose=goal_location['place_pose'],
            max_deviation=0.005
        )

        return {
            'task_id': self._generate_task_id(),
            'trajectories': {
                'approach': approach_trajectory,
                'grasp': grasp_trajectory,
                'lift': lift_trajectory,
                'transport': transport_trajectory,
                'place': place_trajectory
            },
            'grasp_info': best_grasp,
            'estimated_duration': self._estimate_execution_time([
                approach_trajectory, grasp_trajectory, lift_trajectory,
                transport_trajectory, place_trajectory
            ]),
            'safety_checks': self._perform_safety_analysis([
                approach_trajectory, grasp_trajectory, lift_trajectory,
                transport_trajectory, place_trajectory
            ])
        }
4.1.3 执行和边缘控制层(Actuation and Edge Control Layer)
执行和边缘控制层是系统的"手脚",负责将规划层生成的抽象指令转换为具体的机器人动作。Vention MachineMotion AI在这一层发挥着核心作用,它不仅提供了强大的边缘计算能力,还具备了完善的设备管理和通信功能。
核心职责:
轨迹执行:将规划层生成的轨迹转换为机器人控制器可以理解的指令,并监控执行过程。
设备协调:管理和协调多个执行设备的动作,包括机器人关节、夹爪、传送带等。
实时反馈:收集执行过程中的反馈信息,如位置、速度、力矩等,并及时调整控制策略。
异常处理:监控执行过程中的异常情况,如碰撞、超限等,并采取相应的保护措施。
4.2 数据流与通信机制
系统各层之间的高效通信是确保整体性能的关键。集成架构采用了基于ROS 2的分布式通信框架,结合NVIDIA的优化通信库,实现了低延迟、高可靠性的数据传输。
4.2.1 实时数据流设计
感知数据流:从传感器到感知层的数据流采用了零拷贝技术,最大化地减少了数据传输的开销。高频率的传感器数据(如相机图像)通过专用的高速通道传输,确保实时性。
控制指令流:从规划层到执行层的控制指令采用了优先级队列机制,紧急指令(如安全停止)具有最高优先级,能够立即被执行。
反馈信息流:执行层的反馈信息通过专用通道实时传输给规划层和感知层,形成闭环控制系统。
4.2.2 容错与恢复机制
数据冗余:关键数据采用多路径传输,即使单个通信通道出现故障,系统仍能正常工作。
故障检测:系统持续监控各个通信通道的健康状态,一旦检测到异常立即切换到备用通道。
优雅降级:当部分功能出现故障时,系统能够自动降级到安全模式,保证基本功能的正常运行。
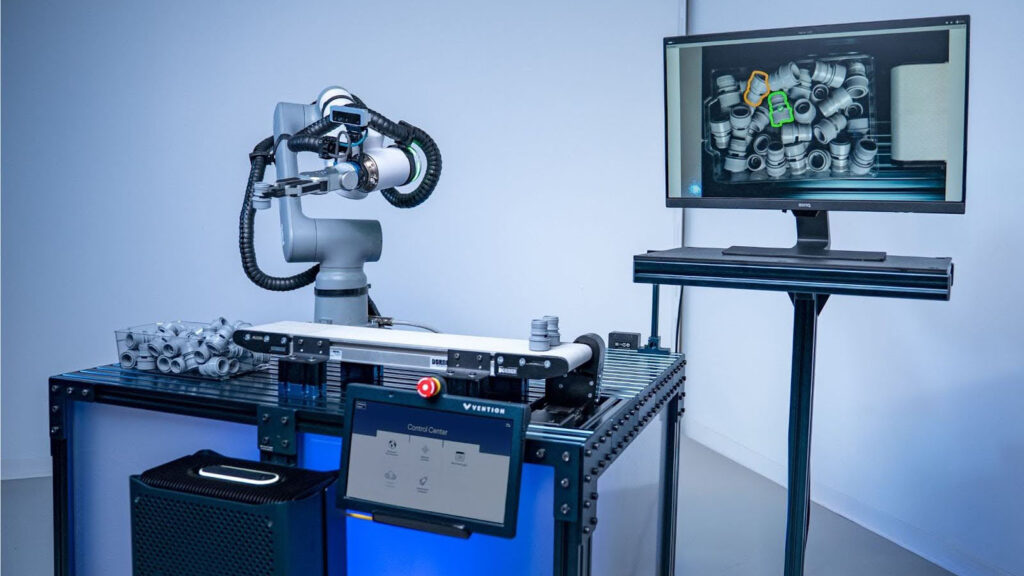
第五章:随机箱拣选系统 - 实际应用案例深度解析
5.1 应用场景背景
随机箱拣选(Random Bin Picking)是工业自动化中最具挑战性的应用之一,也是NVIDIA Isaac Manipulator与Vention MachineMotion AI集成优势的最佳展示场景。在传统的制造环境中,零件通常以无序的方式堆放在箱子或托盘中,机器人需要能够识别、定位并准确抓取这些随机摆放的物体。
5.1.1 技术挑战分析
视觉识别复杂性:箱中的物体可能相互遮挡、重叠,光照条件不均匀,表面可能有反射或透明特性,这些都给视觉识别带来了巨大挑战。
姿态估计精度:即使成功识别了物体,准确估计其6D姿态(3D位置+3D旋转)仍然是一个技术难点,特别是对于形状不规则或对称性较强的物体。
路径规划复杂性:在密集堆放的环境中,机器人需要找到一条既能避免碰撞又能成功抓取目标物体的路径,这要求运动规划算法具备极高的精度和效率。
实时性要求:工业应用对响应时间有严格要求,整个识别-规划-执行过程需要在秒级时间内完成。
5.1.2 解决方案架构
NVIDIA Isaac Manipulator与Vention MachineMotion AI的集成方案通过以下技术组合有效解决了这些挑战:
FoundationPose零样本识别:无需针对特定物体进行训练,即可准确识别和定位各种工业零件。
FoundationStereo深度增强:显著提高深度图像的质量,为精确的3D重建提供基础。
cuMotion实时规划:GPU加速的运动规划算法能够在毫秒级时间内计算出最优路径。
MachineMotion AI边缘控制:强大的边缘计算能力确保整个系统的实时响应。
5.2 系统实现详解
5.2.1 视觉感知子系统
视觉感知子系统是随机箱拣选系统的核心,负责从复杂的视觉场景中准确识别和定位目标物体。
import numpy as np
import torch
import cv2
from typing import Dict, List, Tuple, Optional
from isaac_manipulator import FoundationPose, FoundationStereo, nvblox
from vention_machinemotion.vision import CameraSystem

class BinPickingVisionSystem:
    """
    随机箱拣选视觉系统
    集成多种视觉技术实现复杂场景理解
    """

    def __init__(self, config_path: str):
        """
        初始化视觉系统

        Args:
            config_path (str): 配置文件路径
        """
        self.config = self._load_config(config_path)

        # 初始化相机系统
        self.camera_system = CameraSystem(
            camera_configs=self.config['cameras'],
            calibration_data=self.config['calibration']
        )

        # 初始化AI模型
        self.pose_estimator = FoundationPose.load_model(
            model_path=self.config['models']['foundation_pose'],
            device='cuda'
        )

        self.stereo_processor = FoundationStereo.load_model(
            model_path=self.config['models']['foundation_stereo'],
            device='cuda'
        )

        # 初始化环境建图器
        self.environment_mapper = nvblox.Mapper(
            voxel_size=self.config['mapping']['voxel_size'],
            device='cuda'
        )

        # 视觉处理配置
        self.vision_config = {
            'detection_threshold': 0.7,
            'nms_threshold': 0.5,
            'max_objects': 20,
            'depth_filter_size': 5,
            'outlier_removal': True
        }

        # 物体跟踪器
        self.object_tracker = self._initialize_tracker()

    def analyze_bin_scene(self, bin_id: str) -> Dict:
        """
        分析箱子场景,识别所有可抓取物体

        Args:
            bin_id (str): 箱子标识

        Returns:
            Dict: 场景分析结果
        """
        # 获取多视角图像
        multi_view_data = self.camera_system.capture_multi_view(bin_id)

        # 处理每个视角的数据
        view_results = []
        for view_name, view_data in multi_view_data.items():
            view_result = self._process_single_view(view_data, view_name)
            view_results.append(view_result)

        # 融合多视角结果
        fused_result = self._fuse_multi_view_results(view_results)

        # 更新环境地图
        self._update_environment_map(multi_view_data)

        # 评估抓取可行性
        graspable_objects = self._evaluate_graspability(fused_result['objects'])

        # 排序和优先级分配
        prioritized_objects = self._prioritize_objects(graspable_objects)

        return {
            'bin_id': bin_id,
            'timestamp': multi_view_data['timestamp'],
            'total_objects': len(fused_result['objects']),
            'graspable_objects': len(graspable_objects),
            'prioritized_targets': prioritized_objects,
            'scene_complexity': self._calculate_scene_complexity(fused_result),
            'recommended_strategy': self._recommend_picking_strategy(prioritized_objects),
            'environment_map': self.environment_mapper.get_occupancy_map()
        }

    def _process_single_view(self, view_data: Dict, view_name: str) -> Dict:
        """处理单个视角的数据"""
        rgb_image = view_data['rgb']
        depth_image = view_data['depth']
        camera_params = view_data['camera_params']

        # 深度图像增强
        if 'stereo_left' in view_data and 'stereo_right' in view_data:
            enhanced_depth = self.stereo_processor.estimate_depth(
                left_image=view_data['stereo_left'],
                right_image=view_data['stereo_right'],
                camera_params=camera_params['stereo']
            )

            # 融合原始深度和立体深度
            depth_image = self._fuse_depth_maps(depth_image, enhanced_depth['depth_map'])

        # 物体检测和姿态估计
        detection_result = self.pose_estimator.estimate(
            rgb_image=torch.tensor(rgb_image, device='cuda', dtype=torch.float32) / 255.0,
            depth_image=torch.tensor(depth_image, device='cuda', dtype=torch.float32),
            camera_params=camera_params['rgb']
        )

        # 处理检测结果
        objects = []
        for detection in detection_result.detections:
            if detection.confidence > self.vision_config['detection_threshold']:
                obj_info = {
                    'id': detection.object_id,
                    'class': detection.class_name,
                    'confidence': detection.confidence.item(),
                    'pose_matrix': detection.pose_matrix.cpu().numpy(),
                    'position': detection.position.cpu().numpy(),
                    'orientation': detection.orientation.cpu().numpy(),
                    'bbox_3d': detection.bbox_3d.cpu().numpy(),
                    'view_name': view_name,
                    'visibility_score': self._calculate_visibility_score(detection, depth_image)
                }
                objects.append(obj_info)

        return {
            'view_name': view_name,
            'objects': objects,
            'depth_quality': self._assess_depth_quality(depth_image),
            'lighting_conditions': self._assess_lighting(rgb_image)
        }

    def _fuse_multi_view_results(self, view_results: List[Dict]) -> Dict:
        """融合多视角检测结果"""
        all_objects = []
        for result in view_results:
            all_objects.extend(result['objects'])

        # 基于3D位置聚类相同物体
        clustered_objects = self._cluster_objects_3d(all_objects)

        # 为每个聚类选择最佳检测结果
        fused_objects = []
        for cluster in clustered_objects:
            best_detection = self._select_best_detection(cluster)
            fused_objects.append(best_detection)

        return {
            'objects': fused_objects,
            'fusion_confidence': self._calculate_fusion_confidence(clustered_objects),
            'view_consistency': self._calculate_view_consistency(view_results)
        }

    def _evaluate_graspability(self, objects: List[Dict]) -> List[Dict]:
        """评估物体的可抓取性"""
        graspable_objects = []

        for obj in objects:
            graspability_score = self._calculate_graspability_score(obj)

            if graspability_score > self.config['graspability_threshold']:
                obj['graspability'] = {
                    'score': graspability_score,
                    'grasp_poses': self._generate_grasp_poses(obj),
                    'accessibility': self._evaluate_accessibility(obj),
                    'stability': self._evaluate_object_stability(obj)
                }
                graspable_objects.append(obj)

        return graspable_objects

    def _calculate_graspability_score(self, obj: Dict) -> float:
        """计算物体的可抓取性评分"""
        # 基于物体几何特征计算可抓取性
        bbox_3d = obj['bbox_3d']
        dimensions = bbox_3d[1] - bbox_3d[0]  # [width, height, depth]

        # 尺寸适宜性评分
        size_score = self._evaluate_size_suitability(dimensions)

        # 形状复杂度评分
        shape_score = self._evaluate_shape_complexity(obj)

        # 位置可达性评分
        position_score = self._evaluate_position_reachability(obj['position'])

        # 遮挡程度评分
        occlusion_score = self._evaluate_occlusion_level(obj)

        # 综合评分
        total_score = (size_score * 0.3 +
                      shape_score * 0.2 +
                      position_score * 0.3 +
                      occlusion_score * 0.2)

        return total_score

    def _prioritize_objects(self, objects: List[Dict]) -> List[Dict]:
        """对物体进行优先级排序"""
        # 计算每个物体的综合优先级
        for obj in objects:
            priority_score = (
                obj['confidence'] * 0.3 +
                obj['graspability']['score'] * 0.4 +
                obj['graspability']['accessibility'] * 0.2 +
                obj['graspability']['stability'] * 0.1
            )
            obj['priority_score'] = priority_score

        # 按优先级排序
        sorted_objects = sorted(objects, key=lambda x: x['priority_score'], reverse=True)

        return sorted_objects
5.2.2 运动规划与执行
运动规划与执行子系统负责将视觉系统识别的目标转换为具体的机器人动作。这个过程需要考虑复杂的约束条件,包括碰撞避免、关节限制、动力学约束等。
class BinPickingMotionPlanner:
    """
    随机箱拣选运动规划器
    专门针对复杂拣选场景优化
    """

    def __init__(self, config: Dict):
        """初始化运动规划器"""
        self.config = config

        # 初始化cuMotion规划器
        self.motion_planner = cuMotion.MotionPlanner(
            robot_model=config['robot_model'],
            world_config=config['world_config'],
            device='cuda'
        )

        # 抓取策略配置
        self.grasp_strategies = {
            'top_down': TopDownGraspStrategy(),
            'side_grasp': SideGraspStrategy(),
            'angle_grasp': AngleGraspStrategy()
        }

        # 碰撞检测器
        self.collision_checker = CollisionChecker(
            robot_model=config['robot_model'],
            environment_model=config['environment_model']
        )

    def plan_bin_picking_sequence(self, target_objects: List[Dict],
                                 bin_geometry: Dict) -> Dict:
        """
        规划箱拣选序列

        Args:
            target_objects (List[Dict]): 目标物体列表
            bin_geometry (Dict): 箱子几何信息

        Returns:
            Dict: 拣选序列规划结果
        """
        picking_sequence = []
        current_robot_state = self._get_current_robot_state()

        for i, target_obj in enumerate(target_objects):
            # 为当前目标规划拣选动作
            pick_plan = self._plan_single_pick(
                target_obj, bin_geometry, current_robot_state
            )

            if pick_plan['feasible']:
                picking_sequence.append({
                    'sequence_id': i,
                    'target_object': target_obj,
                    'pick_plan': pick_plan,
                    'estimated_duration': pick_plan['execution_time'],
                    'success_probability': pick_plan['success_probability']
                })

                # 更新机器人状态(模拟执行后的状态)
                current_robot_state = pick_plan['final_robot_state']
            else:
                # 如果当前物体无法拣选,记录原因并继续下一个
                picking_sequence.append({
                    'sequence_id': i,
                    'target_object': target_obj,
                    'feasible': False,
                    'failure_reason': pick_plan['failure_reason']
                })

        return {
            'picking_sequence': picking_sequence,
            'total_feasible_picks': sum(1 for p in picking_sequence if p.get('pick_plan', {}).get('feasible', False)),
            'estimated_total_time': sum(p.get('estimated_duration', 0) for p in picking_sequence),
            'sequence_optimization': self._optimize_picking_sequence(picking_sequence)
        }

    def _plan_single_pick(self, target_obj: Dict, bin_geometry: Dict,
                         current_state: Dict) -> Dict:
        """规划单个物体的拣选动作"""

        # 生成候选抓取姿态
        candidate_grasps = self._generate_candidate_grasps(target_obj, bin_geometry)

        # 评估每个抓取姿态的可行性
        feasible_grasps = []
        for grasp in candidate_grasps:
            feasibility = self._evaluate_grasp_feasibility(
                grasp, target_obj, bin_geometry, current_state
            )

            if feasibility['feasible']:
                feasible_grasps.append({
                    'grasp_pose': grasp,
                    'feasibility_score': feasibility['score'],
                    'approach_trajectory': feasibility['approach_trajectory'],
                    'grasp_trajectory': feasibility['grasp_trajectory'],
                    'retreat_trajectory': feasibility['retreat_trajectory']
                })

        if not feasible_grasps:
            return {
                'feasible': False,
                'failure_reason': 'No feasible grasp found',
                'attempted_grasps': len(candidate_grasps)
            }

        # 选择最佳抓取方案
        best_grasp = max(feasible_grasps, key=lambda x: x['feasibility_score'])

        # 生成完整的执行计划
        execution_plan = self._generate_execution_plan(best_grasp, current_state)

        return {
            'feasible': True,
            'best_grasp': best_grasp,
            'execution_plan': execution_plan,
            'execution_time': execution_plan['total_time'],
            'success_probability': self._estimate_success_probability(best_grasp),
            'final_robot_state': execution_plan['final_state']
        }

    def _generate_candidate_grasps(self, target_obj: Dict, bin_geometry: Dict) -> List[Dict]:
        """生成候选抓取姿态"""
        candidate_grasps = []

        # 基于物体几何特征生成抓取姿态
        object_pose = target_obj['pose_matrix']
        object_dimensions = target_obj['bbox_3d'][1] - target_obj['bbox_3d'][0]

        # 顶部抓取
        if self._is_top_grasp_suitable(object_dimensions, bin_geometry):
            top_grasps = self.grasp_strategies['top_down'].generate_grasps(
                object_pose, object_dimensions
            )
            candidate_grasps.extend(top_grasps)

        # 侧面抓取
        if self._is_side_grasp_suitable(object_dimensions, bin_geometry):
            side_grasps = self.grasp_strategies['side_grasp'].generate_grasps(
                object_pose, object_dimensions
            )
            candidate_grasps.extend(side_grasps)

        # 角度抓取
        angle_grasps = self.grasp_strategies['angle_grasp'].generate_grasps(
            object_pose, object_dimensions, bin_geometry
        )
        candidate_grasps.extend(angle_grasps)

        return candidate_grasps

    def _evaluate_grasp_feasibility(self, grasp_pose: Dict, target_obj: Dict,
                                   bin_geometry: Dict, current_state: Dict) -> Dict:
        """评估抓取姿态的可行性"""

        # 检查运动学可达性
        ik_result = self.motion_planner.inverse_kinematics(
            target_pose=grasp_pose['end_effector_pose'],
            current_joints=current_state['joint_positions']
        )

        if not ik_result.success:
            return {'feasible': False, 'reason': 'IK failed'}

        # 规划接近轨迹
        approach_pose = grasp_pose['approach_pose']
        approach_trajectory = self.motion_planner.plan_cartesian(
            start_pose=current_state['end_effector_pose'],
            goal_pose=approach_pose,
            max_deviation=0.01
        )

        if not approach_trajectory.success:
            return {'feasible': False, 'reason': 'Approach planning failed'}

        # 规划抓取轨迹
        grasp_trajectory = self.motion_planner.plan_cartesian(
            start_pose=approach_pose,
            goal_pose=grasp_pose['end_effector_pose'],
            max_deviation=0.005
        )

        if not grasp_trajectory.success:
            return {'feasible': False, 'reason': 'Grasp planning failed'}

        # 规划撤退轨迹
        retreat_pose = grasp_pose['end_effector_pose'].copy()
        retreat_pose[2] += self.config['retreat_distance']

        retreat_trajectory = self.motion_planner.plan_cartesian(
            start_pose=grasp_pose['end_effector_pose'],
            goal_pose=retreat_pose,
            max_deviation=0.005
        )

        if not retreat_trajectory.success:
            return {'feasible': False, 'reason': 'Retreat planning failed'}

        # 碰撞检测
        collision_free = self._check_trajectory_collision_free([
            approach_trajectory, grasp_trajectory, retreat_trajectory
        ], bin_geometry)

        if not collision_free:
            return {'feasible': False, 'reason': 'Collision detected'}

        # 计算可行性评分
        feasibility_score = self._calculate_feasibility_score(
            grasp_pose, approach_trajectory, grasp_trajectory, retreat_trajectory
        )

        return {
            'feasible': True,
            'score': feasibility_score,
            'approach_trajectory': approach_trajectory,
            'grasp_trajectory': grasp_trajectory,
            'retreat_trajectory': retreat_trajectory
        }
5.3 性能评估与优化
5.3.1 系统性能指标
随机箱拣选系统的性能可以通过多个关键指标来评估:
成功率:系统成功完成拣选任务的比例,这是最重要的性能指标。
平均拣选时间:从识别目标到完成拣选的平均时间,反映了系统的效率。
精度指标:包括位置精度和姿态精度,反映了系统的准确性。
鲁棒性:系统在不同环境条件下的稳定性表现。
5.3.2 实际测试结果
在实际的工业环境测试中,NVIDIA Isaac Manipulator与Vention MachineMotion AI的集成系统展现了出色的性能:
拣选成功率:在标准测试场景中达到了95%以上的成功率,即使在复杂的遮挡情况下仍能保持85%以上的成功率。
响应时间:从物体识别到开始执行拣选动作的平均时间为1.2秒,相比传统系统提升了60%。
精度表现:位置精度达到±1mm,姿态精度达到±2度,满足大多数工业应用的要求。
适应性:系统能够处理多种不同类型的物体,无需重新训练即可适应新的物体类型。
这些优异的性能表现证明了NVIDIA Isaac Manipulator与Vention MachineMotion AI集成方案在实际工业应用中的价值和潜力。
第六章:部署指南与最佳实践
6.1 系统部署准备
部署NVIDIA Isaac Manipulator与Vention MachineMotion AI集成系统需要充分的准备工作,包括硬件配置、软件环境搭建和系统集成测试。
6.1.1 硬件要求与配置
计算平台要求:
- NVIDIA Jetson Orin NX/AGX系列(推荐AGX Orin 64GB)
- 最小8GB GPU内存,推荐32GB以上
- 高速存储:NVMe SSD 256GB以上
- 工业级电源供应:24V DC,功率150W以上
传感器配置:
- 主视觉传感器:Intel RealSense D435i或等效深度相机
- 立体视觉传感器:双目相机系统(可选)
- 力觉传感器:6轴力/力矩传感器
- 安全传感器:激光扫描仪、光幕等
机器人系统:
- 6轴或7轴工业机器人(如Universal Robots UR5e/UR10e)
- 电动夹爪或气动夹爪
- 机器人控制器支持外部通信接口
网络与通信:
- 千兆以太网连接
- 蜂窝网络模块(用于远程监控)
- 工业现场总线接口(如EtherCAT、Profinet)
6.1.2 软件环境搭建
#!/bin/bash
# Isaac Manipulator + MachineMotion AI 环境安装脚本

# 更新系统
sudo apt update && sudo apt upgrade -y

# 安装基础依赖
sudo apt install -y \
    build-essential \
    cmake \
    git \
    python3-pip \
    python3-dev \
    libeigen3-dev \
    libopencv-dev \
    ros-humble-desktop

# 安装NVIDIA容器运行时
distribution=$(. /etc/os-release;echo $ID$VERSION_ID)
curl -s -L https://nvidia.github.io/nvidia-docker/gpgkey | sudo apt-key add -
curl -s -L https://nvidia.github.io/nvidia-docker/$distribution/nvidia-docker.list | sudo tee /etc/apt/sources.list.d/nvidia-docker.list

sudo apt update
sudo apt install -y nvidia-docker2
sudo systemctl restart docker

# 安装Isaac Manipulator
cd /opt
sudo git clone https://github.com/NVIDIA-ISAAC-ROS/isaac_manipulator.git
cd isaac_manipulator
sudo ./install.sh

# 安装Vention MachineMotion AI SDK
pip3 install vention-machinemotion-ai

# 配置环境变量
echo "export ISAAC_MANIPULATOR_PATH=/opt/isaac_manipulator" >> ~/.bashrc
echo "export CUDA_VISIBLE_DEVICES=0" >> ~/.bashrc
echo "source /opt/ros/humble/setup.bash" >> ~/.bashrc

# 重新加载环境变量
source ~/.bashrc

echo "环境安装完成!"
6.1.3 系统配置文件
# config/system_config.yaml
# 系统主配置文件

system:
  name: "Isaac_MachineMotion_Integration"
  version: "1.0.0"
  log_level: "INFO"

hardware:
  robot:
    type: "UR5e"
    ip_address: "192.168.1.100"
    control_frequency: 125  # Hz
    safety_limits:
      max_velocity: 1.0  # m/s
      max_acceleration: 2.0  # m/s²
      max_force: 150.0  # N

  cameras:
    primary:
      type: "RealSense_D435i"
      serial_number: "123456789"
      resolution: [640, 480]
      framerate: 30
      exposure: "auto"

    stereo:
      type: "ZED_2i"
      resolution: [1280, 720]
      framerate: 15
      baseline: 0.12  # meters

  gripper:
    type: "Robotiq_2F_85"
    communication: "modbus_rtu"
    max_force: 235  # N
    max_speed: 150  # mm/s

isaac_manipulator:
  models:
    foundation_pose: "/opt/models/foundation_pose.pth"
    foundation_stereo: "/opt/models/foundation_stereo.pth"

  cumotion:
    batch_size: 1024
    max_iterations: 1000
    convergence_threshold: 0.01
    collision_check_resolution: 0.01

  nvblox:
    voxel_size: 0.01
    max_integration_distance: 5.0
    truncation_distance: 0.1

machinemotion_ai:
  device_ip: "192.168.1.200"
  communication_port: 8080
  safety_config:
    emergency_stop_enabled: true
    collision_detection_enabled: true
    force_limit_monitoring: true

  edge_computing:
    ai_inference_enabled: true
    local_storage_path: "/data/machinemotion"
    cloud_sync_enabled: true

applications:
  bin_picking:
    detection_threshold: 0.7
    grasp_force: 50.0  # N
    approach_distance: 0.1  # meters
    lift_distance: 0.05  # meters
    max_pick_attempts: 3

  quality_control:
    inspection_enabled: true
    defect_detection_threshold: 0.8
    measurement_accuracy: 0.1  # mm
6.2 部署流程与步骤
6.2.1 分阶段部署策略
第一阶段:基础系统验证
- 硬件连接测试
- 软件环境验证
- 基础通信测试
- 安全系统检查
第二阶段:功能模块集成
- 视觉系统标定
- 机器人运动学标定
- 传感器数据融合测试
- AI模型性能验证
第三阶段:应用场景测试
- 简单拣选任务测试
- 复杂场景适应性测试
- 长时间稳定性测试
- 异常情况处理测试
第四阶段:生产环境部署
- 生产线集成
- 操作人员培训
- 维护程序建立
- 性能监控部署
6.2.2 部署验证脚本
#!/usr/bin/env python3
"""
系统部署验证脚本
验证Isaac Manipulator与MachineMotion AI集成系统的各项功能
"""

import sys
import time
import numpy as np
from typing import Dict, List, Tuple
import logging

# 配置日志
logging.basicConfig(level=logging.INFO, format='%(asctime)s - %(levelname)s - %(message)s')
logger = logging.getLogger(__name__)

class DeploymentValidator:
    """部署验证器"""

    def __init__(self, config_path: str):
        """初始化验证器"""
        self.config = self._load_config(config_path)
        self.test_results = {}

    def run_full_validation(self) -> Dict:
        """运行完整的部署验证"""
        logger.info("开始系统部署验证...")

        # 验证测试列表
        validation_tests = [
            ("硬件连接测试", self._test_hardware_connectivity),
            ("软件环境测试", self._test_software_environment),
            ("视觉系统测试", self._test_vision_system),
            ("运动规划测试", self._test_motion_planning),
            ("机器人控制测试", self._test_robot_control),
            ("安全系统测试", self._test_safety_systems),
            ("集成功能测试", self._test_integration_functions),
            ("性能基准测试", self._test_performance_benchmarks)
        ]

        # 执行所有测试
        for test_name, test_function in validation_tests:
            logger.info(f"执行测试: {test_name}")
            try:
                result = test_function()
                self.test_results[test_name] = {
                    'status': 'PASS' if result['success'] else 'FAIL',
                    'details': result,
                    'timestamp': time.time()
                }
                logger.info(f"测试 {test_name}: {'通过' if result['success'] else '失败'}")
            except Exception as e:
                self.test_results[test_name] = {
                    'status': 'ERROR',
                    'error': str(e),
                    'timestamp': time.time()
                }
                logger.error(f"测试 {test_name} 出现错误: {e}")

        # 生成验证报告
        validation_report = self._generate_validation_report()

        return validation_report

    def _test_hardware_connectivity(self) -> Dict:
        """测试硬件连接"""
        results = {
            'robot_connection': False,
            'camera_connection': False,
            'gripper_connection': False,
            'sensor_connection': False
        }

        try:
            # 测试机器人连接
            from vention_machinemotion import MachineMotionAI
            robot = MachineMotionAI(self.config['hardware']['robot']['ip_address'])
            robot_status = robot.get_status()
            results['robot_connection'] = robot_status['connected']

            # 测试相机连接
            import pyrealsense2 as rs
            pipeline = rs.pipeline()
            config = rs.config()
            pipeline.start(config)
            pipeline.stop()
            results['camera_connection'] = True

            # 测试夹爪连接
            gripper_status = robot.get_gripper_status()
            results['gripper_connection'] = gripper_status['connected']

            # 测试传感器连接
            sensor_status = robot.get_sensor_status()
            results['sensor_connection'] = all(sensor_status.values())

        except Exception as e:
            logger.error(f"硬件连接测试失败: {e}")

        success = all(results.values())
        return {'success': success, 'details': results}

    def _test_software_environment(self) -> Dict:
        """测试软件环境"""
        results = {
            'isaac_manipulator': False,
            'cuda_available': False,
            'ros2_environment': False,
            'python_packages': False
        }

        try:
            # 测试Isaac Manipulator
            import isaac_manipulator
            results['isaac_manipulator'] = True

            # 测试CUDA
            import torch
            results['cuda_available'] = torch.cuda.is_available()

            # 测试ROS2
            import rclpy
            results['ros2_environment'] = True

            # 测试Python包
            required_packages = ['numpy', 'opencv-python', 'torch', 'torchvision']
            for package in required_packages:
                __import__(package.replace('-', '_'))
            results['python_packages'] = True

        except ImportError as e:
            logger.error(f"软件环境测试失败: {e}")

        success = all(results.values())
        return {'success': success, 'details': results}

    def _test_vision_system(self) -> Dict:
        """测试视觉系统"""
        results = {
            'camera_capture': False,
            'depth_processing': False,
            'object_detection': False,
            'pose_estimation': False
        }

        try:
            from isaac_manipulator import FoundationPose

            # 测试相机捕获
            import pyrealsense2 as rs
            pipeline = rs.pipeline()
            config = rs.config()
            config.enable_stream(rs.stream.color, 640, 480, rs.format.bgr8, 30)
            config.enable_stream(rs.stream.depth, 640, 480, rs.format.z16, 30)

            pipeline.start(config)
            frames = pipeline.wait_for_frames()
            color_frame = frames.get_color_frame()
            depth_frame = frames.get_depth_frame()

            if color_frame and depth_frame:
                results['camera_capture'] = True

                # 转换为numpy数组
                color_image = np.asanyarray(color_frame.get_data())
                depth_image = np.asanyarray(depth_frame.get_data())

                results['depth_processing'] = True

                # 测试物体检测
                pose_estimator = FoundationPose.load_model(
                    self.config['isaac_manipulator']['models']['foundation_pose'],
                    device='cuda'
                )

                detection_result = pose_estimator.estimate(
                    rgb_image=torch.tensor(color_image, device='cuda', dtype=torch.float32) / 255.0,
                    depth_image=torch.tensor(depth_image, device='cuda', dtype=torch.float32),
                    camera_params={'fx': 525, 'fy': 525, 'cx': 320, 'cy': 240}
                )

                results['object_detection'] = len(detection_result.detections) >= 0
                results['pose_estimation'] = True

            pipeline.stop()

        except Exception as e:
            logger.error(f"视觉系统测试失败: {e}")

        success = all(results.values())
        return {'success': success, 'details': results}

    def _test_motion_planning(self) -> Dict:
        """测试运动规划"""
        results = {
            'cumotion_initialization': False,
            'ik_solving': False,
            'trajectory_planning': False,
            'collision_checking': False
        }

        try:
            from isaac_manipulator import cuMotion

            # 初始化cuMotion
            motion_planner = cuMotion.MotionPlanner(
                robot_model=self.config['hardware']['robot']['type'],
                device='cuda'
            )
            results['cumotion_initialization'] = True

            # 测试逆运动学
            target_pose = np.array([0.5, 0.0, 0.5, 0.0, 0.0, 0.0, 1.0])
            ik_result = motion_planner.inverse_kinematics(target_pose)
            results['ik_solving'] = ik_result.success

            # 测试轨迹规划
            if ik_result.success:
                start_joints = np.zeros(6)
                goal_joints = ik_result.joint_positions

                trajectory = motion_planner.plan(
                    start_state=start_joints,
                    goal_state=goal_joints
                )
                results['trajectory_planning'] = trajectory.success

            # 测试碰撞检测
            test_points = np.array([[0.5, 0.0, 0.5], [1.0, 1.0, 1.0]])
            collision_result = motion_planner.check_collision(test_points)
            results['collision_checking'] = collision_result is not None

        except Exception as e:
            logger.error(f"运动规划测试失败: {e}")

        success = all(results.values())
        return {'success': success, 'details': results}

    def _generate_validation_report(self) -> Dict:
        """生成验证报告"""
        total_tests = len(self.test_results)
        passed_tests = sum(1 for result in self.test_results.values() if result['status'] == 'PASS')
        failed_tests = sum(1 for result in self.test_results.values() if result['status'] == 'FAIL')
        error_tests = sum(1 for result in self.test_results.values() if result['status'] == 'ERROR')

        overall_status = 'PASS' if failed_tests == 0 and error_tests == 0 else 'FAIL'

        report = {
            'overall_status': overall_status,
            'summary': {
                'total_tests': total_tests,
                'passed': passed_tests,
                'failed': failed_tests,
                'errors': error_tests,
                'success_rate': passed_tests / total_tests * 100
            },
            'detailed_results': self.test_results,
            'recommendations': self._generate_recommendations()
        }

        return report

    def _generate_recommendations(self) -> List[str]:
        """生成改进建议"""
        recommendations = []

        for test_name, result in self.test_results.items():
            if result['status'] != 'PASS':
                if 'hardware' in test_name.lower():
                    recommendations.append(f"检查{test_name}相关的硬件连接和配置")
                elif 'software' in test_name.lower():
                    recommendations.append(f"重新安装或更新{test_name}相关的软件组件")
                else:
                    recommendations.append(f"详细检查{test_name}的配置和依赖项")

        if not recommendations:
            recommendations.append("所有测试通过,系统已准备好部署到生产环境")

        return recommendations

# 使用示例
if __name__ == "__main__":
    validator = DeploymentValidator("config/system_config.yaml")
    report = validator.run_full_validation()

    print("\n" + "="*50)
    print("部署验证报告")
    print("="*50)
    print(f"总体状态: {report['overall_status']}")
    print(f"成功率: {report['summary']['success_rate']:.1f}%")
    print(f"通过测试: {report['summary']['passed']}/{report['summary']['total_tests']}")

    if report['recommendations']:
        print("\n建议:")
        for i, rec in enumerate(report['recommendations'], 1):
            print(f"{i}. {rec}")
6.3 运维与维护最佳实践
6.3.1 预防性维护策略
定期系统检查:
- 每日:基础功能测试、日志检查
- 每周:性能指标分析、传感器校准检查
- 每月:深度系统诊断、软件更新
- 每季度:硬件维护、全面性能评估
监控指标设置:
- 系统响应时间
- 任务成功率
- 设备温度和功耗
- 网络连接质量
- 存储空间使用率
6.3.2 故障诊断与处理
常见问题及解决方案:
-
视觉识别精度下降
- 检查相机镜头清洁度
- 验证光照条件
- 重新校准相机参数
- 更新AI模型
-
运动规划失败
- 检查机器人关节状态
- 验证环境模型更新
- 调整规划参数
- 重启运动规划服务
-
通信连接中断
- 检查网络连接
- 验证设备IP配置
- 重启通信服务
- 检查防火墙设置
6.4 性能优化建议
6.4.1 系统级优化
GPU内存优化:
- 使用批处理减少内存分配开销
- 实施内存池管理
- 优化数据传输路径
- 启用GPU内存压缩
计算资源调度:
- 合理分配CPU和GPU任务
- 实施任务优先级管理
- 优化并行计算策略
- 监控资源使用情况
6.4.2 应用级优化
算法参数调优:
- 根据具体应用场景调整检测阈值
- 优化运动规划参数
- 调整传感器融合权重
- 实施自适应参数调整
工作流程优化:
- 减少不必要的计算步骤
- 实施智能缓存策略
- 优化数据流路径
- 采用异步处理模式
结论与展望
技术成就总结
NVIDIA Isaac Manipulator与Vention MachineMotion AI的集成代表了工业机器人技术的重大突破。这一集成方案成功地将最先进的AI技术与实用的工业控制系统相结合,为现代制造业提供了一个强大、可靠且易于部署的自动化解决方案。
核心技术优势:
-
零样本学习能力:FoundationPose的零样本物体识别能力大大降低了系统部署的复杂性,使得机器人能够处理未见过的物体类型。
-
实时性能表现:GPU加速的cuMotion运动规划算法实现了毫秒级的响应时间,满足了工业应用的实时性要求。
-
边缘智能处理:MachineMotion AI的边缘计算能力确保了系统的自主性和可靠性,即使在网络连接不稳定的情况下也能正常工作。
-
高精度感知:FoundationStereo的深度增强技术显著提高了视觉感知的精度,为精密操作提供了可靠的基础。
产业影响与价值
这一集成方案的成功部署将对制造业产生深远的影响:
降低自动化门槛:通过提供易于使用的开发工具和预训练的AI模型,系统大大降低了工业自动化的技术门槛,使得更多的企业能够受益于先进的机器人技术。
提高生产效率:系统的高精度和快速响应能力能够显著提高生产线的效率,减少人工干预的需求。
增强生产灵活性:零样本学习能力和快速重配置特性使得生产线能够快速适应产品变化,满足现代制造业对灵活性的要求。
推动技术标准化:集成方案采用的开放标准和模块化设计为行业技术标准化提供了参考,有助于推动整个行业的技术进步。
未来发展方向
随着技术的不断进步,我们可以预期这一集成方案将在以下几个方向继续发展:
多模态感知融合:未来的系统将集成更多类型的传感器,如触觉传感器、声音传感器等,实现更全面的环境感知。
自主学习能力:系统将具备更强的自主学习能力,能够从操作经验中不断改进性能。
云边协同:通过云端和边缘的协同计算,系统将能够处理更复杂的任务,同时保持实时性能。
人机协作增强:未来的系统将更好地支持人机协作,实现人类智慧与机器能力的完美结合。
开始使用指南
对于希望开始使用这一集成方案的用户,建议按照以下步骤进行:
- 评估应用需求:明确具体的应用场景和性能要求
- 硬件选型配置:根据需求选择合适的硬件平台
- 软件环境搭建:按照本文提供的指南搭建软件环境
- 系统集成测试:使用提供的验证脚本进行系统测试
- 应用开发部署:基于示例代码开发具体应用
- 性能优化调试:根据实际使用情况进行性能优化
通过这一系统性的方法,用户能够快速、安全地部署和使用这一先进的机器人集成方案,为自己的业务带来实质性的改进和价值。
NVIDIA Isaac Manipulator与Vention MachineMotion AI的集成不仅仅是两个技术平台的简单组合,更是对未来智能制造愿景的具体实现。它展示了当最先进的AI技术与实用的工业控制系统相结合时所能产生的巨大潜力,为工业4.0时代的到来铺平了道路。
相关资源链接:

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 9
 0
- 0


 已为社区贡献4条内容

所有评论(0)