解锁Hudi+Spark:大数据处理的超强组合拳
一、Hudi 与 Spark 简介
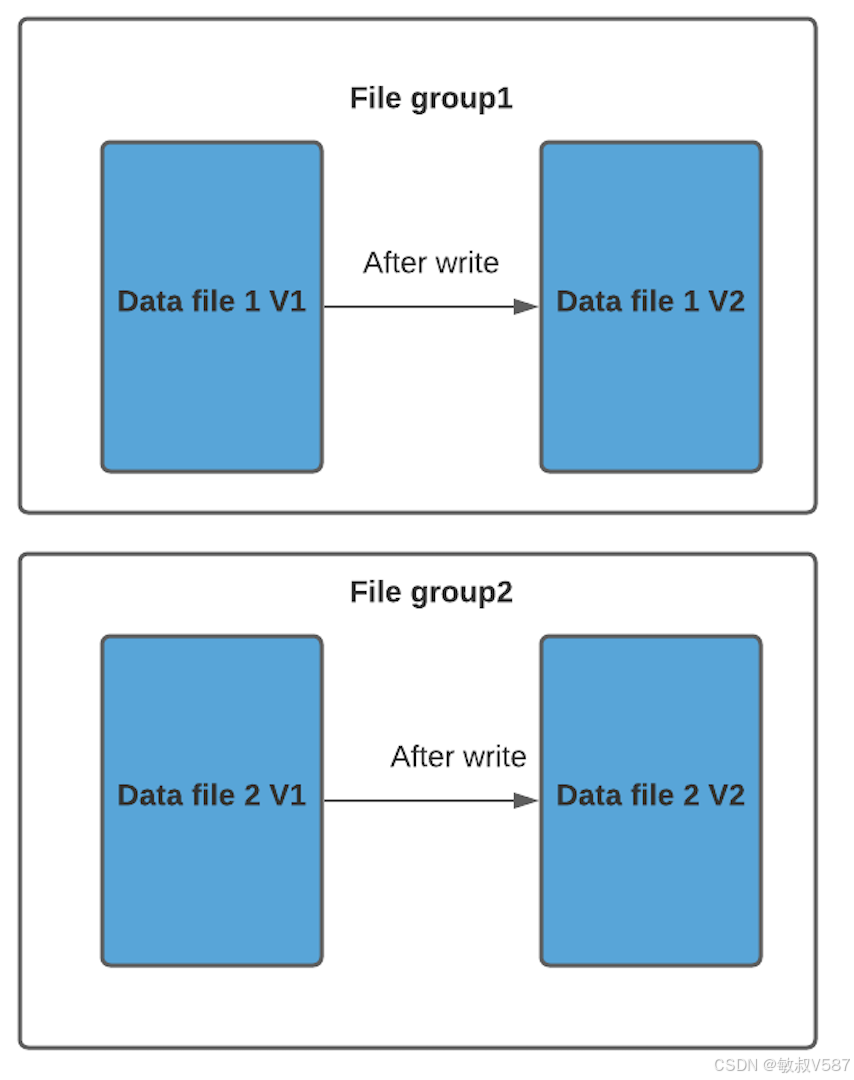
在大数据领域,数据的存储和处理是两大核心任务。Hudi(Hadoop Upserts Delete and Incremental)作为一种新兴的数据湖存储框架,正逐渐崭露头角,它为大规模数据集提供了高效的增量数据处理和实时数据更新能力。而 Spark,作为大数据处理领域的明星框架,以其快速的内存计算、丰富的 API 和强大的分布式处理能力,在批处理、流处理以及机器学习等多个场景中广泛应用。
Hudi 专注于解决数据湖场景下数据的高效管理和更新难题,通过支持 ACID 事务、数据的插入 / 更新 / 删除操作以及增量数据处理,让数据湖能够像数据库一样灵活地处理实时数据。它提供了数据版本管理、时间旅行查询等功能,方便用户对数据的历史版本进行追溯和分析。
Spark 则是一个通用的大数据处理引擎,它的核心数据结构 RDD(Resilient Distributed Datasets)以及后续发展的 DataFrame 和 DataSet,为开发者提供了便捷、高效的数据处理方式。Spark 可以在内存中快速处理大规模数据,大大缩短了数据处理的时间,同时其丰富的生态系统,如 Spark SQL 用于结构化数据处理、Spark Streaming 用于流处理、MLlib 用于机器学习等,使得它能够满足各种复杂的大数据应用场景。
当 Hudi 与 Spark 相结合,就如同强强联手,发挥出更强大的威力。Spark 为 Hudi 提供了强大的计算能力和丰富的生态支持,使得 Hudi 能够利用 Spark 的分布式计算框架高效地处理和分析大规模数据。而 Hudi 则为 Spark 提供了更适合数据湖场景的数据存储和管理方式,让 Spark 在处理实时数据更新和增量数据处理时更加得心应手。两者的结合,为大数据分析和处理带来了更高效、更灵活的解决方案 ,在数据湖构建、实时数据分析、ETL 等诸多场景中都有着广泛的应用前景。
二、Hudi 与 Spark 的融合优势
(一)高性能数据处理
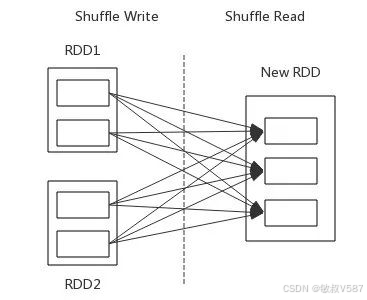
Spark 以其卓越的分布式计算能力而闻名,它能够将大规模数据集分割成多个分区,分布在集群的不同节点上并行处理。当 Hudi 与 Spark 结合时,Hudi 的数据存储格式充分利用了 Spark 的这种分布式计算优势。在写入数据时,Spark 可以高效地将数据按照 Hudi 的格式组织并写入存储系统,例如 HDFS 或 S3。由于 Spark 的并行处理能力,即使是海量数据的写入也能在较短时间内完成。
以一个电商平台的订单数据处理为例,每天可能会产生数百万条订单记录。使用 Hudi 结合 Spark,Spark 可以将这些订单数据按照不同的分区规则(如按日期分区)进行并行写入 Hudi 表中。在读取数据时,Spark 同样可以并行读取 Hudi 表中的数据。如果需要查询某个时间段内的订单数据,Spark 会根据 Hudi 表的元数据信息,快速定位到相应的分区和文件,只读取所需的数据,避免了全表扫描,大大提高了数据读取的效率。通过这种方式,Hudi 与 Spark 的结合能够轻松应对大规模数据集的高效读写,满足企业对大数据处理性能的高要求。
(二)实时数据处理支持
Hudi 的增量处理功能为实时数据处理提供了强大的支持,而 Spark 的流处理能力则使得这种支持得以充分发挥。Hudi 允许将新数据以增量的方式追加到现有数据集中,并且能够高效地处理数据的更新和删除操作。在实时数据处理场景中,数据源源不断地产生,例如物联网设备产生的传感器数据、金融交易数据等。
Spark Streaming 可以实时接收这些数据,并将其以增量的方式写入 Hudi 表中。由于 Hudi 支持 ACID 事务,确保了数据在写入过程中的一致性和完整性。当有新的传感器数据到达时,Spark Streaming 会将数据按照 Hudi 的写入规范,追加到对应的 Hudi 表分区中。如果数据中包含对已有记录的更新或删除操作,Hudi 也能准确地进行处理。这使得企业能够实时获取最新的数据,并基于这些数据进行实时分析和决策,例如实时监控物联网设备的状态、及时发现金融交易中的异常等。
(三)数据一致性保障
在许多大数据应用场景中,数据一致性至关重要,例如金融、电商等领域。Hudi 通过提供强大的事务支持来确保数据的一致性。当使用 Spark 对 Hudi 表进行数据操作时,无论是插入、更新还是删除操作,Hudi 都会将这些操作作为一个事务来处理。在一个事务中,所有的操作要么全部成功提交,要么全部回滚,保证了数据的原子性。
Hudi 通过元数据管理和时间线服务来维护数据的一致性。时间线记录了所有数据操作的顺序和状态,使得 Hudi 能够确保每个读写操作都基于一致的数据视图。在金融交易系统中,可能会同时发生多个交易操作,如账户余额的更新、交易记录的插入等。使用 Hudi 结合 Spark,这些操作可以被封装在一个事务中,确保所有操作的一致性。即使在并发操作的情况下,Hudi 的多版本并发控制(MVCC)机制也能保证各个操作之间的隔离性,避免数据冲突,从而满足对数据一致性要求极高的应用场景。
(四)灵活的数据查询与分析
借助 Spark SQL,用户可以直接对 Hudi 表中的数据进行查询和分析,无需进行复杂的数据转换和迁移。Hudi 表可以像普通的关系型数据库表一样,在 Spark SQL 中进行各种复杂的查询操作,如聚合查询、连接查询等。如果 Hudi 表存储了用户的行为数据,包括浏览记录、购买记录等,通过 Spark SQL 可以轻松地进行查询分析,例如统计某个时间段内用户的购买频率、分析不同地区用户的浏览偏好等。
Spark SQL 还支持与其他 Spark 组件的集成,如 Spark Streaming、MLlib 等。这意味着可以在实时数据处理和机器学习等场景中,灵活地使用 Hudi 表中的数据。通过 Spark Streaming 实时获取新的用户行为数据并写入 Hudi 表,然后利用 Spark SQL 和 MLlib 对这些数据进行实时分析和建模,为用户提供个性化的推荐服务。这种灵活性使得 Hudi 结合 Spark 能够满足企业在不同业务场景下对数据查询和分析的多样化需求。
三、Hudi 与 Spark 结合实战
(一)环境准备
在开始使用 Hudi 与 Spark 结合进行开发之前,需要确保以下软件环境已正确安装和配置:
Java:Hudi 和 Spark 都基于 Java 运行,建议安装 Java 8 或更高版本。安装完成后,配置JAVA_HOME环境变量,例如在 Linux 系统中,编辑~/.bashrc文件,添加export JAVA_HOME=/path/to/java(/path/to/java为 Java 的安装目录),然后执行source ~/.bashrc使配置生效。
Spark:下载并解压 Spark 安装包,可从 Apache Spark 官方网站获取。解压后,配置SPARK_HOME环境变量,同样在~/.bashrc中添加export SPARK_HOME=/path/to/spark,并将$SPARK_HOME/bin添加到PATH环境变量中,即export PATH=$PATH:$SPARK_HOME/bin。同时,根据实际需求配置 Spark 的相关参数,如spark-defaults.conf文件中的内存、并行度等参数。
Hudi:可以通过 Maven 依赖引入 Hudi,也可以下载预编译的 Hudi 包。如果选择下载预编译包,解压后将其相关依赖添加到项目的类路径中。在使用 Hudi 时,还需要根据存储后端(如 HDFS、S3 等)进行相应的配置,例如如果使用 HDFS,需要确保 Hadoop 环境已正确配置且 HDFS 服务正常运行 。
(二)引入依赖
以 Maven 项目为例,在pom.xml文件中添加 Hudi 和 Spark 相关的依赖。首先添加 Hudi 依赖,根据使用的 Spark 版本选择对应的 Hudi 版本,例如:
\<dependency>

<groupId>org.apache.hudi\</groupId>

<artifactId>hudi-spark3.2-bundle\_2.12\</artifactId>

<version>0.12.0\</version>

\</dependency>
同时,添加 Spark 的核心依赖和 SQL 依赖,以确保能够使用 Spark 的基本功能和 SQL 查询:
\<dependency>

<groupId>org.apache.spark\</groupId>

<artifactId>spark-core\_2.12\</artifactId>

<version>3.2.1\</version>

\</dependency>

\<dependency>

<groupId>org.apache.spark\</groupId>

<artifactId>spark-sql\_2.12\</artifactId>

<version>3.2.1\</version>

\</dependency>
添加完依赖后,执行mvn clean install命令,Maven 会自动下载并管理这些依赖。
(三)创建 Hudi 表
使用 Spark SQL 的CREATE TABLE语句创建 Hudi 表,以下是一个创建 Hudi 表的示例代码:
import org.apache.spark.sql.SparkSession

val spark = SparkSession.builder()

.appName("CreateHudiTable")

.master("local\[\*]")

.getOrCreate()

val tableName = "hudi\_trips\_cow"

val basePath = "hdfs://localhost:9000/tmp/hudi\_trips\_cow"

spark.sql(s"""

 CREATE TABLE \$tableName (

   uuid STRING,

   rider STRING,

   driver STRING,

   begin\_lat DOUBLE,

   begin\_lon DOUBLE,

   end\_lat DOUBLE,

   end\_lon DOUBLE,

   fare DOUBLE,

   partitionpath STRING,

   ts BIGINT

 )

 USING hudi

 OPTIONS (

   type = 'cow',

   primaryKey = 'uuid',

   preCombineField = 'ts'

 )

 PARTITIONED BY (partitionpath)

 LOCATION '\$basePath'

""")
在上述代码中:
USING hudi指定使用 Hudi 作为存储格式。
type = 'cow'表示创建的是 Copy - On - Write 类型的表,这种表类型在写入时会直接重写数据文件,适合对数据一致性要求较高且写入频率较低的场景。
primaryKey = 'uuid'指定uuid字段作为表的主键,用于唯一标识每条记录,确保数据的唯一性和更新、删除操作的准确性。
preCombineField = 'ts'指定ts字段作为预合并字段,在写入数据时,如果有相同主键的记录,会根据该字段的值进行合并,通常选择时间戳字段,以确保最新的数据被保留。
PARTITIONED BY (partitionpath)表示按partitionpath字段进行分区,提高数据查询和处理的效率。
(四)写入数据
将数据写入 Hudi 表,可以使用 Spark DataFrame 的write方法,示例代码如下:
import org.apache.hudi.QuickstartUtils.\_

import scala.collection.JavaConversions.\_

import org.apache.spark.sql.SaveMode.\_

val dataGen = new DataGenerator

val inserts = convertToStringList(dataGen.generateInserts(10))

val df = spark.read.json(spark.sparkContext.parallelize(inserts, 2))

df.write

.format("hudi")

.options(getQuickstartWriteConfigs)

.option("hoodie.datasource.write.recordkey.field", "uuid")

.option("hoodie.datasource.write.precombine.field", "ts")

.option("hoodie.datasource.write.partitionpath.field", "partitionpath")

.option("hoodie.datasource.write.table.name", tableName)

.mode(Overwrite)

.save(basePath)
在这段代码中:
df.write.format("hudi")指定数据写入的格式为 Hudi。
options(getQuickstartWriteConfigs)设置一些通用的写入配置,如 Shuffle 时的分区数目等。
hoodie.datasource.write.recordkey.field指定记录键字段,即主键,这里为uuid。
hoodie.datasource.write.precombine.field指定预合并字段,这里为ts。
hoodie.datasource.write.partitionpath.field指定分区路径字段,这里为partitionpath。
hoodie.datasource.write.table.name指定要写入的 Hudi 表名。
mode(Overwrite)表示如果表已存在,覆盖原有数据。如果希望追加数据,可以使用Append模式 。
(五)查询数据
快照查询
快照查询用于获取表的最新状态,示例代码如下:
val tripsSnapshotDF = spark.read

.format("hudi")

.load(basePath)

tripsSnapshotDF.createOrReplaceTempView("hudi\_trips\_snapshot")

spark.sql("SELECT fare, begin\_lon, begin\_lat, uuid, ts FROM hudi\_trips\_snapshot WHERE fare > 20.0").show()
在上述代码中,spark.read.format("hudi").load(basePath)读取 Hudi 表的数据,createOrReplaceTempView将 DataFrame 注册为临时视图,方便后续使用 SQL 语句进行查询。快照查询会返回表的最新数据,包括所有已提交的更新和插入操作。
增量查询
增量查询用于获取自某个时间点或提交之后的新增数据,示例代码如下:
val beginTime = "2023-10-01T00:00:00.000Z"

val endTime = "2023-10-02T00:00:00.000Z"

val incrementalDF = spark.read

.format("hudi")

.option("hoodie.datasource.query.type", "incremental")

.option("hoodie.datasource.read.begin.instanttime", beginTime)

.option("hoodie.datasource.read.end.instanttime", endTime)

.load(basePath)

incrementalDF.createOrReplaceTempView("hudi\_trips\_incremental")

spark.sql("SELECT \* FROM hudi\_trips\_incremental").show()
这里,hoodie.datasource.query.type设置为incremental表示进行增量查询。hoodie.datasource.read.begin.instanttime和hoodie.datasource.read.end.instanttime分别指定了查询的起始时间和结束时间,只有在这个时间范围内提交的数据会被查询出来。
(六)更新与删除数据
更新数据
更新 Hudi 表中的数据,可以使用upsert操作,示例代码如下:
val dataGen = new DataGenerator

val updates = convertToStringList(dataGen.generateUpdates(10))

val updateDF = spark.read.json(spark.sparkContext.parallelize(updates, 2))

updateDF.write

.format("hudi")

.options(getQuickstartWriteConfigs)

.option("hoodie.datasource.write.recordkey.field", "uuid")

.option("hoodie.datasource.write.precombine.field", "ts")

.option("hoodie.datasource.write.partitionpath.field", "partitionpath")

.option("hoodie.datasource.write.table.name", tableName)

.option("hoodie.datasource.write.operation", "upsert")

.mode(Append)

.save(basePath)
在这段代码中,hoodie.datasource.write.operation设置为upsert,表示执行插入或更新操作。如果记录的主键已存在,则更新该记录;如果不存在,则插入新记录。
删除数据
删除 Hudi 表中的数据,示例代码如下:
val deleteData = spark.range(0, 2).selectExpr("id as uuid")

deleteData.write

.format("hudi")

.options(getQuickstartWriteConfigs)

.option("hoodie.datasource.write.recordkey.field", "uuid")

.option("hoodie.datasource.write.partitionpath.field", "partitionpath")

.option("hoodie.datasource.write.table.name", tableName)

.option("hoodie.datasource.write.operation", "delete")

.mode(Append)

.save(basePath)
这里,hoodie.datasource.write.operation设置为delete,表示执行删除操作。deleteData中包含要删除记录的主键,Hudi 会根据这些主键删除表中对应的记录 。通过以上步骤,我们可以在 Spark 环境中使用 Hudi 进行数据的创建、写入、查询、更新和删除操作,充分发挥 Hudi 与 Spark 结合的强大功能。
四、应用案例分析
(一)电商订单数据分析
某大型电商平台每天会产生海量的订单数据,这些数据对于分析用户购买行为、优化商品推荐以及库存管理等方面具有重要价值。在过去,该电商平台使用传统的 Hive 表存储订单数据,由于 Hive 表在数据更新和实时处理方面存在一定的局限性,导致数据的时效性较差,无法满足快速变化的业务需求。
为了解决这一问题,电商平台引入了 Hudi 结合 Spark 的技术方案。首先,使用 Spark Streaming 实时接收来自各个业务系统的订单数据。这些数据包括订单的基本信息,如订单编号、用户 ID、商品 ID、购买数量、价格等,以及订单的状态信息,如已支付、已发货、已完成等。然后,将这些实时数据以增量的方式写入 Hudi 表中。
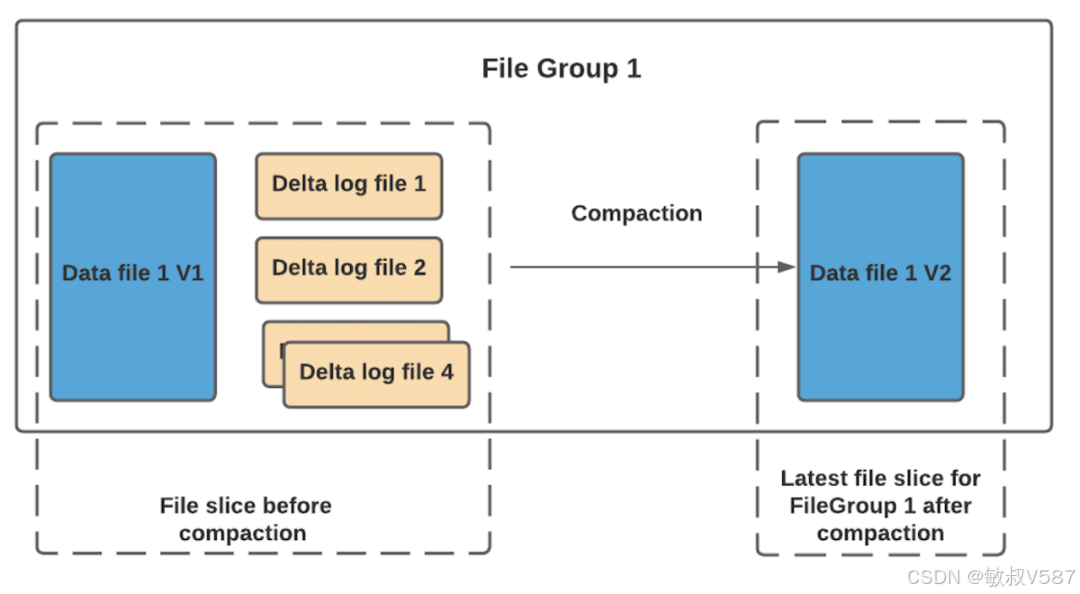
在写入过程中,利用 Hudi 的 Copy - On - Write(COW)或 Merge - On - Read(MOR)表类型来保证数据的一致性和高效存储。如果选择 COW 表类型,每次写入操作会直接重写数据文件,虽然写入性能相对较低,但能保证数据的强一致性,适合对数据准确性要求极高的场景,如财务相关的订单数据统计。若选择 MOR 表类型,新数据会先写入日志文件,在查询时再与原数据文件合并,这种方式写入性能较高,适合数据更新频繁且对查询实时性要求不是特别高的场景,如一般的订单信息查询。
通过 Hudi 的分区和索引机制,能够快速定位和查询订单数据。按照订单日期进行分区,这样在查询某个时间段内的订单数据时,可以直接定位到相应的分区,大大减少了数据扫描范围。同时,利用 Hudi 的索引功能,如 Bloom Filter 索引或 Bucket 索引,能够快速查找特定订单编号或用户 ID 的订单记录,提高查询效率。
借助 Spark 强大的计算能力,对 Hudi 表中的订单数据进行实时分析。可以实时统计不同地区、不同时间段的订单数量和金额,分析用户的购买偏好和购买频率,为商品推荐系统提供实时的数据支持。通过实时分析订单数据,发现某地区在某个时间段内对某类商品的购买需求突然增加,电商平台可以及时调整该地区的库存策略,增加该类商品的库存,以满足用户需求,避免缺货情况的发生。
(二)金融交易数据处理
在金融领域,交易数据的处理要求极高,不仅需要保证数据的实时性,还需要确保数据的一致性和可追溯性,以满足监管要求和风险控制的需要。某银行每天会处理大量的金融交易数据,包括存款、取款、转账、贷款审批等业务产生的数据。
银行采用 Hudi 结合 Spark 的架构来处理这些交易数据。在数据采集阶段,使用 Kafka 作为消息队列,实时接收来自各个业务系统的交易数据。Spark Streaming 从 Kafka 中读取数据,并进行初步的清洗和转换,确保数据的格式和质量符合要求。
将处理后的数据写入 Hudi 表中,Hudi 的 ACID 事务支持确保了数据在写入过程中的一致性。在进行一笔转账交易时,涉及到转出账户和转入账户的余额更新,这两个操作会被封装在一个事务中。如果其中任何一个操作失败,整个事务会回滚,保证了数据的完整性和一致性,避免出现转账成功但账户余额未正确更新的情况。
对于数据的可追溯性,Hudi 的时间旅行查询功能发挥了重要作用。银行可以根据时间戳或事务 ID 查询到任何一笔交易的历史记录,包括交易的原始数据、修改记录以及最终状态。这在处理审计和风险排查时非常关键。监管部门要求银行提供某笔贷款审批的详细历史记录,通过 Hudi 的时间旅行查询,银行可以快速准确地获取到该笔贷款从申请提交、审核过程到最终审批结果的所有相关数据,满足监管要求。
利用 Spark 的机器学习库 MLlib,结合 Hudi 表中的交易数据,进行风险评估和欺诈检测。通过对历史交易数据的分析,建立风险评估模型,实时对新的交易进行风险评估。如果发现某笔交易的行为模式与历史上的欺诈交易相似,系统会及时发出警报,提醒银行工作人员进行进一步的核实和处理,有效降低了金融风险。
五、总结与展望
Hudi 与 Spark 的结合为大数据处理带来了显著的优势。通过融合 Hudi 强大的数据管理能力和 Spark 卓越的计算性能,在高性能数据处理、实时数据处理支持、数据一致性保障以及灵活的数据查询与分析等方面都展现出了巨大的潜力。从实际应用案例来看,无论是电商订单数据分析,还是金融交易数据处理,Hudi 结合 Spark 的技术方案都能够有效地解决复杂业务场景下的数据处理难题,为企业的决策提供了有力的数据支持。
展望未来,随着大数据技术的不断发展,Hudi 与 Spark 的生态系统也将持续演进。一方面,Hudi 有望在存储格式优化、事务处理效率提升以及与更多存储系统的兼容性等方面取得进一步突破,从而更好地满足企业对大规模数据存储和管理的需求。另一方面,Spark 也将不断提升其计算性能和易用性,拓展在人工智能、机器学习等领域的应用,为 Hudi 提供更强大的计算引擎。
在应用场景方面,Hudi 结合 Spark 可能会在更多领域得到广泛应用。在医疗保健领域,用于处理和分析大量的患者医疗记录,实现疾病预测和健康管理;在智能交通领域,对实时交通数据进行分析,优化交通流量调度等。相信在未来,Hudi 与 Spark 的结合将为大数据领域带来更多的创新和突破,助力企业在数字化转型的道路上不断前行。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 7
 0
- 0


 已为社区贡献9条内容

所有评论(0)