【斯坦福cs324w】中译版 大模型学习笔记五 LLM的模型架构
文章目录
从两个主题来讨论llm的构建
分词:如何将⼀个字符串拆分成多个标记(token)组成的序列
模型架构:Transformer架构
分词
分词实现了将自然语言转化为一个token序列,即自然语言和机器语言的对齐
对齐
这里指的是自然语言中的一个token与一个向量之间的对应建立
基于空格的分词
text.split(' ')
只能针对英文这种按照空格分隔单词,且每个分词后的单词有语义关系的文本
不能适用的文本
中文句子中的单词之间没有空格
德语,存在着长的复合词(例如Abwasserbehandlungsanlange)
在英语中,也有连字符词(例如father-in-law)和缩略词(例如don’t)
好的分词应该做到什么?
标记不能过多,否则序列难以建模
标记不能过少,否则单词之间难以共享参数
每个标记应为一个在语言或统计上有意义的单位
Byte pair encoding
用于数据压缩领域的字节对编码(BPE)算法可以生成分词器
分词器的训练过程
输入语料库用于分词器训练
初始化词汇表
V
V
V为字符的集合
找到
V
V
V中共同出现次数最多的元素对
x
,
x
′
x,x'
x,x′
用一个新的符号
x
x
′
xx'
xx′代替所有
x
,
x
′
x, x'
x,x′的出现
举个例子
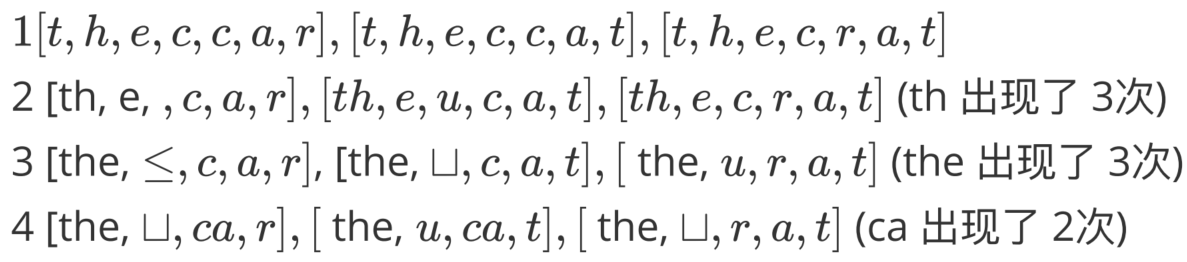
Unicode的问题
Unicode字符非常多(共144,697个字符),训练数据中出现的字符仅为一个很小的集合。
这会导致根据字符的encoding结果很稀疏
解决办法
对字节运行BPE算法
作用
减少数据中出现的低频词汇从而减小数据的稀疏性
将不同语言中的词汇统一表示为字节序列,对多语言数据友好
Unigram model(SentencePiece)
分词思路
定义一个用于捕捉分词特征的目标函数,基于这个目标函数建立对应的分词模型
Unigram model
SentencePiece工具支持的分词方法,并被用来训练T5和Gopher模型
分词介绍:给定一个序列
x
1
:
L
x_{1:L}
x1:L,分词器
T
T
T是
p
(
x
1
:
L
)
=
∏
(
i
,
j
)
∈
T
p
(
x
i
:
j
)
p\left(x_{1: L}\right)=\prod_{(i, j) \in T} p\left(x_{i: j}\right)
p(x1:L)=∏(i,j)∈Tp(xi:j)的一个集合
举个例子
训练数据(字符串):
a
b
a
b
c
ababc
ababc
分词结果
T
T
T=(1,2),(3,4),(5,5) (其中
V
V
V={𝖺𝖻,𝖼})
似然值:
p
(
x
1
:
L
)
=
2
/
3
⋅
1
/
3
=
4
/
9
p(x_{1:L})=2/3⋅1/3=4/9
p(x1:L)=2/3⋅1/3=4/9
似然值表示训练数据的似然度,即将训练数据分词为所给的分词结果
T
T
T的概率。用于评估分词结果的质量,较高的似然值对应的是一个更为合理的分词结果。
概率计算:词汇表中每个词汇在训练数据中的出现次数
在这个例子中,
a
b
ab
ab 在训练数据中出现了两次,
c
c
c出现了一次。因此,
p
(
a
b
)
=
2
/
3
,
p
(
c
)
=
1
/
3
p(ab)=2/3, p(c)=1/3
p(ab)=2/3,p(c)=1/3,因而似然值为4/9
算法流程
- 从一个“相当大”的种子词汇表 V V V开始。
- 重复以下步骤:
- 给定 V V V,使用EM算法优化 p ( x ) p(x) p(x)和 T T T。
- 计算每个词汇 x ∈ V x \in V x∈V 的 l o s s ( x ) loss(x) loss(x),即若将 x x x从 V V V中移除, p ( V ) p(V) p(V)会减小多少
- 按照
l
o
s
s
loss
loss排序,保留
V
V
V中排名靠前的80%的词汇
算法思想:优化原有的大词汇表,剔除 V V V中对似然度贡献小的词汇
EM算法:通过迭代求得含有隐变量的模型中参数的最大似然估计
算法包含两个步骤,E步骤根据参数的当前估计计算对数似然函数的期望值;M 步骤对参数进行更新,使 E 步中计算的对数似然函数的期望值最大化。不断迭代,直到参数结果收敛
模型架构
上下文向量表征(Contextual Embedding):将标记序列映射为对应的上下文的向量表征
举个例子
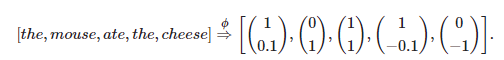
形式化定义:嵌入函数 每个token映射为一个d维向量
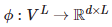
即将标记序列 x 1 : L = [ x 1 , . . . , x L ] x_{1:L} = [x_1, ..., x_L] x1:L=[x1,...,xL]映射为 ϕ ( x 1 : L ) ϕ(x_{1:L}) ϕ(x1:L)
语言模型分类
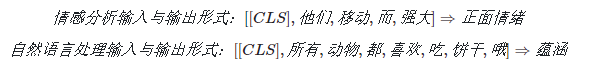
编码器(Encoder-Only)架构
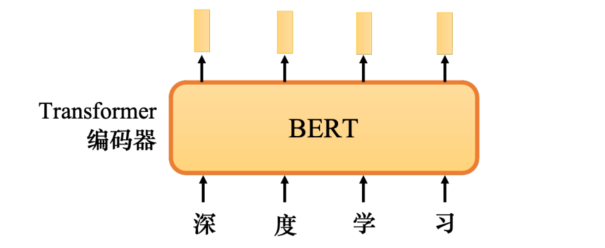
举例
BERT、RoBERTa等模型
特点
生成上下文向量表征,不直接用于文本生成 即完成嵌入函数的工作
自监督式学习,在预训练时使用mask掩码让BERT模型做填空题进行训练
优点
对于每个
x
i
x_i
xi 上下文向量表征可以双向依赖
x
1
:
i
−
1
x_{1:i-1}
x1:i−1和
x
i
+
1
:
L
x_{i+1:L}
xi+1:L
缺点
需要大量训练数据
应用
分类任务或者是自然语言理解任务,如情感分类、自然语言推理
解码器(Decoder-Only)架构
举例
GPT系列模型 属于自回归语言模型,即通过上文预测下一个词语的模型
特点
生成上下文向量表征和下一个标记
x
i
+
1
x_{i+1}
xi+1的概率分布
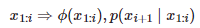
在自监督学习时模型做的任务是根据当前已有tokens预测接下来会出现的token
使用最大似然来学习词语之间的概率分布
优点
能够完成文本生成
训练目标简单,使用最大似然
缺点
对于每个标记
x
i
x_i
xi,上下文向量表征只能依赖左侧上下文
(
x
1
:
i
−
1
)
(x_{1:i-1})
(x1:i−1)
应用
自动补全任务
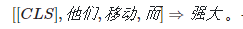
编码-解码端(Encoder-Decoder)架构
举例
Transformer、BART、T5
特点
使用双向上下文表征,并完成文本生成
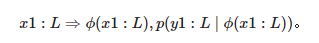
缺点
需要更多训练数据
应用
表格到文本生成任务

语言模型理论
利用定义的构建模块库完成Transformer模型的构建
基础架构
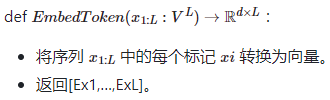
将标记序列转换为序列的向量形式
传统词嵌入
得到向量内容与上下文无关
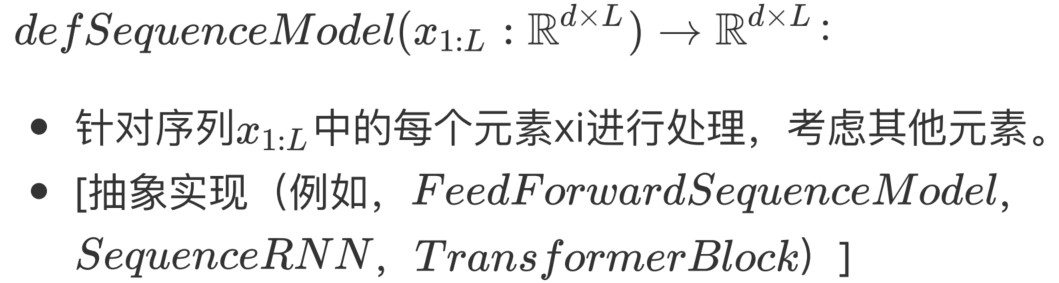
序列模型
作用:接受上下文无关的嵌入,将其映射为上下文相关的嵌入
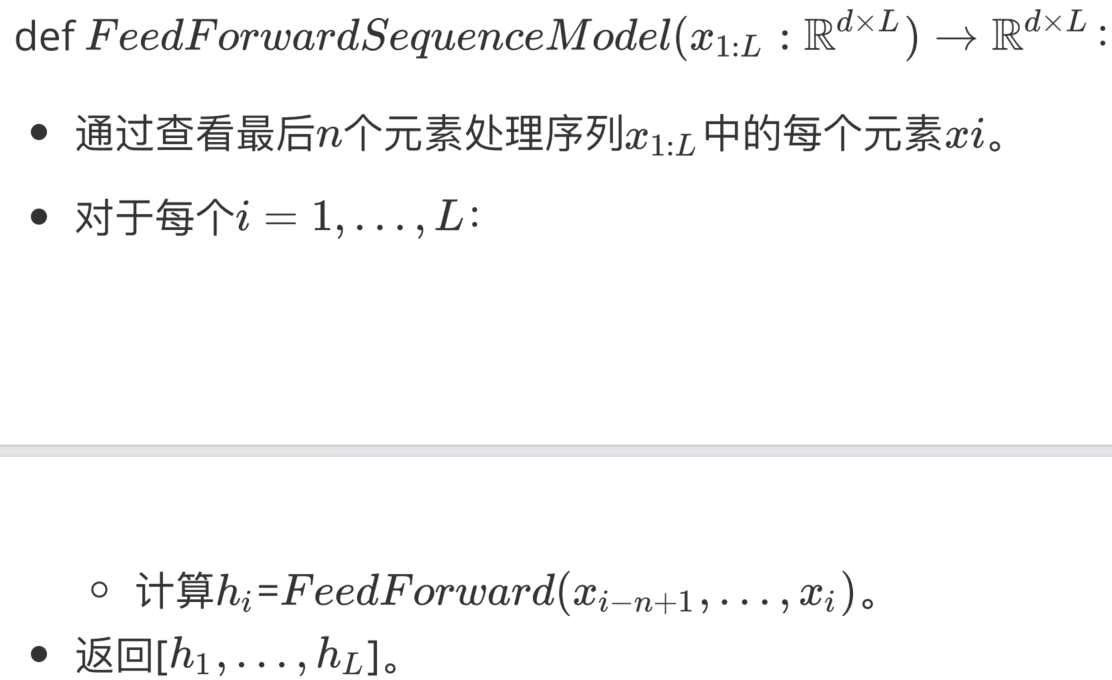
简单的序列模型
FeedForwardSequenceModel使用的是固定长度的上下文进行向量嵌入
第一个真正的序列模型
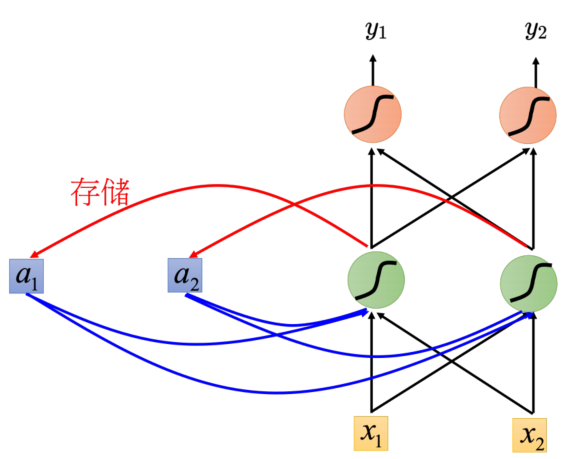
递归神经⽹络(RNN):通过递归地计算一系列隐藏状态来实现上下文向量嵌入
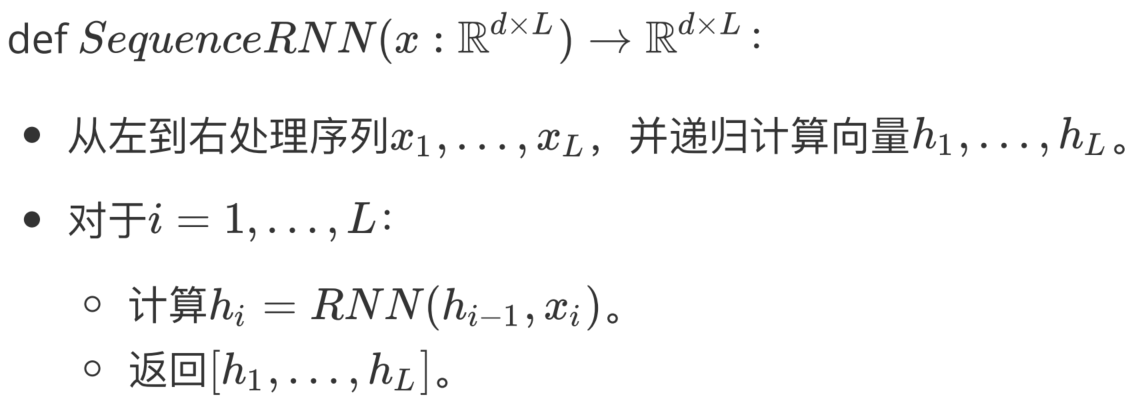
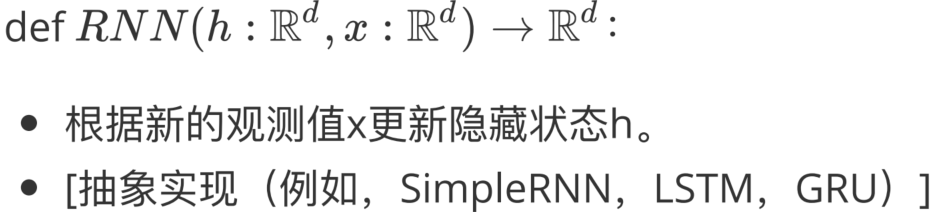
RNN模型
接收当前状态h、新观测值x,并返回更新后的状态
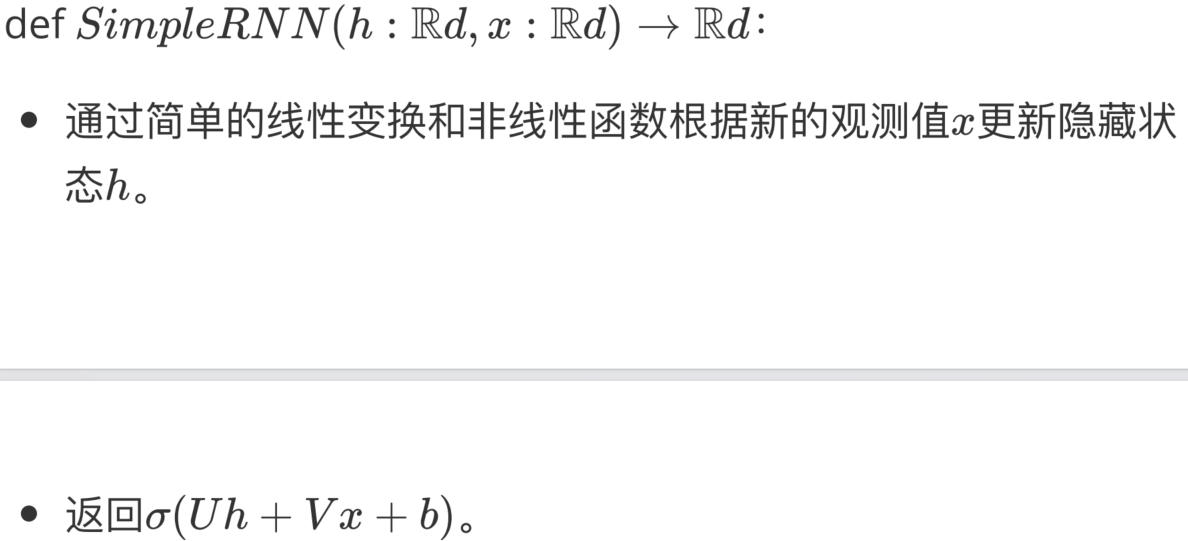
简单RNN
实现方法:将
x
x
x和
h
h
h的组合通过逐元素非线性函数,如逻辑函数
σ
(
z
)
=
(
1
+
e
−
z
)
−
1
\sigma(z) = (1+e-z)-1
σ(z)=(1+e−z)−1 或
R
e
L
U
ReLU
ReLU函数
σ
(
z
)
=
m
a
x
(
0
,
z
)
\sigma(z) = max(0,z)
σ(z)=max(0,z)
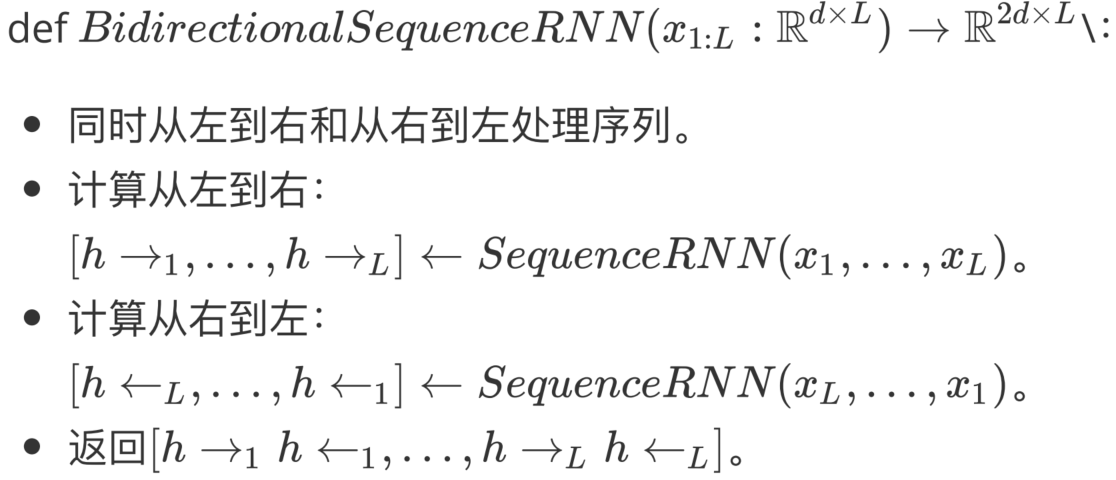
双向RNN
一个RNN存储上文信息,一个RNN存储下文信息,整合进行向量编码
模型被使用在ELMo和ULMFiT中
RNN模型的问题
简单RNN模型中会出现梯度消失的问题,于是引入LSTM模型和GRU模型
隐藏状态的存储对内存要求高,并且在距离当前token远的input信息不容易被利用
Transformer
真正推动llm发展的序列模型
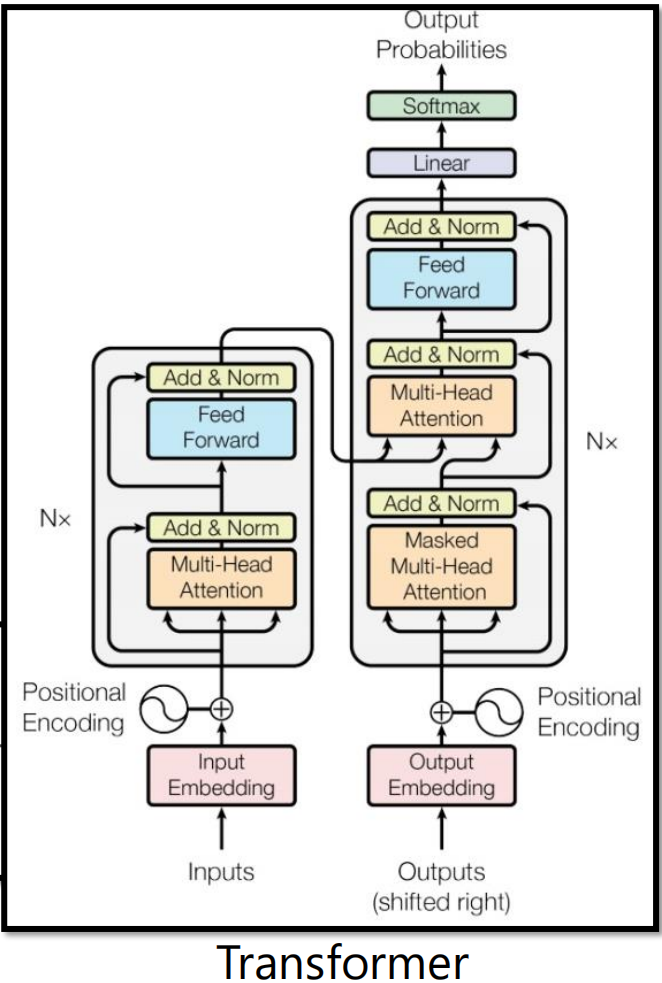
注意力机制
Transformer的关键
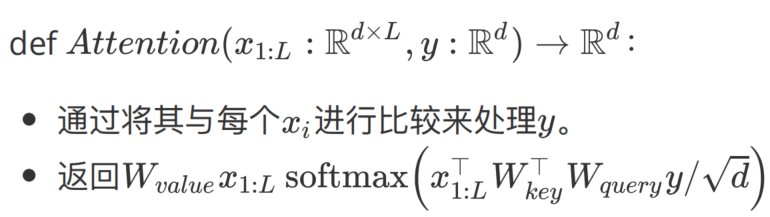
注意力机制的理解
通过线性变换将每个token
x
i
x_i
xi转换一个键值对
(
W
k
e
y
x
i
)
:
(
W
v
a
l
u
e
x
i
)
(W_{key}x_i):(W_{value}x_i)
(Wkeyxi):(Wvaluexi) 使用另一个线性变换形成查询
W
q
u
e
r
y
y
W_{query}y
Wqueryy
将键和查询使用点积计算得到相似度分数
s
c
o
r
e
i
=
x
i
T
W
k
e
y
T
W
q
u
e
r
y
T
y
score_i = x_i^TW_{key}^TW_{query}^Ty
scorei=xiTWkeyTWqueryTy
将这些相似度分数进行指数化和归一化得到关于各个标记位置i的概率分布
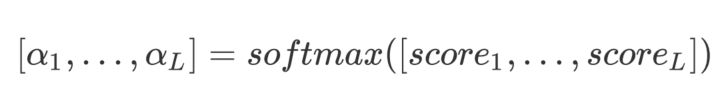
输出为基于值的加权组合
∑
i
=
1
L
α
i
(
W
v
a
l
u
e
x
i
)
\sum^L_{i=1}\alpha_i(W_{value}x_i)
i=1∑Lαi(Wvaluexi)
矩阵形式:
多头注意力机制
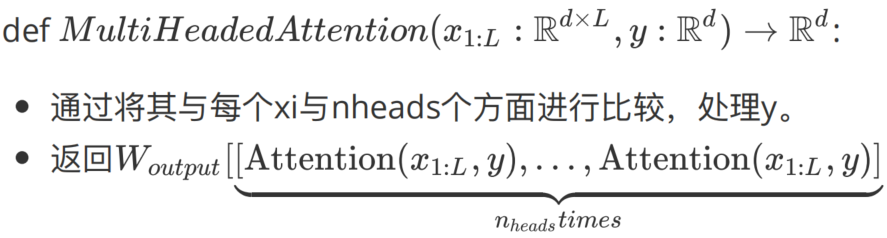
考虑单一注意力所能捕捉的是各个input的某一特征,充分利用input的上下文表征,使用多个注意力头,即多个查询键值组合
简明表示:
自注意力机制
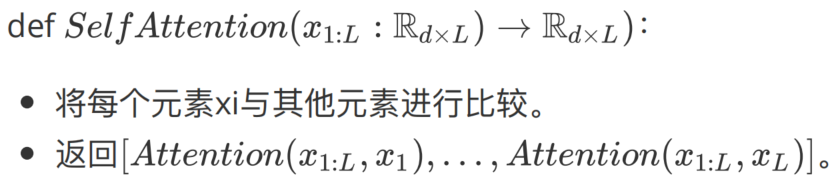
对于Transformer中使用的自注意力层,用
x
i
x_i
xi替换
y
y
y实现自身与句子上下文进行attention计算,产生的输出即为该位置基于上下文表征的向量
形式化表示:
前馈层
使用前馈层单独处理经过自注意力层已经得到上下文信息的向量
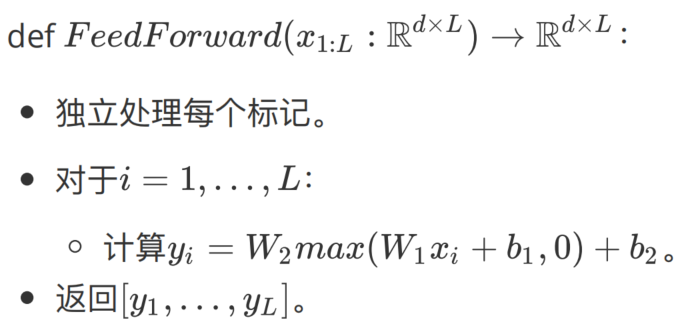
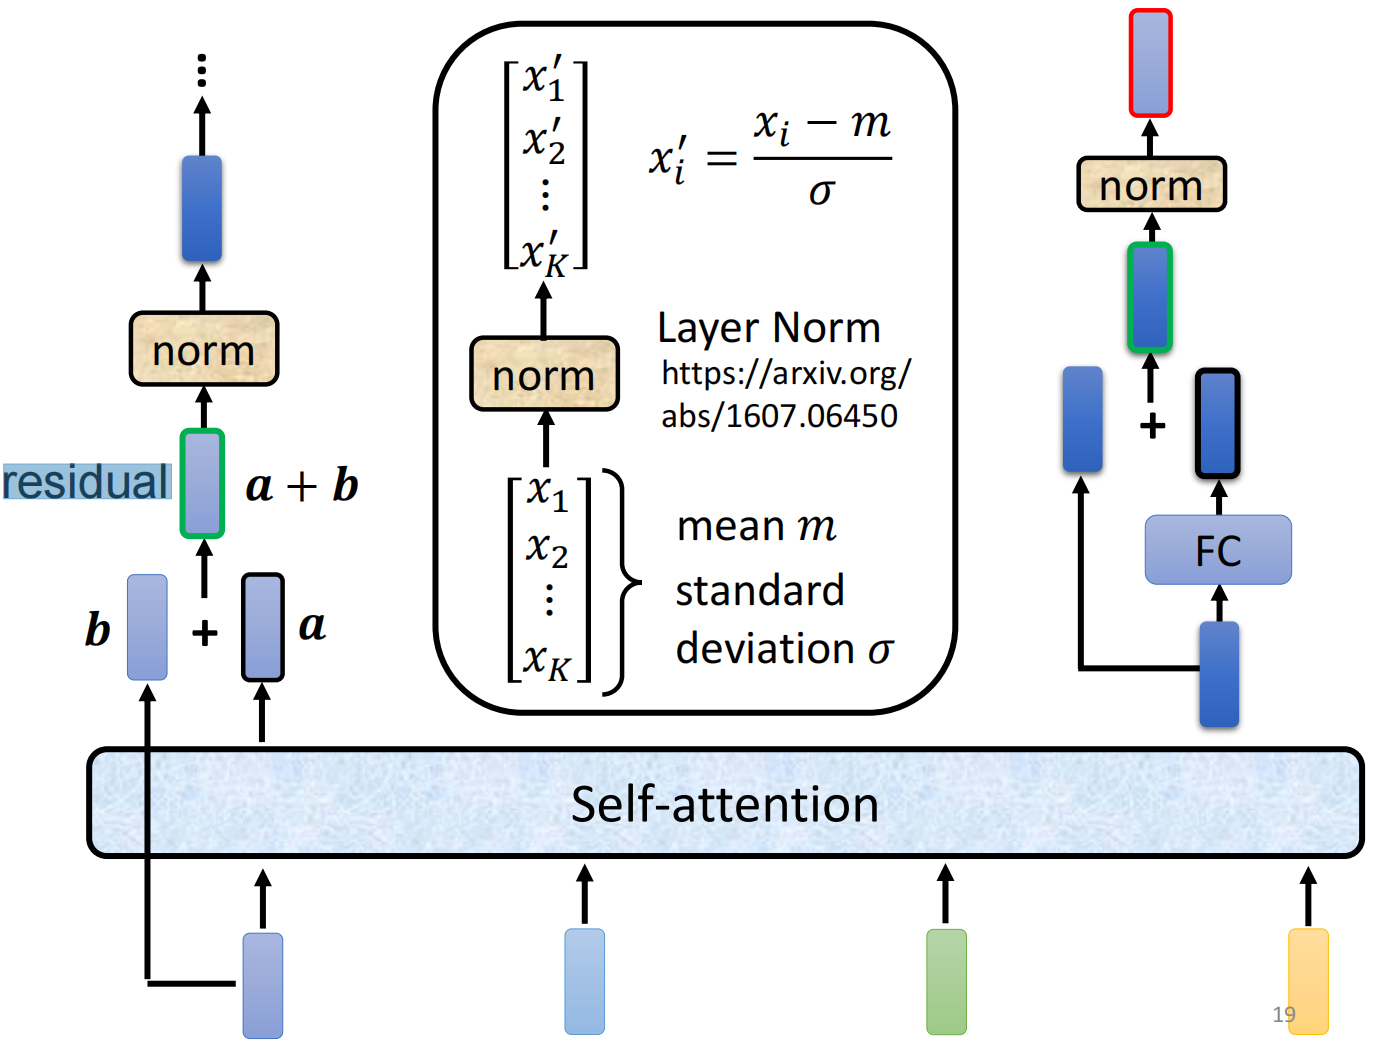
Transformer的主要组成部分即是自注意力层和全连接前馈层,但为了解决网络中梯度消失问题,需要在现有网络中加入残差连接和归一化两个技巧
残差连接和归一化
残差连接
自注意力层的output+自注意力层的input得到的结果作为前馈层的input
即
x
1
:
L
+
f
(
x
1
:
L
)
x_{1:L}+f(x_{1:L})
x1:L+f(x1:L)
作用:在
f
f
f梯度消失时,仍可以通过
x
1
:
L
x_{1:L}
x1:L来计算梯度
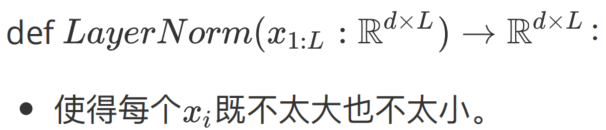
层归一化
层归一化函数的形式化定义:
简明化地定义Transformer
首先是一个适配器函数,输入为一个序列模型和上下文无关的序列向量表示,输出为上下文有关的归一化的向量表示,这即是定义了Transformer中的一个层
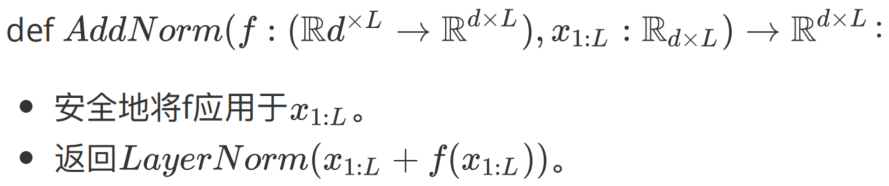
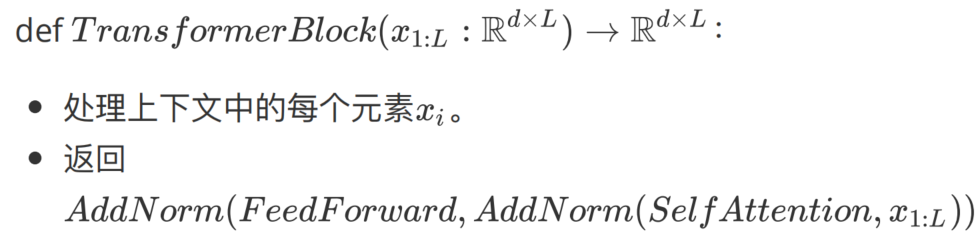
则包含一层自注意力和一层前馈层的Tranformer模型为
位置嵌入
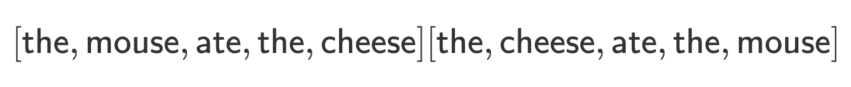
截止到目前,Transformer模型是不考虑token在句子中的位置信息的,举个例子,下面两个句子中的mouse具有相同的嵌入
一种位置嵌入的方式
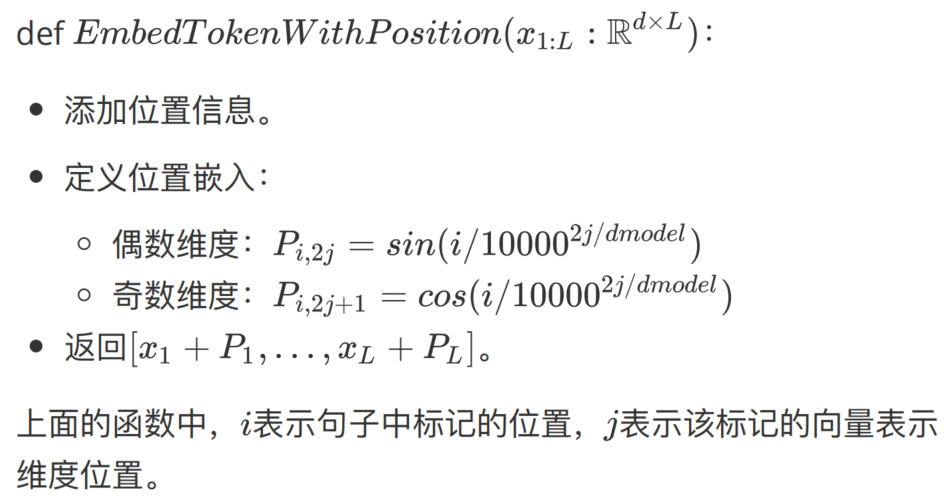
解释:将token的位置信息嵌入为一个向量P,通过图中所述确定每个token的P中每一维度的数值,将token的向量表示与P相加得到序列加入位置信息的向量结果
考虑GPT-3
将Transformer堆叠96次的结果
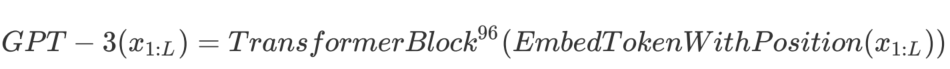
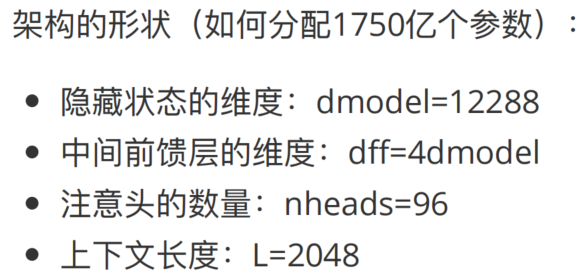
变化的Transformer
归一化的位置,先归一化还是先经过神经网络(包括自注意力层和前馈层)
使用dropout防止过拟合
不同的Transformer子类型的使用
参考资料

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献4条内容

所有评论(0)