爬虫内容学习-工具类---xpath-1
一、爬虫理解
爬虫学习建议:
1.1在编写python爬虫程序时,只需要做以下两件事:
- 发送GET请求,获取HTML [第一类]
- 解析HTML,获取数据 [第二类]
-
这两件事,python都有相应的库帮你去做,你只需要知道如何去用它们就可以了。
爬虫目前涉及两种一是获取网页类的如urllib库,requests库,对网页进行获取,获取内容,保存,响应等。
1.2、解析网页内容:是网页中有很多内容,爬虫的本质是选择我需要的内容,例如我只想网页中的一部分图片,一部分视频或者一部分特殊的内容,这个选择的“部分”主要有1.正则表达式 2.xpath 3.BeautifulSoup 4.jsonparh 5.selenium
前期练习的时候,可以使用requests库+正则表达式 进行练习
后期使用的过程中,建议requests库+xpath库+Xpath Helper【浏览器工具】
工作中建议重点:requests库+xpath库+Xpath Helper【浏览器工具】+selenium结合使用
1.3个人建议:
背景内容:
Python爬虫中Xpath的用法,相信每一个写爬虫、或者是做网页分析的人,都会因为在定位、获取XPath路径上花费大量的时间,在没有这些辅助工具的日子里,我们只能通过搜索HTML源代码,定位一些id,class属性去找到对应的位置,非常的麻烦,
一款插件Chrome中的一种爬虫网页解析工具:XPath Helper
XPath Helper插件是一款免费的Chrome爬虫网页解析工具,可以帮助用户解决在获取XPath路径时无法正常定位等问题安装了XPath Helper后就能轻松获取HTML元素的XPath,该插件主要能帮助我们在各类网站上查看的页面元素来提取查询其代码,同时我们还能对查询出来的代码进行编辑,而编辑出的结果将立即显示在旁边的结果框中,也很方便的帮助我们判断我们的XPath语句是否书写正确
1.4.Xpath Helper的安装【工具的安装】
在网上找到的下载地址,你可以根据实际情况进行下载
https://chrome.zzzmh.cn/info/hgimnogjllphhhkhlmebbmlgjoejdpjl

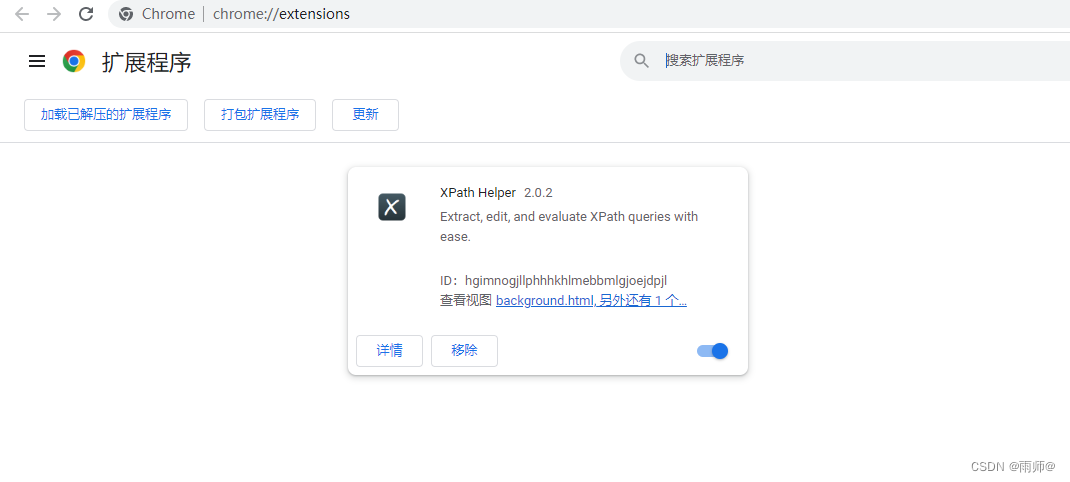
安装完毕后,在需要匹配数据的页面处,使用快捷键打开助手工具(快捷键:ctrl+shift+x)
1.5.Xpath Helper使用
涉及到的素材仅限于学习---仅限于学习---
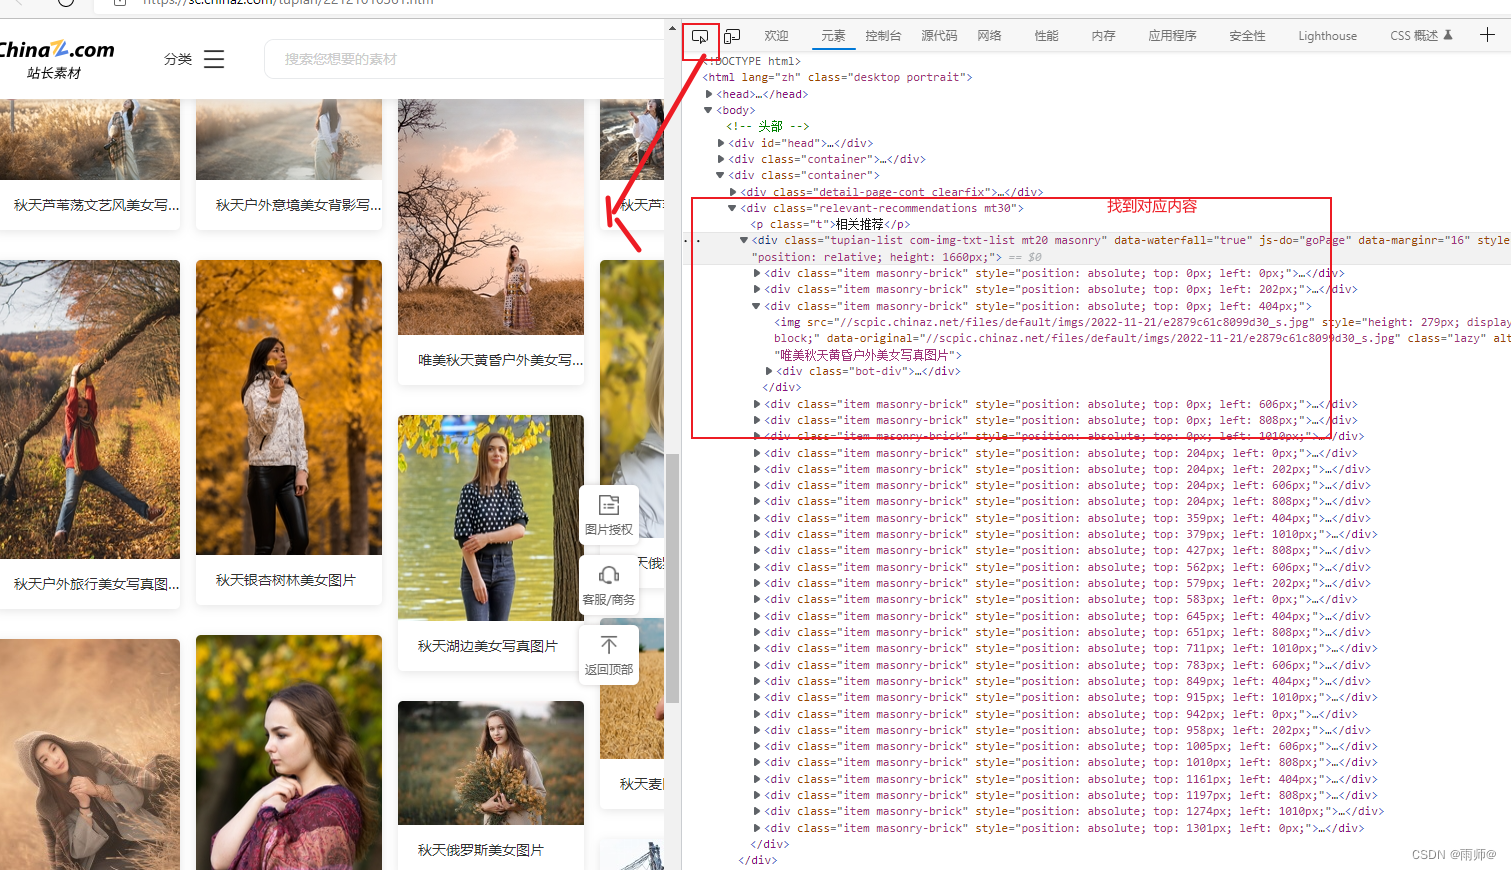
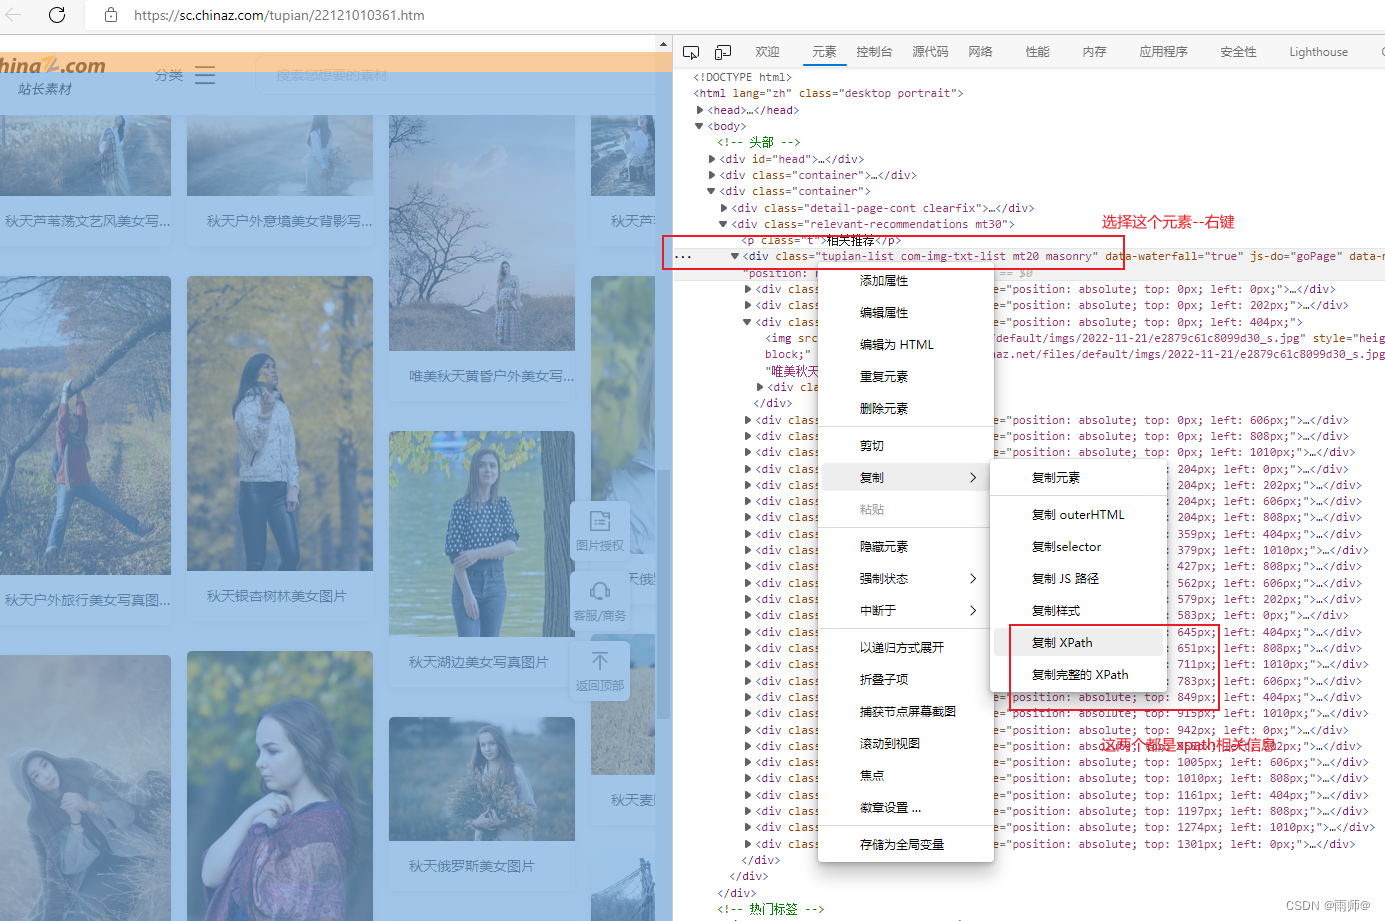
把刚刚复制的xpath内容复制到Xpath Helper工具中,观察结果

1.6.xpath的语法
XPath(XML Path Language - XML路径语言),它是一种用来确定XML文档中某部分位置的语言。
Xpath以XML为基础,提供用户在数据结构树中寻找节点的能力,Xpath被很多开发者亲切的称为小型查询语言。xpath可以使用路径表达式在XML上选取节点,从而达到确认元素的目的,我们先来介绍以下语法规则
语法规则:
| 表达式 | 作用 |
|---|---|
| nodename | 选取此层级节点下的所有子节点 |
| / | 代表从根节点进行选取 |
| // | 可以理解为匹配,就是在所有节点中选取此节点,直到匹配为止 |
| . | 选取当前节点 |
| … | 选取当前节点上一层(上一级目录) |
| @ | 选取属性(也是匹配) |
标签定位:
| 方式 | 效果 |
| /html/body/div | 表示从根节点开始寻找,标签与标签之间/表示一个层级 |
| /html//div | 表示多个层级 作用于两个标签之间(也可以理解为在html下进行匹配寻找标签div) |
| //div | 从任意节点开始寻找,也就是查找所有的div标签 |
| ./div | 表示从当前的标签开始寻找div |
属性定位
| 需求 | 格式 |
| 定位div中属性名为href,属性值为‘www.baidu.com’的div标签 | @属性名=属性值 |
| href为属性名 'www.baidu.com’为属性值 | /html/body/div[href=‘www.baidu.com’] |
索引定位
| 定位ul下第二个li标签(下图) | //ul/li[2] |
| 索引值开始位置为 | 1 |
取文本内容
| 方法 | 效果 |
| /text() | 获取标签下直系的标签内容 |
| //text() | 获取标签中所有的文本内容 |
| string() | 获取标签中所有的文本内容 |
二、python中使用
python中使用
使用步骤:
2.1.安装lxml库
pip install lxml
2.导入lxml
from lxml import etree
3.解析文件
3.1解析本地文件(离线文件)【不常用】
html_tee=etree.parse("xxx.html")
3.2解析网络文件 (互联网网址)系统自带urllib库【不常用】
html_tee=etree.HTML(response.read().decode("utf-8"))
3.3如果是respones库【常用的方式】
import requests
response = requests.get(url=f'http://www.baidu.com', headers=headers)
#可选步骤,如果网页是gb2312编码的就是修改这里,不然不需要添加
response .encoding='gb2312'
html_tee=etree.HTML(response.text)
4.加载文件
重要的就是xpath规则的编写,这个规则也很简单,掌握如下就是满足爬虫的使用了
xpathguize="//div[@class="info-con pd20"]//img/@src"
html_tee.xpath(xpathguize)
5补充规则的编写:--示例:
1.如何定位到元素,下面“5.2网络源码样式”,如何找img这里的src里面的图片地址
5.1 F12 调出网页源码(或者右键网页选择‘检查’),选择一个你需要的额图片右键
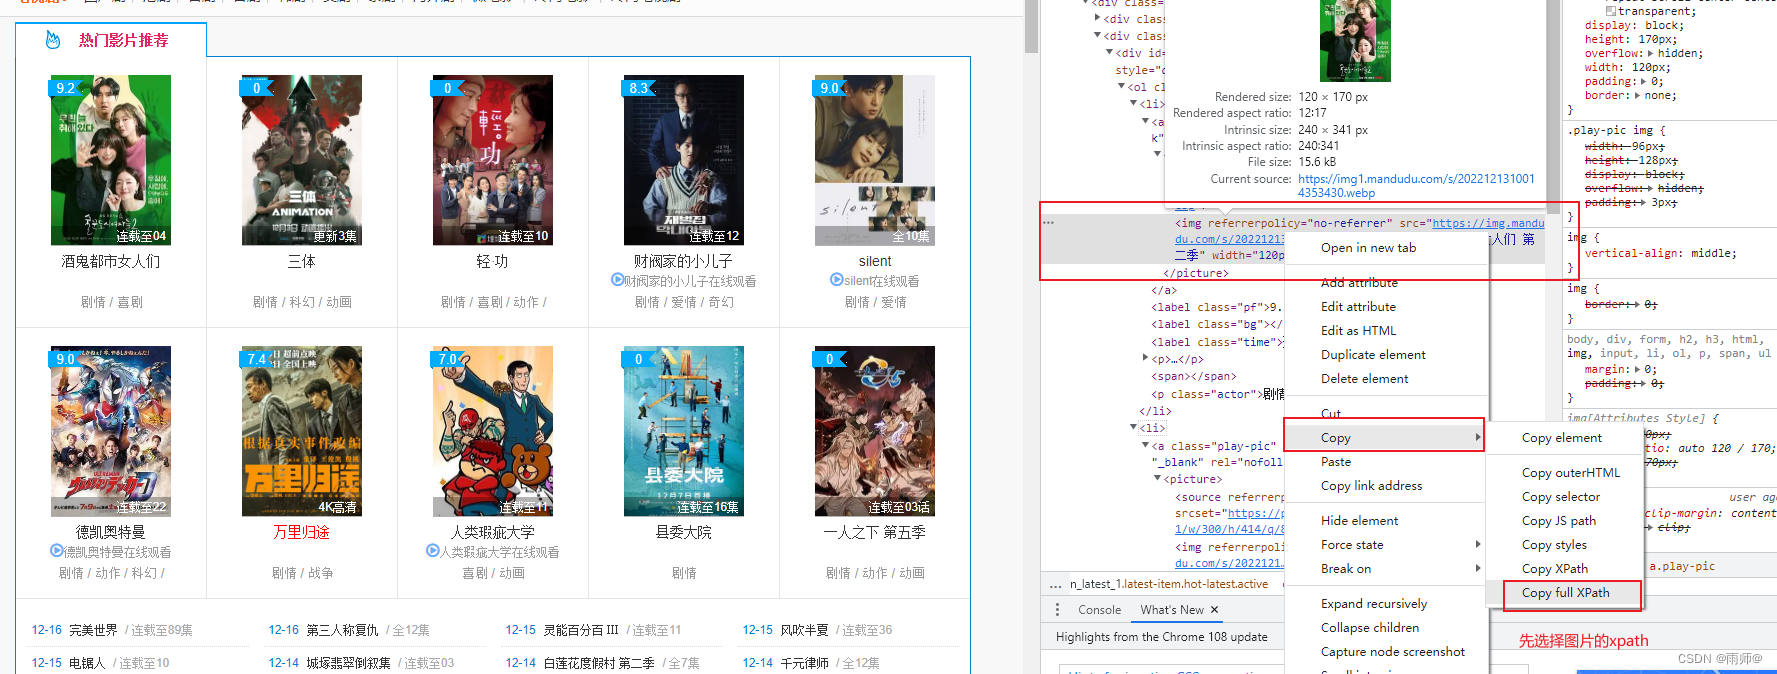
下面的元素选择,在右边就是显示你需要的 xpath了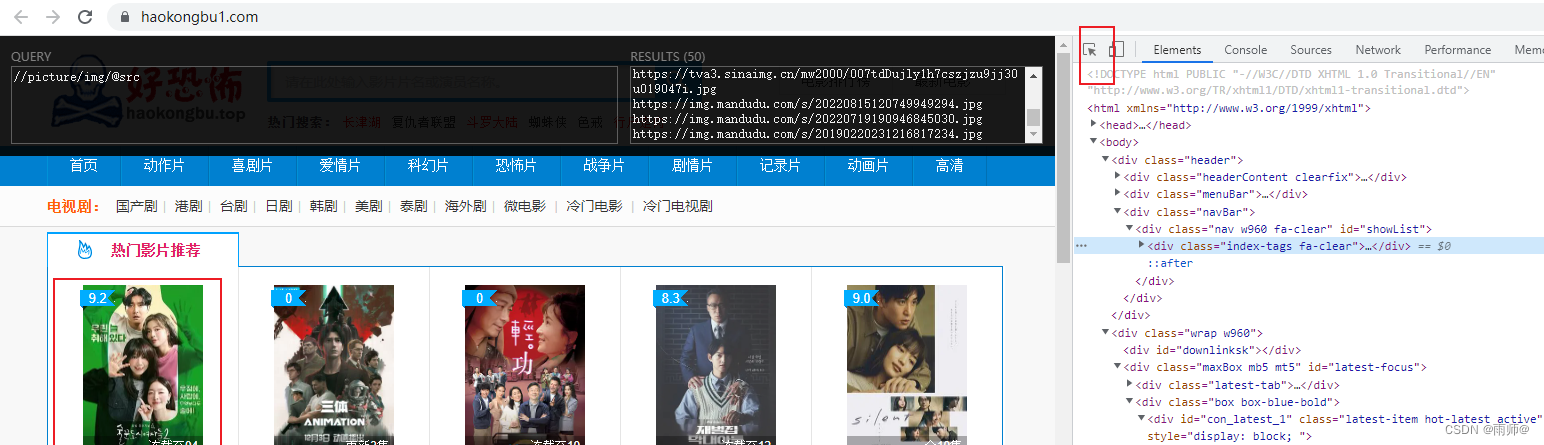
调出xpath、浏览器工具,修改你需要的样式,同时可以在右边查看是否选择正确
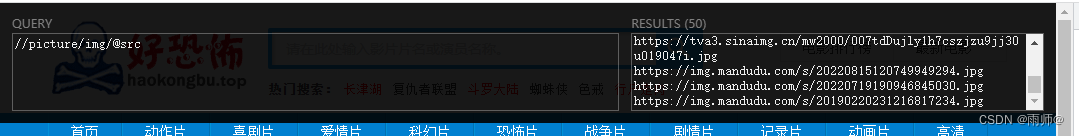
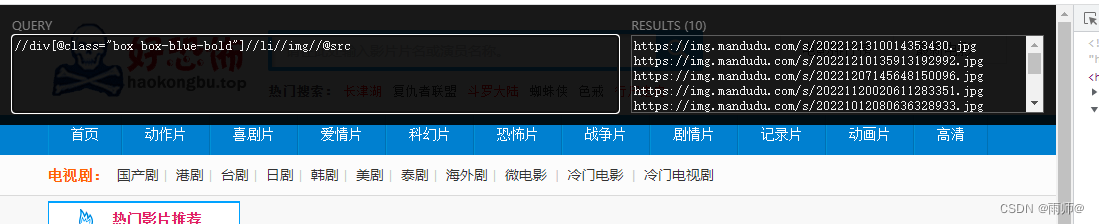
选择的重要点 :
三、核心知识点分析
xpath中充分掌握下面的1和2就是可以写出不错的xpath规则了,可以满足大部分的需求了
3.1.定位,用属性定位
//div[@class="box box-blue-bold"]//li//img//@src
//div[@class="box box-blue-bold"]//li//img//@src
说明:定位就是找到网页中的你要的元素的起始位置---定位作用
[@class="box box-blue-bold"]===就是用 class来定位标签,
经常使用的是 @id=“xxx” 和@class=“xxx”
如:div[@class="box box-blue-bold"],div[@id="con_latest_1"]
3.2.获取元素属性内容--需要的内容,一般图片地址,视频地址居多
//div[@class="box box-blue-bold"]//li//img//@src
<img referrerpolicy="no-referrer" src="https://img.mandudu.com/s/20221210135913192992.jpg" alt="三体" width="120px" height="170px">
</picture>
/@src 就是获取img的src的连接地址信息,可以获取图片地址信息“"https://img.mandudu.com/s/20221210135913192992.jpg”
3.3网络网页源码样式:
<li>
    <a class="play-pic" href="/donghuapian/155272.html" target="_blank" rel="nofollow">
    <picture>
        <source referrerpolicy="no-referrer" type="image/webp"
                srcset="https://p0.pipi.cn/mmdb/25bfd65111e33867cbb860d07090375118263.jpg?imageView2/1/w/300/h/414/q/80">
        <img referrerpolicy="no-referrer" src="https://img.mandudu.com/s/20221210135913192992.jpg" alt="三体" width="120px" height="170px">
    </picture>
</a>
    <label class="pf">0</label><label class="bg"></label><label class="time">更新3集</label>
    <p><a href="/donghuapian/155272.html" target="_blank">三体</a></p><span></span>
    <p class="actor">剧情 / 科幻 / 动画</p>
</li>
3.4xpath核心匹配规则:
1. 获取节点对象
     //div[@class="test"]
2. 获取节点属性值
     //div[@class="test"]//a/@src
3. 函数
     //div[contains(@class,"test")]/a/@href
4.获取节点对象内容
    //div/a/text()
3.5对数据进一步筛选,示例;
    <?xml version="1.0" encoding="ISO-8859-1"?>
    <bookstore>
    <book>
      <title lang="eng">Harry Potter</title>
      <price>29.99</price>
    </book>
    <book>
      <title lang="eng">Learning XML</title>
      <price>39.95</price>
    </book>
    </bookstore>
3.5.1都写在方括号"[]"中,表示对节点进行进一步的筛选。
有谓语的一些路径表达式,以及表达式的结果:
| 路径表达式 | 结果 |
|---|---|
| /bookstore/book[1] | 选取属于 bookstore 子元素的第一个 book 元素。 |
| /bookstore/book[last()] | 选取属于 bookstore 子元素的最后一个 book 元素。 |
| /bookstore/book[last()-1] | 选取属于 bookstore 子元素的倒数第二个 book 元素。 |
| /bookstore/book[position()<3] | 选取最前面的两个属于 bookstore 元素的子元素的 book 元素。 |
| //title[@lang] | 选取所有拥有名为 lang 的属性的 title 元素。 |
| //title[@lang=’eng’] | 选取所有 title 元素,且这些元素拥有值为 eng 的 lang 属性。 |
| //book[price] | 选取所有 book 元素,且被选中的book元素必须带有price子元素 |
| /bookstore/book[price>35.00] | 选取 bookstore 元素的所有 book 元素,且其中的 price 元素的值须大于 35.00。 |
| /bookstore/book[price>35.00]/title | 选取 bookstore 元素中的 book 元素的所有 title 元素,且其中的 price 元素的值须大于 35.00。 |

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献4条内容

所有评论(0)