动手学习深度学习(总结梳理)——5.权重衰退(weight decay)
目录
3.2 实践中权重衰减的值设为多少比较好?为什么之前感觉这个参数的调整效果不太好?
3.3 为什么要把w往小拉?如果最优解的w是个很大的数,权重衰减会不会起到反作用?
1. 基础理论篇
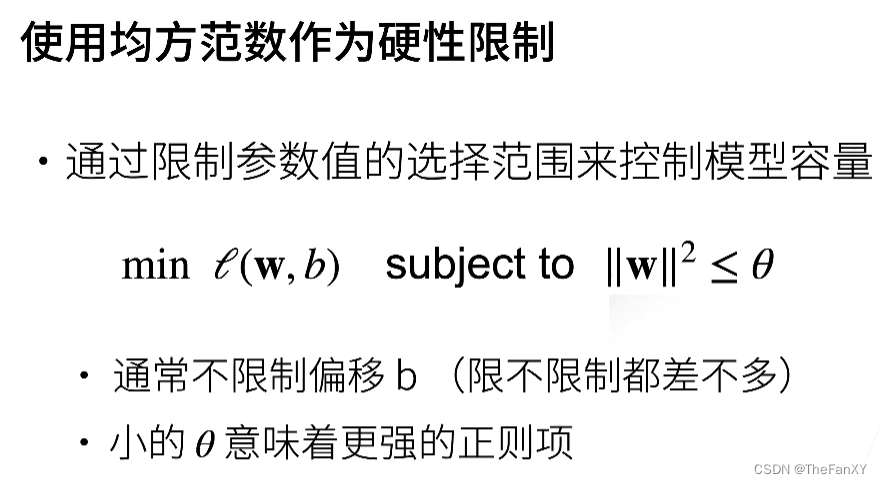
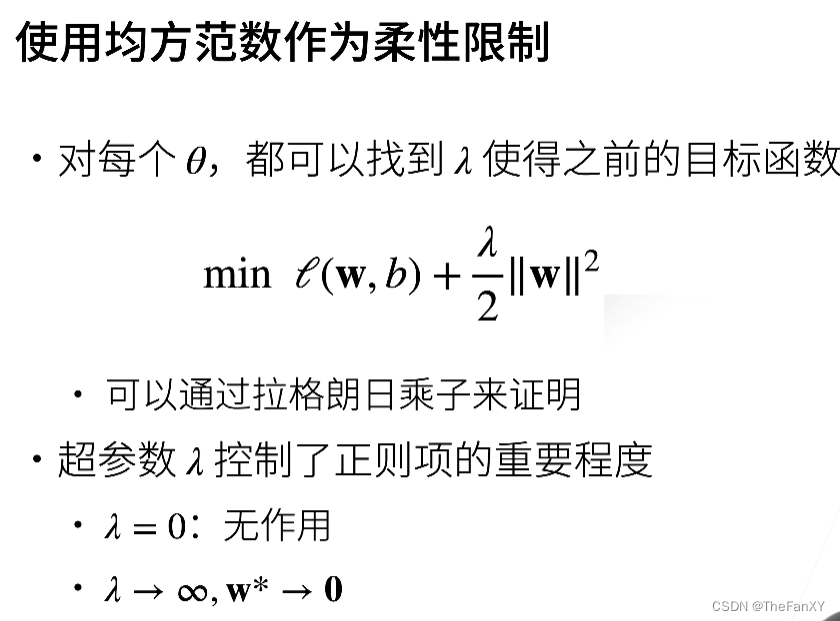
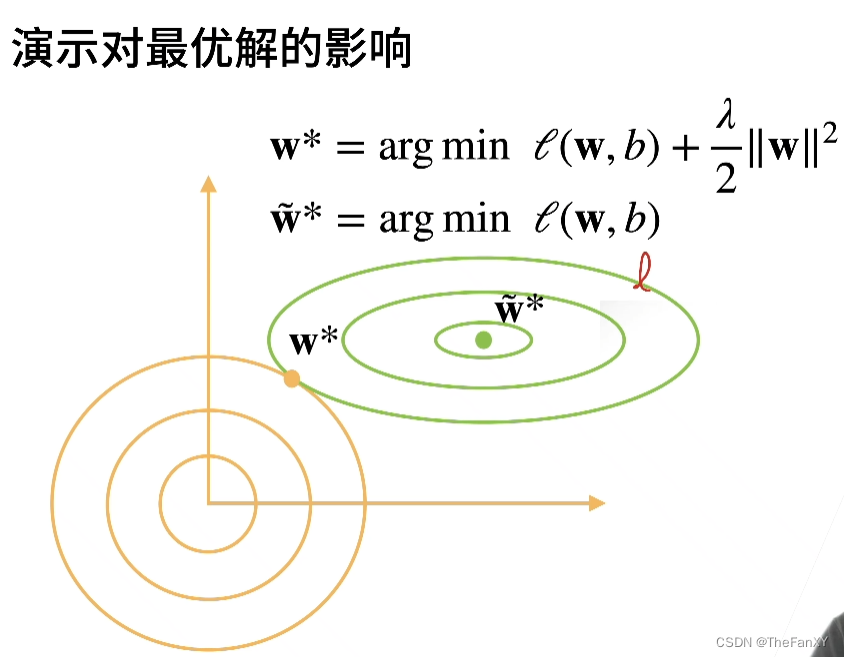
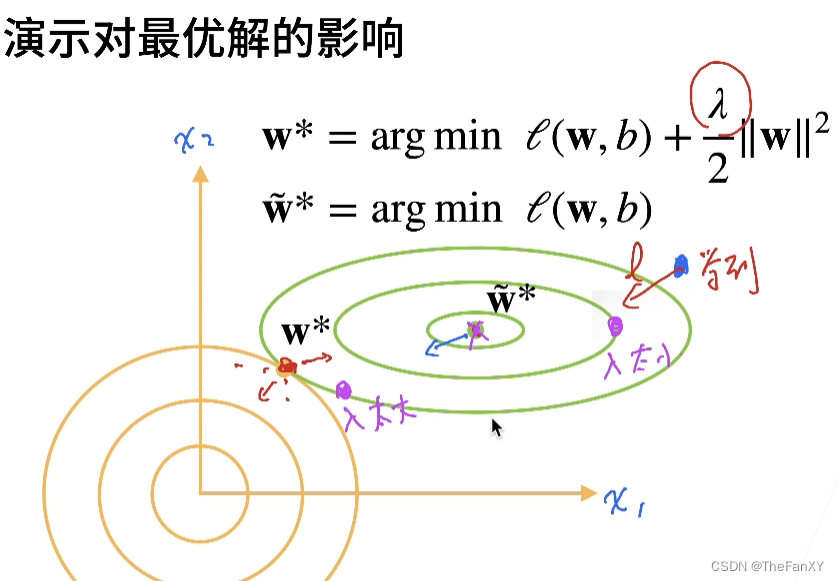
在此前的学习过程中,我们认识到此前的均方差损失函数,在接近最优时梯度接近为0,此时对w的限制不够强,而加入的L2正则项使得我们的w往模型简单的方向逼近,最终在两者约束下到达一个合理的w
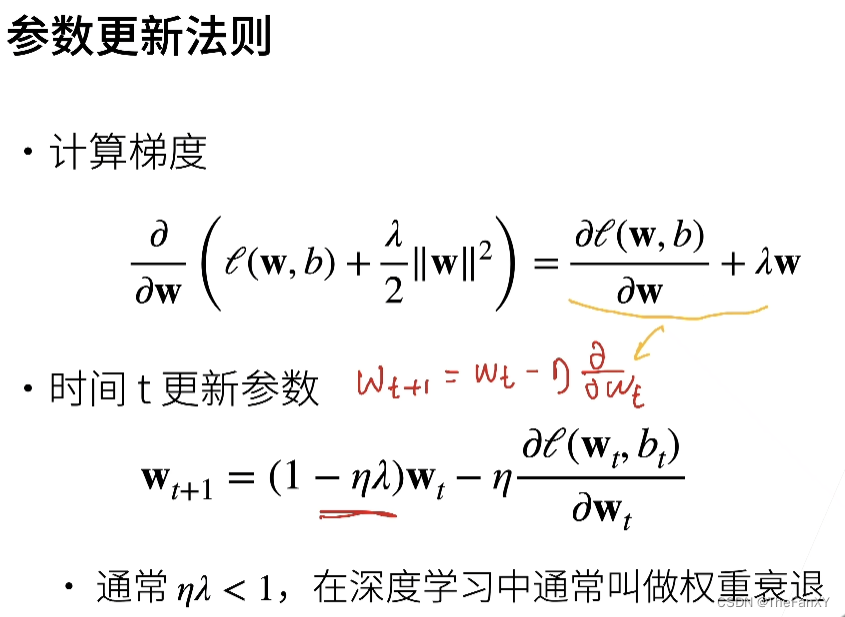
权重衰退名字的由来
2. 用实例演示权重衰退
%matplotlib inline
import torch
from torch import nn
from d2l import torch as d2l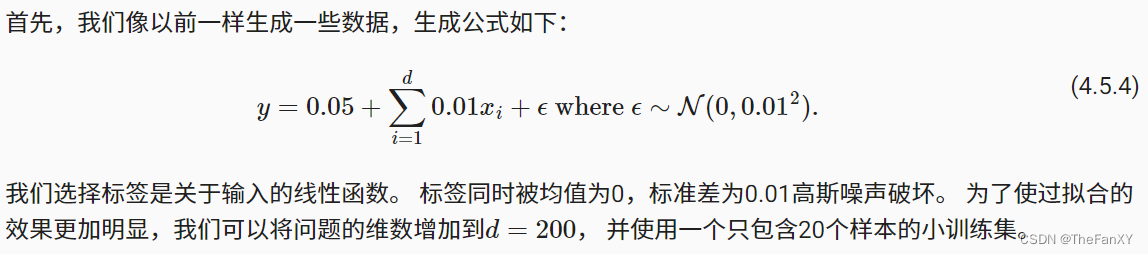
这里的synthetic_data和load_array函数均在第一章线性模型中我们完成过封装
n_train, n_test, num_inputs, batch_size = 20, 100, 200, 5
true_w, true_b = torch.ones((num_inputs, 1)) * 0.01, 0.05
train_data = d2l.synthetic_data(true_w, true_b, n_train)
train_iter = d2l.load_array(train_data, batch_size)
test_data = d2l.synthetic_data(true_w, true_b, n_test)
test_iter = d2l.load_array(test_data, batch_size, is_train=False)
2.1 从0开始实现权重衰减
只需要讲L2的平方惩罚项添加到目标函数即可
2.1.1 初始化模型参数
def init_params():
    w = torch.normal(0, 1, size=(num_inputs, 1), requires_grad=True)
    b = torch.zeros(1, requires_grad=True)
    return [w, b]
2.1.2 定义L2范数惩罚
python中pow函数实现了幂次运算
def l2_penalty(w):
    return torch.sum(w.pow(2)) / 2
2.1.3 定义训练代码实现
下面的代码将模型拟合训练数据集,并在测试数据集上进行评估。从我们学习以来,线性网络和平方损失没有变化, 所以我们通过d2l.linreg和d2l.squared_loss导入它们。 唯一的变化是损失现在包括了惩罚项。这里我们直接调用.norm()可以访问写入模型tensor的范数,item()可以避免生成计算图
def train(lambd):
    w, b = init_params()
    net, loss = lambda X: d2l.linreg(X, w, b), d2l.squared_loss
    num_epochs, lr = 100, 0.003
    animator = d2l.Animator(xlabel='epochs', ylabel='loss', yscale='log',
                            xlim=[5, num_epochs], legend=['train', 'test'])
    for epoch in range(num_epochs):
        for X, y in train_iter:
            # 增加了L2范数惩罚项,
            # 广播机制使l2_penalty(w)成为一个长度为batch_size的向量
            l = loss(net(X), y) + lambd * l2_penalty(w)
            l.sum().backward()
            d2l.sgd([w, b], lr, batch_size)
        if (epoch + 1) % 5 == 0:
            animator.add(epoch + 1, (d2l.evaluate_loss(net, train_iter, loss),
                                     d2l.evaluate_loss(net, test_iter, loss)))
    print('w的L2范数是:', torch.norm(w).item())
2.1.4 忽略正则化项直接训练
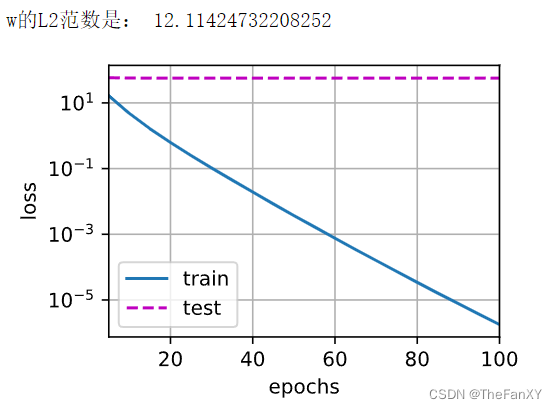
train(lambd=0)可以看到训练误差随着轮次进行减少,但是测试误差缺没有变化,说明严重过拟合
2.1.5 加入正则化项训练
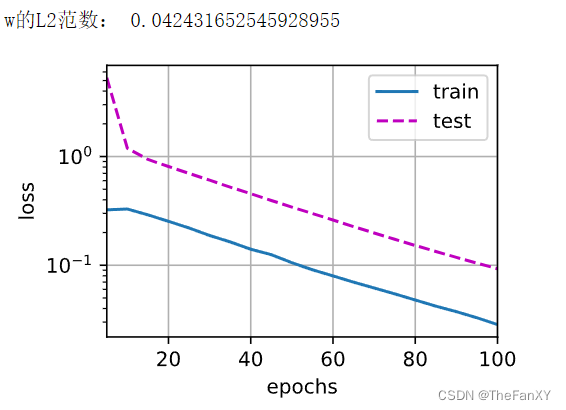
train(lambd=30)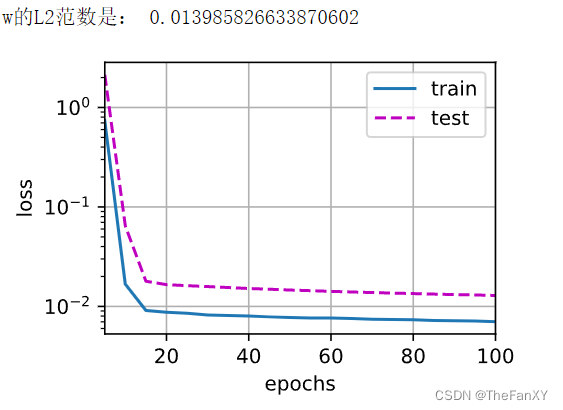
2.2 梯度衰减的简洁实现
由于权重衰减在神经网络优化中很常用, 深度学习框架为了便于我们使用权重衰减, 将权重衰减集成到优化算法中,以便与任何损失函数结合使用。 此外,这种集成还有计算上的好处, 允许在不增加任何额外的计算开销的情况下向算法中添加权重衰减。 由于更新的权重衰减部分仅依赖于每个参数的当前值, 因此优化器必须至少接触每个参数一次。
在下面的代码中,我们在实例化优化器时直接通过weight_decay指定weight decay超参数。 默认情况下,PyTorch同时衰减权重和偏移。 这里我们只为权重设置了weight_decay,所以偏置参数b不会衰减。
def train_concise(wd):
    net = nn.Sequential(nn.Linear(num_inputs, 1))
    for param in net.parameters():
        param.data.normal_()
    loss = nn.MSELoss(reduction='none')
    num_epochs, lr = 100, 0.003
    # 偏置参数没有衰减
    trainer = torch.optim.SGD([
        {"params":net[0].weight,'weight_decay': wd},
        {"params":net[0].bias}], lr=lr)
    animator = d2l.Animator(xlabel='epochs', ylabel='loss', yscale='log',
                            xlim=[5, num_epochs], legend=['train', 'test'])
    for epoch in range(num_epochs):
        for X, y in train_iter:
            trainer.zero_grad()
            l = loss(net(X), y)
            l.mean().backward()
            trainer.step()
        if (epoch + 1) % 5 == 0:
            animator.add(epoch + 1,
                         (d2l.evaluate_loss(net, train_iter, loss),
                          d2l.evaluate_loss(net, test_iter, loss)))
    print('w的L2范数:', net[0].weight.norm().item())
这些图看起来和我们从零开始实现权重衰减时的图相同。 然而,它们运行得更快,更容易实现。 对于更复杂的问题,这一好处将变得更加明显。
train_concise(0)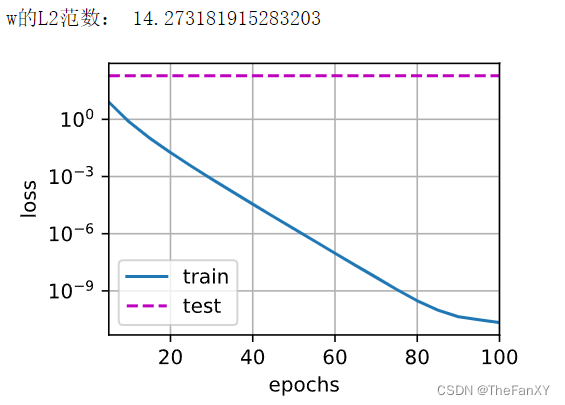
train_concise(30)
3. 本节课QA环节优质问题
3.1 为什么参数不过大复杂度就低?
正则项的目的是限制模型的weight取不到特别大的值,如果weight可以任意选择,在一个小的数据集或者简单的模型它可以任意变化不平滑的拟合数据,而这个限制使得weight的值趋向于平滑,使得看似损失比以前大了,但是泛化能力得到了增强。
3.2 实践中权重衰减的值设为多少比较好?为什么之前感觉这个参数的调整效果不太好?
一般设置为e-3, e-4,其实权重衰减对很复杂的模型的影响并没有特别大,只是在一些特定场合会大大影响模型的准确性,还有一些别的办法去提高模型的能力
3.3 为什么要把w往小拉?如果最优解的w是个很大的数,权重衰减会不会起到反作用?
事实上我们在一个模型中学习的过程中,会受到噪音的影响,实际可能学不到最优解,可能是被噪声影响学到更大的W,而惩罚项过小,可能还是不够把它拉到最优解,但是会比之前优化,如果惩罚过大,可能又会拉远里最优解的距离.假设根本就没有噪音,那么就不会overfit到一些奇怪的地方,然后再去去加入正则化项减小模型的复杂度

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 3
 0
- 0


 已为社区贡献3条内容

所有评论(0)