大数据之Kafka开发实例
外部系统的集成,即通过不同的生产端或消费端来实现数据消费过程。
1、集成flume
flume是大数据开发者常用的组件,主要是高可用高可靠的日志系统,通过编写.conf文件来实现对日志文件的收集后转存到文件或hdfs集群的操作(离线日志文件)。可用于kafka的生产者,也可用于kafka的消费者。
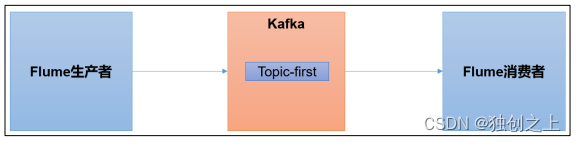
1)、flume作为生产端
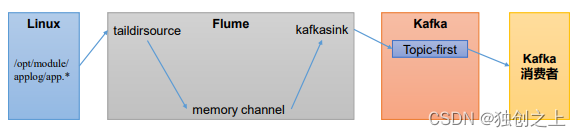
前期准备:启动kafka集群和zookeeper
zk.sh start
kf.sh start
先启动kafka的消费者,便于接收flume生产端发送的数据
bin/kafka-console-consumer.sh --bootstrap-server hadoop102:9092 --topic first
配置flume,设置数据来源,传输的方式。在 hadoop102 节点的 Flume 的 job 目录下创建 file_to_kafka.conf
 1 组件定义
a1.sources = r1
a1.sinks = k1
a1.channels = c1
# 2 配置 source
a1.sources.r1.type = TAILDIR
a1.sources.r1.filegroups = f1
a1.sources.r1.filegroups.f1 = /opt/module/applog/app.*
a1.sources.r1.positionFile =
/opt/module/flume/taildir_position.json
# 3 配置 channel
a1.channels.c1.type = memory
a1.channels.c1.capacity = 1000
a1.channels.c1.transactionCapacity = 100
# 4 配置 sink
a1.sinks.k1.type = org.apache.flume.sink.kafka.KafkaSink
a1.sinks.k1.kafka.bootstrap.servers = hadoop102:9092,hadoop103:9092,hadoop104:9092
a1.sinks.k1.kafka.topic = first
a1.sinks.k1.kafka.flumeBatchSize = 20
a1.sinks.k1.kafka.producer.acks = 1
a1.sinks.k1.kafka.producer.linger.ms = 1
# 5 拼接组件
a1.sources.r1.channels = c1
a1.sinks.k1.channel = c1
启动flume:&表示在后台运行
bin/flume-ng agent -c conf/ -n a1 -f jobs/file_to_kafka.conf &
然后向/opt/module/applog/app.log 里追加数据,查看 kafka 消费者消费情况
mkdir applog
echo hello >> /opt/module/applog/app.log
可以在kafka消费端查看hello数据。
2)、flume作为消费者(接收kafka数据)
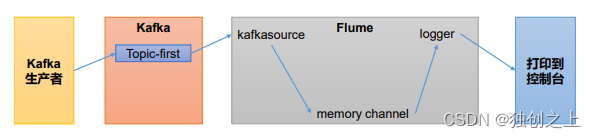
配置flume:在 hadoop102 节点的 Flume 的/opt/module/flume/jobs 目录下创建 kafka_to_file.conf
# 1 组件定义
a1.sources = r1
a1.sinks = k1
a1.channels = c1
# 2 配置 source
a1.sources.r1.type = org.apache.flume.source.kafka.KafkaSource
a1.sources.r1.batchSize = 50
a1.sources.r1.batchDurationMillis = 200
a1.sources.r1.kafka.bootstrap.servers = hadoop102:9092
a1.sources.r1.kafka.topics = first
a1.sources.r1.kafka.consumer.group.id = custom.g.id
# 3 配置 channel
a1.channels.c1.type = memory
a1.channels.c1.capacity = 1000
a1.channels.c1.transactionCapacity = 100
# 4 配置 sink
a1.sinks.k1.type = logger
# 5 拼接组件
a1.sources.r1.channels = c1
a1.sinks.k1.channel = c1
启动flume(在flume终端查看消费数据)
bin/flume-ng agent -c conf/ -n a1 -f jobs/kafka_to_file.conf -Dflume.root.logger=INFO,console
启动kafka,输入数据‘hello’,可以在控制台查看输出的日志。
bin/kafka-console-producer.sh -- bootstrap-server hadoop102:9092 --topic first
2、集成flink
Flink 是一个在大数据开发中非常常用的组件。可以用于 Kafka 的生产者,也可以用于 Flink 的消费者。
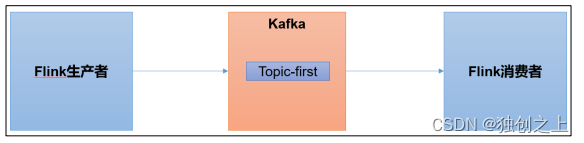
环境准备:创建maven项目,并导入依赖
<dependencies>
        <dependency>
            <groupId>org.apache.flink</groupId>
            <artifactId>flink-java</artifactId>
            <version>1.13.0</version>
        </dependency>
        <dependency>
            <groupId>org.apache.flink</groupId>
            <artifactId>flink-streaming-java_2.12</artifactId>
            <version>1.13.0</version>
        </dependency>
        <dependency>
            <groupId>org.apache.flink</groupId>
            <artifactId>flink-clients_2.12</artifactId>
            <version>1.13.0</version>
        </dependency>
        <dependency>
            <groupId>org.apache.flink</groupId>
            <artifactId>flink-connector-kafka_2.12</artifactId>
            <version>1.13.0</version>
        </dependency>
    </dependencies>
将 log4j.properties 文件添加到 resources 里面,就能更改打印日志的级别为 error
log4j.rootLogger=error, stdout,R
log4j.appender.stdout=org.apache.log4j.ConsoleAppender
log4j.appender.stdout.layout=org.apache.log4j.PatternLayout
log4j.appender.stdout.layout.ConversionPattern=%d{yyyy-MM-dd
HH:mm:ss,SSS} %5p --- [%50t] %-80c(line:%5L) : %m%n
log4j.appender.R=org.apache.log4j.RollingFileAppender
log4j.appender.R.File=../log/agent.log
log4j.appender.R.MaxFileSize=1024KB
log4j.appender.R.MaxBackupIndex=1
log4j.appender.R.layout=org.apache.log4j.PatternLayout
log4j.appender.R.layout.ConversionPattern=%d{yyyy-MM-dd
HH:mm:ss,SSS} %5p --- [%50t] %-80c(line:%6L) : %m%n
1)flink生产端
package com.atguigu.flink;

import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.connectors.kafka.FlinkKafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import java.util.ArrayList;
import java.util.Properties;

public class FlinkKafkaProducer1 {
    public static void main(String[] args) throws Exception {

        //获取环境
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(3);

        // 准备数据源(即要输入到kafka集群中的数据)
        ArrayList<String> wordList = new ArrayList<>();
        wordList.add("hello");
        wordList.add("nihao");
        DataStreamSource<String> stream = env.fromCollection(wordList);

        //创建一个kafka生产者,与flink绑定
        Properties properties = new Properties();     properties.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG,"hadoop102:9092,hadoop103:9092");
        FlinkKafkaProducer<String> flinkKafkaProducer = new FlinkKafkaProducer<>("first", new SimpleStringSchema(), properties);

        //添加数据源 kafka生产者
        stream.addSink(flinkKafkaProducer);

        //执行代码
        env.execute();
    }
}
启动kafka消费者查看数据
bin/kafka-console-consumer.sh -- bootstrap-server hadoop102:9092 --topic first
2)flink消费者
package com.atguigu.flink;

import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.connectors.kafka.FlinkKafkaConsumer;
import org.apache.kafka.clients.producer.ProducerConfig;
import java.util.Properties;

public class FlinkKafkaConsumer1 {
    public static void main(String[] args) throws Exception {
        //获取环境(初始化 flink 环境)
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(3);

        //创建一个消费者
        Properties properties = new Properties();
        properties.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG,"hadoop102:9092,hadoop103:9092");
        FlinkKafkaConsumer<String> FlinkKafkaConsumer = new FlinkKafkaConsumer<String>("first",new SimpleStringSchema(),properties);

        //关联消费者和flink
        env.addSource(FlinkKafkaConsumer).print();
        //执行
        env.execute();
    }
}
启动kafka生产者
bin/kafka-console-producer.sh --bootstrap-server hadoop102:9092 - -topic first
3、集成springBoot
SpringBoot 是一个在 JavaEE 开发中非常常用的组件。可以用于 Kafka 的生产者,也可以 用于 SpringBoot 的消费者。主要是从前端页面进行操作是获取数据或日志文件
连接信息在application.propeties中
4、集成spark
Spark 是一个在大数据开发中非常常用的组件。可以用于 Kafka 的生产者,也可以用于 Spark 的消费者。(主要使用scale语言编写)
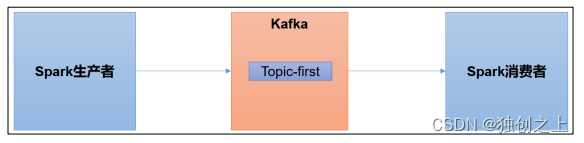
环境准备:在scale下创建项目,配置文件
<dependencies>
<dependency>
<groupId>org.apache.spark</groupId>
<artifactId>spark-streaming-kafka-0-10_2.12</artifactId>
<version>3.0.0</version>
</dependency>
</dependencies>
将 log4j.properties 文件添加到 resources 里面,就能更改打印日志的级别为 error
log4j.rootLogger=error, stdout,R
log4j.appender.stdout=org.apache.log4j.ConsoleAppender
log4j.appender.stdout.layout=org.apache.log4j.PatternLayout
log4j.appender.stdout.layout.ConversionPattern=%d{yyyy-MM-dd
HH:mm:ss,SSS} %5p --- [%50t] %-80c(line:%5L) : %m%n
log4j.appender.R=org.apache.log4j.RollingFileAppender
log4j.appender.R.File=../log/agent.log
log4j.appender.R.MaxFileSize=1024KB
log4j.appender.R.MaxBackupIndex=1
log4j.appender.R.layout=org.apache.log4j.PatternLayout
log4j.appender.R.layout.ConversionPattern=%d{yyyy-MM-dd
HH:mm:ss,SSS} %5p --- [%50t] %-80c(line:%6L) : %m%n
1)spark生产者(创建 scala Object:SparkKafkaProducer)
package com.atguigu.spark
import java.util.Properties
import org.apache.kafka.clients.producer.{KafkaProducer,
ProducerRecord}
object SparkKafkaProducer {
 def main(args: Array[String]): Unit = {
 // 0 kafka 配置信息
 val properties = new Properties()
 properties.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG,
"hadoop102:9092,hadoop103:9092,hadoop104:9092")
 properties.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG,
classOf[StringSerializer])
 properties.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG,
classOf[StringSerializer])
 // 1 创建 kafka 生产者
 var producer = new KafkaProducer[String, String](properties)
 // 2 发送数据
 for (i <- 1 to 5){
 producer.send(new
ProducerRecord[String,String]("first","atguigu" + i))
 }
 // 3 关闭资源
 producer.close()
 }
}
启动kafka消费者
bin/kafka-console-consumer.sh -- bootstrap-server hadoop102:9092 --topic first
执行 SparkKafkaProducer 程序,观察 kafka 消费者控制台情况
2)spark消费者
配置文件
<dependencies>
<dependency>
<groupId>org.apache.spark</groupId>
<artifactId>spark-streaming-kafka-0-10_2.12</artifactId>
<version>3.0.0</version>
</dependency>
<dependency>
<groupId>org.apache.spark</groupId>
<artifactId>spark-core_2.12</artifactId>
<version>3.0.0</version>
</dependency>
<dependency>
<groupId>org.apache.spark</groupId>
<artifactId>spark-streaming_2.12</artifactId>
<version>3.0.0</version>
</dependency>
</dependencies>
创建 scala Object:SparkKafkaConsumer
package com.atguigu.spark
import org.apache.kafka.clients.consumer.{ConsumerConfig, ConsumerRecord}
import org.apache.kafka.common.serialization.StringDeserializer
import org.apache.spark.SparkConf
import org.apache.spark.streaming.dstream.{DStream, InputDStream}
import org.apache.spark.streaming.{Seconds, StreamingContext}
import org.apache.spark.streaming.kafka010.{ConsumerStrategies, KafkaUtils, LocationStrategies}
object SparkKafkaConsumer {
 def main(args: Array[String]): Unit = {
 //1.创建 SparkConf
 val sparkConf: SparkConf = new
SparkConf().setAppName("sparkstreaming").setMaster("local[*]")
 //2.创建 StreamingContext
 val ssc = new StreamingContext(sparkConf, Seconds(3))
 //3.定义 Kafka 参数:kafka 集群地址、消费者组名称、key 序列化、value 序列化
 val kafkaPara: Map[String, Object] = Map[String, Object](
 ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG ->
"hadoop102:9092,hadoop103:9092,hadoop104:9092",
 ConsumerConfig.GROUP_ID_CONFIG -> "atguiguGroup",
 ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG ->
classOf[StringDeserializer],
 ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG ->
classOf[StringDeserializer]
)
//4.读取 Kafka 数据创建 DStream
 val kafkaDStream: InputDStream[ConsumerRecord[String, String]] =
KafkaUtils.createDirectStream[String, String](
 ssc,
 LocationStrategies.PreferConsistent, //优先位置
 ConsumerStrategies.Subscribe[String, String](Set("first"), kafkaPara)// 消费策略:(订阅
多个主题,配置参数)
 )
 //5.将每条消息的 KV 取出
 val valueDStream: DStream[String] = kafkaDStream.map(record => record.value())
 //6.计算 WordCount
 valueDStream.print()
 //7.开启任务
 ssc.start()
 ssc.awaitTermination()
 }
}
启动 SparkKafkaConsumer 消费者,启动kafka生产者,在idea控制台查看数据打印。
bin/kafka-console-producer.sh --bootstrap-server hadoop102:9092 - -topic first

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献6条内容

所有评论(0)