机器人“看十遍就会”:CoRL 2025研究突破少样本学习瓶颈
论文标题: ControlVLA: Few-shot Object-centric Adaptation for Pre-trained Vision-Language-Action Models
研究单位: 北京通用人工智能研究院 (BIGAI)、清华大学、星尘智能 (Astribot Inc.) 等
论文链接: https://arxiv.org/abs/2506.16211
项目主页: https://controlvla.github.io
摘要
学习真实世界中的机器人操作是一项极具挑战性的任务,尤其是在演示数据有限的情况下。现有方法通常依赖仿真增强数据或预设的抓取模块,这些方法不仅难以克服“仿真到现实”的差异,也缺乏可扩展性。虽然大规模模仿学习预训练的视觉-语言-动作 (Vision-Language-Action, VLA) 模型展现了通用潜力,但在数据稀缺场景下如何高效地将这些通用策略适配于特定任务,仍是一个待解决的难题。
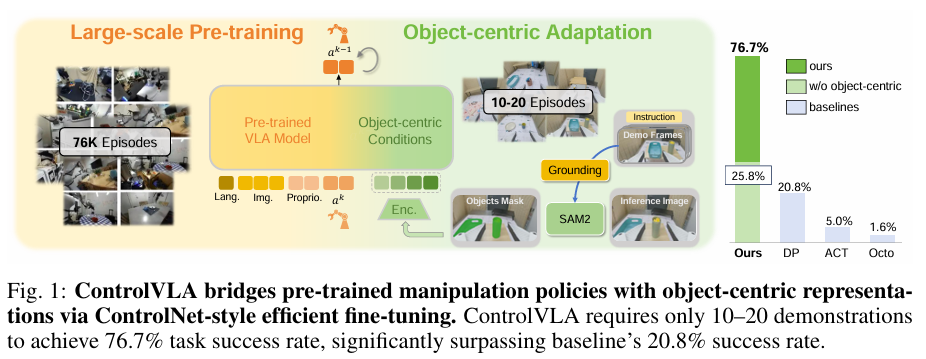
为应对此挑战,研究团队提出了 ControlVLA,一种新颖的、以物体为中心进行适配的微调框架。该框架通过一种类似 ControlNet 的架构,将预训练的 VLA 模型与物体中心表征连接起来,实现了高效的少样本学习。具体而言,ControlVLA 通过对一组投影层进行零初始化,在不覆盖模型先验知识的前提下,引入物体中心的条件信息,从而渐进式地适配预训练的操作策略。在涵盖倒水、叠衣服等 8 项真实世界任务的实验中,ControlVLA 仅需 10-20 次人类示范,即可达到 76.7% 的平均成功率。实验结果同时证明了该框架在长时序任务和对未见物体的泛化能力上的鲁棒性。
一、 研究背景
机器人操作领域的核心挑战之一是减少对大量演示数据的依赖。现有方法或通过仿真来增强数据,但这需要精确的物体 3D 模型和位姿估计,在真实场景中难以满足;或直接采用模仿学习,但将通用 VLA 模型微调至下游任务时,依然需要大量的特定数据。
另一方面,以物体为中心 (object-centric) 的表征方法,通过让模型关注物体的形状、大小和位置等关键属性,降低了输入空间的复杂性,提升了策略的鲁棒性。然而,现有物体中心方法由于缺乏动作先验,通常仍需数百次演示数据才能有效学习。
ControlVLA 的提出旨在弥合大规模 VLA 模型预训练与高效物体中心适配之间的鸿沟,使机器人能够从极少量的人类示范中快速习得复杂技能。
二、 研究方法
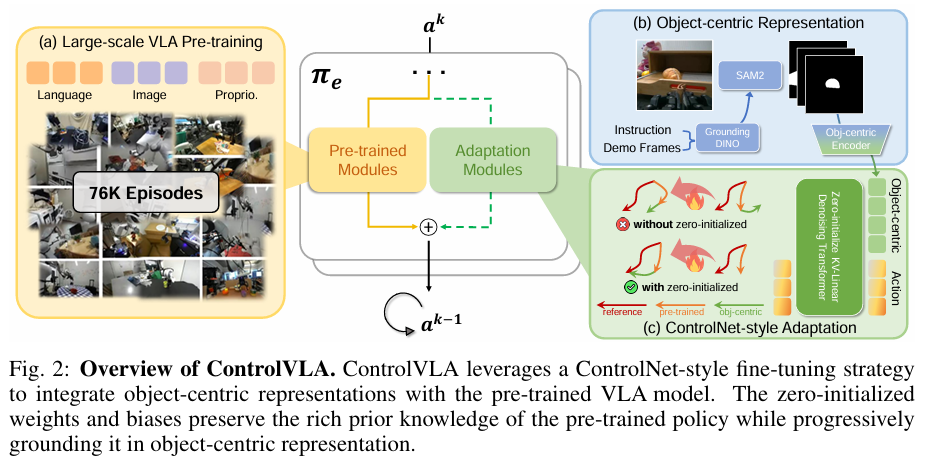
ControlVLA 框架旨在将一个预训练的通用策略 πg\pi_gπg 高效地适配为特定任务的专家策略 πe\pi_eπe。其核心工作流程分为三个步骤:
1. 大规模 VLA 模型预训练 (VLA Model Pre-training)
首先,使用大规模、多任务的操作数据集 (如 DROID 数据集) 预训练一个通用的 VLA 策略模型 πg\pi_gπg。该模型采用扩散变换器 (diffusion transformer) 架构,学习从观测(包括单视角 RGB 图像 ItI_tIt、语言指令 ltl_tlt 和机器人本体状态 qtq_tqt)到动作序列的条件分布 p(At∣Ot)p(A_t | O_t)p(At∣Ot),为后续任务提供强大的技能先验。
2. 物体中心表征提取 (Object-centric Representations)
为了让模型精确聚焦于任务相关物体,需要构建物体中心表征 ZZZ 作为额外的动作条件。
- 分割与跟踪: 利用 GroundingDINO 和 SAM2 模型,根据少量示范帧和语言指令,自动地对任务相关物体进行分割和持续跟踪,获取其实例掩码 MiM_iMi。
- 特征提取: 为每个物体提取两种特征:
- 位置特征 (zposi)(z_{pos}^i)(zposi): 对物体掩码的中心点坐标进行正弦位置编码。
- 几何特征 (zgeoi)(z_{geo}^i)(zgeoi): 使用一个卷积神经网络 (CNN) 对每个物体的掩码进行处理,提取其空间几何信息。
最终,将两种特征拼接成该物体的中心表征 zi=[zposi,zgeoi]z^i = [z_{pos}^i, z_{geo}^i]zi=[zposi,zgeoi]。
3. ControlNet 风格的微调适配 (ControlNet-style Fine-tuning)
这是 ControlVLA 的核心机制。在预训练 VLA 模型的交叉注意力模块中,引入一个双重注意力结构,以融合物体中心表征 ZZZ。原始的交叉注意力机制可表示为:
softmax(QKTd)V
\text{softmax}\left(\frac{QK^T}{\sqrt{d}}\right)V
softmax(dQKT)V
其中 QQQ 是动作的查询投影,KKK 和 VVV 是观测的键和值投影。为了引入物体中心表征 ZZZ,该机制被扩展为:
softmax(QKTd)V+softmax(QKzTd)Vz
\text{softmax}\left(\frac{QK^T}{\sqrt{d}}\right)V + \text{softmax}\left(\frac{QK_z^T}{\sqrt{d}}\right)V_z
softmax(dQKT)V+softmax(dQKzT)Vz
这里的 KzK_zKz和 VzV_zVz 是物体中心表征 ZZZ 对应的键和值投影,由一组新增的投影层计算得出 (Kz,Vz=WzZ+BzK_z, V_z = W_z Z + B_zKz,Vz=WzZ+Bz)。
关键在于,这组新增投影层的权重 WzW_zWz 和偏置 BzB_zBz 被 零初始化 (zero-initialized)。这意味着在微调的第一步:
Kz=WzZ+Bz=0,Vz=0
K_z = W_z Z + B_z = 0, \quad V_z = 0
Kz=WzZ+Bz=0,Vz=0
此时,双重注意力机制退化为原始的交叉注意力形式,完全保留了预训练模型的先验知识,避免了在微调初期引入有害噪声。随着训练的进行,这部分权重会逐步学习,稳定地将物体信息融入策略生成中。
三、 实验结果
研究团队在星尘智能的 AI 机器人 Astribot S1 上进行了开发与测试,并在一个包含 8 项真实世界任务的评估基准上验证了 ControlVLA 的性能。这些任务涵盖了刚体、软体、关节物体、可变形物体和流体等多种复杂操作场景。
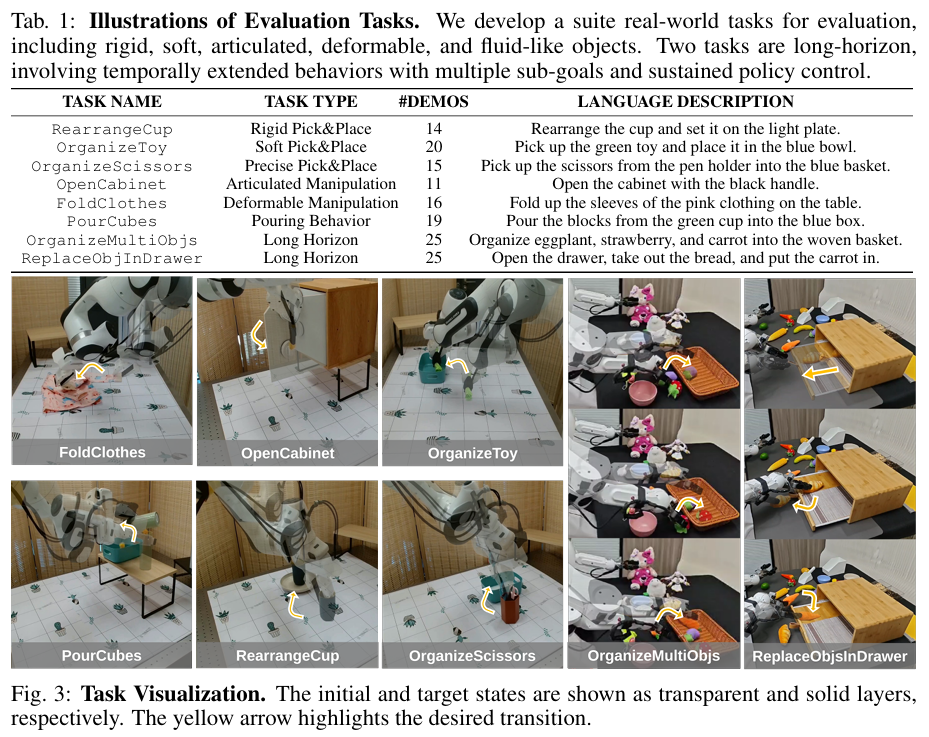
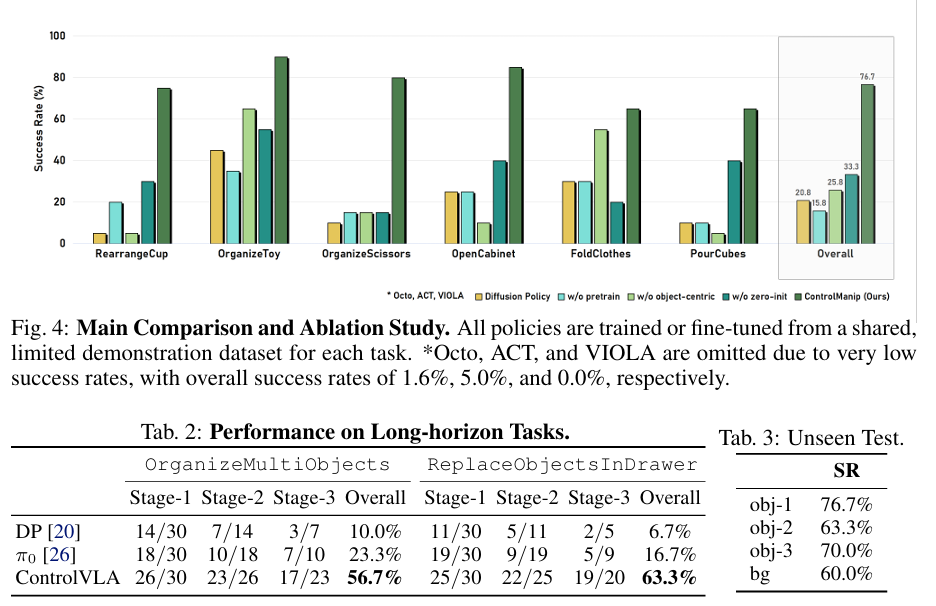
- 短时序任务性能: 在 6 个短时序任务中(如整理杯子、放置剪刀、叠衣服、倒方块等),ControlVLA 仅用 10-20 条演示数据,就取得了 76.7% 的总体成功率,显著优于基线方法(如 Diffusion Policy 的 20.8%)。
- 长时序任务性能: 在两个需要多步骤顺序执行的长时序任务(整理多种物体、替换抽屉内物体)中,ControlVLA 的平均成功率达到 60%,是当时最优方法的近 3 倍,展现了其在长序列执行中减少误差累积的能力。
- 数据效率: 在“整理玩具”任务中,ControlVLA 使用 20 条演示数据即可达到 80% 的成功率,而其他基线方法即使使用 100 条数据也未能达到同等水平,这表明该框架能大幅降低机器人训练所需的数据采集成本。
- 泛化能力: 针对未见过的物体(如面包、香蕉)和新的背景环境,经过训练的 ControlVLA 模型依旧能保持 60%-70% 的任务成功率,展示了其在动态变化环境下的鲁棒性。
四、 结论
ControlVLA 框架通过结合 VLA 模型的强大先验知识和物体中心表征的精确引导,并利用 ControlNet 风格的微调方法实现了二者的稳定融合,成功解决了在少样本场景下高效适配机器人操作策略的难题。实验证明,该方法显著降低了对大规模演示数据的依赖,提升了机器人在复杂、长时序任务以及动态环境中的鲁棒性,为通用机器人在真实世界的部署和应用提供了更具可行性的技术路径。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 24
 0
- 0


 已为社区贡献8条内容

所有评论(0)