强化学习(RL)入门基础
强化学习是什么?
强化学习(Reinforcement Learning, RL) 是机器学习的一个分支,目标是让智能体(agent)通过与环境(environment)的交互来学习最优的行为策略(policy),从而最大化某个累积回报(cumulative reward)。
其核心思想是通过试错和反馈的机制,找到在每个情境下的最优决策。
强化学习的优化目标是通过选择策略来最大化累积奖励。 具体来说,智能体的目标是寻找一个最优策略 ,使得它在各个状态下的累积回报最大。形式上,可以用**价值函数(Value Function)或动作价值函数**(Q函数)来表示。
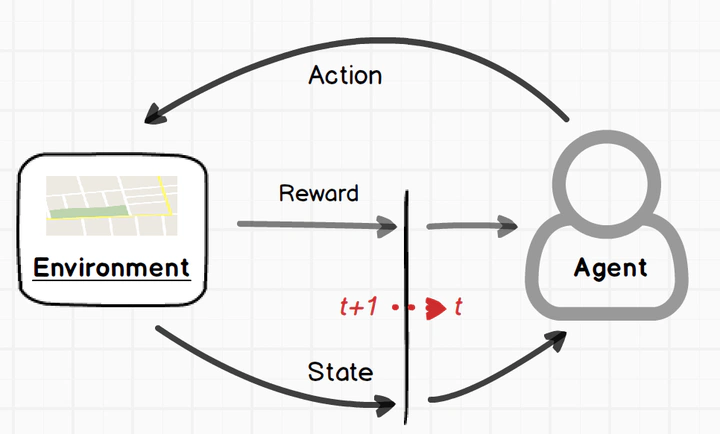
强化学习的要素
在强化学习中,我们通常将问题描述为一个**马尔可夫决策过程**(Markov Decision Process, MDP),它包含以下几个关键元素:
- 状态(State, S):智能体所处的环境状态,可能是游戏画面的一帧,也可能是机器人观测到的传感器数据。
- 动作(Action, A):智能体在给定状态下可以执行的一系列操作。
- 状态转移(Transition Dynamics, P):从当前状态s采取动作a后,会以一定的概率转移到下一个状态s’。
- 奖励(Reward, R):智能体在每个时刻(或每次转移)获得的即时回报,反映了该动作在此状态下的好坏。
- 折扣因子(Discount Factor, ):用于平衡当前奖励和未来奖励的重要性,数值通常在 (0, 1] 之间。
- **轨迹(Trajectory):**在强化学习中,智能体从环境的初始状态开始,与环境交互直至到达终止状态所经历的一系列状态、动作以及相应的奖励就构成了一条完整的“轨迹”。
- **经验(Experience):**智能体可与环境交互多次,进行多次实验,形成多个轨迹。多个轨迹的集合被称为经验。
- **回报(Return):**强化学习的目标是学习一个好的策略,智能体按照这样的策略和环境交互,让累积奖励达到最大。这个累积奖励就是回报。通常现在的奖励和将来的奖励权重是不同的,比如今天奖励1万元和50年后奖励1万元,两者的价值大概率不同。因此会加上折扣因子。
其中折旧因子用于平衡当前奖励和未来奖励的重要性。如果没有折扣,那么回报就是从时间步开始直到回合结束所获得的总奖励。在有了回报概念后,我们知道,强化学习的目标是最大化期望回报。
- 价值函数(Value Function):价值函数衡量的是“期望回报”。具体分为状态价值函数和动作价值函数。
- 状态价值函数表示在状态 s 下,后续按照策略行动所能获得的期望回报;
- 动作价值函数表示在状态 s 下执行动作 a,并在之后按照策略行动所能获得的期望回报;
- V用来评价在某个状态下的策略表现好坏。Q用来评价在某个状态-动作对下的策略表现好坏。价值的估计至关重要,下文还会讨论。
- **优势函数(Advantage Function)****:优势函数度量的是,在给定状态 s 下,执行某个动作 a 比起在该状态的平均水平(即状态价值)好多少或差多少。它的常见形式是:
- 如果 大于 0,说明在状态 s 下执行动作 a 要比该状态的平均策略价值要好。
- 如果 小于 0,则说明这个动作比“平均”水平要差。
- 探索(Exploration)和学习(Learning):强化学习一般分为两个阶段。第一个是探索阶段,智能体先按照某些策略和环境进行交互,形成经验。第二个是学习阶段,智能体按照某些算法,从经验中学习,进而优化自己的策略。
- 行为策略(Behavior Policy)和目标策略(Target Policy):行为策略是智能体在环境交互时实际执行的策略。目标策略是智能体最终想要学到的策略。两个策略相同就是on-policy,否则就是off-policy,这点我们在下文中会详细探讨。
A、Q、V的关系
优势函数(A)与值函数(V)、动作值函数(Q)的区别的联系:优势函数是Q和V的差值。A=Q-V
优势函数与值函数、动作值函数的区别:
- 值函数(V):衡量一个状态的价值,反映了在某个状态下,智能体根据当前策略所能期望得到的总回报。
- 动作值函数(Q):直接衡量在某状态下采取某动作后,智能体所能期望得到的总回报。
- 优势函数(A):是一个动作对比的度量,表明选择某个动作相较于平均策略的回报增益。和V、Q不同的是,A提供了一个相对的评价。
估计值函数的三种方法:MC、TD、GAE
RL中,价值的估计非常重要。估计值函数的常见方法有三种:蒙特卡洛(MC)、时间差分(TD)、广义优势估计(GAE)。
它们在估计值函数时各有优缺点,具体在方差和偏差之间存在不同的权衡。
1. 蒙特卡洛方法(MC)
原理:蒙特卡洛方法通过在完整的轨迹上计算回报(即从当前状态开始到最终状态的累积奖励)来估计状态值函数或动作值函数。这个方法完全依赖于最终的回报,因此需要等待完整的路径(完整的Episode)来计算值。
优点:
- 不需要任何模型假设,直接依赖实际回报。
- 在长期内是无偏的(即期望值是正确的),因为它直接使用实际的累积奖励。
缺点:
- 高方差:由于只使用每个Episode的最终回报,导致每个回报的估计可能存在较大波动,尤其是在奖励信号稀疏或变动较大的情况下,估计的方差较大。
总结:MC方法因为依赖完整的回报,所以它的估计有较大的方差,但没有偏差。
2. 时序差分方法(TD)
原理:时序差分方法则是通过递推更新(也称为bootstrapping)来估计值函数,它并不需要等待完整的Episode,而是根据每一步的即时反馈进行更新。TD方法将当前的估计值与下一时刻的估计值进行比较,通过差分来更新当前状态的值。
优点:
- 较低的方差:由于TD方法使用每一步的即时反馈,它不依赖于完整Episode的回报,估计过程可以在更短时间内进行,因而方差较小。
- 可以在线学习,不需要等待完整的Episode。
缺点:
- 高偏差:由于TD方法使用的是估计值而非真实回报,它会引入一定的偏差。特别是它依赖当前的估计来更新,因此如果初始估计有偏,后续的更新也会继承这个偏差。
总结:TD方法具有较低的方差,但它引入了偏差,因为它依赖于现有的估计,而非实际的回报。
3. 广义优势估计(GAE)
原理:GAE是一种折中方法,它结合了MC和TD的方法,旨在通过平衡方差和偏差来提高估计的稳定性和效率。GAE通过引入一个超参数 (类似于TD方法中的折扣因子),在计算优势函数时利用TD方法的部分信息,而不是完全依赖于真实的回报。
具体来说,GAE通过对TD误差进行加权平均来估计优势函数,从而减少单步TD误差带来的偏差,并控制方差的大小。其中, 表示每一步的TD误差, 是折扣因子, 是用于加权的超参数,控制了TD和MC的折中。
优点:
- 在方差和偏差之间取得了更好的折中。通过调节 ,GAE可以灵活控制偏差和方差之间的权衡。
缺点:
- 相较于纯粹的TD或MC,GAE需要更多的计算,因为它需要在每一步计算加权的TD误差。
总结:GAE通过加权TD误差,能够在MC的低偏差和TD的低方差之间取得一个折中。
一个简单的例子:假设我们有一个机器人学习在迷宫中导航。值函数表示从某个位置开始,机器人能获得多少总奖励。
- MC方法:让机器人多次从起点走到终点,记录每次的总奖励,然后平均这些奖励来估计每个位置的值。这就像考试后看总分,但每次考试难度不同,所以分数波动大(高方差)。
- TD方法:机器人每走一步就更新值估计。例如,从位置A走到位置B,获得奖励R,然后使用位置B的当前值来更新位置A的值。这就像在考试中每答一题就估计最终分数,但估计可能不准(有偏差),但波动小(低方差)。
- GAE方法:结合多步的奖励和值估计,通过λ控制看多远。λ=0时纯TD,λ=1时纯MC。这就像在考试中不仅看当前题目的得分,还考虑后续题目的估计,但调整权重。
最后,总结它们的权衡:
- MC:高方差,无偏差
- TD:低方差,有偏差
- GAE:可调偏差和方差
NLP中的RL
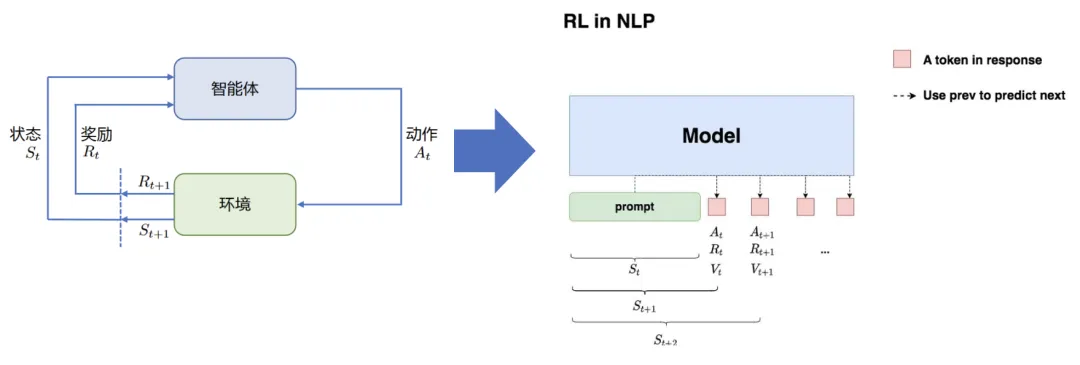
**状态S:**输入prompt
**动作A:**输出response(即LLM输出下一个token)
**奖励R:**根据prompt+response进行奖励模型打分
整体目标:给定prompt,调整policy,生成符合人类喜好(RM偏序信号)的response
回想一下我们对NLP任务做强化学习(RLHF)的目的:我们希望给模型一个prompt,让模型能生成符合人类喜好的response。再回想一下gpt模型做推理的过程:每个时刻 只产生一个token,即token是一个一个蹦出来的,先有上一个token,再有下一个token。
复习了这两点,现在我们可以更好解读上面这张图了:
- 我们先喂给模型一个prompt,期望它能产出符合人类喜好的response
- 在t时刻,模型根据上文,产出一个token,**这个token即对应着强化学习中的动作,我们记为A(t)。因此不难理解,在NLP语境下,强化学习任务的动作空间就对应着词表。
- 在t时刻,模型产出token A(t)对应着的即时收益为R(t),总收益为(**复习一下, 蕴含着“即时收益”与“未来收益”两个内容)。这个收益即可以理解为“对人类喜好的衡量”。此刻,**模型的状态从S(t)变为S(t+1),也就是从“上文”变成“上文 + 新产出的token”
- 在NLP语境下,智能体是语言模型本身,环境则对应着它产出的语料
经典强化学习算法的分类
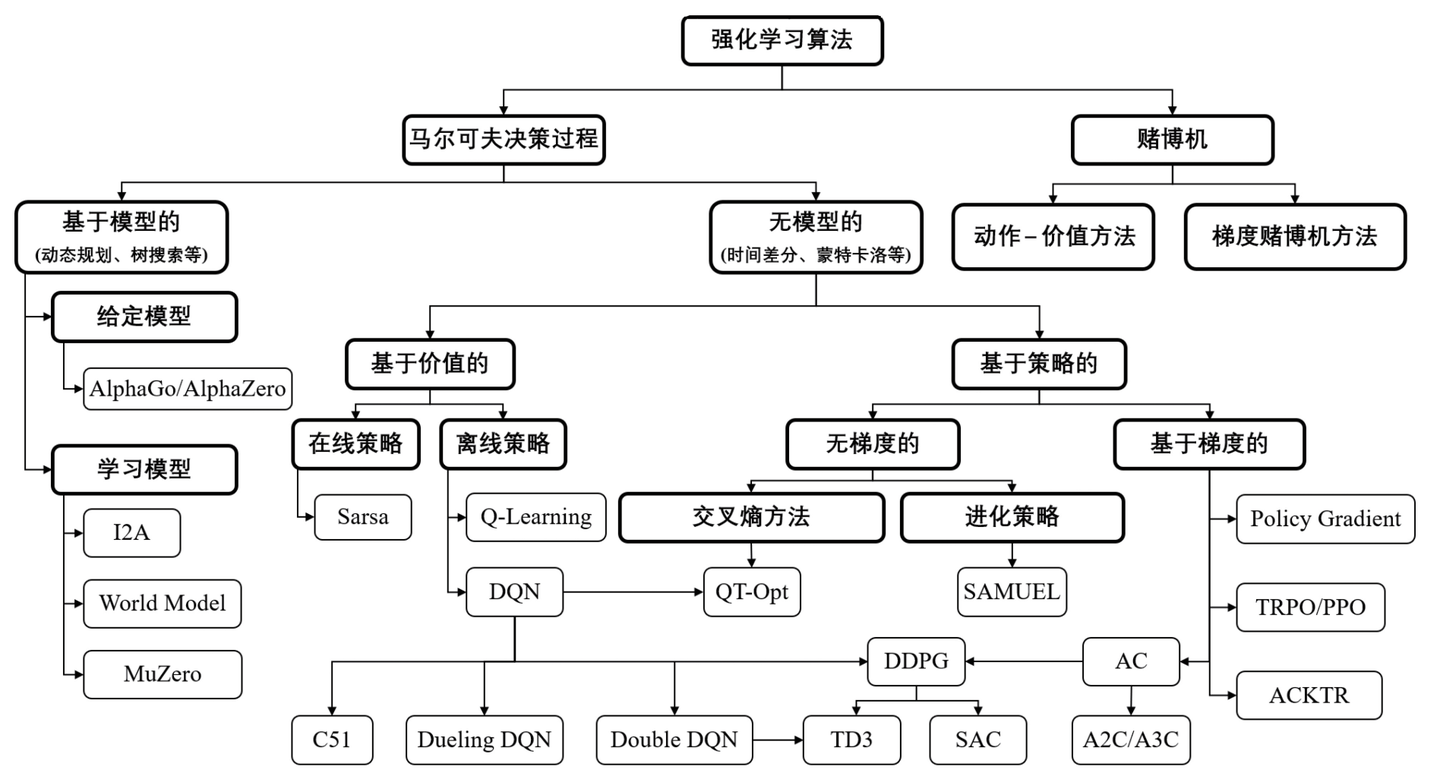
RL中的on-policy 和 off-policy有什么区别?
在强化学习中,on-policy 和 off-policy 的区别,核心在于“数据采样的策略(Policy)与学习的策略是否相同”。
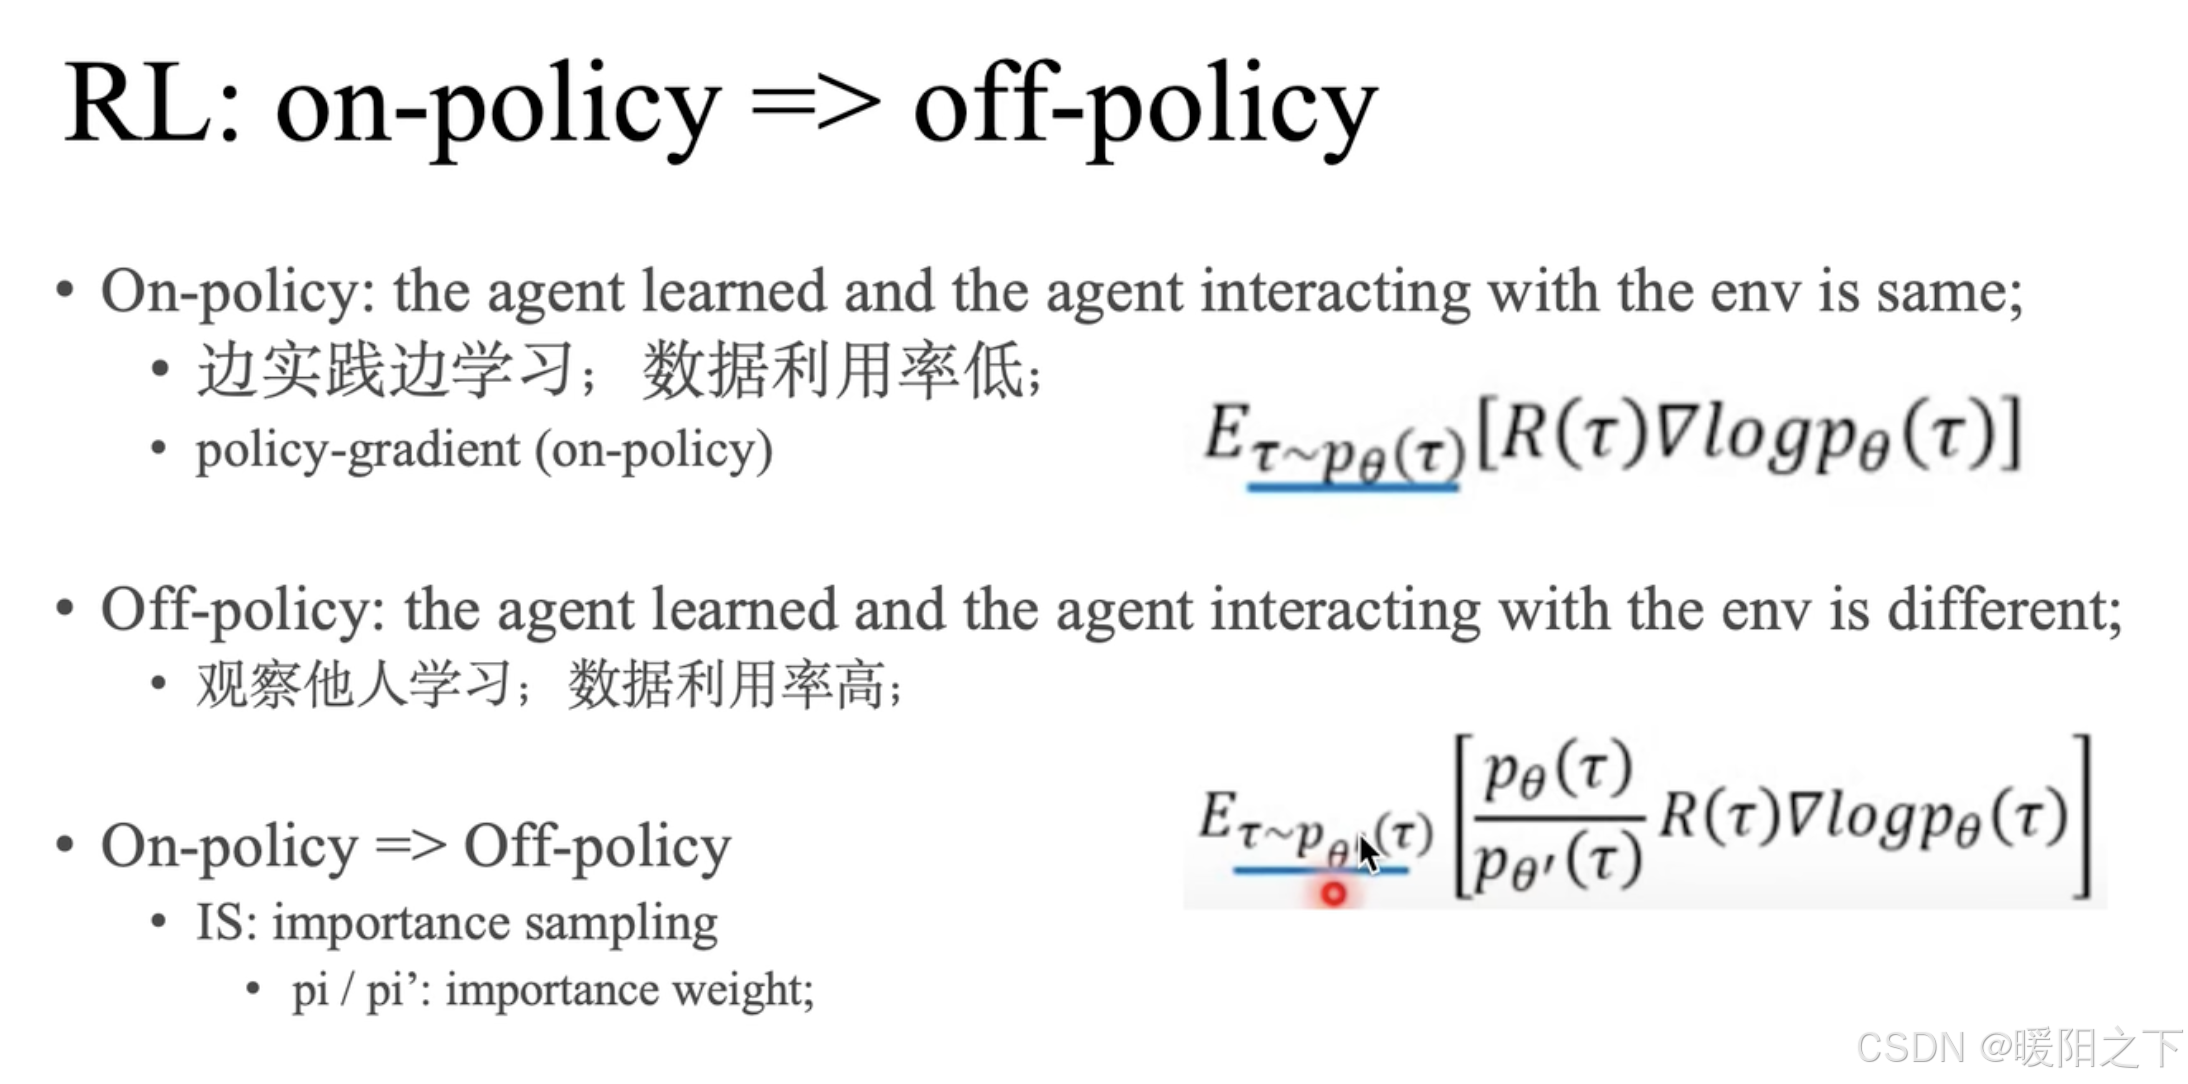
| 方面 | On-policy | Off-policy |
|---|---|---|
| 数据来源 | 必须来自当前模型策略生成 | 可以来自旧模型、人类写的样本或其他模型 |
| 典型方法 | PPO(RLHF 主流) | Q-learning 风格、离线 RL |
| 样本效率 | 低(采样一次只能用一次) | 高(历史数据可反复利用) |
| 稳定性 | 更稳定,偏保守 | 更高效,但不稳定性更大 |
| 应用场景 | RLHF 的 policy 微调 | 奖励模型训练、offline RLHF、结合多源数据的对齐 |
RL中的online和offline有什么区别?
| 特性 | Online RL(在线) | Offline RL(离线) |
|---|---|---|
| 核心区别 | 边交互边学习 | 从固定数据集中学习 |
| 数据来源 | 智能体自己实时生成 | 预先收集的静态数据集 |
| 与环境交互 | 是,持续交互 | 否,学习期间零交互 |
| 别名 | 交互式学习 | 批量学习(Batch RL) |
| 优点 | 数据新鲜,适应性强,能主动探索 | 安全,成本低,可利用历史数据 |
| 缺点 | 试错成本高,可能不安全,采样效率可能低 | 受数据质量限制,存在分布外(OOD)问题 |
| 类比 | 学开车:亲自上路练习 | 学开车:看驾驶教学录像 |
RLHF(RM+PPO)
RLHF 的全称是 Reinforcement Learning from Human Feedback,即基于人类反馈的强化学习。
RLHF的整体流程是什么?
RLHF主要分为奖励模型训练和**近端策略优化(Proximal Policy Optimization, PPO)**两个步骤。
- 奖励模型通过由人类反馈标注的偏好数据来学习人类的偏好,判断模型回复的有用性以及保证内容的无害性。奖励模型模拟了人类的偏好信息,能够不断地为模型的训练提供奖励信号。
- 在获得奖励模型后,需要借助强化学习对语言模型继续进行微调。近端策略优化可以根据奖励模型获得的反馈 优化模型,通过不断的迭代,让模型探索和发现更符合人类偏好的回复策略。
RLHF一般包括三个步骤:
- 有监督微调(SFT):使用高质量的对话数据对预训练模型进行微调,得到一个初始的对话模型。
- 奖励模型训练(RM):使用人类标注的偏好数据训练一个奖励模型,能够对模型生成的回答进行评分。
- 强化学习微调(RL):使用强化学习算法(如PPO)对SFT模型进行微调,以最大化奖励模型的得分,同时防止模型偏离SFT模型太远。在第三步RL中,我们会同时使用Reference Model和Actor Model。
RLHF中有哪些数据集?
RLHF中有三种数据集,分别是:
- 偏好数据集:用来训练奖励模型。
- 提示数据集:在PPO流程中用来训练LLM。
- 评估数据集:用来评估RLHF的效果。
RLHF中的四个重要角色
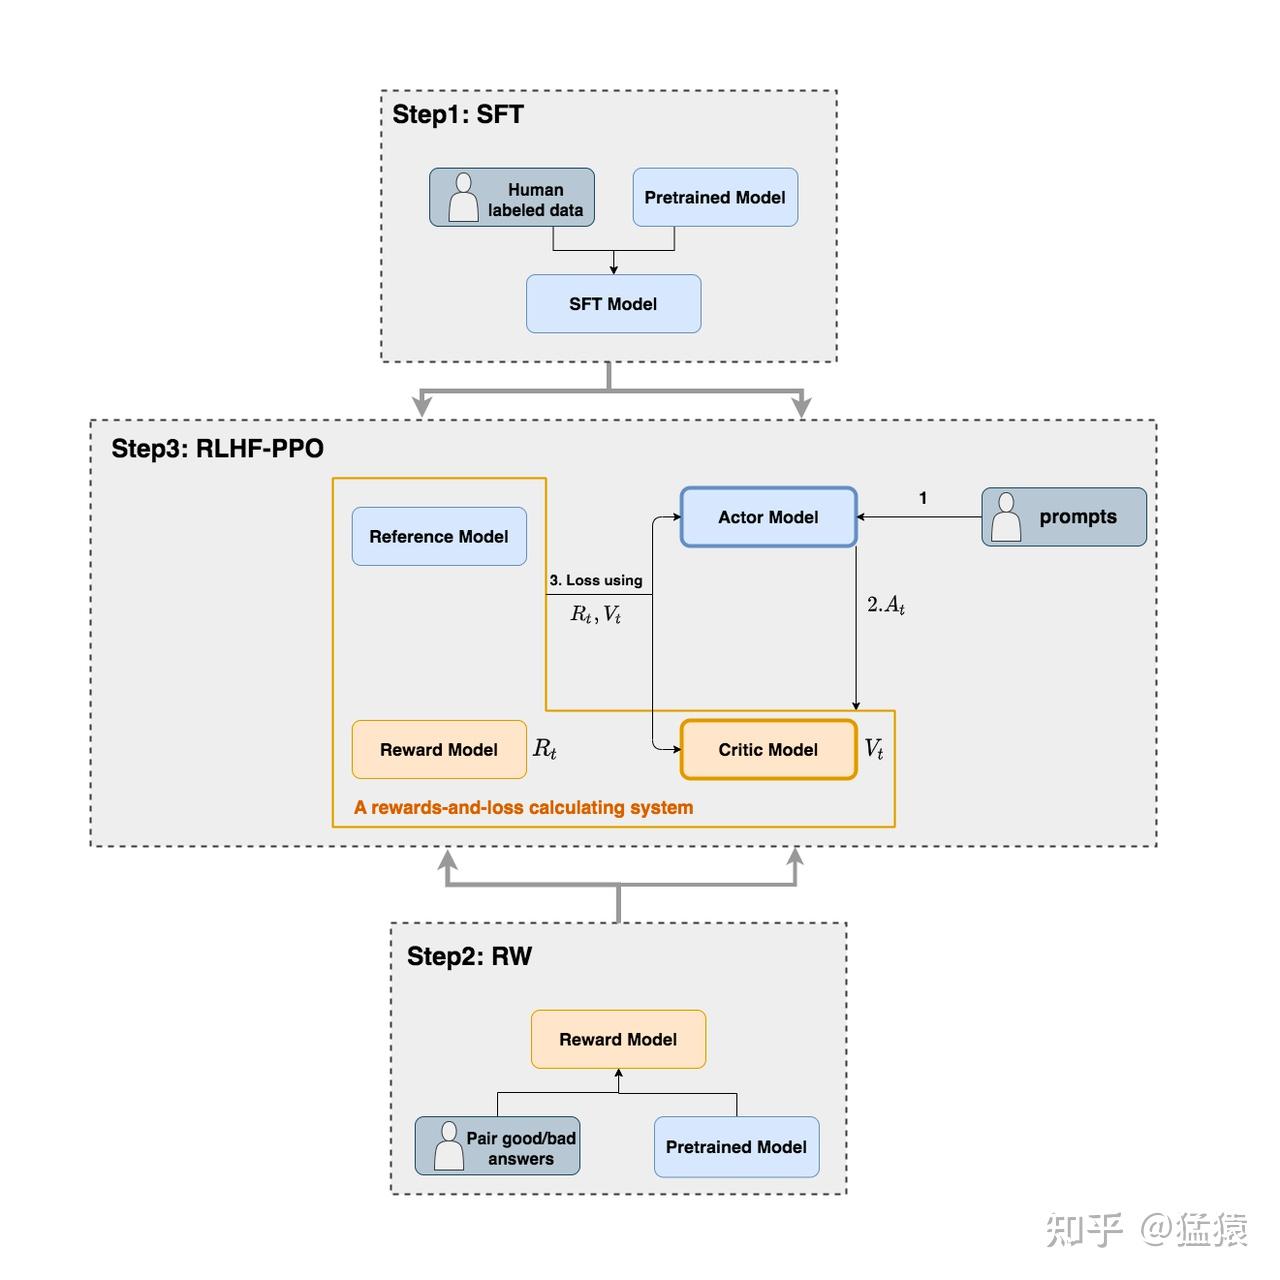
如上图,在RLHF-PPO阶段,一共有四个主要模型,分别是:
- Actor Model:演员模型,这就是我们想要训练的目标语言模型
- Critic Model:评论家模型,它的作用是预估总收益
- Reward Model:奖励模型,它的作用是计算即时收益
- Reference Model:参考模型,它的作用是在RLHF阶段给语言模型增加一些“约束”,防止语言模型训歪(朝不受控制的方向更新,效果可能越来越差)
- 策略模型(Policy Model,或Actor Model),生成模型回复。它就是RLHF训练希望产出的模型。在PPO训练中更新梯度。
- 奖励模型(Reward Model),输出奖励分数来评估回复质量的好坏。在PPO训练中不更新梯度。
- 评论模型(Critic Model,或Value Network),来预测回复的好坏,可以在训练过程中实时调整模型,选择对未来累积收益最大的行为。在PPO训练中更新梯度。
- **参考模型(Reference Model)**提供了一个 SFT 模型的备份,帮助模型不会出现过于极端的变化。在PPO训练中不更新梯度。
其中:
- Actor/Critic Model在RLHF阶段是需要训练的(图中给这两个模型加了粗边,就是表示这个含义);而Reward/Reference Model是参数冻结的。
- Critic/Reward/Reference Model共同组成了一个“奖励-loss”计算体系(为了方便理解),我们综合它们的结果计算loss,用于更新Actor和Critic Model
Actor Model (演员模型)
正如前文所说,Actor就是我们想要训练的目标语言模型。我们一般用SFT阶段产出的SFT模型来对它做初始化。
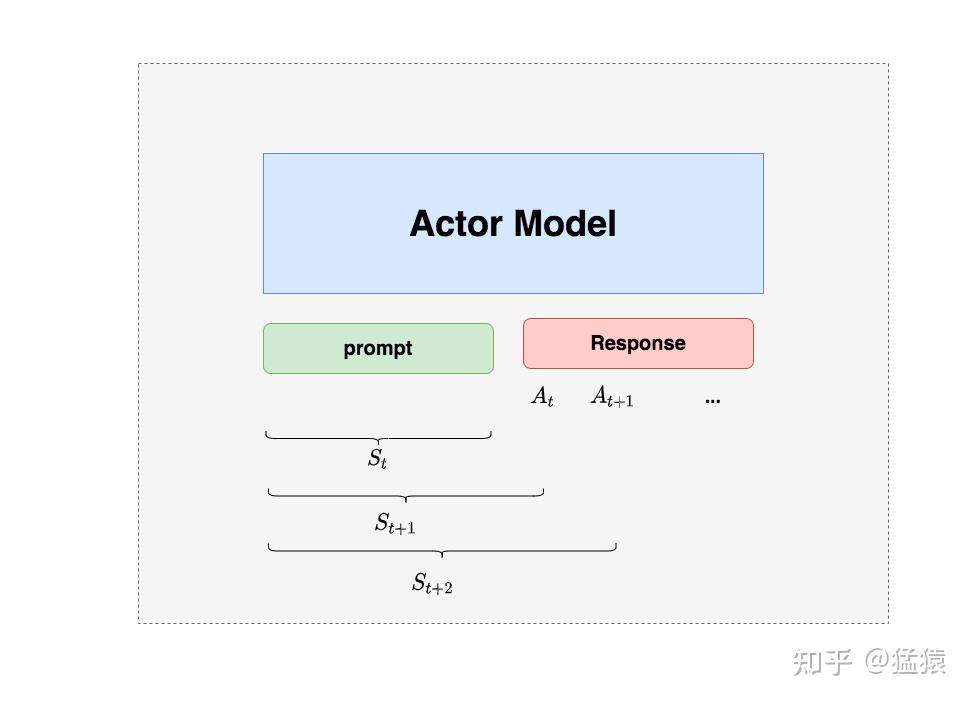
我们的最终目的是让Actor模型能产生符合人类喜好的response。所以我们的策略是,先喂给Actor一条prompt (这里假设batch_size = 1,所以是1条prompt),让它生成对应的response。然后,我们再将“prompt + response"送入我们的“奖励-loss”计算体系中去算得最后的loss,用于更新actor。
Reference Model(参考模型)
**Reference Model(以下简称Ref模型)一般也用SFT阶段得到的SFT模型做初始化,在训练过程中,它的参数是冻结的。**Ref模型的主要作用是防止Actor”训歪”,那么它具体是怎么做到这一点的呢?
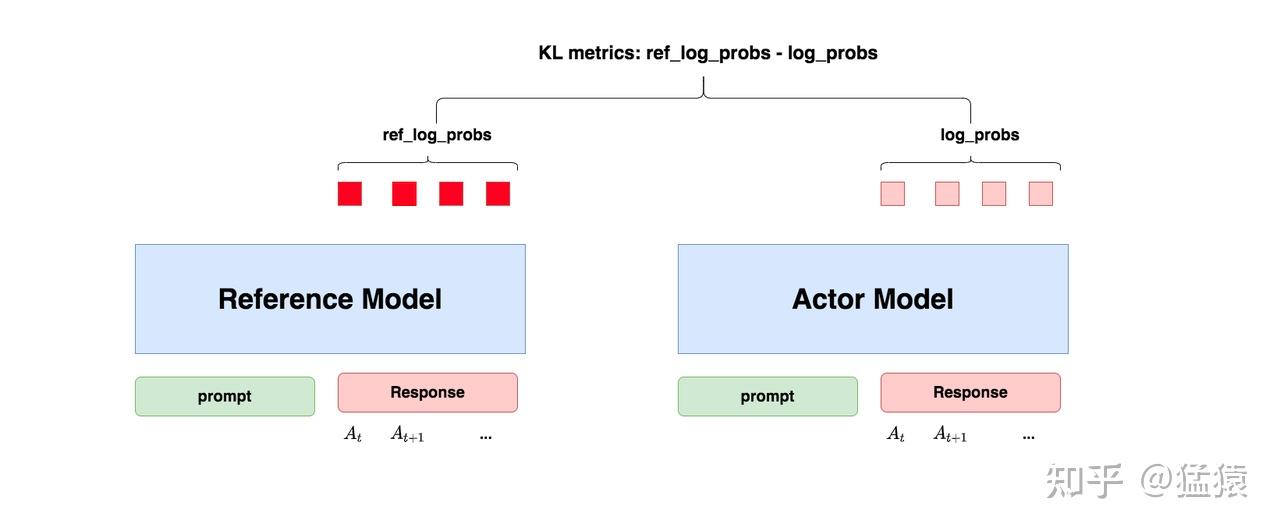
“防止模型训歪”换一个更详细的解释是:我们希望训练出来的Actor模型既能达到符合人类喜好的目的,又尽量让它和SFT模型不要差异太大。简言之,我们希望两个模型的输出分布尽量相似。那什么指标能用来衡量输出分布的相似度呢?我们自然而然想到了KL散度。KL散度 = Actor模型的log_prob - Reference模型的log_prob。
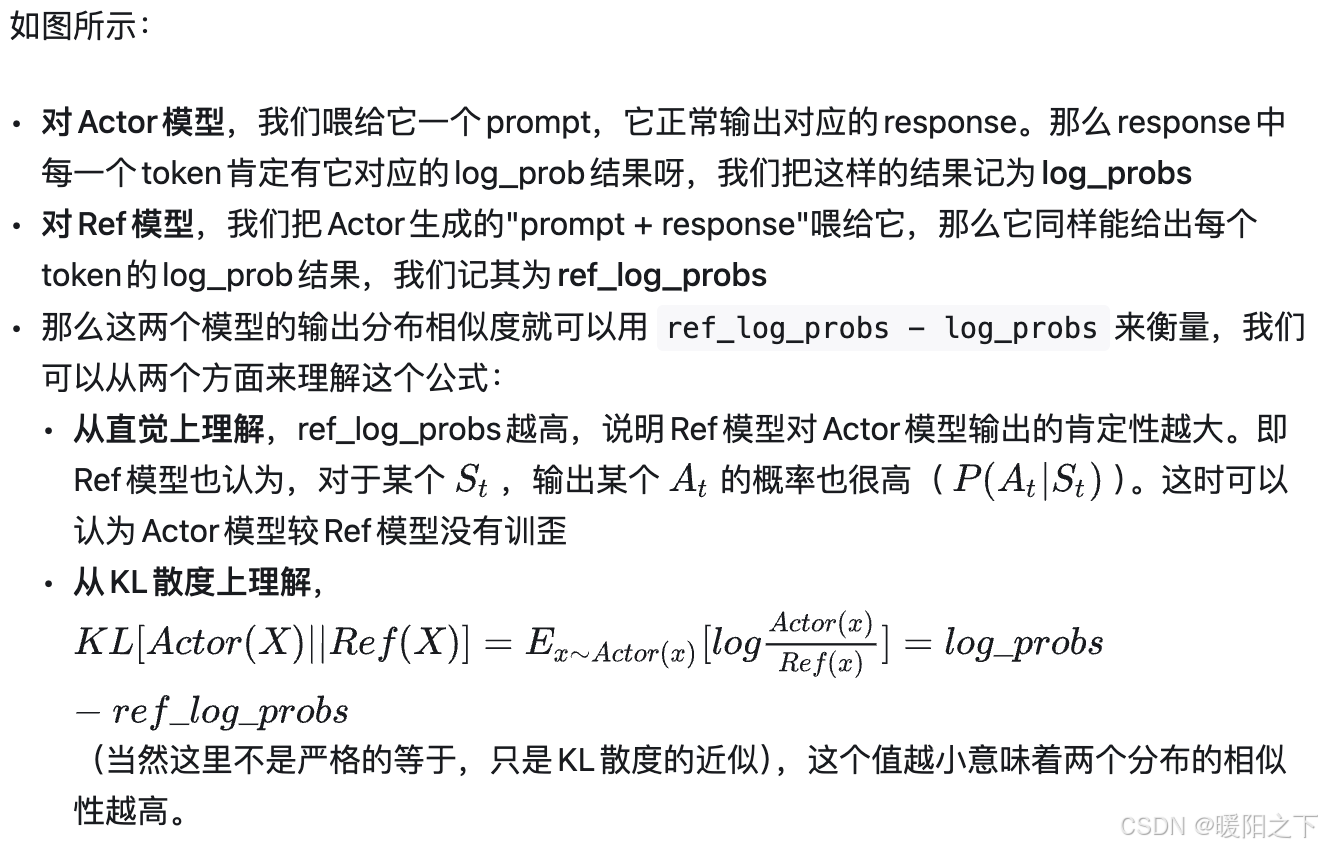
注:你可能已经注意到,按照KL散度的定义,这里写成log_probs - ref_log_probs更合适一些。但是如果你看过一些rlhf相关的论文的话,你可能记得在计算损失函数时,有一项 散度 (对这个有疑惑不要紧,我们马上在后文细说),即KL散度前带了负号,所以这里我写成ref_log_probs - log_probs这样的形式,更方便大家从直觉上理解这个公式。
现在,我们已经知道怎么利用Ref模型和KL散度来防止Actor训歪了。KL散度将在后续被用于loss的计算,我们在后文中会详细解释。
理解基础:log_prob
- 概率是什么?
当语言模型生成文本时,在每个位置,它都会从词汇表中选择一个词(token)。比如:
- 输入:“今天天气”
- 模型可能输出:“很好”(概率0.4)、“不错”(概率0.3)、“糟糕”(概率0.2)等
这里的0.4、0.3、0.2就是概率 - 模型认为各个选项的可能性。
- 为什么要用log_prob?
问题:概率值很小,连乘会数值下溢!
- 假设生成10个token,每个概率0.1
- 总概率 = 0.1 × 0.1 × … × 0.1 = 0.0000000001(非常小!)
解决方案:取对数!
- log(0.1) = -2.3026
- 10个token的总log_prob = -2.3026 × 10 = -23.026
- 数值稳定,便于计算!
log_prob就是概率的对数值,是深度学习中的标准做法。
假设我们让Actor模型生成回答:“我喜欢RL”。Actor模型的log_probs:
输入prompt: "解释强化学习"
生成过程:
- "我"的log_prob: -1.2   (对应概率≈0.30)
- "喜"的log_prob: -0.8   (对应概率≈0.45)
- "欢"的log_prob: -0.9   (对应概率≈0.41)
- "R"的log_prob: -2.1    (对应概率≈0.12)
- "L"的log_prob: -1.8    (对应概率≈0.17)
Critic Model(评论家模型)
Critic Model用于预测期望总收益 ,和Actor模型一样,它需要做参数更新。实践中,Critic Model的设计和初始化方式也有很多种,例如和Actor共享部分参数、从RW阶段的Reward Model初始化而来等等。我们讲解时,和deepspeed-chat的实现保持一致:从RW阶段的Reward Model初始化而来。
你可能想问:训练Actor模型我能理解,但我还是不明白,为什么要单独训练一个Critic模型用于预测收益呢?
这是因为,当我们在前文讨论总收益 (即时 + 未来)时,我们是站在上帝视角的,也就是客观存在的、真正的总收益。但是我们在训练模型时,就没有这个上帝视角加成了,也就是在t时刻,我们给不出客观存在的总收益**,我们只能训练一个模型去预测它。**
所以总结来说,在RLHF中,我们不仅要训练模型生成符合人类喜好的内容的能力(Actor),也要提升模型对人类喜好量化判断的能力(Critic)。这就是Critic模型存在的意义。我们来看看它的大致架构:
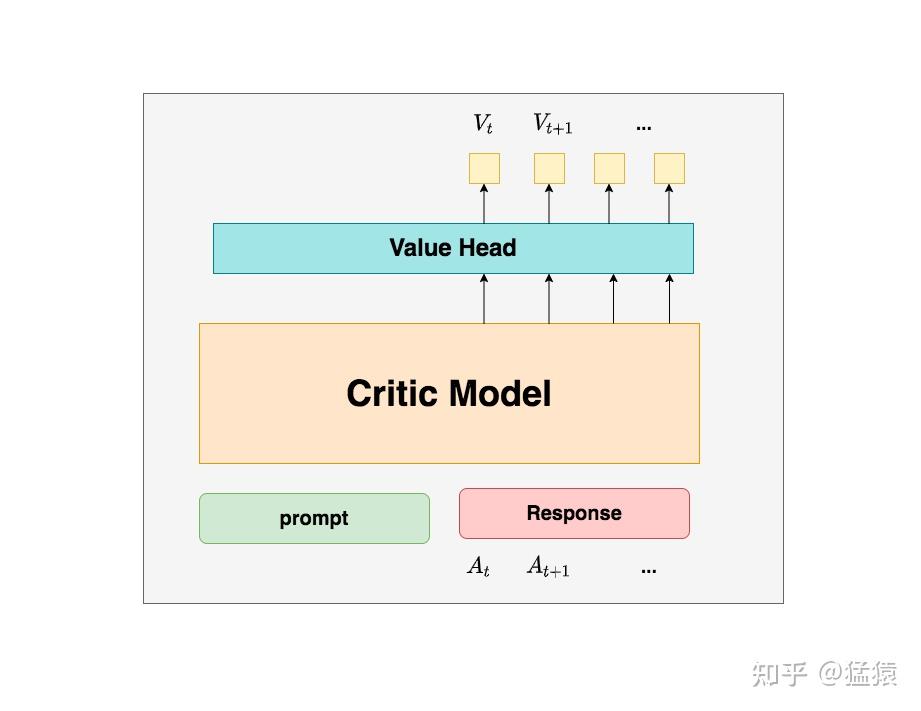
deepspeed-chat采用了Reward模型作为它的初始化,所以这里也按Reward模型的架构来简单画画它。你可以简单理解成,Reward/Critic模型和Actor模型的架构是很相似的(毕竟输入都一样),同时,它在最后一层增加了一个Value Head层,该层是个简单的线形层,用于将原始输出结果映射成单一的Vt值。
在图中,Vt表示Critic模型对t时刻及未来(response完成)的收益预估。
Reward Model(奖励模型)
Reward Model用于计算生成token 的即时收益,它就是RW阶段所训练的奖励模型,在RLHF过程中,它的参数是冻结的。
你可能想问:为什么Critic模型要参与训练,而同样是和收益相关的Reward模型的参数就可以冻结呢?
这是因为,Reward模型是站在上帝视角的。这个上帝视角有两层含义:
- 第一点,Reward模型是经过和“估算收益”相关的训练的,因此在RLHF阶段它可以直接被当作一个能产生客观值的模型。
- 第二点,Reward模型代表的含义就是“即时收益”,你的token已经产生,因此即时收益自然可以立刻算出。
通俗理解:
Reward Model
- 客观标准的守护者
- Reward Model在RW阶段已经学会了"什么是好回答"
- 它就像考试评分标准:一旦制定,在整个考试期间保持不变
- 如果我们在RLHF过程中也更新Reward Model,就相当于在考试中不断修改评分标准,那学习目标就混乱了!
- 即时收益的计算器
- Reward Model只看当前生成的文本,给出一个最终得分
- 它回答:“这个回答质量如何?” → 给出分数
- 不需要考虑"接下来会怎样",所以不需要随着Actor的变化而调整
Critic Model
- 价值预估的专家
- Critic要预测:“从这个状态开始,期望能获得多少累积奖励?”
- 它回答:“如果我现在处在对话的这个位置,预计最终能得多少分?”
- 需要适应变化的策略
- 当Actor模型不断更新时,生成策略在变化
- 同样的对话状态,不同策略下的未来收益预期完全不同
- 所以Critic必须跟着训练,才能准确预估当前策略的价值
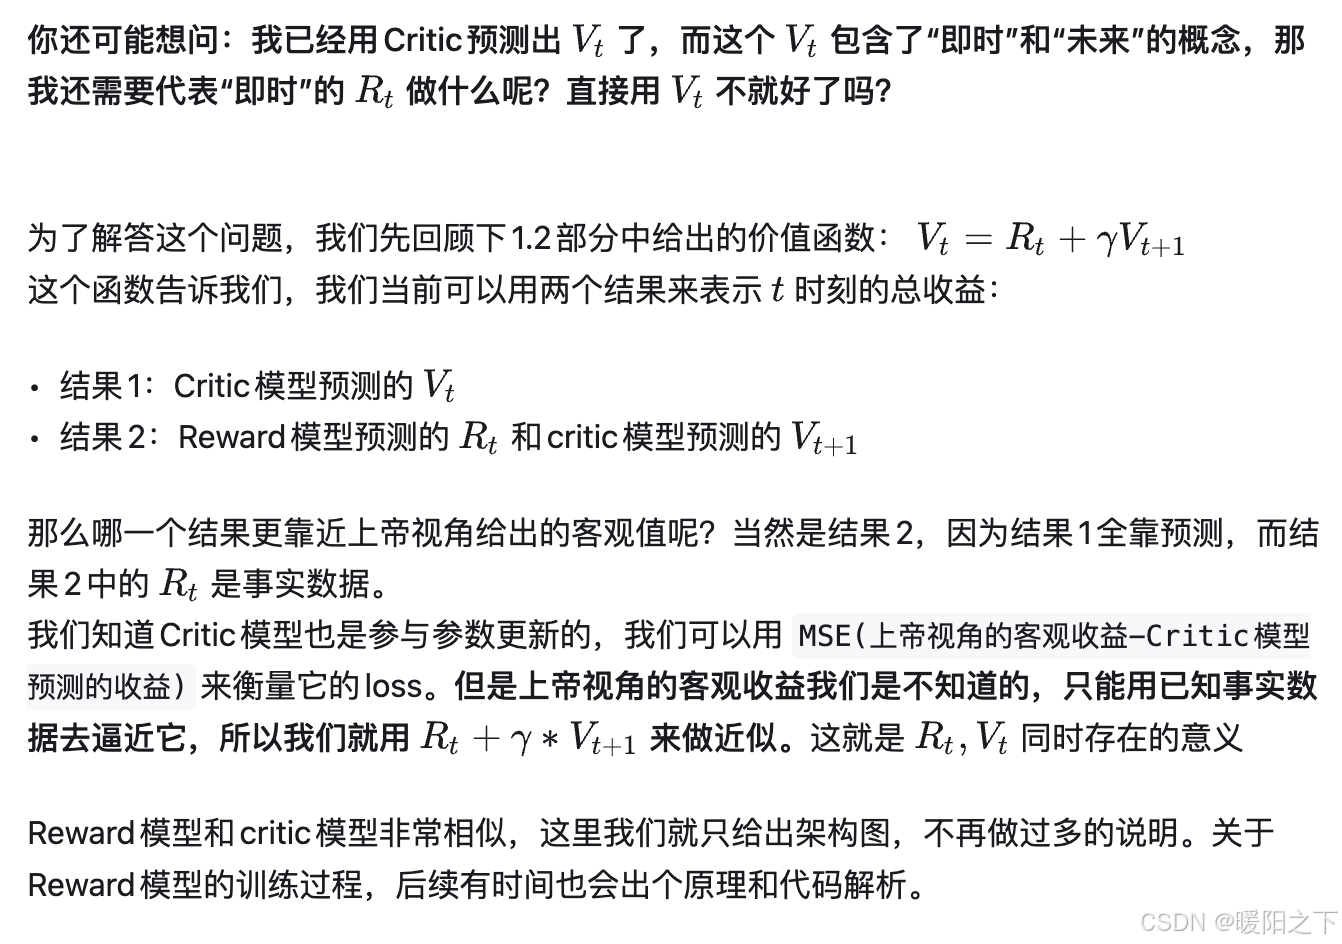
通俗的讲解一下:
- 奖励模型(Reward Model)是预先训练好的,用于提供即时奖励,它不需要随着策略的更新而更新,因为人类的偏好标准是固定的。
- Critic模型则需要随着Actor策略的更新而不断训练,以准确估计当前策略下的累积收益。
RLHF中的loss计算
到目前为止,我们已经基本了解了RLHF的训练框架,以及其中的四个重要角色(训练一个RLHF,有4个模型在硬件上跑,可想而知对存储的压力)。在本节中,我们一起来解读RLHF的loss计算方式。在解读中,我们会再一次理一遍RLHF的整体训练过程,填补相关细节。在这之后,我们就可以来看代码解析了。
在四个角色的讲解中,我们知道Actor和Critic模型都会做参数更新,所以我们的loss也分成2个:
- **Actor loss:**用于评估Actor是否产生了符合人类喜好的结果,将作用于Actor的BWD上。
- **Critic loss:**用于评估Critic是否正确预测了人类的喜好,将作用于Critic的BWD上。
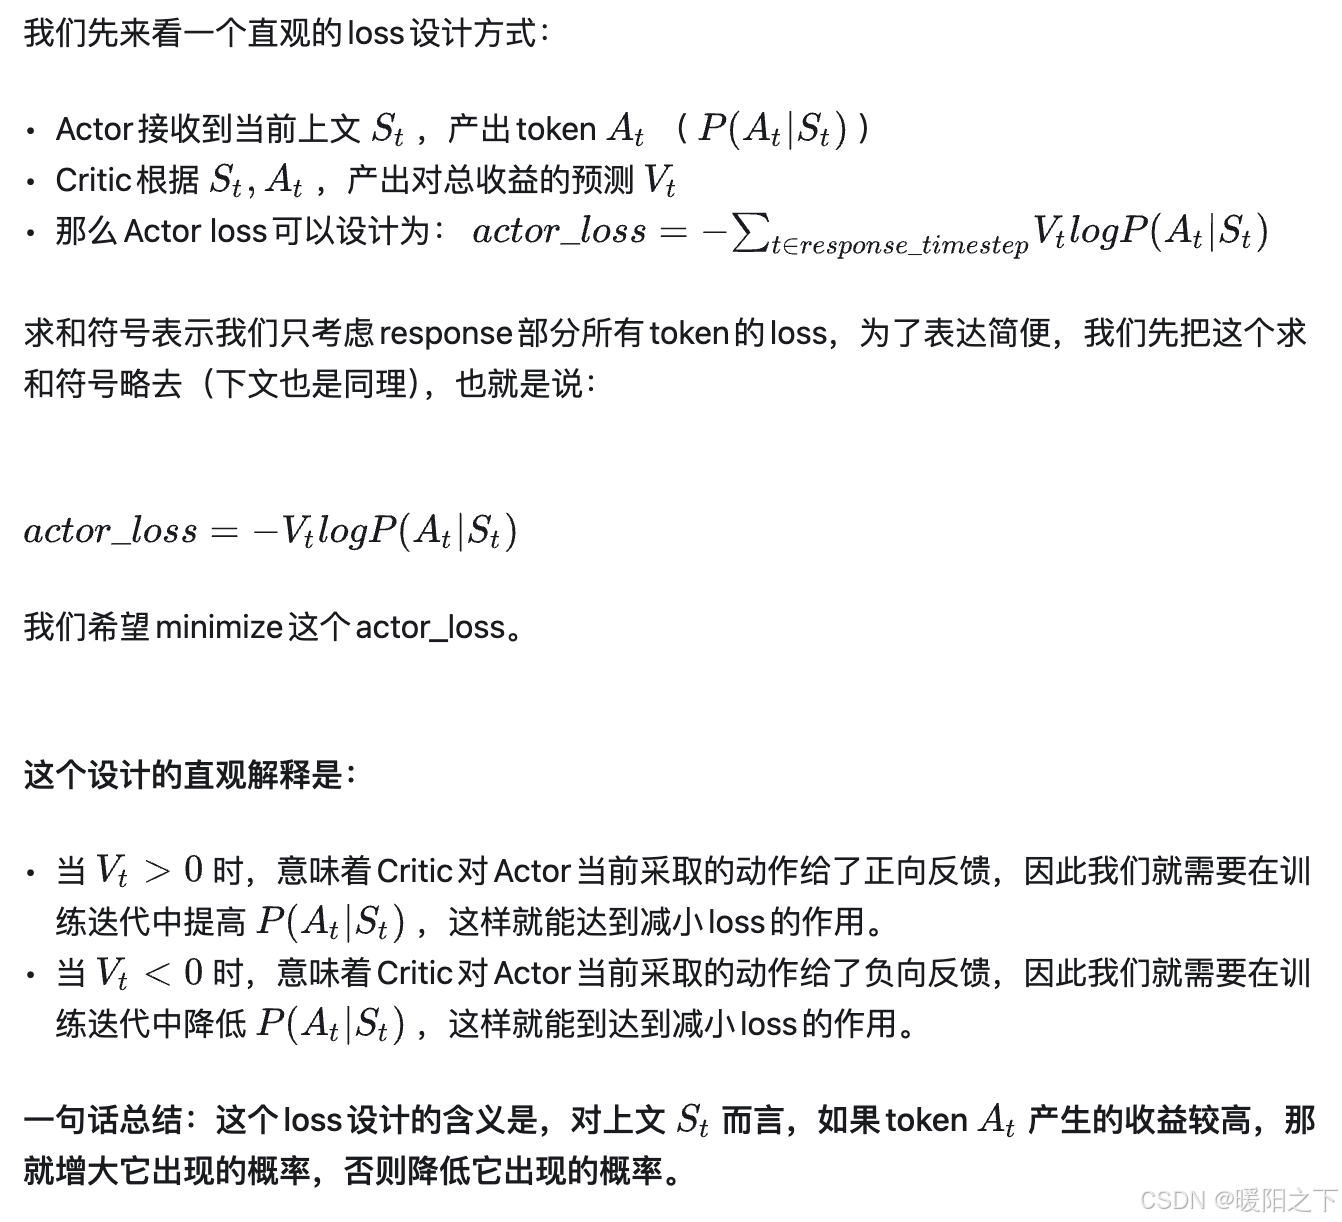
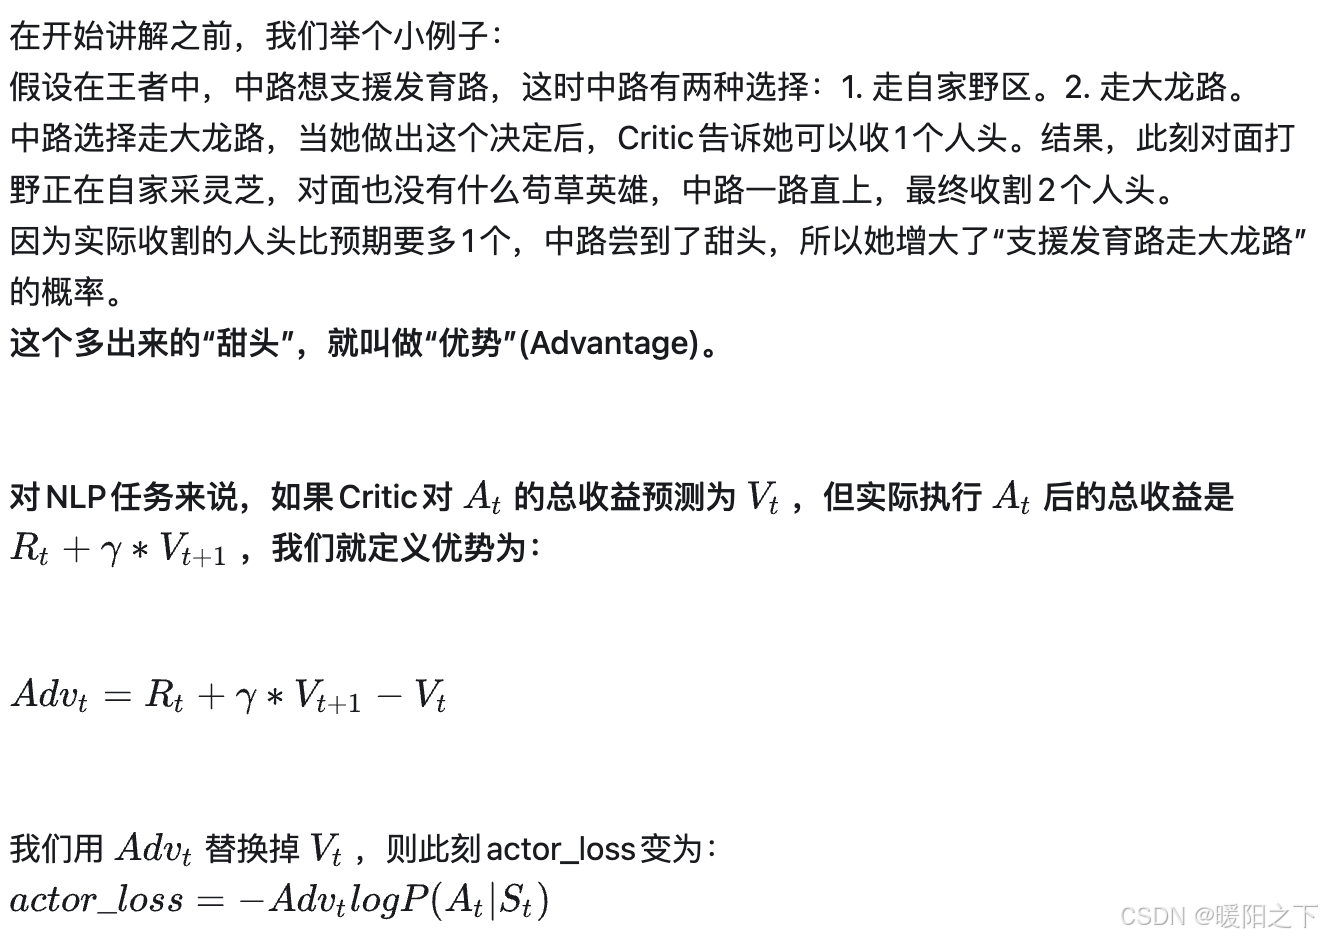
Actor loss
(1)直观设计
(2)引入优势
(3)重新设计Rt
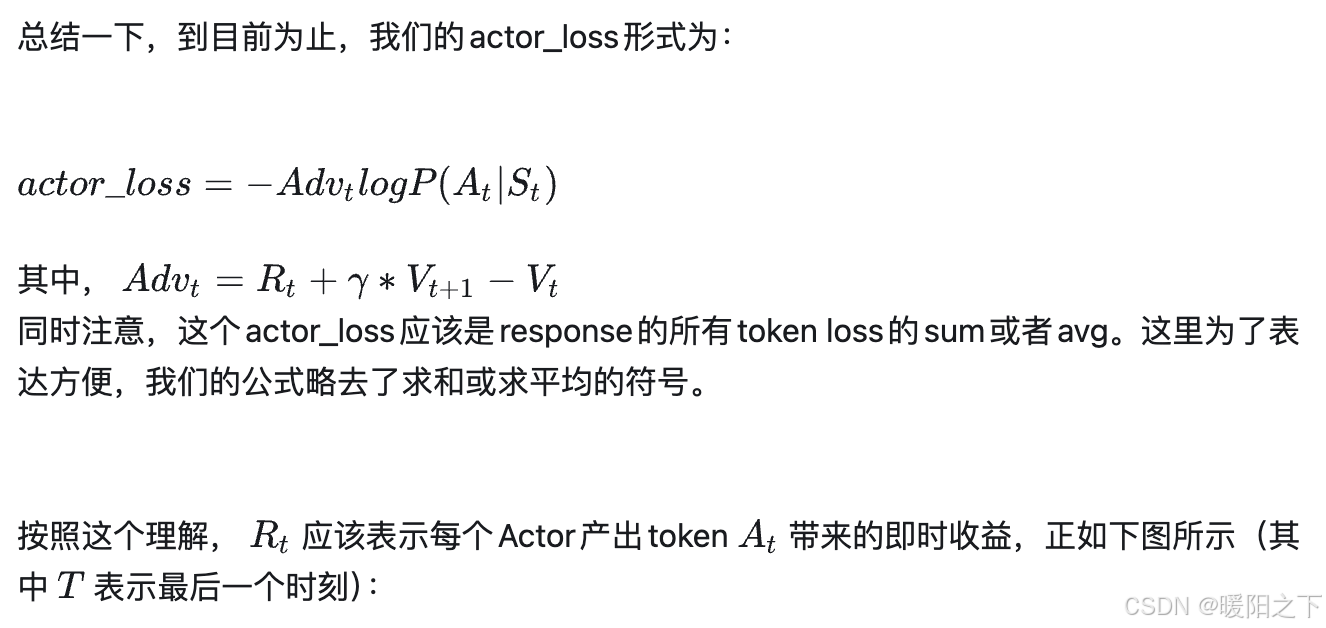
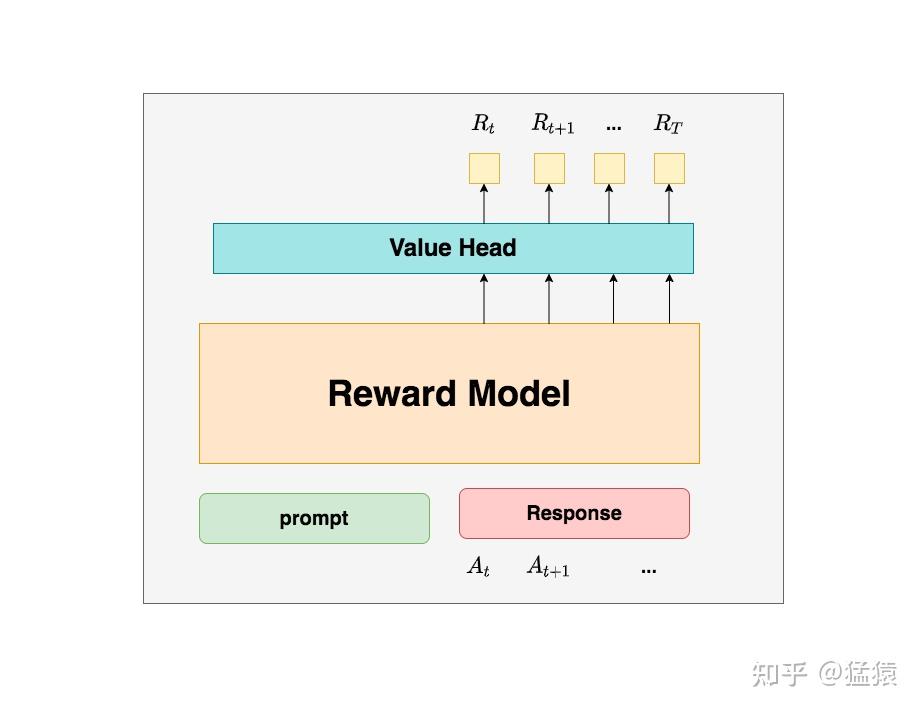
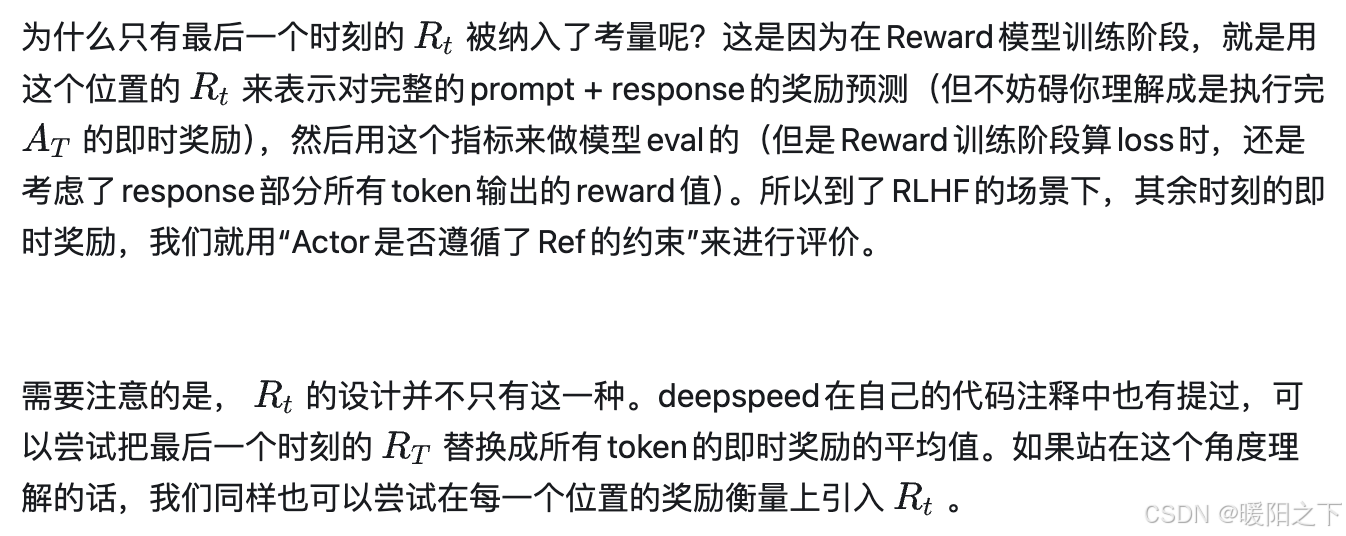
代码实践如下:
def compute_rewards(self, prompts, log_probs, ref_log_probs, reward_score,
                        action_mask):
        """
        reward_function:计算最终的reward分数
        复习一下几个相关参数的默认值:
        self.kl_ctl = 0.1
        self.clip_reward_value = 5

        对于batch中的某个prompt来说,它最终的reward分数为:
        (1) 先计算actor和ref_model的logit相似度: -self.kl_ctl * (log_probs - ref_log_probs)
            其实写成self.kl_ctl * (ref_log_probs - log_probs)更好理解些
            这个值越大,说明ref_model对actor生成的结果的认可度越高(即表明rlhf没有训歪),
            没有训歪的情况下我们也应该给模型一些奖励,这个奖励就是self.kl_ctl * (ref_log_probs - log_probs)

        (2)由于我们只取最后一个token对应位置的分数作为reward_score,因此我们只需要:
            self.kl_ctl * (ref_log_probs - log_probs)的最后一位 + reward_score

         (3) 同时我们对reward_score也做了大小限制,最大不超过self.clip_reward_value(超过统一给成self.clip_reward_value),
             最小不低于-self.clip_reward_value(低于统一给成-self.clip_reward_value)

         (4) 最后返回的rewards大小为:(batch_size, 各条数据的长度),对batch中的每条数据来说:
             - response的最后一位:self.kl_ctl * (ref_log_probs - log_probs)的最后一位 + reward_score
             - response的其余位置:self.kl_ctl * (ref_log_probs - log_probs)

        """

        kl_divergence_estimate = -self.kl_ctl * (log_probs - ref_log_probs)
        rewards = kl_divergence_estimate
        # ---------------------------------------------------------------------------------------------------
        # response开始的位置
        # (因为我们对prompt做过padding处理,因此batch中每个prompt长度一致,也就意味着每个response开始的位置一致)
        # (所以这里start是不加s的,只是一个int)
        # ---------------------------------------------------------------------------------------------------
        start = prompts.shape[1] - 1
        # ---------------------------------------------------------------------------------------------------
        # response结束的位置
        # (因为一个batch中,每个response的长度不一样,所以response的结束位置也不一样)
        # (所以这里end是加s的,ends的尺寸是(batch_size,)
        # ---------------------------------------------------------------------------------------------------
        ends = start + action_mask[:, start:].sum(1) + 1
        # ---------------------------------------------------------------------------------------------------
        # 对rewards_score做限制
        # ---------------------------------------------------------------------------------------------------
        reward_clip = torch.clamp(reward_score, -self.clip_reward_value,
                                  self.clip_reward_value)
        batch_size = log_probs.shape[0]
        for j in range(batch_size):
            rewards[j, start:ends[j]][-1] += reward_clip[j] #

        return rewards
(4)重新设计优势
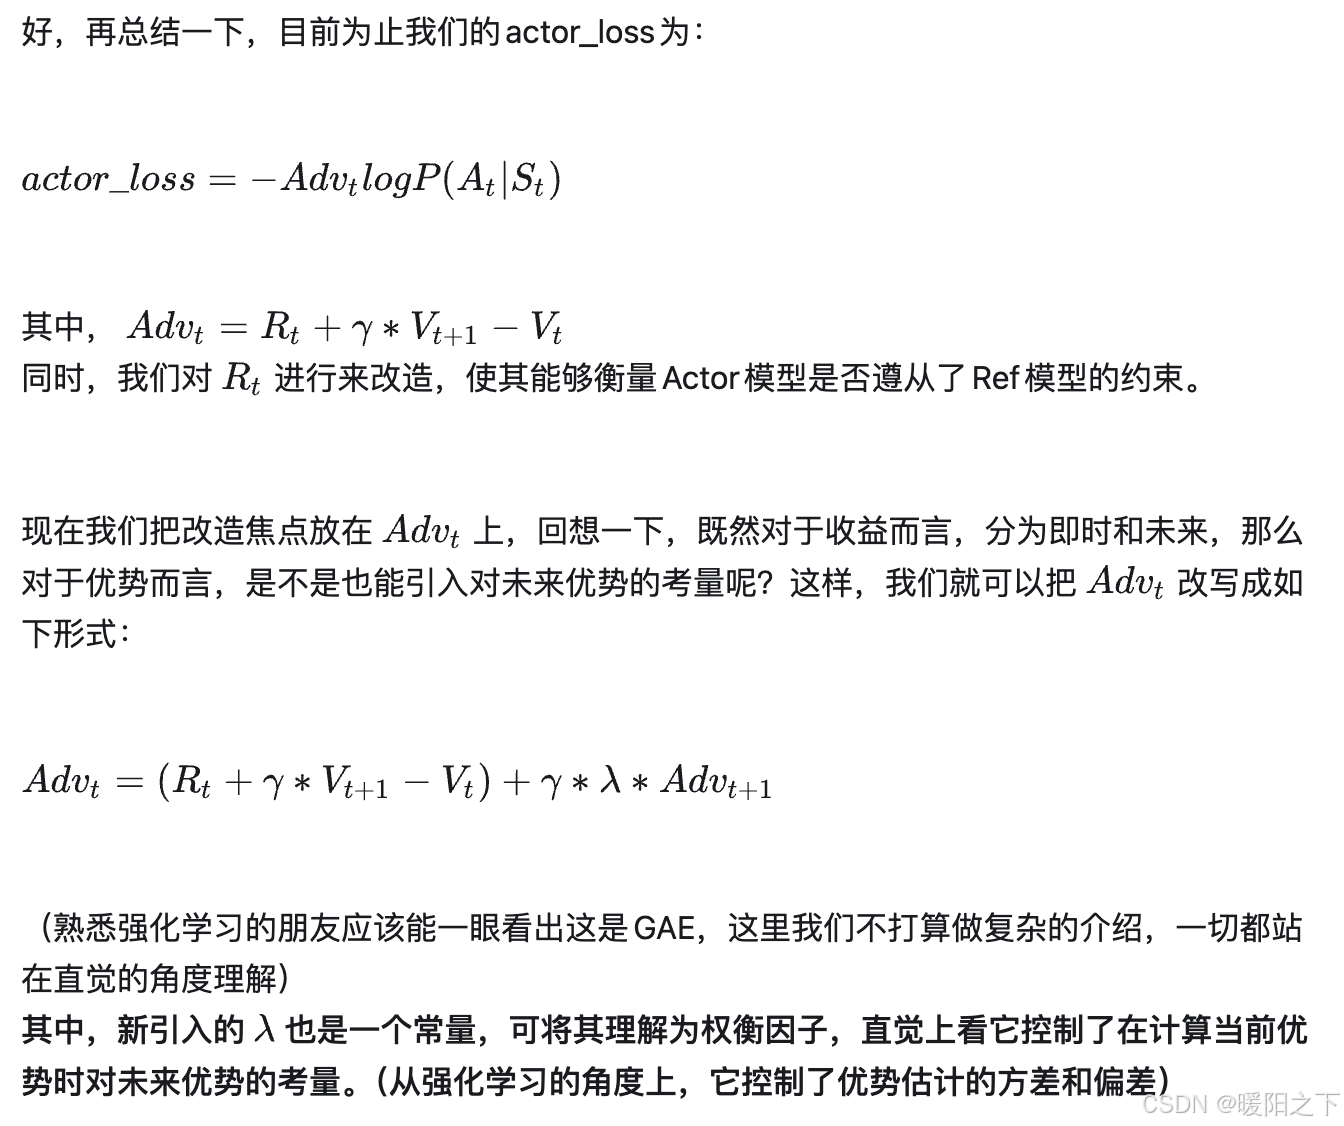
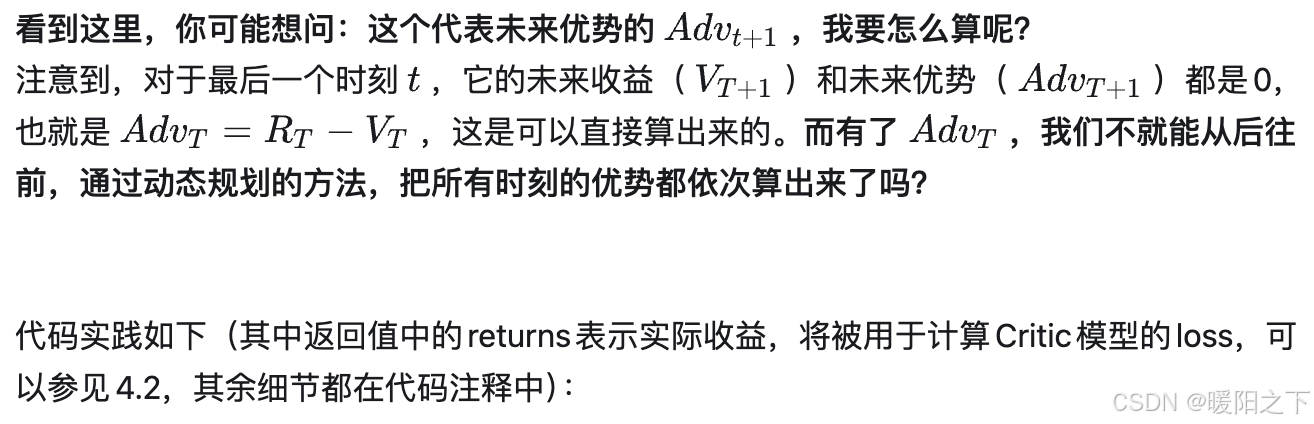
def get_advantages_and_returns(self, values, rewards, start):
        """
        Adopted from https://github.com/CarperAI/trlx/blob/main/trlx/models/modeling_ppo.py#L134

        没有引入GAE前的t时刻的优势值:
        detal_t = r_t + gamma * V_t+1 - V_t
        其中:
            - r_t表示t时刻的即时收益
            - V_t+1表示未来时刻的预期收益
            - r_t + gamma * V_t+1可理解成t时刻的实际预期收益
            - V_t可理解成t时刻的预估预期收益(是模型,例如critic model自己估算出来的)

        引入GAE后的t时刻的优势值:
        A_t = delta_t + gamma * lambda * A_t+1
        粗暴理解为在t时刻时,不仅考虑当下优势,还考虑了未来的优势
        为了知道A_t, 我们得知道A_t+1,所以在本算法中采取了从后往前做动态规划求解的方法,也即:
        假设T是最后一个时刻,则有A_T+1 = 0, 所以有: A_T = delta_T
        知道了A_T, 就可以依次往前倒推,把A_t-1, A_t-2之类都算出来了

        引入GAE后t时刻的实际预期收益
        returns_t = A_t + V_t
                  = delta_t + gamma * lambda * A_t+1 + V_t
                  = r_t + gamma * V_t+1 - V_t + gamma * lambda * A_t+1 + V_t
                  = r_t + gamma * (V_t+1 + lambda * A_t+1)

        注意,这里不管是advantages还是returns,都只算response的部分
        """

        # Adopted from https://github.com/CarperAI/trlx/blob/main/trlx/models/modeling_ppo.py#L134
        lastgaelam = 0
        advantages_reversed = []
        length = rewards.size()[-1]
        # 注意这里用了reversed,是采取从后往前倒推计算的方式
        for t in reversed(range(start, length)):
            nextvalues = values[:, t + 1] if t < length - 1 else 0.0
            delta = rewards[:, t] + self.gamma * nextvalues - values[:, t]
            lastgaelam = delta + self.gamma * self.lam * lastgaelam
            advantages_reversed.append(lastgaelam)
        advantages = torch.stack(advantages_reversed[::-1], dim=1) # 优势
        returns = advantages + values[:, start:] # 实际收益
        # values: 预期收益
        return advantages.detach(), returns
(5)PPO-epoch: 引入新约束
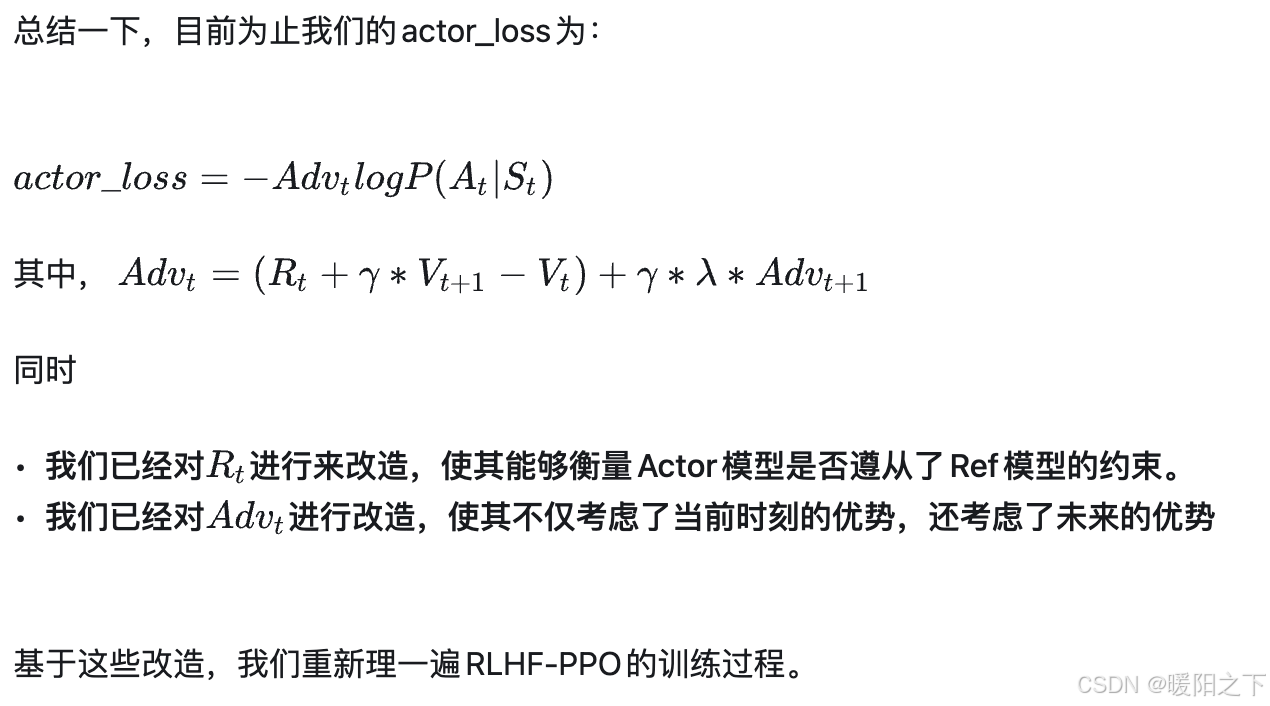
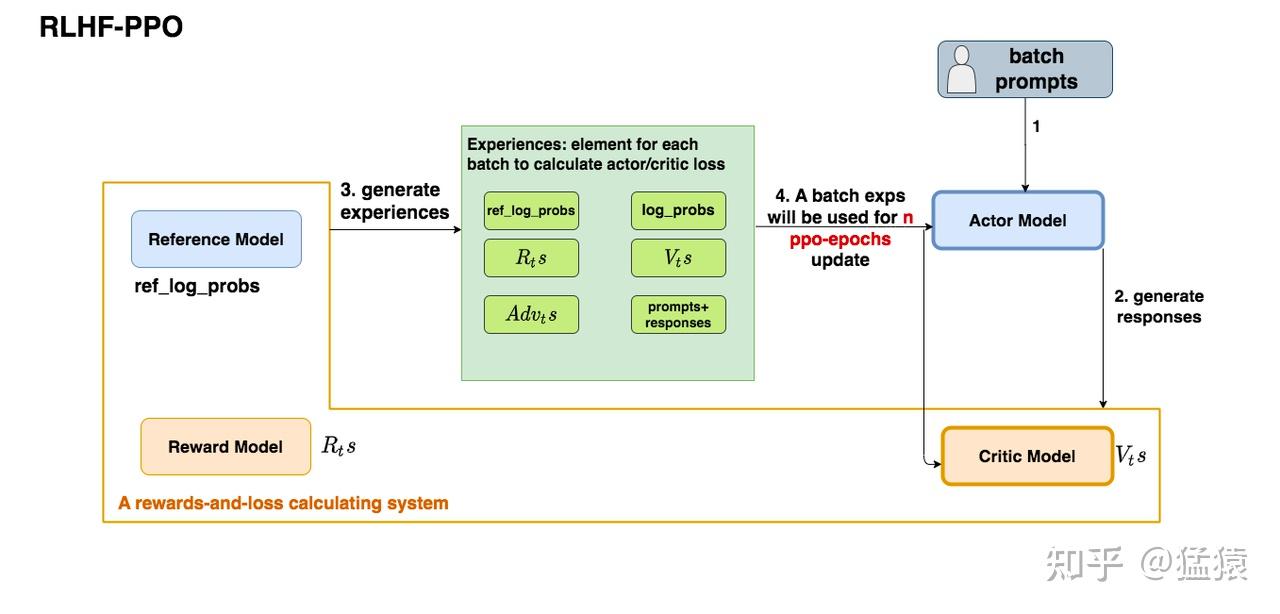
- 第一步,我们准备一个batch的prompts
- 第二步,我们将这个batch的prompts喂给Actor模型,让它生成对应的responses
- 第三步,我们把prompt+responses喂给我们的Critic/Reward/Reference模型,让它生成用于计算actor/critic loss的数据,按照强化学习的术语,我们称这些数据为经验(experiences)。critic loss我们将在后文做详细讲解,目前我们只把目光聚焦到actor loss上
- 第四步,我们根据这些经验,实际计算出actor/critic loss,然后更新Actor和Critic模型
这些步骤都很符合直觉,但是细心的你肯定发现了,文字描述中的第四步和图例中的第四步有差异:图中说,这一个batch的经验值将被用于n次模型更新,这是什么意思呢?
我们知道,在强化学习中,收集一个batch的经验是非常耗时的。对应到我们RLHF的例子中,收集一次经验,它要等四个模型做完推理才可以,正是因此,一个batch的经验,只用于计算1次loss,更新1次Actor和Critic模型,好像有点太浪费了。
所以,**我们自然而然想到,1个batch的经验,能不能用来计算ppo-epochs次loss,更新ppo-epochs次Actor和Critic模型?**简单写一下伪代码,我们想要:
# --------------------------------------------------------------
# 初始化RLHF中的四个模型
# --------------------------------------------------------------
actor, critic, reward, ref = initialize_models()

# --------------------------------------------------------------
# 训练
# --------------------------------------------------------------
# 对于每一个batch的数据
for i in steps:
    # 先收集经验值
    exps = generate_experience(prompts, actor, critic, reward, ref)
    # 一个batch的经验值将被用于计算ppo_epochs次loss,更新ppo_epochs次模型
    # 这也意味着,当你计算一次新loss时,你用的是更新后的模型
    for j in ppo_epochs:
        actor_loss = cal_actor_loss(exps, actor)
        critic_loss = cal_critic_loss(exps, critic)

        actor.backward(actor_loss)
        actor.step()

        critc.backward(critic_loss)
        critic.step()
**而如果我们想让一个batch的经验值被重复使用ppo_epochs次,等价于我们想要Actor在这个过程中,模拟和环境交互ppo_epochs次。**举个例子:
- 如果1个batch的经验值只使用1次,那么在本次更新完后,Actor就吃新的batch,正常和环境交互,产出新的经验值
- 但如果1个batch的经验值被使用ppo_epochs次,在这ppo_epochs中,Actor是不吃任何新数据,不做任何交互的,所以我们只能让Actor“模拟”一下和环境交互的过程,吐出一些新数据出来。
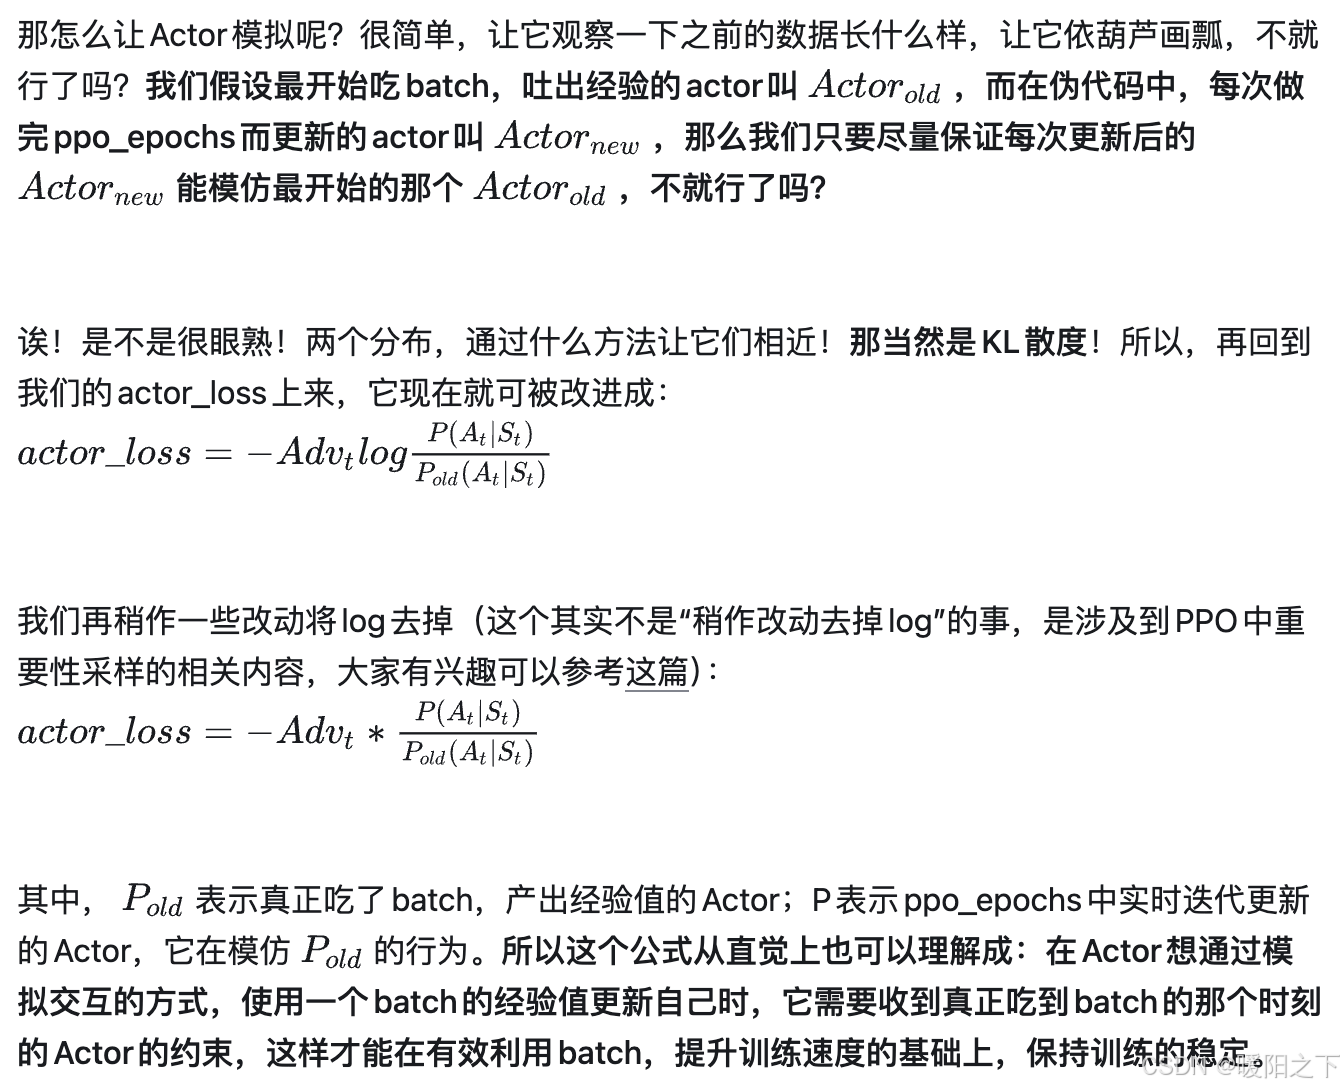
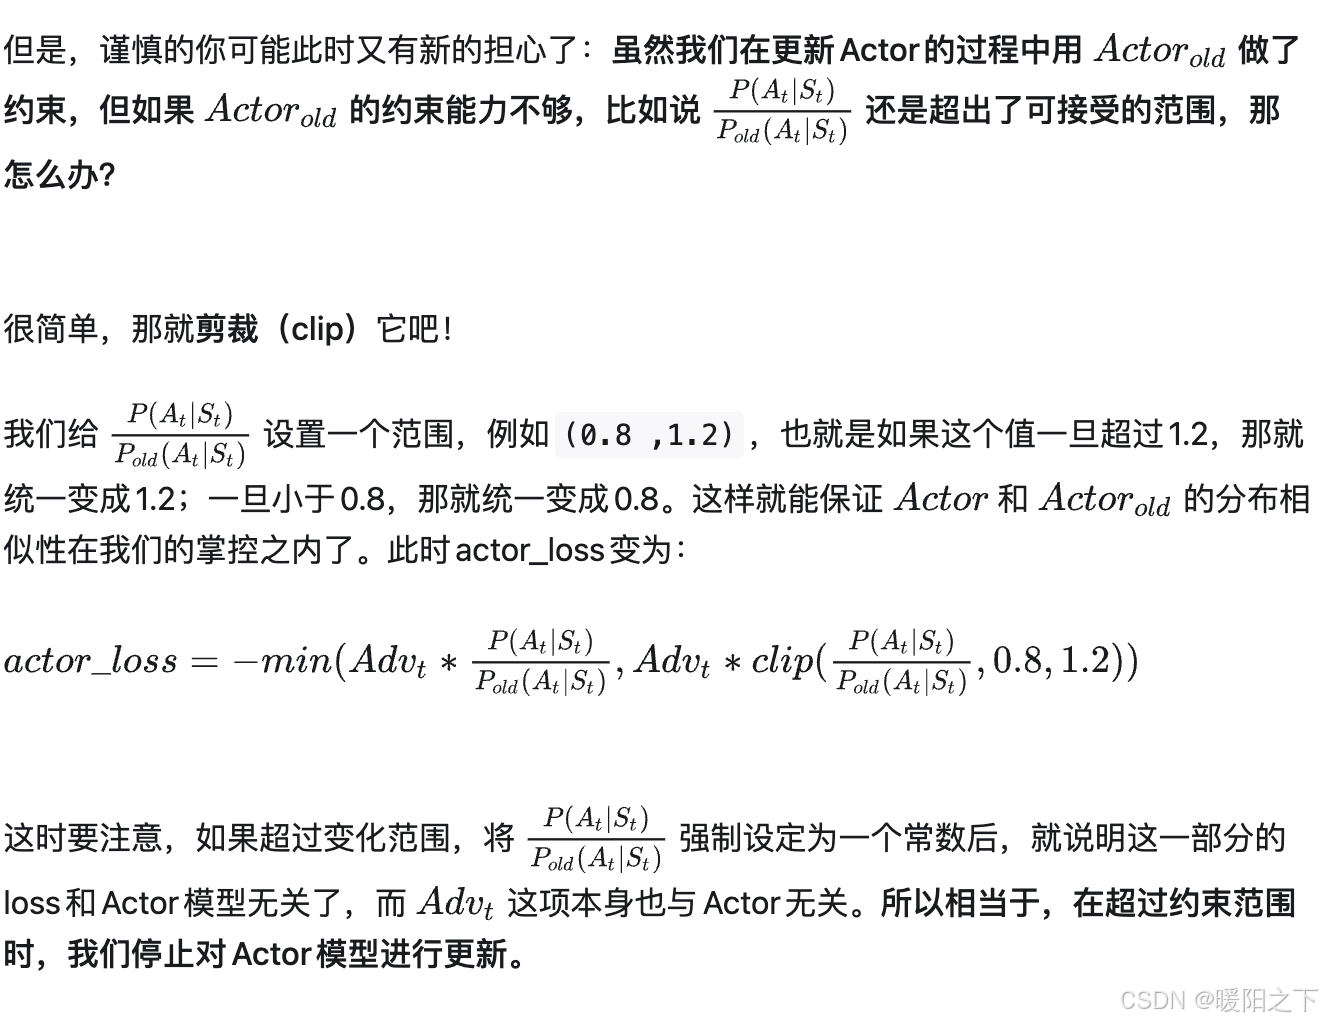
整体代码如下:
def actor_loss_fn(self, logprobs, old_logprobs, advantages, mask):
        """
        logprobs: 实时计算的,response部分的prob(只有这个是随着actor实时更新而改变的)
        old_logprobs:老策略中,response部分的prob (这个是固定的,不随actor实时更新而改变)
        advantages: 老策略中,response部分每个token对应的优势(这个是固定的,不随actor实时更新而改变)
        mask:老策略中,response部分对应的mask情况这个是固定的,不随actor实时更新而改变)

        之所以要引入logprobs计算actor_loss,是因为我们不希望策略每次更新的幅度太大,防止模型训歪

        self.cliprange: 默认值是0.2
        """
        ## policy gradient loss
        # -------------------------------------------------------------------------------------
        # 计算新旧策略间的KL散度
        # -------------------------------------------------------------------------------------
        log_ratio = (logprobs - old_logprobs) * mask
        ratio = torch.exp(log_ratio)
        # -------------------------------------------------------------------------------------
        # 计算原始loss和截断loss
        # -------------------------------------------------------------------------------------
        pg_loss1 = -advantages * ratio
        pg_loss2 = -advantages * torch.clamp(ratio, 1.0 - self.cliprange, 1.0 + self.cliprange)
        pg_loss = torch.sum(torch.max(pg_loss1, pg_loss2) * mask) / mask.sum() # 最后是取每个非mask的response token的平均loss作为最终loss
        return pg_loss
(6)Actor loss小结
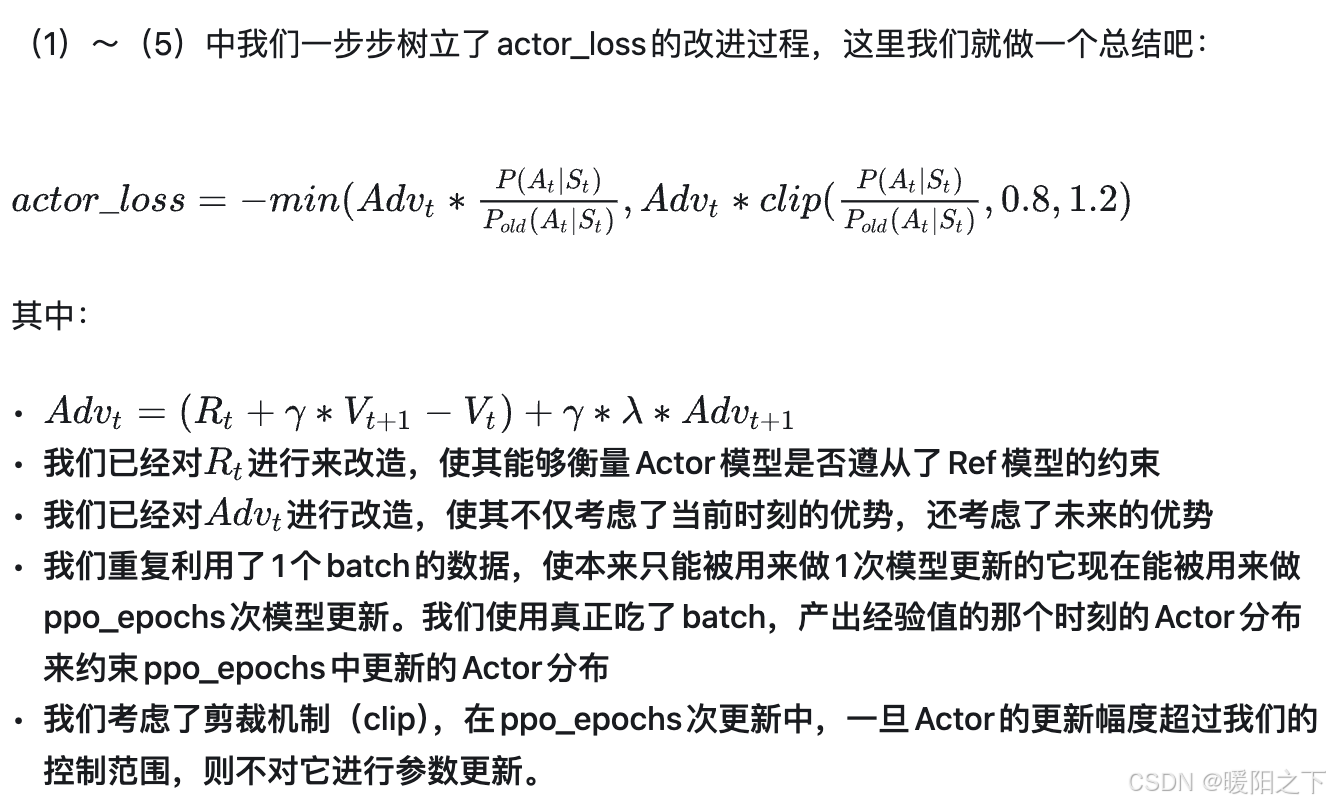
Critic loss
我们知道,1个batch产出的经验值,不仅被用来更新Actor,还被用来更新Critic。对于Critic loss,我们不再像Actor loss一样给出一个“演变过程”的解读,我们直接来看它最后的设计。
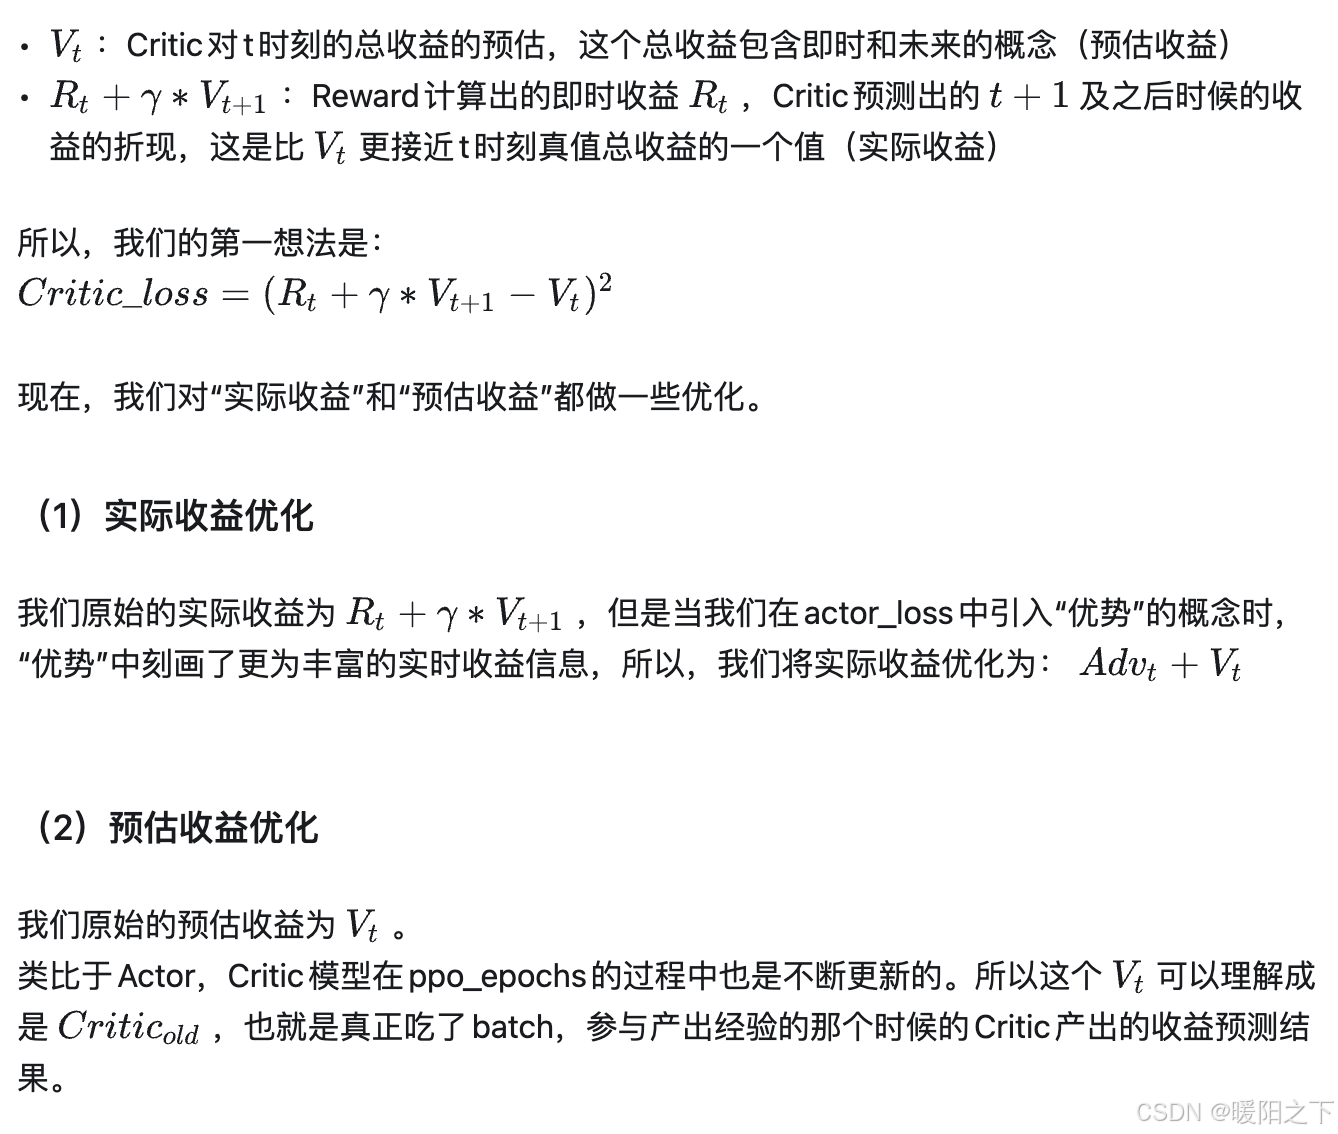
首先,在之前的解说中,你可能有这样一个印象:
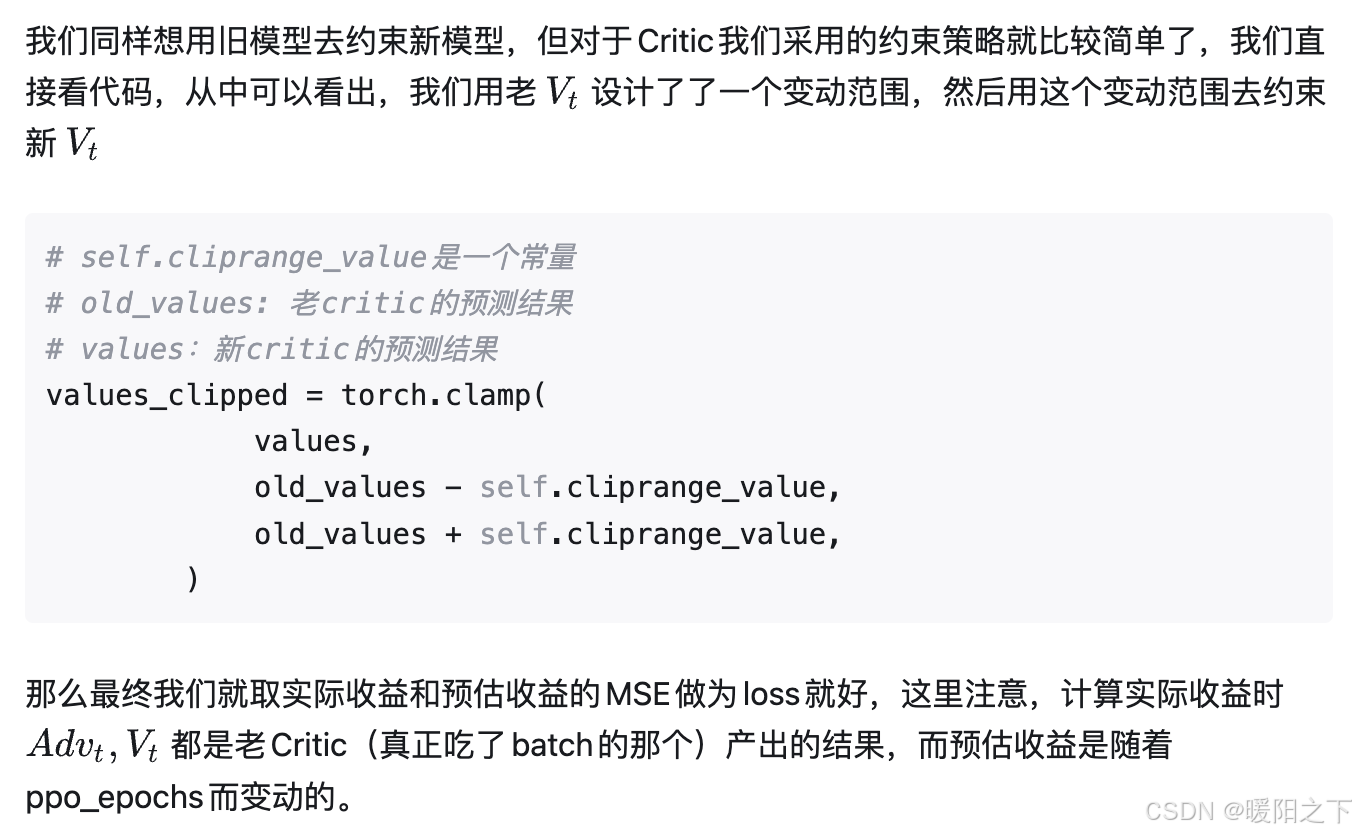
代码如下:
def critic_loss_fn(self, values, old_values, returns, mask):
        """
        values: 实时critic跑出来的预估预期收益(是变动的,随着ppo epoch迭代而改变)
        old_values:老critic跑出来的预估预期收益(是固定值)
        returns:实际预期收益
        mask:response部分的mask

        self.cliprange_value = 0.2
        """
        ## value loss
        # 用旧的value去约束新的value
        values_clipped = torch.clamp(
            values,
            old_values - self.cliprange_value,
            old_values + self.cliprange_value,
        )
        if self.compute_fp32_loss:
            values = values.float()
            values_clipped = values_clipped.float()

        # critic模型的loss定义为(预估预期收益-实际预期收益)**2
        vf_loss1 = (values - returns)**2
        vf_loss2 = (values_clipped - returns)**2
        vf_loss = 0.5 * torch.sum(
            torch.max(vf_loss1, vf_loss2) * mask) / mask.sum() # 同样,最后也是把critic loss平均到每个token上
        return vf_loss
PPO的流程
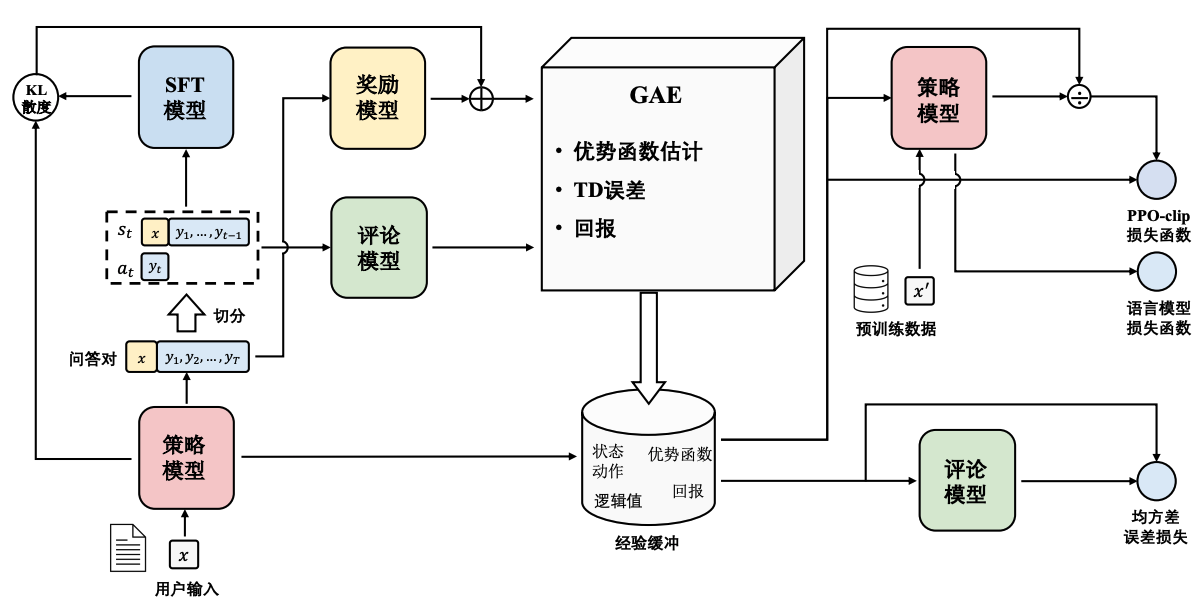
PPO的实施流程如下:
- 环境采样:策略模型基于给定输入生成一系列的回复,奖励模型则对这些回复进行打分获得奖励。
- 优势估计:利用评论模型预测生成回复的未来累积奖励,并借助广义优势估计(Generalized Advantage Estimation,GAE)算法来估计优势函数,能够有助于更准确地评估每次行动的好处。
- 优化调整:使用优势函数来优化和调整策略模型,同时利用参考模型确保更新的策略不会有 太大的变化,从而维持模型的稳定性。
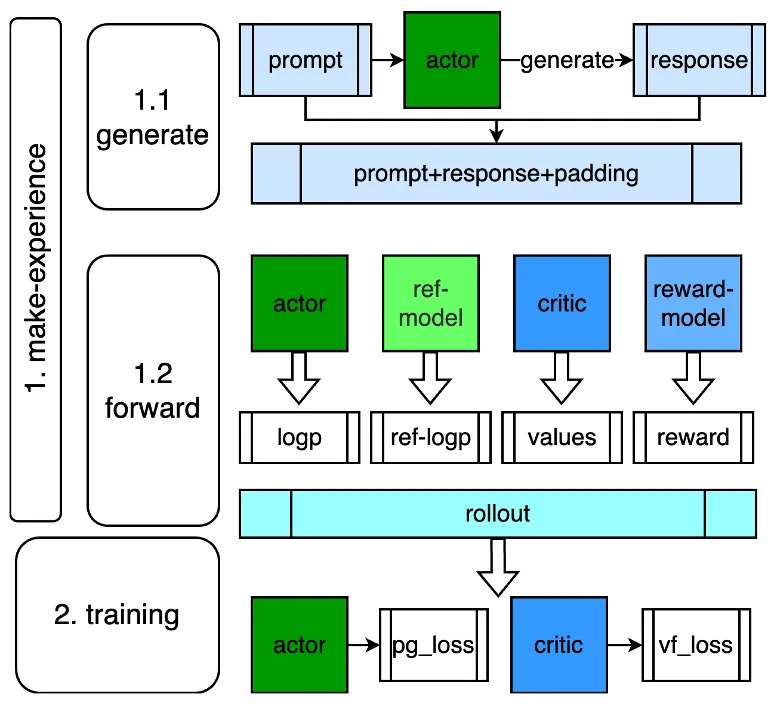
作为PPO流程的补充,参考下面这张图,可以划分为经验采样和训练两个阶段。
第一阶段经验采样,也叫做rollout,就是滑跑的意思,在RL中可以理解为一次实验,也就是actor模型在当前环境下进行策略动作的过程,具体实现上就是actor模型根据prompt数据集进行generate生成response,然后根据prompt+response进行forward计算,得到logp/values/reward等元素,这里涉及到actor、reference、critic、reward 4个模型的推理过程;
第二阶段就是训练流程,涉及到actor和critic两个模型,从计算loss来看,算法上是相互独立的,本质上是两个模型独立训练。
make_experience和rollout、Episode有什么区别与联系
在RLHF-PPO的语境下,这三个术语都涉及生成和收集与环境交互的数据,但侧重点略有不同:
- make_experience:这是一个泛指的说法,描述了让模型与环境交互、生成经验数据的整个过程。它强调“制造经验”,也就是收集状态、动作、奖励等数据,为后续训练提供素材。
- rollout:特指利用当前策略模型在环境中生成一段轨迹的过程。这段轨迹可以是完整的,也可以只是部分数据。Rollout更侧重于“展开”策略执行的具体过程,用来评估策略或计算优势等。
- episode:指的是从环境的初始状态开始,到达到终止条件为止的一整段交互过程,是一种完整的轨迹。它是rollout的一种特殊情况,即rollout生成的是一个完整的体验序列。
联系与区别:
- 联系:三者都涉及通过策略与环境交互来收集数据。通常,make_experience的过程可能就是通过执行rollout来实现,而如果rollout生成的是从开始到结束的完整轨迹,那么它就构成了一个episode。
- 区别:make_experience是一个更宽泛的概念,强调整个数据收集过程;rollout强调的是生成轨迹的动作,不一定要求轨迹完整;而episode专指完整的体验序列。
总的来说,make_experience包含了通过rollout生成经验,而rollout有时可能只是一部分episode,三者在数据生成过程中各有侧重。
DPO
DPO的基本原理:增加偏好样本的对数概率与减小非偏好样本响应的对数概率。它结合了动态加权机制,以避免仅使用概率比目标时遇到的模型退化问题。
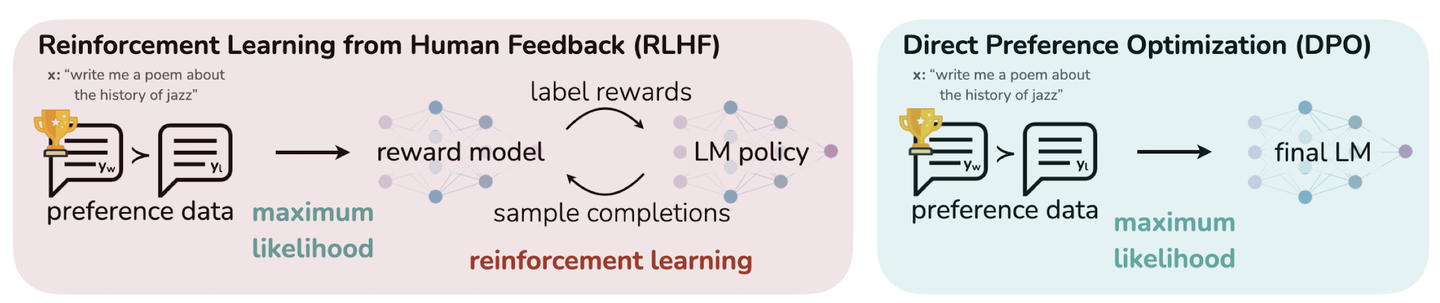
DPO在优化人类偏好时避免了使用强化学习。现有RLHF方法通常会首先使用一个奖励模型(Reward Model)来拟合一个包含提示(Prompt)和人类对响应对(Response Pair)偏好的数据集,然后通过强化学习找到一个能够最大化该奖励模型的策略(Policy)。相比之下,DPO 直接以简单的分类目标优化最能满足偏好的策略,通过拟合一个隐式奖励模型,其对应的最优策略可以以闭式形式(Closed Form)提取出来。
GRPO
GRPO是对PPO的一种改进版本,属于online RL。它通过暴力采样求均值的方式替代了PPO中的Critic Model,同时保留了PPO中的重要性采样和裁剪机制。GRPO中冻结了Ref和RM 2个模型,仅需要训练Policy Model。
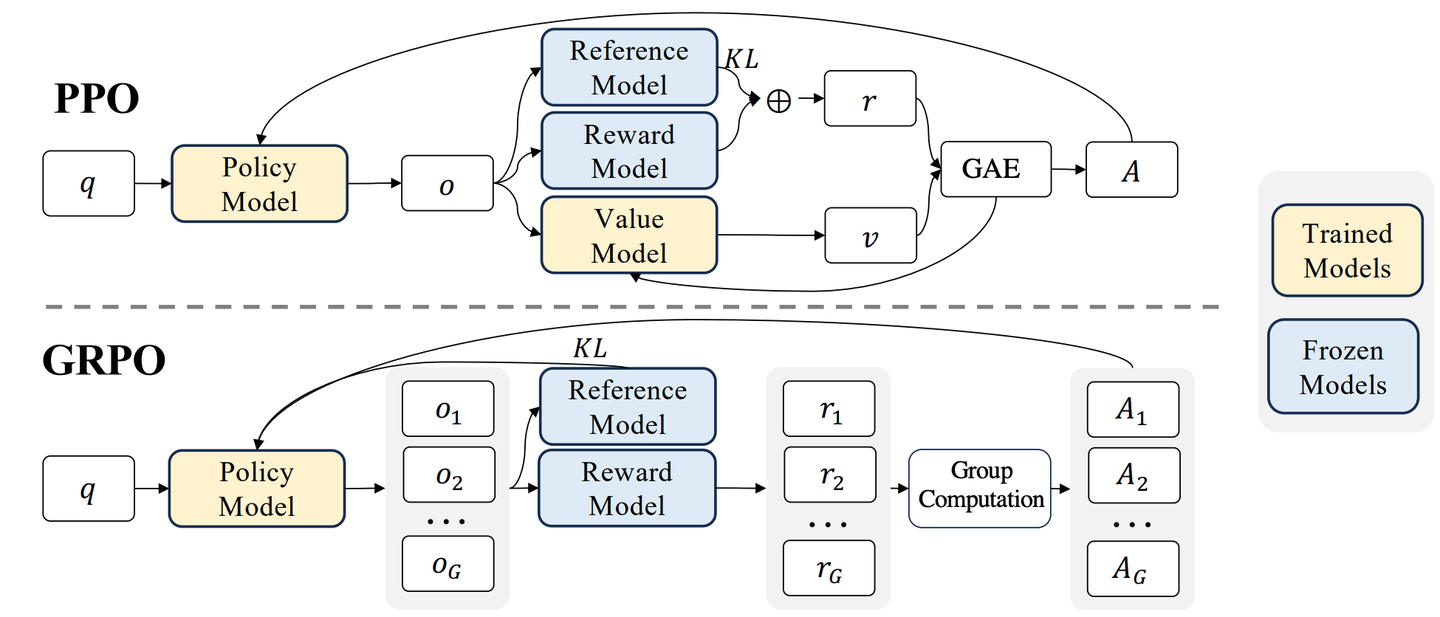
GRPO的目标函数:
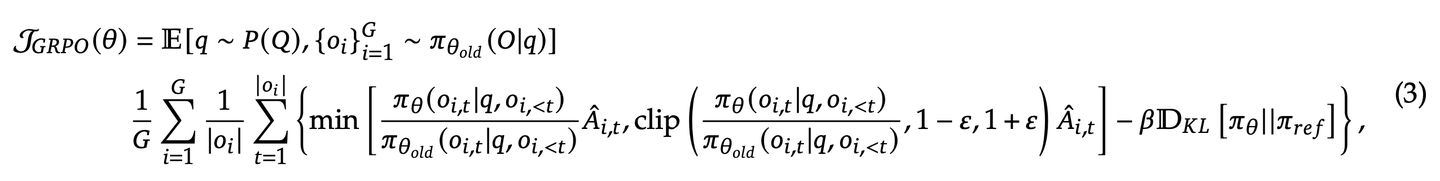
DAPO
这是字节跳动seed团队对GRPO的重要改进。GRPO 面临四个主要问题:其单一剪切范围易导致低概率 Token 无法得到有效提升(熵坍塌),样本级别损失会弱化长序列 Token 的梯度贡献,一旦所有输出都是全对或全错则无梯度信号可用,且统一惩罚过长生成会引入噪声。
DAPO 则通过“四大改进”逐一解决:
- Clip-Higher 将剪切上下限分开以保留多样性;
- Dynamic Sampling 过滤全对/全错样本保持有效梯度;
- Token-Level Policy Gradient Loss 平衡长序列 Token 贡献;
- Overlong Reward Shaping 为过长文本进行柔性惩罚或掩码,减少噪声干扰。
Reference
图解大模型RLHF系列之:人人都能看懂的PPO原理与源码解读 https://zhuanlan.zhihu.com/p/677607581
大模型中的强化学习 https://zhuanlan.zhihu.com/p/693582342

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 12
 0
- 0


 已为社区贡献1条内容

所有评论(0)