NLP中的对抗学习VS对比学习-1
文章目录
思维导图链接:https://www.processon.com/mindmap/64159f9ff502f062b5d616be
1 对抗学习的目的是什么?
是为了让模型更鲁棒,对噪声更加的不敏感。
在实现这一点上,有对抗防御、对抗攻击和对抗训练。
对抗防御是识别出更多的样本
对抗攻击是为了构造更多的样本
对抗训练是将样本添加到模型中,以提高模型的鲁棒性
2 embedding是什么?
embedding是词的表示的一种,一般是可以互相替换的词之间的相似度是比较高的。
大概还是和最初的训练objective 有关,一般的Word embedding的训练是根据自监督方式完成,即预测下一个字
如果两个字是可以同时接在下一个字后面的话,相似度理应高一些。比如:我喜欢你和我讨厌你。
参考链接:https://spaces.ac.cn/archives/4122
3 对抗训练
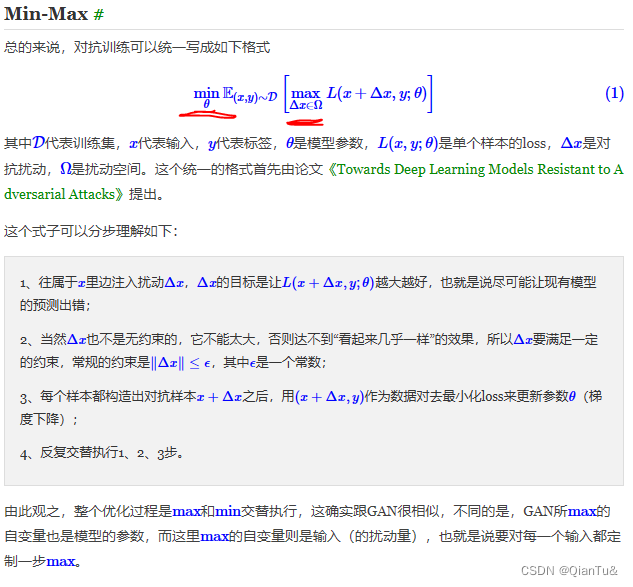
深度学习中的对抗,一般会有两个含义:一个是生成对抗网络(Generative Adversarial Networks,GAN),代表着一大类先进的生成模型;另一个则是跟对抗攻击、对抗样本相关的领域,它跟GAN相关,但又很不一样,它主要关心的是模型在小扰动下的稳健性。
原文链接:https://spaces.ac.cn/archives/7234
最好还是看原文,讲的很透彻。
问题
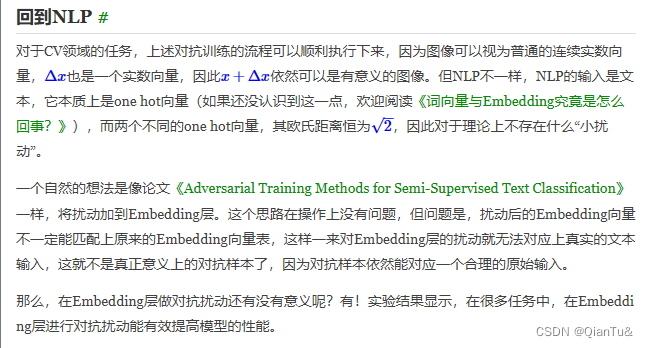
1.FGM从思想上来说,我理解它的意思是,在原始输入样本x上加对抗r,但这个对抗肯定没法在原始token上加,所以就加在E = nn.word_embedding(x) = x * W_emb上,所以简单描述应该是x_adv = x * W_emb + r;
但从你的FGM的代码实操来看,似乎是将扰动r加在了embedding层的权重W_emb上,即x_adv’ = x * (W_emb + r)
= x * W_emb + x * r,似乎扰动r被多加了(x-1)倍?当然,这种略带玄学的东西本就不该十分一丝不苟,因为好不好用应该是实践说了算,不过我担心是我理解有误,所以请教一下这个问题~
1 如果加在bias的位置的话,反向传播的话,加不加都不会产生任何影响,这时候FGM就没有意义了;
2 为什么不能加?严格来说,NLP里面就没有真正的对抗样本,因为真正的对抗样本是需要加了扰动之后仍然能够在vocab中有对应的index,而NLP里面很难做到。
2.此外,再问个更小白的问题——我理解必须先算出原始embedding对应的loss,才能在此基础上算出embedding空间加扰动r之后的对抗loss,从而反向传播得到grad以进行参数更新。但我不理解的是,为何第二次backward()要在第一次backward()基础上进行?即最终得到的grad,是由原始loss对应的grad+对抗loss对应的grad加和而得,我个人理解是,模型训练只需要使用更难更容易出大loss的对抗样本即可,那为何还要保留原始loss对应的grad进行参数更新呢?是觉得前后向传播算都算了,不用上有点亏吗😂,还请大佬指教!
对抗训练是一种引入噪声的训练方式,可以对参数进行正则化,提升模型鲁棒性和泛化能力。
对抗训练的假设是:给输入加上扰动之后,输出分布和原Y的分布一致
有监督的数据下使用交叉熵作为损失;
半监督数据下可计算KL散度;
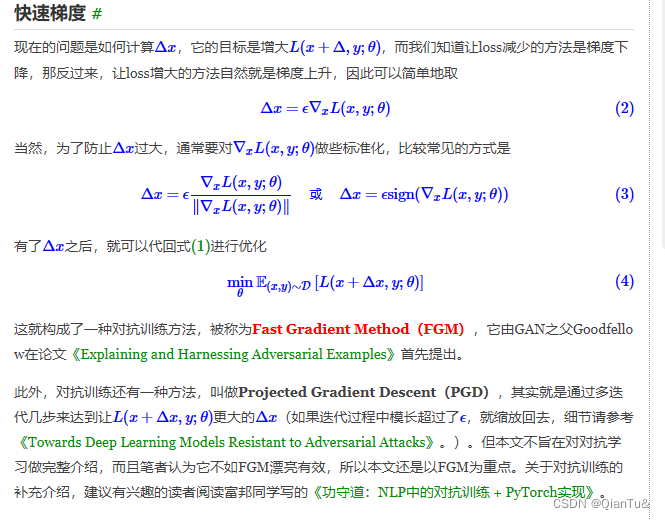
扰动如何得来呢?这需要对抗的思想,即往增大损失的方向增加扰动
用一句话形容对抗训练的思路,就是在输入上进行梯度上升(增大loss),在参数上进行梯度下降(减小loss)。由于输入会进行embedding lookup,所以实际的做法是在embedding table上进行梯度上升。
接下来介绍不同的方法,后续方法优化的主要方向有两点:得到更优的扰动 & 提升训练速度
4 常见的对抗训练方式
4.1 FGM
对于每个x:
  1.计算x的前向loss、反向传播得到梯度
  2.根据embedding矩阵的梯度计算出r,并加到当前embedding上,相当于x+r
  3.计算x+r的前向loss,反向传播得到对抗的梯度,累加到(1)的梯度上
  4.将embedding恢复为(1)时的值
  5.根据(3)的梯度对参数进行更新
FGM简单粗暴的“一步到位”,可能走不到约束内的最优点。PGD则是“小步走,多走几步”,如果走出了扰动半径为epsilon的空间,就映射回“球面”上,以保证扰动不要过大
4.2 PGD
对于每个x:
  1.计算x的前向loss、反向传播得到梯度并备份
  对于每步t:
      2.根据embedding矩阵的梯度计算出r,并加到当前embedding上,相当于x+r(超出范围则投影回epsilon内)
      3.t不是最后一步: 将梯度归0,根据1的x+r计算前后向并得到梯度
      4.t是最后一步: 恢复(1)的梯度,计算最后的x+r并将梯度累加到(1)上
  5.将embedding恢复为(1)时的值
  6.根据(4)的梯度对参数进行更新
在循环中r是逐渐累加的,要注意的是最后更新参数只使用最后一个x+r算出来的梯度。
4.3 FreeAT
FGSM和FGM都只用计算两次,一次是计算x的前后向,一次是计算x+r的前后向。而PGD则计算了K+1次,消耗了更多的计算资源。因此FreeAT被提了出来,在PGD的基础上进行训练速度的优化
FreeAT的思想是在对每个样本x连续重复m次训练,计算r时复用上一步的梯度,为了保证速度,整体epoch会除以m。r的更新公式为:
初始化r=0
对于epoch=1...N/m:
  对于每个x:
      对于每步m:
        1.利用上一步的r,计算x+r的前后向,得到梯度
        2.根据梯度更新参数
        3.根据梯度更新r
4.4 FreeLB
FreeLB和PGD主要有两点区别:
1.PGD是迭代K次r后取最后一次扰动的梯度更新参数,FreeLB是取K次迭代中的平均梯度
2.PGD的扰动范围都在epsilon内,因为伪代码第3步将梯度归0了,每次投影都会回到以第1步x为圆心,半径是epsilon的圆内,而FreeLB每次的x都会迭代,所以r的范围更加灵活,更可能接近局部最优:
对于每个x:
  1.通过均匀分布初始化r,梯度g为0
  对于每步t=1...K:
      2.根据x+r计算前后向,累计梯度g
      3.更新r
  4.根据g/K更新梯度
论文中还指出了很重要的一点,就是**对抗训练和dropout不能同时使用,加上dropout相当于改变了网络结构,会影响r的计算。**如果要用的话需要在K步中都使用同一个mask。
把最近的一些对抗训练方法总结出来,可以看到趋势从**“优化PGD的速度”又回到了“找寻最优扰动”**,个人也比较认同,训练速度慢一些对于普通模型还是可以接受的,主要还是看最终的效果有没有提升。
原文链接:原文链接
5 对抗训练和constractive learning
According to the web search results, 对抗训练 (adversarial training) is a technique that improves the robustness and generalization of a model by adding perturbations to the input data and minimizing the loss function. 对比学习 (contrastive learning) is a technique that learns an encoder that produces similar representations for data from the same class and dissimilar representations for data from different classes. Both techniques are related to self-supervised learning, which uses pseudo-labels as training signals without requiring manual annotations. Some recent papers have explored the combination of adversarial training and contrastive learning to generate more challenging positive pairs and enhance the representation quality².
对比学习是自监督学习的一类,属于表示学习的范畴,目的是得到足够strong和transferable的特征表示,可以用做下游的分类或分割等任务。
而对抗学习属于机器学习安全领域,主要研究模型的攻击与防御
对比学习是自监督学习的一种,也就是说,不依赖标注数据,要从无标注图像中自己学习知识。我们知道,自监督学习其实在图像领域里已经被探索了很久了。
总体而言,图像领域里的自监督可以分为两种类型:生成式自监督学习,判别式自监督学习。VAE和GAN是生成式自监督学习的两类典型方法,即它要求模型重建图像或者图像的一部分,这类型的任务难度相对比较高,要求像素级的重构,中间的图像编码必须包含很多细节信息。对比学习则是典型的判别式自监督学习,相对生成式自监督学习,对比学习的任务难度要低一些。
目前,对比学习貌似处于“无明确定义、有指导原则”的状态,它的指导原则是:**通过自动构造相似实例和不相似实例,要求习得一个表示学习模型,通过这个模型,使得相似的实例在投影空间中比较接近,而不相似的实例在投影空间中距离比较远。**而**如何构造相似实例,以及不相似实例,**如何构造能够遵循上述指导原则的表示学习模型结构,以及如何防止模型坍塌(Model Collapse),这几个点是其中的关键。
如果从防止模型坍塌的不同方法角度,我们可大致把现有方法划分为:基于负例的对比学习方法、基于对比聚类的方法、基于不对称网络结构的方法,以及基于冗余消除损失函数的方法。
6 对比学习的history and achievement
一定要看原文,原文讲的非常透彻。
https://cloud.tencent.com/developer/article/1851784
张俊林:对比学习「Contrastive Learning」研究进展精要

对比学习更多的是让模型实现一种不变性,在图像数据中,可以表现为颜色不变形、图像遮挡不变性、视角不变性、照明不变性等等。
目前很多探索,集中研究对比学习中的Hard负例问题。我们从上文讲解可知:对于负例对比学习方法,之所以负例越多模型效果越好,其实本质上,是因为越多负例,会包含更多的Hard负例,而这些Hard负例对于模型贡献较大,而easy负例,其实没多少贡献。但是,我们又知道,温度超参本身其实是可以聚焦在Hard负例上的。那么,Hard负例应该研究什么具体问题?

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献4条内容

所有评论(0)