实战使用 TimechoAI:完成一次时序预测、异常分析与系统接入
时序大模型的价值,不是把一段历史数值“再算一遍”,而是把连续变化的数据转化为下一步可以执行的判断。以园区电力负荷为例:运维团队既想知道未来 24 小时每小时需要预留多少容量,也想尽早发现“实际负荷为何突然偏离正常轨迹”。这正是 TimechoAI 的使用场景——先让模型理解目标序列及其上下文,再把预测结果和实时数据放在一起分析。
TimechoAI 是面向数值时间序列的云服务,提供建模分析、趋势预测、异常检测,以及控制台、REST API 和 Python SDK 接入能力。下面以“园区负荷预测”为一条完整主线,说明怎样实际使用它,以及它在时序分析中具体能帮助团队做什么。
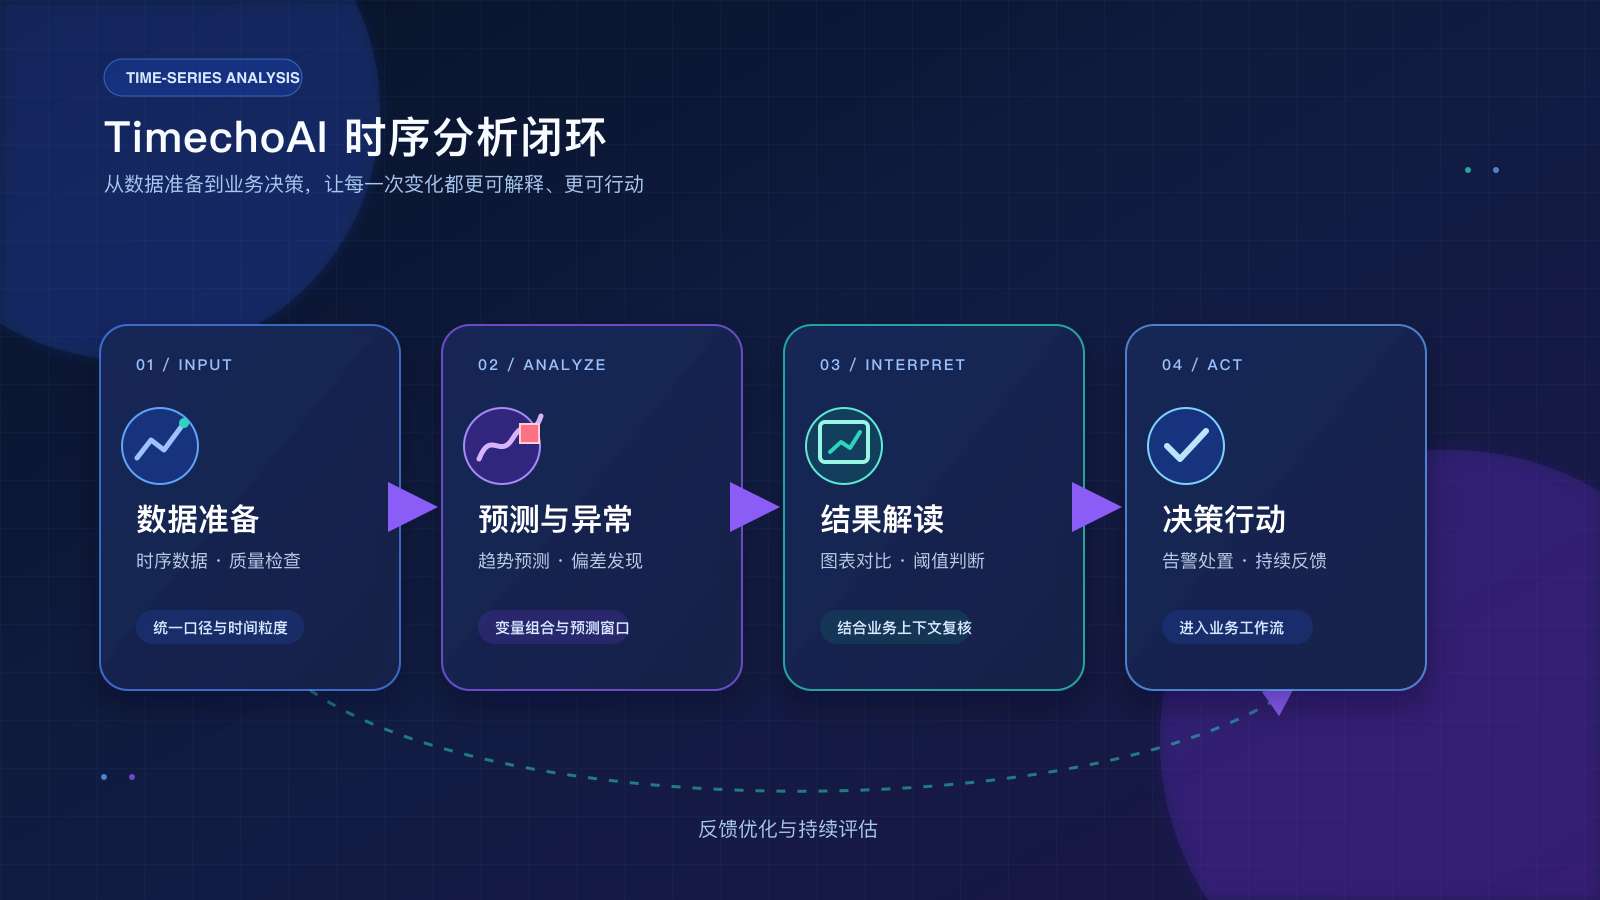
图:TimechoAI 的典型使用闭环。模型预测、实际观测、异常判断和业务处置需要连续衔接。
一、先准备一个能回答业务问题的数据集
不要从“我有多少数据”出发,而要从“我准备预测什么”出发。本例的目标是预测未来 24 个小时的园区总负荷,最小 CSV 可以按下面方式组织:
输入字段与角色
| 字段 | 示例 | 在分析中的角色 |
|---|---|---|
time | 2026-07-27 09:00:00 | 时间轴,所有序列必须按同一粒度对齐 |
load_kw | 1280.4 | 目标变量,即希望预测的负荷 |
temperature_c | 31.6 | 历史协变量,帮助解释过去负荷为何变化 |
is_holiday | 0 / 1 | 可作为含未来数据的协变量,因为节假日计划可提前获知 |
这里有一个关键区别:温度、湿度等已经发生的数据只能作为历史协变量;节假日、排产计划、预约量等未来已经确定的信息,才可以作为含未来数据的协变量。把未来时刻才会知道的真实负荷或真实温度混入输入,会造成数据泄漏,离线结果再好也没有上线价值。
在上传前先检查三件事:时间戳是否连续且时区一致;数值单位是否统一;缺失点、重复点和设备停机等特殊工况是否被标记。TimechoAI 的数据评估可帮助查看完整性、可预测性和综合评分:完整性低时先治理缺失、重复或时间戳异常;可预测性低并不必然说明数据错误,而是提示这条曲线的随机波动较强,可能需要加入温度、班次或计划等解释变量。
二、控制台实操:把数据变成一次可追溯的预测任务
进入 TimechoAI 时序大模型云服务 并登录后,按以下步骤完成第一次预测。控制台以“会话”为单位保存一项预测任务的数据、参数与结果,因此同一个团队可以保留多次历史实验并回看差异。
- 点击“新建会话/新建预测”,填写会话名称,选择模型与预测配置。
- 添加目标变量
load_kw。可以直接绘制曲线、逐行输入“时间戳,数值”,或上传 CSV/TsFile。实际业务中建议上传整理好的 CSV 或 TsFile;系统解析后会显示数据条数和列名。 - 在“标注列角色”中把
time标为时间、load_kw标为目标变量、temperature_c标为协变量、is_holiday标为“协变量(含未来数据)”。无关列标为忽略,避免把无意义字段交给模型。 - 设置预测长度。官方能力支持 1 到 720 步;若数据粒度为小时,本例先设置 24 步,得到明天每小时的负荷预测。先选短而可验证的窗口,才能快速判断模型是否适合业务。
- 运行预测并保存结果。会话中保留了输入、模型配置和输出,后续可以替换协变量、调整预测长度,比较不同实验的效果。
这套操作体现了 TimechoAI 的第一项核心分析能力:它不只接收一列孤立数值,还允许在相同时间轴上组合目标变量、历史协变量和未来已知协变量。对于有明显季节性、班次规律或计划驱动的负荷、销量、流量数据,这比只看历史均值更接近真实决策条件。
三、Python SDK 实战:把预测接入现有数据管道
控制台验证有效后,可用官方 Python SDK 将预测放进定时任务、数据平台或告警服务。先安装 SDK:
pip install timecho-ai
下面的示例读取园区负荷数据,取最近 168 个小时作为输入,用温度作为历史协变量,预测后续 24 个小时。targets、history_covs、output_length 和 time_col 都是官方 SDK 文档中定义的调用参数。
import pandas as pd
from timecho_ai import TimechoAIClient

# load_history.csv 包含 time、load_kw、temperature_c 三列
raw_df = pd.read_csv("load_history.csv")

client = TimechoAIClient(api_key="替换为你的 TimechoAI API Key")

# 目标变量:历史负荷;历史协变量:已发生的温度
targets = raw_df[["time", "load_kw"]].tail(168)
history_covs = raw_df[["time", "temperature_c"]].tail(168)

forecast = client.forecast(
    targets=targets,
    history_covs=history_covs,
    output_length=24,
    time_col="time",
    auto_adapt=True,
)

print(forecast[0])
SDK 文档规定,目标序列数据长度可在 16 到 2,880 个点之间,预测长度可在 1 到 720 步之间。若已经掌握未来 24 小时的节假日、排产或计划温度,还可以追加 future_covs;它的长度应与预测长度一致,并且必须是预测开始前确实已经知道的数值信息。这样,模型可以把“明天是工作日还是节假日”这类已知条件纳入预测,而不是把它当作不可解释的随机波动。
API 场景也遵循相同的数据逻辑:TimechoAI 提供 POST https://ai.timecho.com/ai/api/v1/forecast 预测接口,使用 Authorization: Bearer {API-Key} 认证。返回结果包含预测时间、列名和对应预测数据;工程上应把原始请求、模型参数和返回结果一起记录,便于复盘某一条预测是如何产生的。API Key 是访问凭据,应放在环境变量或密钥服务中,不能提交到代码仓库。
四、预测结果怎么用于异常判断
“预测”回答的是未来大致会落在什么轨迹上;“异常分析”回答的是实际发生的值是否已经偏离了这条应有轨迹。TimechoAI 提供异常检测能力,实践中可把预测输出和实时观测接入下面的判断链路:
- 每小时请求一次未来 24 步预测,并将每个预测时间点与预测值保存下来。
- 当该时间点的真实
load_kw到达时,计算它与对应预测值的偏差,并结合业务阈值、历史波动区间或连续偏离次数判断是否需要告警。 - 告警出现后,不要只看“偏差大不大”,还要回看温度、节假日、设备状态和排产记录:如果协变量变化合理,可能是正常工况;如果协变量没有变化而负荷持续越界,则应排查设备、计量或用电行为。
- 将处置结果回填到会话或业务系统。若确认是设备故障、临时生产或数据采集异常,应保留标签,供后续数据治理和规则优化使用。
例如,模型预测某日 14:00 的负荷约为 1,280 kW,而实际值连续两个采样点超过 1,520 kW;同时温度和节假日状态没有明显变化。这个信号比“超过固定 1,500 kW 就报警”更有分析价值,因为它同时考虑了该时段原本的趋势和可解释的外部条件。反过来,如果预测本身就指出午后升温会带来负荷上升,系统便可把容量调度前置,而不是等越界后被动响应。
五、TimechoAI 的时序分析能力,具体体现在哪里
从上述实操可以看到,TimechoAI 的能力不是一个抽象标签,而是贯穿在每一步的数据决策中:
- 趋势预测:根据连续历史序列输出未来 1 到 720 步的数值结果,适合负荷、销量、流量、温度等按时间持续变化的指标。
- 协变量建模:区分已经发生的历史协变量与未来已知协变量,让天气、节假日、排产计划等业务上下文进入预测,而不是只依赖目标曲线本身。
- 数据评估与治理指引:用完整性、可预测性和综合评分帮助团队先判断数据能否建模、问题应优先出在数据质量还是序列规律。
- 异常检测与结果解读:把实时观测与预测轨迹、波动区间和业务阈值结合,支持从“发现偏差”走到“解释偏差、安排处置”。
- 产品化接入:控制台适合试验与复盘,Python SDK 和 REST API 则适合接入定时调度、告警系统、BI 看板和业务服务。
六、从一个小闭环开始推广到企业场景
建议先选取一条能快速验真的序列,例如一座园区的小时负荷、一条产线的温度、一个区域的订单量或一段网络流量。用控制台完成一次数据上传、会话预测和实际值对比,再把已经验证的输入字段与预测逻辑迁移到 SDK 或 API。这样可以先建立可信的分析闭环,再逐步扩展到更多设备、更多测点和更多业务系统。
如需了解企业级时序数据管理和服务,请访问 Timecho 企业版官方链接。如需申请试用、查看控制台和产品文档,请访问 时序大模型 TimechoAI。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 6
 0
- 0


 已为社区贡献15条内容

所有评论(0)