算法:动态规划基础(中):树型dfs+回溯+记忆化搜索
在前面几章中了解了所有的回溯和动态规划实际上都可以看作树形的 DFS,虽然部分动态规划题目使用DFS+记忆化仍然会超时,但这种思想仍提供了一种可行的思路。
1. 139. 单词拆分
给你一个字符串 s 和一个字符串列表 wordDict 作为字典。如果可以利用字典中出现的一个或多个单词拼接出 s 则返回 true。
注意:不要求字典中出现的单词全部都使用,并且字典中的单词可以重复使用。
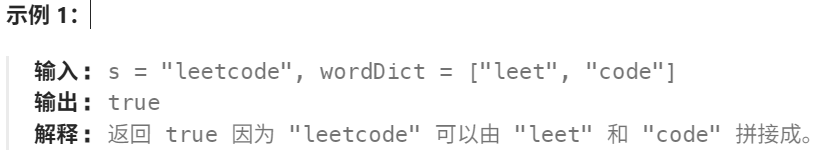
1.1 自底向上
循环尝试各个切分点,确认被切掉的一部分是否被给出的词典包含在内。
如果包含在内,则从被切开的部分继续递归尝试切剩下的,直到切到 0 说明都被切掉切包含了。
- 根节点:切分点在 s 最后一个字符 n
- 叶子节点:切分点在 s 第一个字符 1
- 子节点:当前切分点前面的所有可能的切分点
class Solution {
public:
    bool wordBreak(string s, vector<string>& wordDict) {
        int maxLen = 0;
        for(auto word : wordDict){
            maxLen = max(maxLen, (int)word.size());
        }
        unordered_set<string> words(wordDict.begin(), wordDict.end());
        int n = s.size();
        auto dfs = [&](this auto&& dfs, int i) -> bool {
            if(i == 0) return 1;
            for(int j = i - 1; j >= max(i - maxLen, 0); j--){
                bool isCurContain = words.contains(s.substr(j, i - j));
                bool isBeforeContain = dfs(j);
                if(isCurContain && isBeforeContain) return 1;
            }
            return 0;
        };
        return dfs(n);
    }
};
1.2 记忆化
class Solution {
public:
    bool wordBreak(string s, vector<string>& wordDict) {
        int maxLen = 0;
        for(auto word : wordDict){
            maxLen = max(maxLen, (int)word.size());
        }
        unordered_set<string> words(wordDict.begin(), wordDict.end());
        int n = s.size();
        vector<int> mem(n + 1, -1);
        auto dfs = [&](this auto&& dfs, int i) -> bool {
            if(i == 0) return 1;
            if(mem[i] != -1) return mem[i];
            for(int j = i - 1; j >= max(i - maxLen, 0); j--){
                bool isCurContain = words.contains(s.substr(j, i - j));
                bool isBeforeContain = dfs(j);
                if(isCurContain && isBeforeContain){
                    mem[i] = 1;
                    return 1;
                }
            }
            mem[i] = 0;
            return 0;
        };
        return dfs(n);
    }
};
1.3 动态规划
class Solution {
public:
    bool wordBreak(string s, vector<string>& wordDict) {
        int n = s.size();
        unordered_set<string> uset;
        int maxLen = 0;
        for(auto ss : wordDict){
            uset.insert(ss);
            maxLen = max(maxLen,(int)ss.size());
        }
        vector<int> f(n + 1);
        // 必须n + 1,f[i]表示前i个,因为可能一整个都是,此时f[n]依赖f[0]
        // 否则以f[i]表示索引i,则f[n-1]如果是的话,此时f[0]表示索引为0的,f[n-1]无法依赖
        f[0] = 1;
        for(int j = 1; j <= n; j++){
            for(int i = j - 1; i >= 0 && j - i <= maxLen ; i--){
                if(f[i] && uset.count(s.substr(i, j - i))){
                    f[j] = 1;
                    break;
                }
            }
        }
        return f[n];
    }
};
2. 300.最长递增子序列
给你一个整数数组 nums ,找到其中最长严格递增子序列的长度。
子序列 是由数组派生而来的序列,删除(或不删除)数组中的元素而不改变其余元素的顺序。例如,[3,6,2,7] 是数组 [0,3,1,6,2,2,7] 的子序列。
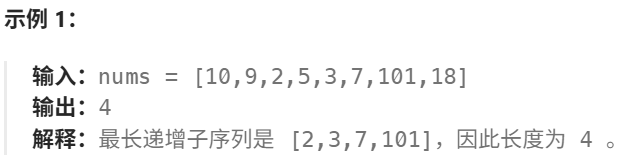
2.1 自底向上
题目分解:题目要求数组中最长递增子序列,那么我们可以求从数组每个元素开始的最长递增子序列,遍历后取最大值。
- 根节点:当前开始的元素
- 子节点:从当前元素开始,任一个大于它的元素
- 叶子节点:最后一个元素
- 递归返回值:从当前节点开始的最大长度
class Solution {
public:
    int lengthOfLIS(vector<int>& nums) {
        int n = nums.size();
        auto dfs = [&](this auto&& dfs, int cur) -> int {
            int curMax = 1;
            for(int nxt = cur + 1; nxt < n; nxt++){
                if(nums[nxt] > nums[cur]){
                    int subLen = dfs(nxt);
                    int curLen = subLen + 1;
                    curMax = max(curMax, curLen);
                }
            }
            return curMax;
        };
        int ans = 0;
        for(int i = 0; i < n; i++){
            ans = max(ans, dfs(i));
        }
        return ans;
    }
};
2.2 记忆化
- 根节点:当前开始的元素
- 子节点:从当前元素开始,任一个大于它的元素
- 叶子节点:最后一个元素
- 递归返回值:从当前节点开始的最大长度
- 记忆:从当前节点开始的最大长度
class Solution {
public:
    int lengthOfLIS(vector<int>& nums) {
        int n = nums.size();
        vector<int> mem(n+1, -1);
        auto dfs = [&](this auto&& dfs, int cur) -> int {
            int curMax = 1;
            if(mem[cur] != -1) return mem[cur];
            for(int nxt = cur + 1; nxt < n; nxt++){
                if(nums[nxt] > nums[cur]){
                    int subLen = dfs(nxt);
                    int curLen = subLen + 1;
                    curMax = max(curMax, curLen);
                }
            }
            mem[cur] = curMax;
            return curMax;
        };
        int ans = 0;
        for(int i = 0; i < n; i++){
            ans = max(ans, dfs(i));
        }
        return ans;
    }
};
2.3 动态规划
class Solution {
public:
    int lengthOfLIS(vector<int>& nums) {
        int n = nums.size();
        int ans = 1;
        vector<int> f(n, 1);
        for(int i = 1; i < n; i++){
            for(int j = 0; j < i; j++){
                if(nums[i] > nums[j])
                    f[i] = max(f[i], 1 + f[j]);
            }
            ans = max(ans, f[i]);
        }
        return ans;
    }
};
3. 152.乘积最大子数组
给你一个整数数组 nums ,请你找出数组中乘积最大的非空连续 子数组(该子数组中至少包含一个数字),并返回该子数组所对应的乘积。
测试用例的答案是一个 32-位 整数。
请注意,一个只包含一个元素的数组的乘积是这个元素的值。
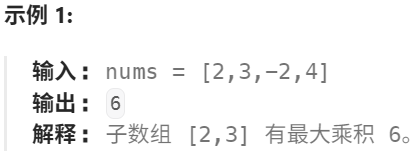
3.1 自底向上
同理,与上一题一样,将乘积最大子数组拆解为以数组中每个元素作为起点的最大子数组乘积.
- 根节点:当前元素
- 子节点:在当前元素之后的一个元素
- 叶子节点:最后一个元素
- 递归返回值:从当前节点开始的最大积和最小积,因为可能负负得正
- 注意:这里要求的是连续的,所以只有一个子节点
class Solution {
public:
    int maxProduct(vector<int>& nums) {
        int n = nums.size();
        auto dfs = [&](this auto&& dfs,int cur) -> pair<int, int> {
            if(cur >= n) return {1, 1};
            int curNum = nums[cur];
            int nxt = cur + 1;
            auto subPro = dfs(nxt);
            int subPro1 = subPro.first;
            int subPro2 = subPro.second;
            int maxPro = max(curNum, max(curNum * subPro1, curNum * subPro2));
            int minPro = min(curNum, min(curNum * subPro1, curNum * subPro2));
            return {maxPro, minPro};
        };
        int ans = INT_MIN;
        for(int i = 0; i < n; i++){
            auto curAns = dfs(i);
            int a = curAns.first;
            int b = curAns.second;
            ans = max(ans, max(a, b));
        }
        return ans;
    }
};
3.2 记忆化
- 根节点:当前元素
- 子节点:在当前元素之后的一个元素
- 叶子节点:最后一个元素
- 递归返回值:从当前节点开始的最大积和最小积,因为可能负负得正
- 记忆:当前节点的最大和最小积
- 注意:这里要求的是连续的,所以只有一个子节点
class Solution {
public:
    int maxProduct(vector<int>& nums) {
        int n = nums.size();
        vector<int> memMax(n + 1, INT_MIN);
        vector<int> memMin(n + 1, INT_MAX);
        auto dfs = [&](this auto&& dfs,int cur) -> pair<int, int> {
            if(cur >= n) return {1, 1};
            if(memMax[cur] != INT_MIN) return{memMax[cur], memMin[cur]};
            int curNum = nums[cur];
            int nxt = cur + 1;
            auto subPro = dfs(nxt);
            int subPro1 = subPro.first;
            int subPro2 = subPro.second;
            int maxPro = max(curNum, max(curNum * subPro1, curNum * subPro2));
            int minPro = min(curNum, min(curNum * subPro1, curNum * subPro2));
            memMax[cur] = maxPro;
            memMin[cur] = minPro;
            return {maxPro, minPro};
        };
        int ans = INT_MIN;
        for(int i = 0; i < n; i++){
            auto curAns = dfs(i);
            int a = curAns.first;
            int b = curAns.second;
            ans = max(ans, max(a, b));
        }
        return ans;
    }
};
3.3 动态规划
class Solution {
public:
    int maxProduct(vector<int>& nums) {
        int n = nums.size();
        vector<int> minF(n, INT_MAX);
        vector<int> maxF(n, INT_MIN);
        minF[0] = nums[0];
        maxF[0] = nums[0];
        int ans = nums[0];
        for(int i = 1; i < n; i++){
            int a = nums[i];
            int b = nums[i] * minF[i - 1];
            int c = nums[i] * maxF[i - 1];
            minF[i] = min({a, b, c});
            maxF[i] = max({a, b, c});
            ans = max(ans, maxF[i]);
        }
        return ans;
    }
};
4. 416.分割等和子集
给你一个 只包含正整数 的 非空 数组 nums 。请你判断是否可以将这个数组分割成两个子集,使得两个子集的元素和相等。
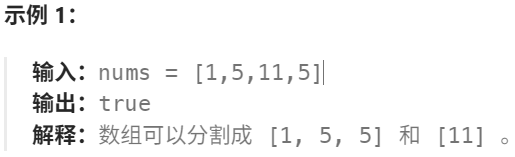
4.1 自顶向下
翻译:是否可以取出一部分使得总和为总数组和的一半。
该题类似二叉树中的路径总和Ⅲ,所以使用自顶向下,路径总和Ⅲ中使用前缀和简化计算,如果不用前缀和的话,就需要双重递归,一个递归枚举起点,一个递归计算路径总和。
本题使用这种思路,枚举起点计算路径总和。
- 根节点:-1(因为枚举数组中所有的元素)
- 叶子节点:路径和 >= target 或者 走到最后一个节点
- 子节点:当前元素之后的所有元素
class Solution {
public:
    bool canPartition(vector<int>& nums) {
        int sum = 0;
        for(auto num : nums){
            sum += num;
        }
        if(sum % 2 == 1) return 0;
        int n = nums.size();
        int target = sum / 2;
        bool ans = 0;
        int path = 0;
        auto dfs = [&](this auto&& dfs, int cur) -> void {
            if(ans == 1) return;
            if(path > target) return;
            if(path == target){
                ans = 1;
                return;
            }
            if(cur >= n) return;
            for(int nxt = cur + 1; nxt < n; nxt++){
                path += nums[nxt];
                dfs(nxt);
                path -= nums[nxt];
                if(ans) break;
            }
        };
        dfs(-1);
        return ans;
    }
};
4.2 记忆化
- 根节点:-1(因为枚举数组中所有的元素)
- 叶子节点:路径和 >= target 或者 走到最后一个节点
- 子节点:当前元素之后的所有元素
- 记忆:从当前节点开始,这个路径是否走过?
class Solution {
public:
    bool canPartition(vector<int>& nums) {
        int sum = 0;
        for(auto num : nums){
            sum += num;
        }
        if(sum % 2 == 1) return 0;
        int n = nums.size();
        int target = sum / 2;
        bool ans = 0;
        int path = 0;
        vector<unordered_map<int, bool>> mem(n + 1);
        auto dfs = [&](this auto&& dfs, int cur) -> void {
            if(ans == 1) return;
            if(path > target) return;
            if(path == target){
                ans = 1;
                return;
            }
            if(cur >= n) return;
            if(mem[cur + 1].count(path)) return;
            mem[cur + 1][path] = 1;
            for(int nxt = cur + 1; nxt < n; nxt++){
                path += nums[nxt];
                dfs(nxt);
                path -= nums[nxt];
                if(ans) break;
            }
        };
        dfs(-1);
        return ans;
    }
};
5. 32.最长有效括号
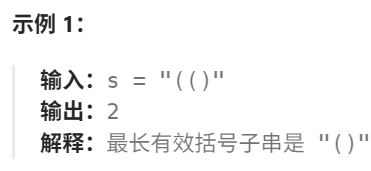
给你一个只包含 '(' 和 ')' 的字符串,找出最长有效(格式正确且连续)括号 子串 的长度。
左右括号匹配,即每个左括号都有对应的右括号将其闭合的字符串是格式正确的,比如 "(()())"。
5.1 双重循环
思路是枚举每个起点,找到每个起点的最长有效括号,但是用递归完全没必要,因为每个节点只有一个子节点,那就是自己后方的元素,也可用使用双重循环。
class Solution {
public:
    int longestValidParentheses(string s) {
        int n = s.size();
        int ans = 0;
        vector<int> mem(n, -1);  // 记忆化数组,mem[i]表示从位置i开始的最长有效括号长度

        // 递归函数
        auto dfs = [&](this auto&& dfs, int start) -> int {
            if (start >= n) return 0;  // 超出边界
            if (mem[start] != -1) return mem[start];  // 已计算过

            int balance = 0;
            int maxLen = 0;

            // 从start开始往后找有效括号
            for (int i = start; i < n; i++) {
                if (s[i] == '(') balance++;
                else balance--;

                if (balance < 0) break;  // 无效

                if (balance == 0) {
                    int len = i - start + 1;
                    maxLen = max(maxLen, len);
                }
            }

            // 递归计算从start+1开始的结果
            int nextResult = dfs(start + 1);

            // 取最大值:要么从start开始的有效长度,要么从start+1开始的结果
            mem[start] = max(maxLen, nextResult);
            ans = max(ans, mem[start]);

            return mem[start];
        };

        dfs(0);
        return ans;
    }
};
class Solution {
public:
    int longestValidParentheses(string s) {
        int n = s.size();
        int ans = 0;

        // 枚举每个起点
        for (int start = 0; start < n; start++) {
            int balance = 0;  // 括号平衡计数器
            int maxLen = 0;   // 从start开始的最长有效括号长度

            // 从起点开始往后找有效括号
            for (int i = start; i < n; i++) {
                if (s[i] == '(') {
                    balance++;
                } else {
                    balance--;
                }

                if (balance < 0) {
                    break;  // 右括号太多,无效
                }

                if (balance == 0) {
                    int len = i - start + 1;
                    maxLen = max(maxLen, len);
                }
            }

            ans = max(ans, maxLen);
        }

        return ans;
    }
};
5.2 栈
-
栈里存的不是括号,而是下标
-
栈底永远保存着最后一个无效位置的下标
-
遇到'('就把它下标入栈
-
遇到')'就出栈,然后:
-
如果栈空了,说明这个')'是无效的,因为没有弹出对应的 '(',弹出的是无效位置的下标,这时不用更新 ans,把它下标入栈(作为新的边界)
-
如果栈不空,说明弹出的是有效的 '(',用当前下标 - 栈顶(也就是无效位置)下标 计算有效长度
-
class Solution {
public:
    int longestValidParentheses(string s) {
        int n = s.size();
        stack<int> st;
        st.push(-1);  // 初始边界
        int ans = 0;
        for(int i = 0; i < n; i++){
            if(s[i] == '('){
                st.push(i);
            }else{
                st.pop();
                if(st.empty()){
                    st.push(i);
                }else{
                    int idx = st.top();
                    ans = max(ans, i - idx);
                }
            }
        }
        return ans;
    }
};

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 10
 0
- 0


 已为社区贡献2条内容

所有评论(0)