基于DP动态规划的混合动力汽车P2构型探索
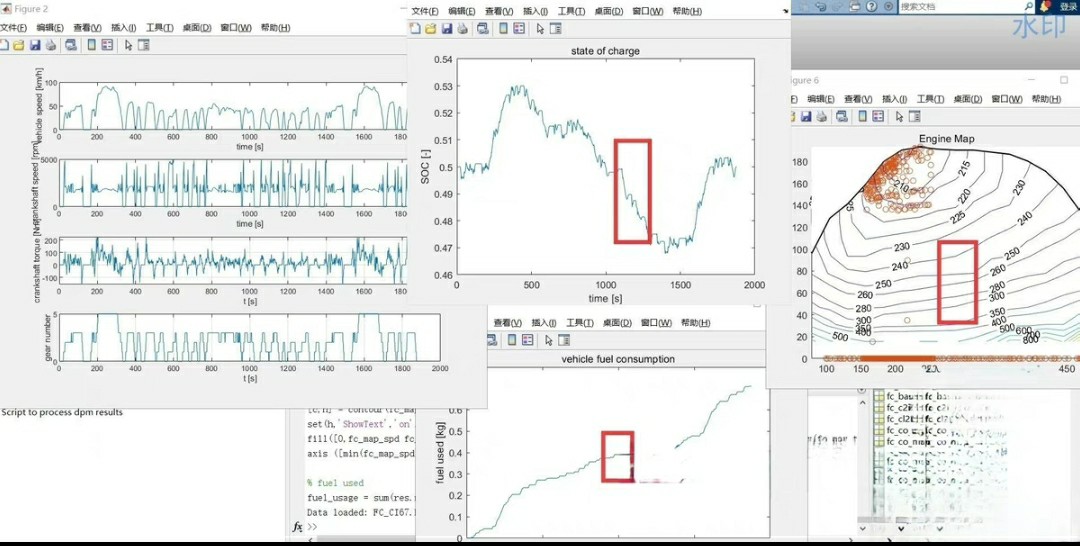
基于DP动态规划的混合动力汽车,P2构型 1.车辆数据来源advisor。 2.电池SOC为电量维持型策略。 3.全程序包含逆向迭代和正向寻优过程。 4.DP可为后续mpc提供参考,也可将数据提取作为神经网络训练和规则作为参考。
在混合动力汽车的研究领域,P2构型凭借其独特的结构优势受到广泛关注。今天咱们就来唠唠基于DP动态规划在P2构型混合动力汽车上的应用。
车辆数据来源
本次研究的车辆数据源自advisor。advisor是一款强大的车辆系统仿真软件,为我们提供了丰富且精准的车辆参数,像是发动机特性、电机性能、变速器传动比等,这些数据就如同搭建房屋的基石,是后续分析和算法实现的基础。比如说,通过advisor获取发动机在不同转速和扭矩下的燃油消耗率,这在后续计算车辆能量管理策略时起着关键作用。
电池SOC电量维持型策略
电池的状态(SOC,State of Charge)管理策略采用电量维持型。简单来讲,就是要在车辆行驶过程中,尽可能让电池的电量维持在一个相对稳定的区间内,既不能让电池过度放电,影响电机性能,也不能一直充电而浪费能源。代码实现部分可以是这样:
# 假设初始SOC值
soc = 0.5
# 设定SOC的上下限
soc_lower_limit = 0.3
soc_upper_limit = 0.7
# 模拟行驶过程中SOC的更新
for time_step in range(total_time_steps):
    # 根据当前的动力需求计算电池的充放电功率
    power = calculate_power(demand)
    if power > 0:  # 放电
        soc = soc - power * time_step_duration / battery_capacity
    else:  # 充电
        soc = soc + abs(power) * time_step_duration / battery_capacity
    # 确保SOC在限定范围内
    if soc < soc_lower_limit:
        soc = soc_lower_limit
    elif soc > soc_upper_limit:
        soc = soc_upper_limit
这段代码中,我们先设定了初始SOC值以及上下限。在每个时间步中,根据动力需求计算电池的充放电功率,然后更新SOC值。最后通过判断,保证SOC始终在我们设定的合理区间内。这样的电量维持型策略,能有效平衡电池的使用和车辆的动力性能。
全程序的逆向迭代和正向寻优过程
整个程序包含了逆向迭代和正向寻优两个重要过程。逆向迭代过程就像是我们从目的地往回找路线,先确定在最后一个时刻车辆处于不同状态时的最优决策,然后逐步向前推算。而正向寻优则是根据逆向迭代得到的结果,从初始状态开始,按照最优策略一步步执行,使车辆在整个行驶过程中达到最优性能。
逆向迭代代码示例
# 定义状态空间
states = define_states()
# 定义决策空间
decisions = define_decisions()
# 初始化代价矩阵
cost_matrix = [[0 for _ in range(len(decisions))] for _ in range(len(states))]
# 逆向迭代
for time in reversed(range(total_time_steps)):
    for state_index, state in enumerate(states):
        for decision_index, decision in enumerate(decisions):
            # 计算下一状态
            next_state = calculate_next_state(state, decision)
            # 计算代价
            cost = calculate_cost(state, decision, time) + cost_matrix[next_state_index][next_time_step]
            cost_matrix[state_index][decision_index] = cost
在这段逆向迭代代码中,我们先定义了状态空间和决策空间,初始化了代价矩阵。然后从最后一个时间步开始逆向遍历,对于每个状态和决策,计算下一状态以及相应的代价,并更新代价矩阵。
正向寻优代码示例
# 正向寻优
current_state = initial_state
optimal_decisions = []
for time in range(total_time_steps):
    best_decision_index = find_best_decision(current_state, cost_matrix)
    optimal_decisions.append(decisions[best_decision_index])
    current_state = calculate_next_state(current_state, decisions[best_decision_index])
正向寻优时,从初始状态开始,根据逆向迭代得到的代价矩阵找到每个时刻的最优决策,并更新当前状态,将最优决策记录下来,这样就得到了整个行驶过程的最优策略。
DP为后续研究的作用
DP动态规划在这里不仅对当前混合动力汽车P2构型的能量管理起到关键作用,还为后续研究提供了诸多可能性。一方面,它可以为后续的MPC(Model Predictive Control,模型预测控制)提供参考。MPC是一种先进的控制策略,通过对系统未来行为的预测来优化当前决策。DP得到的最优决策序列和状态轨迹等信息,能帮助MPC更好地构建预测模型和优化目标函数。比如说,DP计算出的不同工况下的最优动力分配,能让MPC在实时控制中更快地找到接近最优的控制策略。
另一方面,我们可以从DP的计算结果中提取数据作为神经网络的训练样本,同时把DP得到的规则作为参考。神经网络在处理复杂非线性关系方面有着强大的能力,通过DP提供的数据进行训练,神经网络可以学习到更准确的车辆能量管理模式。例如,以DP计算出的车辆状态、决策以及对应的能耗等数据作为训练集,训练一个神经网络模型,让它能够在新的行驶工况下给出合理的能量管理决策。
基于DP动态规划的混合动力汽车P2构型研究,从数据获取到策略制定,再到为后续研究铺砖引路,是一个充满挑战与机遇的领域,期待未来能看到更多基于此的创新成果。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 24
 0
- 0


 已为社区贡献7条内容

所有评论(0)