主数据管理系统(7)- 雪花算法
这次的雪花算法非本人的自我理解,属于整合内容。
一、定义
雪花算法是 Twitter 开发的一种分布式唯一 ID 生成算法,用于在分布式系统中生成全局唯一的 64 位整数 ID。它具有高性能、高可用、单调递增(或部分单调递增)的特性,广泛应用于分布式数据库主键、消息队列 ID 等场景。
二、雪花算法的核心思想
1、雪花算法生成的 ID 是一个 64 位的长整型,分为以下几个部分:
| 1 位(符号位) | 41 位(时间戳) | 10 位(机器 ID) | 12 位(序列号) |
1 位符号位
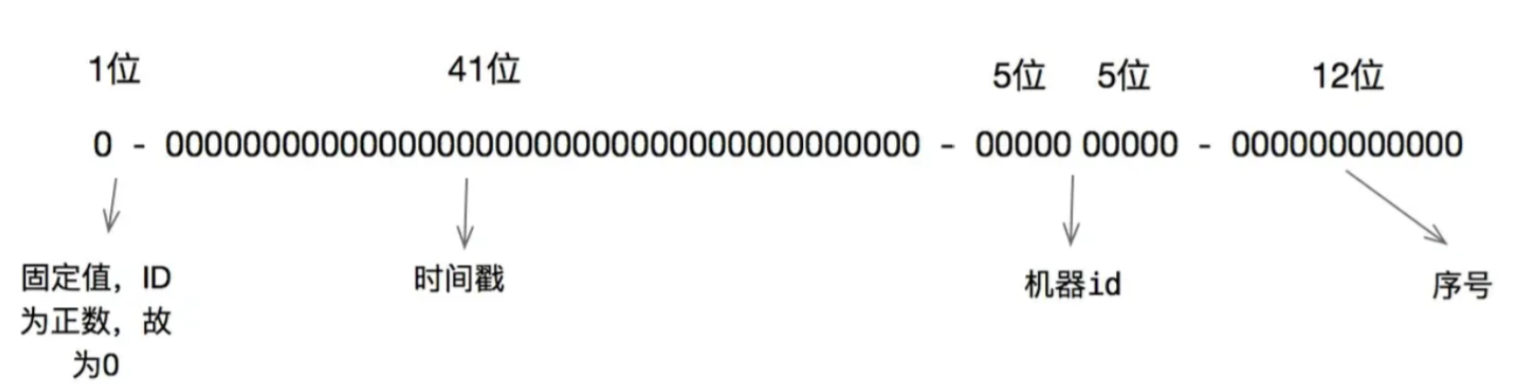
①固定为 0,表示正数。41 位时间戳
②记录毫秒级时间戳,通常是从一个固定起始时间(epoch,如 2020-01-01)到当前时间的差值。41 位可表示约 69 年(2^41 毫秒 ≈ 69 年)。10 位机器 ID
③表示机器或数据中心标识,支持 2^10 = 1024 个节点。12 位序列号
④表示同一毫秒内的递增序列号,每毫秒可生成 2^12 = 4096 个 ID。
2、通过这种结构,雪花算法确保:
①全局唯一性:时间戳、机器 ID 和序列号的组合保证 ID 唯一。
②单调递增:时间戳递增,同一毫秒内序列号递增,使 ID 大致有序。
③高性能:生成速度快,适合高并发场景。
④分布式友好:通过机器 ID 区分不同节点,无需中心化协调。
三、实现原理
雪花算法的工作流程如下:
1、时间戳生成:
获取当前毫秒级时间戳,减去固定的起始时间(epoch),得到时间差。
时间戳左移 22 位(10 位机器 ID + 12 位序列号),占据高位。
2、机器 ID 配置:每台机器分配一个唯一的机器 ID(通过配置文件、环境变量或分布式协调服务如 Zookeeper 指定)。机器 ID 左移 12 位,拼接到时间戳后。
3、序列号生成:在同一毫秒内,通过递增序列号生成不同 ID。序列号用完(达到 4096)时,等待下一毫秒并重置序列号。
4、ID 组合:通过位运算( 或 <<)将符号位(0)、时间戳、机器 ID 和序列号组合成 64 位 ID。
5、时钟回拨处理:如果系统时间回拨(当前时间小于上次生成 ID 的时间),需特殊处理以避免 ID 重复。常见策略:抛出异常、等待时间追上,或使用随机偏移。
四、java实现
package com.example.common.utils;


public class SnowflakeIdGenerator {

    // 起始时间戳(例如:2023-01-01 00:00:00)

    private final long START_TIMESTAMP = 1672502400000L;


    // 机器标识位数(5位,支持0~31)

    private final long WORKER_ID_BITS = 5L;

    // 数据中心标识位数(5位,支持0~31)

    private final long DATA_CENTER_ID_BITS = 5L;

    // 序列号位数(12位,支持0~4095)

    private final long SEQUENCE_BITS = 12L;


    // 机器标识最大值(31)

    private final long MAX_WORKER_ID = ~(-1L << WORKER_ID_BITS);

    // 数据中心标识最大值(31)

    private final long MAX_DATA_CENTER_ID = ~(-1L << DATA_CENTER_ID_BITS);


    // 序列号左移位数(时间戳+机器标识+数据中心标识的总位数)

    private final long SEQUENCE_SHIFT = 0L;

    // 机器标识左移位数(序列号位数)

    private final long WORKER_ID_SHIFT = SEQUENCE_BITS;

    // 数据中心标识左移位数(序列号+机器标识位数)

    private final long DATA_CENTER_ID_SHIFT = SEQUENCE_BITS + WORKER_ID_BITS;

    // 时间戳左移位数(序列号+机器标识+数据中心标识位数)

    private final long TIMESTAMP_SHIFT = SEQUENCE_BITS + WORKER_ID_BITS + DATA_CENTER_ID_BITS;


    private final long workerId;         // 机器标识

    private final long dataCenterId;     // 数据中心标识(可固定或从Nacos获取)

    private long sequence = 0L;          // 序列号

    private long lastTimestamp = -1L;    // 上一次生成ID的时间戳


    /**

     * 构造器(通过IP生成workerId,dataCenterId固定为0或从配置获取)

     */

    public SnowflakeIdGenerator(long workerId, long dataCenterId) {

        if (workerId > MAX_WORKER_ID || workerId < 0) {

            throw new IllegalArgumentException("workerId超出范围: " + workerId);

        }

        if (dataCenterId > MAX_DATA_CENTER_ID || dataCenterId < 0) {

            throw new IllegalArgumentException("dataCenterId超出范围: " + dataCenterId);

        }

        this.workerId = workerId;

        this.dataCenterId = dataCenterId;

    }


    /**

     * 生成下一个ID

     */

    public synchronized long nextId() {

        long timestamp = System.currentTimeMillis();


        // 处理时钟回拨(若当前时间 < 上一次时间,说明时钟回拨)

        if (timestamp < lastTimestamp) {

            long offset = lastTimestamp - timestamp;

            if (offset > 5) { // 回拨超过5ms,抛出异常

                throw new RuntimeException("时钟回拨异常: " + offset + "ms");

            }

            // 回拨较少时,等待到上一次时间+1ms

            timestamp = lastTimestamp + 1;

        }


        // 同一毫秒内,序列号自增

        if (timestamp == lastTimestamp) {

            sequence = (sequence + 1) & (~(-1L << SEQUENCE_BITS)); // 序列号掩码(保证不超过最大值)

            // 序列号溢出(同一毫秒内超过4096个),等待下一毫秒

            if (sequence == 0) {

                timestamp = tilNextMillis(lastTimestamp);

            }

        } else {

            // 新的毫秒,序列号重置为0

            sequence = 0L;

        }


        lastTimestamp = timestamp;


        // 组合ID:时间戳 << 位移 + 数据中心ID << 位移 + 机器ID << 位移 + 序列号

        return ((timestamp - START_TIMESTAMP) << TIMESTAMP_SHIFT)

                | (dataCenterId << DATA_CENTER_ID_SHIFT)

                | (workerId << WORKER_ID_SHIFT)

                | sequence;

    }


    /**

     * 等待到下一毫秒

     */

    private long tilNextMillis(long lastTimestamp) {

        long timestamp = System.currentTimeMillis();

        while (timestamp <= lastTimestamp) {

            timestamp = System.currentTimeMillis();

        }

        return timestamp;

    }


}
代码说明
1、初始化:设置起始时间戳、机器 ID 和序列号的位数,验证 workerId 有效性。
2、ID 生成:获取当前时间戳,检查时钟回拨,递增序列号,组合 ID。
3、时钟回拨:检测到回拨时抛出异常(生产环境可改为等待或偏移)。
4、输出:生成 64 位唯一 ID,单调递增。
五、优点
1、高性能:单机每秒可生成数百万 ID。
2、全局唯一:时间戳和机器 ID 确保唯一性。
3、单调递增:适合需要排序的场景(如数据库索引)。
4、分布式友好:无需中心化协调。
六、缺点
1、时钟依赖:时间回拨可能导致 ID 冲突。
2、机器 ID 配置:需手动或通过服务分配唯一 ID。
3、ID 长度:64 位可能对某些场景过长。
七、实际应用
Twitter:生成推文 ID。
分布式数据库:如 MySQL、MongoDB 主键。
消息队列:如 Kafka、RabbitMQ 的消息 ID。
日志系统:生成唯一日志标识。
八、总结
雪花算法通过 64 位 ID(1 位符号 + 41 位时间戳 + 10 位机器 ID + 12 位序列号)实现分布式唯一 ID 生成。其原理依赖时间戳递增、机器 ID 区分节点和序列号递增,确保唯一性和单调性。上述 Java 实现展示了核心逻辑,适合高并发场景,但需注意时钟回拨和机器 ID 分配问题。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 14
 0
- 0


 已为社区贡献3条内容

所有评论(0)