数据结构与算法——串(含KMP算法)
串类型的定义及函数
我们之前说过,串和数组很相似。那么,如果我们用前面的线性表来定义理解串的话,我们就可以认为串是特殊的线性表,即元素为字符的线性表。
比如说,S = "abcdef",它就是一个串。我们同时要明确:
S是串名;这里的 abcdef 是串的内容;串的大小是6;这里的字符,可以是字母,也可以是数字或者其他符号。
倘若一个串中什么元素都没有,那么我们就称其为空串。例如:S = ""
还需要注意的是,我们前面说到过,在C/C++语言中,默认在串的后面,都会有一个'\0'。
以上,是我们对于串的一些文字的定义。我们下面来看一看串的ADT定义。不过在ADT中,我们加入了串的基本操作,就是我们后面要讲的串的基本操作。
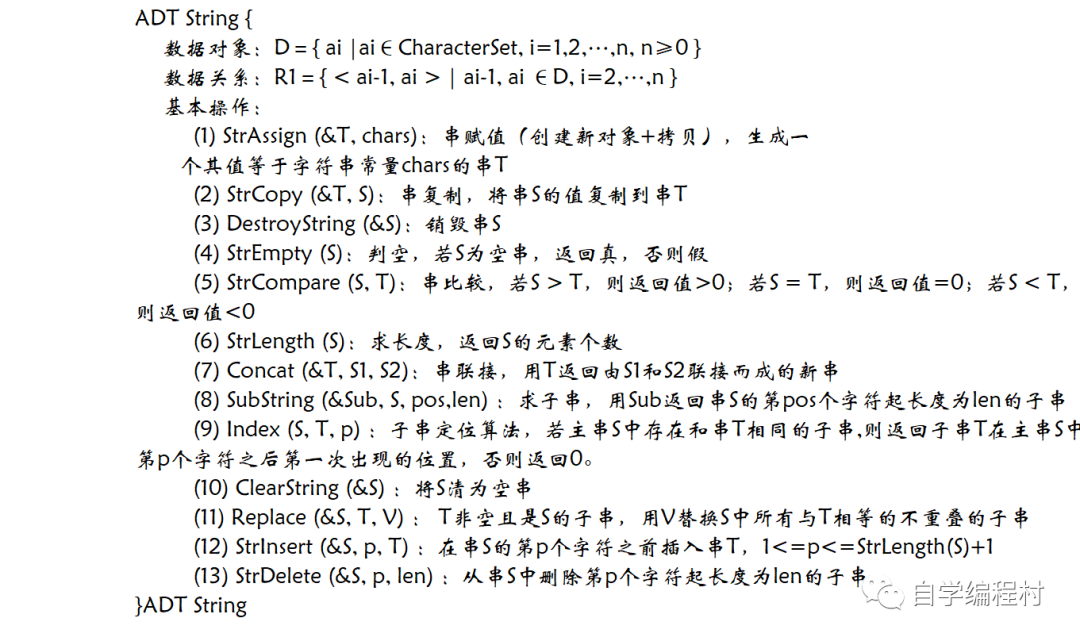
这个东西看一眼就行,不需要记住。就知道它说的是什么就可以了。
我们下面来挑一些重点的说说看——我们要说的叫串的最小操作子集。
所谓最小操作子集是一些串操作的集合,串的所有其他的操作都可以由最小操作子集来去实现,而串的最小操作子集中的操作不可以由其他操作来去完成。
最小操作子集一共有五个,分别为:
串赋值 StrAssign
求串长 StrLength
串比较 StrCompare
求子串 SubString
串联接 Concat
这些操作在实现上本身也很简单了。我们在C语言中讲解字符串函数的时候,相信大家也都多多少少见到过。
我们这里呢,就简单给出它们实现的大概的思路。因为确实比较简单。
对于StrAssign,就是把一个字符串的每一个元素依次一一地复制到另一个串身上,从而实现整个字符串的赋值。
对于StrLength,就是从字符串的头依次遍历到字符串的尾部,直到遍历到'\0'结束。每次遍历一个字符,就将计数器加一。
对于StrCompare,就是把两个字符串的每一个字符从最左端开始逐一 一对一对地比较。比较的依据是字典序。
对于SubString,就是求一个串里面有没有某个字串。一般来说,有则返回true,没有则返回false。比如对于字符串 s = "abcdef",那么a.SubString("abc")就是true。因为在字符串s中,确实有“abc”这样一个子串。
对于Concat,就是把两个字符串拼接起来。仅此而已。比如两个串 a = "abc",b = “cde”,那么Concat(a,b)返回的字符串就是"abccde"
这些内容我们需要理解其原理,不过在日后的开发当中,我们很少会再把这些函数从头直接再写一遍了。我们都是直接调用库里帮助我们写好的就行。
以上的函数是具体代码实现不是我们本节的重点,因为比较简单。我们重点来讲解优化后的串的模式匹配算法——也就是通常来说的KMP算法。
串的模式匹配算法
什么叫串的模式匹配?
模式匹配:给定主串S=“s1s2…sn”和模式串T=“t1t2…tm”,在主串S中寻找子串T的过程称为模式匹配,也就是去看在主串S中是否存在字串T。如果匹配成功,返回相匹配的子串的第一个字符在S中的位置,如果匹配失败,返回0。它也称为字符串定位算法等。在实际应用中是很广泛的一种算法。比如用在搜索引擎中。
那么,我们如何来去写出这样一个算法呢?
通常来说,我们有两种写法。
第一种是BF算法,还有一种是KMP算法。
01
BF算法

所谓BF,就是Brute Force,也称暴力搜索算法。它最简单直观、最容易实现。所以我们今天肯定不是来讲这种算法。
但我们还是要来提一下这种算法:
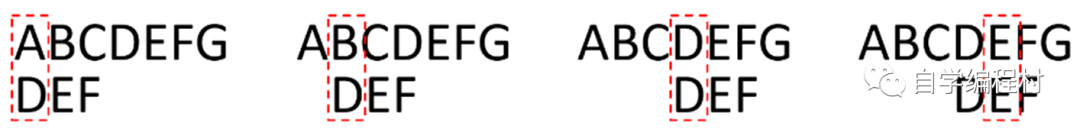
这种算法是思路是:
首先将原串和子串左端对齐,逐一比较;如果第一个字符不能匹配,则子串向后移动一位继续比较;如果第一个字符匹配,则继续比较后续字符,直至全部匹配。
说到底,就是暴力搜索啦。
我们给出示例代码:
int Index_BF(SString S, SString T, int pos) { //SString类型为我们自定义的string类型,并规定在字符串第一个位置存放的是字符串的长度
//返回模式T在主串S中第pos个字符开始第一次出现的位置,若不存在则返回值为0
//其中,T非空,1<=pos<=S.length
    int i = pos, j = 1; // i指向主串待比较字符,j指向子串待比较字符
    while (i <= S[0] && j <= T[0]) { //两个串均未比较到串尾  S[0]代表的是字符串的长度
    if (S.ch[i] == T.ch[j]) {//继续比较后继字符
        ++i; ++j;
    }
    else {
        i = i - j + 2;//指针后退重新匹配,主串从下一个字符开始匹配
        j=1;
    }
}
if (j > T[0])
    return i - T[0];//匹配成功,返回匹配的子串在主串的起始位置
else
    return 0;//匹配失败

}
关于它的时间复杂度:
设主串的长度为n,子串的长度为m,假设从主串的第i个位置开始与模式串匹配成功,则在前i-1躺匹配中字符总共比较了(i-1)*m次;若第i趟成功的字符比较次数为m,则总比较次数为i*m。因此最坏情况下匹配成功的平均比较次数为
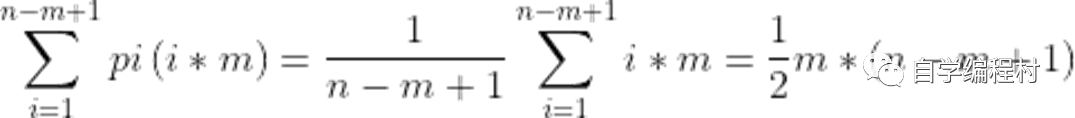
即最坏情况下的平均时间复杂度为O(n*m)。
02
KMP算法

能够想象,当我们的模式串或者主串很长时,它的算法的时间复杂度就会很大;并且当模式串的长度接近于主串时,它的算法的时间复杂度就来到了O(N^2)。所以,我们迫切渴望有一种算法,能够降低我们的时间复杂度,提高查找的效率。KMP算法应运而生。
Knuth,Morris,Pratt共同提出,其对于任何模式和目标序列,都可以在线性时间内完成匹配查找,而不会发生退化,是一个非常优秀的模式匹配算法。它曾经被选为十大算法。
KMP算法在开始的时候,也是将原串和子串左端对齐,逐一比较,但是当出现不匹配的字符时,KMP算法不是向BF算法那样向后移动一位,而是按照事先计算好的“部分匹配表”中记载的位数来移动,节省了大量时间。
我们下面将会用图来演示一下。
我们首先要明白,KMP算法是什么样子的。举个例子:
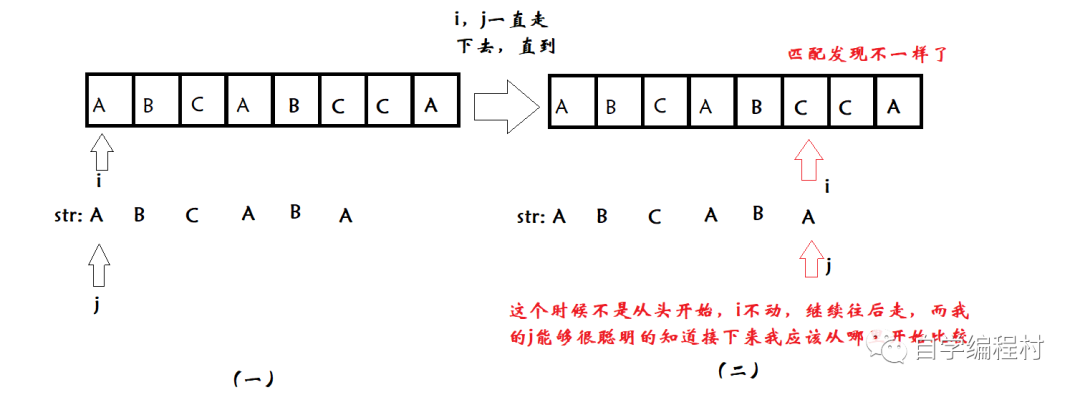
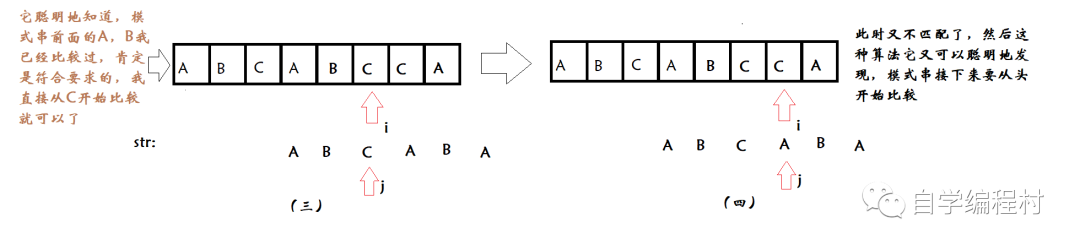
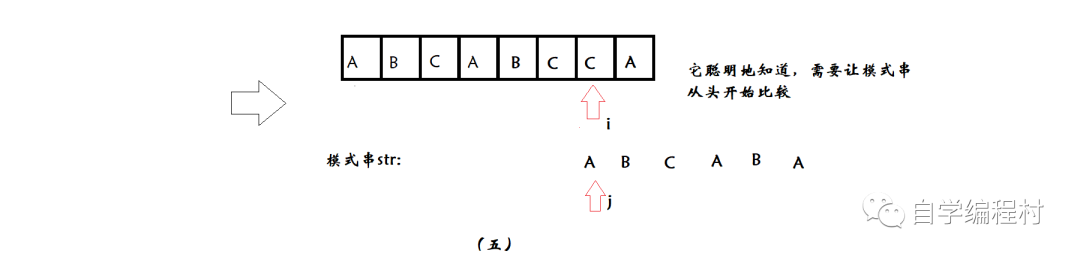
从上图可以看到,算法的核心就在于,当图(二)中发现模式串和原生串匹配不了的时候,它能够很聪明的知道接下来我应当从模式串的哪一个位置开始比较。而不是再傻傻地让i回退,然后j置零了。
因为我们会发现,这里的i自始至终都是没有回退的(就是没有变小的过程)。所以,我们实际上就只把原生串遍历了一遍。那么在不匹配的时候,由于我的i是永远都不会回退的,所以关键就是j能够跳到str中下一个比较的位置。
那现在问题来了,我们如何才能“聪明地”知道,当我不匹配的时候,我下一步的j应当跳在什么地方呢?
我们可以把不匹配时跳到“位置”用一个next数组来去存储。这样的话,当我不匹配的时候,我就直接去找next数组里的内容,就可以知道模式串将要跳往何处去。
那next数组怎么写?
用公式来表示(注意这里的下表是从1开始):
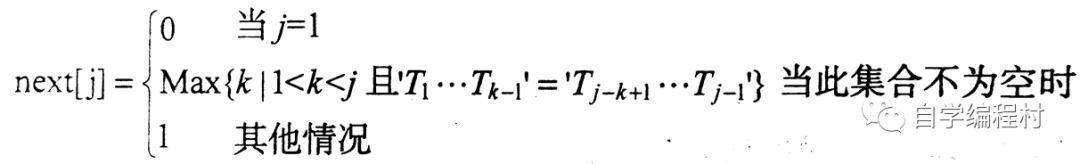
用文字来表示:
next[i]表示模式串A[0]至A[i]这个字串,使得前k个字符等于后k个字符的最大值,特别的k不能取i+i,因为字串一共才i+1个字符,自己跟自己相等毫无意义。
实际上问题和公式都不太好明白哈哈,那就记得next数组是要使得前k个字符等于后k个字符的最大值。我们举个例子:
对于模式串str = "ABCABC"
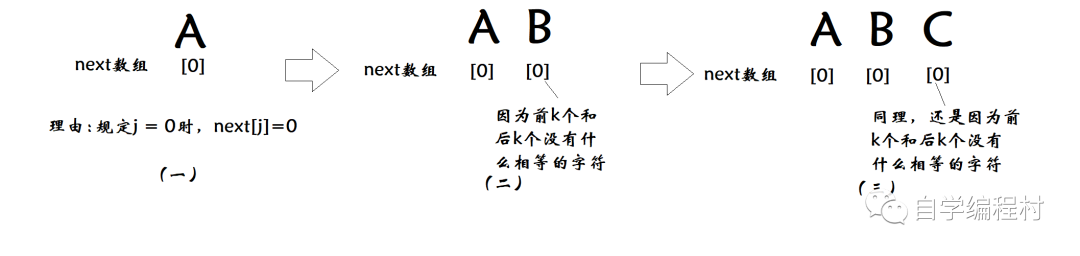
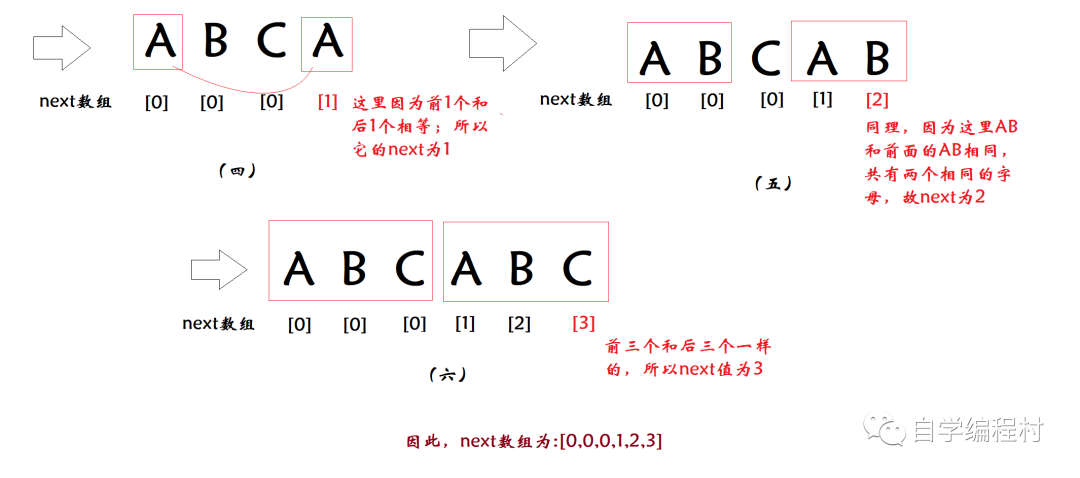
那么,我们next数组确定下来之后,就可以确定在不匹配的时候j往哪里跳了。假设模式串为s,则当一个地方不匹配的时候(假如为j),那么j应当跳到next[j-1]的位置,即j=next[j-1];它应当下面是一个完整的例子:
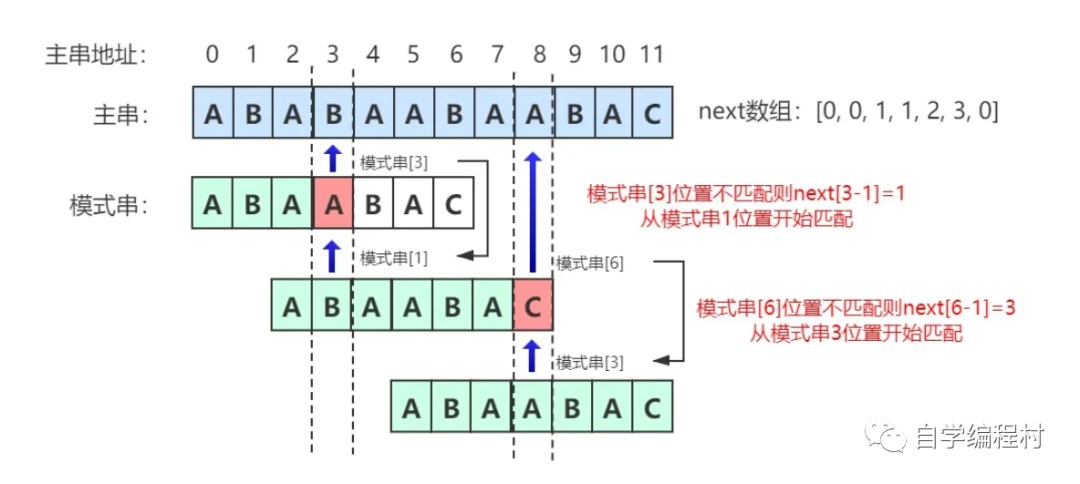
代码:
//next数组的求法
void BuildNext(string P){
  int m = P.length();
  int t = Next[0] = 0;
  int j = 1;
  while(j < m){
    if(P[j] == P[t]){
      j++;
      t++;
      Next[j-1] = t;
    }else if(t) {
         t = Next[t-1];
      }
    else{
         Next[j] = 0;
         j++;
     }
    }
}

//KMP算法
int KMP(string a,string b){
  BuildNext(b);//用来求Next数组
  int n = a.length();
  int m = b.length();
  int i = 0,j = 0;
  while(j < m && i < n){
    if(j < 0 || a[i] == b[j])
      i++,j++;
    else if(j) j = Next[j-1];
    else i++;
  }
  if(j == m)return i - j;
  return -1;
}
综上分析也可知,它的算法的时间复杂度为O(m+n)(假设模式串和原生串的长度分别为m和n)
关于这部分的OJ,可以直接从LeetCode上去搜索。
下面给出的示例OJ就用到了KMP算法:
https://leetcode.cn/problems/find-the-index-of-the-first-occurrence-in-a-string/
Part 3 本节回顾
简单来回顾下本节说了啥。
实际上本节说的内容也很简单,就是串的基本概念以及结构,并且介绍了串的最小操作子集。同时我们也介绍了KMP算法。
别看串的一些概念、操作简单,但是在未来的程序编写过程生涯中,它是一个经常出现的角色。也就是说,字符串才是用的最多的数据结构!所以,对于串的一些操作,要熟稔于心,对于KMP算法,也要能够说出个大概,最好能够写出代码来。
本节内容就到此结束啦,如果大家有什么意见欢迎加村长微信,同时,没有关注的小伙伴,看到这么用心的文章(不要脸哈哈哈),能不能给个关注呢?

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 30
 0
- 0


 已为社区贡献3条内容

所有评论(0)