Java中的贪心算法与关键图论问题实践

简介:在IT领域,贪心算法是一种常用优化策略,通过局部最优解来寻求全局最优解。在Java中,贪心算法广泛应用于最小生成树、单源最短路径和单机调度问题。本文详细解释了这三个核心概念及其经典算法。最小生成树通过Kruskal和Prim算法实现,单源最短路径利用Dijkstra算法解决,而单机调度问题则可以通过贪心策略如FCFS、SJF和LRT在Java中模拟。这些算法的学习与实践不仅有助于解决实际工程问题,还为更高级的优化问题打下基础。
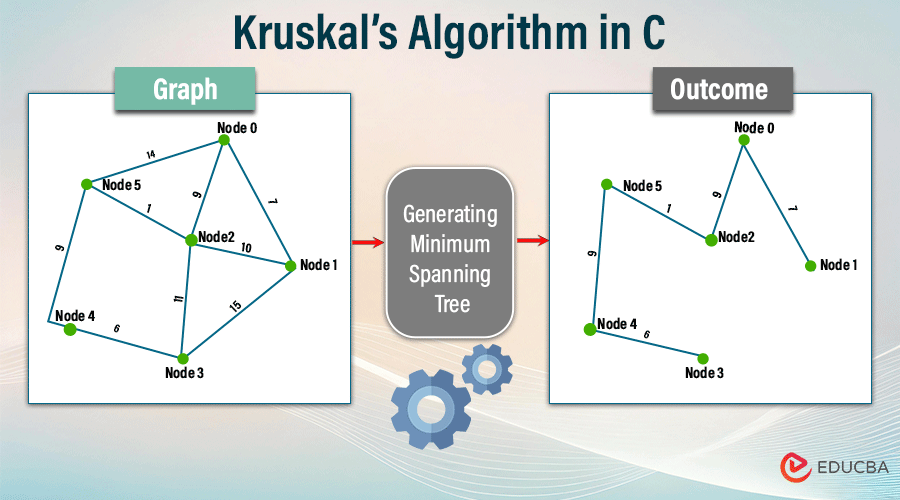
1. 贪心算法概念与应用
贪心算法的基本原理和策略
贪心算法是一种在每一步选择中都采取在当前状态下最好或最优(即最有利)的选择,从而希望导致结果是全局最好或最优的算法。其核心思想是根据问题的性质,做出一次选择,直接达到局部最优解,每一步都求当前状态下最优解,从而希望导致结果是全局最优解。
贪心算法在实际问题中的应用实例分析
一个典型的贪心算法应用实例是找零问题。假设你是商店收银员,需要给顾客找零n分钱,你将如何使用最少的硬币数完成找零?此问题的贪心策略是优先给出面值最大的硬币。
贪心算法的优势与局限性探讨
贪心算法的优点在于简单易实现且效率高,但它不一定能求出全局最优解。一个著名的例子是硬币找零问题的变形,如果硬币面值是非标准的,贪心策略就可能不再适用,从而不能保证得到最优解。
2. 最小生成树问题及Kruskal和Prim算法
2.1 最小生成树的理论基础
2.1.1 图论中最小生成树的定义
在图论中,最小生成树(Minimum Spanning Tree,MST)指的是在一个加权连通图中,选取的边构成的树形结构,使得树中所有边的权值之和最小,且连接了图中的所有顶点。最小生成树具有几个关键的特性:首先,它是无环的;其次,它包含图中所有顶点;最后,它的总权重是最小的。
最小生成树广泛应用于网络设计、电路板布局、公共交通路线规划等场景。比如在设计一个城市的交通网络时,为了保证道路的高效利用和成本的最小化,可以通过最小生成树算法来确定修建哪些道路。
2.1.2 最小生成树的重要性质与应用场景
一个连通图的最小生成树不一定是唯一的,但是它们的总权值是相同的。克鲁斯卡尔(Kruskal)和普里姆(Prim)算法是两种常用的求解最小生成树的算法。
在实际应用中,最小生成树算法可以用来设计电信网络。例如,为了将几个村庄连接到互联网,可以使用最小生成树算法来找出连接所有村庄所需要的最小电缆长度和成本。
2.2 Kruskal算法的实现与分析
2.2.1 Kruskal算法的基本步骤
Kruskal算法是通过边来构造最小生成树,其基本步骤如下:
1. 将图中的所有边按权重从小到大排序。
2. 初始化最小生成树,不包含任何边。
3. 按排序后的顺序逐个选择边,加入最小生成树中,但前提是这条边不会与已选择的边形成环路。
4. 重复步骤3,直到最小生成树中包含了图的所有顶点。
这里是一个Kruskal算法的伪代码示例:
Kruskal(G):
    A = ∅
    for each v in G.V:
        MAKE-SET(v)
    sort the edges of G.E into nondecreasing order by weight w
    for each edge (u,v) in G.E, taken in nondecreasing order by weight:
        if FIND-SET(u) ≠ FIND-SET(v):
            A = A ∪ {(u,v)}
            UNION(u, v)
    return A
2.2.2 Kruskal算法的正确性和效率讨论
Kruskal算法的正确性建立在并查集(Disjoint Set Union, DSU)的性质之上。并查集是支持三种操作:MAKE-SET(x),UNION(x, y),和FIND-SET(x)的数据结构,用来高效地管理元素的集合。Kruskal算法的关键是保证了每次添加到最小生成树中的边都不会形成环路,这是由并查集的FIND-SET(x)操作保证的。
Kruskal算法的时间复杂度主要取决于对边进行排序和并查集操作的时间。排序通常可以在O(ElogE)时间内完成,其中E是边的数量。并查集操作在路径压缩和按秩合并的优化下,可以达到接近O(1)的均摊时间复杂度。因此,整个算法的时间复杂度通常是O(ElogE)。
2.3 Prim算法的实现与分析
2.3.1 Prim算法的基本步骤
Prim算法则是通过顶点来构造最小生成树,其基本步骤如下:
1. 初始化:选择任意一个顶点作为最小生成树的起点,其余顶点的最短距离为无穷大,父节点指针为空。
2. 对于当前的最小生成树,选择一条连接树与未加入树的顶点中权值最小的边,将这条边对应的顶点加入到最小生成树中。
3. 更新最小生成树和未加入的顶点的距离及父节点指针。
4. 重复步骤2和3,直到所有顶点都被加入到最小生成树中。
下面是一个Prim算法的伪代码示例:
Prim(G, w, r):
    for each u in G.V
        u.key = ∞
        u.π = NIL
    r.key = 0
    Q = G.V
    while Q ≠ ∅
        u = EXTRACT-MIN(Q)
        for each v in G.Adj[u]
            if v in Q and w(u,v) < v.key
                v.π = u
                v.key = w(u,v)
2.3.2 Prim算法的正确性和效率讨论
Prim算法的正确性基于贪心策略:每一步都选择连接最小生成树与未加入树顶点中权值最小的边。这个策略保证了在每一步加入的边都是最小生成树的一部分。
Prim算法的时间复杂度主要取决于它对数据结构的选择。最简单实现使用优先队列,时间复杂度为O(V²),其中V是顶点的数量。使用二叉堆作为优先队列的实现可以降低到O(ElogV + VlogV),进一步优化可以使用斐波那契堆减少到O(E + VlogV)。
2.4 最小生成树算法的对比
Kruskal和Prim算法各有优缺点,它们适用的场景也有所不同。Kruskal算法更适用于稀疏图,因为其边的排序操作在边数量较多时仍然相对高效。而Prim算法在稠密图中表现更好,因为它更多地使用顶点操作,而稠密图中顶点的连接边较多。
在实际应用中,选择算法时应考虑图的类型和场景的具体需求。比如,在设计电力网络时,可能需要考虑网络的鲁棒性,此时Kruskal算法可能更加合适,因为它考虑了边的重要性,而Prim算法则更适用于需要快速计算最小生成树的场景,例如城市规划。
Kruskal和Prim算法的对比可以从复杂度、易用性、空间需求等多个角度进行分析,为特定问题找到最优的解决方案提供了多种选择。
3. 单源最短路径问题及Dijkstra算法
3.1 单源最短路径问题的定义和解决方法
3.1.1 最短路径问题的图论基础
单源最短路径问题是指在一个带权有向图中,找到从单一源点到所有其他顶点的最短路径。这个问题是图论中的一个经典问题,广泛应用于网络路由、地图导航、交通规划等领域。最短路径问题的概念最早由数学家欧拉提出,他研究了通过柯尼斯堡七桥问题的路径优化。图论基础要求我们理解图的表示方法(如邻接矩阵和邻接表)、图的类型(如无向图、有向图、加权图和非加权图)以及路径和路径权重的概念。
在实际应用中,解决单源最短路径问题不仅仅是找到最短的物理距离,还可能涉及到时间、成本或其他的度量标准。算法的选择会根据问题的不同而有所差异。例如,在某些情况下,可能需要最小化经过的边数而不是边的权重之和。
3.1.2 单源最短路径问题的复杂度分析
计算单源最短路径的复杂度取决于图的表示方式以及所使用的算法。最直观的方法是暴力枚举所有可能的路径,但是这种方法的复杂度高达O(n!),其中n为顶点的数量,这在实际应用中是不可行的。
为了减少复杂度,我们可以使用一些更高效的算法,例如Dijkstra算法,其时间复杂度为O(V^2)或者使用优先队列优化后为O((V+E)logV),其中V表示顶点数,E表示边数。当图中边的权重为非负时,Dijkstra算法能够提供最优解。对于存在负权重边的图,可以采用Bellman-Ford算法,其复杂度为O(VE)。Floyd-Warshall算法适用于计算所有顶点对之间的最短路径,复杂度为O(V^3)。
3.2 Dijkstra算法的原理与实现
3.2.1 Dijkstra算法的步骤解析
Dijkstra算法的基本思想是贪心策略,通过逐次选出距离源点最近的顶点,更新其邻居顶点的最短路径估计,直到所有顶点的最短路径都被确定。算法步骤如下:
- 初始化:将所有顶点分为两个集合,已确定最短路径的顶点集合和未确定最短路径的顶点集合。源点的最短路径已知,为0,其余顶点的最短路径设为无穷大。
- 选择未确定集合中距离源点最近的顶点,将它移入已确定集合。
- 更新该顶点的邻居顶点的最短路径估计。如果通过当前顶点到达邻居顶点的路径比已知的路径更短,则更新路径长度。
- 重复步骤2和步骤3,直到所有顶点都被移入已确定集合。
3.2.2 算法正确性的证明与优化方法
算法的正确性可以通过数学归纳法证明。简单来说,每次循环都会从候选顶点中找到一个当前最短的顶点,保证了每一步都朝着最短路径的方向前进,最终得到全局最短路径。
为了提高Dijkstra算法的效率,可以使用优先队列(通常是最小堆)来优化选择最小距离顶点的操作。优先队列可以保证每次从队列中取出的都是当前未确定集合中距离源点最近的顶点,而不是简单地遍历未确定集合,从而降低算法的时间复杂度。
下面是使用优先队列优化的Dijkstra算法的Python代码实现:
import heapq

def dijkstra(graph, start):
    # 初始化距离表,所有距离设为无穷大
    distances = {vertex: float('infinity') for vertex in graph}
    # 起点到起点的距离是0
    distances[start] = 0
    # 优先队列,存储 (距离, 顶点) 元组
    priority_queue = [(0, start)]

    while priority_queue:
        # 从队列中取出距离最小的元素
        current_distance, current_vertex = heapq.heappop(priority_queue)

        # 如果这个顶点的距离已经被更新过了,则跳过
        if current_distance > distances[current_vertex]:
            continue

        # 遍历当前顶点的邻接顶点
        for neighbor, weight in graph[current_vertex].items():
            distance = current_distance + weight

            # 如果找到更短的路径,则更新距离表,并将其加入优先队列
            if distance < distances[neighbor]:
                distances[neighbor] = distance
                heapq.heappush(priority_queue, (distance, neighbor))

    return distances
3.3 单源最短路径问题的其他算法简介
3.3.1 Bellman-Ford算法与Floyd-Warshall算法概述
Bellman-Ford算法能够处理包含负权重边的图,它的工作原理是通过不断松弛每一条边来逐步逼近真实的最短路径。算法的核心在于,对于图中的每一条边,都执行V-1次松弛操作,其中V是顶点的数量。Bellman-Ford算法的时间复杂度为O(VE)。
Floyd-Warshall算法则用于计算所有顶点对之间的最短路径。它的基本思想是动态规划,通过三重循环来更新每一对顶点之间的最短路径估计,直到没有任何路径可以被进一步缩短。Floyd-Warshall算法的时间复杂度为O(V^3),适合顶点数量不是非常大的图。
3.3.2 不同算法适用场景的比较
当选择单源最短路径算法时,需根据具体问题的条件来决定。例如,如果图中包含负权重边,则Dijkstra算法不再适用,应选择Bellman-Ford算法。如果问题涉及所有顶点对之间的最短路径,那么Floyd-Warshall算法可能是最佳选择。对于大规模图,如果图的密度较小(边的数量远少于顶点数的平方),可以使用Johnson算法来降低整体复杂度。
| 算法 | 负权重边 | 时间复杂度 | 适用场景 |
|---|---|---|---|
| Dijkstra | 不允许 | O((V+E)logV) | 小到中等规模的非负权重有向图 |
| Bellman-Ford | 允许 | O(VE) | 可能包含负权重边的有向图 |
| Floyd-Warshall | 不适用 | O(V^3) | 计算所有顶点对之间的最短路径 |
通过对比不同算法的适用场景和时间复杂度,可以更有效地选择合适的算法来解决实际问题中的最短路径问题。
4. 单机调度问题及其贪心策略
4.1 单机调度问题的基本概念和分类
4.1.1 调度问题的定义与重要性
调度问题在生产管理、计算机科学、物流管理等多个领域中是一个核心问题。它涉及如何高效地安排任务,以达到某种优化目标,例如最小化延迟、最大化吞吐量或最小化资源消耗。在单机调度问题中,任务必须在单台机器上顺序执行,目标是安排这些任务的执行顺序以优化特定的性能指标。
单机调度问题的重要性主要体现在以下几个方面:
- 资源优化 :通过有效的调度,可以更好地利用有限的计算资源和时间资源。
- 成本节约 :合理调度可以降低生产成本,提高企业经济效益。
- 服务质量提升 :在服务行业,快速响应客户需求可以提升客户满意度。
- 系统性能提升 :在计算机系统中,良好的调度策略可以提升系统的吞吐量和响应速度。
4.1.2 单机调度问题的几种常见类型
根据不同的优化目标,单机调度问题主要分为以下几种类型:
- 最小化总完成时间 :这种类型的目标是使得所有任务完成所需的总时间最短。
- 最小化最大延迟 :也称为最小化最晚完成时间,目标是使得单个任务的最晚完成时间尽可能早。
- 最小化最大负载 :即在所有时间点上,机器的负载尽可能平均。
- 最小化总延迟 :计算从任务到达开始到实际开始执行的时间总和。
每种类型的单机调度问题都有其特定的算法和解决方案,贪心策略在这些领域中扮演了重要角色。
4.2 贪心策略在单机调度中的应用
4.2.1 贪心策略处理单机调度的原理
贪心策略是解决单机调度问题的一种简单直观的方法。它的基本思想是在每一步选择中都采取在当前状态下最好或最优的选择,从而希望导致结果是全局最好或最优的算法。
对于单机调度问题,贪心策略通常按照任务的某个特征(如执行时间、到达时间、截止时间等)来排序任务,并按照这个排序来决定执行顺序。
4.2.2 典型问题实例解析与代码实现
以最小化总完成时间为例,一种常用的贪心策略是先执行最短的作业(Shortest Job First,SJF)。
代码实现示例(假设任务按执行时间排序) :
class Job {
    int id;       // Job ID
    int time;     // Job execution time
}

public class GreedyScheduling {
    public static void scheduleJobs(Job[] jobs) {
        Arrays.sort(jobs, Comparator.comparingInt(a -> a.time));
        int currentTime = 0;
        for (Job job : jobs) {
            System.out.println("Job " + job.id + " starts at " + currentTime + " and finishes at " + (currentTime + job.time));
            currentTime += job.time;
        }
    }
    public static void main(String[] args) {
        Job[] jobs = {
            new Job(1, 4),
            new Job(2, 3),
            new Job(3, 1),
            new Job(4, 5)
        };
        scheduleJobs(jobs);
    }
}
执行结果将展示每个作业的开始和结束时间,我们可以通过分析结果来观察贪心策略的实际效果。
逻辑分析 :
- 使用 Arrays.sort 对作业数组按执行时间( job.time )进行升序排序。
- 定义 currentTime 变量来记录当前时间。
- 遍历排序后的作业列表,并打印出每个作业的开始和结束时间。
- 每次执行作业后, currentTime 更新为当前时间加上作业执行时间。
参数说明 :
- Job[] jobs : 任务数组,每个任务包含ID和执行时间。
- sort : 根据任务的执行时间排序。
- currentTime : 当前时间,初始值为0。
贪心策略不保证在所有情况下都能得到全局最优解,但通常它提供了一种快速且相对较好的解法。
4.3 单机调度问题的其他策略比较
4.3.1 动态规划与回溯算法在调度问题中的应用
除了贪心策略外,动态规划和回溯算法也是解决单机调度问题的常见方法。动态规划尝试所有可能的组合,并保存中间结果以避免重复计算。回溯算法则是一种更为通用的方法,它探索所有可能的解决方案,并在找到一个有效解或所有解时停止。
4.3.2 策略选择的考量因素
选择合适的算法解决调度问题时,以下因素需要考虑:
- 问题规模 :对于大规模问题,动态规划可能不适用,因为其时间复杂度可能会非常高。
- 求解时间限制 :贪心算法通常执行速度较快,适合时间限制严格的情况。
- 解的质量要求 :如果需要最优解,可以考虑动态规划或回溯算法。
- 问题的具体情况 :有些调度问题可能适合某种算法,而不适合另一种算法。
在实际应用中,对策略的选择需要结合具体问题来决定。
5. Java实现贪心算法的高效数据结构与库
5.1 Java中实现贪心算法所需的数据结构
贪心算法作为一种解决问题的策略,依赖于合适的数据结构来实现高效的查找和选择。在Java中,有两种关键的数据结构在贪心算法中扮演着重要角色:优先队列和图的表示方法。
5.1.1 优先队列与堆结构在贪心算法中的应用
优先队列是Java中一种特殊的数据结构,它能够按照优先级从队列中提取元素,这使得它成为了贪心算法中用于选择下一个操作的最佳工具。在Java中,优先队列通常通过堆结构实现。
在贪心算法中,优先队列常用于:
- 寻找最小或最大元素
- 保持元素的顺序
例如,假设我们要解决一个调度问题,其中任务按照所需时间长短进行排序。我们可以使用优先队列来存储这些任务,并持续取出所需时间最短的任务来执行。
PriorityQueue<Task> pq = new PriorityQueue<>(Comparator.comparingInt(Task::getTimeRequired));
pq.addAll(taskList);
while (!pq.isEmpty()) {
    Task task = pq.poll();
    // 执行任务
}
在上述代码块中,我们创建了一个任务列表的优先队列,并用所需时间进行排序。然后,我们通过不断取出队列中的任务来执行它们,这符合贪心算法的思想。
5.1.2 图的表示方法:邻接表和邻接矩阵
在处理涉及图的问题时,如最小生成树和单源最短路径问题,需要合理表示图结构。Java中主要有两种图的表示方法:邻接表和邻接矩阵。
- 邻接表使用链表数组表示图的每个顶点,它节省空间但可能增加访问时间复杂度。
- 邻接矩阵使用二维数组表示图,便于快速判断任意两个顶点之间是否存在边,但空间消耗较大。
选择哪种图的表示方法取决于具体问题和图的稠密程度。例如,对于稀疏图,使用邻接表通常更合适,而稠密图则可能更适合邻接矩阵。
5.2 Java标准库中的算法实现与借鉴
Java标准库中包含了一系列高效的算法实现,这些算法的实现可以为贪心算法的编码提供直接帮助或借鉴。
5.2.1 使用Java标准库中的类与方法
Java标准库提供了一个功能强大的 Arrays 类,它包含了很多用于数组操作的静态方法,可以帮助实现贪心算法中的排序和查找等操作。此外, Collections 类也提供了类似的功能,适用于操作集合。
import java.util.Arrays;
import java.util.Collections;

List<Integer> list = new ArrayList<>(Arrays.asList(3, 2, 1, 4));
Collections.sort(list, Collections.reverseOrder());
// 此时list中的元素顺序是[4, 3, 2, 1],适合贪心策略的选择
5.2.2 分析Java标准库中的算法设计思路
通过分析Java标准库中的算法设计思路,我们能够学习如何高效地实现和优化贪心算法。例如,Java集合框架中的 TreeMap 和 TreeSet 是基于红黑树实现的,它们能够保证数据的有序性,并提供对数时间复杂度的查找、插入和删除操作,这对于实现高效的贪心算法非常重要。
5.3 高效实现贪心算法的自定义数据结构
尽管Java标准库提供了丰富的数据结构和算法实现,但在一些特定的贪心算法问题中,可能需要自定义数据结构来达到更好的性能。
5.3.1 设计自定义数据结构以优化算法性能
自定义数据结构可以针对特定问题进行优化。例如,在解决某个需要频繁插入和删除的贪心算法问题时,可以考虑使用平衡二叉搜索树(如AVL树或红黑树)作为数据结构,以确保操作的时间复杂度为对数级别。
5.3.2 对比不同数据结构在贪心算法中的性能差异
在实现贪心算法时,需要对比不同数据结构的性能差异。选择合适的数据结构可以显著减少算法运行时间,提高效率。例如,在使用优先队列时,可以通过对比不同实现(如堆结构)和操作效率(如插入和删除操作的时间复杂度)来选择最适合当前问题的数据结构。
总之,了解和掌握Java中实现贪心算法所需的数据结构和库,能够帮助开发者更高效地编写和优化算法代码,提升解决问题的能力。
简介:在IT领域,贪心算法是一种常用优化策略,通过局部最优解来寻求全局最优解。在Java中,贪心算法广泛应用于最小生成树、单源最短路径和单机调度问题。本文详细解释了这三个核心概念及其经典算法。最小生成树通过Kruskal和Prim算法实现,单源最短路径利用Dijkstra算法解决,而单机调度问题则可以通过贪心策略如FCFS、SJF和LRT在Java中模拟。这些算法的学习与实践不仅有助于解决实际工程问题,还为更高级的优化问题打下基础。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 26
 0
- 0


 已为社区贡献15条内容

所有评论(0)