正则表达式基础语法到进阶
第一章 概述
正则表达式,又称规则表达式**,**(Regular Expression,在代码中常简写为regex、regexp或RE),是一种【文本模式(Pattern)】。
正则表达式使用单个字符串来描述、匹配具有相同规则的字符串,通常被用来检索、替换那些符合某个模式(规则)的文本。正则表达式的核心功能就是处理文本。
正则表达式并不仅限于某一种语言,但是在每种语言中有细微的差别。
- 核心用途(文本匹配、搜索、替换)
- 适用场景(日志分析、数据清洗、表单验证、文本处理等)
第二章 正则表达式基础语法
-
普通字符:每一个字符串都可以被视为一个简单的正则表达式,例如 Hello World 正则表达式匹配 “Hello World” 字符串。
-
特殊的字符:如
.它可以匹配任何一个字符,如:“a” 或 “b”;比如+可以代表一个或多个;比如\d可以代表任意数字等等。 -
字符组:
[abc]和排除字符组[^abc]
一、元字符
元字符是构造正则表达式的一种基本元素。
.:匹配除换行符以外的任意字符\w:匹配字母或数字或下划线或汉字\s:匹配任意的空白符\d:匹配数字\b:匹配单词的开始或结束^:匹配字符串的开始$:匹配字符串的结束
案例:
- 匹配8位数字的QQ号码:
^\d\d\d\d\d\d\d\d$ - 匹配1开头11位数字的手机号码:
^1\d\d\d\d\d\d\d\d\d\d$ - 匹配biz_dt非等条件的语句:
\s+biz_dt\s+(>|>=|<|<=|between)
二、重复限定符
正则表达式提供了对重复字符进行简写的方式:
*:重复零次或更多次+:重复一次或更多次?:重复零次或一次{n}:重复n次{n,}:重复n次或更多次{n,m}:重复n到m次
有了这些限定符之后,我们就可以对之前的正则表达式进行改造了,比如:
- 匹配8位数字的QQ号码:
^\d{8}$ - 匹配1开头11位数字的手机号码:
^1\d{10}$ - 匹配银行卡号是14~18位的数字:
^\d{14,18}$ - 匹配以a开头的,0个或多个b结尾的字符串:
^ab*$
三、分组
限定符是作用在与他相邻的最左边的一个字符,那么问题来了,如果我想要ab同时被限定那怎么办呢?
正则表达式中用小括号()来做分组,也就是括号中的内容会作为一个整体。
如匹配字符串中包含0到多个ab开头:^(ab)*
四、转义
正则提供了转义的方式,也就是要把这些元字符、限定符或者关键字转义成普通的字符,做法很简答,就是在要转义的字符前面加个斜杠,也就是\即可。
匹配字符串中包含0到多个(ab)开头:^(\(ab\))*
匹配一个字符*:\*
五、条件
回到我们刚才的手机号匹配,我们都知道:国内号码都来自三大运营商,它们都有属于自己的号段。
比如联通有130/131/132/155/156/185/186/145/176等号段,假如让我们匹配一个联通的号码,那按照我们目前所学到的正则,应该无从下手的,因为这里包含了一些并列的条件,也就是“或”,那么在正则中是如何表示“或”的呢?
正则用符号 | 来表示或,也叫做分支条件,当满足正则里的分支条件的任何一种条件时,都会当成是匹配成功。
那么我们就可以用或条件来处理这个问题:
^(130|131|132|155|156|185|186|145|176)\d{8}$
六、区间
正则提供一个元字符中括号 [] 来表示区间条件。
- 限定0到9 可以写成
[0-9] - 限定A-Z 写成
[A-Z] - 限定某些数字
[165]
那上面的正则我们还改成这样:
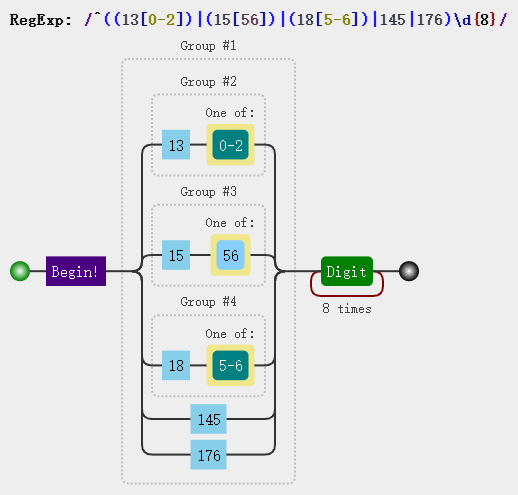
^((13[0-2])|(15[56])|(18[5-6])|145|176)\d{8}$
七、反义
前面说到元字符的都是要匹配什么什么,当然如果你想反着来,不想匹配某些字符,正则也提供了一些常用的反义元字符:
| 元字符 | 解释 |
|---|---|
| \W | 匹配任意不是字母,数字,下划线,汉字的字符 |
| \S | 匹配任意不是空白符的字符 |
| \D | 匹配任意非数字的字符 |
| \B | 匹配不是单词开头或结束的位置 |
| [^x] | 匹配除了x以外的任意字符 |
| [^aeiou] | 匹配除了aeiou这几个字母以外的任意字符 |
八、常见的正则表达式
-
匹配中文字符的正则表达式:
[\u4e00-\u9fa5]匹配形式:My name is 李华!
-
匹配Email地址的正则表达式:
^[a-zA-Z0-9_-]+@[a-zA-Z0-9_-]+(\.[a-zA-Z0-9_-]+)+$
匹配形式: 51012324@qq.com 、ydlclass@163.com,ydl-class@126.com -
匹配国内电话号码:
\d{3}-\d{8}|\d{4}-\d{7}
匹配形式:匹配形式如 0511-4405222 或 021-87888822 -
匹配腾讯QQ号:
[1-9][0-9]{4,}
匹配形式:510180222 -
匹配身份证:
(^\d{15}$)|(^\d{18}$)|(^\d{17}(\d|X)$
匹配形式:142228198508252125 -
匹配ip地址:
\d{1,3}\.\d{1,3}\.\d{1,3}\.\d{1,3}
匹配形式:127.0.0.1 -
匹配国内的手机号:
^(13[0-9]|14[01456879]|15[0-35-9]|16[2567]|17[0-8]|18[0-9]|19[0-35-9])\d{8}$匹配形式:1388888888
第三章 正则表达式进阶语法
一、零宽断言
【断言】就是说正则可以【断定】在指定内容的前面或后面会出现满足指定规则的内容。
【零宽】 断言部分只确定位置不匹配任何内容,只是一种模式。内容宽度为零。
我们来举个栗子:假设我们要用爬虫抓取csdn里的文章阅读量。通过查看源代码可以看到文章阅读量这个内容是这样的结构:
"<span class="read-count">阅读数:641</span>"
其中也就【641】这个是变量,也就是说不同文章不同的值,当我们拿到这个字符串时,需要获得这里边的【641】有很多种办法,但如果正则应该怎么匹配呢?下面先来讲几种类型的断言:
几个概念:
| 概念 | 功能 |
|---|---|
| 预测/先行 | (模式在前),要求后面的符合匹配 |
| 回顾/后发 | (模式在后),要求前面的符合匹配 |
| 正 | 符合匹配 |
| 负 | 不符合匹配 |
1、正向先行断言
零宽度正预测先行断言
- 语法:
(?=pattern) - 作用:匹配pattern表达式的前面内容,不返回本身。
【正向先行断言】可以匹配表达式前面的内容,那意思就是(?=) 就可以匹配到前面的内容了。
如果我们要匹配所有内容那就是:
@Test
public void testAssert2(){
    String regex = "\\d+(?=</span>)";
    String context = "<span class=\"read-count\">阅读数:641</span>";
    Pattern pattern = Pattern.compile(regex);
    Matcher matcher = pattern.matcher(context);
    while (matcher.find()){
        System.out.println(matcher.group());
    }
}

//匹配结果:
//641
2、正向后行断言
零宽度正回顾后发断言,断言在前,模式在后
- 语法:
(?<=pattern) - 作用:匹配pattern表达式的后面的内容,不返回本身。
有先行就有后行,先行是匹配前面的内容,那后行就是匹配后面的内容啦。
上面的例子,我们也可以用后行断言来处理:
@Test
public void testAssert3(){
    String regex = "(?<=<span class=\"read-count\">阅读数:)\\d+";
    String context = "<span class=\"read-count\">阅读数:641</span>";
    Pattern pattern = Pattern.compile(regex);
    Matcher matcher = pattern.matcher(context);
    while (matcher.find()){
        System.out.println(matcher.group());
    }
}
//匹配结果:
//641
3、负向先行断言
零宽度负预测先行断言
- 语法:
(?!pattern) - 作用:匹配非pattern表达式的前面内容,不返回本身。
有正向也有负向,负向在这里其实就是非的意思。
举个栗子:比如有一句 “我爱祖国,我是祖国的花朵”。现在要找到不是’的花朵’前面的祖国。
用正则就可以这样写:祖国(?!的花朵)
4、负向后行断言
零宽度负回顾后发断言
- 语法:
(?<!pattern) - 作用:匹配非pattern表达式的后面内容,不返回本身。
举个例子:比如有一句 “我爱祖国,我是祖国的花朵”。现在要找到不是’我爱’后面的祖国。
用正则就可以这样写:(?<!我爱)祖国
二、捕获和非捕获
**捕获组:**我们匹配子表达式的内容,并把匹配结果【以数字编号或组名的方式】保存到内存中,之后可以通过序号或名称来使用这些匹配结果。
而根据命名方式的不同,又可以分为两种组:
1、数字编号捕获组:
语法:(exp)
解释:从表达式左侧开始,每出现一个左括号和它对应的右括号之间的内容为一个分组,在分组中,第0组为整个表达式,第一组开始为分组。
- 比如固定电话的:020-85653333
- 正则表达式为:
(0\d{2})-(\d{8})
按照左括号的顺序,这个表达式有如下分组:
| 序号 | 编号 | 分组 | 内容 |
|---|---|---|---|
| 0 | 0 | (0\d{2})-(\d{8}) | 020-85653333 |
| 1 | 1 | (0\d{2}) | 020 |
| 2 | 0 | (\d{8}) | 85653333 |
String test = "020-85653333";
String reg="(0\\d{2})-(\\d{8})";
Pattern pattern = Pattern.compile(reg);
Matcher mc= pattern.matcher(test);
if(mc.find()){
    System.out.println("分组的个数有:"+mc.groupCount());
    for(int i=0;i<=mc.groupCount();i++){
        System.out.println("第"+i+"个分组为:"+mc.group(i));
    }
}
//输出结果:

//分组的个数有:2
//第0个分组为:020-85653333
//第1个分组为:020
//第2个分组为:85653333
可见,分组个数是2,但是因为第0个为整个表达式本身,因此也一起输出了。
2、命名编号捕获组:
语法:(?exp)
解释:分组的命名由表达式中的name指定,比如区号也可以这样写:
(?<areaCode>0\\d{2})-(?<PhoneNumber>\\d{8})
按照左括号的顺序,这个表达式有如下分组:
| 序号 | 名称 | 分组 | 内容 |
|---|---|---|---|
| 0 | 0 | (0\d{2})-(\d{8}) | 020-85653333 |
| 1 | areaCode | (0\d{2}) | 020 |
| 2 | PhoneNumber | (\d{8}) | 85653333 |
用代码来验证一下:
String test = "020-85653333";
String reg="(?<areaCode>0\\d{2})-(?<PhoneNumber>\\d{8})";
Pattern pattern = Pattern.compile(reg);
Matcher mc= pattern.matcher(test);
if(mc.find()){
    System.out.println("分组的个数有:"+mc.groupCount());
    System.out.println(mc.group("areaCode"));
    System.out.println(mc.group("PhoneNumber"));
}
// 输出结果:

// 分组的个数有:2
// 分组名称为:areaCode,匹配内容为:020
// 分组名称为:PhoneNumber,匹配内容为:85653333
3、非捕获组:
- 语法:
(?:exp) - 解释:和捕获组刚好相反,它用来标识那些不需要捕获的分组。
比如上面的正则表达式,程序不需要用到第一个分组,那就可以这样写:(?:0\d{2})-(\d{8})
| 序号 | 名称 | 分组 | 内容 |
|---|---|---|---|
| 0 | 0 | (0\d{2})-(\d{8}) | 020-85653333 |
| 1 | 1 | (\d{8}) | 85653333 |
String test = "020-85653333";
String reg="(?:0\\d{2})-(\\d{8})";
Pattern pattern = Pattern.compile(reg);
Matcher mc= pattern.matcher(test);
if(mc.find()){
    System.out.println("分组的个数有:"+mc.groupCount());
    for(int i=0;i<=mc.groupCount();i++){
        System.out.println("第"+i+"个分组为:"+mc.group(i));
    }
}
// 输出结果:

// 分组的个数有:1
// 第0个分组为:020-85653333
// 第1个分组为:85653333
三、反向引用
我们知道:捕获会返回一个捕获组,这个分组是保存在内存中,不仅可以在正则表达式外部通过程序进行引用,也可以【在正则表达式内部进行引用】,这种引用方式就是【反向引用】。
根据捕获组的命名规则,反向引用可分为:
- 普通捕获组反向引用:
\k<number>,通常简写为\number - 命名捕获组反向引用:
\k<name>,或者\k'name'
我们可以举一个例子:
比如要查找一串字母"aabbbbgbddesddfiid"里成对的字母,如果按照我们之前学到的正则,什么区间啊限定啊断言啊可能是办不到的。
现在我们先用程序思维理一下思路:
1)匹配到一个字母
2)匹配第下一个字母,检查是否和上一个字母是否一样
3)如果一样,则匹配成功,否则失败
这里的思路中,在匹配下一个字母时,需要用到上一个字母进行比较,但是目前的知识实在办不到。
这下子捕获就有用处啦,我们可以利用捕获把上一个匹配成功的内容用来作为本次匹配的条件即可。
- 首先匹配一个字母:
\w。我们需要做成分组才能捕获,因此写成这样:(\w) - 那这个表达式就有一个捕获组:
(\w) - 然后我们要用这个捕获组作为条件,那就可以:
(\w)\1
这里的\1是什么意思呢?根据反向引用的数字命名规则,就需要\k<1>或者\1,当然,通常都是是后者。
我们来测试一下:
@Test
public void testRef(){
    String context = "aabbxxccdddsksdhfhshh";
    String regex = "(\\w)\\1";
    Pattern pattern = Pattern.compile(regex);
    Matcher matcher = pattern.matcher(context);
    while (matcher.find()){
        System.out.println(matcher.group());
    }
}
// 输出结果:

// aa
// bb
// xx
// cc
// dd
// hh
再举个替换的例子,假如想要把字符串中abc换成a
@Test
public void testReplaceAll(){
    String context = "abc aabc bc xxx mm";
    String regex = "(a*)(b)(c)";
    String res = context.replaceAll(regex, "$1");
    System.out.println(res);
}
// 输出结果:

// a aa  xxx mm
四、贪婪和非贪婪
1、贪婪匹配
**贪婪匹配:**当正则表达式中包含能接受重复的限定符时,该方式会匹配尽可能多的字符,这匹配方式叫做贪婪匹配。
前面我们讲过重复限定符,其实这些限定符就是贪婪量词,比如表达式:\d{3,6}。
用来匹配3到6位数字,在这种情况下,它是一种贪婪模式的匹配,也就是假如字符串里有6个数字可以匹配,那它就是全部匹配到。
@Test
public void testGreed(){
    String regex = "\\d{3,6}";
    String context ="61762828 176 2991 871";
    System.out.println("文本:" + context);
    System.out.println("贪婪模式:"+ regex);
    Pattern pattern =Pattern.compile(regex);
    Matcher matcher = pattern.matcher(context);
    while(matcher.find()){
        System.out.println("匹配结果:" + matcher.group(0));
    }
}
// 输出结果:

// 文本:61762828 176 2991 44 871
// 贪婪模式:\d{3,6}
// 匹配结果:617628
// 匹配结果:176
// 匹配结果:2991
// 匹配结果:871
由结果可见:本来字符串中的“61762828”这一段,其实只需要出现3个(617)就已经匹配成功了的,但是他并不满足,而是匹配到了最大能匹配的字符,也就是6个。
多个贪婪量词在一起时,如果字符串能满足他们各自最大程度的匹配时,就互不干扰,但如果不能满足时,会优先满足最大数量的匹配,剩余再分配下一个量词匹配。
@Test
public void testGreed2(){
    String regex = "\\d{1,2}\\d{3,5}";
    String context ="61762828 176 2991 871";
    System.out.println("文本:" + context);
    System.out.println("贪婪模式:"+ regex);
    Pattern pattern =Pattern.compile(regex);
    Matcher matcher = pattern.matcher(context);
    while(matcher.find()){
        System.out.println("匹配结果:" + matcher.group(0));
    }
}
// 输出结果:

// 文本:61762828 176 2991 871
// 贪婪模式:\d{1,2}\d{3,5}
// 匹配结果:6176282
// 匹配结果:2991
- “2991” :是优先满足最大数量d{3,5}右边的贪婪匹配出991,剩下的左边的匹配出2。
2、懒惰匹配
懒惰匹配:当正则表达式中包含能接受重复的限定符时,会匹配尽可能少的字符,这匹配方式叫做懒惰匹配。
懒惰量词是在贪婪量词后面加个“?”
| 代码 | 说明 |
|---|---|
| *? | 重复任意次,但尽可能少重复 |
| +? | 重复1次或更多次,但尽可能少重复 |
| ?? | 重复0次或1次,但尽可能少重复 |
| {n,m}? | 重复n到m次,但尽可能少重复 |
| {n,}? | 重复n次以上,但尽可能少重复 |
@Test
public void testNotGreed(){
    String reg="(\\d{1,2}?)(\\d{3,4})";
    String test="61762828 176 2991 87321";
    System.out.println("文本:"+test);
    System.out.println("贪婪模式:"+reg);
    Pattern p1 =Pattern.compile(reg);
    Matcher m1 = p1.matcher(test);
    while(m1.find()){
        System.out.println("匹配结果:"+m1.group(0));
    }
}
// 输出结果:

// 文本:61762828 176 2991 87321
// 懒惰匹配:(\d{1,2}?)(\d{3,4})
// 匹配结果:61762
// 匹配结果:2991
// 匹配结果:87321
- “61762” 是左边的懒惰匹配出6,右边的贪婪匹配出1762。
- “2991” 是左边的懒惰匹配出2,右边的贪婪匹配出991。
- “87321” 左边的懒惰匹配出8,右边的贪婪匹配出7321。
五、案例分析:
行业的正则:
// 银行卡号正则
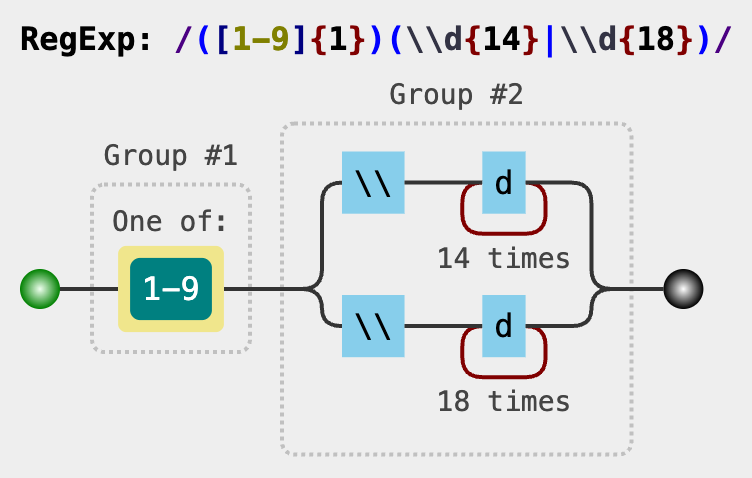
  public static final String BANK_CARD_NUMBER_REGEX= "([1-9]{1})(\\d{14}|\\d{18})";

// 手机号正则
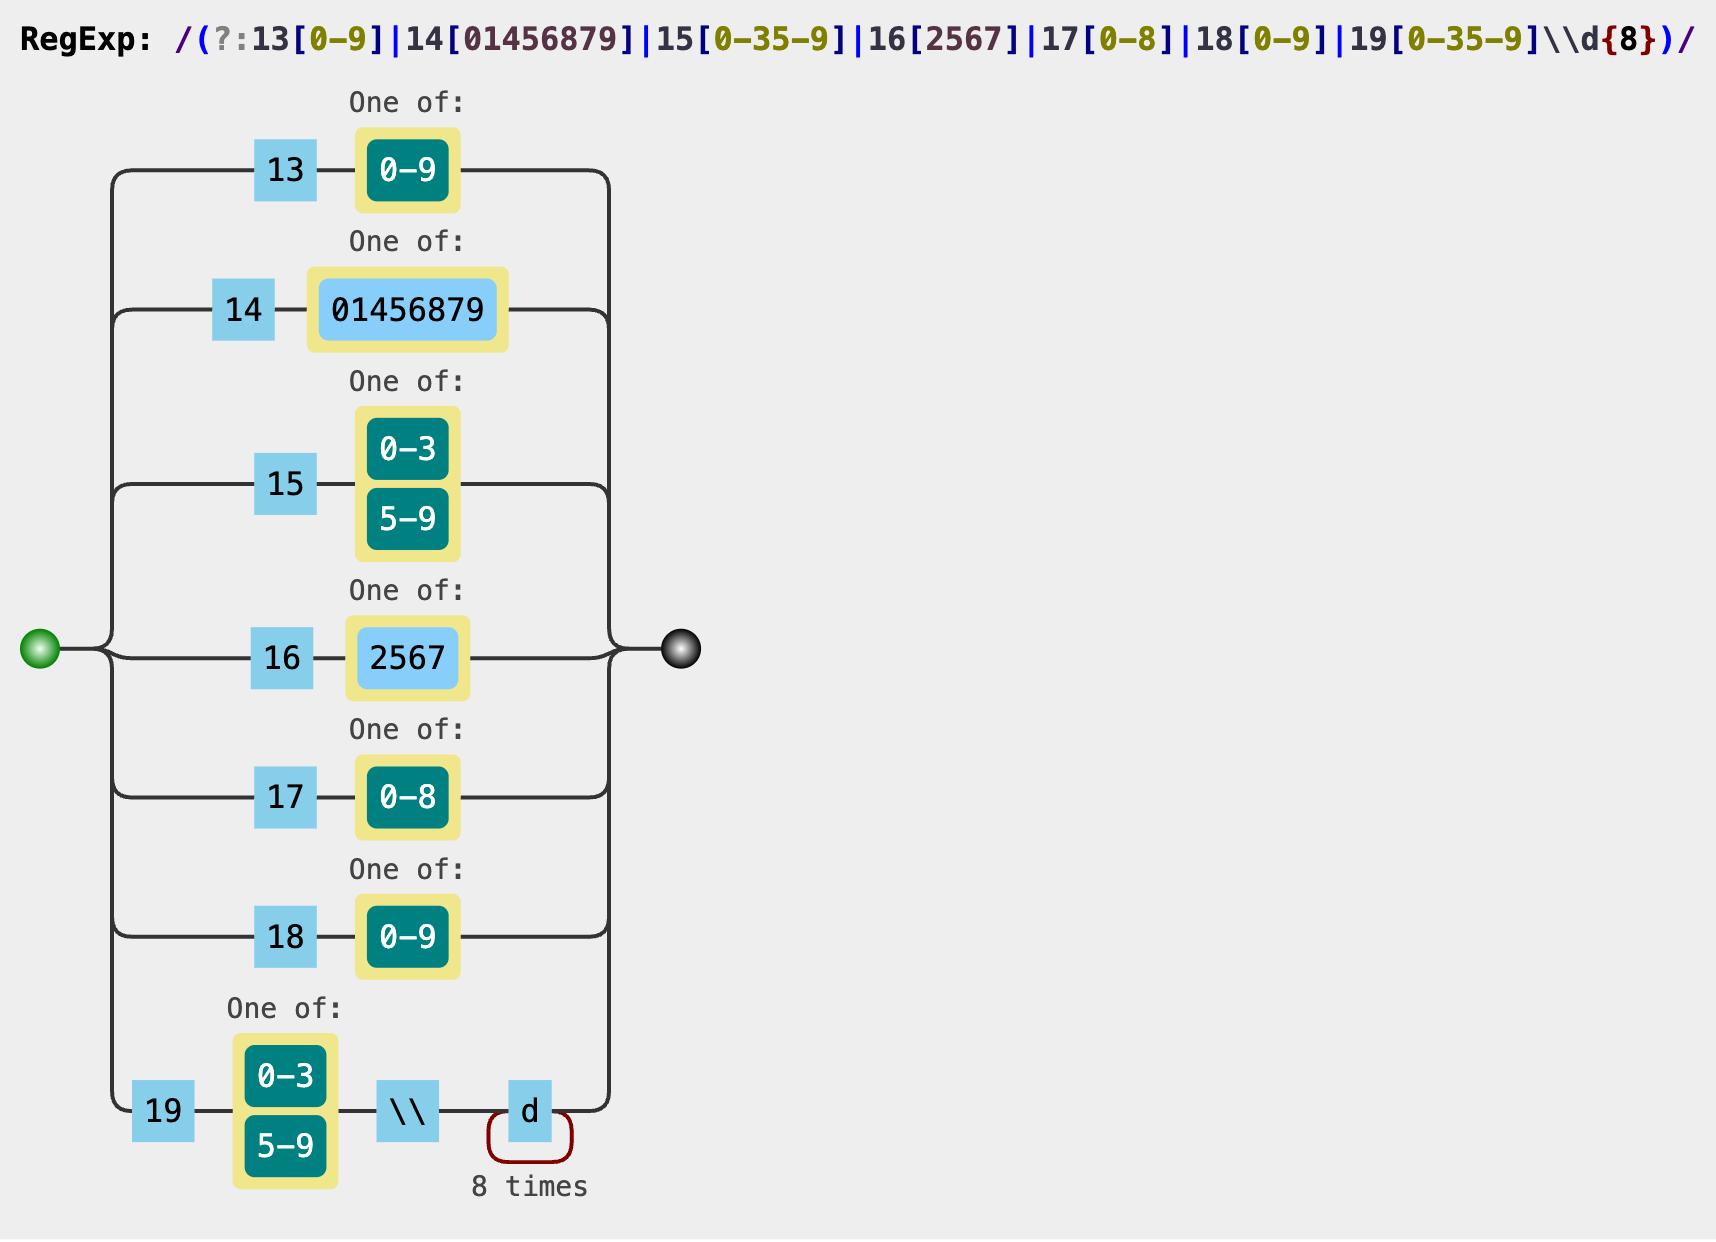
public static final String PHONE_NUMBER_REGEX= "(?:13[0-9]|14[01456879]|15[0-35-9]|16[2567]|17[0-8]|18[0-9]|19[0-35-9]\\d{8})";

// 电子邮箱正则
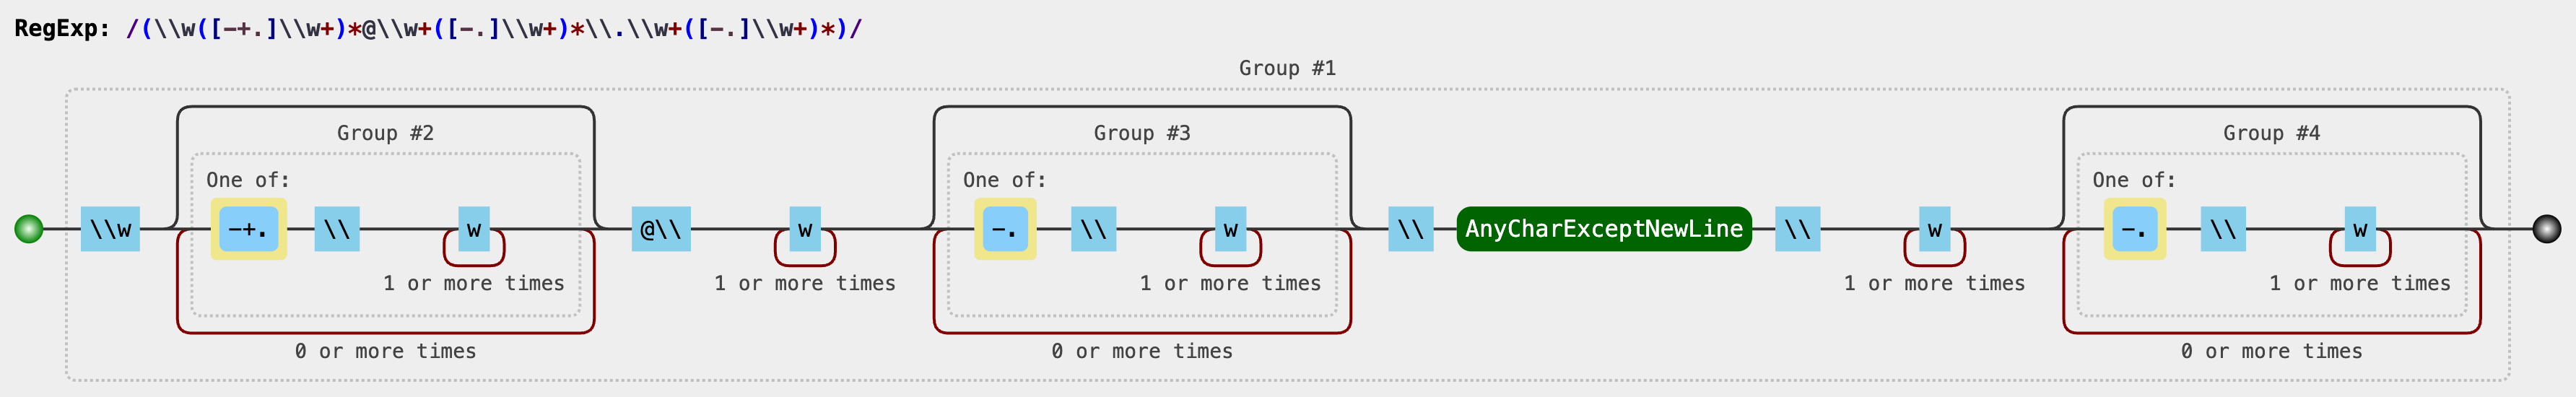
 public static final String EMAIL_REGEX = "(\\w([-+.]\\w+)*@\\w+([-.]\\w+)*\\.\\w+([-.]\\w+)*)";

// 身份证号码正则(包括大陆,港澳和台湾)
 public static final String ID_CARD_NUMBER_REGEX = "([1-9]\\d{5}(?:18|19|20|(?:3\\d))\\d{2}(?:(?:0[1-9])|(?:1[0-2]))(?:(?:[0-2][1-9])|10|20|30]31)\\d{3}[0-9Xx])";
1.银行卡号正则:
([1-9]{1})(\\d{14}|\\d{18})
-
([1-9]{1}):匹配第一个字符为1-9中的任意一个数字
-
(\\d{14}|\\d{18}):匹配后续14位或18位数字(\d等价于[0-9])
表达式用于匹配 以非零数字开头,后接14位或18位数字 的字符串,总长度为15位或19位
2. 手机号正则:
(?:13[0-9]|14[01456879]|15[0-35-9]|16[2567]|17[0-8]|18[0-9]|19[0-35-9]\\d{8})
-
((?: ... )):这是一个非捕获组,用小括号包裹起来的内容表示这一部分作为一个整体进行匹配。非捕获组的意思是,虽然它会匹配内容,但是不会单独提取这部分作为结果(捕获组会提取)。
-
15[0-35-9]:这里匹配以15开头的号码
[0-35-9]是一个字符集合,表示匹配0、1、2、3、5、6、7、8、9中的任意一个。
所以,15[0-35-9]可以匹配150, 151, 152, 153, 155, 156, 157, 158, 159。
3.电子邮箱正则:
(\\w([-+.]\\w+)*@\\w+([-.]\\w+)*\\.\\w+([-.]\\w+)*)
-
用户名部分:
\\w([-+.]\\w+)* -
\\w:匹配一个单词字符(字母、数字、下划线)作为用户名开头 (等价于[a-zA-Z0-9_])([-+.]\\w+)*:允许包含 -、+、. 的扩展字符组合,但必须紧跟在符号后接单词字符
示例:user.name、user-name 有效,但 user. 或 user- 无效
-
域名分隔符:
@ -
域名部分:
\\w+([-.]\\w+)*\\.\\w+([-.]\\w+)* -
- 主域名:
\\w+
匹配域名主体(如 gmail、example),需以单词字符开头 - 子域名:
([-.]\\w+)*
允许包含 - 或 . 的分段(如 mail-server、co.uk) - 顶级域名:
\\.\\w+([-.]\\w+)*
匹配 .com、.co.uk 等格式,要求以点号开头
- 主域名:
-
用例:user@example.com
user.name@example.co.uk
user+name@example.sub-domain.org
它涵盖了常见的电子邮件格式,并且允许一些特殊字符(如 -, +, .)出现在用户名和域名中。
4.身份证号码正则(包括大陆,港澳和台湾):
([1-9]\\d{5}(?:18|19|20|(?:3\\d))\\d{2}(?:(?:0[1-9])|(?:1[0-2]))(?:(?:[0-2][1-9])|10|20|30|31)\\d{3}[0-9Xx])
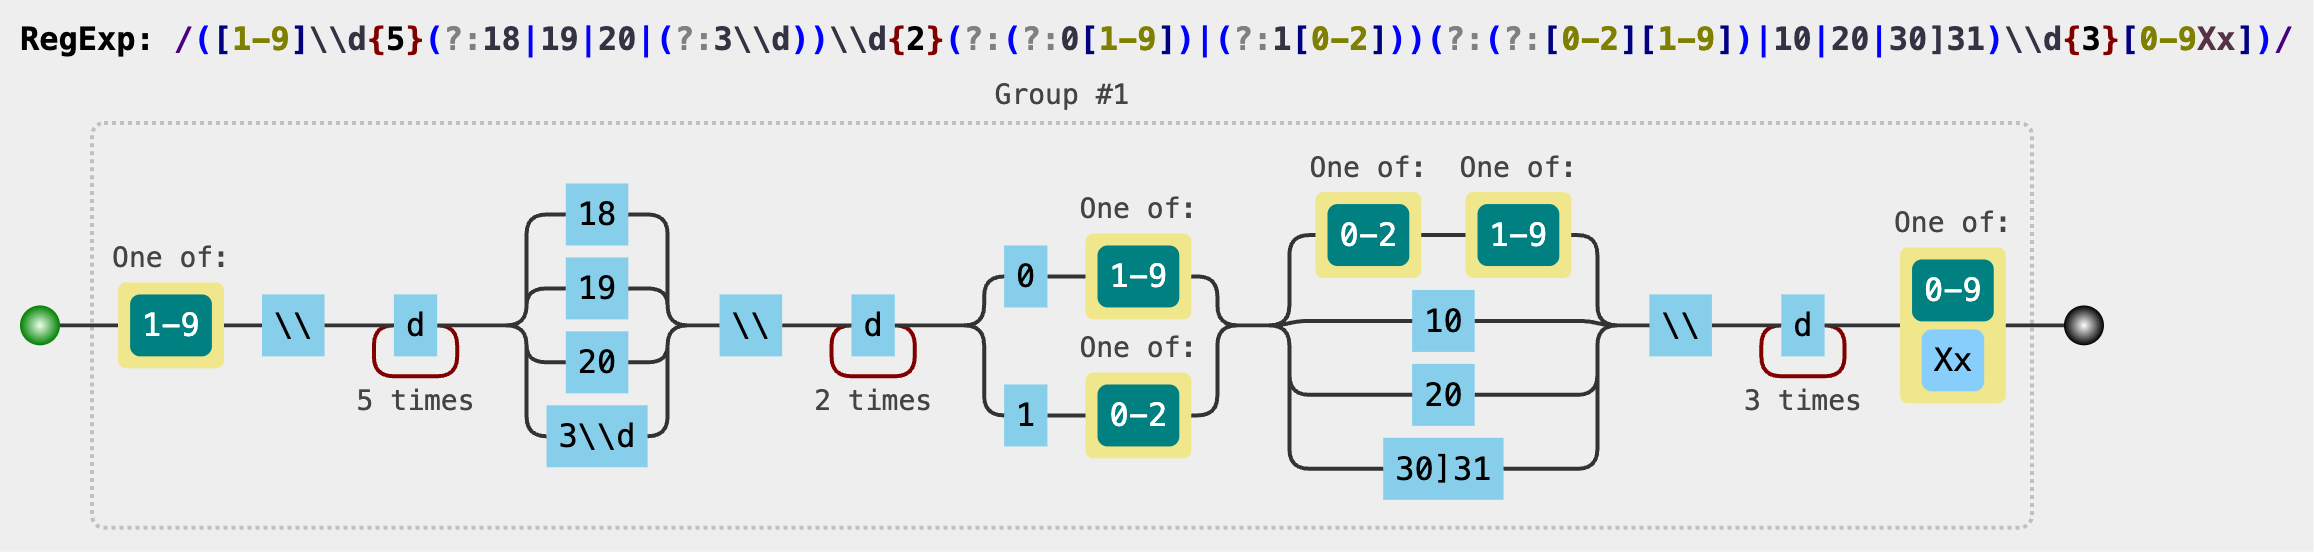
- 地址码 [1-9]\d{5}
前6位行政区划代码,首位非零,后跟5位数字(不验证实际存在性)。
-
年份码 (?:18|19|20|21)\d{2}
限制年份为 1800-2199,排除无效年份(如 3000)。
-
月份码 (?:0[1-9]|1[0-2])
严格匹配 01-12 月。
-
日期码 (?:0[1-9]|\d|3)
匹配 01-31 日,但仍需注意:
不验证月份与天数的逻辑关系(如 02-29 需额外判断闰年)。
顺序码 \d{3} -
3位顺序码,无特殊限制。
校验码 [\dX]仅允许数字或大写 X,符合国家标准(GB 11643-1999)。
第四章 性能优化
一、Java 正则性能核心问题:回溯爆炸
回溯爆炸(Catastrophic Backtracking)指正则引擎在尝试不同匹配路径时陷入指数级增长的无效尝试,导致匹配时间呈灾难性增长。其根源在于正则表达式模式设计缺陷与NFA引擎的回溯机制
二、回溯爆炸案例与优化
灾难性回溯(指数级)
**1. 正则 (a+)+**
- **内层分组
(a+):匹配 1 个或多个 “a”**(+是贪婪量词,尽可能多匹配)。 - 外层量词
+:表示内层分组 至少重复一次,允许重复多次。
- 匹配机制:套的贪婪量词会导致指数级回溯。外层
+会尝试所有可能的a+组合分割方式(如(a)(aaa)(aaaaa)...),导致每次失败后逐层回溯尝试所有可能的分割方案。 - 输入
"aaaaaaaaaaaaX"的匹配过程:- 内层
a+贪婪匹配所有a,剩余字符X无法匹配。 - 引擎回溯,尝试减少最后一个
a+的长度,重新分割组合(如(aaaaa...a)(a)→(aaaaa...)(aa)),直到所有可能的分割均失败。 - 回溯次数为 **O(2ⁿ)**(n为
a的数量),对长字符串性能极差。
- 内层
- 适用场景:
理论上可匹配连续a的分组组合,但实际场景中需避免因回溯导致的性能问题。
**2. 正则 (a++)+**
- 匹配机制:
内层a++为占有型量词(Possessive Quantifiers),匹配后禁止回溯。外层+仅尝试剩余字符的匹配,不回溯已匹配的内容。 - 输入
"aaaaaaaaaaaaX"的匹配过程:- 内层
a++贪婪匹配所有a(因占有特性,无法释放已匹配的字符)。 - 外层
+仅需检查一次组合(即整体匹配一次a+),剩余字符X无法匹配,立即失败。 - 回溯次数为 **O(1)**,性能最优。
- 内层
- 适用场景:
需快速失败的长字符串匹配场景,避免灾难性回溯(如日志过滤、输入校验)。
**3. 正则 (?>a+)+**
- 匹配机制:
通过原子分组(Atomic Group)锁定内层a+的匹配结果,禁止回溯已匹配的内容,行为与a++类似。 -
"aaaaaaaaaaaaX"的匹配过程- 原子分组
(?>a+)匹配所有a后,引擎将其视为不可分割单元。 - 外层
+无法调整内部分组长度,剩余字符X无法匹配,直接失败。 - 回溯次数为 **O(1)**,性能与
(a++)+相同。
- 原子分组
- 适用场景:
需高性能且不支持占有型量词的正则引擎(如.NET、PCRE),替代a++使用。
Java 使用 java.util.regex 包提供的正则引擎(传统 NFA 模型),在处理复杂正则时易因回溯导致性能骤降。以下通过代码示例解析优化方法。
三、测试环境准备
测试工具类
import java.util.regex.Pattern;

public class RegexBenchmark {

    public static void benchmark(String regex, String input, int iterations) {
        Pattern pattern = Pattern.compile(regex);
        long startTime = System.nanoTime();
        for (int i = 0; i < iterations; i++) {
            pattern.matcher(input).matches();
        }
        long duration = (System.nanoTime() - startTime) / 1_000_000;
        System.out.printf("正则: %-30s 耗时: %4d ms%n", regex, duration);
    }
}
1. 未优化正则:指数级回溯
public class BacktrackingDemo {
    public static void main(String[] args) {
        // 构造一个易引发回溯的输入(末尾的 X 导致匹配失败)
        String input = "aaaaaaaaaaaaaaaaaaaaX";
        int iterations = 1000; // 测试次数

        // 危险正则: (a+)+ 导致回溯爆炸
        RegexBenchmark.benchmark("(a+)+", input, iterations);
    }
}
输出:
正则: (a+)+ 耗时: 3725 ms
2. 优化方案 1:使用占有量词(Possessive Quantifier)
在量词后添加 +,禁止回溯到子表达式内部。
RegexBenchmark.benchmark("(a++)+", input, iterations);
输出:
正则: (a++)+ 耗时: 3 ms
3. 优化方案 2:原子组(Atomic Group)
通过 (?>...) 锁定组内匹配结果。
RegexBenchmark.benchmark("(?>(a+))+", input, iterations);
输出:
正则: (?>(a+))+ 耗时: 2 ms
总结对比
| 正则表达式 | 回溯复杂度 | 适用场景 | 关键特性 |
|---|---|---|---|
(a+)+ | O(2ⁿ) | 理论分组,需避免长字符串 | 嵌套贪婪量词,灾难回溯 |
(a++)+ | O(1) | 高性能匹配,支持占有型量词引擎 | 占有量词,禁止回溯 |
(?>(a+))+ | O(1) | 高性能匹配,通用正则引擎 | 原子分组,禁止回溯 |
注意:(a++)+ 需语言支持(如Java),而 (?>(a+))+ 兼容性更广(如PCRE、.NET)
四、贪婪匹配优化:精确限定范围
1. 未优化:贪婪量词吞并内容
String html = "<div>Hello</div><div>World</div>";

// 错误:贪婪匹配吞掉所有内容
RegexBenchmark.benchmark("<div>.*</div>", html, 1000);
输出:
正则: <div>.*</div> 耗时: 125 ms
2. 优化:非贪婪匹配或精确排除
// 方案 1: 非贪婪量词
RegexBenchmark.benchmark("<div>.*?</div>", html, 1000);

// 方案 2: 排除 < 字符
RegexBenchmark.benchmark("<div>[^<]*</div>", html, 1000);
输出:
正则: <div>.*?</div>              耗时:   45 ms
正则: <div>[^<]*</div>            耗时:    8 ms
1. 匹配方式与范围
| 表达式 | 匹配机制 | 示例输入与结果 |
|---|---|---|
**<div>.\*</div>** | 贪婪模式:.* 吞并所有字符,直到最后一个 </div> 出现,可能跨越多个嵌套或相邻标签 。 | 输入:<div>A</div><div>B</div> 结果:<div>A</div><div>B</div>(整体匹配) |
**<div>.\*?</div>** | 非贪婪模式:.*? 在遇到第一个 </div> 时停止,分割独立标签 。 | 输入:<div>A</div><div>B</div> 结果:两个独立匹配 <div>A</div> 和 <div>B</div> |
**<div>[^<]\*</div>** | 精确排除:[^<]* 匹配除 < 外的任意字符,强制限定在单层标签内(无法处理嵌套标签)。 | 输入:<div>A<span>嵌套</span></div> 结果:仅匹配 <div>A</div>(忽略 <span> 内容) |
2. 典型场景对比
| 场景 | <div>.*</div>(贪婪) | <div>.*?</div>(非贪婪) | <div>[^<]*</div>(精确排除) |
|---|---|---|---|
| 相邻标签 | 合并相邻标签为整体匹配 | 分割为独立标签 | 分割为独立标签(同非贪婪) |
| 嵌套标签 | 吞并所有嵌套结构 | 可能部分吞并(需结合断言优化) | 仅匹配外层标签内容(忽略内部 < 标签) |
| 性能损耗 | 高(回溯风险) | 低(快速截断) | 极低(无回溯) |
3. 核心差异总结
- 贪婪与非贪婪的区别:
.*会吞并所有可能的字符(包括其他<div>标签),适合匹配完整闭合块(如无嵌套的单个标签)。.*?按最小范围分割,适用于提取多个独立标签(如爬虫抓取列表项)。
- 精确排除的边界控制:
[^<]*通过排除<字符,严格限定标签内容为非标签文本,避免嵌套或干扰标签的污染,适用于结构化数据(如纯文本属性提取)。
4. 性能与适用性建议
- 优先选择非贪婪模式:在需要分割标签且无嵌套的场景下,
.*?性能优于贪婪模式 。 - 严格排除干扰字符:若标签内容不含其他 HTML 标签,使用
[^<]*可避免意外匹配(如<div>纯文本</div>)。 - 避免贪婪模式的嵌套风险:处理复杂 HTML 结构时,贪婪模式易导致过度匹配,需结合断言或语法树优化 。
注:若需处理嵌套标签(如
<div><div>A</div></div>),建议使用递归语法(如(?R))或解析库(如 BeautifulSoup)替代正则表达式
五、分支结构优化:高频分支前置
1. 未优化:低频分支在前
// 匹配协议(假设 http 请求占 90%)
String url = "http://example.com";
RegexBenchmark.benchmark("^(ftp|https?):\\/\\/", url, 1000);
2. 优化:高频分支优先
RegexBenchmark.benchmark("^(https?|ftp):\\/\\/", url, 1000);
性能提升:高频分支前置可减少平均匹配路径长度。
六、实战案例:邮箱验证优化
1. 未优化正则(易回溯)
String email = "user.name@example.com";
String badEmail = "user@name@example.com";

// 松散正则,允许无效字符
String regexLoose = "^[\\w.-]+@[\\w-]+(\\.[\\w-]+)+$";
RegexBenchmark.benchmark(regexLoose, badEmail, 1000);
2. 优化后正则
// 严格正则 + 原子组
String regexStrict = "^[a-z0-9](?>[\\w.-]*[\\w-])@(?>[a-z0-9-]+\\.)+[a-z]{2,6}$";
RegexBenchmark.benchmark(regexStrict, badEmail, 1000);
优化点:
- 使用原子组
(?>[\\w.-]*[\\w-])锁定用户名格式 - 明确域名部分结构
(?>[a-z0-9-]+\\.)+
电子邮箱正则:
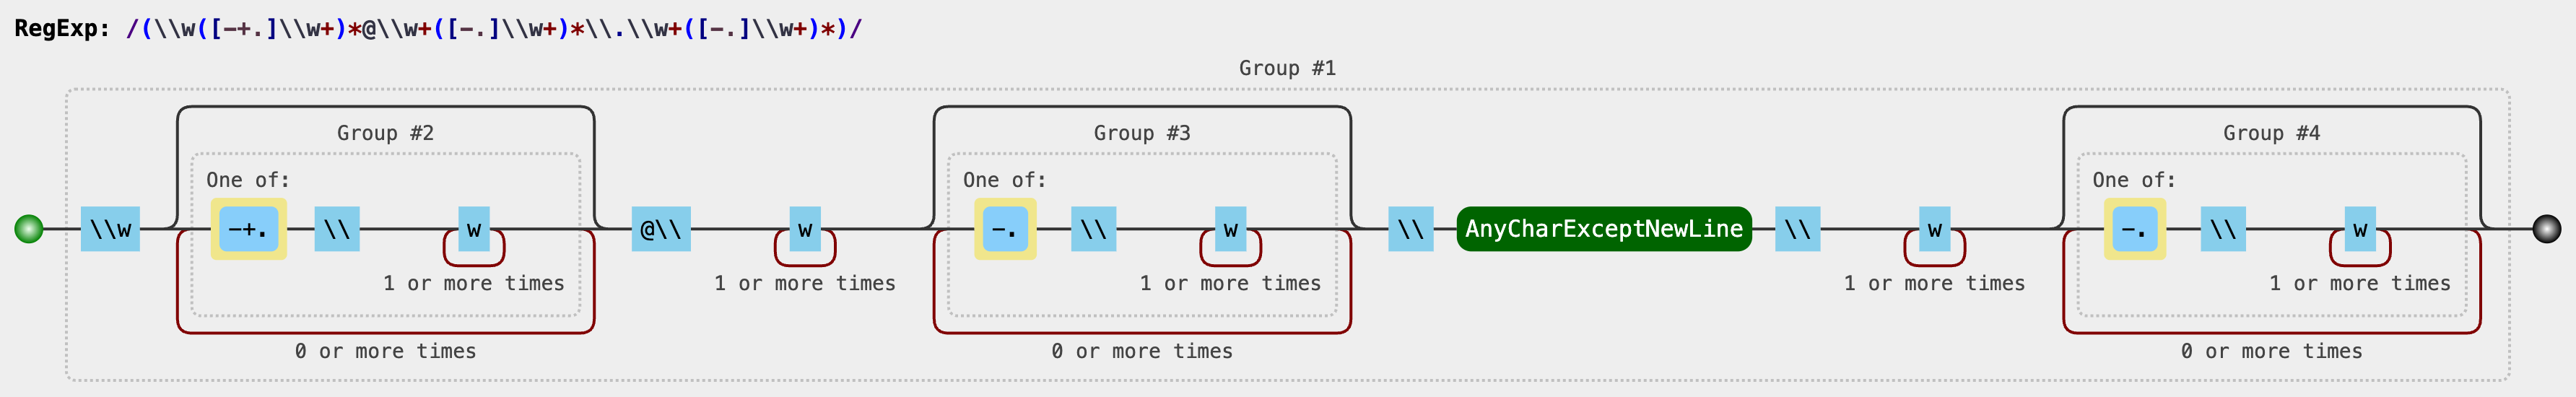
原始: (\\w([-+.]\\w+)*@\\w+([-.]\\w+)*\\.\\w+([-.]\\w+)*)
-
存在的问题
- 捕获组冗余:所有
()都是捕获组,但其实只需要整体捕获。 - 用户名部分:
\w包含_,但也允许匹配到一些不合理的组合(比如.-开头); - 域名部分:
\w也会允许下划线_,但真实域名不允许_; - 顶级域名:写成了
\w+,会匹配数字或单个字母,不符合规范; - 回溯风险:
(X+)*这种嵌套写法容易导致性能问题。
- 捕获组冗余:所有
优化后: ^[a-zA-Z0-9]+(?:[-+.]?[a-zA-Z0-9]+)*@(?:[a-zA-Z0-9](?:[a-zA-Z0-9-]{0,61}[a-zA-Z0-9])?\.)+[a-zA-Z]{2,63}$
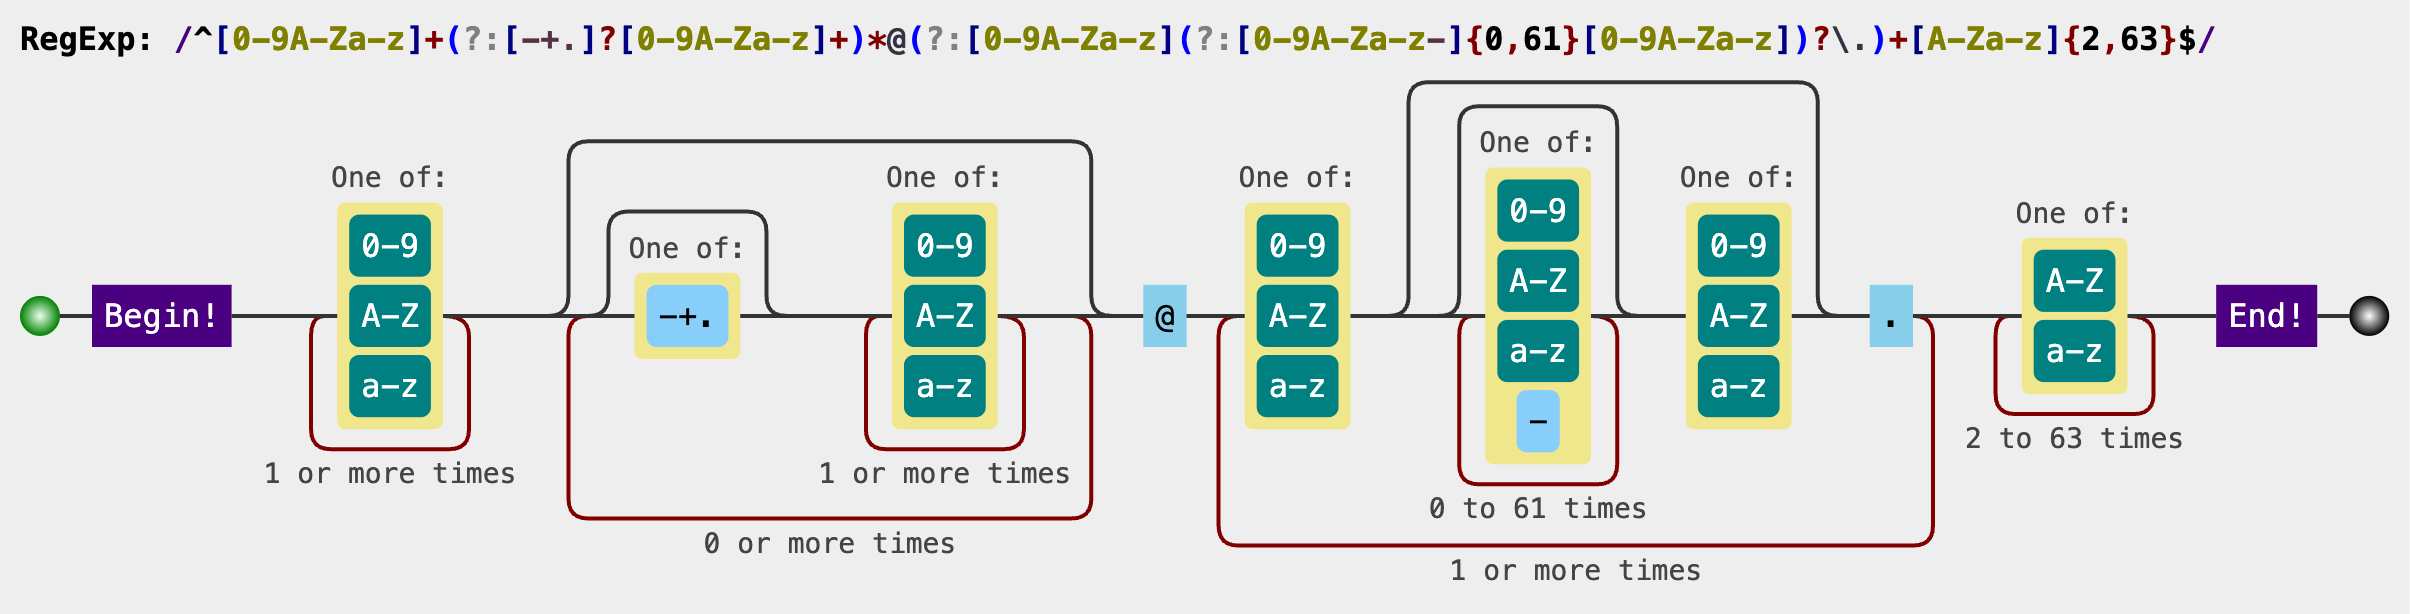
优化点分析
- 锚点:
- 加了
^...$,确保整串是邮箱,而不是在一段字符串中局部匹配。
- 加了
- 用户名部分:
^[a-zA-Z0-9]+:必须以字母或数字开头,避免了非法前导符号;(?:[-+.]?[a-zA-Z0-9]+)*:控制符号-+.必须夹在字母或数字之间,不能连续堆叠。比原来的\w([-+.]\\w+)*更严谨。
- 域名部分:
(?:[a-zA-Z0-9](?:[a-zA-Z0-9-]{0,61}[a-zA-Z0-9])?\.)+- 域名每一段必须以字母/数字开头和结尾,中间允许
-,但不能超过 63 个字符; - 彻底避免了
_和.-这种非法写法。
- 顶级域名部分:
[a-zA-Z]{2,63}:严格限制顶级域名必须是 2~63 位字母;- 避免了原来
\w+匹配到单个字母或数字的情况。
- 非捕获分组:
- 用
(?: ... )替代了原始的捕获组,只做分组而不保存结果; - 既减少内存占用,也避免了多余分组编号,语义更清晰。
- 用
总结对比
| 特性 | 原始版 | 优化后 |
|---|---|---|
| 捕获组 | 全是捕获组(冗余) | 合理使用非捕获组 |
| 用户名 | 过宽松(\w) | 严格符号规则 |
| 域名 | 允许 _ / 不限长度 | RFC 风格:字母数字开头结尾,≤63 |
| 顶级域名 | \w+(太宽松) | [a-zA-Z]{2,63}(规范) |
| 回溯风险 | 存在 (X+)* | 避免复杂嵌套,性能更好 |
| 规范程度 | 只能算“能用” | 接近 RFC 合法邮箱定义 |
七、Java 正则优化总结表
| 问题类型 | 优化手段 | Java 代码示例 |
|---|---|---|
| 回溯爆炸 | 占有量词 ++ | "(a++)+" |
| 动态内容匹配 | 原子组 (?>...) | "(?>(a+))+" |
| 贪婪匹配 | 非贪婪量词 .*? 或精确排除 | "<div>[^<]*</div>" |
| 分支顺序 | 高频分支前置 | `"^(https? |
第四章 Java 与 Shell 在正则表达式语法差异
以下是 Java 与 Shell 在正则表达式语法和使用上的主要区别对比表格
核心语法差异对比
| 分类 | Java 正则 | Shell 正则(如 grep/sed) | 说明 |
|---|---|---|---|
| 转义规则 | 双重转义(字符串和正则均需转义,如 \\d 表示 \d) | - 单引号 ' ':直接编写正则(无需转义)- 双引号 " ":需转义 Shell 特殊字符(如 \\ 表示 \) | Java 需考虑字符串和正则两层转义;Shell 中单引号更安全,避免 Shell 解释干扰。 |
| 数字匹配 | \\d | [0-9] 或 [[:digit:]] | Shell 默认不支持 \d,需用字符类或 POSIX 语法。 |
| 单词字符 | \\w | [[:alnum:]] 或 \w(部分工具支持) | Shell 中 \w 依赖工具版本(如 grep -P 支持 Perl 语法)。 |
| 空白符匹配 | \\s | [[:space:]] | Shell 中需用 POSIX 字符类。 |
| 单词边界 | \\b | \<(词首)和 \>(词尾)或 \b(仅部分工具) | Shell 基础正则中常用 \< 和 \>,\b 需工具支持(如 grep -P)。 |
| 量词语法 | ?、+、*,支持非贪婪(*?、+?) | ? 和 + 仅在扩展正则中有效(如 grep -E)非贪婪匹配需 grep -P | Shell 基础正则中 ? 和 + 需转义(如 \?、\+),且非贪婪匹配几乎不支持。 |
| 分组与后向引用 | () 分组,\\1 引用 | () 分组仅在扩展正则中有效,\1 引用 | Shell 基础正则(如默认 grep)不支持分组引用,需用 grep -E 或 sed -r。 |
| 行首/行尾 | ^ 和 $ | ^ 和 $ | 两者语法一致,但 Shell 中需注意多行模式是否启用(默认单行)。 |
| 工具兼容性 | 统一使用 java.util.regex(PCRE 风格) | 依赖工具: - grep -E(扩展正则)- grep -P(Perl 语法,非通用)- sed -r(扩展正则) | Shell 工具碎片化,不同工具/选项语法差异较大。 |
注意事项:
- Shell 工具差异:不同的 Shell 工具(如
grep、sed、awk)支持的正则表达式语法可能不同,需要根据具体工具选择合适的语法。 - 扩展正则表达式:在 Shell 中,
grep -E或sed -r可以启用扩展正则表达式(ERE),支持更多特性(如+、?、|等)。 - Perl 正则表达式:
grep -P和awk支持更接近 Perl 的正则表达式语法,但并非所有 Shell 环境都默认支持。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 10
 0
- 0


 已为社区贡献1条内容

所有评论(0)