计算机基础速通--数据结构·树的应用
如有问题大概率是我的理解比较片面,欢迎评论区或者私信指正。
一、基础概念
一、树的基本概念与性质
-
树是n(n≥0)个结点的有限集合。n=0时称为空树;非空树满足:有且仅有一个根节点;除根节点外,每个结点有且仅有一个前驱;每个结点可以有0个或多个后继;没有后继的结点称为叶子结点(终端结点),有后继的结点称为分支结点(非终端结点)。
-
基本术语
- 结点关系:根节点(无前驱)、叶子结点(无后继)、分支结点(有后继);父节点(前驱)、孩子节点(后继)、兄弟节点(同一父节点)、祖先 / 子孙结点(路径关系)。
- 属性描述:结点的度(孩子数)、树的度(最大结点度);结点的层次(深度,从上往下数)、高度(从下往上数);树的高度(总层数)。
- 特殊分类:有序树(子树次序不可换)、无序树(子树次序可换);森林
棵互不相交的树)。
-
树的常考性质
- 结点数与度数的关系:总结点总数 = 总度数 + 1。
- m叉树与度为m的树的区别:
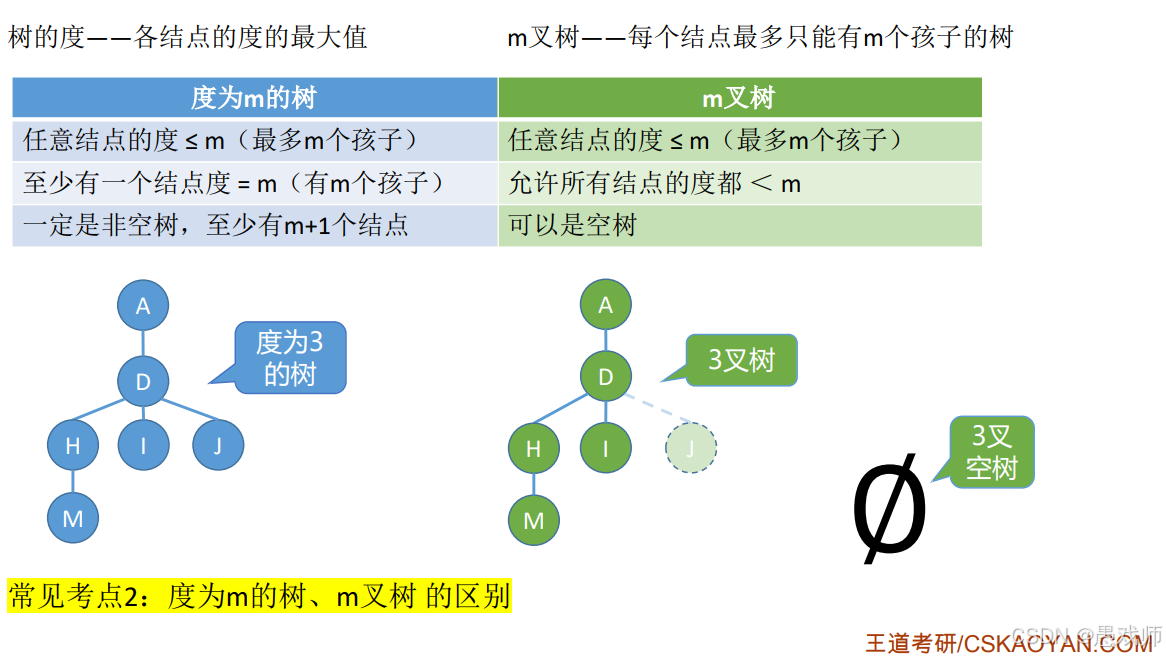
-
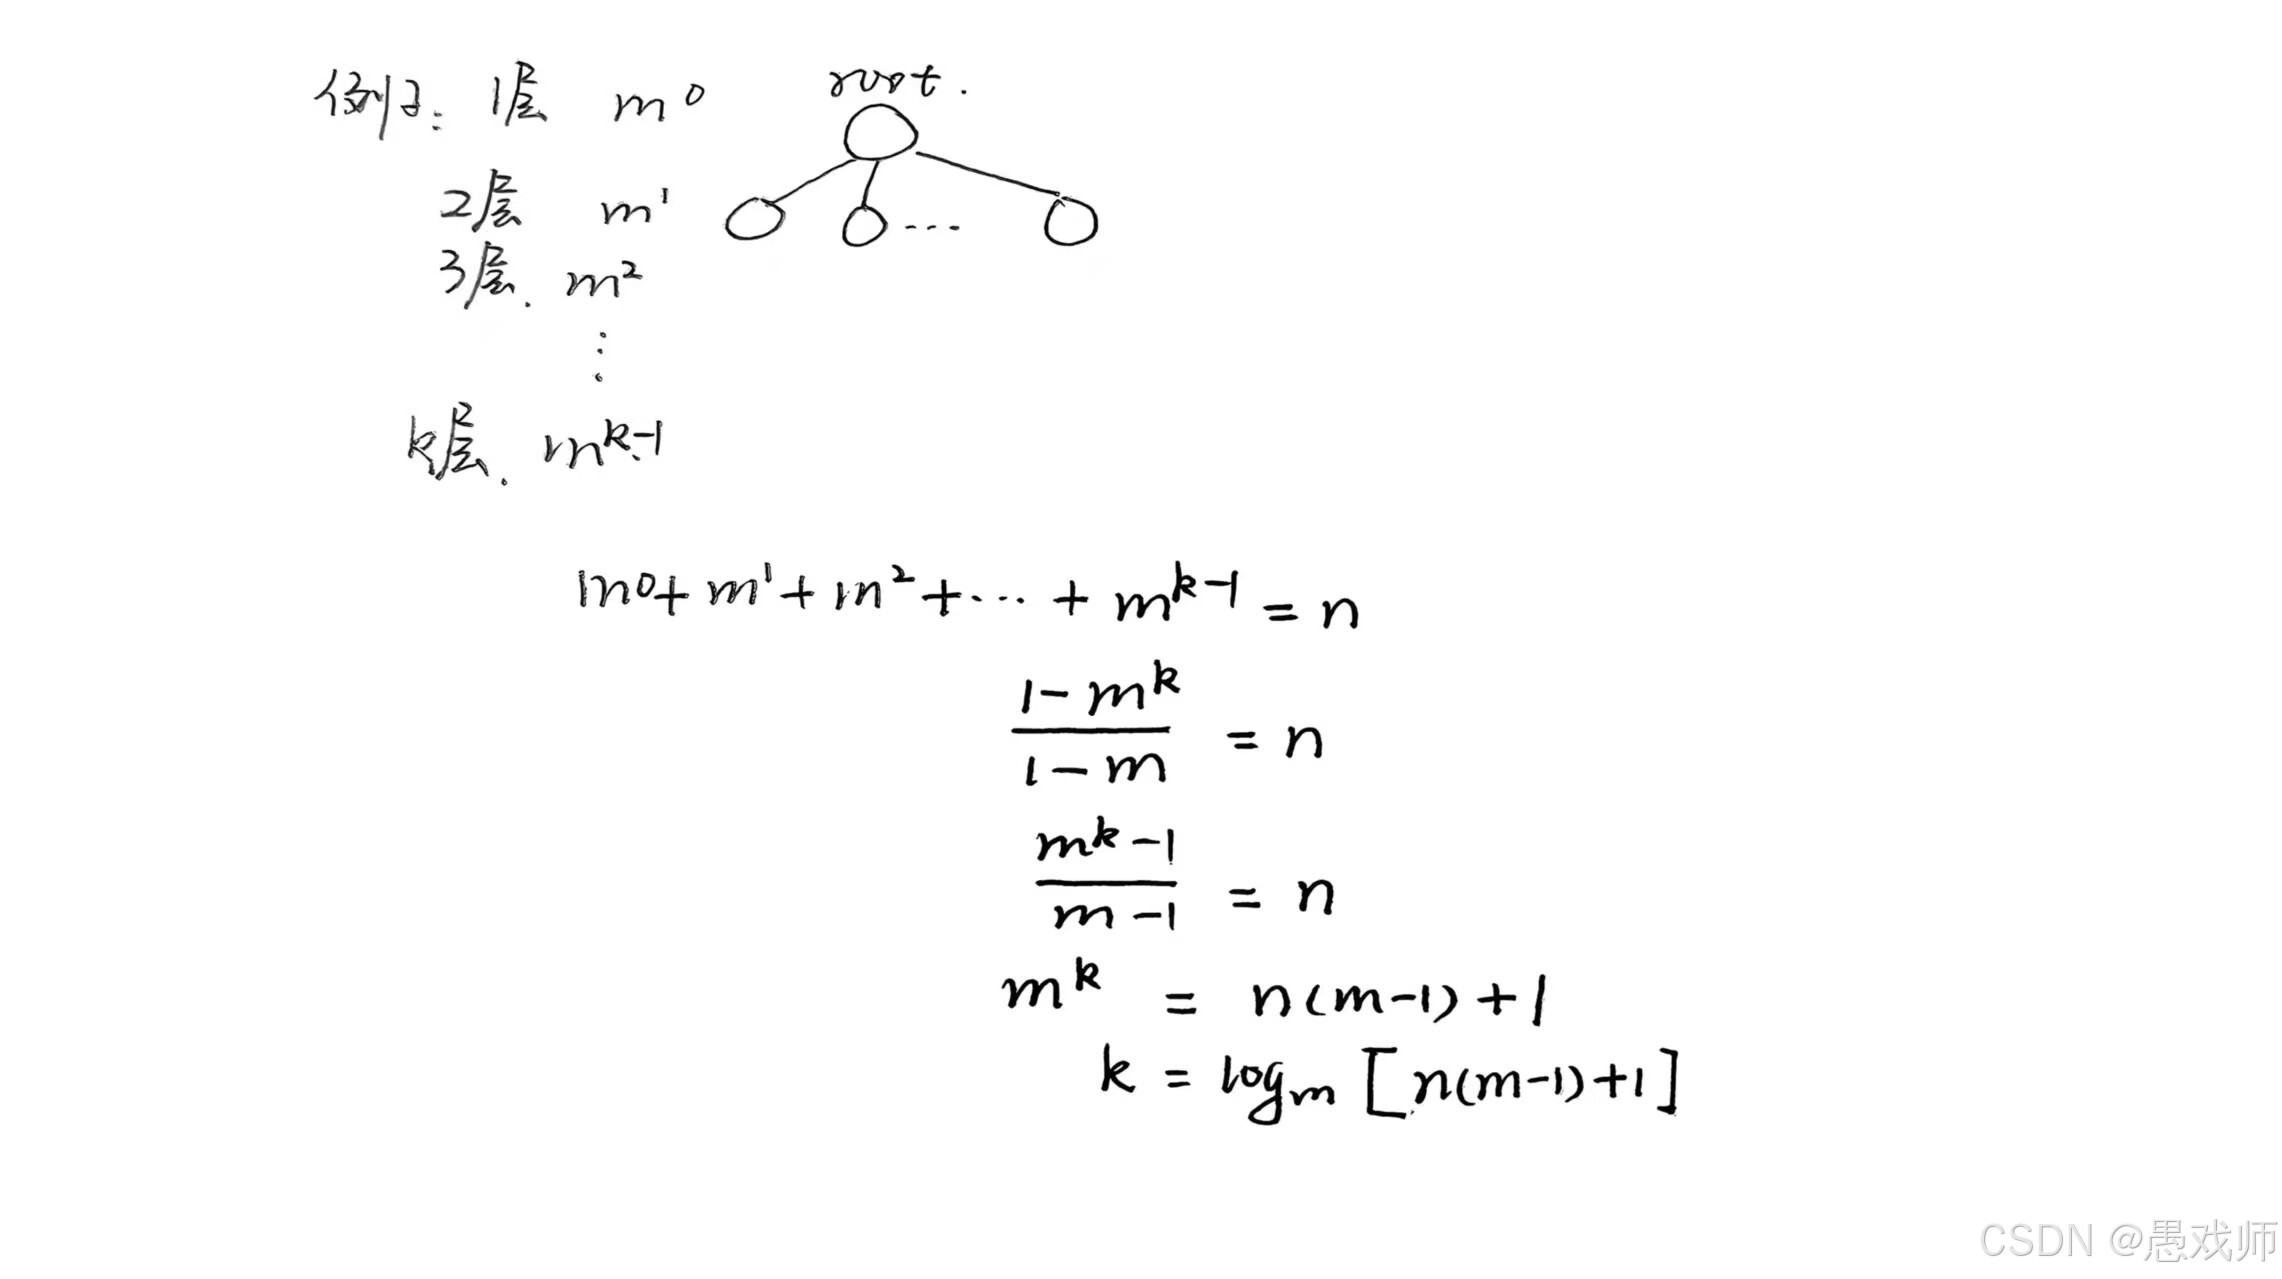
层结点数限制:度为m或m叉树第i层至多有
个结点(i≥1)。
树的高度与结点数: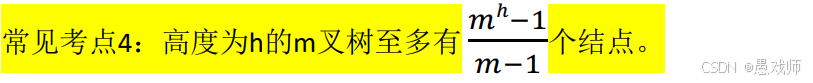
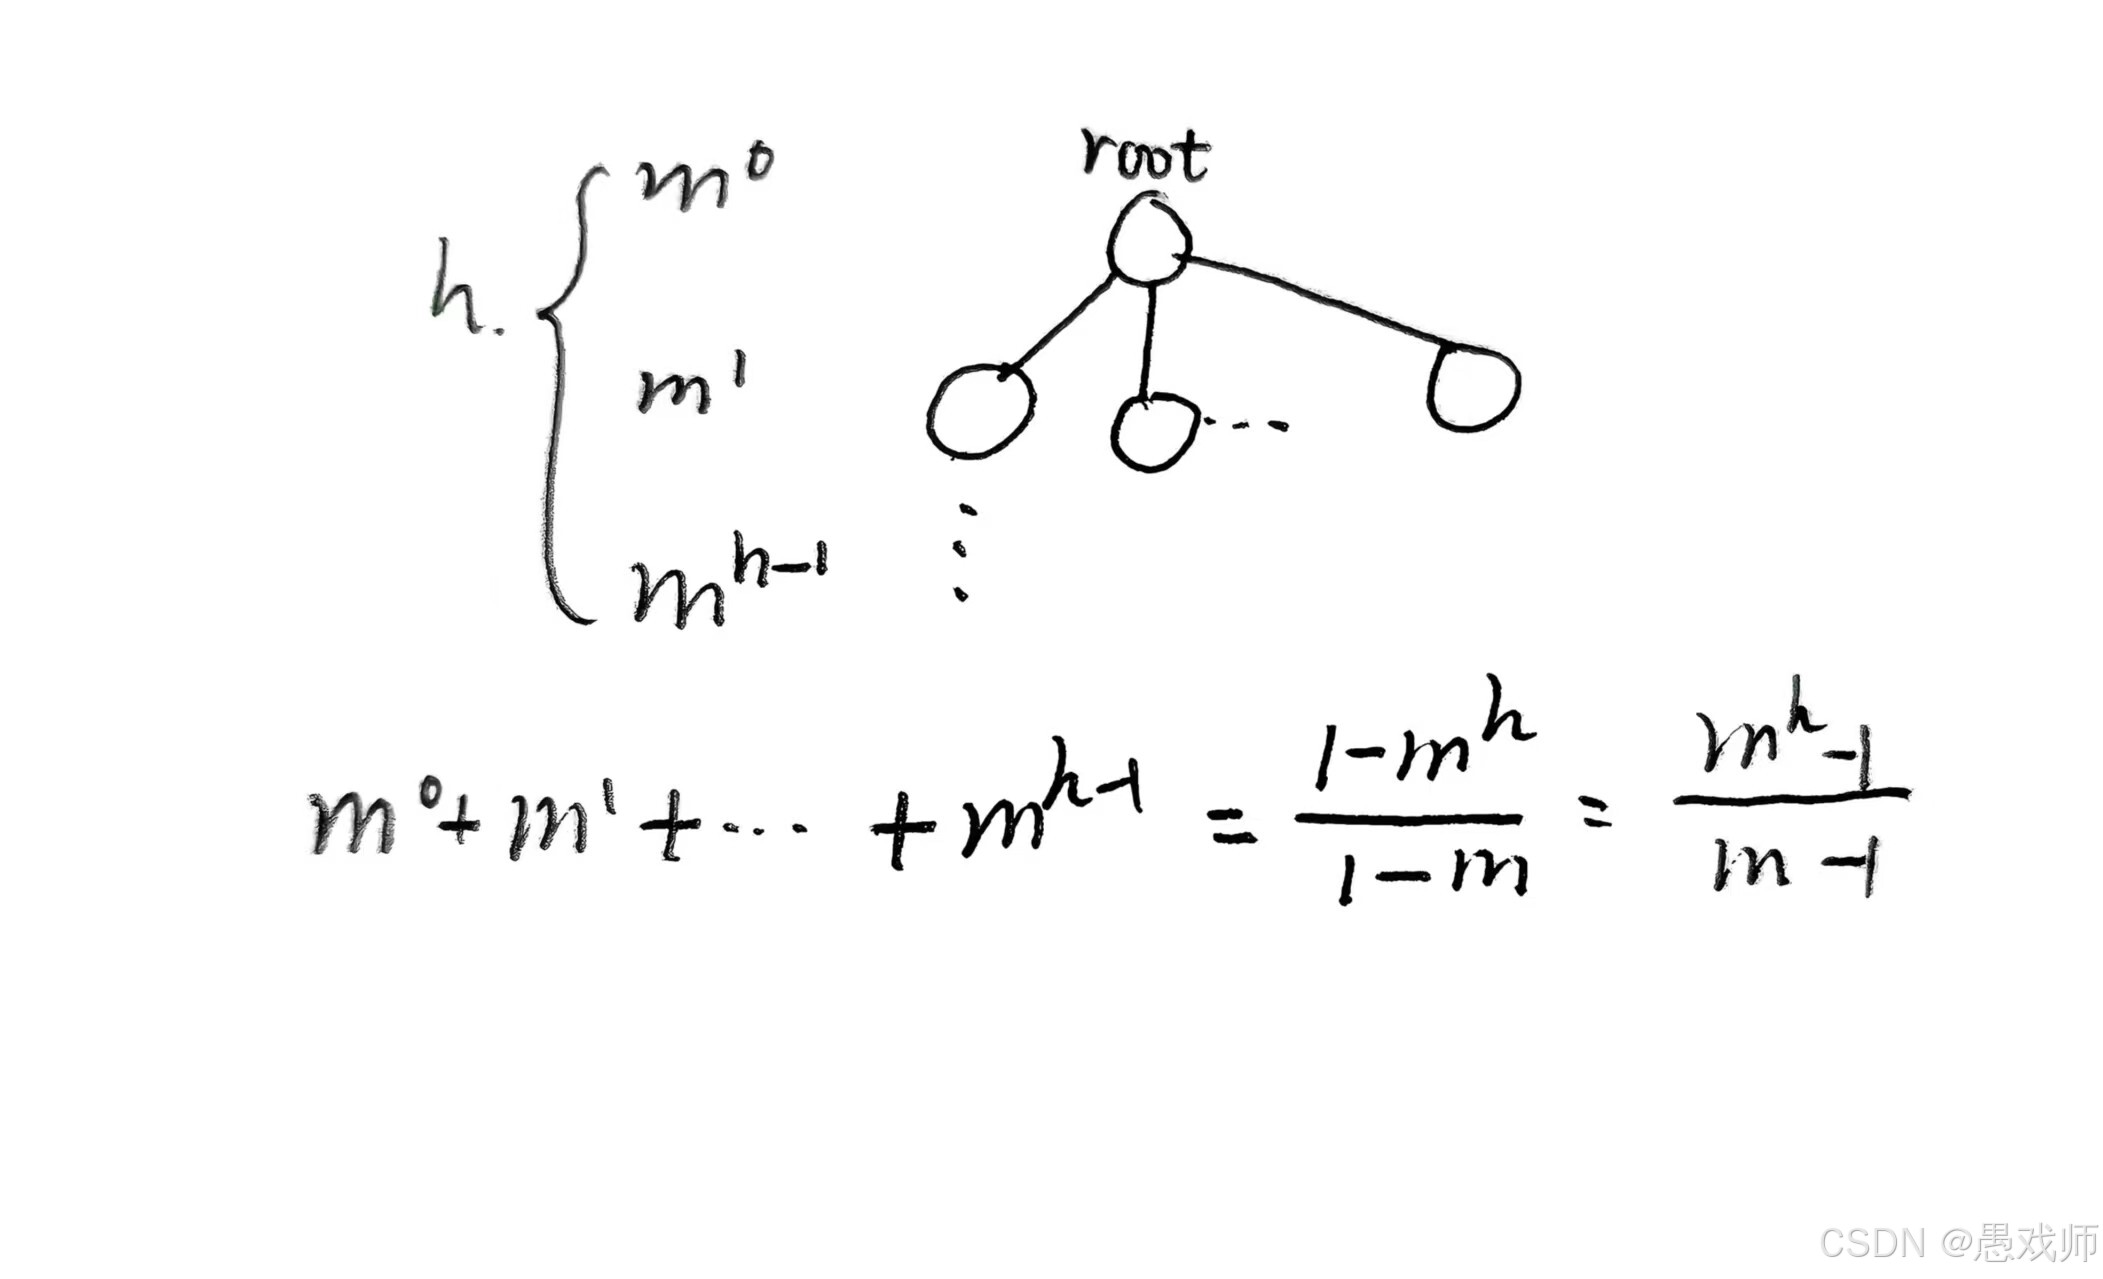
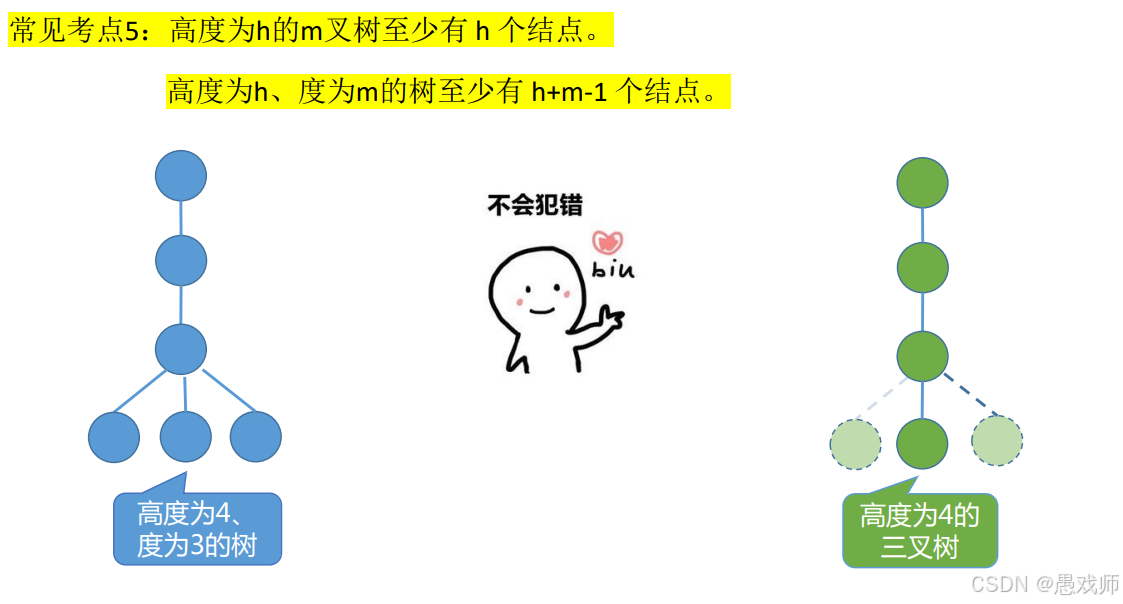
-
最小高度计算:具有n个结点的m叉树最小高度为
,推导基于满二叉树性质。
二、二叉树的基本概念与性质
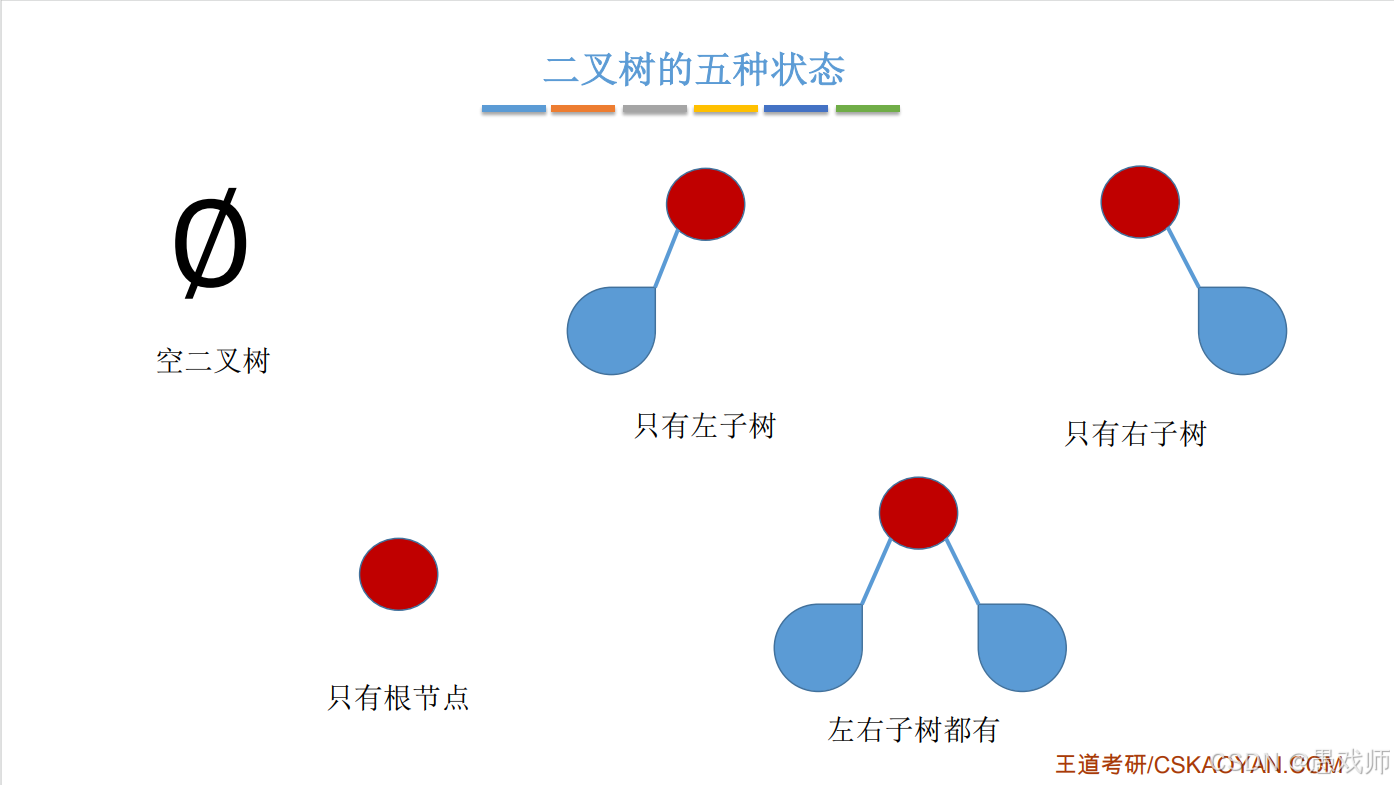
二叉树定义 :二叉树是n(n≥0)个结点的有限集合:或为空二叉树;或由一个根结点和两个互不相交的左子树和右子树组成(左右子树不能颠倒,是有序树)。二叉树与度为2的有序树区别在于,二叉树允许空子树,且子树次序固定。
五种状态:空二叉树、只有根节点、只有左子树、只有右子树、左右子树均存在。
特殊二叉树
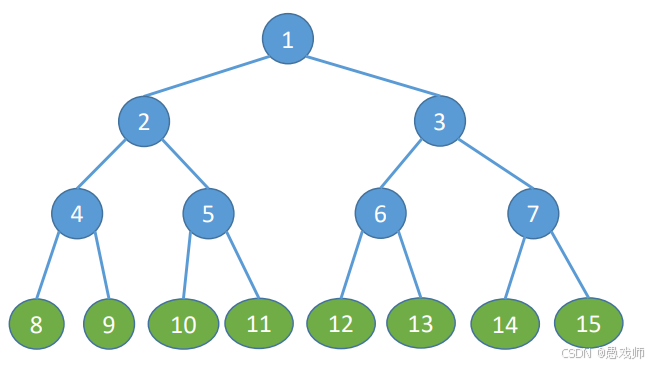
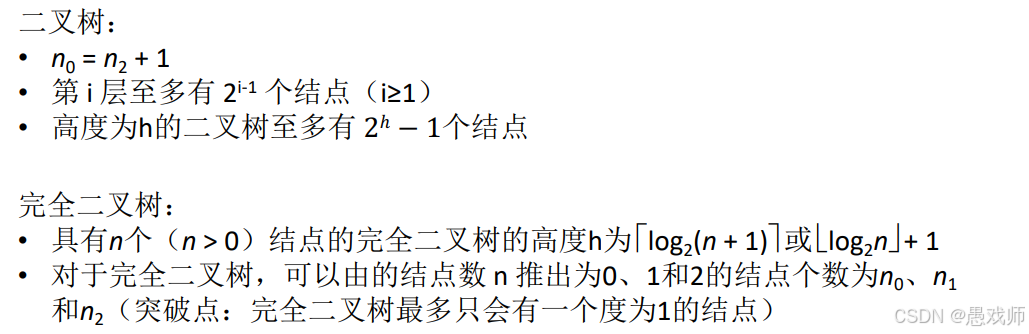
满二叉树:高度h,含个结点,仅最后一层有叶子结点。
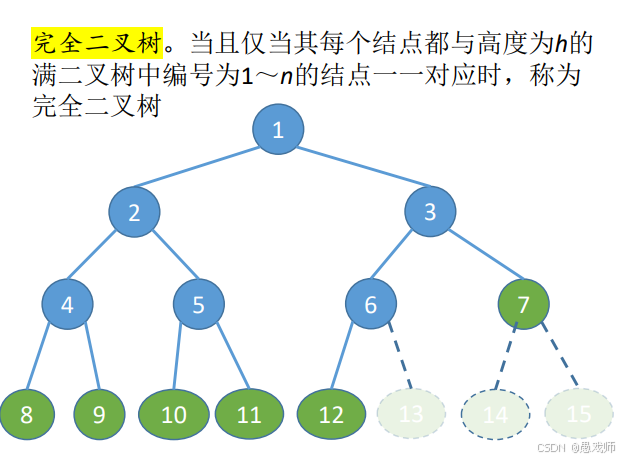
完全二叉树:结点编号与同高度满二叉树的前n个结点一一对应,最后两层可能有叶子,最多一个度为 1 的结点。
二叉排序树:左子树关键字<根节点<右子树关键字(递归),用于排序和搜索。
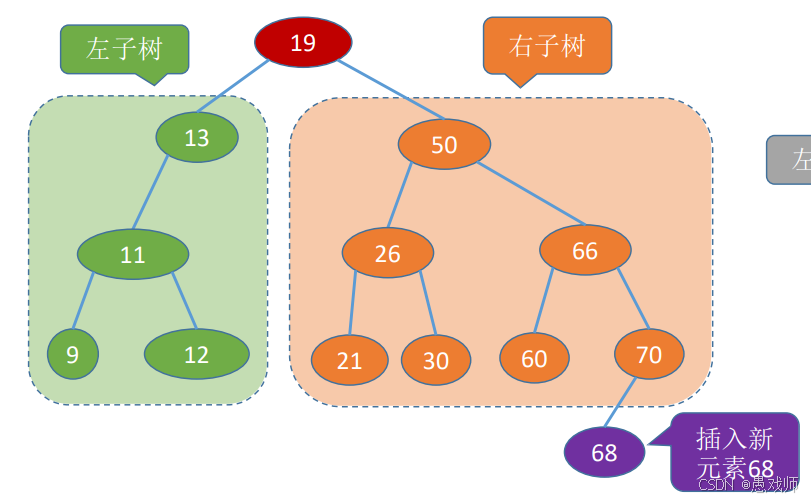
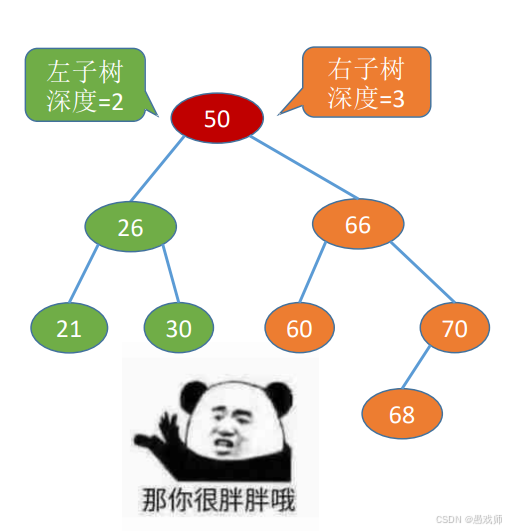
平衡二叉树:任一结点左右子树深度差,保证高效搜索。
二叉树的常考性质
三、二叉树的存储结构
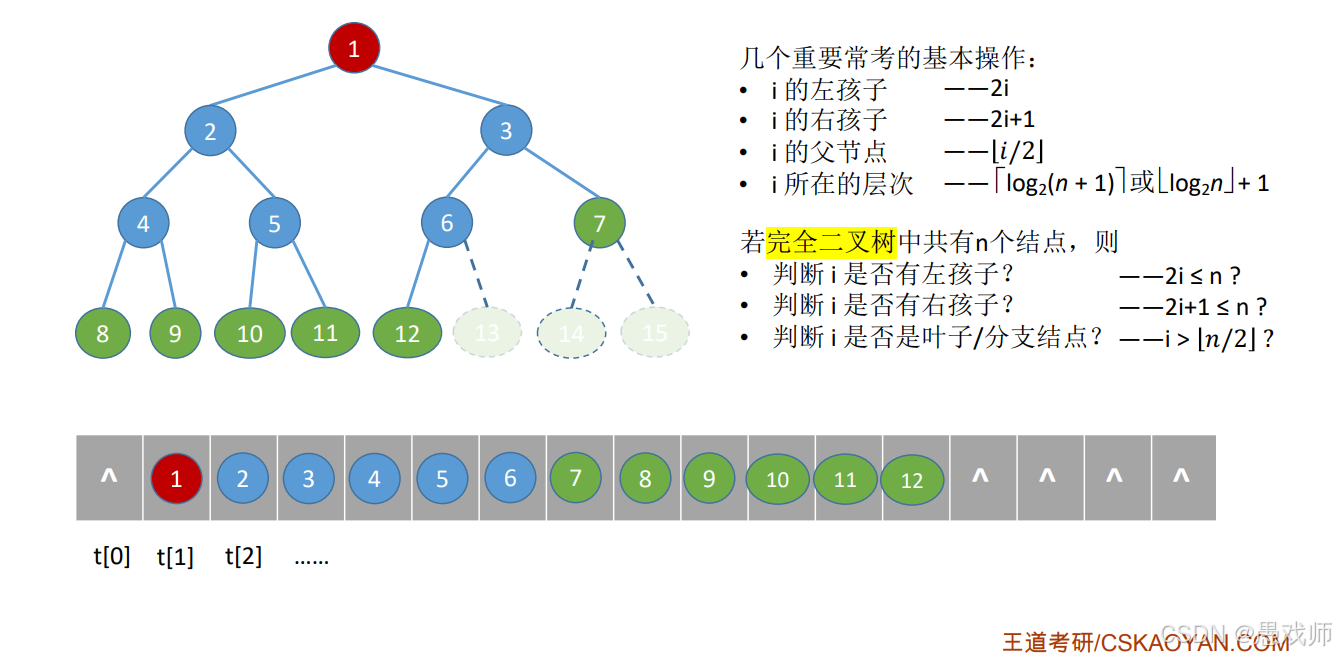
顺序存储 适合完全二叉树,用数组按层序存储,下标反映关系:i的左孩子2i、右孩子、父节点
;非完全二叉树会浪费空间。
链式存储
- 二叉链表:每个结点含数据域、左 / 右孩子指针,n个结点有n+1个空链域。
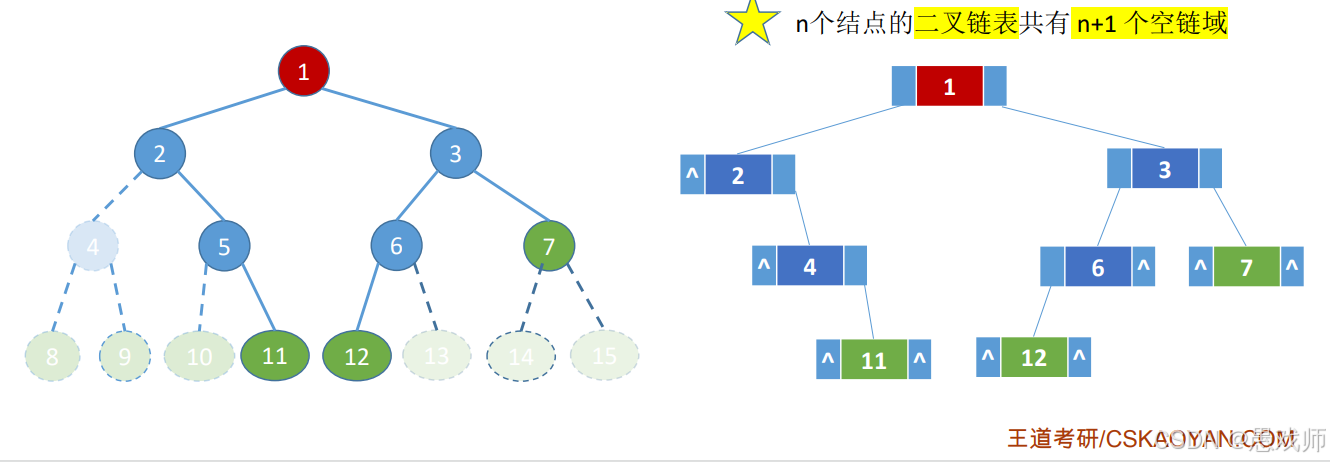
- 三叉链表:增加父节点指针,方便找前驱。
问题1:“为什么完全二叉树适合用数组存储?”
二、基本操作实现
二叉树的遍历与构造
- 重点:二叉树的前序、中序、后序遍历(递归和非递归实现)以及层序遍历的算法思想、代码实现和应用场景;根据遍历序列构造二叉树(如已知前序和中序遍历序列,构造二叉树);遍历算法在解决实际问题中的应用(如计算二叉树的高度、结点数、叶子结点数等)。
遍历方式
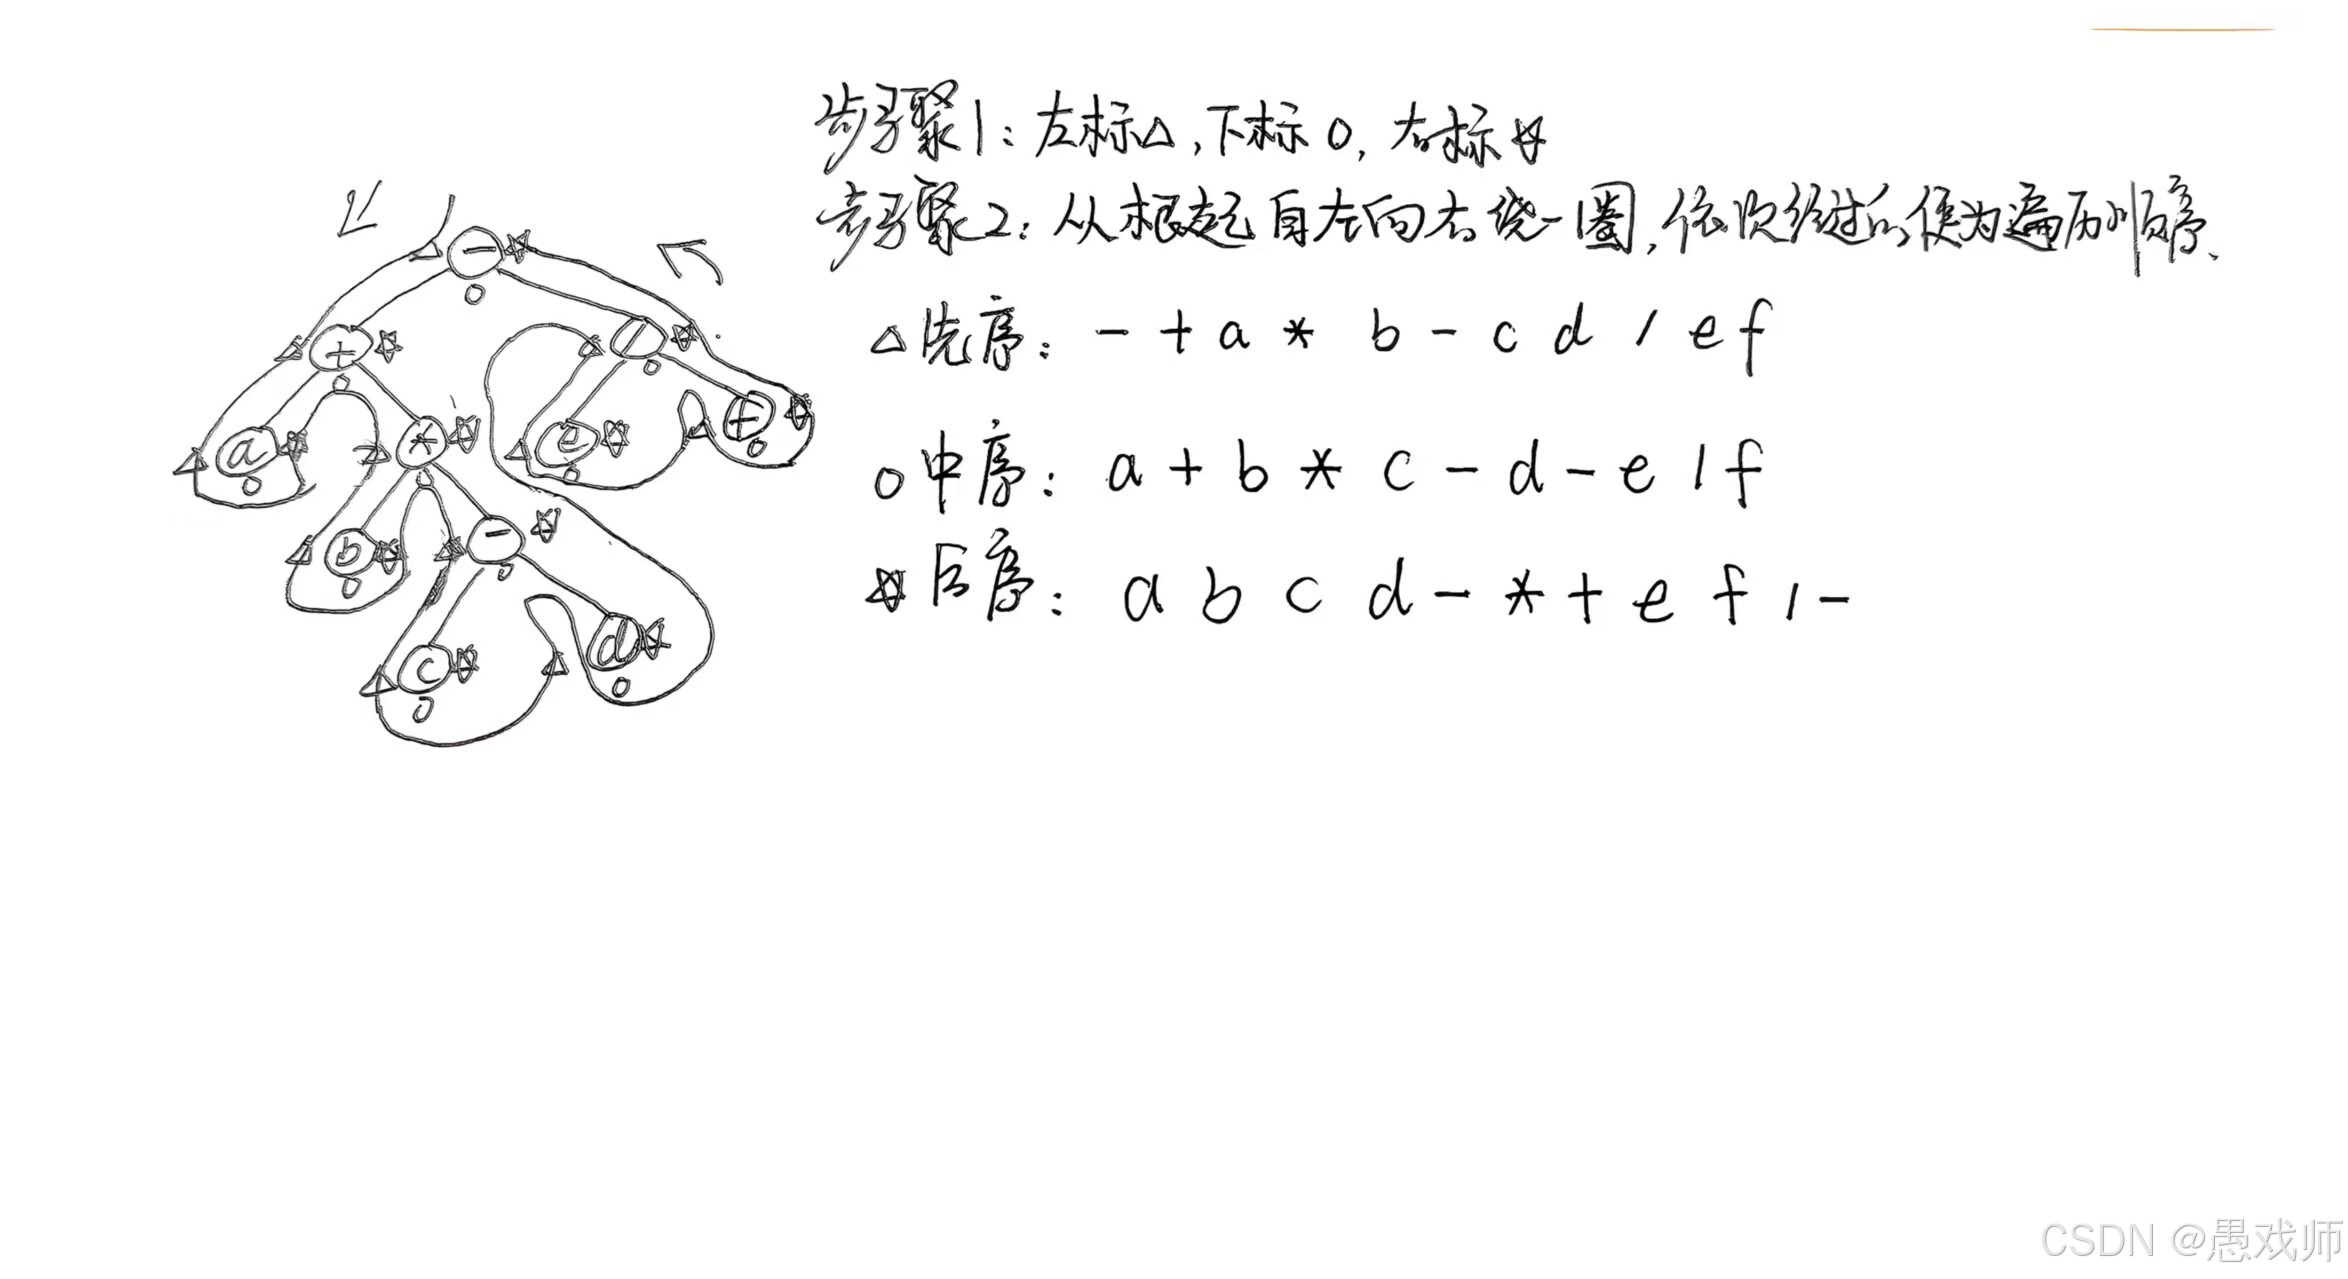
- 先序遍历(NLR):根→左子树→右子树。
- 中序遍历(LNR):左子树→根→右子树。
- 后序遍历(LRN):左子树→右子树→根。
- 层序遍历:用队列实现,按层访问(根入队→出队访问→孩子入队,循环至空)。
遍历序列的应用
算术表达式树:先序→前缀表达式,中序→中缀表达式(需括号),后序→后缀表达式。
求树的深度:递归计算左右子树深度的最大值 + 1。
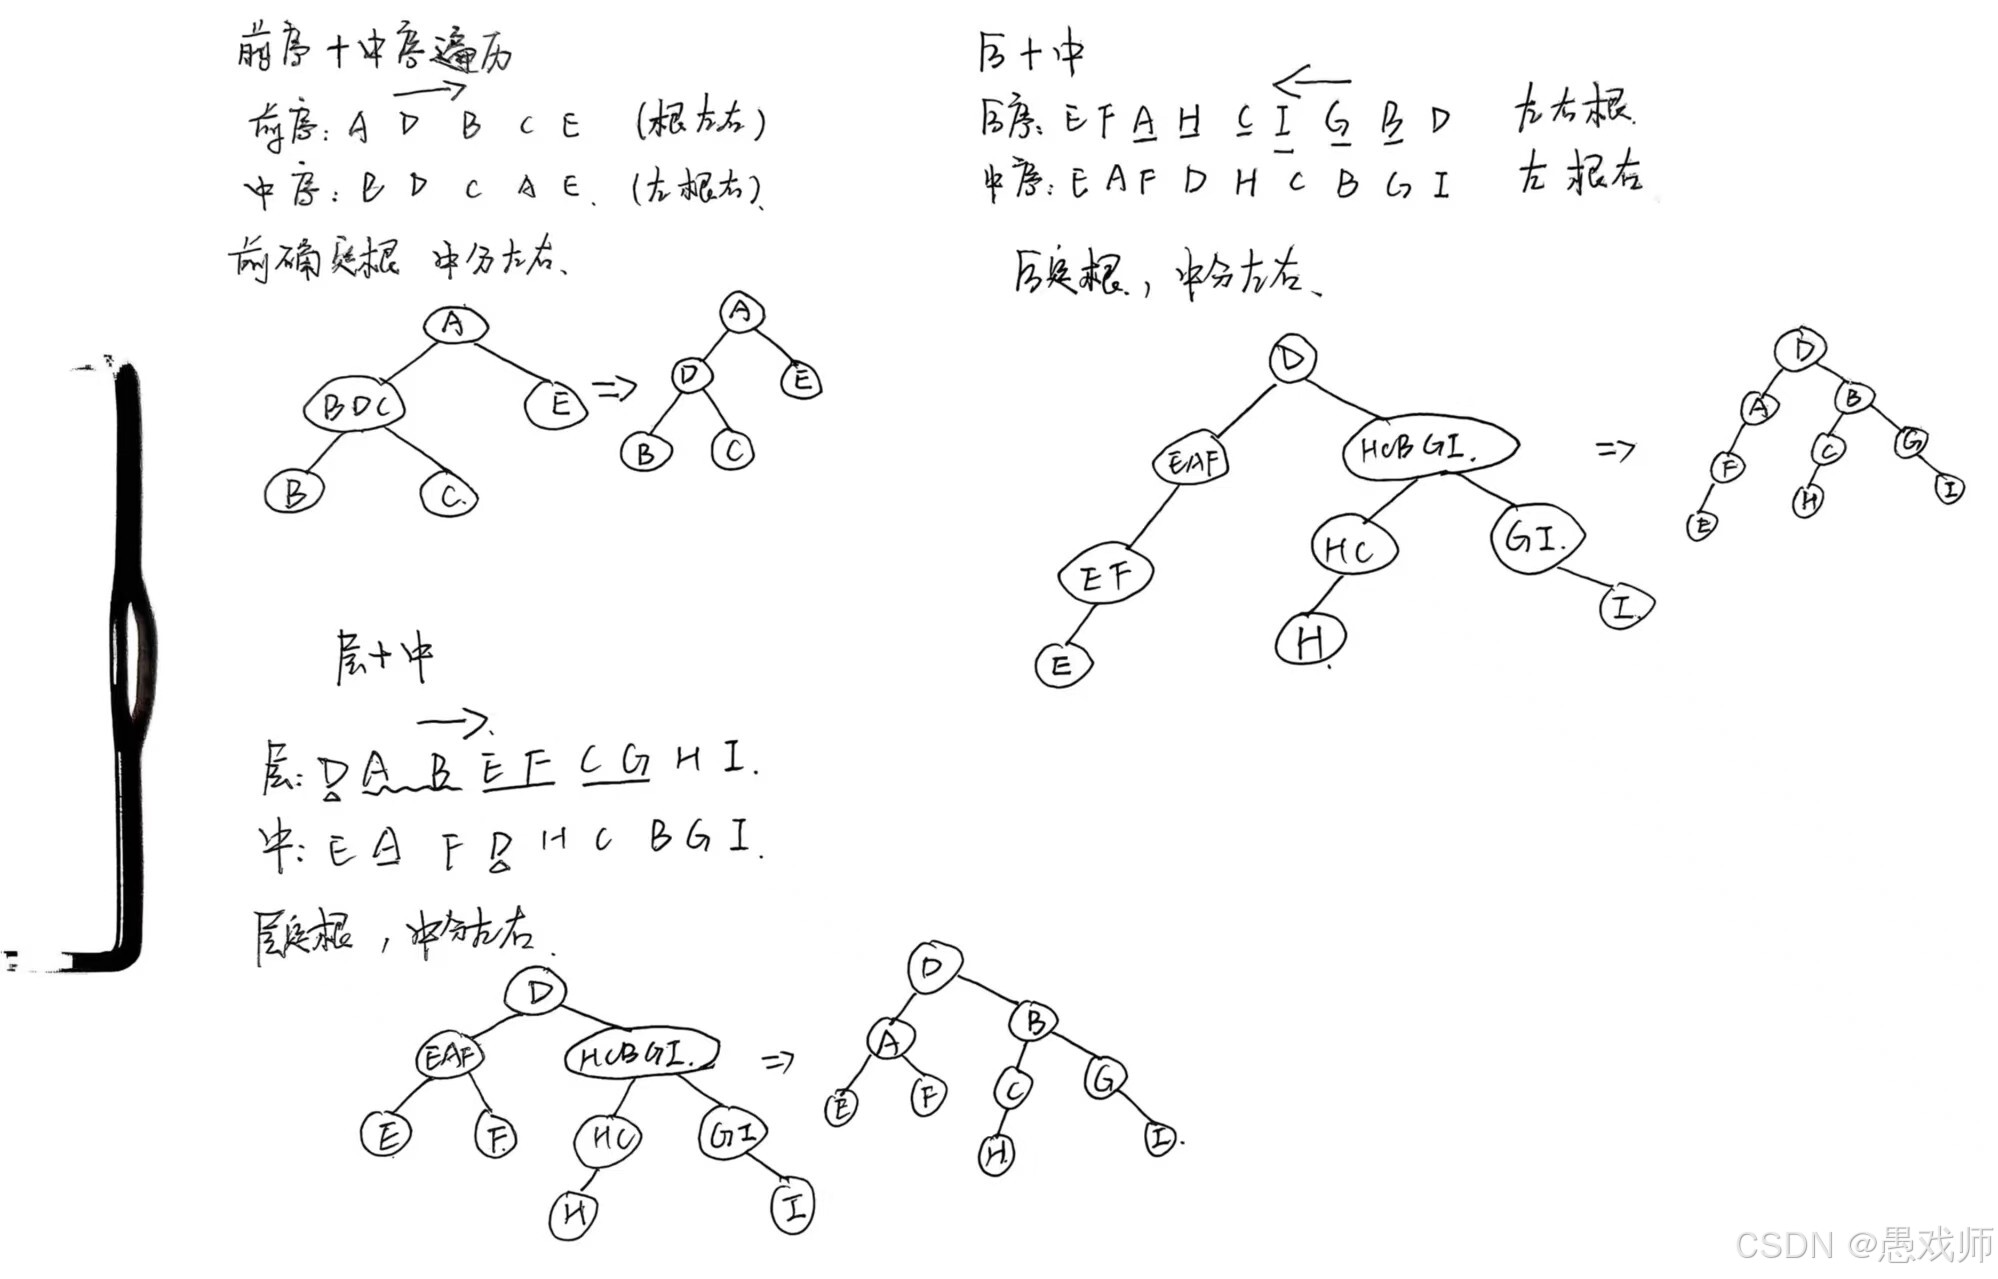
由遍历序列构造二叉树 需结合中序序列:前序 + 中序、后序 + 中序、层序 + 中序可唯一确定二叉树(中序用于划分左右子树)。若只给出一棵二叉树的 前/中/后/层 序遍历序列中的一种,不能唯一确定一棵二叉树。
问题1:94. 二叉树的中序遍历 - 力扣(LeetCode)
class Solution {
    public List<Integer> inorderTraversal(TreeNode root) {
      List<Integer> ans=new ArrayList<>();
      inorder(root,ans);
      return ans;
    }

    public static void inorder(TreeNode root,List<Integer> ans){
        if(root==null)return ;
        inorder(root.left,ans);
        ans.add(root.val);
        inorder(root.right,ans);
    }
}问题2:102. 二叉树的层序遍历 - 力扣(LeetCode)
关键思路:用队列记录每层扩展节点
size的作用
在进入内层循环前获取当前队列大小 Size = deque.size()
确保内层循环只处理当前层的节点(外层循环的每轮对应一层)
层级分离原理
内层循环中:弹出的节点都是当前层的,加入的子节点属于下一层
循环结束时:队列中仅剩下一层的节点,实现了自动分层
终止条件:队列为空时说明所有层处理完毕
class Solution {
    public List<List<Integer>> levelOrder(TreeNode root) {
        List<List<Integer>> ans=new ArrayList<List<Integer>>();
        if(root==null)return ans;
        Deque <TreeNode> deque=new LinkedList<>();
        deque.offerLast(root);
        while(!deque.isEmpty()){
            List<Integer> level=new ArrayList<>();
            //确定同层次边界
            int size=deque.size();
            //同层次节点处理
            for(int i=0;i<size;i++){
                //取节点
                TreeNode curr=deque.pollFirst();
                //处理
                level.add(curr.val);
                //存下一层节点
                if(curr.left!=null)deque.offerLast(curr.left);
                if(curr.right!=null)deque.offerLast(curr.right);
            }
            //保存一层结果
            ans.add(level);
        }
        return ans ;
    }
}问题3:104. 二叉树的最大深度 - 力扣(LeetCode)
关键思路:树的高度=max(左子树高度,右子树高度)+1
class Solution {
    public int maxDepth(TreeNode root) {
        //终止条件·到达叶子节点
        if(root==null)return 0;
        //左子树深度
        int left=maxDepth(root.left);
        //右子树深度
        int right=maxDepth(root.right);
        //总深度=左右子树深度最大值+1(这个1指的是根节点)
        return Math.max(left,right)+1;
    }
}问题4:226. 翻转二叉树 - 力扣(LeetCode)
class Solution {
    public TreeNode invertTree(TreeNode root) {
        //终止条件
        if(root==null)return null;
        //翻转一棵树只需要交换它的左子树和右子树便可
        TreeNode left=invertTree(root.left);
        TreeNode right=invertTree(root.right);
        root.left=right;
        root.right=left;
        return root;
    }
}问题5:101. 对称二叉树 - 力扣(LeetCode)
整棵树的对称性 = 根节点值相等 + 左子树右子树对称
左子树右子树对称=左子树右子树的根节点相等+镜像位置值相等
将整棵树的对称性转化为左右子树是否镜像对称的问题:
根节点自身对称(左右子树镜像对称)
左子树与右子树互为镜像
两个树互为镜像当且仅当同时满足:
-
根节点值相同 (
p.val == q.val) -
左子树的左子树与右子树的右子树对称 (
p.left 与 q.right) -
左子树的右子树与右子树的左子树对称 (
p.right 与 q.left)
形象理解:想象把左右子树对折后能完全重合
class Solution {
    public boolean isSymmetric(TreeNode root) {
        //向左右子树对称遍历
        return check(root.left,root.right);
    }
    public boolean check(TreeNode left,TreeNode right){
        //终止条件
        if(left==null && right==null)return true;
        if(left==null || right==null)return false;

        return left.val==right.val && check(left.left,right.right) && check(left.right,right.left);
    }
}问题6:543. 二叉树的直径 - 力扣(LeetCode)
问题本质:二叉树的直径实际上是指树中任意两个节点路径长度的最大值。路径长度定义为路径上的边数也就是节点数减1。
关键观察:对于任意节点,经过该节点的最长路径由左子树的最深路径、右子树的最深路径和该节点自身组成。
递归策略:
计算每个节点左子树的深度(L)和右子树的深度(R)。
经过当前节点的最长路径节点数为 L + R + 1。
更新全局最大路径节点数 ans。
返回当前节点的深度(max(L, R) + 1)供父节点使用。
结果转换:最终直径为 ans - 1(因为路径长度 = 节点数 - 1)。
class Solution {
    int ans=0;
    public int diameterOfBinaryTree(TreeNode root) {
        deep_node(root);
        return ans-1;
    }

    //求路径的节点数
    public  int deep_node(TreeNode root){
        //终止条件
        if(root==null)return 0;
        //左
        int left=deep_node(root.left);
        //右
        int right=deep_node(root.right);
        //更新最大路径节点数
        ans=Math.max(ans,left+right+1);
        //返回当前节点的最大深度
        return Math.max(left,right)+1;
    }

}
核心:将求最长路径=最大节点数-1,一个二叉树的最大节点数=左子树最大深度+右子树最大深度+本身。
二叉树的搜索
问题7:108. 将有序数组转换为二叉搜索树 - 力扣(LeetCode) https://leetcode.cn/problems/convert-sorted-array-to-binary-search-tree/description/?envType=study-plan-v2&envId=top-100-liked
核心思路
中序遍历特性
二叉搜索树(BST)的中序遍历结果是升序序列,题目给定的有序数组即对应BST的中序遍历结果。
仅凭中序遍历序列无法唯一确定BST(因根节点位置不固定)。
平衡二叉搜索树的构建关键
增加高度平衡要求后,仍无法唯一确定BST(根节点可选不同中间位置)。
核心策略:选择中间位置的值作为根节点,确保左右子树节点数最多相差 1,递归构建左右子树。
三种根节点选择方法
| 方法 | 根节点下标计算 | 特点 |
|---|---|---|
| 方法一(左中位数) |
| 总是选中间靠左的值作为根节点 |
| 方法二(右中位数) |
| 总是选中间靠右的值作为根节点 |
| 方法三(随机中位数) |
| 随机选择左或右中位数作为根节点 |
递归实现步骤
终止条件:
当子数组范围无效时(left > right),返回空树。
根节点选择:
计算当前子数组的中间位置 mid,以 nums[mid]作为根节点。
递归构建子树:
左子树范围:[left, mid-1]
右子树范围:[mid+1, right]
class Solution {
    public TreeNode sortedArrayToBST(int[] nums) {
        return CreatTree(nums,0,nums.length-1);

    }
    public TreeNode CreatTree(int[] nums,int left,int right){
        //终止条件
        if(left>right)return null;
        int mid=left+((right-left)>>1);
        TreeNode root=new TreeNode(nums[mid]);
        root.left=CreatTree(nums,left,mid-1);
        root.right=CreatTree(nums,mid+1,right);
        return root;
    }
}
关键在于:nums是中序遍历结果(升序),并且根据平衡限制从中间位置作为根从而固定根的位置。
问题8 98. 验证二叉搜索树 - 力扣(LeetCode)https://leetcode.cn/problems/validate-binary-search-tree/description/?envType=study-plan-v2&envId=top-100-liked
class Solution {
    public boolean isValidBST(TreeNode root) {
        return Check(root,Long.MIN_VALUE,Long.MAX_VALUE);
    }
    public boolean Check(TreeNode node,long low,long up){
        //终止条件
        if(node==null)return true;
        //检查当前节点
        if(node.val<=low || node.val>=up)return false;
        //检查左右子树
        return Check(node.left,low,node.val) && Check(node.right,node.val,up);
    }
}核心思想
通过上下边界约束子树节点值范围:
左子树上限 = 当前根节点值
右子树下限 = 当前根节点值
使用开区间 (lower, upper)
问题9 230. 二叉搜索树中第 K 小的元素 - 力扣(LeetCode)
class Solution {
    List<Integer> ans=new ArrayList<>();
    public int kthSmallest(TreeNode root, int k) {
        Deque<TreeNode> stack=new ArrayDeque<>();
        while(!stack.isEmpty() || root!=null){
            while(root!=null){
                stack.push(root);
                root=root.left;
            }
            root=stack.pop();
            --k;
            if(k==0)break;
            root=root.right;
        }
        return root.val;
    }
}
基础做法就是用栈模拟递归中序遍历即可。
问题10 199. 二叉树的右视图 - 力扣(LeetCode)
class Solution {
    public List<Integer> rightSideView(TreeNode root) {
        Deque<TreeNode> queue=new ArrayDeque<>();
        List<Integer> ans=new ArrayList<>();
        if (root==null)return ans;
        queue.offerLast(root);
        while(!queue.isEmpty()){
            int size=queue.size();
            for(int i=0;i<size-1;i++){
                TreeNode node=queue.poll();
                if(node.left!=null) queue.offer(node.left);
                if(node.right!=null)queue.offer(node.right);
            }
            //处理每层最后一个节点
            TreeNode node=queue.poll();
            ans.add(node.val);
            if(node.left!=null) queue.offer(node.left);
            if(node.right!=null)queue.offer(node.right);
        }
        return ans;
    }
}
每层最后一个节点就是右视图看到的节点。
线索二叉树
线索二叉树是通过改造二叉树的遍历过程,在空指针域中添加“线索”(即前驱或后继指针),以实现高效的遍历操作。目的是节省存储空间(避免递归栈)并加速前驱/后继查找。
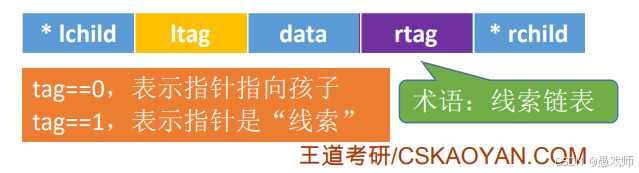
线索化是遍历算法的改造:在遍历过程中,用指针pre记录当前访问节点的前驱,并为空指针域添加线索(ltag和rtag标记,0表示孩子,1表示线索)。
1. 中序线索化
-
核心逻辑:基于中序遍历(左-根-右),在访问节点时,检查左/右孩子是否为空。若为空,则将其指针指向
pre(前驱)或后继。 -
算法步骤:
-
递归遍历左子树。
-
访问根节点:若左孩子为空,设置前驱线索(指向
pre);若pre的右孩子为空,设置后继线索(指向当前节点)。 -
递归遍历右子树。
-
易错点:遍历的最后一个节点右孩子必为空,需手动设置rtag=1。此外,pre需为引用类型(或全局变量),以确保跨递归共享。
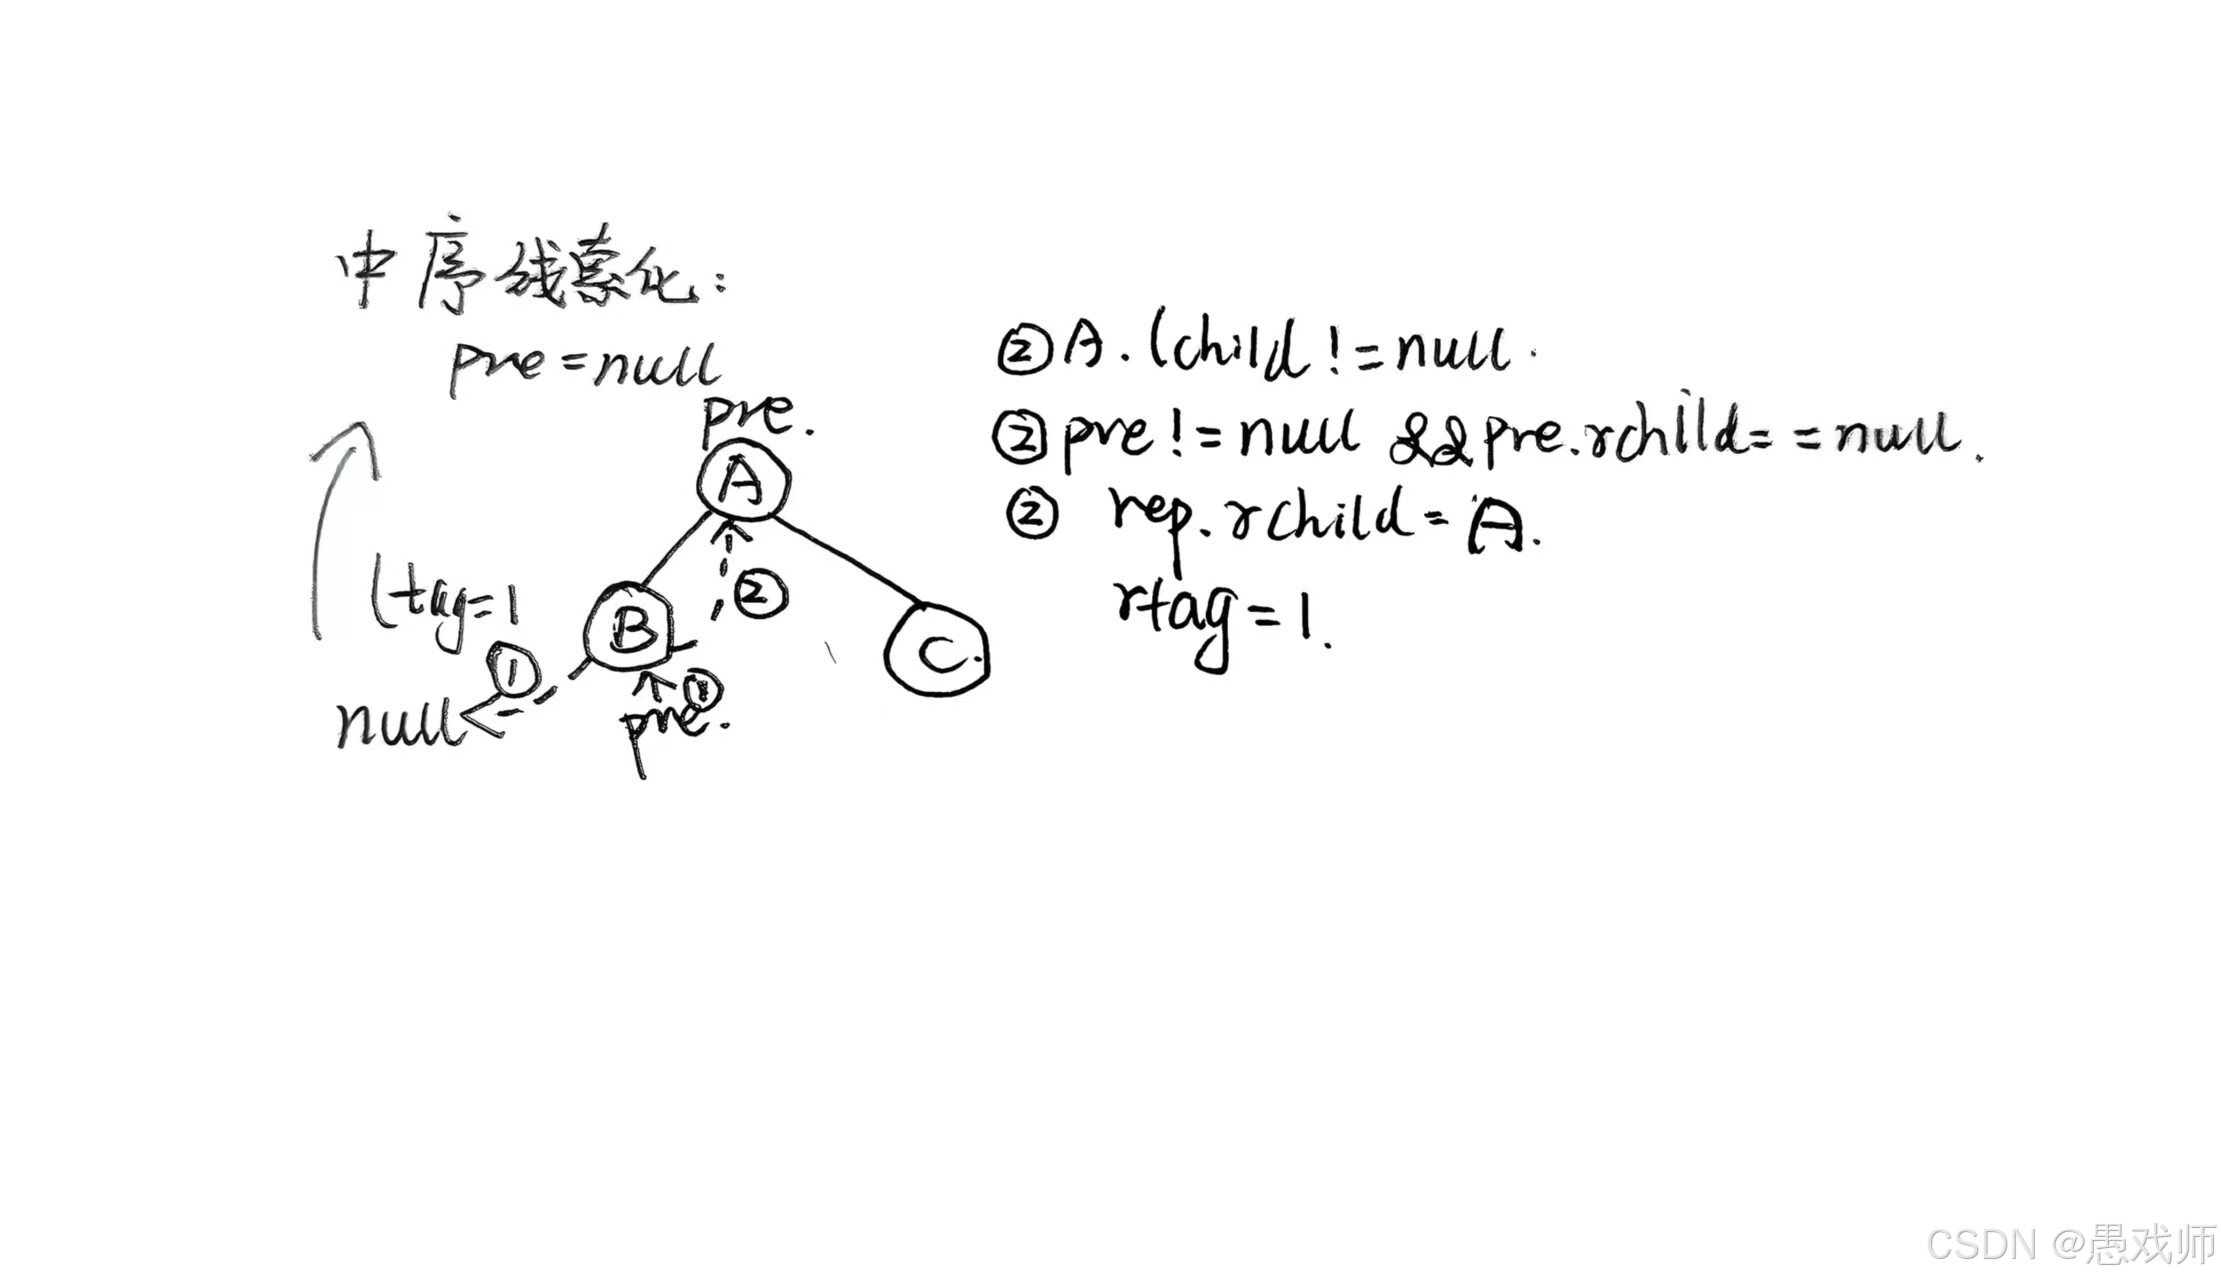
2. 先序线索化
核心逻辑:基于先序遍历(根-左-右)。在访问根节点时添加线索,但需处理左子树非空时,递归可能因线索导致死循环。
为什么先序线索化特有该问题?
遍历顺序差异:
先序:根→左→右(访问根时可能修改左指针)
中序/后序:递归左子树后才访问根(指针未修改)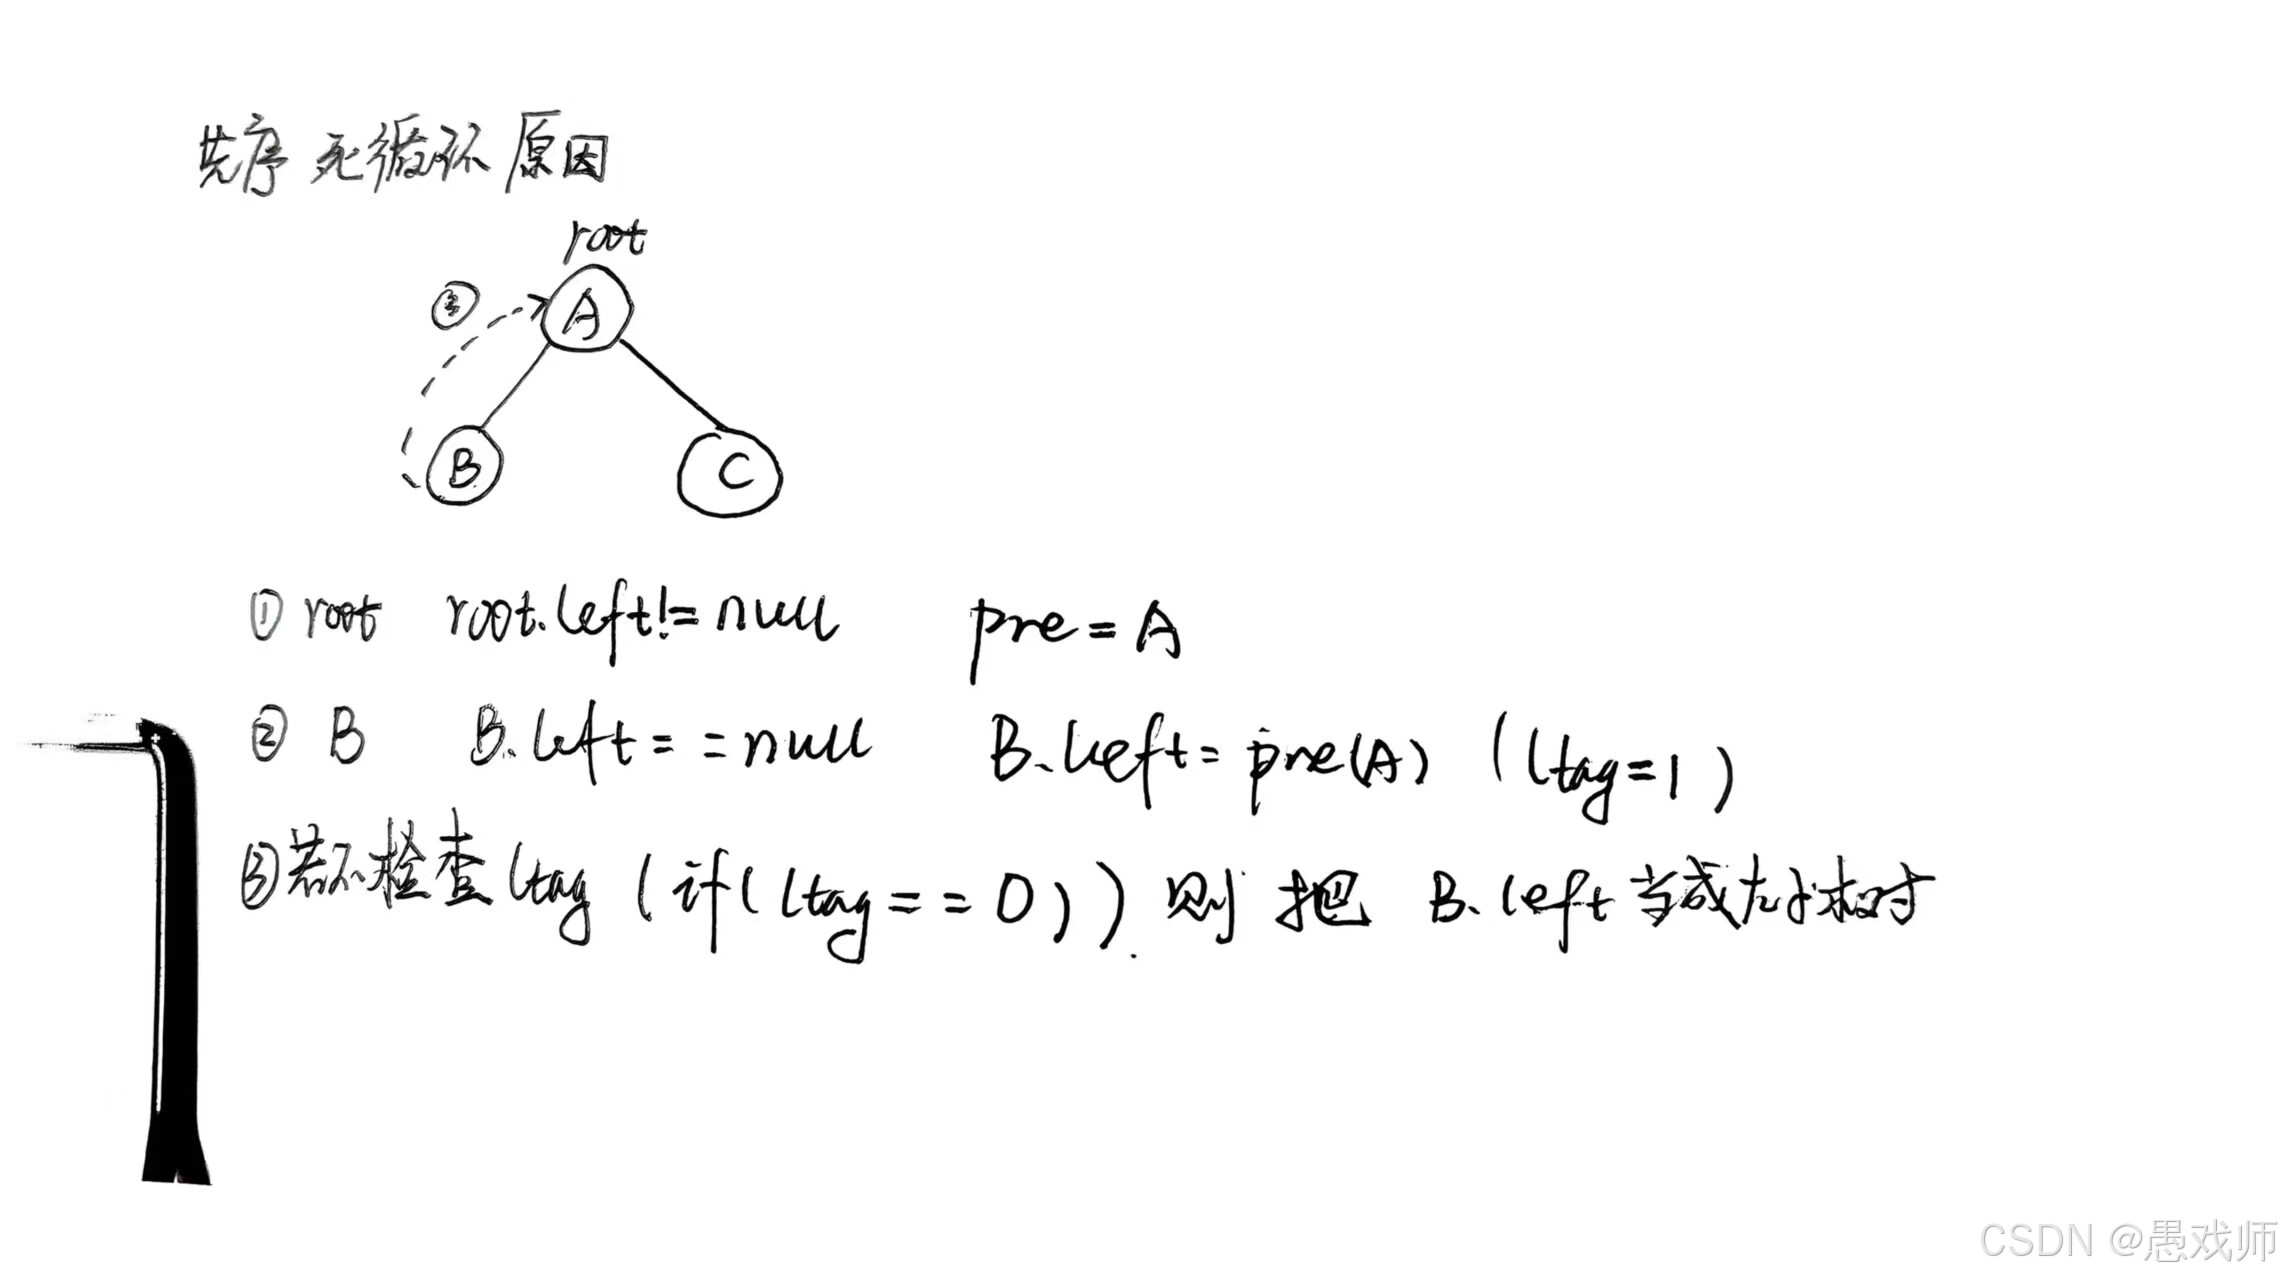
-
算法步骤:
-
访问根节点:若左孩子为空,设前驱线索;若
pre的右孩子为空,设后继线索。 -
仅当
ltag==0时(即左孩子非线索),递归左子树。 -
递归右子树。
-
3. 后序线索化
-
核心逻辑:基于后序遍历(左-右-根)。访问节点时添加线索,无递归陷阱问题。
-
算法步骤:
-
递归左子树。
-
递归右子树。
-
访问根节点:类似中序,设置前驱和后继线索。
-
-
易错点:最后一个节点右孩子为空,需设置
rtag=1。 -
核心要点:后序线索化适用于找前驱操作
线索化总结
-
共同点:所有线索化都改造遍历算法,使用
pre指针记录前驱,并添加ltag/rtag标记。 -
输出:中序线索化得中序线索二叉树,先序得先序线索二叉树,后序得后序线索二叉树。
-
高频考点:代码手算(尤其先序的递归检查)、最后一个节点的处理(
rtag设置)。
线索化代码实现
线索二叉树节点类定义
Java中使用类封装节点属性,通过枚举类型明确线索标记:
// 线索标记枚举(0:孩子节点,1:线索指针)
enum Tag { CHILD, THREAD }

class ThreadNode {
    int data;          // 节点数据
    ThreadNode lchild; // 左孩子/前驱
    ThreadNode rchild; // 右孩子/后继
    Tag ltag;          // 左标记
    Tag rtag;          // 右标记

    public ThreadNode(int data) {
        this.data = data;
        this.ltag = Tag.CHILD; // 初始化为孩子节点
        this.rtag = Tag.CHILD;
    }
}
中序线索化
class ThreadBinaryTree {
    private ThreadNode pre = null; // 全局前驱指针

    // 中序线索化入口
    public void inOrderThread(ThreadNode root) {
        if (root != null) {
            inThread(root);
            // 处理最后一个节点
            if (pre != null && pre.rchild == null) {
                pre.rtag = Tag.THREAD;
            }
        }
    }

    // 递归线索化
    private void inThread(ThreadNode node) {
        if (node == null) return;

        inThread(node.lchild); // 递归左子树
        visit(node);           // 访问当前节点
        inThread(node.rchild); // 递归右子树
    }

    // 访问节点并建立线索
    private void visit(ThreadNode node) {
        if (node.lchild == null) {
            node.lchild = pre;      // 左指针指向前驱
            node.ltag = Tag.THREAD;
        }
        if (pre != null && pre.rchild == null) {
            pre.rchild = node;      // 前驱的右指针指向当前
            pre.rtag = Tag.THREAD;
        }
        pre = node; // 更新前驱
    }
}
先序线索化(注意递归左子树的判断条件)
class ThreadBinaryTree {
    private ThreadNode pre = null; // 全局前驱指针

    // 中序线索化入口
    public void inOrderThread(ThreadNode root) {
        if (root != null) {
            inThread(root);
            // 处理最后一个节点(文档1强调的易错点)
            if (pre != null && pre.rchild == null) {
                pre.rtag = Tag.THREAD;
            }
        }
    }

    // 递归线索化
    private void inThread(ThreadNode node) {
        if (node == null) return;
        visit(node);           // 访问当前节点
        if(node.ltag==0)inThread(node.lchild); // 递归左子树
        inThread(node.rchild); // 递归右子树
    }

    // 访问节点并建立线索(文档1原始逻辑)
    private void visit(ThreadNode node) {
        if (node.lchild == null) {
            node.lchild = pre;      // 左指针指向前驱
            node.ltag = Tag.THREAD;
        }
        if (pre != null && pre.rchild == null) {
            pre.rchild = node;      // 前驱的右指针指向当前
            pre.rtag = Tag.THREAD;
        }
        pre = node; // 更新前驱
    }
}
3. 后序线索化
class ThreadBinaryTree {
    private ThreadNode pre = null; // 全局前驱指针

    // 中序线索化入口
    public void inOrderThread(ThreadNode root) {
        if (root != null) {
            inThread(root);
            // 处理最后一个节点
            if (pre != null && pre.rchild == null) {
                pre.rtag = Tag.THREAD;
            }
        }
    }

    // 递归线索化
    private void inThread(ThreadNode node) {
        if (node == null) return;

        inThread(node.lchild); // 递归左子树
        inThread(node.rchild); // 递归右子树
        visit(node);           // 访问当前节点
    }

    // 访问节点并建立线索
    private void visit(ThreadNode node) {
        if (node.lchild == null) {
            node.lchild = pre;      // 左指针指向前驱
            node.ltag = Tag.THREAD;
        }
        if (pre != null && pre.rchild == null) {
            pre.rchild = node;      // 前驱的右指针指向当前
            pre.rtag = Tag.THREAD;
        }
        pre = node; // 更新前驱
    }
}
前驱/后继查找算法
中序找前驱和后继(重点)
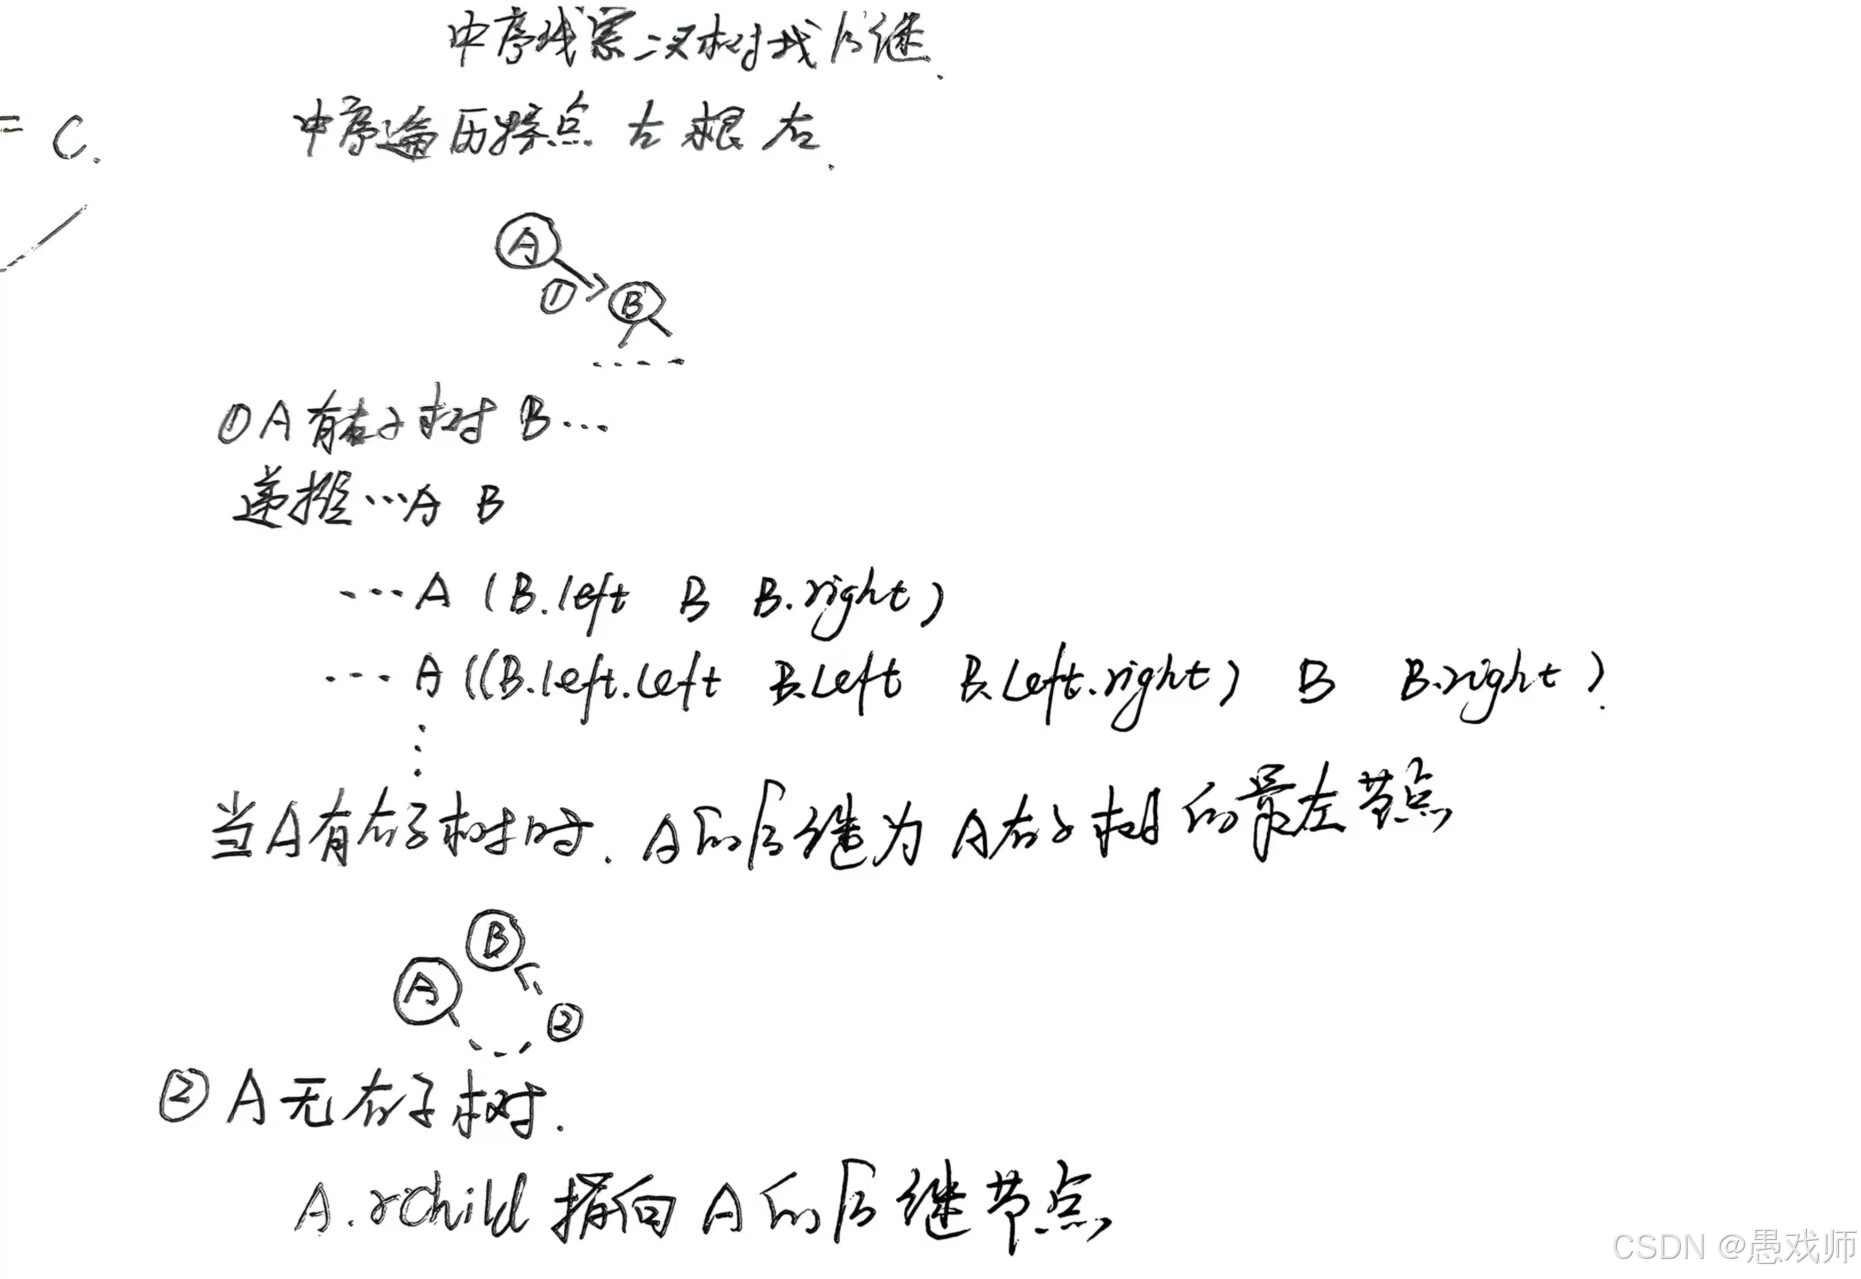
class ThreadNode {
    int data;
    ThreadNode left;
    ThreadNode right;
    int ltag; // 0: 左孩子, 1: 前驱线索
    int rtag; // 0: 右孩子, 1: 后继线索

    public ThreadNode(int data) {
        this.data = data;
        this.left = null;
        this.right = null;
        this.ltag = 0;
        this.rtag = 0;
    }
}

public class ThreadedBinaryTree {
    private ThreadNode pre = null; // 全局变量,指向当前访问节点的前驱

    // 中序线索化二叉树
    public void inThread(ThreadNode node) {
        if (node == null) return;

        // 线索化左子树
        inThread(node.left);

        // 处理当前节点的前驱线索
        if (node.left == null) {
            node.left = pre;
            node.ltag = 1;
        }

        // 处理前驱节点的后继线索
        if (pre != null && pre.right == null) {
            pre.right = node;
            pre.rtag = 1;
        }

        pre = node; // 更新前驱节点

        // 线索化右子树
        inThread(node.right);
    }

    // 找到子树中第一个被中序遍历的节点
    public ThreadNode firstNode(ThreadNode node) {
        if (node == null) return null;
        while (node.ltag == 0) {
            node = node.left;
        }
        return node;
    }

    // 找到节点的中序后继
    public ThreadNode nextNode(ThreadNode node) {
        if (node.rtag == 1) {
            return node.right; // 直接返回后继线索
        }
        return firstNode(node.right); // 返回右子树的最左下节点
    }

    // 非递归中序遍历(利用线索)
    public void inOrderTraversal(ThreadNode root) {
        for (ThreadNode node = firstNode(root); node != null; node = nextNode(node)) {
            System.out.print(node.data + " ");
        }
    }

    public static void main(String[] args) {
        // 构建示例二叉树
        //       1
        //     /   \
        //    2     3
        //   / \   /
        //  4   5 6
        ThreadNode root = new ThreadNode(1);
        root.left = new ThreadNode(2);
        root.right = new ThreadNode(3);
        root.left.left = new ThreadNode(4);
        root.left.right = new ThreadNode(5);
        root.right.left = new ThreadNode(6);

        // 线索化二叉树
        ThreadedBinaryTree tree = new ThreadedBinaryTree();
        tree.inThread(root);

        // 测试查找中序后继
        System.out.println("4的后继: " + tree.nextNode(root.left.left).data); // 4→2
        System.out.println("2的后继: " + tree.nextNode(root.left).data);      // 2→5
        System.out.println("5的后继: " + tree.nextNode(root.left.right).data); // 5→1

        // 非递归中序遍历
        System.out.print("中序遍历: ");
        tree.inOrderTraversal(root); // 4 2 5 1 6 3
    }
}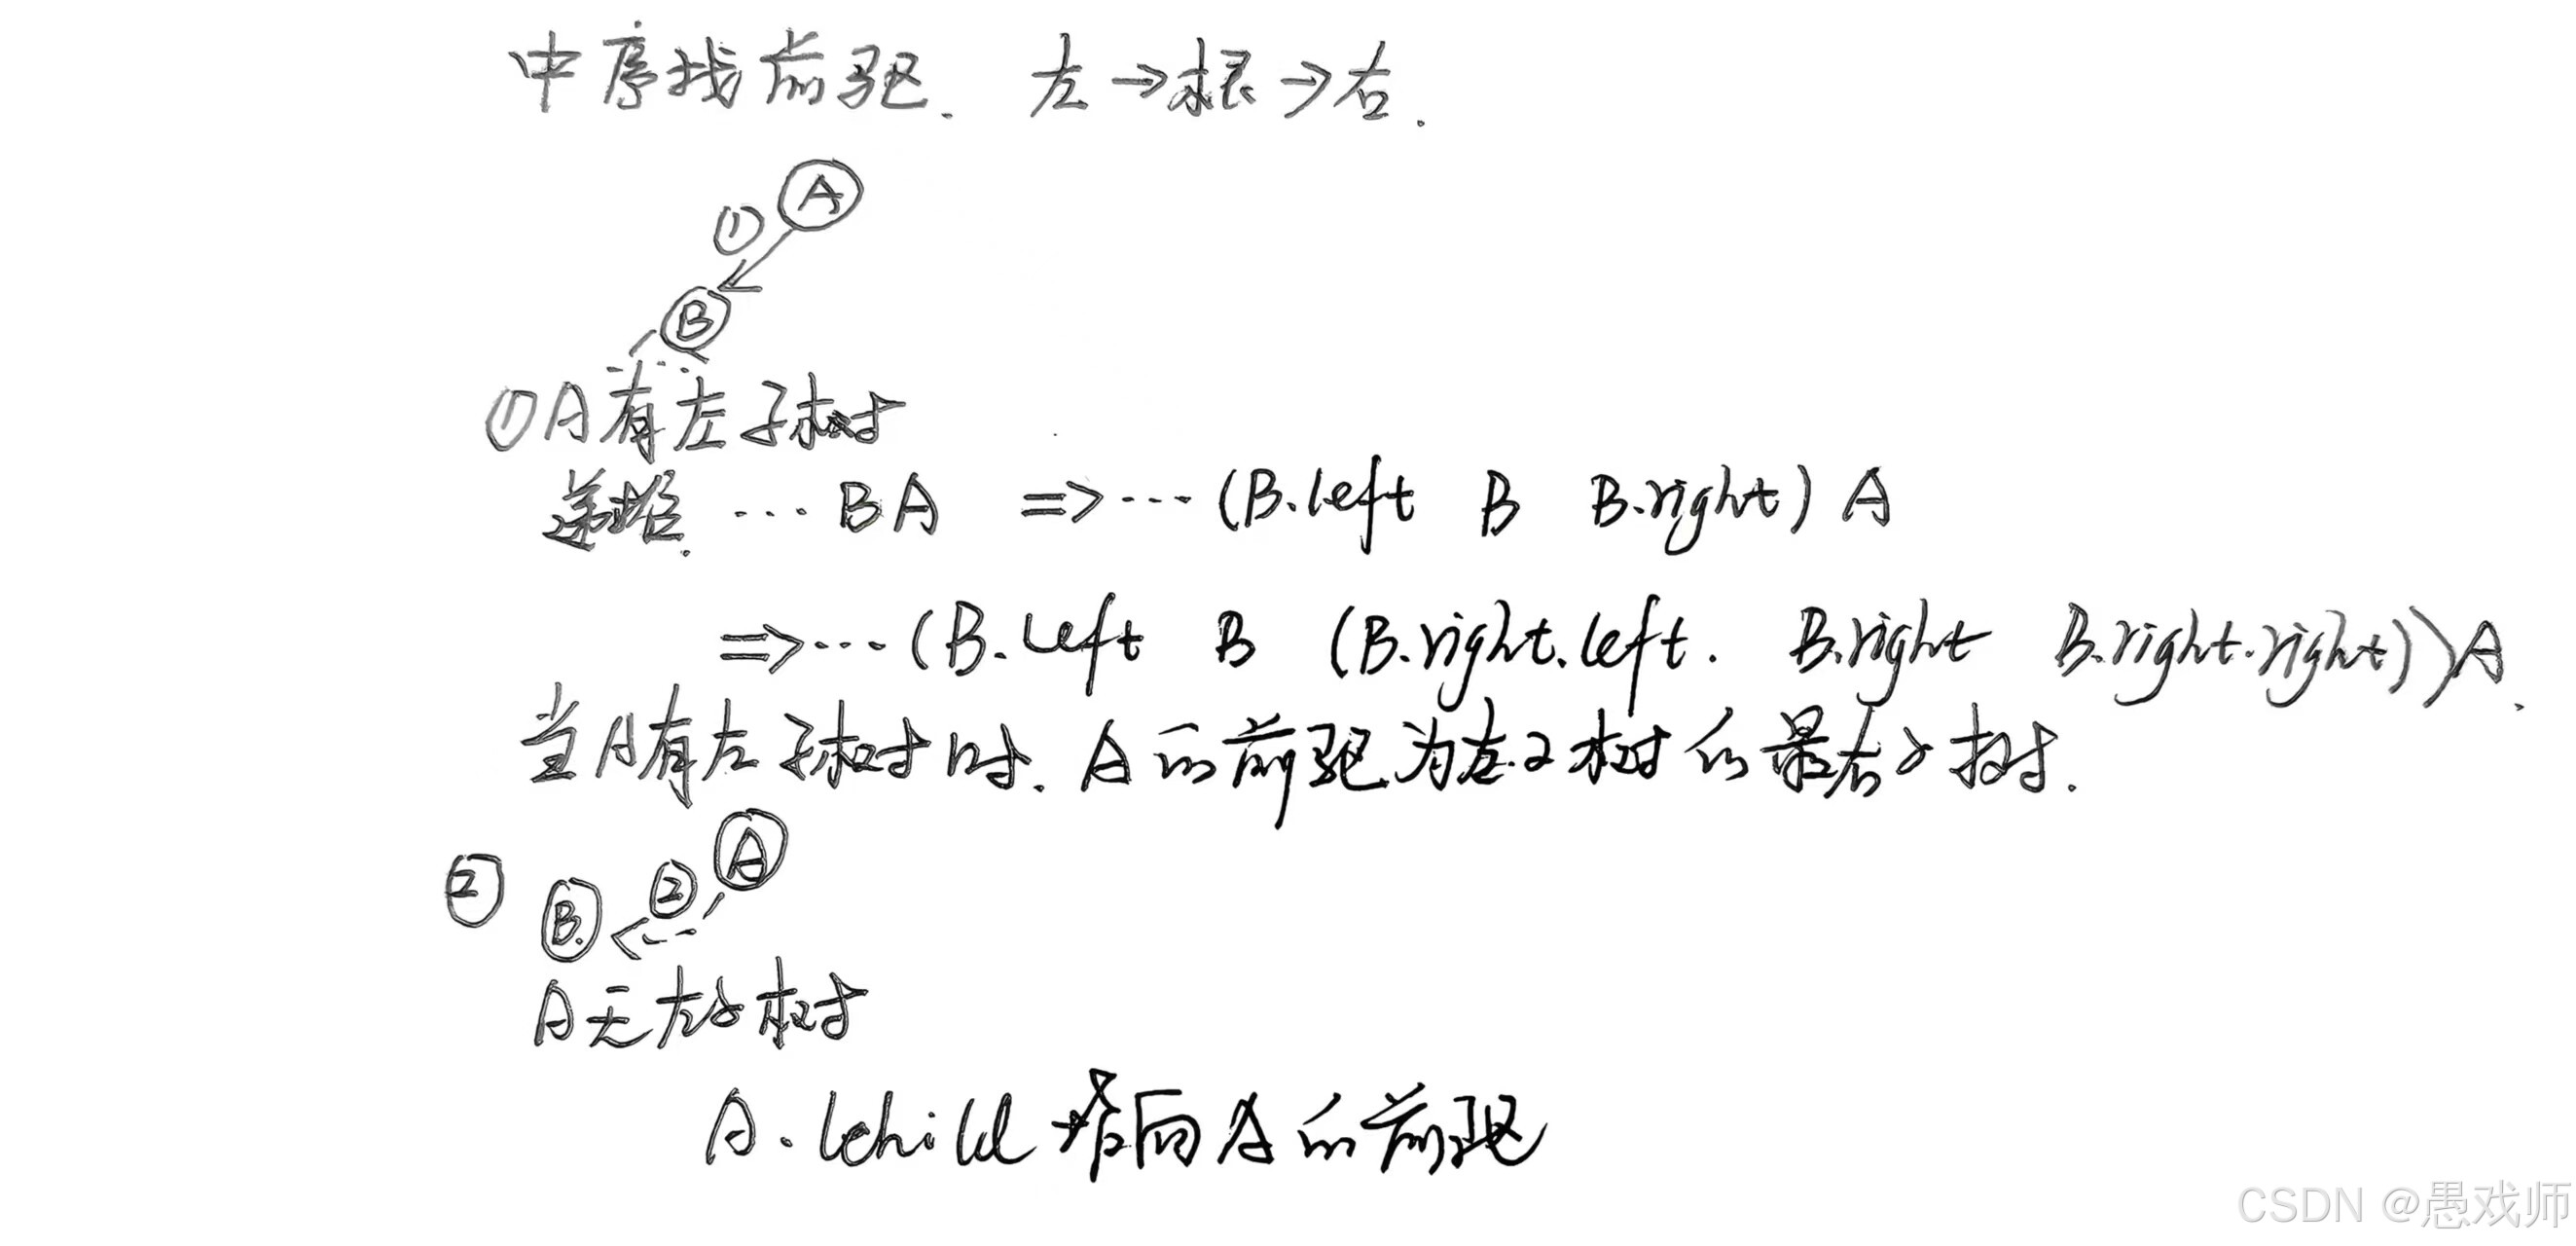
先序找前驱和后继(后序思考方式与先序类似)
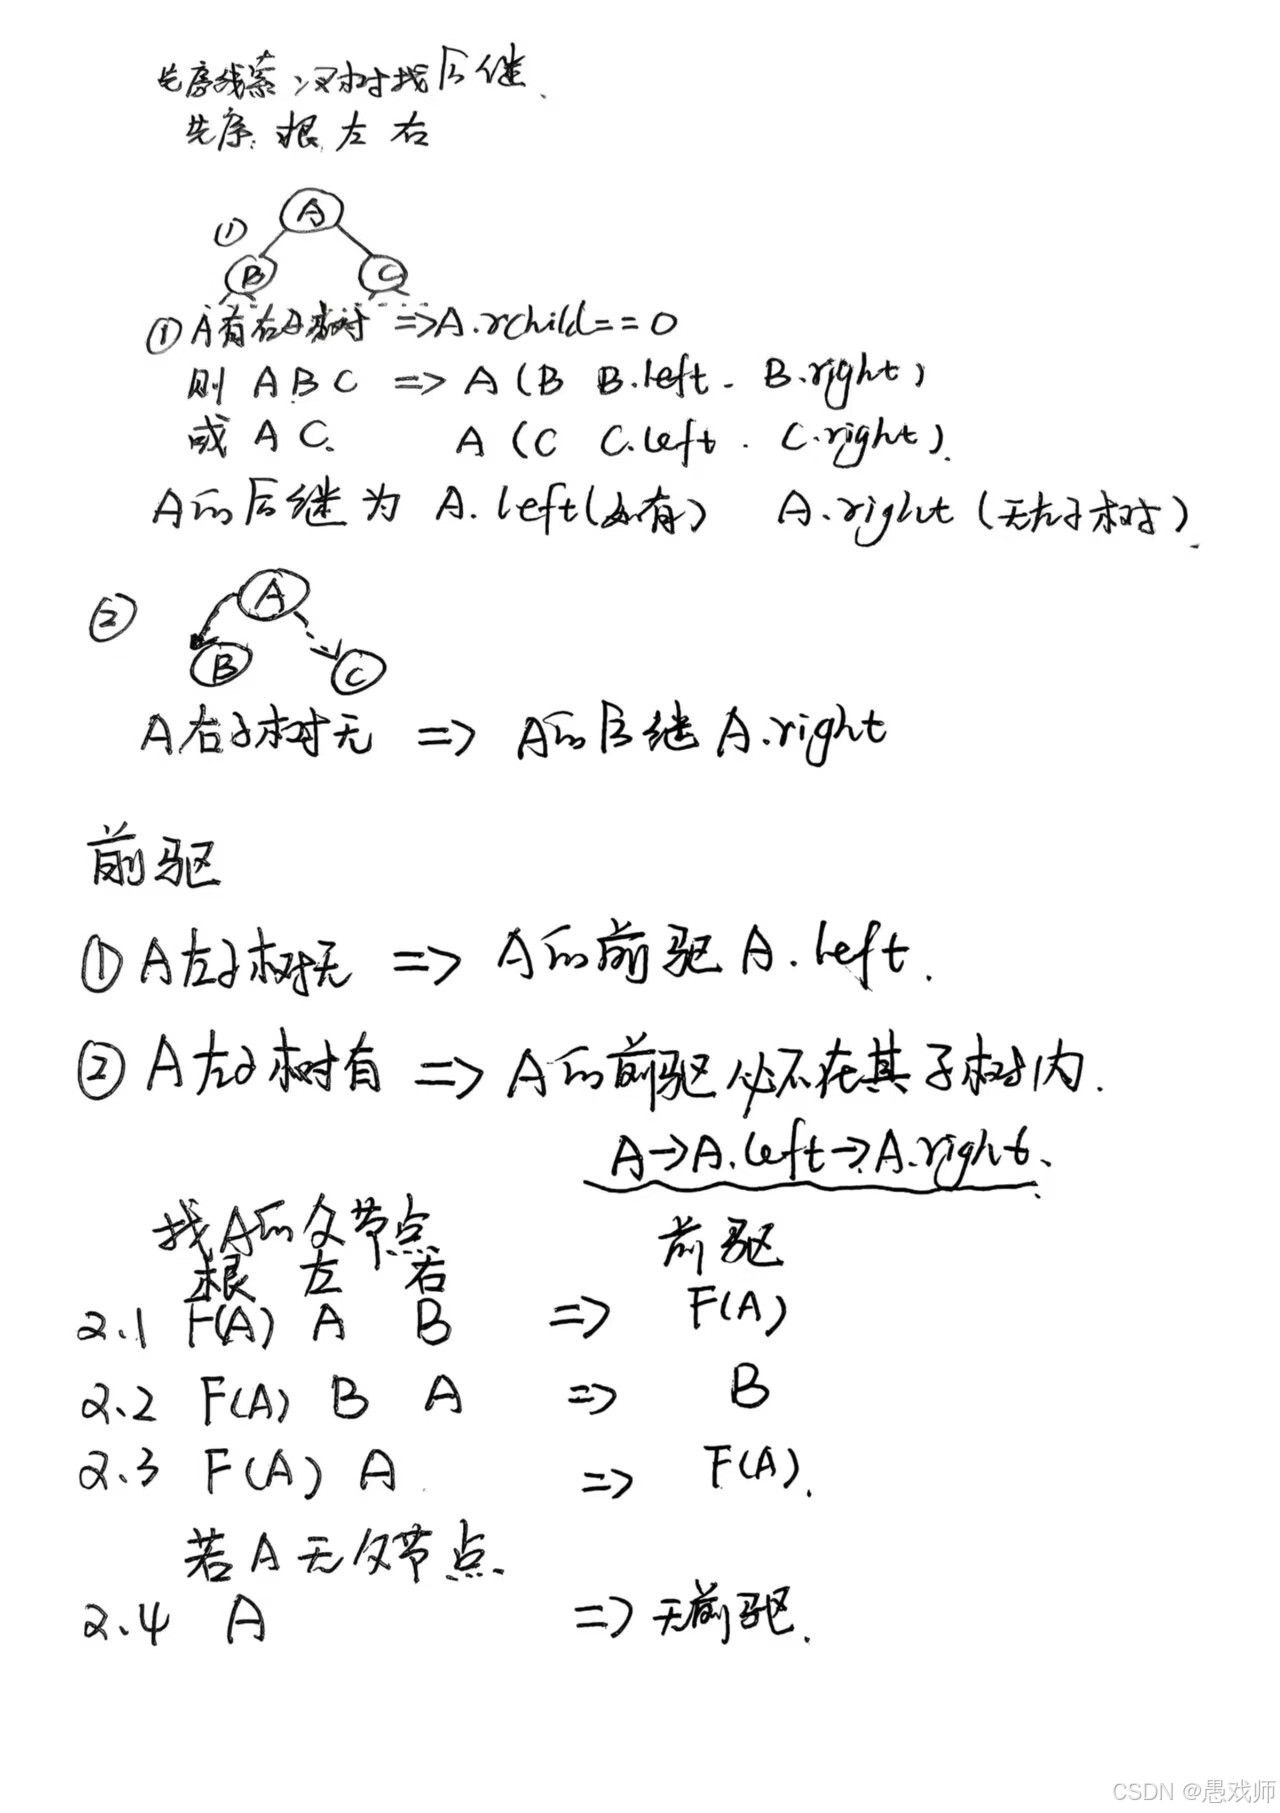
树与森林的存储
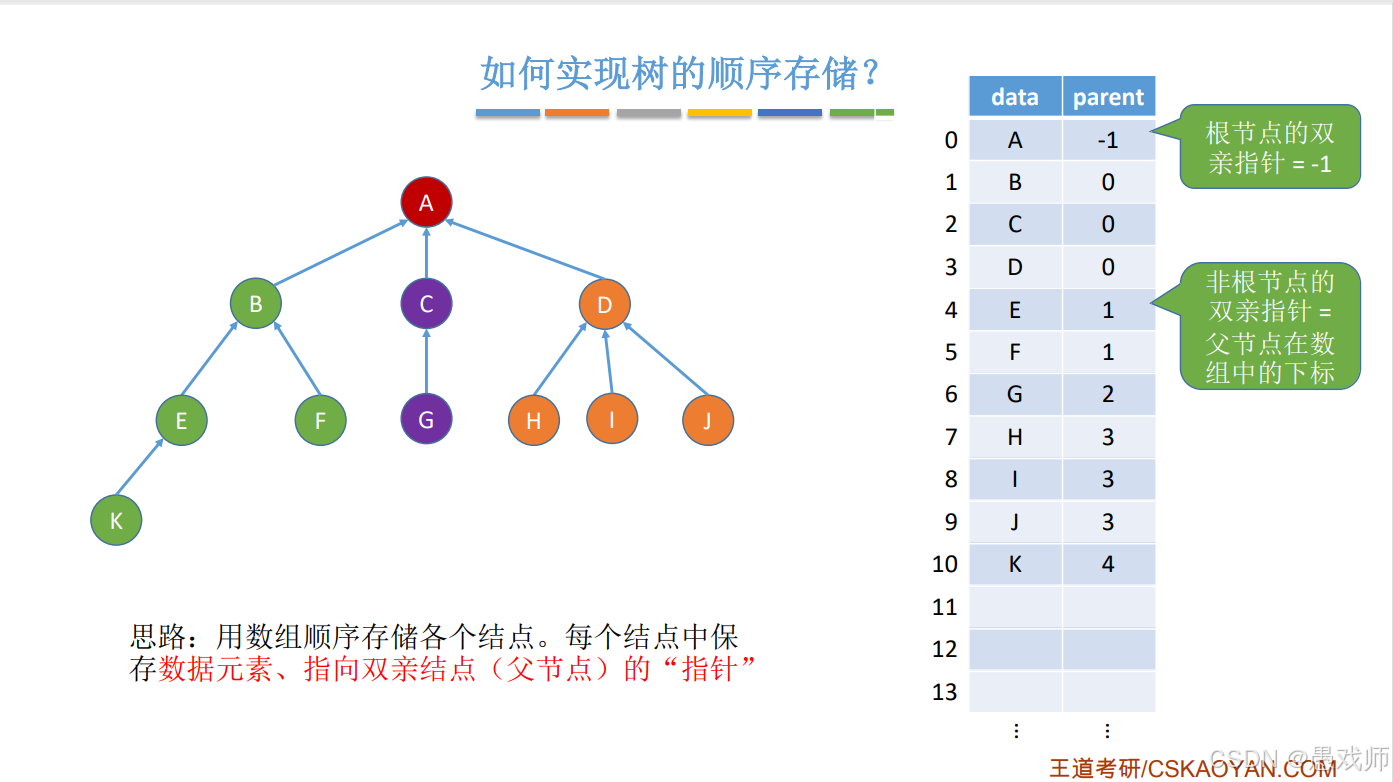
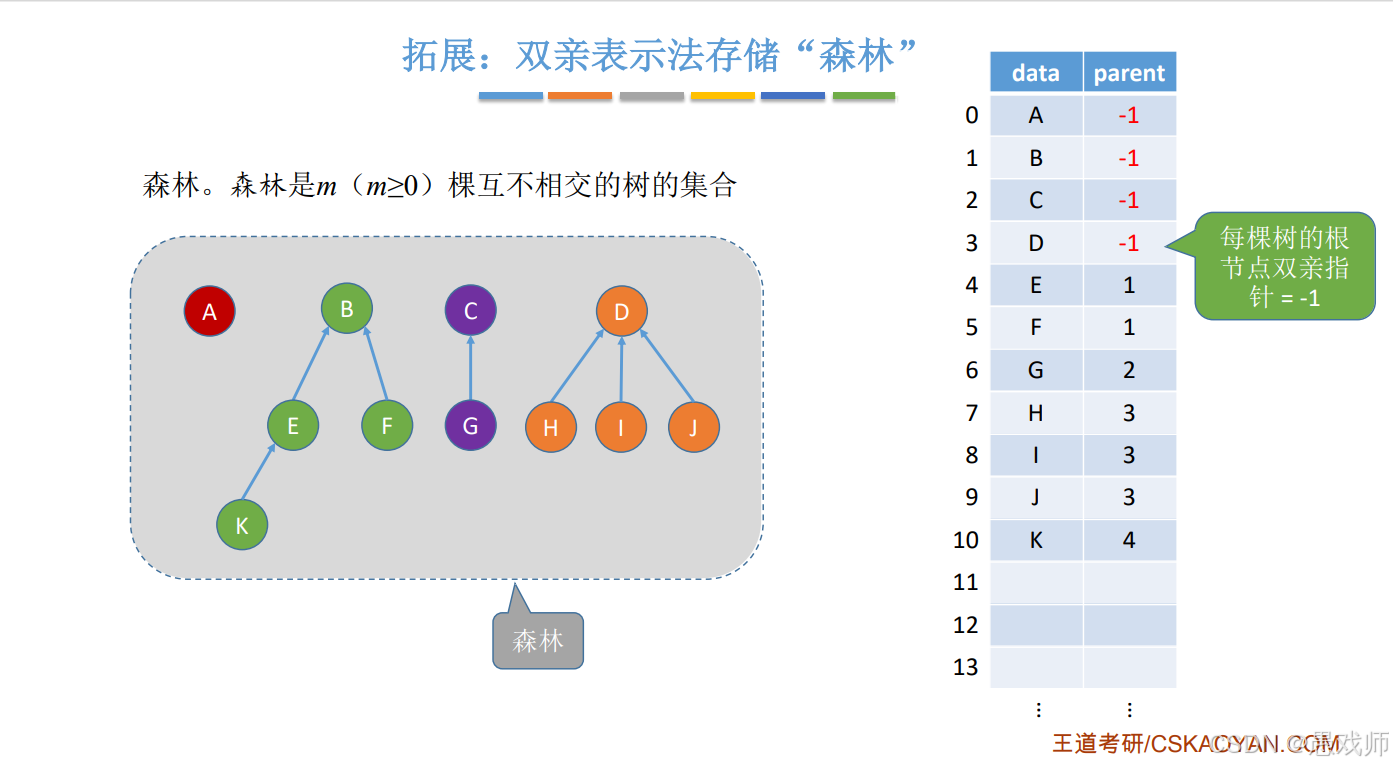
双亲表示法 优点:找双亲(父节点)很方便 缺点:找孩子不方便,只能从头到尾遍历整个数组
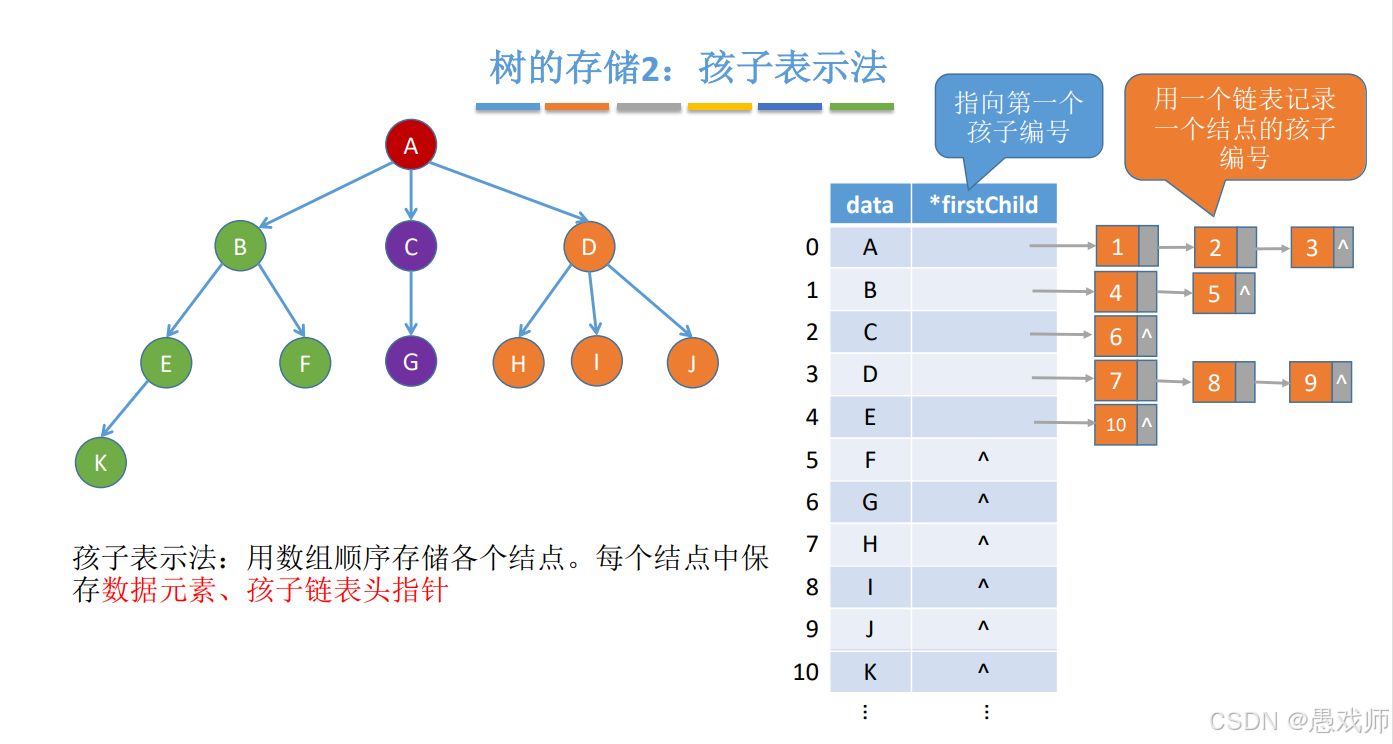
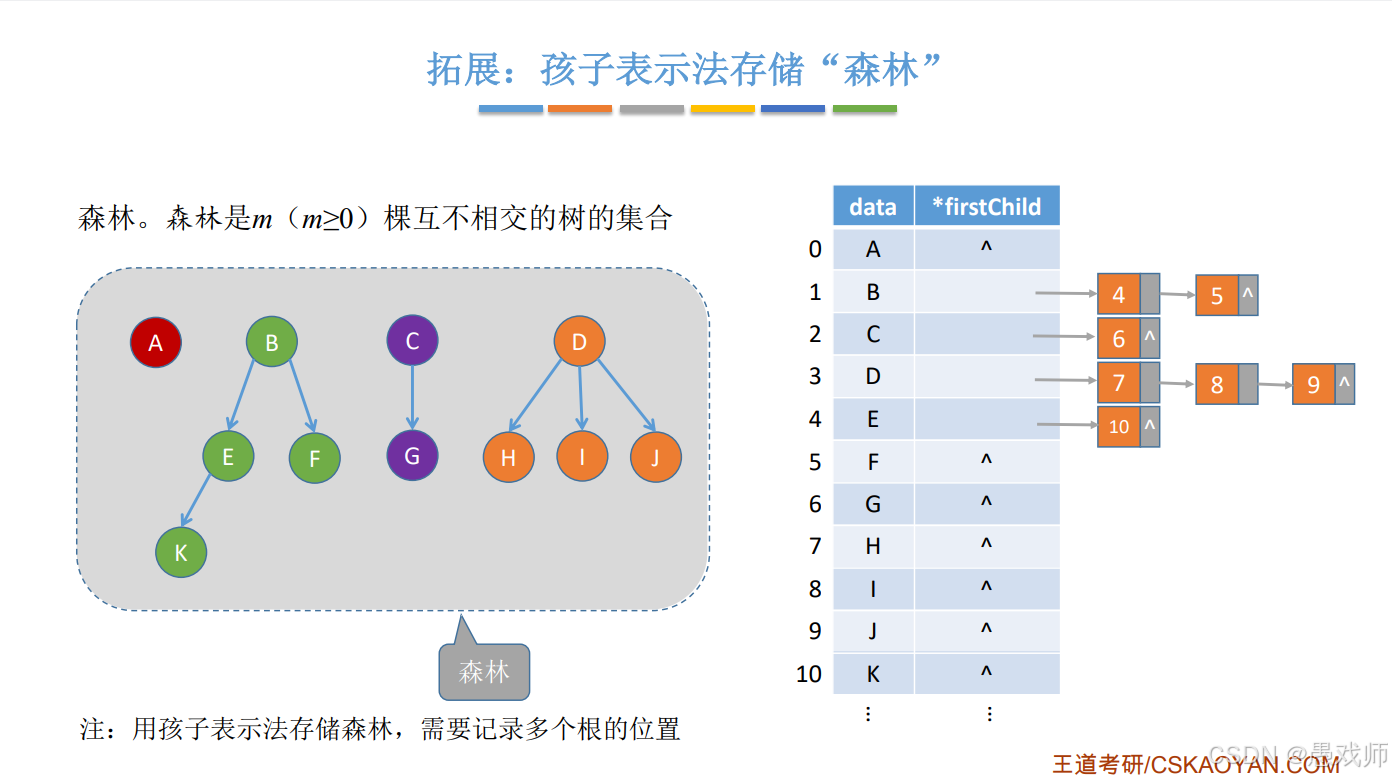
孩子表示法 优点:找孩子很方便 缺点:找双亲(父节点)不方便,只能遍历每个链表
树、森林与二叉树的转换(实现统一处理)
转换规则
树→二叉树:孩子兄弟表示法(第一个孩子为左子树,兄弟为右子树)。
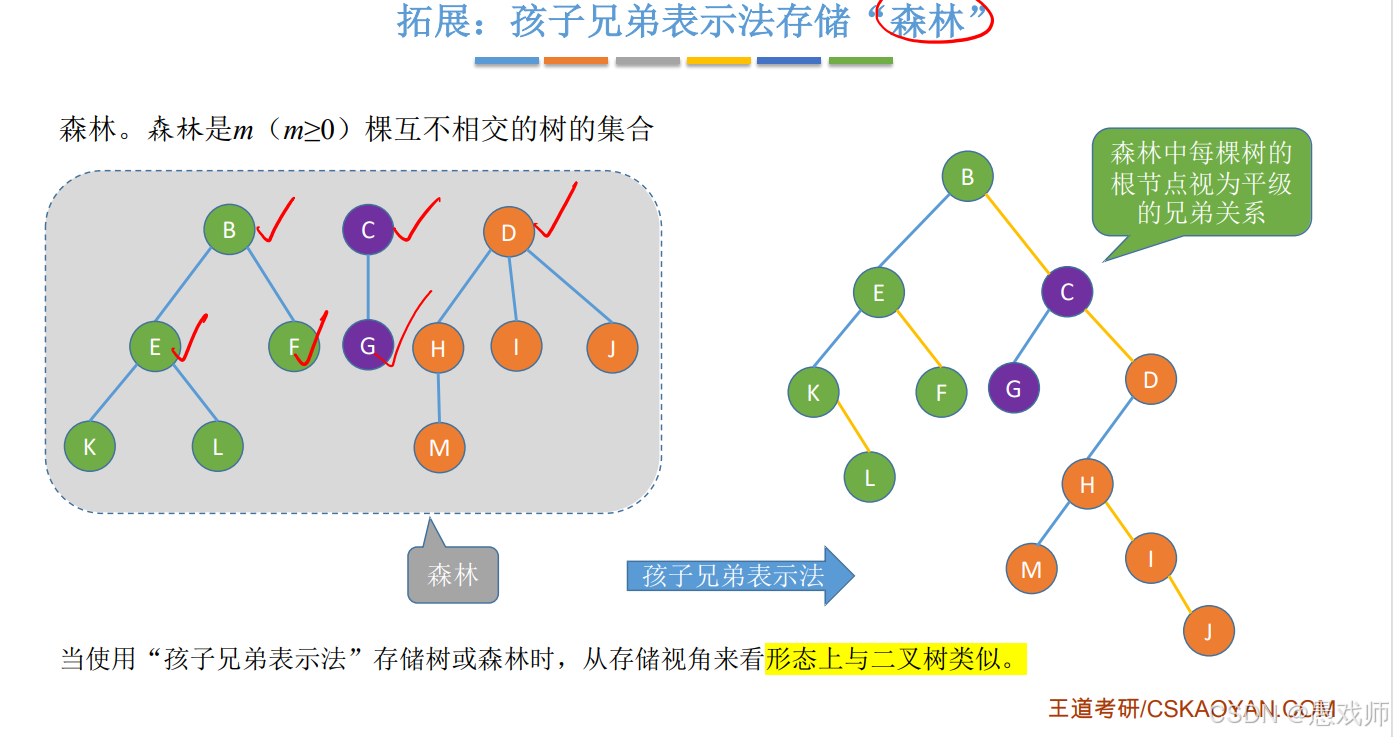
森林→二叉树:各树根视为兄弟,按树→二叉树规则转换。
二叉树→树 / 森林:左子树为孩子,右子树为兄弟(根无右子树则为树,有则为森林)。
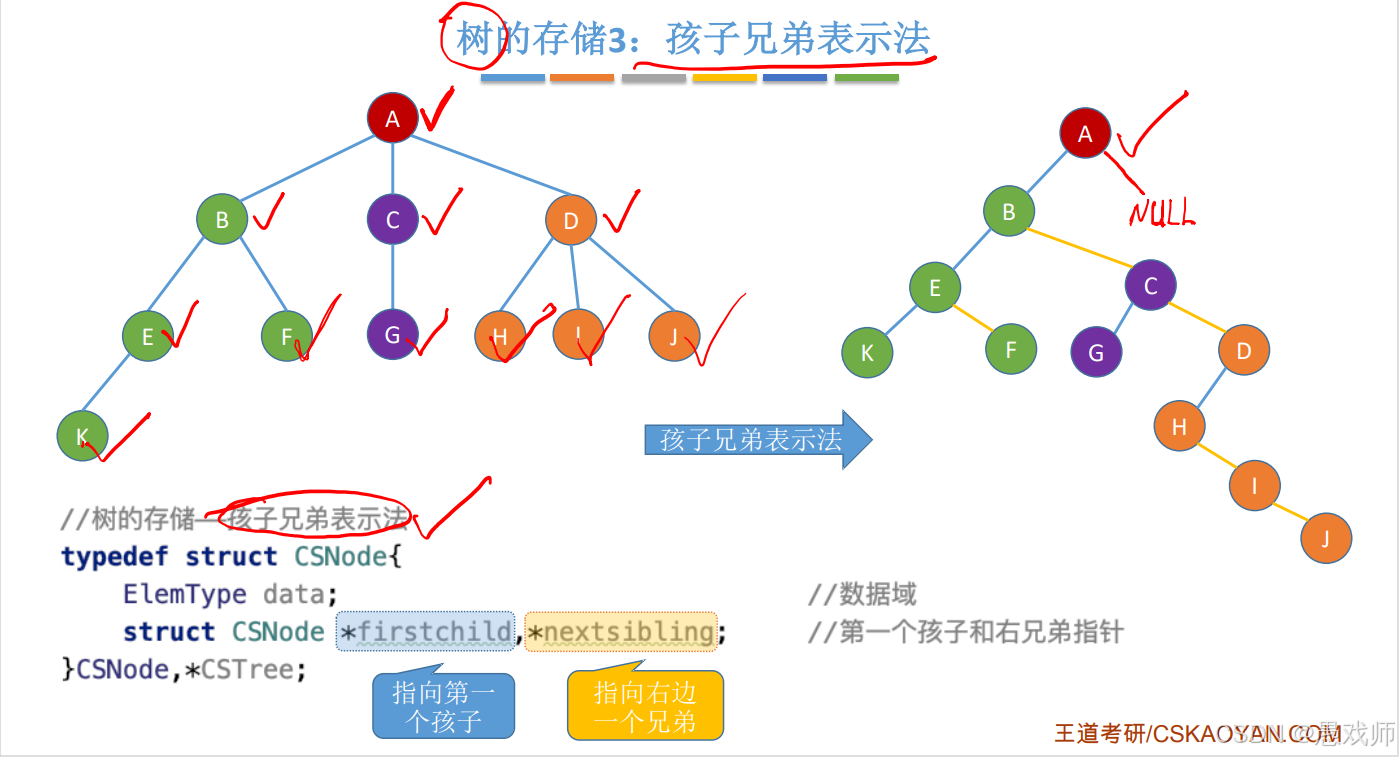
遍历关系
树的先根遍历 = 对应二叉树的先序遍历;树的后根遍历 = 对应二叉树的中序遍历。
森林的先序遍历 = 对应二叉树的先序遍历;森林的中序遍历 = 对应二叉树的中序遍历。
哈夫曼树与哈夫曼编码
哈夫曼树(最优二叉树)
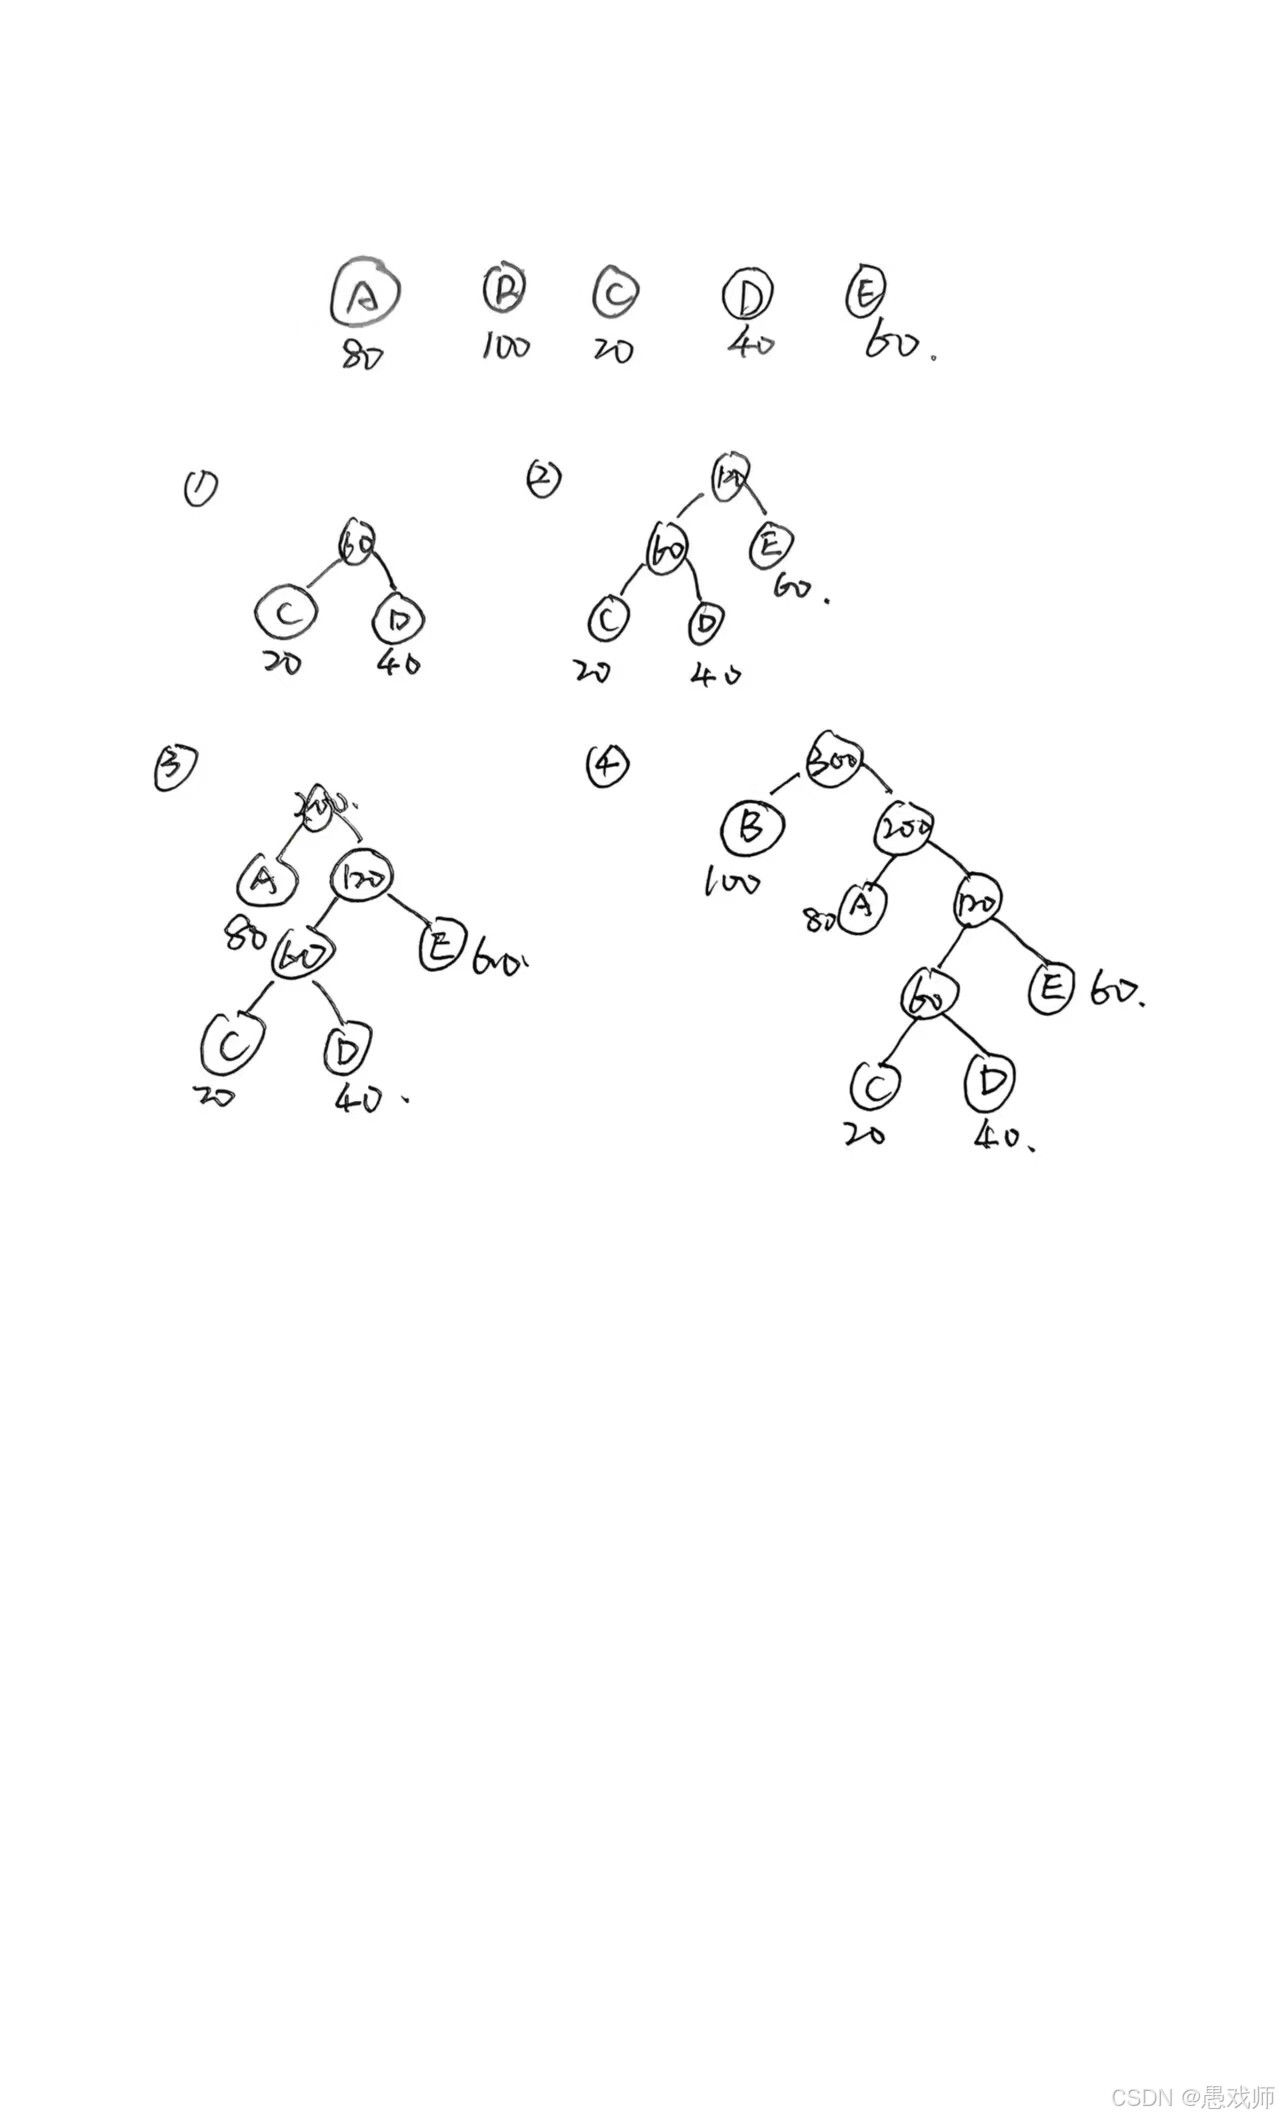
定义:含n个带权叶结点的二叉树中,带权路径长度(WPL,所有叶结点权值 × 路径长度之和)最小的树。
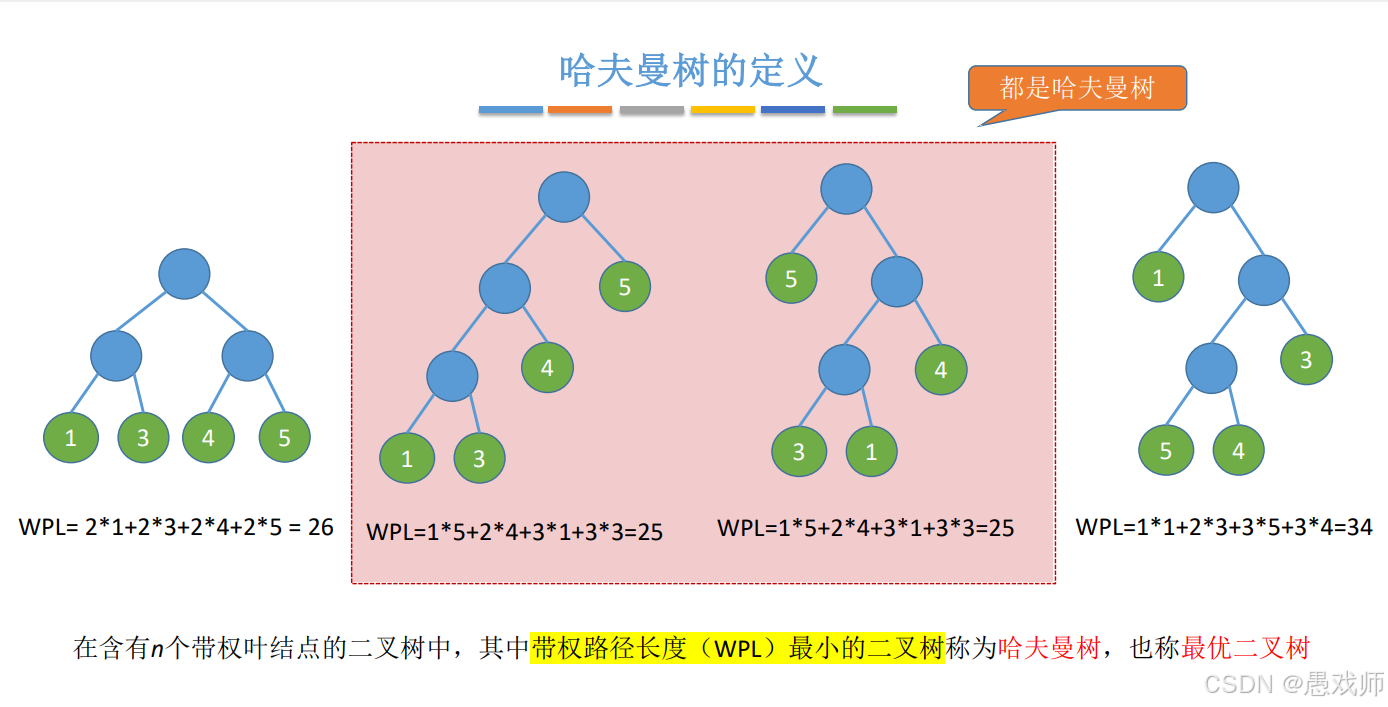
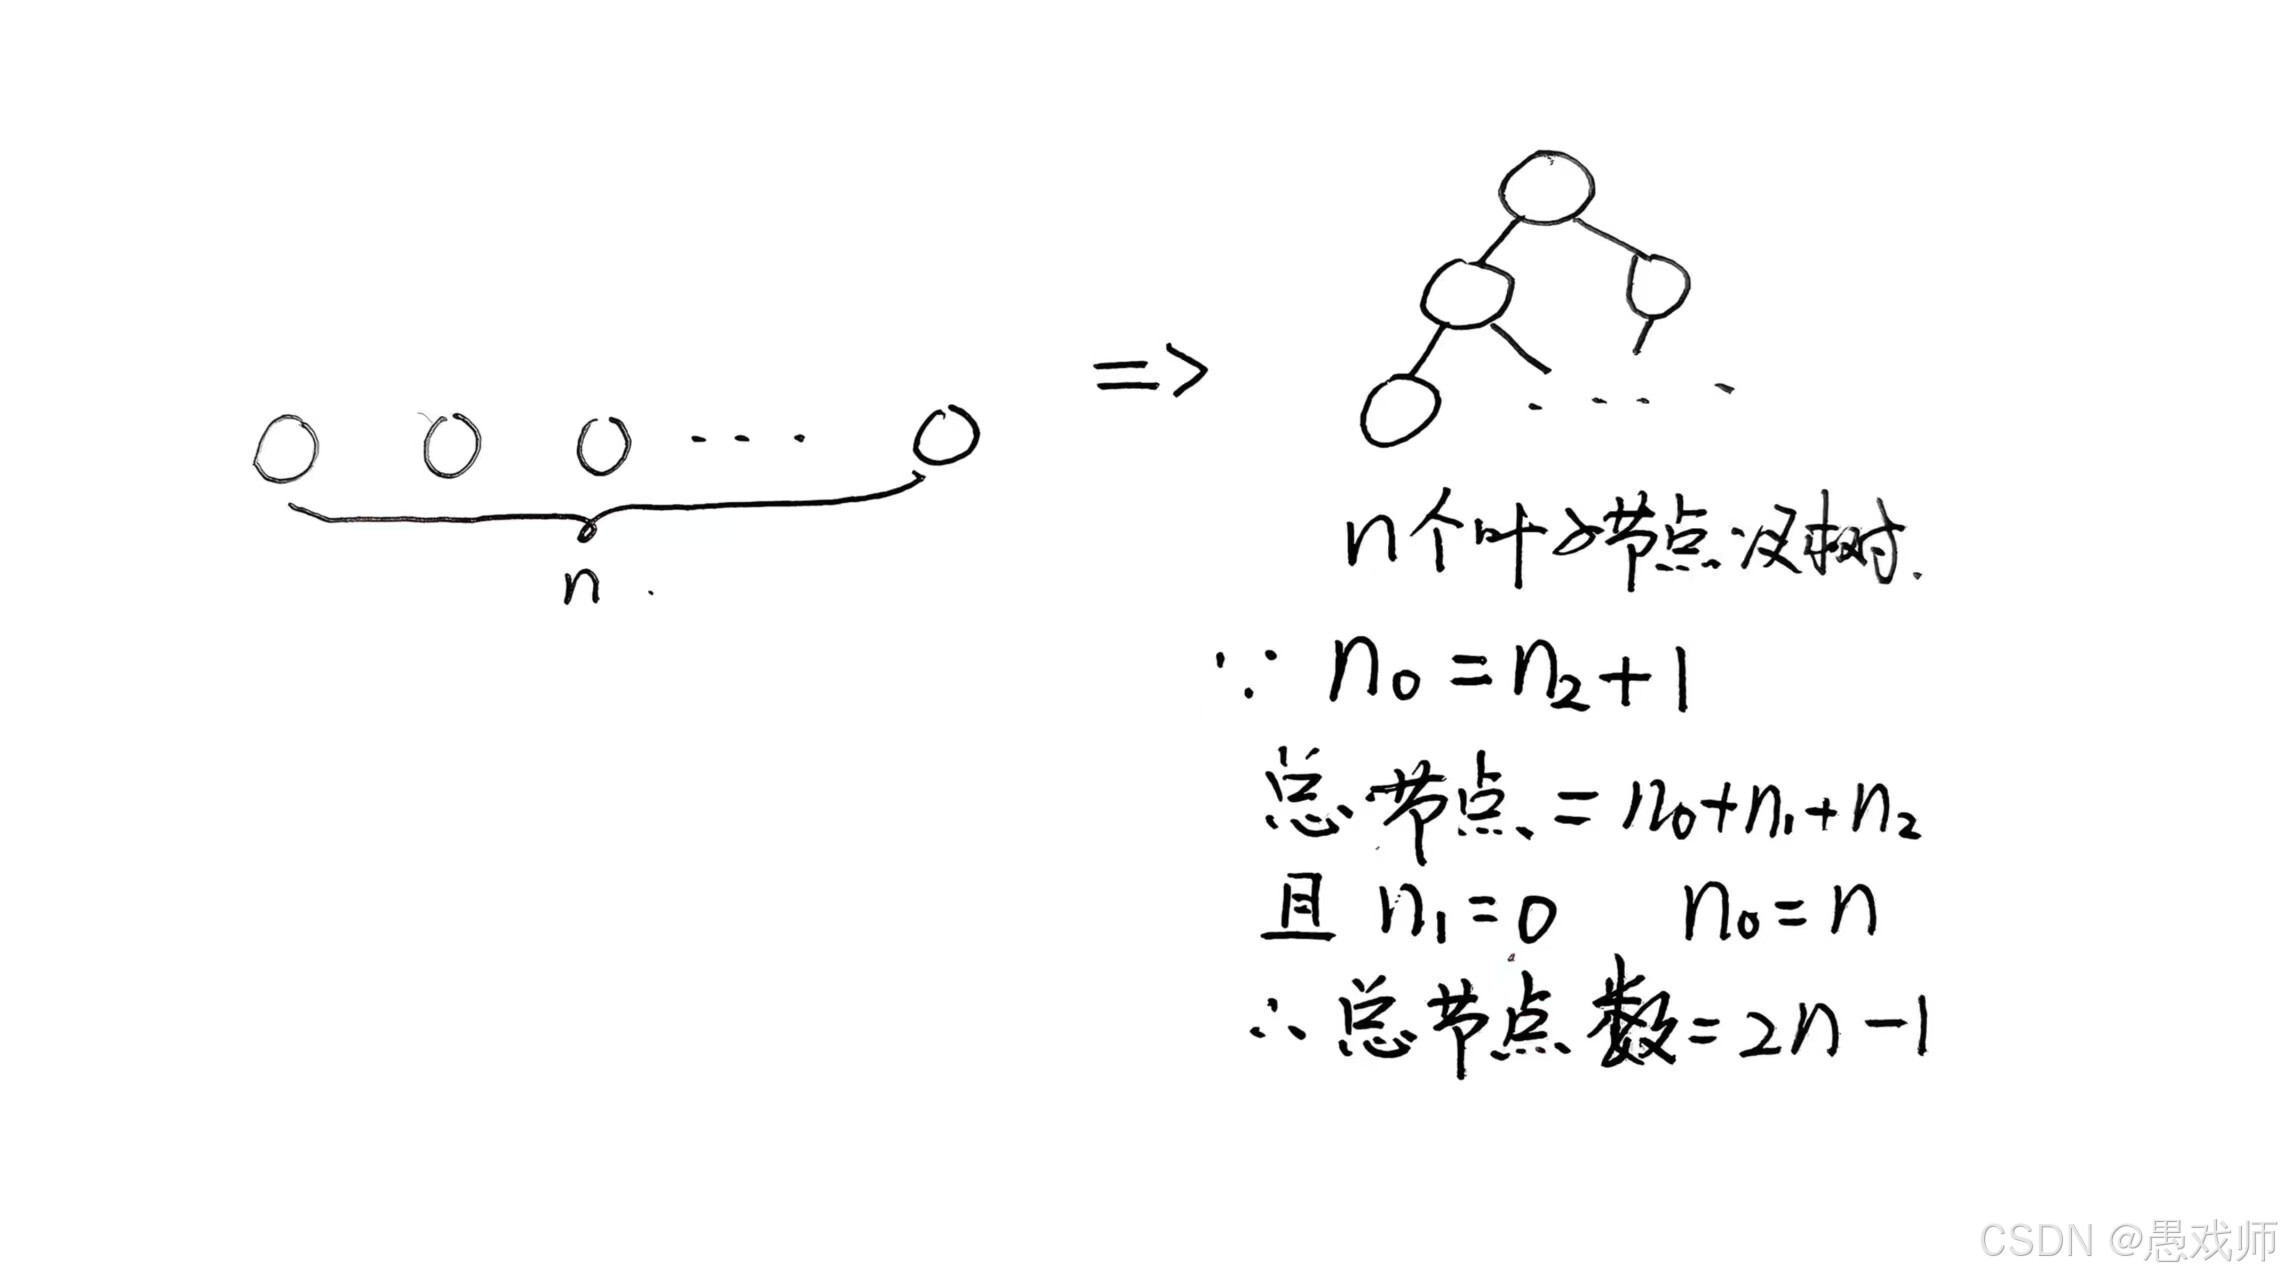
构造:选 2 个最小权值结点合并为新结点(权值为两者之和),重复至只剩一棵树;结点总数,无度为 1 的结点。
哈夫曼编码
前缀编码(无编码是另一编码的前缀,简单说就是任意两个前缀间互斥),通过哈夫曼树生成:左分支为 0,右分支为 1,叶结点编码为路径序列。
并查集(集合的实现)
逻辑结构
用互不相交的树(森林) 表示多个集合,每棵树对应一个子集。
根节点 代表整个集合,通过判断根节点是否相同来确定元素是否同属一个集合。
存储结构
双亲表示法:使用数组 S[] 存储:
非根节点:S[x] 存储父节点的下标。
根节点:S[root] = -集合大小(优化后)或 -1(基础版)。
基本操作
初始化 Initial
void Initial(int S[]) {
    for (int i = 0; i < SIZE; i++)
        S[i] = -1;  // 每个元素独立成集合(根节点)
}
查找 Find
基础版:不断向上追溯父节点,直到根节点(S[x] < 0)。
int Find(int S[], int x) {
    while (S[x] >= 0) x = S[x]; // 向上查找
    return x; // 返回根节点下标
}时间复杂度:最坏情况树退化为链,O(n)。
合并 Union
基础版:将 Root2 的根节点指向 Root1。
void Union(int S[], int Root1, int Root2) {
    if (Root1 == Root2) return;
    S[Root2] = Root1; // 直接合并
}
优化策略
Union 优化(按规模合并)
原理:小树合并到大树,避免树过高。
实现:
根节点 S[root] = -集合大小(负数绝对值表示节点总数)。
合并时比较集合大小,小树挂到大树下。
void Union(int S[], int Root1, int Root2) {
    if (Root1 == Root2) return;
    if (S[Root2] > S[Root1]) { // Root2 更小(负数比较)
        S[Root1] += S[Root2];  // 更新集合大小
        S[Root2] = Root1;      // 小树挂到大树
    } else {
        S[Root2] += S[Root1];
        S[Root1] = Root2;
    }
}效果:树高控制在 O(log n),Find 操作优化至 O(log n)。
Find 优化(路径压缩)
原理:在 Find 过程中将路径上的节点直接挂到根节点,大幅降低后续查询成本。
实现:
int Find(int S[], int x) {
    int root = x;
    while (S[root] >= 0) root = S[root]; // 先找到根
    while (x != root) {                  // 压缩路径
        int t = S[x];                    // 暂存父节点
        S[x] = root;                     // 当前节点挂到根
        x = t;                           // 处理父节点
    }
    return root;
}效果:配合按规模合并,均摊时间复杂度接近 O(α(n))(极低的增长函数,α(n) ≤ 4 对常见 n 有效)。
| 操作 | 基础版 | 优化后(Union + Find) |
|---|---|---|
|
|
|
|
|
|
|
|
| n 次合并 |
|
|
核心思想
物理存储:用数组模拟树结构,通过父指针维护集合关系。
高效关键:
- 按规模合并:避免树退化为链。
- 路径压缩:扁平化树结构,加速后续查询。
适用场景:动态连通性问题(如网络连接、图连通分量)。
可视化工具:Disjoint Sets Visualization 可动态演示优化效果,两种优化的按钮不要同时勾选,会运行错误看不到优化效果。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献5条内容

所有评论(0)