【数据库】Apache Paimon数据湖查询引擎StarRocks
StarRocks 是一款专为在线分析处理(OLAP)场景设计的高性能、开源分布式 SQL 数据库。它基于 MPP(大规模并行处理)架构,融合了多种现代数据库技术的优势,致力于提供卓越的查询性能和高并发处理能力。
StarRocks 不仅支持从多种实时和离线数据源高效导入数据,还能够直接分析数据湖中各种格式的数据。其兼容 MySQL 协议,用户可以通过 MySQL 客户端和常用 BI 工具轻松连接。此外,StarRocks 具备水平扩展、高可用性、高可靠性和易于运维等特性,广泛应用于实时数据仓库、OLAP 报表生成和数据湖分析等场景。
StarRocks 的架构设计简洁高效,整个系统仅由前端(FE)和后端(BE 或 CN)两种组件构成。前端节点负责协调和管理,而后端节点则根据存储模式的不同分为 BE(本地存储)和 CN(计算节点,用于存算分离场景,数据存储在对象存储或 HDFS 中)。这种设计使得 StarRocks 无需依赖任何外部组件,简化了部署和维护流程。系统支持节点水平扩展,确保服务在扩展过程中不受影响。此外,StarRocks 通过元数据和服务数据副本机制,显著提升了数据可靠性,有效避免了单点故障(SPOF)的风险。
StarRocks 的核心特性:
MPP 架构:依托大规模并行处理技术,将查询任务动态分配到多个节点并行执行,显著提升查询效率。
向量化引擎:采用先进的向量化计算技术,最大化 CPU 利用率,进一步优化查询性能。
存算分离:支持计算与存储的完全解耦,实现计算节点的弹性扩缩容,并内置高性能热数据缓存机制,灵活应对不同业务需求。
CBO 优化器:基于成本的查询优化器(Cost-Based Optimizer)智能分析查询场景,自动选择最优执行计划,确保高效查询。
列式存储:采用列式存储格式,针对大数据集优化读取效率,尤其适用于仅涉及部分列的查询场景,大幅减少 I/O 开销。
物化视图:通过预先计算的聚合表(物化视图),加速复杂查询的执行,显著提升分析效率。
数据湖分析:借助 StarRocks 提供的 External Catalog 功能,用户可直接查询 Apache Hive、Apache Iceberg、Apache Hudi、Delta Lake 等数据湖中的数据,无需繁琐的数据迁移,简化分析流程。
这些特性共同奠定了 StarRocks 在高性能 OLAP 领域的领先地位,为用户提供高效、灵活且易用的数据分析解决方案。
在之前的文章中,我们详细介绍了如何在 Apache Paimon 数据湖上构建分钟级更新的分层数据仓库,并将其部署在 Hive 上。为了实现数据的深度分析和 BI 展示,我们曾使用 Impala 作为查询引擎,为 OLAP 查询提供高效支持。然而,其他如 ClickHouse、Doris 等解决方案通常需要将数据同步到其数据库中,增加了复杂性和成本。
如今,StarRocks 提供了更高效的替代方案。它能够像 Impala 查询 HDFS 上的离线数据一样,直接高效地查询 Paimon 数据湖中的数据,为 Paimon 的数据分析以及与 BI 看板系统的无缝集成提供了更优的解决方案。接下来,我们将演示如何部署一个存算一体模式的 StarRocks 集群,并展示其如何高效查询 Paimon 上的数据。
一、StarRocks下载
1.1浏览器下载页面:https://www.starrocks.io/download/community
1.2终端代码下载
# 切换到hadoop用户su - hadoop# 进入opt目录cd /opt# 下载StarRocks包sudo wget https://releases.starrocks.io/starrocks/StarRocks-3.4.2-ubuntu-amd64.tar.gz# 解压StarRocks包sudo tar -xzvf StarRocks-3.4.2-ubuntu-amd64.tar.gz#创建一个符号链接以便于管理不同版本:sudo ln -s /opt/StarRocks-3.4.2-ubuntu-amd64 /opt/StarRocks
二、创建StarRocks数据存储路径
# 创建FE元数据存储目录sudo mkdir -p /var/lib/StarRocks/FE# 创建BE数据存储目录sudo mkdir -p /var/lib/StarRocks/BE
三、配置并启动FE
3.1 配置FE
# 编辑FE配置文件vi /opt/StarRocks/fe/conf/fe.conf进行如下简单配置# FE元数据路径meta_dir = /var/lib/StarRocks/FE# IP地址priority_networks = 127.0.0.1/32# JAVA地址,我安装了多个jdk,因此需指定JAVA_HOME = /usr/lib/jvm/java-17-openjdk-amd64
3.2 启动FE
# 启动FEsudo /opt/StarRocks/fe/bin/start_fe.sh --daemon# 查看启动日志cat /opt/StarRocks/fe/log/fe.log | grep thrift

四、配置并启动BE
4.1配置BE
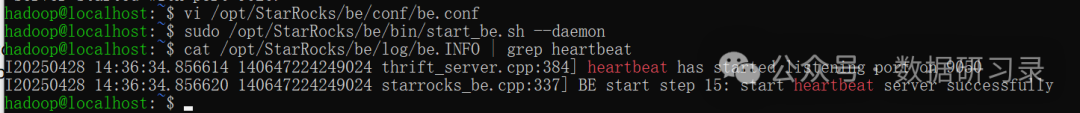
# 编辑BE配置文件vi /opt/StarRocks/be/conf/be.conf进行如下简单配置# BE数据存储目录storage_root_path = /var/lib/StarRocks/BE# ip地址priority_networks = 127.0.0.1/32# JAVA地址,我安装了多个jdk,因此需指定JAVA_HOME = /usr/lib/jvm/java-17-openjdk-amd64
4.2 启动BE
# 启动BEsudo /opt/StarRocks/be/bin/start_be.sh --daemon# 查看启动日志cat /opt/StarRocks/be/log/be.INFO | grep heartbeat
五、搭建集群
当所有 FE 和 BE/CN 节点启动成功后,即可搭建 StarRocks 集群。
以下过程在 MySQL 客户端实例上执行。您必须安装 MySQL 客户端(5.5.0 或更高版本)。
5.1通过 MySQL 客户端连接到 StarRocks。
您需要使用初始用户 root 登录,密码默认为空。
mysql -h 127.0.0.1 -P9030 -uroot#执行以下 SQL 查看 Leader FE 节点状态。SHOW PROC '/frontends'\G
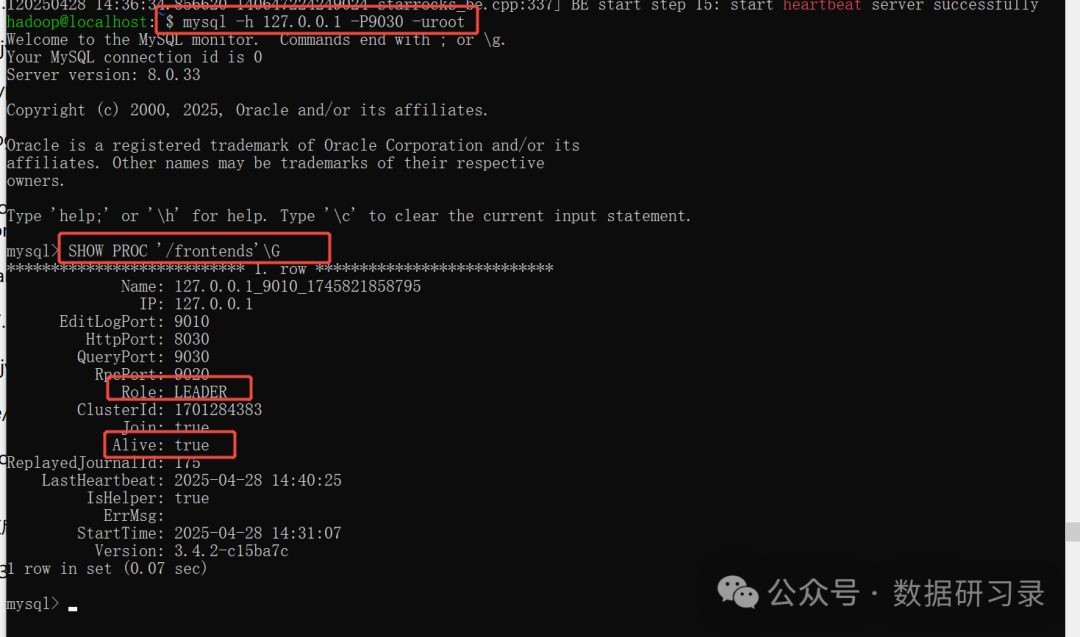
字段 Alive 为 true,说明该 FE 节点正常启动并加入集群。字段 Role 为 LEADER,说明该 FE 节点为 Leader FE 节点。
5.2存算一体,添加 BE节点至集群。
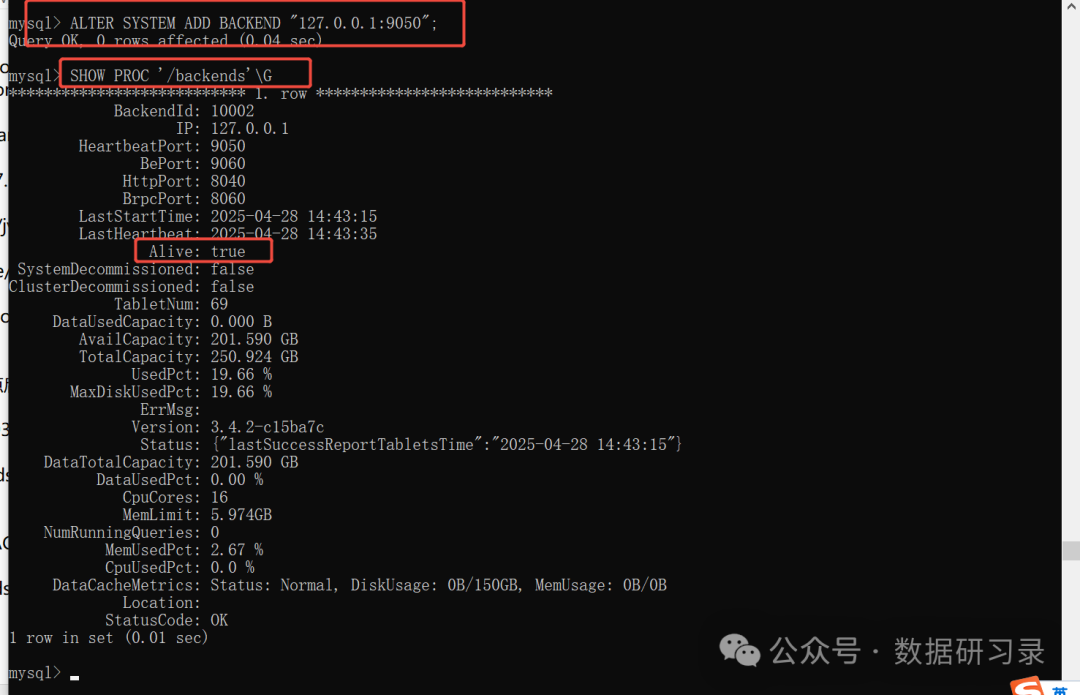
# 添加 BE节点ALTER SYSTEM ADD BACKEND "127.0.0.1:9050";# 执行以下 SQL 查看 BE/CN 节点状态。SHOW PROC '/backends'\G
六、管理初始帐户
# 修改root密码SET PASSWORD = PASSWORD('rootmima');

七、启停StarRocks
# 启动FEsudo /opt/StarRocks/fe/bin/start_fe.sh --daemon# 查看FE启动日志cat /opt/StarRocks/fe/log/fe.log | grep thrift# 启动BEsudo /opt/StarRocks/be/bin/start_be.sh --daemon# 查看BE启动日志cat /opt/StarRocks/be/log/be.INFO | grep heartbeat停止 BE 节点。sudo /opt/StarRocks/be/bin/stop_be.sh --daemon停止 FE 节点。sudo /opt/StarRocks/fe/bin/stop_fe.sh --daemon
八、使用StarRocks直接查询数据湖Paimon上的数据
8.1 创建Paimon catalog
创建存储在Hive上的Paimon的catalog
# 用mysql客户端链接StarRocks数据库mysql -h 127.0.0.1 -P9030 -uroot -prootmima# 创建catalogCREATE EXTERNAL CATALOG paimon_catalog PROPERTIES ("type" = "paimon", --数据源类型paimon"paimon.catalog.type" = "hive", --paimon存储类型,我这里是在Hive上"hive.metastore.uris" = "thrift://localhost:9083", --Hive metastore 地址"paimon.catalog.warehouse" = "hdfs://localhost:8020/user/hive/warehouse/" --paimon数据在HDFS上的路径地址);
8.2 Paimon catalog操作
# 查看StarRocks的catalog列表SHOW CATALOGS;# 删除StarRocks的具体catalogDROP Catalog paimon_catalog_fs;# 使用 paimon_catalogSET CATALOG paimon_catalog;# 查看创建的 paimon_catalog 有哪些数据库SHOW DATABASES FROM paimon_catalog;# 使用paimon_catalog.odsdbUSE paimon_catalog.odsdb;# 查看具体数据库下的表列表SHOW TABLES FROM paimon_catalog.odsdb;
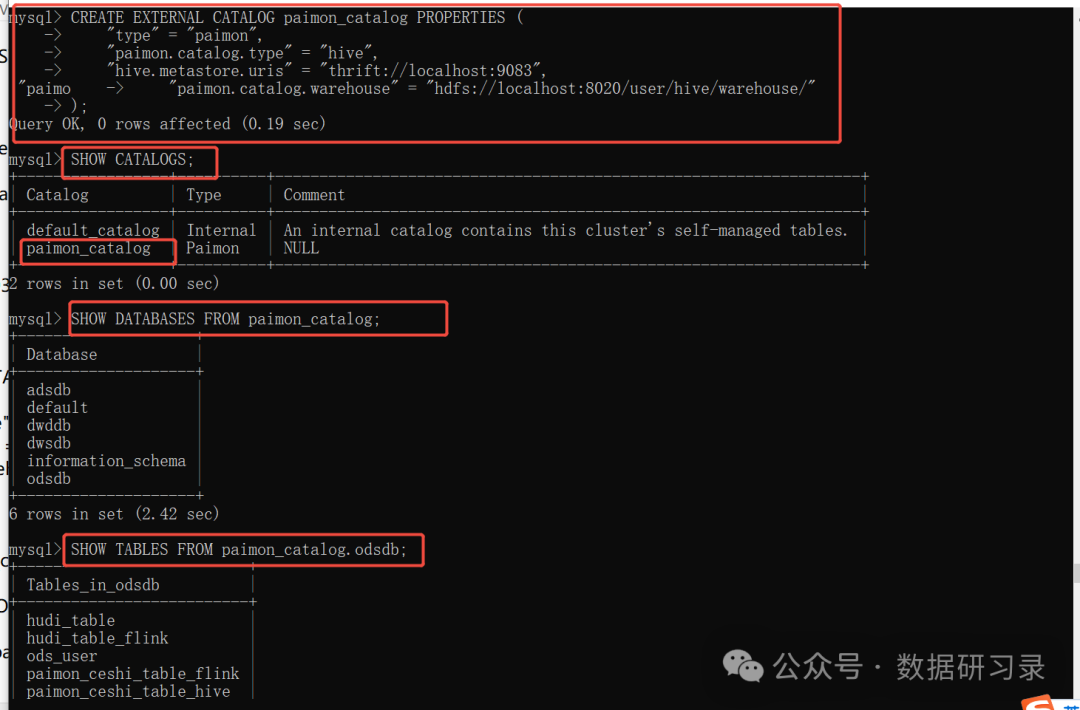
可以看到我们已经能够用Mysql客户端链接StarRocks,并查询Hive上的数据库和数据表。
8.3 查询数据
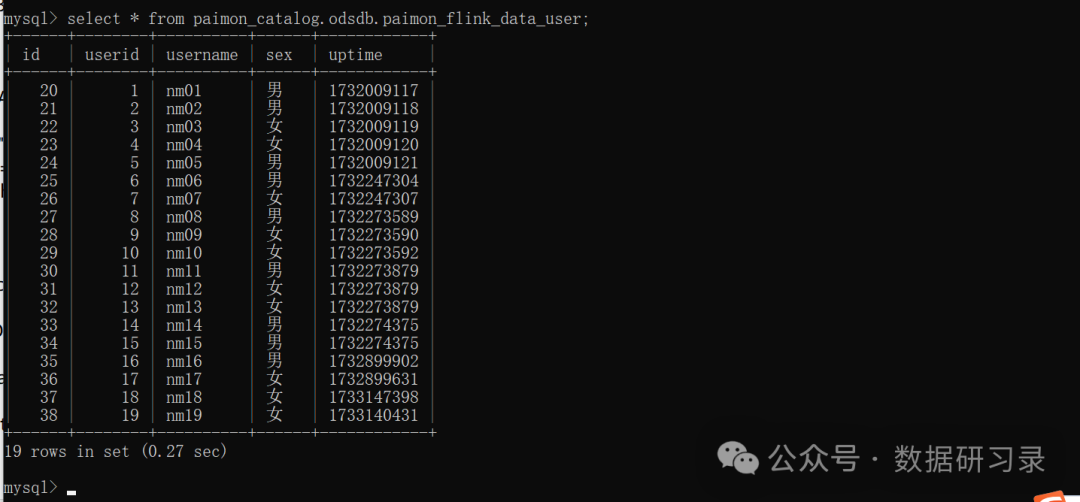
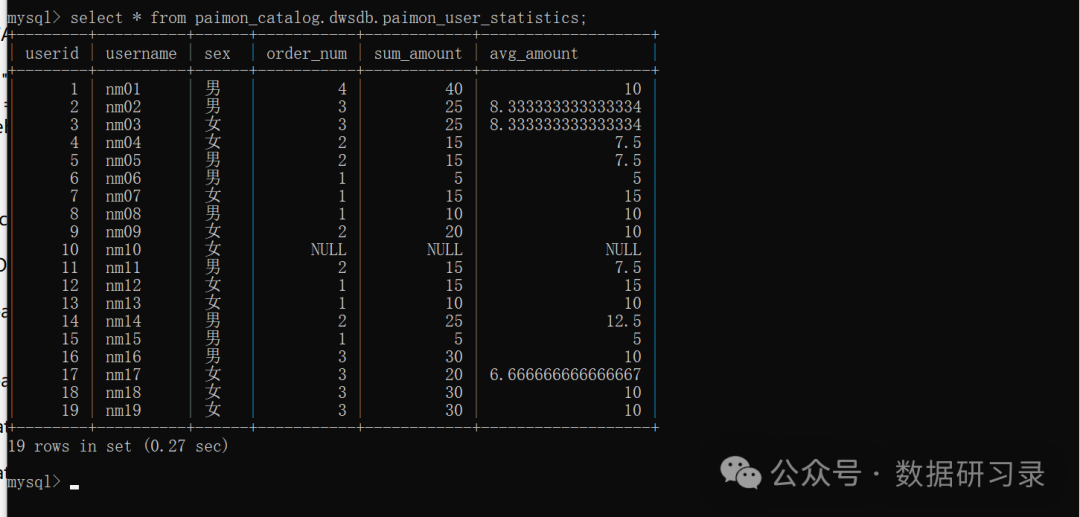
用Mysql客户端链接StarRocks,并查询和计算Hive上的Paimon数据表的数据。
# 查询paimon_catalog.odsdb.paimon_flink_data_user表数据select * from paimon_catalog.odsdb.paimon_flink_data_user;
# 查询paimon_catalog.dwsdb.paimon_user_statistics表数据select * from paimon_catalog.dwsdb.paimon_user_statistics;
# 分组计数数据select sex,count(userid) as aafrom paimon_catalog.odsdb.paimon_flink_data_usergroup by sex;
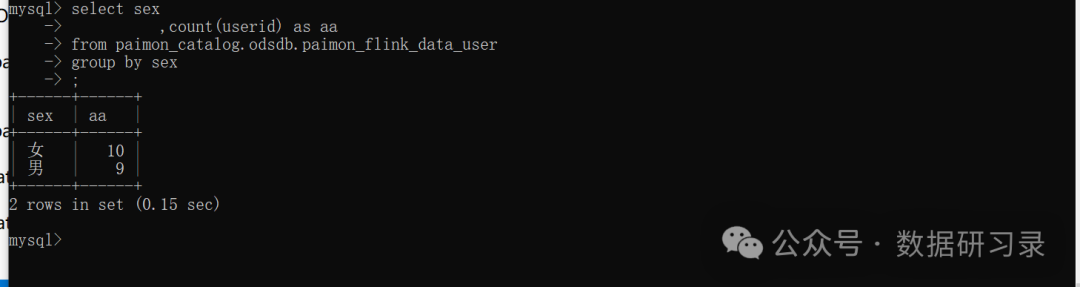
可以看到我们已经能够用Mysql客户端链接StarRocks,高效查询和计算我们之前在Hive上制作的Paimon数据库的数据。
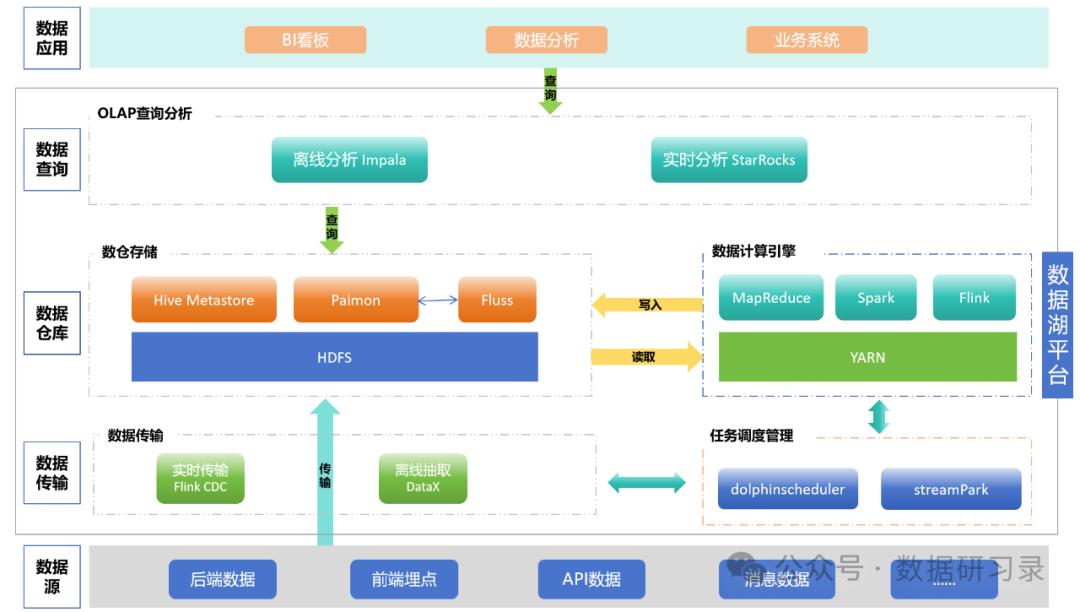
引入StarRocks后,我们就完成了一个相对完整的数据湖平台链路。Paimon支持分钟级实时数据及离线数据数仓存储,再引入Fluss后,Fluss与Paimon结合能够实现秒级数据更新存储及探查。具体如下,其中查询引擎完全也可以只用StarRocks,Impala也可以不用。
以上就是本次分享的内容,感谢!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 14
 0
- 0


 已为社区贡献15条内容

所有评论(0)