59.【必备】拓扑排序的扩展技巧
·
本文的网课内容学习自B站左程云老师的算法详解课程,旨在对其中的知识进行整理和分享~
一.最大食物链计数
题目:最大食物链计数
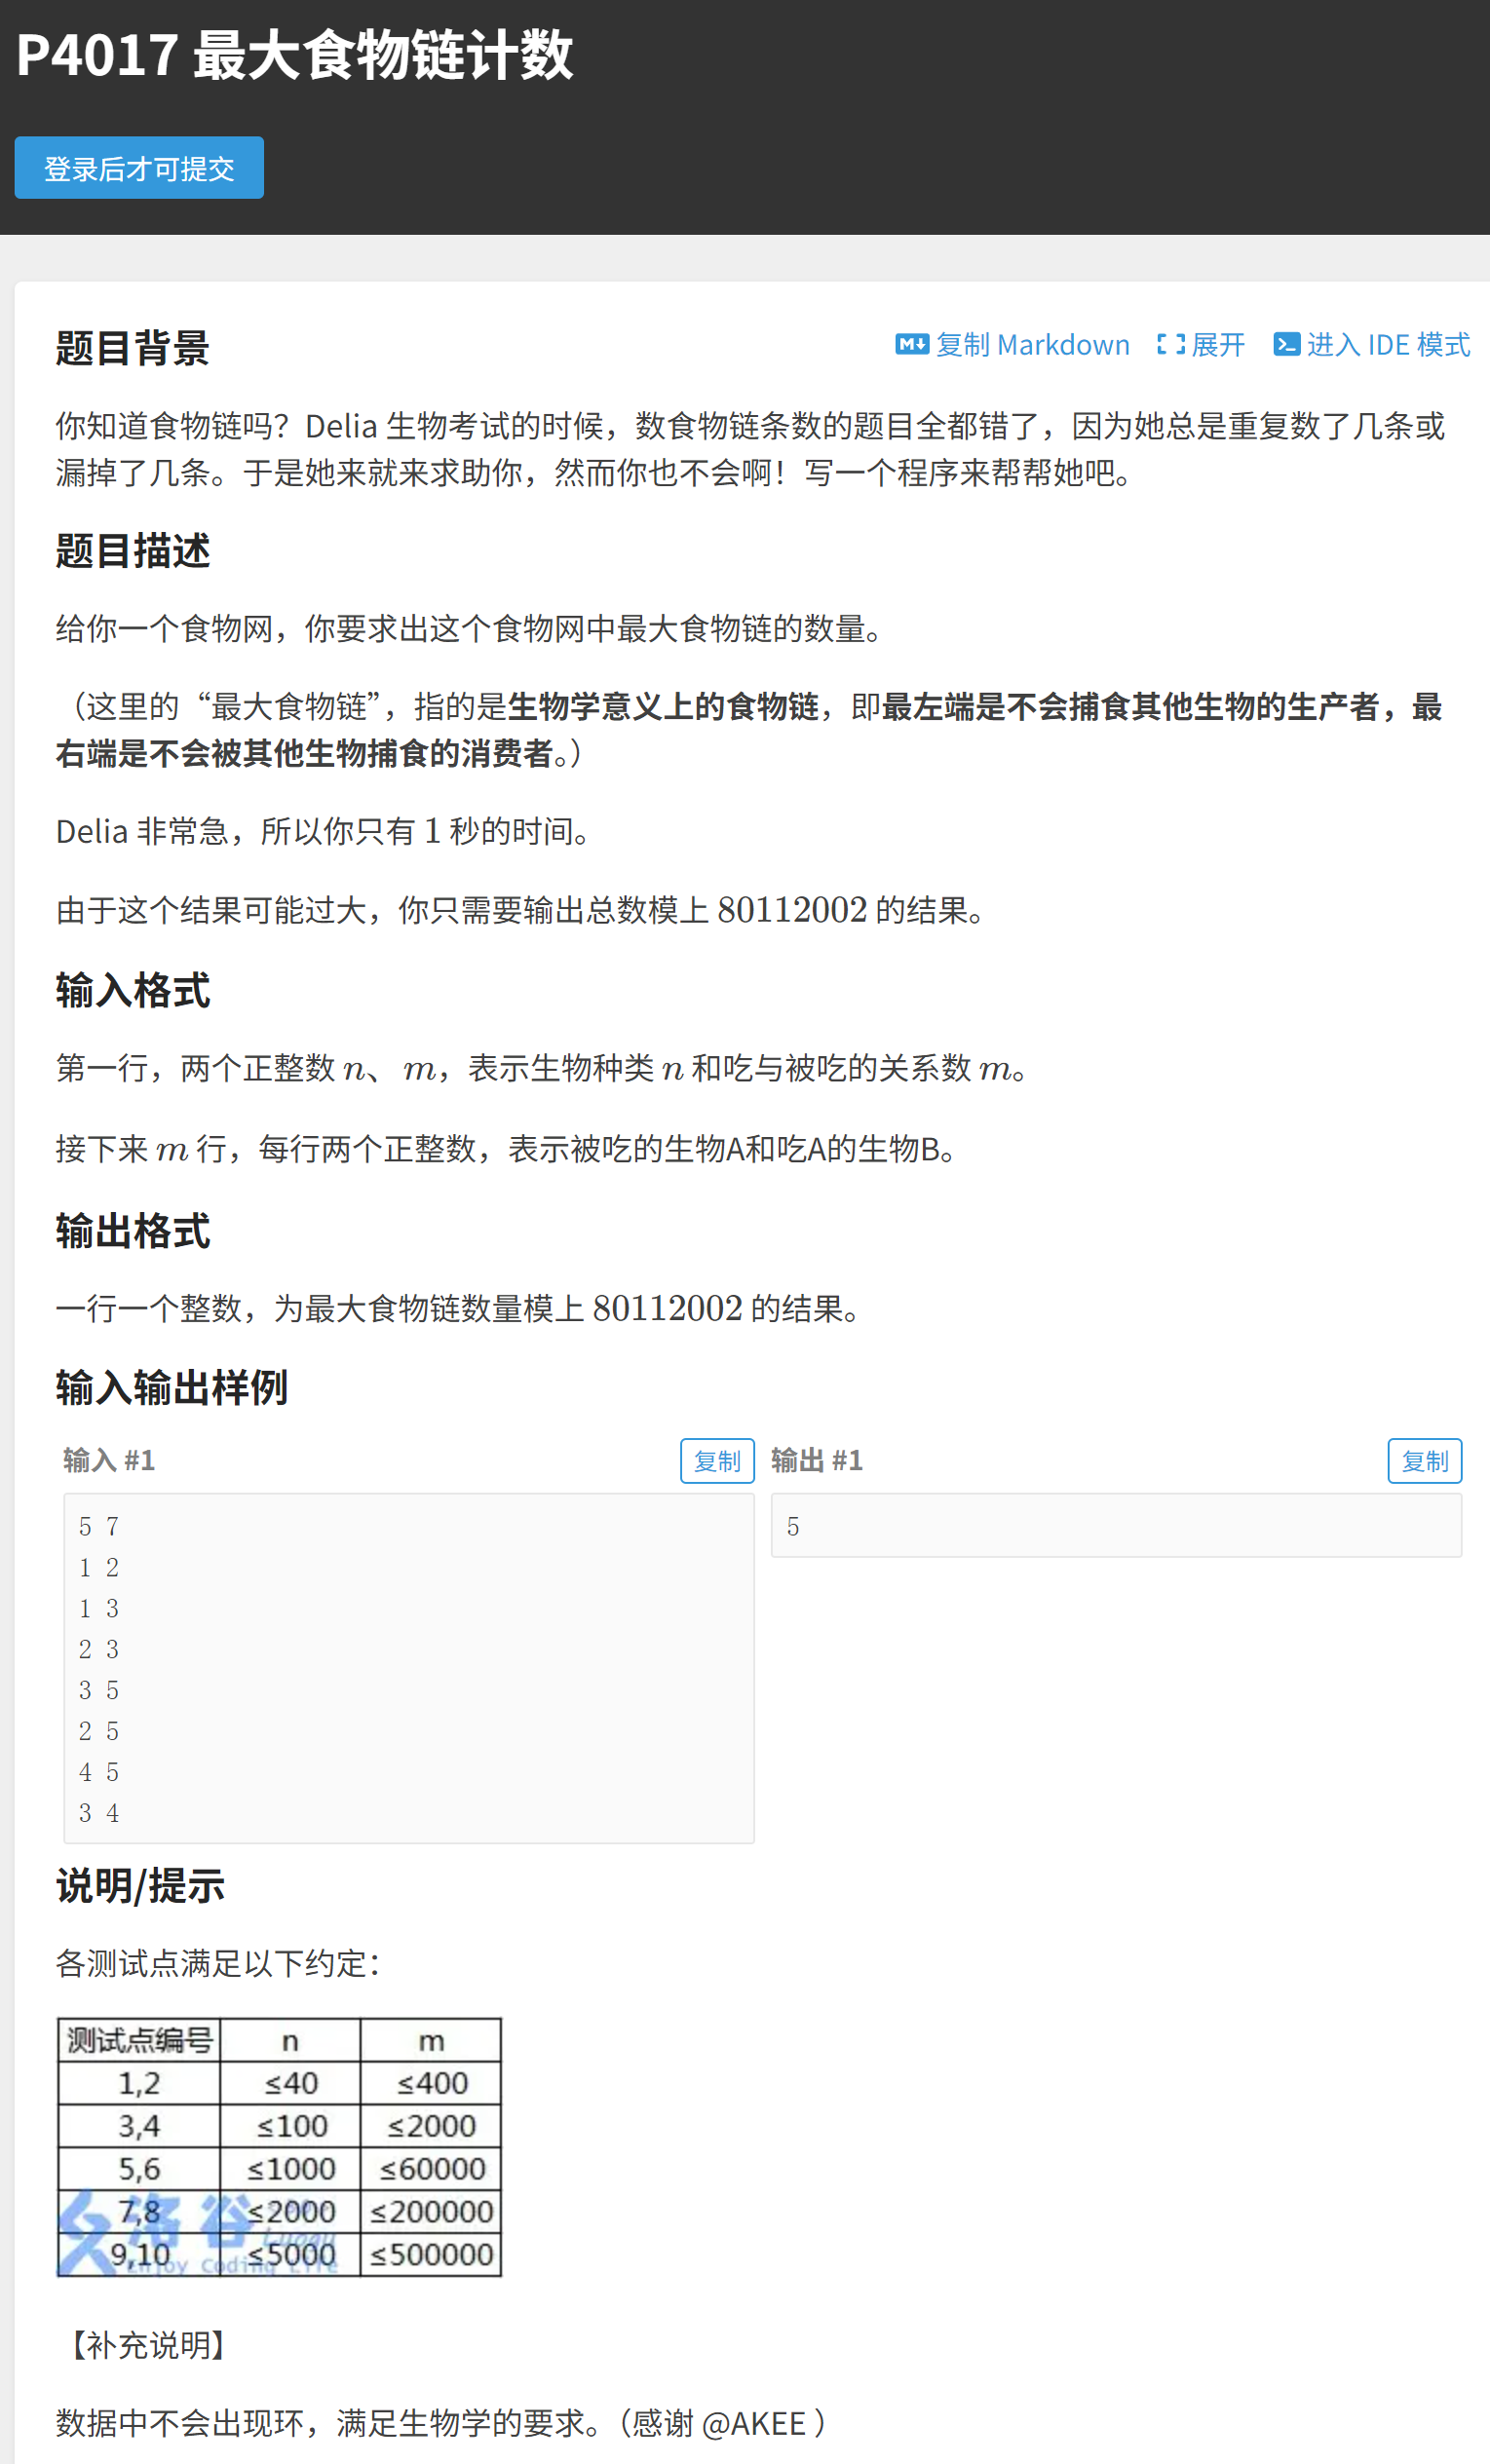
算法原理
-
整体原理
- 利用拓扑排序的思想,在有向无环图中从入度为0的节点开始逐步计算到其他节点的某种路径数量(在此为食物链数量)。通过不断更新每个节点的相关路径数量,最终得到从最初级节点(入度为0)到最顶级节点(出度为0或者到达最终状态)的路径总数。
-
具体步骤
- 建图阶段
- build函数
- 此函数用于初始化一些关键的全局变量。
- 它将边的计数器
cnt重置为1,这有助于后续构建图时正确地标记边的编号。 - 对于入度数组
indegree、到每个节点的食物链数量数组lines以及链式前向星的表头数组head,都通过Arrays.fill方法将指定范围内的值初始化为0,为后续操作提供一个初始的、干净的状态。
- addEdge函数
- 用于构建图的边关系。
- 当添加一条从节点
u到节点v的边时,它将新边的下一条边指针next[cnt]设置为当前节点u的表头head[u],这意味着新边被插入到链表的头部。 - 然后将
to[cnt]设置为目标节点v,表示这条边指向v。 - 最后更新
head[u]=cnt++,这使得head[u]指向新添加的边,并且cnt自增1,为下一条边的添加做准备。
- build函数
- 计算阶段(ways函数)
- 初始化队列和入度为0的节点
- 首先,遍历所有节点(从1到
n)。 - 当发现节点
i的入度为0时,将其加入队列queue。这里l和r作为队列的头和尾指针,初始时都为0,当节点i入队时,queue[r++] = i,并且将到该节点的食物链数量lines[i]设置为1,表示从最初级动物(入度为0的节点)到自身的食物链数量为1。
- 首先,遍历所有节点(从1到
- 拓扑排序与更新食物链数量
- 在
while (l < r)循环中,不断从队列中取出节点进行处理。 - 取出队列头部的节点
u,如果head[u]==0,说明这个节点没有出边,可能是最顶级捕食者。此时将到这个节点的食物链数量lines[u]累加到最终结果ans中,并进行取模操作(ans=(ans + lines[u])%MOD)。 - 如果节点
u有出边,通过遍历以head[u]为表头的链表(即遍历u的所有出边),对于每条边u -> v(其中v = to[ei]),更新到节点v的食物链数量为lines[v]=(lines[v]+lines[u])%MOD。这是因为到达v的食物链数量可以由原来到达v的数量加上通过u到达v的数量得到。然后,如果节点v的入度减1后变为0,就将v加入队列(queue[r++] = v)。
- 在
- 返回结果
- 最后,函数返回
ans,这个ans就是从最初级动物到最顶级捕食者的食物链数量总和(取模MOD)。
- 最后,函数返回
- 初始化队列和入度为0的节点
- 建图阶段
代码实现
// 最大食物链计数
// a -> b,代表a在食物链中被b捕食
// 给定一个有向无环图,返回
// 这个图中从最初级动物到最顶级捕食者的食物链有几条
// 测试链接 : https://www.luogu.com.cn/problem/P4017
// 请同学们务必参考如下代码中关于输入、输出的处理
// 这是输入输出处理效率很高的写法
// 提交以下所有代码,把主类名改成Main,可以直接通过

import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStreamReader;
import java.io.OutputStreamWriter;
import java.io.PrintWriter;
import java.io.StreamTokenizer;
import java.util.Arrays;

public class Code01_FoodLines {

    public static int MAXN = 5001;

    public static int MAXM = 500001;

    public static int MOD = 80112002;

    // 链式前向星建图
    public static int[] head = new int[MAXN];

    public static int[] next = new int[MAXM];

    public static int[] to = new int[MAXM];

    public static int cnt;

    // 拓扑排序需要的队列
    public static int[] queue = new int[MAXN];

    // 拓扑排序需要的入度表
    public static int[] indegree = new int[MAXN];

    // 拓扑排序需要的推送信息
    public static int[] lines = new int[MAXN];

    public static int n, m;

    public static void build(int n) {
        cnt = 1;
        Arrays.fill(indegree, 0, n + 1, 0);
        Arrays.fill(lines, 0, n + 1, 0);
        Arrays.fill(head, 0, n + 1, 0);
    }

    public static void addEdge(int u, int v) {
        next[cnt] = head[u];
        to[cnt] = v;
        head[u] = cnt++;
    }

    public static void main(String[] args) throws IOException {
        BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
        StreamTokenizer in = new StreamTokenizer(br);
        PrintWriter out = new PrintWriter(new OutputStreamWriter(System.out));
        while (in.nextToken() != StreamTokenizer.TT_EOF) {
            n = (int) in.nval;
            in.nextToken();
            m = (int) in.nval;
            build(n);
            for (int i = 0, u, v; i < m; i++) {
                in.nextToken();
                u = (int) in.nval;
                in.nextToken();
                v = (int) in.nval;
                addEdge(u, v);
                indegree[v]++;
            }
            out.println(ways());
        }
        out.flush();
        out.close();
        br.close();
    }

    public static int ways() {
        int l = 0;
        int r = 0;
        for (int i = 1; i <= n; i++) {
            if (indegree[i] == 0) {
                queue[r++] = i;
                lines[i] = 1;
            }
        }
        int ans = 0;
        while (l < r) {
            int u = queue[l++];
            if (head[u] == 0) {
                // 当前的u节点不再有后续邻居了
                ans = (ans + lines[u]) % MOD;
            } else {
                for (int ei = head[u], v; ei > 0; ei = next[ei]) {
                    // u -> v
                    v = to[ei];
                    lines[v] = (lines[v] + lines[u]) % MOD;
                    if (--indegree[v] == 0) {
                        queue[r++] = v;
                    }
                }
            }
        }
        return ans;
    }

}
二.喧嚣和富有
题目:喧闹和富有
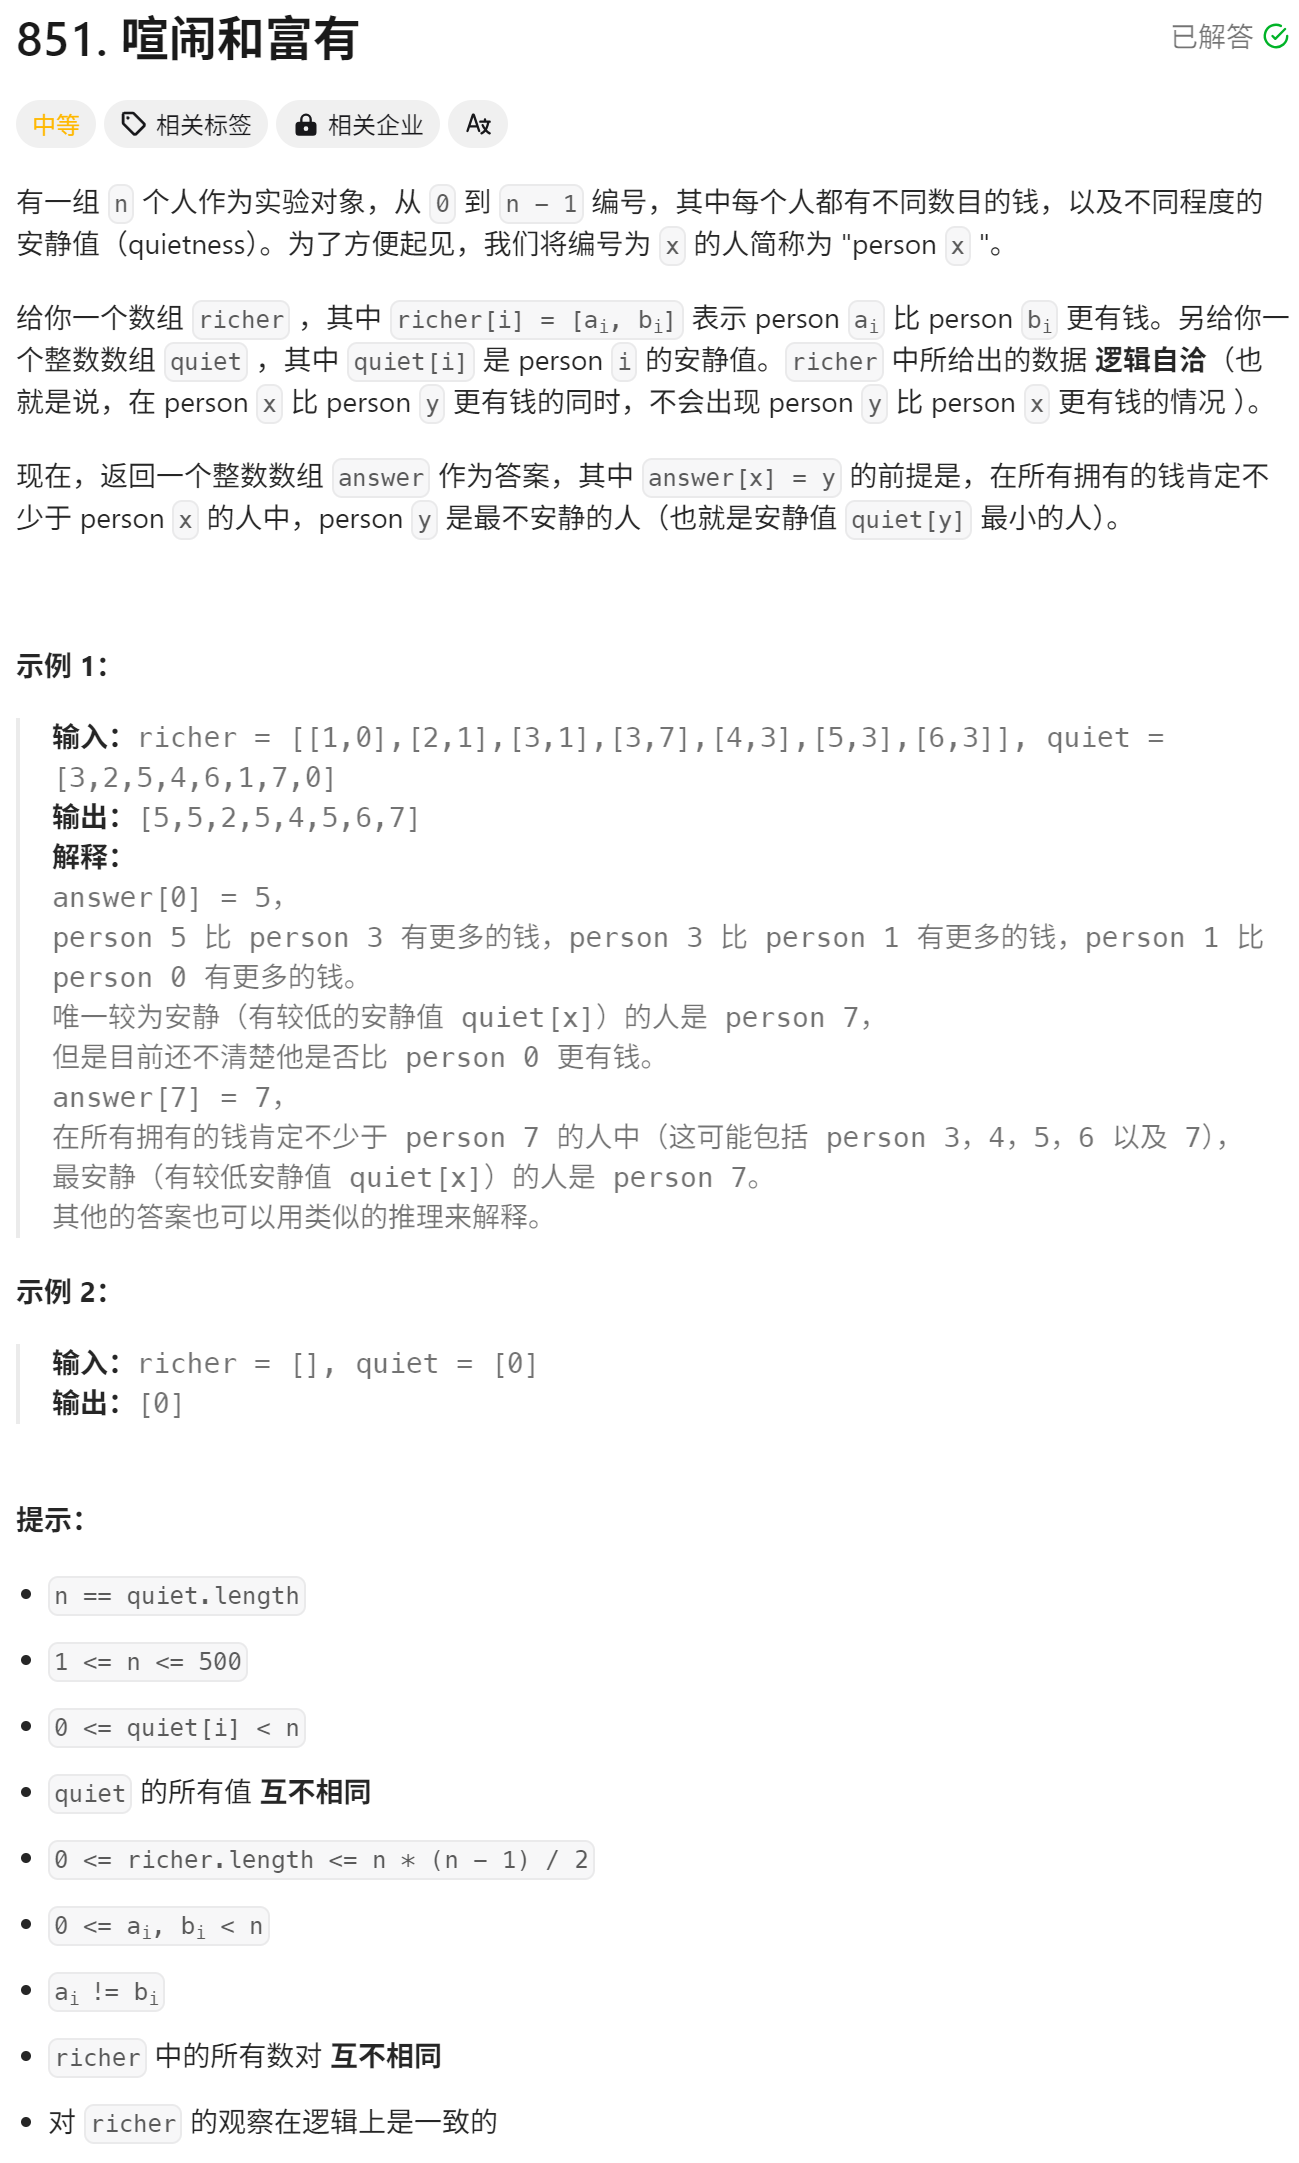
算法原理
-
整体原理
- 本算法旨在根据给定的人物财富关系(
richer数组)和每个人的安静值(quiet数组),找出对于每个个体,在所有不比其贫穷的人中最安静的那个人的编号。通过构建有向图来表示财富关系中的“更富有”关系,然后利用拓扑排序的思想,从入度为0(即最富有的人)开始逐步处理每个节点,在处理过程中更新每个节点对应的最安静的人的编号,最终得到完整的答案数组。
- 本算法旨在根据给定的人物财富关系(
-
具体步骤
- 构建图与相关初始化
- 图的构建与入度计算
- 首先,根据输入的人数
n(quiet数组的长度)创建一个ArrayList类型的图graph。这里graph的每个元素graph.get(i)是一个ArrayList,用于存储比节点i更穷的人的编号,也就是节点i的出边指向的节点。 - 同时创建一个入度数组
indegree,用于记录每个节点的入度。通过遍历richer数组,对于其中的每一个元素richer[i]=[ai, bi],表示ai比bi更有钱。所以在图中从ai到bi有一条有向边,将bi的入度indegree[bi]加1,并且把bi加入到graph.get(ai)中,表示ai的邻居中有bi。
- 首先,根据输入的人数
- 队列与答案数组初始化
- 创建一个长度为
n的队列queue,用于拓扑排序。 - 遍历所有节点(从0到
n - 1),将入度为0的节点加入队列。入度为0的节点表示最富有的人,因为没有其他人比他们更富有(根据财富关系的逻辑自洽性)。 - 创建一个长度为
n的答案数组ans,并将ans[i]初始化为i。这是基于最初的假设,即每个节点自身就是在所有比它富有的人中最安静的人,后续会在算法过程中进行修正。
- 创建一个长度为
- 图的构建与入度计算
- 拓扑排序与答案更新
- 拓扑排序循环
- 进入
while (l < r)循环,其中l和r分别是队列的头指针和尾指针。在每次循环中,取出队列头部的节点cur(cur = queue[l++])。
- 进入
- 邻居处理与答案调整
- 遍历
cur的邻居节点next(通过graph.get(cur)获取邻居列表)。对于每个邻居next:- 比较
quiet[ans[cur]]和quiet[ans[next]]的值。如果quiet[ans[cur]] < quiet[ans[next]],这意味着当前节点cur对应的最安静的人(ans[cur])比next节点当前对应的最安静的人(ans[next])更安静。根据算法要求,在所有不比next贫穷的人中,应该选择最安静的人,所以更新ans[next]=ans[cur]。 - 将
next的入度减1(因为cur指向next,处理了一条指向next的边),如果入度减1后为0,说明next的所有入边都已处理,将next加入队列(queue[r++] = next)。
- 比较
- 遍历
- 拓扑排序循环
- 最终结果输出
- 当
while循环结束后,ans数组已经更新完成。这个ans数组就是最终的答案,其中ans[x]表示在所有拥有的钱肯定不少于person x的人中,最安静的人的编号。
- 当
- 构建图与相关初始化
代码实现
import java.util.ArrayList;

// 喧闹和富有
// 从 0 到 n - 1 编号,其中每个人都有不同数目的钱,以及不同程度的安静值
// 给你一个数组richer,其中richer[i] = [ai, bi] 表示
// person ai 比 person bi 更有钱
// 还有一个整数数组 quiet ,其中 quiet[i] 是 person i 的安静值
// richer 中所给出的数据 逻辑自洽
// 也就是说,在 person x 比 person y 更有钱的同时,不会出现
// person y 比 person x 更有钱的情况
// 现在,返回一个整数数组 answer 作为答案,其中 answer[x] = y 的前提是,
// 在所有拥有的钱肯定不少于 person x 的人中,
// person y 是最安静的人(也就是安静值 quiet[y] 最小的人)。
// 测试链接 : https://leetcode.cn/problems/loud-and-rich/
public class Code02_LoudAndRich {

    public static int[] loudAndRich(int[][] richer, int[] quiet) {
        int n = quiet.length;
        ArrayList<ArrayList<Integer>> graph = new ArrayList<>();
        for (int i = 0; i < n; i++) {
            graph.add(new ArrayList<>());
        }
        int[] indegree = new int[n];
        for (int[] r : richer) {
            graph.get(r[0]).add(r[1]);
            indegree[r[1]]++;
        }
        int[] queue = new int[n];
        int l = 0;
        int r = 0;
        for (int i = 0; i < n; i++) {
            if (indegree[i] == 0) {
                queue[r++] = i;
            }
        }
        int[] ans = new int[n];
        for (int i = 0; i < n; i++) {
            ans[i] = i;
        }
        while (l < r) {
            int cur = queue[l++];
            for (int next : graph.get(cur)) {
                if (quiet[ans[cur]] < quiet[ans[next]] ) {
                    ans[next] = ans[cur];
                }
                if (--indegree[next] == 0) {
                    queue[r++] = next;
                }
            }
        }
        return ans;
    }

}
三.并行课程
题目:并行课程 III
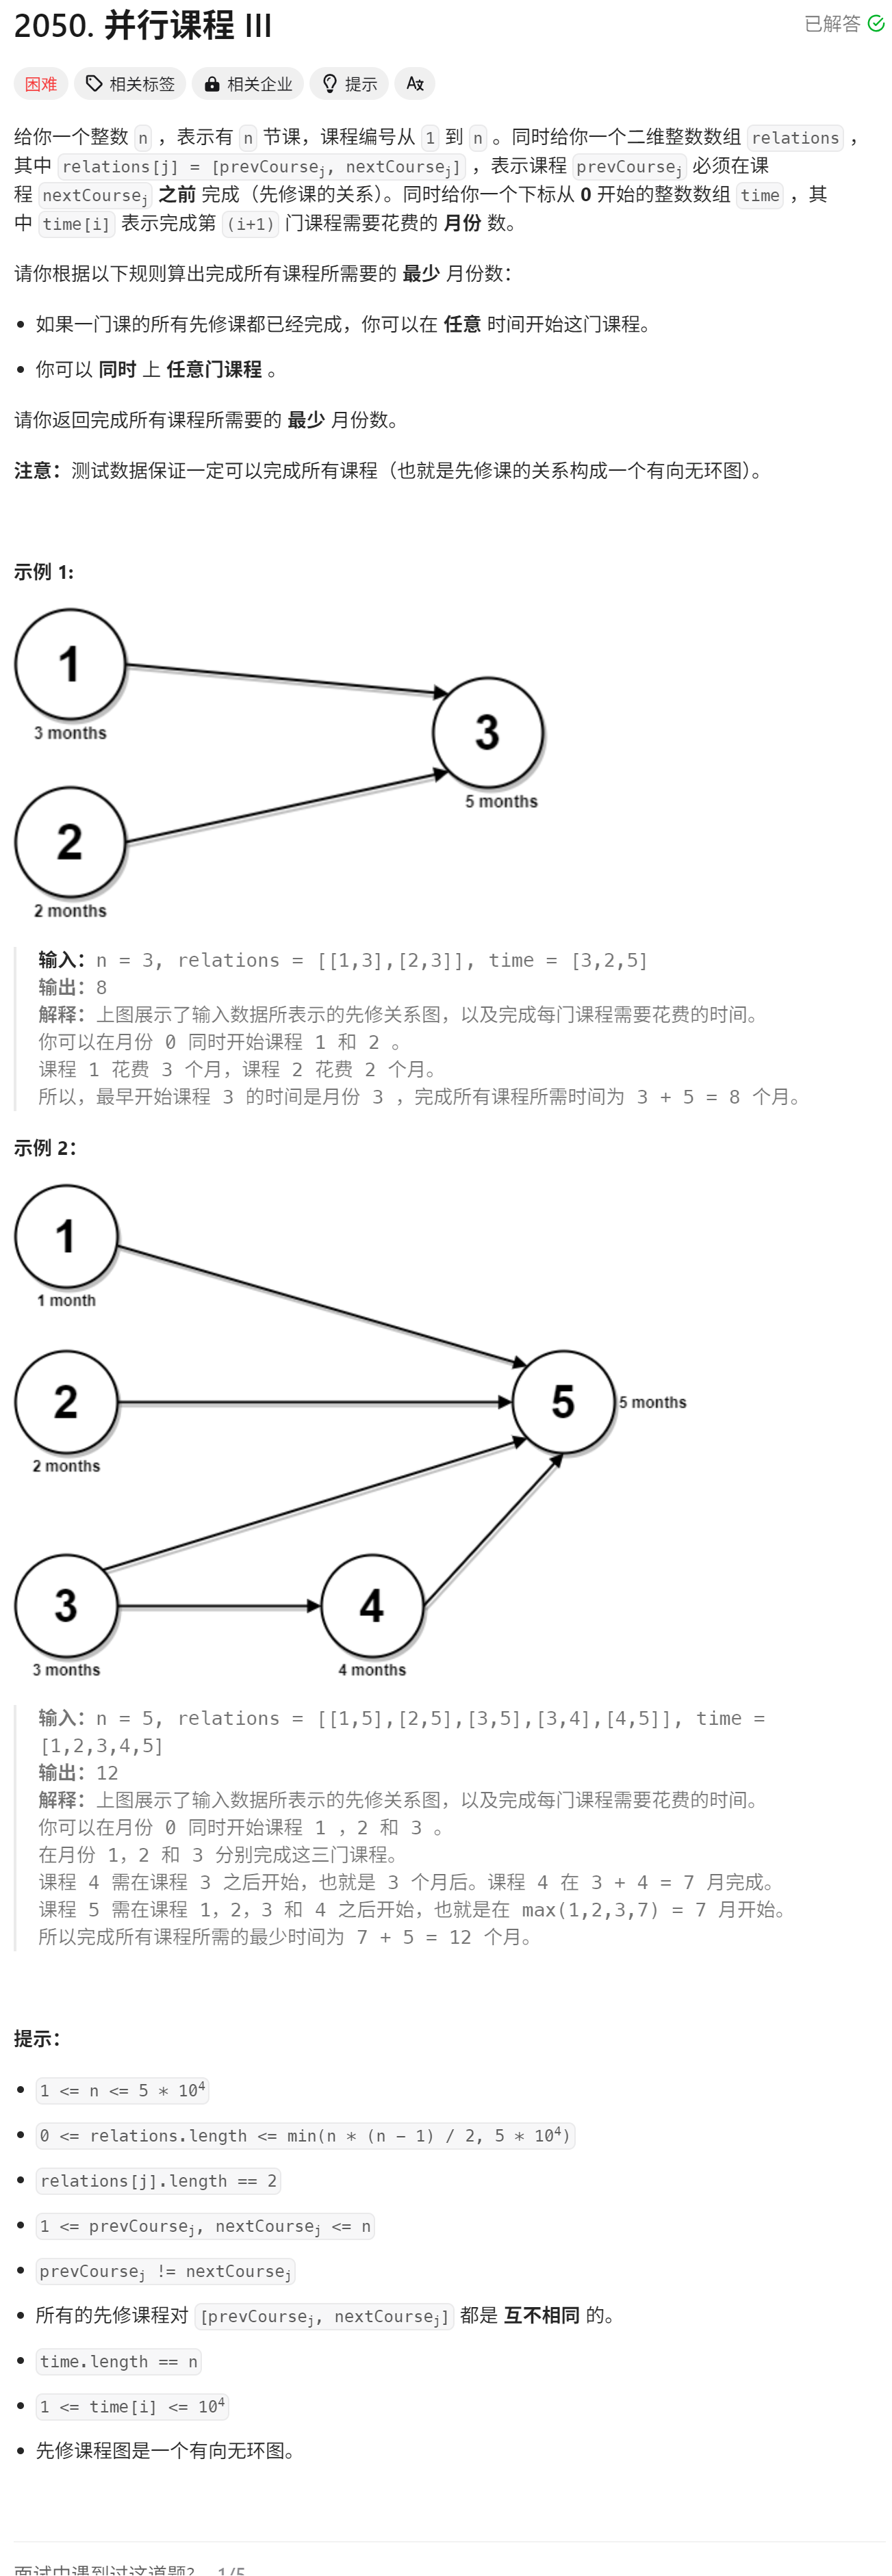
算法原理
-
整体原理
- 该算法旨在解决根据课程先修关系和每门课程的完成时间,计算完成所有课程的最少月份数的问题。利用拓扑排序处理课程之间的先修关系,在排序过程中计算每门课程的完成时间,通过不断更新每门课程的最早完成时间,最终得到完成所有课程的最少月份数。
-
具体步骤
- 构建图与入度计算
- 构建图结构
- 首先创建一个
ArrayList的数组graph来表示课程之间的先修关系图。对于每一个课程编号i(从0到n),graph.get(i)将存储以课程i为前置课程的后续课程编号列表。通过遍历n + 1次并为每个graph.get(i)创建一个新的ArrayList来初始化这个图结构。
- 首先创建一个
- 计算入度
- 创建一个入度数组
indegree,其长度为n + 1,用于记录每门课程(编号从1到n)的入度,即有多少前置课程。遍历relations数组中的每一个关系relations[j]=[prevCoursej, nextCoursej],对于每一个这样的关系,将课程nextCoursej的入度indegree[nextCoursej]加1,并将nextCoursej添加到graph.get(prevCoursej)中,表示课程prevCoursej是课程nextCoursej的前置课程。
- 创建一个入度数组
- 构建图结构
- 初始化队列与相关数组
- 初始化队列
- 创建一个整数数组
queue作为拓扑排序的队列,其长度为n。然后遍历课程编号从1到n,将入度为0(即没有前置课程)的课程编号加入到队列queue中,同时维护队列的头指针l = 0和尾指针r,每加入一个元素,r就加1。
- 创建一个整数数组
- 初始化成本数组和结果变量
- 创建一个整数数组
cost,长度为n + 1,用于记录每门课程的最早完成时间,初始值都为0。创建一个变量ans并初始化为0,用于存储最终的完成所有课程的最少月份数。
- 创建一个整数数组
- 初始化队列
- 拓扑排序与时间计算
- 拓扑排序过程
- 在
while (l < r)循环中,不断从队列queue中取出课程编号cur(通过queue[l++]操作)。
- 在
- 计算当前课程的完成时间
- 根据课程编号
cur与时间数组time的对应关系(课程编号x对应的时间存储在time[x - 1]中),将cost[cur]加上time[cur - 1],得到课程cur的完成时间。
- 根据课程编号
- 更新最少月份数和后续课程的完成时间
- 更新
ans为ans和cost[cur]中的最大值(ans = Math.max(ans, cost[cur])),因为完成所有课程的最少月份数取决于最后完成的课程所需的时间。 - 遍历
cur的后续课程(通过graph.get(cur)获取后续课程编号列表)。对于每一个后续课程next,更新cost[next]为cost[next]和cost[cur]中的最大值(cost[next]=Math.max(cost[next], cost[cur])),这是因为后续课程next必须在其前置课程cur完成之后才能开始,所以next的最早完成时间取决于其前置课程中最后完成的时间。然后将next的入度减1,如果入度减1后为0,就将next加入队列queue中(queue[r++])。
- 更新
- 拓扑排序过程
- 最终结果
- 当
while循环结束后,ans就是完成所有课程所需要的最少月份数,最后返回ans。
- 当
- 构建图与入度计算
代码实现
import java.util.ArrayList;

// 并行课程 III
// 给你一个整数 n ,表示有 n 节课,课程编号从 1 到 n
// 同时给你一个二维整数数组 relations ,
// 其中 relations[j] = [prevCoursej, nextCoursej]
// 表示课程 prevCoursej 必须在课程 nextCoursej 之前 完成(先修课的关系)
// 同时给你一个下标从 0 开始的整数数组 time
// 其中 time[i] 表示完成第 (i+1) 门课程需要花费的 月份 数。
// 请你根据以下规则算出完成所有课程所需要的 最少 月份数:
// 如果一门课的所有先修课都已经完成,你可以在 任意 时间开始这门课程。
// 你可以 同时 上 任意门课程 。请你返回完成所有课程所需要的 最少 月份数。
// 注意:测试数据保证一定可以完成所有课程(也就是先修课的关系构成一个有向无环图)
// 测试链接 : https://leetcode.cn/problems/parallel-courses-iii/
public class Code03_ParallelCoursesIII {

    public static int minimumTime(int n, int[][] relations, int[] time) {
        // 点 : 1....n
        ArrayList<ArrayList<Integer>> graph = new ArrayList<>();
        for (int i = 0; i <= n; i++) {
            graph.add(new ArrayList<>());
        }
        int[] indegree = new int[n + 1];
        for (int[] edge : relations) {
            graph.get(edge[0]).add(edge[1]);
            indegree[edge[1]]++;
        }
        int[] queue = new int[n];
        int l = 0;
        int r = 0;
        for (int i = 1; i <= n; i++) {
            if (indegree[i] == 0) {
                queue[r++] = i;
            }
        }
        int[] cost = new int[n + 1];
        int ans = 0;
        while (l < r) {
            int cur = queue[l++];
            // 1 : time[0]
            // x : time[x-1]
            cost[cur] += time[cur - 1];
            ans = Math.max(ans, cost[cur]);
            for (int next : graph.get(cur)) {
                cost[next] = Math.max(cost[next], cost[cur]);
                if (--indegree[next] == 0) {
                    queue[r++] = next;
                }
            }
        }
        return ans;
    }

}
四.参加会议的最多员工数
题目:参加会议的最多员工数
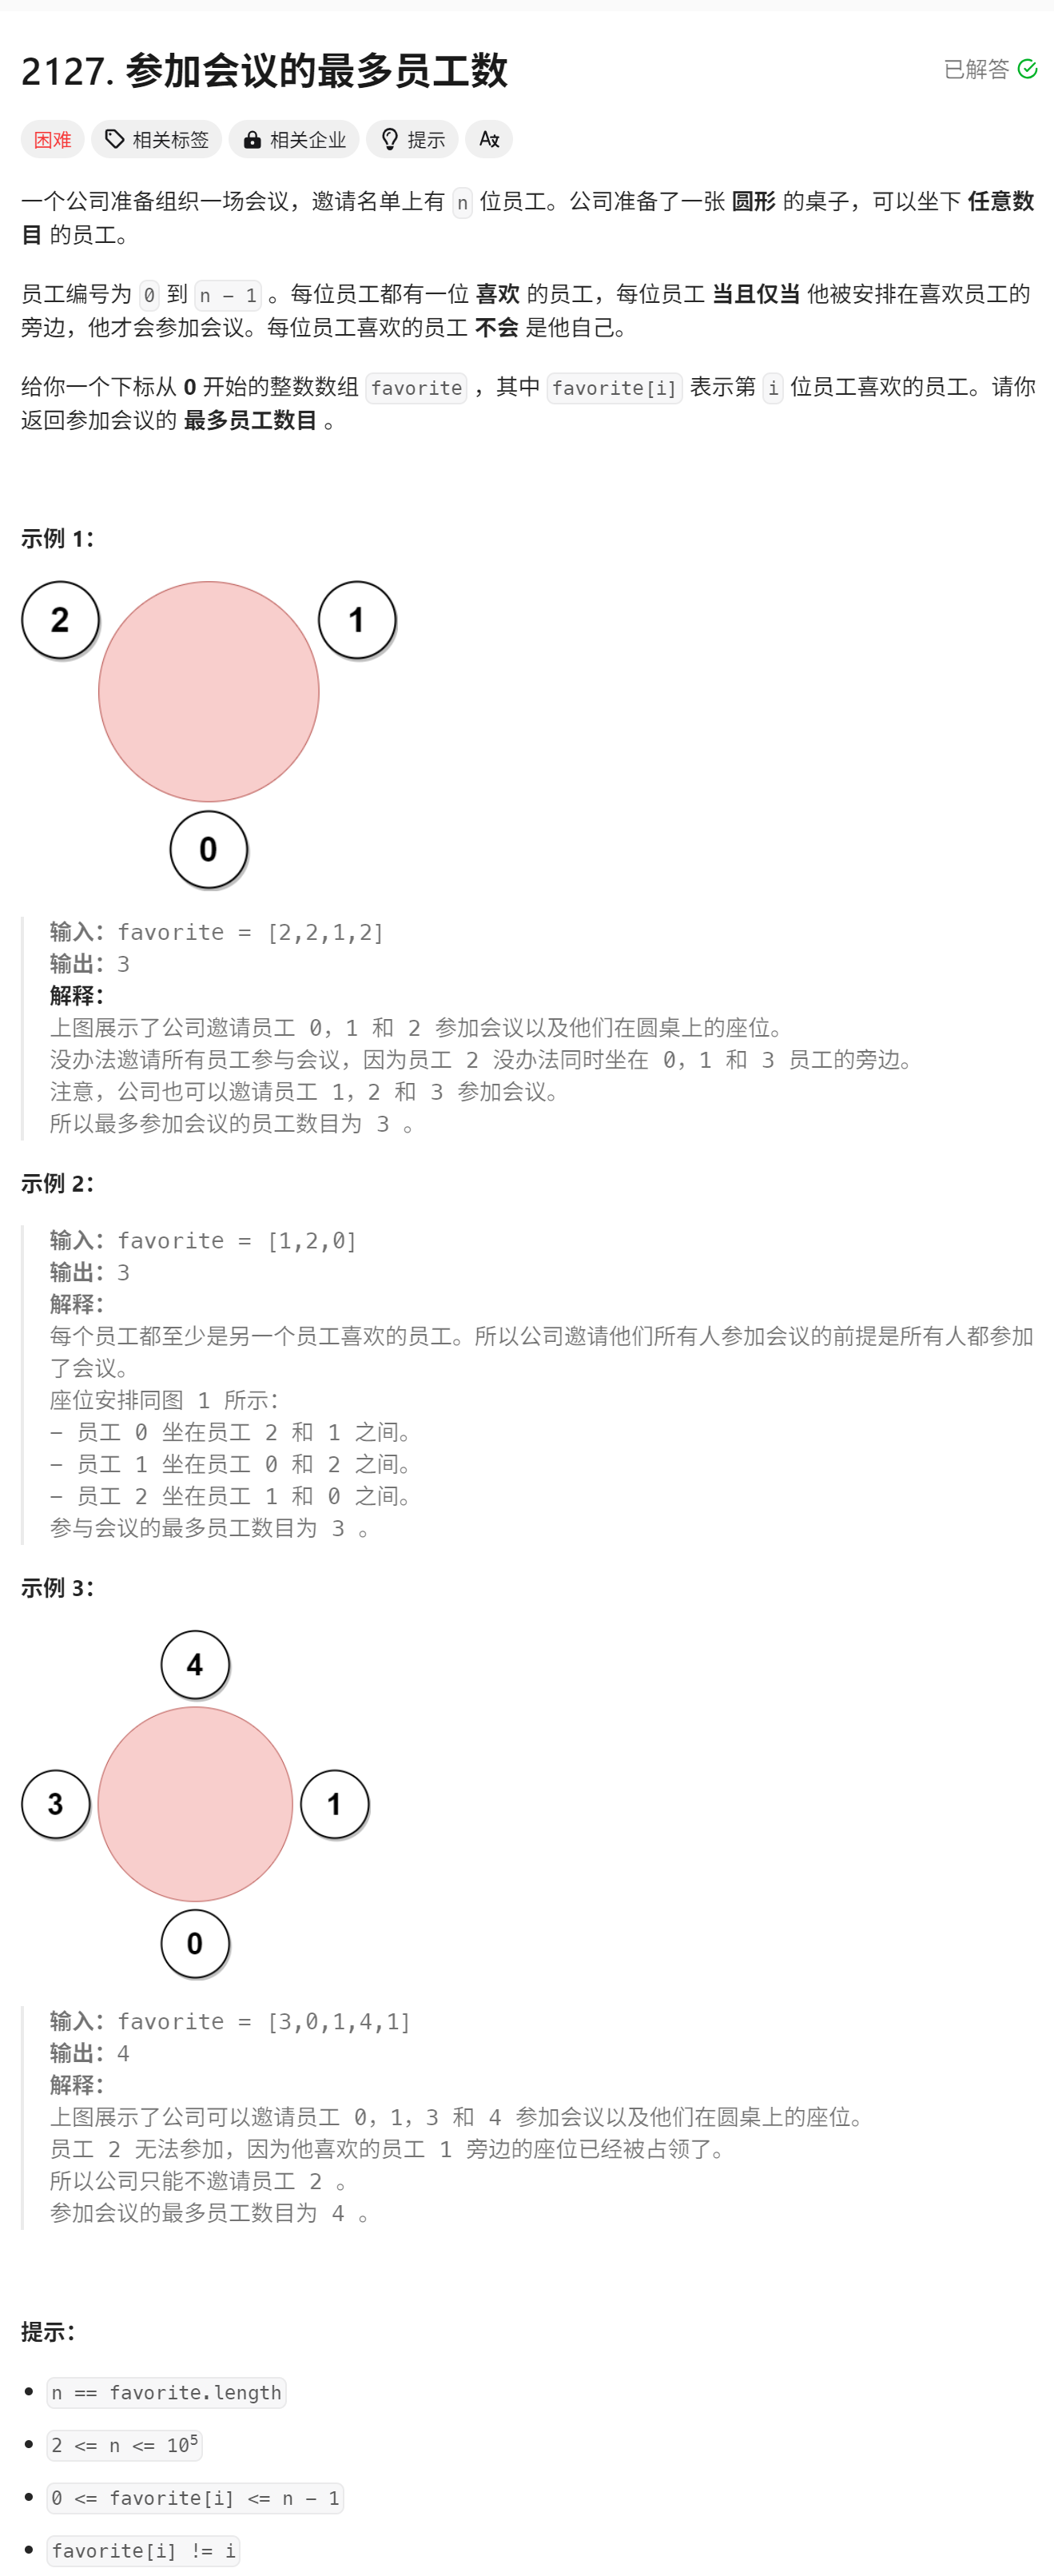
算法原理
-
整体原理
- 本算法旨在找出在特定条件下参加会议的最多员工数目。通过构建基于员工喜好关系的有向图,利用入度和拓扑排序的概念先处理图中入度为0(即没有被其他人喜欢的员工)的节点,计算出每个节点之前的最长链长度。然后分别考虑图中的小环(中心个数为2)和大环(中心个数大于2)情况,计算出两种情况下可能的最大参会员工数,最后取两者中的最大值作为结果。
-
具体步骤
- 构建入度数组与初始化队列
- 计算入度
- 首先创建一个入度数组
indegree,其长度为n(员工数量)。通过遍历favorite数组,对于favorite[i]=b,表示员工i喜欢员工b,那么将员工b的入度indegree[b]加1,因为有员工i喜欢员工b。
- 首先创建一个入度数组
- 初始化队列
- 创建一个队列
queue,长度为n。然后遍历所有员工编号i(从0到n - 1),将入度为0的员工编号加入队列。这里的入度为0表示该员工没有被其他员工喜欢。同时维护队列的头指针l = 0和尾指针r,每加入一个元素,r就加1。
- 创建一个队列
- 计算入度
- 计算最长链长度(拓扑排序相关)
- 创建一个数组
deep,长度为n,用于存储每个节点不包括自身在内,之前的最长链的长度。 - 在
while (l < r)循环中,从队列中取出一个员工编号cur(通过queue[l++]操作)。然后找到员工cur喜欢的员工next(即next = favorite[cur])。 - 更新
deep[next]为deep[next]和deep[cur]+1中的最大值(deep[next]=Math.max(deep[next], deep[cur]+1)),这表示以next为终点的最长链长度(不包括next自身)。 - 将
next的入度减1,如果入度减1后为0,就将next加入队列queue中(queue[r++])。
- 创建一个数组
- 处理环并计算最大参会人数
- 计算小环的贡献
- 初始化变量
sumOfSmallRings为0,用于统计所有小环(中心个数为2)的总贡献。遍历所有员工编号i,如果indegree[i]>0,表示这个员工在环中(因为入度不为0的员工在之前没有被处理掉,必然在环中)。对于这样的员工,计算环的大小ringSize,从i开始,沿着favorite关系一直走,直到回到i,每经过一个节点就将ringSize加1并且将经过节点的入度设置为0(表示已经处理过这个环)。如果环的大小ringSize为2,那么将2 + deep[i]+deep[favorite[i]]累加到sumOfSmallRings中。这里2表示环中的两个中心点,deep[i]和deep[favorite[i]]表示两个中心点向外延伸的最长链长度。
- 初始化变量
- 计算大环的贡献
- 初始化变量
bigRings为0,用于统计所有大环(中心个数大于2)的最大环的中心点个数。同样遍历所有员工编号i,如果indegree[i]>0,计算环的大小ringSize,如果环的大小大于2,更新bigRings为bigRings和ringSize中的最大值。
- 初始化变量
- 计算小环的贡献
- 最终结果
- 最后返回
sumOfSmallRings和bigRings中的最大值,这个值就是参加会议的最多员工数目。
- 最后返回
- 构建入度数组与初始化队列
代码实现
// 参加会议的最多员工数
// 一个公司准备组织一场会议,邀请名单上有 n 位员工
// 公司准备了一张 圆形 的桌子,可以坐下 任意数目 的员工
// 员工编号为 0 到 n - 1 。每位员工都有一位 喜欢 的员工
// 每位员工 当且仅当 他被安排在喜欢员工的旁边,他才会参加会议
// 每位员工喜欢的员工 不会 是他自己。给你一个下标从 0 开始的整数数组 favorite
// 其中 favorite[i] 表示第 i 位员工喜欢的员工。请你返回参加会议的 最多员工数目
// 测试链接 : https://leetcode.cn/problems/maximum-employees-to-be-invited-to-a-meeting/
public class Code04_MaximumEmployeesToBeInvitedToAMeeting {

    public static int maximumInvitations(int[] favorite) {
        // 图 : favorite[a] = b : a -> b
        int n = favorite.length;
        int[] indegree = new int[n];
        for (int i = 0; i < n; i++) {
            indegree[favorite[i]]++;
        }
        int[] queue = new int[n];
        int l = 0;
        int r = 0;
        for (int i = 0; i < n; i++) {
            if (indegree[i] == 0) {
                queue[r++] = i;
            }
        }
        // deep[i] : 不包括i在内,i之前的最长链的长度
        int[] deep = new int[n];
        while (l < r) {
            int cur = queue[l++];
            int next = favorite[cur];
            deep[next] = Math.max(deep[next], deep[cur] + 1);
            if (--indegree[next] == 0) {
                queue[r++] = next;
            }
        }
        // 目前图中的点,不在环上的点,都删除了! indegree[i] == 0
        // 可能性1 : 所有小环(中心个数 == 2),算上中心点 + 延伸点,总个数
        int sumOfSmallRings = 0;
        // 可能性2 : 所有大环(中心个数 > 2),只算中心点,最大环的中心点个数
        int bigRings = 0;
        for (int i = 0; i < n; i++) {
            // 只关心的环!
            if (indegree[i] > 0) {
                int ringSize = 1;
                indegree[i] = 0;
                for (int j = favorite[i]; j != i; j = favorite[j]) {
                    ringSize++;
                    indegree[j] = 0;
                }
                if (ringSize == 2) {
                    sumOfSmallRings += 2 + deep[i] + deep[favorite[i]];
                } else {
                    bigRings = Math.max(bigRings, ringSize);
                }
            }
        }
        return Math.max(sumOfSmallRings, bigRings);
    }

}
北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 7
 0
- 0


 已为社区贡献4条内容

所有评论(0)