科普文:线程池、连接池、动态线程池
池化技术的优点如下:
1. 统一管理资源,线程是操作系统一个重要监控管理指标,过多的线程会导致占用内存、上下文切换频繁等问题,所以需要管理起来线程,而每处都用new Thread()方法来创建线程,那线程资源散落在应用程序各地,没法管理。
2. 不需要每次要用到线程时都再次创建一个新的线程,可以做到线程重用。线程池默认初始化时是没有创建线程的(也可以在创建线程池时自动创建好核心线程),线程池里的线程的初始化与其他线程一样,但是在完成任务以后,该线程不会自行销毁,而是以挂起的状态返回到线程池。直到应用程序再次向线程池发出请求时,线程池里挂起的线程就会再度激活执行任务。这样既节省了建立线程所造成的性能损耗,也可以让多个任务反复重用同一线程,从而在应用程序生存期内节约大量开销。
线程池类似于数据库链接池、Redis链接池等池化技术。
线程池
线程池是一种多线程处理方式,通过预先创建一组线程来执行提交的任务,以减少线程创建和销毁的开销,提高系统效率。 它的主要组成部分包括:
- 线程池管理器:负责创建和管理线程池,包括线程的创建、启动和销毁。
- 工作线程:是线程池中的实际执行单元,负责执行具体的任务。
- 任务队列:用于存储待执行的任务,提供一个缓冲机制,确保任务的顺序执行或异步处理。
- 任务接口:定义了任务必须实现的接口,确保任务的标准化执行。
线程池的工作原理主要包括:
- 任务提交:当有新任务提交时,它被放入任务队列中等待执行。
- 线程复用:如果线程池中的工作线程空闲,它们会被用来执行队列中的任务,避免了频繁创建和销毁线程的开销。
- 队列管理:如果所有工作线程都在忙碌,新任务会在队列中等待,直到有工作线程完成当前任务并返回线程池。
- 控制并发数:通过控制最大并发数,防止过多的并发任务导致系统资源耗尽。
通过这种方式,线程池有效地管理了系统的并发执行任务,提高了系统的整体效率和响应速度。
线程池是一种用于管理和重用线程的机制,它允许开发人员有效地执行并发任务。通过使用线程池,可以带来了许多好处:
-
资源管理: 线程池能够有效地管理系统资源,通过限制并发任务的数量和重用线程,减少了线程创建和销毁的开销,提高了系统资源利用率。
-
性能提升: 通过合理地配置线程池大小和任务队列,可以优化任务执行流程,降低了线程的上下文切换成本,提高了任务的执行效率和系统的吞吐量。
-
避免资源耗尽: 线程池可以控制并发任务的数量,防止系统因创建过多线程而导致资源耗尽,从而提高了系统的稳定性和可靠性。
-
任务排队: 线程池通过任务队列来暂存尚未执行的任务,保证了任务的顺序执行,并且能够灵活地处理突发任务量,避免了系统的过载。简化并发编程: 使用线程池可以简化并发编程的复杂性,开发人员无需手动管理线程的生命周期和任务的调度,只需将任务提交给线程池即可,从而降低了编程的复杂度和出错的可能性。
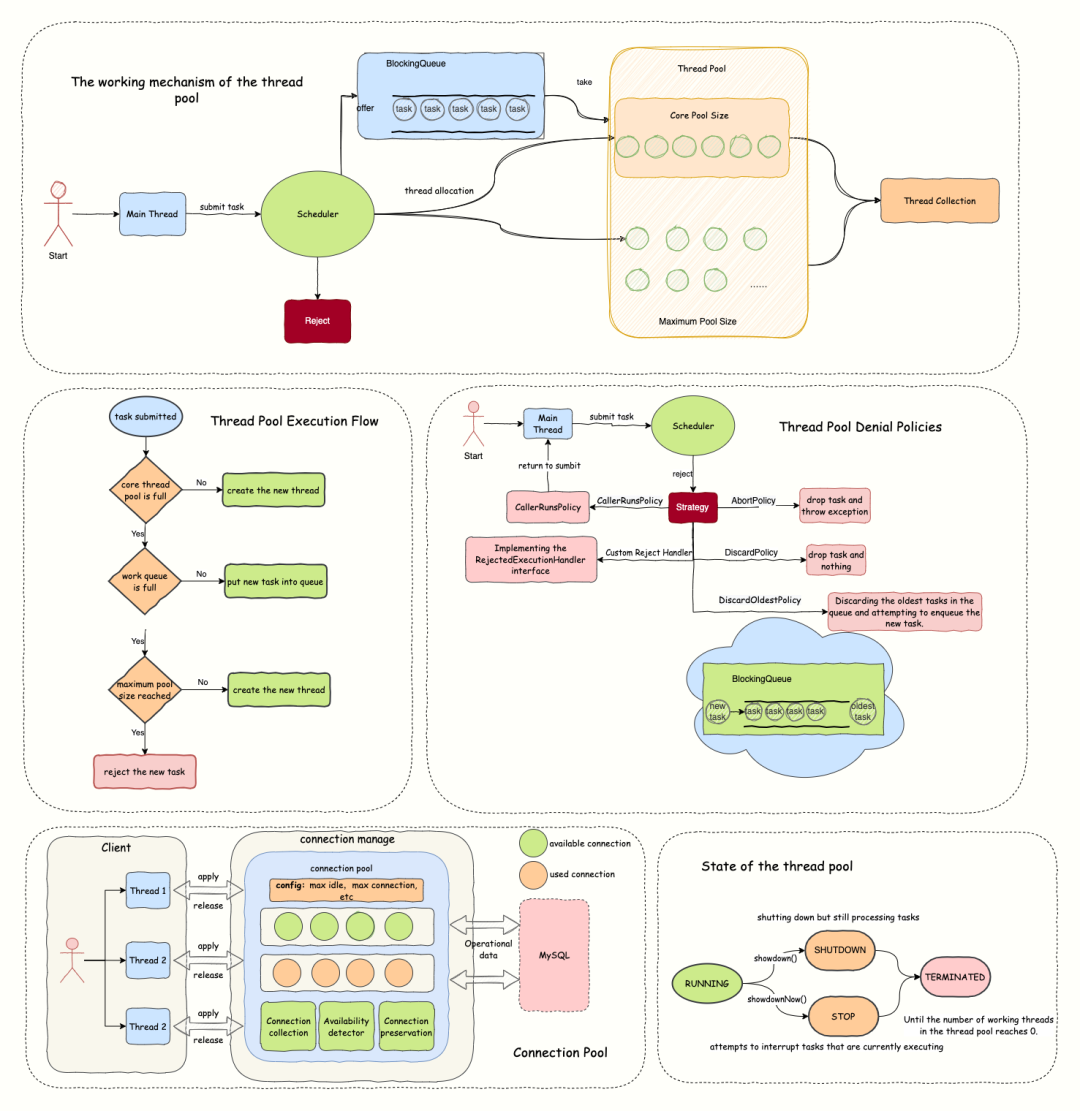
接下来以 Java 中的线程池实现机制为例,带你掌握线程池的工作机制。
线程池的工作机制
线程池的工作机制可以看作是一种生产者-消费者模型的应用。
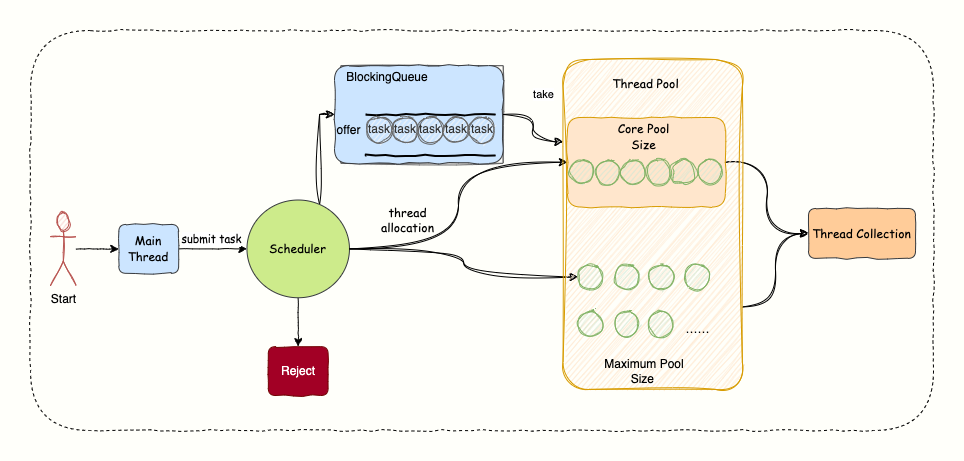
在这个模型中,任务(生产者)被提交到线程池,然后线程池中的线程(消费者)从任务队列中取出任务并执行,线程池模型架构如下图:
-
开发人员使用 ThreadPoolExecutor 的 submit() 方法提交任务。
-
检测线程池运行状态,如果不是 RUNNING,则直接拒绝,线程池要保证在 RUNNING 的状态下执行任务
-
提交的任务(通常实现了 Callable 或 Runnable 接口)会被封装成一个 FutureTask 对象,该对象实现了 Future 接口,允许获取任务执行的结果。
-
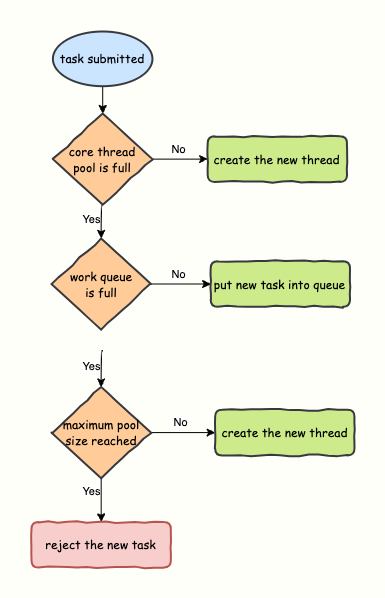
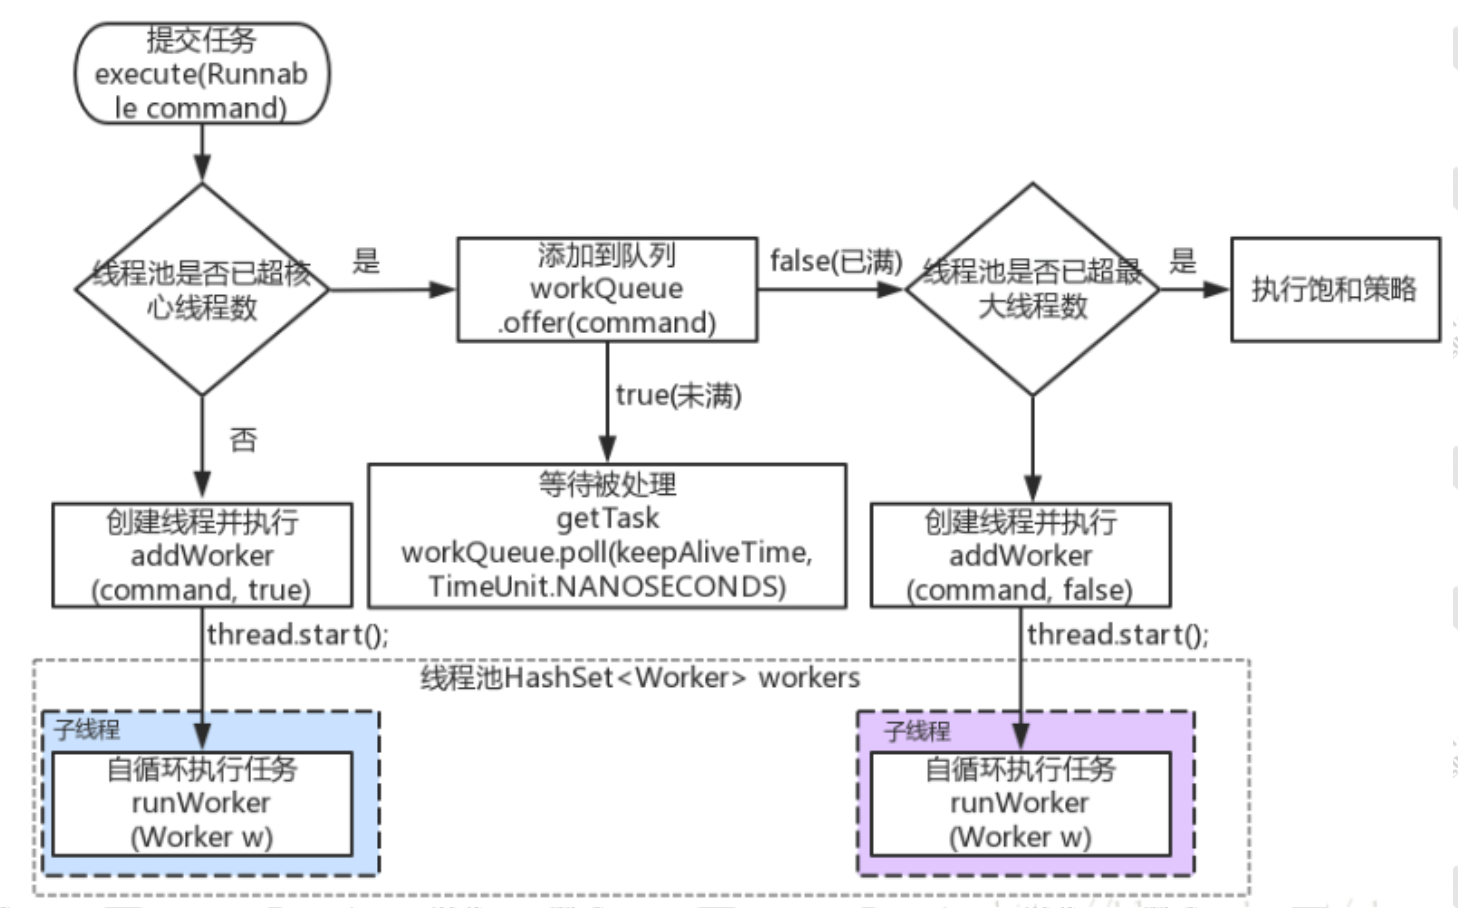
如果线程池中的核心线程数小于核心线程池大小(corePoolSize),则尝试创建新的核心线程来执行任务。
-
如果当前核心线程数已经达到 corePoolSize,则将任务放入任务队列中,等待工作线程获取任务执行。
-
如果队列已满,而且当前线程池中的线程数量小于最大线程池大小(maximumPoolSize),则尝试创建新的非核心线程来执行任务。
-
如果当前线程池中的线程数量已经达到最大线程池大小,则根据拒绝策略进行处理。
-
任务执行完成后,线程池将返回一个 Future 对象,通过这个对象可以获取任务执行的结果。
线程池的执行流程图如下所示。
线程池的状态
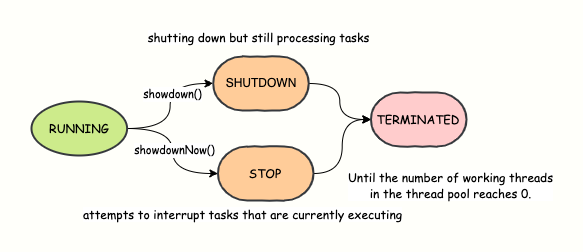
Java 中的线程池具有不同的状态,这些状态反映了线程池在其生命周期中的不同阶段和行为。主要的线程池状态有以下几种:
| 状态 | 描述 |
|---|---|
| RUNNING(运行中) | 表示线程池正在正常运行,并且可以接受新的任务提交。在这种状态下,线程池可以执行任务,并且可以创建新的线程来处理任务。 |
| SHUTDOWN(关闭中) | 表示线程池正在关闭中。在这种状态下,线程池不再接受新的任务提交,但会继续执行已提交的任务,直到所有任务执行完成。 |
| STOP(停止) | 表示线程池已经停止,不再接受新的任务提交,并且尝试中断正在执行的任务。 |
| TERMINATED(终止) | 表示线程池已经终止,不再接受新的任务提交,并且所有任务已经执行完成。在这种状态下,线程池中的所有线程都已经被销毁。 |
这些状态是通过 ThreadPoolExecutor 类中的 ctl(control)字段来维护的,ctl 是一个 AtomicInteger 类型的变量,它的高 3 位表示线程池的运行状态,低 29 位表示线程池中的工作线程数量。
在 ThreadPoolExecutor 中,通过位运算来修改和检查 ctl 的值,以实现线程池状态的转换和管理。
通过 ctl 字段,ThreadPoolExecutor 类能够高效地维护线程池的状态和线程数量信息,从而实现了对线程池的有效管理和控制。
要注意的是,线程池的状态不是直接设置的,而是通过调用 shutdown()、shutdownNow() 等方法触发状态的转换。
例如,调用 shutdown() 方法会将线程池的状态从 RUNNING 转换为 SHUTDOWN。
拒绝策略
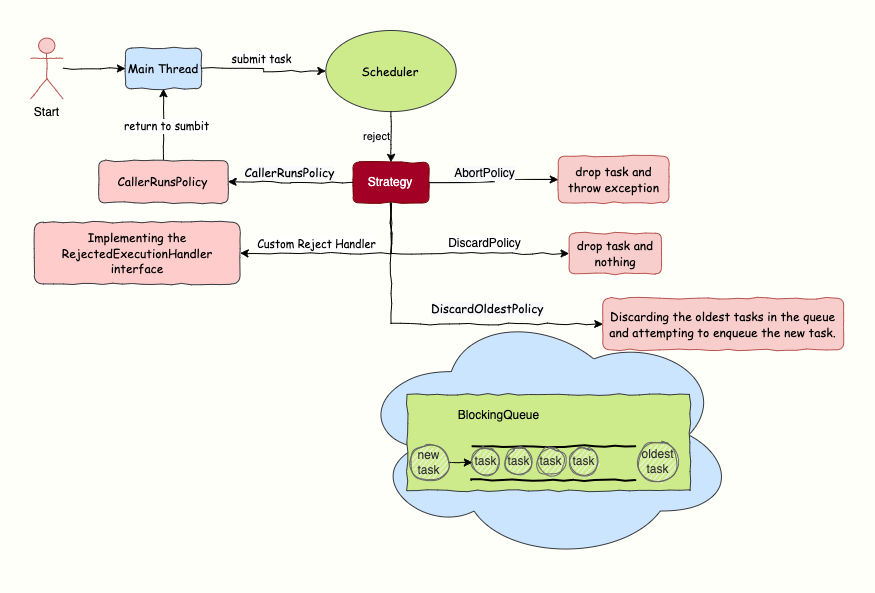
线程池的拒绝策略用于定义当线程池已满并且无法处理新提交的任务时应该采取的行动。以下是 Java 中常见的线程池拒绝策略:
| 策略名称 | 描述 |
|---|---|
| AbortPolicy(默认策略) | 如果线程池已满并且无法接受新任务,则会抛出 RejectedExecutionException 异常。这是默认的拒绝策略。 |
| CallerRunsPolicy | 当线程池已满时,会使用提交任务的线程来执行该任务。换句话说,如果无法接受新任务,则会由提交任务的线程自己执行该任务。 |
| DiscardPolicy | 当线程池已满时,会丢弃掉无法处理的新任务,而不会抛出异常。 |
| DiscardOldestPolicy | 当线程池已满时,会丢弃队列中等待时间最长的任务,然后尝试将新任务加入队列。 |
除了上述标准拒绝策略之外,您还可以实现 RejectedExecutionHandler 接口来定义自定义的拒绝策略。这使您能够根据应用程序的需求实现更复杂的拒绝逻辑。RejectedExecutionHandler 接口:
public interface RejectedExecutionHandler {
    void rejectedExecution(Runnable r, ThreadPoolExecutor executor);
}
提交任务给线程池触发线程池的拒绝策略如下图所示。
线程池使用场景
Java 线程池在业务中有许多实践应用,以下是其中一些常见的实践方式:
-
Web 服务器:用 Tomcat 作为示例。Tomcat 是一个常见的 Java Web 服务器,它使用线程池来处理传入的 HTTP 请求。每当有一个新的 HTTP 请求到达 Tomcat 服务器时,Tomcat 会从预先配置的线程池中获取一个线程来处理该请求。这样可以有效地管理并发请求,提高服务器的响应速度和稳定性。
-
并发任务处理:许多业务场景需要处理大量的并发任务,例如数据处理、文件上传下载、消息处理等。线程池可以用于并发处理这些任务,提高任务的执行效率和系统的吞吐量。
-
异步处理:在某些业务场景中,需要执行一些耗时的操作,但不想让主线程阻塞。线程池可以用于异步执行这些操作,例如发送邮件、短信通知、数据分析等。通过将任务提交给线程池,主线程可以立即返回,而任务会在后台线程中异步执行。
线程池和连接池的区别
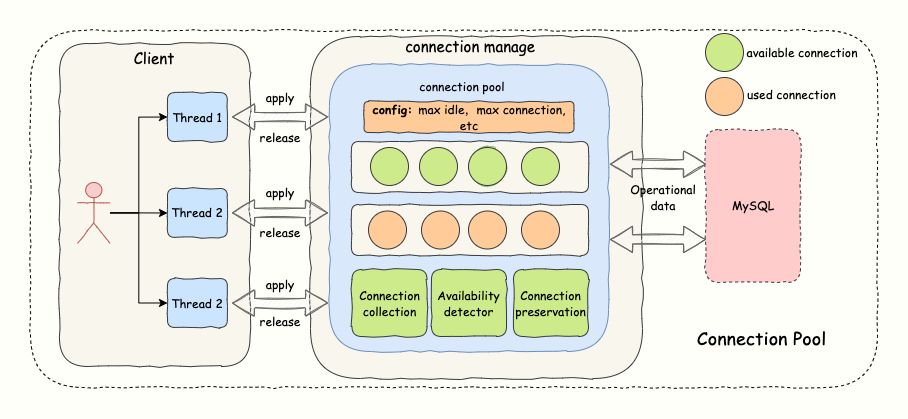
连接池是一组预先初始化和可重复使用的数据库连接。它用于管理到数据库的连接池,允许多个客户端共享和重复使用数据库连接。
连接池有助于通过减少建立和关闭数据库连接的开销来提高数据库密集型应用程序的性能和可伸缩性。
线程池和连接池都是用于提高系统性能和资源利用率的重要技术,但它们的主要区别在于应用场景和管理的资源类型。
线程池用于管理可重复使用的线程资源,以便有效地执行并发任务,而连接池则用于管理可重复使用的数据库连接资源,以便高效地处理数据库访问。
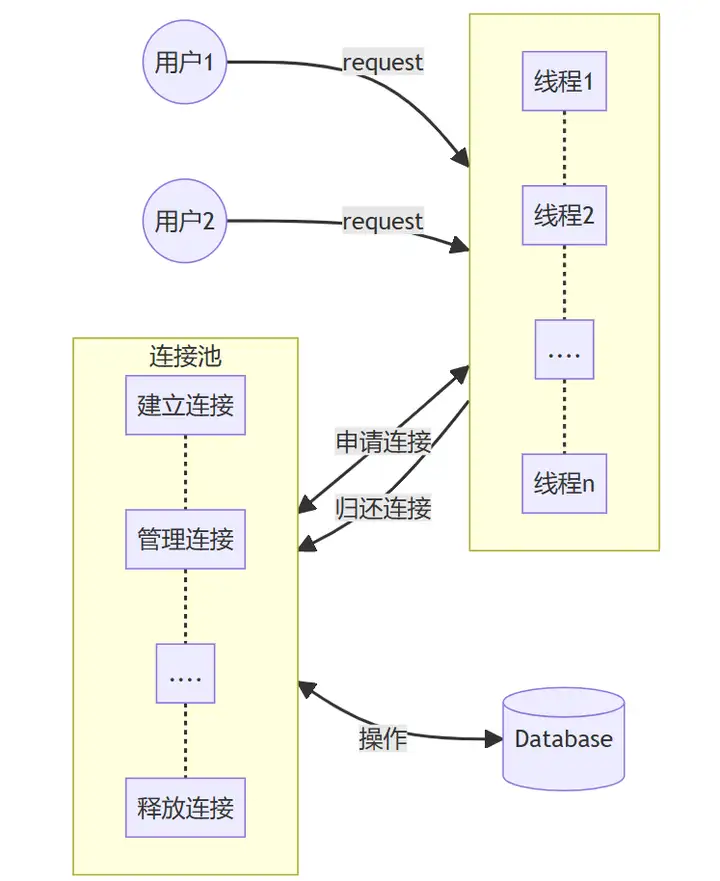
如下图是数据库连接池工作机制。
Java中提供的创建线程池的API
为了方便大家对于线程池的使用,在 Executors 里面提供了几个线程池的工厂方法,这样很多新手就不需要了解太多关于 ThreadPoolExecutor 的知识了,他们只需要直接使用 Executors 的工厂方法,就可以使用线程池。但是作为有目标的青年,还是要了解下里面的概念和坑。
先来解释一下每个参数的作用,稍后我们在分析源码的过程中再来详细了解参数的意义。
public ThreadPoolExecutor(int corePoolSize, // 核心线程数
                          int maximumPoolSize,// 最大线程数
                          long keepAliveTime,// 非核心线程数空闲时,回收时长
                          TimeUnit unit,// 回收时长单位
                          BlockingQueue<Runnable> workQueue,// 阻塞队列
                          RejectedExecutionHandler handler/** 拒绝策略*/) {
    this(corePoolSize, maximumPoolSize, keepAliveTime, unit, workQueue,
            Executors.defaultThreadFactory(), handler);
}
1. FixedThreadPool:
核心线程数=最大线程数,阻塞队列用的是LinkedBlockingQueue(且默认队列长度是Integer.MAX_VALUE),这样的话就造成了阻塞队列是无界队列,不会有非核心线程和拒绝策略。这个线程池执行任务的流程如下:
1. 线程数少于核心线程数(也就是设置的线程数)时,新建线程执行任务;
2. 线程数等于核心线程数后,将任务加入阻塞队列;
3. 由于队列容量非常大,所以可以一直添加;
4. 执行完任务的线程反复去队列中取任务执行;
用途:FixedThreadPool 用于负载比较大的服务器,为了资源的合理利用,需要限制当前线程数量
public static ExecutorService newFixedThreadPool(int nThreads) {
    return new ThreadPoolExecutor(nThreads, nThreads,
            // 不会有非核心线程,所以回收时间间隔为0
            0L, TimeUnit.MILLISECONDS,
            new LinkedBlockingQueue<>());
}
2. CachedThreadPool:
核心线程数为0,然后任务进入SynchronousQueue阻塞队列,最后在由非核心线程来处理其余的任务(在60秒内非核心线程处理完后可以继续服用)。(先来的先做,后来的全部找外包干,来多少活就找多少外包,反正老子有的是钱,结果最后老板跑路,发生了著名的OOM事件)
最大线程数和非核心线程数是Integer.MAX_VALUE,不会有拒绝策略。所有线程执行完任务的线程有 60 秒生存时间,如果在这个时间内可以接到新任务,就可以继续活下去,否则就被回收。
它的执行流程如下:
1. 没有核心线程,直接向 SynchronousQueue 中提交任务
2. 如果有空闲的非核心线程,就去取出任务执行;如果没有空闲的非核心线程,就新建一个
3. 执行完任务的非核心线程有 60 秒生存时间,如果在这个时间内可以接到新任务,就可以继续活下去,否则就被回收
/*
 * 核心线程数为0(没有核心线程,直接向 SynchronousQueue 中提交任务),
 * 最大线程数是Integer.MAX_VALUE,不会有拒绝策略,导致大量线程的创建出现 CPU 使用过高或者 OOM 的问题
 * 执行完任务的线程有 60 秒生存时间,如果在这个时间内可以接到新任务,就可以继续活下去,否则就被回收
 */
public static ExecutorService newCachedThreadPool() {
    return new ThreadPoolExecutor(0, Integer.MAX_VALUE,
            60L, TimeUnit.SECONDS,
            new SynchronousQueue<>());
}
3. newSingleThreadExecutor():
核心线程数=最大线程数=1,使用无界阻塞队列。(老子就一个人,慢慢做,先来先做,后来的全部去排队)
public static ExecutorService newSingleThreadExecutor() {
    return new FinalizableDelegatedExecutorService
            (new ThreadPoolExecutor(1, 1,
                    0L, TimeUnit.MILLISECONDS,
                    new LinkedBlockingQueue<Runnable>()));
}
FixedThreadPool线程池的实现原理分析:
我们先看下线程池原理分析(FixedThreadPool)。
举个例子:好比现在有家宾馆,一共有500个床位(核心线程数),200个预约名额(阻塞队列),外加100个临时床位以备不时之需(临时线程数)。好了,现在宾馆开业,先来了300个客人,OK,直接搞定。后来又来了300个客人,这下搞了,其中200个客人直接搞定,还有100个客人呢?我那100个临时床位可是以备不时之需的,先不给他们,这100个客人给我排队预约(进入阻塞队列),后来又TM来了200个客人,这200个客人中有100个我可以让他们去预约排队,那还剩下100个人呢,我只得操家伙拿出压箱底的那100个临时床位来伺候了,那如果后面在来客人怎么办?拒绝策略伺候!!!!!
这个例子大致意思描述对了,但是里面还是有些不准确的地方,线程池默认初始化时,里面是没有现成的,而例子中宾馆刚开业其实已经准备好床位了。但是这点不影响大家理解,凑活着用呗。
源码分析:
ThreadPoolExecutor的execute()方法:
/**
* !!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!
* 线程池初始化时是没有创建线程的,线程池里的线程的初始化与其他线程一样,但是在完成任务以后,该线程不会自行销毁,
* 而是以挂起的状态返回到线程池。直到应用程序再次向线程池发出请求时,线程池里挂起的线程就会再度激活执行任务。
* 这样既节省了建立线程所造成的性能损耗,也可以让多个任务反复重用同一线程,从而在应用程序生存期内节约大量开销
*
* 默认情况下,创建线程池之后,线程池中是没有线程的,需要提交任务之后才会创建线程。
* 在实际中如果需要线程池创建之后立即创建线程,可以通过以下两个方法办到:
* prestartCoreThread():初始化一个核心线程
* prestartAllCoreThreads():初始化所有核心线程
* !!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!
*/
public void execute(Runnable command) {
  if (command == null)
    throw new NullPointerException();

  int c = ctl.get();

  // 1.当前池中线程比核心数少,新建一个线程执行任务
  if (workerCountOf(c) < corePoolSize) {
    // 创建新的线程并执行任务,如果成功就返回
    if (addWorker(command, true))
      return;
    c = ctl.get();
  }

  // 2.核心池已满但任务队列未满,将任务添加到队列中
  if (isRunning(c) && workQueue.offer(command)) {
    //重新获取ctl
    int recheck = ctl.get();
    //任务成功添加到队列以后,再次检查是否需要添加新的线程,因为已存在的线程可能被销毁了
    //如果线程池处于非运行状态,并且把当前的任务从任务队列中移除成功,则拒绝该任务
    if (!isRunning(recheck) && remove(command))
      reject(command);
    //如果之前的线程已被销毁完,新建一个线程
    else if (workerCountOf(recheck) == 0)
      addWorker(null, false);
  /*
  * 如果执行到这里,有两种情况:
  * 1. 线程池已经不是RUNNING状态;
  * 2. 线程池是RUNNING状态,但workerCount >= corePoolSize并且workQueue已满。
  */
  } else if (!addWorker(command, false))
    // 如果线程池是非RUNNING状态或者加入阻塞队列失败,则尝试创建新非核心线程(外包)直到maxPoolSize
    // 创建非核心线程失败,则启动拒绝策略
    reject(command);
}
其中ctl就是一个AutomicInteger的变量,用于存储线程数量(低29位)和线程池的状态(高3位)。
线程池状态如下:
/**
 * 即高3位为111,该状态的线程池会接收新任务,并处理阻塞队列中的任务;
 * 111 0 0000 0000 0000 0000 0000 0000 0000
 * -1 原码:0000 ... 0001 反码:1111 ... 1110 补码:1111 ... 1111
 * 左移操作:后面补 0
 * 111 0 0000 0000 0000 0000 0000 0000 0000
 */
private static final int RUNNING = -1 << COUNT_BITS;
/**
 * 即高3位为000,该状态的线程池不会接收新任务,但会处理阻塞队列中的任务;
 * 000 0 0000 0000 0000 0000 0000 0000 0000
 */
private static final int SHUTDOWN = 0 << COUNT_BITS;
/**
 * 即高3位为001,该状态的线程不会接收新任务,也不会处理阻塞队列中的任务,而且会中断正在运行的任务;
 * 001 0 0000 0000 0000 0000 0000 0000 0000
 */
private static final int STOP = 1 << COUNT_BITS;
/**
 * 即高3位为010,所有任务都已终止,workerCount为零,过渡到状态TIDYING的线程将运行terminated()钩子方法;
 * 010 0 0000 0000 0000 0000 0000 0000 0000
 */
private static final int TIDYING = 2 << COUNT_BITS;
/**
 * 即高3位为011,terminated()方法执行完毕;
 * 011 0 0000 0000 0000 0000 0000 0000 0000
 */
private static final int TERMINATED = 3 << COUNT_BITS;
ThreadPoolExecutor的addWorker():
1)采用循环 CAS 操作来将线程数加 1;
2)新建一个线程并启用;
/**
 * firstTask参数用于表示怎么获取线程处理的任务,true为传入的任务,false表示从阻塞队列获取任务
 * core参数为true表示在新增线程时会判断当前活动线程数是否少于corePoolSize,
 * false表示新增线程前需要判断当前活动线程数是否少于maximumPoolSize
 */
private boolean addWorker(Runnable firstTask, boolean core) {
    // 内嵌循环,通过CAS worker + 1
    retry:
    for (; ; ) {
        // 获取当前线程池状态与线程数
        int c = ctl.get();
        // 获取当前线程状态
        int rs = runStateOf(c);

        // Check if queue empty only if necessary.
        /**
         * 这个if判断
         * 如果线程池处于SHUTDOWN,STOP,TIDYING,TERMINATED的时候,则表示此时不再接收新任务;
         * 接着判断以下3个条件,只要有1个不满足,则返回false:
         * 1. rs == SHUTDOWN,这时表示关闭状态,不再接受新提交的任务,但却可以继续处理阻塞队列中已保存的任务
         * 2. firsTask为空
         * 3. 阻塞队列不为空
         *
         * 首先考虑rs == SHUTDOWN的情况
         * 这种情况下不会接受新提交的任务,所以在firstTask不为空的时候会返回false;
         * 然后,如果firstTask为空,并且workQueue也为空,则返回false,
         * 因为队列中已经没有任务了,不需要再添加线程了
         */
        if (rs >= SHUTDOWN &&
                !(rs == SHUTDOWN &&
                        // 不在接受新的任务
                        firstTask == null &&
                        // 队列中已经没有任务了,不需要再添加线程了
                        !workQueue.isEmpty()))
            return false;
        // 增加工作线程数
        for (; ; ) {
            // 线程数量
            int wc = workerCountOf(c);
            // 如果当前线程数大于线程最大上限CAPACITY  return false
            // 创建核心线程则与 corePoolSize 比较,否则与 maximumPoolSize 比较
            if (wc >= CAPACITY ||
                    wc >= (core ? corePoolSize : maximumPoolSize))
                return false;
            // 尝试增加workerCount,如果成功,则跳出第一个for循环
            if (compareAndIncrementWorkerCount(c))
                break retry;
            c = ctl.get();  // Re-read ctl
            if (runStateOf(c) != rs)
                continue retry;
            // else CAS failed due to workerCount change; retry inner loop
        }
    }

    // 创建一个新的线程并执行
    boolean workerStarted = false;
    boolean workerAdded = false;
    Worker w = null;
    try {
        final ReentrantLock mainLock = this.mainLock;
        // 新建线程,将线程封装成Worker
        w = new Worker(firstTask);
        // 每一个Worker对象都会创建一个线程
        final Thread t = w.thread;
        if (t != null) {
            // 将任务添加到workers Queue中
            mainLock.lock();
            try {
                // Recheck while holding lock.
                // Back out on ThreadFactory failure or if
                // shut down before lock acquired.
                int c = ctl.get();
                // 线程池状态
                int rs = runStateOf(c);

                // rs < SHUTDOWN表示是RUNNING状态;
                if (rs < SHUTDOWN ||
                        // rs是SHUTDOWN状态并且firstTask为null,向线程池中添加线程。
                        // 因为在SHUTDOWN时不会在添加新的任务,但还是会执行workQueue中的任务
                        (rs == SHUTDOWN && firstTask == null)) {
                    // 当前线程已经启动,抛出异常
                    if (t.isAlive()) // precheck that t is startable
                        throw new IllegalThreadStateException();
                    // workers是一个HashSet<Worker>
                    workers.add(w);
                    // 设置最大的池大小largestPoolSize,workerAdded设置为true
                    int s = workers.size();
                    if (s > largestPoolSize)
                        largestPoolSize = s;
                    workerAdded = true;
                }
            } finally {
                mainLock.unlock();
            }
            // 启动线程
            if (workerAdded) {
                // 启动时会调用Worker类中的run方法,Worker本身实现了Runnable接口,所以一个Worker类型的对象也是一个线程
                t.start();
                workerStarted = true;
            }
        }
    } finally {
        // 线程启动失败
        if (!workerStarted)
            addWorkerFailed(w);
    }
    return workerStarted;
}
Worker 类说明1. 每个worker,都是一条线程,同时里面包含了一个firstTask,即初始化时要被首先执行的任务;2. 最终执行任务的,是 runWorker()方法;
Worker 类继承了 AQS并实现了 Runnable 接口,注意其中的 firstTask 和 thread 属性:
firstTask 用它来保存传入的任务;thread 是在调用构造方法时通过 ThreadFactory 来创建的线程,是用来处理任务的线程。
在调用构造方法时,需要传入任务,这里通过 getThreadFactory().newThread(this) 来新建一个线程,newThread 方法传入的参数是 this,因为 Worker 本身继承了 Runnable 接口,所以一个 Worker 对象在启动的时候会调用 Worker 类中的 run 方法。
/**
 * 1. 如果 task 不为空,则开始执行 task
 * 2. 如果 task 为空则通过 getTask()再去取任务,并赋值给 task;如果取到的 Runnable 不为空则执行该任务
 * 3. 执行完毕后,通过 while 循环继续 getTask()取任务
 * 4. 如果 getTask()取到的任务依然是空,那么整个 runWorker()方法执行完毕
 */
final void runWorker(Worker w) {
    // 获取当前线程
    Thread wt = Thread.currentThread();
    // 获取第一个任务
    Runnable task = w.firstTask;
    w.firstTask = null;
    // 释放锁,运行中断
    w.unlock(); // allow interrupts
    //是否突然完成,如果是由于异常导致的进入finally,那么completedAbruptly==true就是突然完成的
    boolean completedAbruptly = true;
    try {
        // 调用getTask()方法从阻塞队列中获取新任务,如果阻塞队列为空则根据是否超时来判断是否需要阻塞
        while (task != null || (task = getTask()) != null) {
            /**
             * !!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!
             * 上锁,不是为了防止并发执行任务,为了在shutdown()时不终止正在运行的 worker
             * !!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!
             */
            w.lock();
            /**
             * 如果线程池正在停止,那么要保证当前线程是中断状态;
             * 如果不是的话,则要保证当前线程不是中断状态;
             */
            if ((runStateAtLeast(ctl.get(), STOP) ||
                    /**
                     * 线程池为 stop 状态时不接受新任务,不执行已经加入任务队列的任务,还中断正在执
                     * 行的任务,所以对于 stop 状态以上是要中断线程的
                     */
                    (Thread.interrupted() &&
                            runStateAtLeast(ctl.get(), STOP))) &&
                    !wt.isInterrupted())
                // 设置中断标志
                wt.interrupt();
            try {
                //自定义实现
                beforeExecute(wt, task);
                Throwable thrown = null;
                try {
                    // 执行任务
                    task.run();
                } catch (RuntimeException x) {
                    thrown = x;
                    throw x;
                } catch (Error x) {
                    thrown = x;
                    throw x;
                } catch (Throwable x) {
                    thrown = x;
                    throw new Error(x);
                } finally {
                    //自定义实现
                    afterExecute(task, thrown);
                }
            } finally {
                task = null;
                // 完成任务数 + 1
                w.completedTasks++;
                // 释放锁
                w.unlock();
            }
        }
        completedAbruptly = false;
    } finally {
        // 获取不到任务时,主动回收自己
        // 线程回收的工作是在processWorkerExit方法完成的
        processWorkerExit(w, completedAbruptly);
    }
}
连接池
连接池技术是一种简单而强大的方法,可用于加速数据库访问。在传统的数据库访问过程中,每次与数据库建立连接和关闭连接都需要耗费大量的时间和资源。而连接池技术通过事先建立一组可重复使用的数据库连接,有效地减少了连接和关闭连接的开销。本文将深入探讨连接池技术的工作原理和优势,以及如何正确配置和使用连接池来提高应用程序的性能。无论你是开发人员还是系统管理员,通过了解连接池技术,你将能够更好地利用数据库资源,使系统更加稳定和高效。
一、为什么需要连接池?
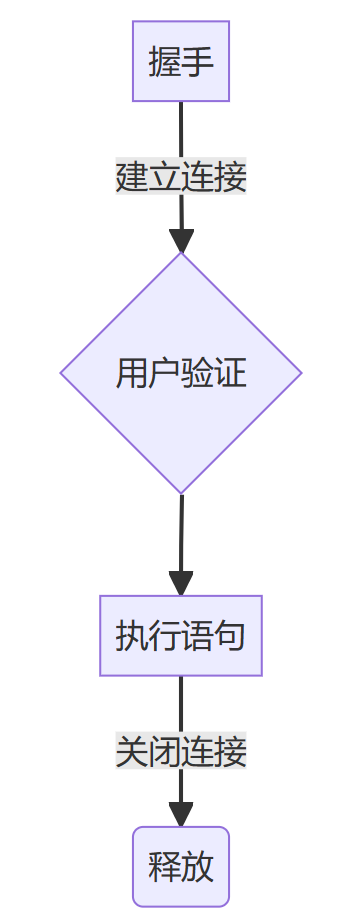
以操作数据库为例,当一个数据库操作任务到来时,程序需要和数据库建立连接,进行三次握手、数据库用户验证,然后执行SQL语句,最后用户退出、四次挥手关闭连接。每次任务都执行这样的流程,那么整个流程中,真正有效而且变化的只有<执行SQL语句>这一步骤,而且每次建立连接、用户验证、关闭连接都耗费时间。
因此,考虑能不能将连接只创建一次,然后复用长连接执行 SQL 语句呢?这需要连接池技术。
二、池化技术
池化技术可以减少资源对象的创建次数,提高程序的响应性能,特别是对高并发场景下的性能提升非常明显。
适合使用池化技术缓存的资源对象具有如下特点:
(1)对象创建时间长;
(2)对象创建需要大量的资源;
(3)对象创建后可以重复使用。
比如常见的线程池、‘内存池、连接池、对象池等都具有以上的特点。
三、数据库连接池
定义:
数据库连接池是程序启动时建立足够的数据库连接,并将这些连接组成一个连接池,由程序动态的对池中的连接进行申请、使用、归还。
创建数据库连接是一个很耗时的操作,而且容易容易对数据库造成安全隐患。因此,程序初始化的时候,创建足够的数据库连接,并把它们集中管理,提供给程序使用,可以保证较快的数据库读写速度。
数据库连接池的优点:
(1)资源复用。避免了频繁的创建、释放连接引起的性能开销,减少系统消耗,增进系统运行环境的稳定(减少内存碎片和数据库临时线程/进程数量)。
(2)更快的系统响应速度。数据库连接池初始化完成后,直接利用现有可用连接,避免了从数据库连接初始化和释放过程的开销,从而缩减了系统整体响应时间。
(3)统一的连接管理,避免数据库连接泄漏。数据库连接池实现中,可根据预先的连接占用超时设定,强制收回被占用连接。从而避免了常规数据库连接操作中可能出现的资源泄露。
3.1、不使用连接池
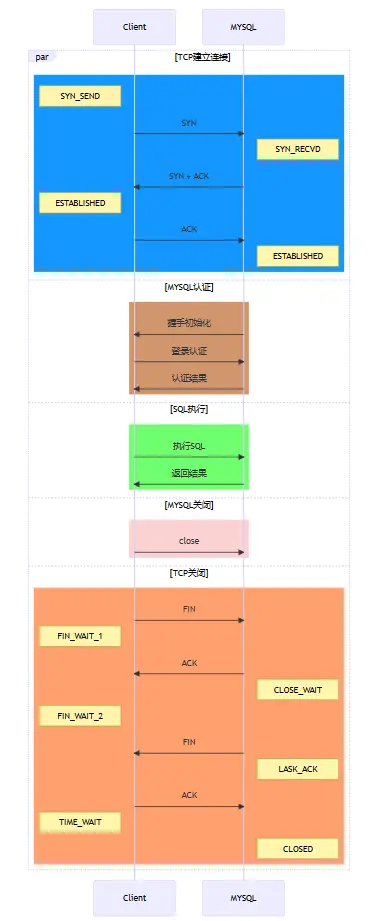
可以看出,为了执行一条SQL语句,需要进行TCP三次握手、MYSQL认证、MYSQL关闭、TCP四次挥手等操作,执行SQL操作在所有的操作中占比非常低。
这种实现方式的缺点:
(1)网络IO较多。
(2)带宽利用率低。
(3)QPS较低。
(4)频繁创建连接和关闭连接,导致临时对象较多,产生更多的内存碎片。
(5)关闭连接后出现大量TIME_WAIT的TCP状态。
这种实现方式的优点:实现简单,不需要设计连接池。
3.2、使用连接池
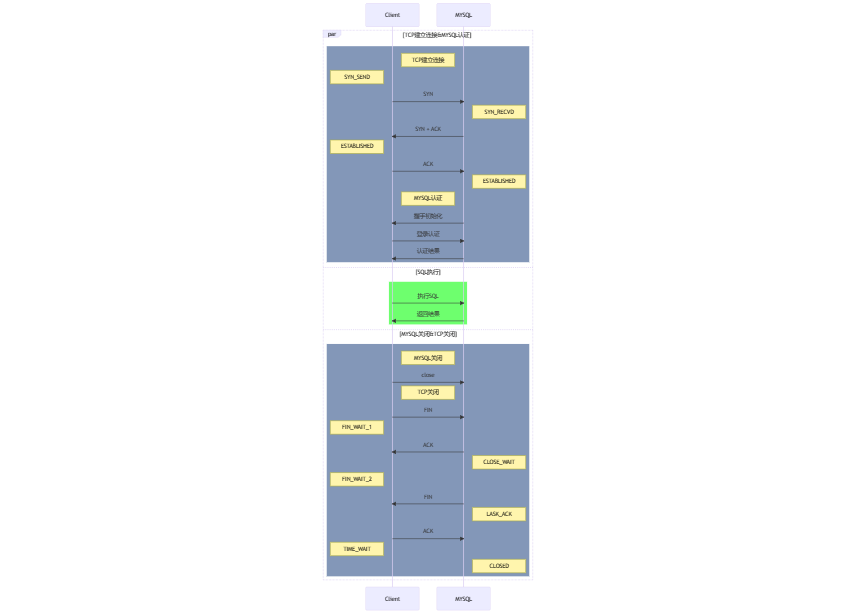
程序初始化的时候建立连接,之后的访问复用之前创建的连接,直接执行SQL语句。
优点:
(1)降低网络开销。
(2)连接复用。减少连接次数。
(3)提升性能。避免了频繁的创建连接。
(4)没有TIME_WAIT状态问题。
缺点:设计较为复杂。
3.3、长连接和连接池的区别
(1)长连接是一些驱动、驱动架构、ORM(即Object-Relational Mapping)工具的特性,由驱动来保持连接句柄的打开,以便后续的数据库操作可以重用连接,从而减少数据库的连接开销。
(2)连接池是应用服务器的组件,它可以通过参数来配置连接数、连接检查、连接的生命周期等。
(3)连接池内的连接,其实就是长连接。
如果每个任务线程绑定一个连接,而有些任务是不需要操作数据库的,这就不利于参入参数的解耦,降低性能。
3.4、 数据库连接池运行机制
(1)从连接池获取或创建可用连接;
(2)使用完毕,把连接返回给连接池。
(3)系统关闭前,断开所有连接并释放连接占用的系统资源。
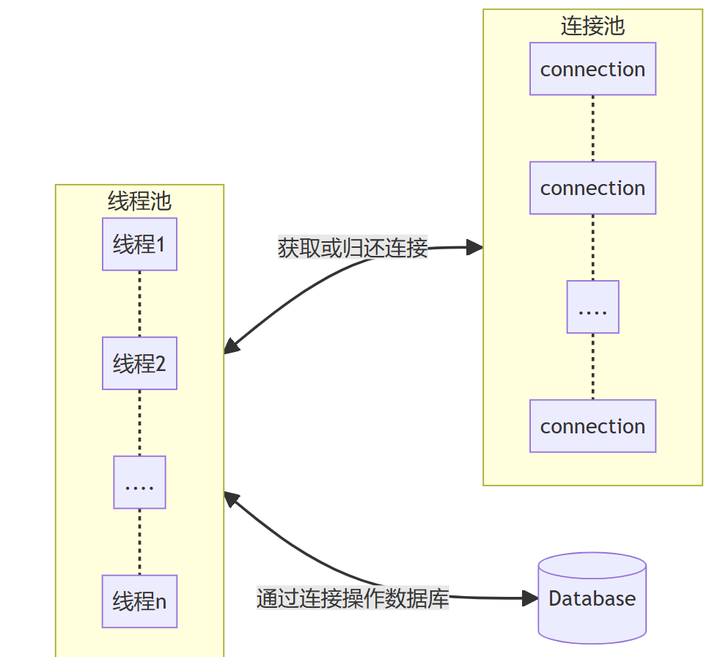
四、连接池和线程池的关系
线程池:主动操作,主动获取任务并执行任务。
连接池:被动操作,池内的对象被任务获取,任务执行完成后归还。
4.1、连接池和线程池的区别
线程池:主动调用任务。当任务队列不为空时从队列取出任务并执行。
连接池:被任务使用,被动取出。当某任务需要操作数据库时从连接池取出一个连接对象;当任务使用完连接对象后,将该连接对象放回到连接池中;如果连接池中没有连接对象可用,那么该任务就必须等待。
4.2、连接池和线程池设置数量的关系
(1)一般,连接池连接对象数量和线程池数量一致。
(2)线程使用完连接对象后归还连接对象到连接池。
五、Ubuntu使用MySQL
(1)安装mysql-server
sudo apt-get install mysql-server(2)初始配置MySQL
使用root账户登录,注意这个账户是默认没有密码的。为了数据库的安全,需要第一时间给root用户设置密码。
# 切换系统账户,$
sudo su
# 进入mysql,#
mysql
# 查看用户表,mysql>
select user, plugin from mysql.user;
# 修改root密码,mysql>
update mysql.user set authentication_string=PASSWORD('123456'), plugin='mysql_native_password' where user='root';
# 刷新,mysql>
flush privileges;
# 退出mysql,mysql>
exit
# 重启服务,#
service mysql restart
(3)安装MySQL库,用于编程
sudo apt-get install libmysqlclient-dev(4)创建一个数据库
# 创建mysql_pool_test的数据库,mysql>
create database mysql_pool_test;
# 查看所有数据库,mysql>
show databases;
(5)MySQL提示“too many connections“的解决方法
# 查看最大连接数。mysql>
show variables like "max_connections";
# 结果显示如下:
# mysql> show variables like "max_connections";
# +-----------------+-------+
# | Variable_name   | Value |
# +-----------------+-------+
# | max_connections | 151   |
# +-----------------+-------+
# 1 row in set (0.00 sec)
#
# 默认连接数量这里只有151,可以根据自己需要修改。比如可以临时设置为1000
set GLOBAL max_connections=1000;
六、连接池设计要点
使用连接池,需要预先建立数据库连接。
(1)连接到数据库,涉及数据库IP、端口、用户名、密码、数据库名称等;
a. 连接操作,每个连接对象都是独立的连接通道
b. 配置最小连接数和最大连接数
(2)需要一个队列管理它的连接;
(3)获取连接对象;
(4)归还连接对象;
(5)连接池的名称。不同的业务可以设计不同的连接池,比如聊天工具中的一对一聊天和群组聊天分别对应不同的连接池。
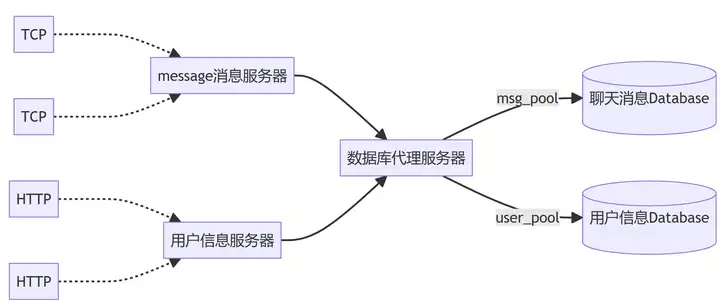
6.1、设计逻辑
(1)构造函数
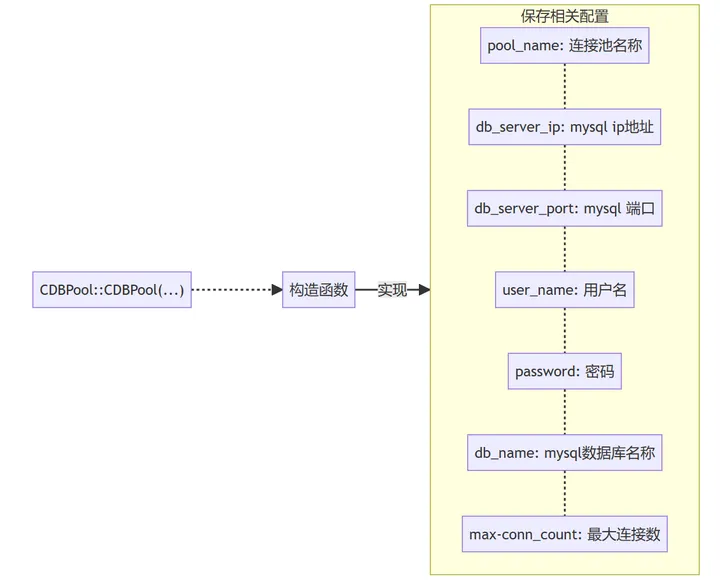
CDBPool::CDBPool(
const char *pool_name,
const char *db_server_ip,
uint16_t db_server_port,
const char *username,
const char *password,
const char *db_name,
int max_conn_cnt)
{
	m_pool_name = pool_name;
	m_db_server_ip = db_server_ip;
	m_db_server_port = db_server_port;
	m_username = username;
	m_password = password;
	m_db_name = db_name;
	m_db_max_conn_cnt = max_conn_cnt;	//
	m_db_cur_conn_cnt = MIN_DB_CONN_CNT; // 最小连接数量
}
(2)初始化
一般,构造函数和初始化函数分开来,构造函数一般做保存数据这种不会发生错误的操作,而初始化函数做一些比较复杂,可能伴随错误返回的操作(比如申请内存)。因为构造函数不会返回,如果构造函数内有错误产生,需要在外部进行异常捕获,异常捕获的开销是巨大的,所以一般不这么做。
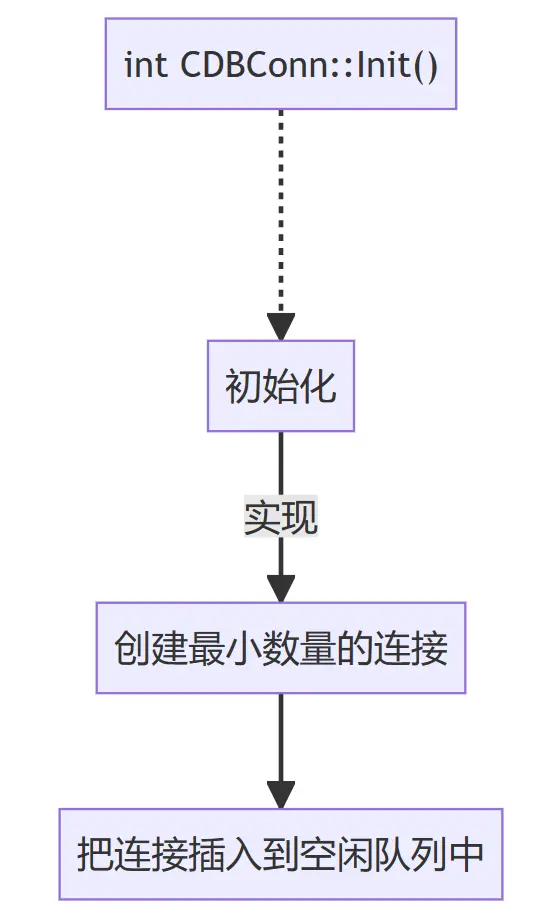
// 连接对象初始化
int CDBConn::Init()
{
	m_mysql = mysql_init(NULL);	// mysql_标准的mysql c client对应的api
	if (!m_mysql)
	{
		log_error("mysql_init failed\n");
		return 1;
	}

	my_bool reconnect = true;
	mysql_options(m_mysql, MYSQL_OPT_RECONNECT, &reconnect);	// 配合mysql_ping实现自动重连
	mysql_options(m_mysql, MYSQL_SET_CHARSET_NAME, "utf8mb4");	// 设置字符集,utf8mb4和utf8区别

	// ip 端口 用户名 密码 数据库名
	if (!mysql_real_connect(m_mysql, m_pDBPool->GetDBServerIP(), m_pDBPool->GetUsername(), m_pDBPool->GetPasswrod(),
							m_pDBPool->GetDBName(), m_pDBPool->GetDBServerPort(), NULL, 0))
	{
		log_error("mysql_real_connect failed: %s\n", mysql_error(m_mysql));
		return 2;
	}

	return 0;
}
// 连接对象的构造函数
CDBConn::CDBConn(CDBPool *pPool)
{
	m_pDBPool = pPool;
	m_mysql = NULL;
}
// 连接对象的析构函数
CDBConn::~CDBConn()
{
	if (m_mysql)
	{
		mysql_close(m_mysql);
	}
}
// ......

// pool 初始化
int CDBPool::Init()
{
	// 创建固定最小的连接数量
	for (int i = 0; i < m_db_cur_conn_cnt; i++)
	{
		CDBConn *pDBConn = new CDBConn(this);//新建一个连接
		int ret = pDBConn->Init();// 初始化连接
		if (ret)
		{
			delete pDBConn;
			return ret;// 失败返回
		}

		m_free_list.push_back(pDBConn);// 将连接对象放入到容器中管理
	}
	return 0;
}
注意utf8和utf8mb4的区别。在mysql中utf8不是真正的utf8,它只支持三个字节的Unicode,不支持四字节的Unicode;只有utf8mb4支持复杂的字符。这对乱码的解决很重要。
(3)请求获取连接
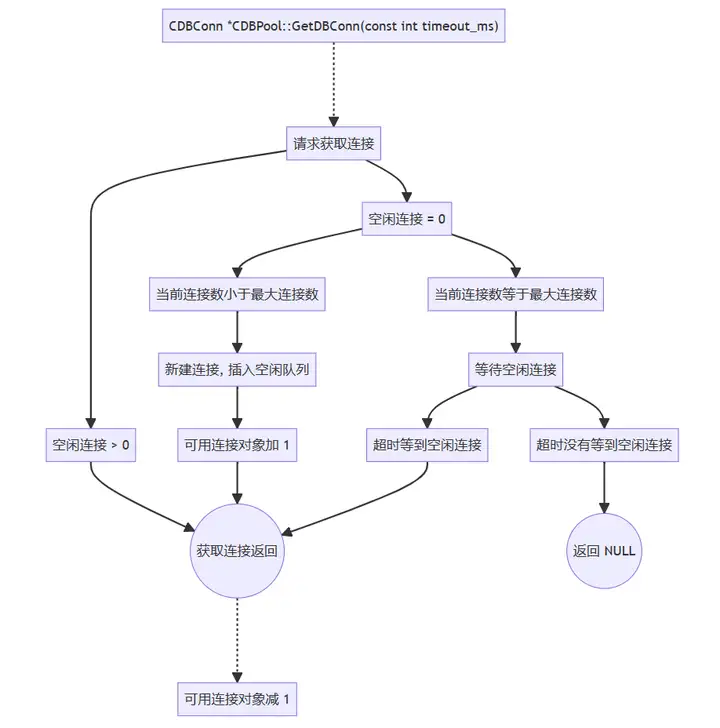
/*
 *TODO: 增加保护机制,把分配的连接加入另一个队列,这样获取连接时,如果没有空闲连接,
 *TODO: 检查已经分配的连接多久没有返回,如果超过一定时间,则自动收回连接,放在用户忘了调用释放连接的接口
 * timeout_ms默认为 0死等
 * timeout_ms >0 则为等待的时间
 */
CDBConn *CDBPool::GetDBConn(const int timeout_ms)
{
	std::unique_lock<std::mutex> lock(m_mutex);
	if(m_abort_request)
	{
		log_warn("have aboort\n");
		return NULL;
	}

	if (m_free_list.empty())		// 当没有连接可以用时
	{
		// 第一步先检测 当前连接数量是否达到最大的连接数量
		if (m_db_cur_conn_cnt >= m_db_max_conn_cnt)
		{
			// 如果已经到达了,看看是否需要超时等待
			if(timeout_ms <= 0)		// 死等,直到有连接可以用 或者 连接池要退出
			{
				log_info("wait ms:%d\n", timeout_ms);
				m_cond_var.wait(lock, [this]
				{
					// 当前连接数量小于最大连接数量 或者请求释放连接池时退出
					return (!m_free_list.empty()) | m_abort_request;
				});
			} else {
				// return如果返回 false,继续wait(或者超时),  如果返回true退出wait
				// 1.m_free_list不为空
				// 2.超时退出
				// 3. m_abort_request被置为true,要释放整个连接池
				m_cond_var.wait_for(lock, std::chrono::milliseconds(timeout_ms), [this] {
					// log_info("wait_for:%d, size:%d\n", wait_cout++, m_free_list.size());
					return (!m_free_list.empty()) | m_abort_request;
				});
				// 带超时功能时还要判断是否为空
				if(m_free_list.empty()) 	// 如果连接池还是没有空闲则退出
				{
					return NULL;
				}
			}

			if(m_abort_request)
			{
				log_warn("have aboort\n");
				return NULL;
			}
		}
		else // 还没有到最大连接则创建连接
		{
			CDBConn *pDBConn = new CDBConn(this);	//新建连接
			int ret = pDBConn->Init();
			if (ret)
			{
				log_error("Init DBConnecton failed\n\n");
				delete pDBConn;
				return NULL;
			}
			else
			{
				m_free_list.push_back(pDBConn);
				m_db_cur_conn_cnt++;
			}
		}
	}

	CDBConn *pConn = m_free_list.front();	// 获取连接
	m_free_list.pop_front();	// STL 吐出连接,从空闲队列删除

	return pConn;
}
(4)归还连接
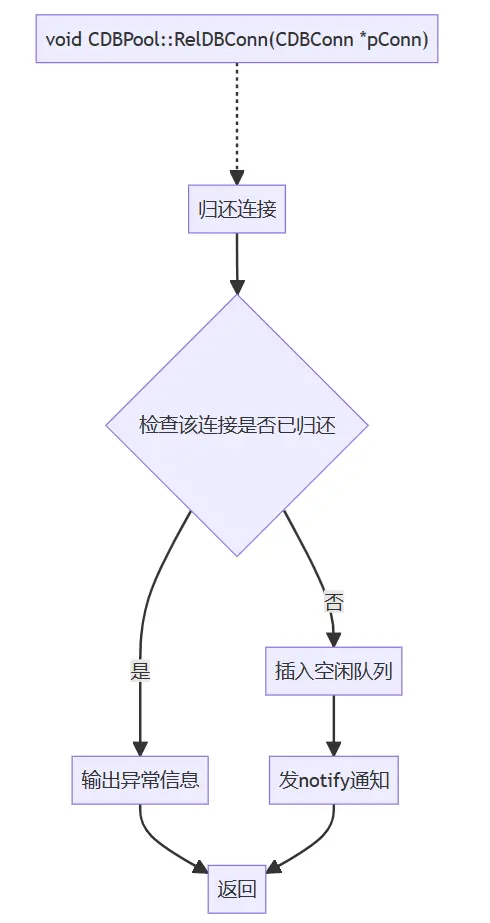
void CDBPool::RelDBConn(CDBConn *pConn)
{
	std::lock_guard<std::mutex> lock(m_mutex);

	list<CDBConn *>::iterator it = m_free_list.begin();
	for (; it != m_free_list.end(); it++)	// 避免重复归还
	{
		if (*it == pConn)
		{
			break;
		}
	}

	if (it == m_free_list.end())
	{
		m_free_list.push_back(pConn);
		m_cond_var.notify_one();		// 通知取队列
	} else
	{
		log_error("RelDBConn failed\n");
	}
}
(5)析构连接池:释放连接
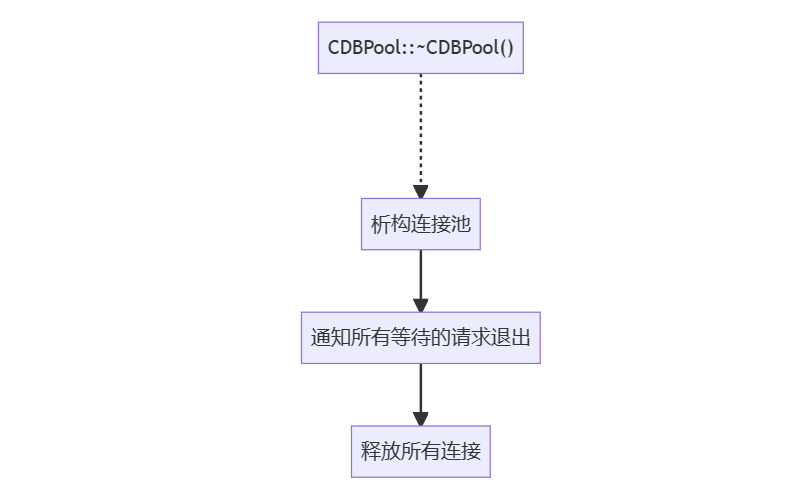
// 释放连接池
CDBPool::~CDBPool()
{
	std::lock_guard<std::mutex> lock(m_mutex);
	m_abort_request = true;
	m_cond_var.notify_all();		// 通知所有在等待的

	for (list<CDBConn *>::iterator it = m_free_list.begin(); it != m_free_list.end(); it++)
	{
		CDBConn *pConn = *it;
		delete pConn;
	}

	m_free_list.clear();
}
6.2、MySQL连接重连机制
(1)设置启用自动重连
连接的时候设置自动重连参数,当发现连接断开时会自动重连。
my_bool reconnect = true;
mysql_options(m_mysql, MYSQL_OPT_RECONNECT, &reconnect);	// 配合mysql_ping实现自动重连
(2)检测连接是否正常
函数原型:
int STDCALL mysql_ping(MYSQL *mysql);
检查与服务器的连接是否正常。连接断开时,如果自动重连功能开启,则尝试重新连接数据库服务器。该函数可被客户端用来检测闲置许久以后,与服务端的连接是否关闭,如有需要,则重新连接。
返回值:
- 连接正常,返回0;
- 如有错误发生,则返回非0值。返回非0值并不意味着服务器本身关闭掉,也有可能是网络原因导致网络不通。
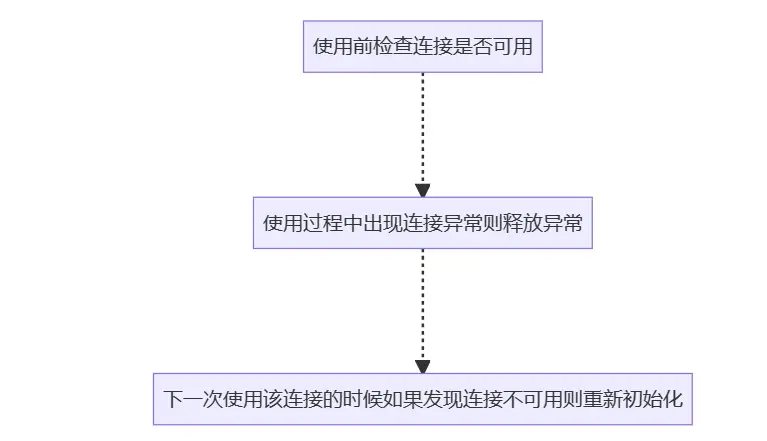
6.3、redis连接重连机制
七、连接池连接数量设置
(1)经验公式,连接数=(核心数*2)+有效磁盘数。
假如服务器CPU是i7的8核,那么连接池连接数大小为 8∗2+1=9 。这仅仅是一个经验公式,具体的还要和线程池数量以及具体业务结合在一起。
- CPU总核数 = 物理CPU个数 * 每颗物理CPU的核数
- 总逻辑CPU数 = 物理CPU个数 * 每颗物理CPU的核数 * 超线程数
(2)IO密集型任务。
如果任务整体上是一个IO密集型的任务。在处理一个请求的过程中(处理一个任务),总共耗时100+5=105ms,而其中只有5ms是用于计算操作的(消耗cpu),另外的100ms等待io响应,CPU利用率为5/(100+5)。
使用线程池是为了尽量提高CPU的利用率,减少对CPU资源的浪费,假设以100%的CPU利用率来说,要达到100%的CPU利用率,对于一个CPU就要设置其利用率的倒数个数的线程数,也即1/(5/(100+5))=21,4个CPU的话就乘以4,即84,这个时候线程池要设置84个线程数,然后连接池也是设置为84个连接。
八、连接池扩展
对连接池进行相关的监控,比较著名的是阿里开源的druid连接池,可以研究下druid连接池的设计理念,扩展对连接池的理解。比如:
(1)最大连接时间=归还时间-请求时间。如果最大连接时间超出的知道时间,打印警告信息等。这需要设计一个结构体,在请求连接的时候记录请求时间,归还的时候记录归还时间。
(2)统计每秒请求连接的次数。
(3)可能连接没有归还,造成程序异常,可以考虑添加定时检测,超时没有归还是打印警告,或者销毁连接重新创建连接放入连接池中;这依赖于业务需求。
连接池总结
(1)使用连接池主要是为了复用连接资源。
(2)连接池是被动的,由任务需要时取,用完之后归还;而线程池是主动的,主动的从任务队列中取出任务并执行。连接池连接数量根据线程池数量设置。
(3)线程池和连接池的数量要考虑IO同步时间问题,要根据IO等待时间和CPU处理时间来计算具体是池内对象数量。
(4)VMware虚拟机对写入性能是有影响的。
(5)异步比同步有更高的吞吐量,但是异步编程比同步编程复杂很多,如果异步过程中发生异常就不好处理,而且等待数据库返回结果也变得复杂起来;所以,如果同步可以满足性能要求,就尽量使用同步的方式。
(6)连接池的扩展功能,比如统计连接池中的最大连接时间(归还时间-请求时间)、每秒连接次数的监控、没有归还连接时的处理等。
动态线程池的优化策略与实践
需求:在同一个页面下同时管理三家运营商(例如中国电信、中国联通、中国移动)的数据,涉及到调用三家不同的API接口,并在前端页面上统一展示和管理这些数据。
串行化查询:
执行过程如下,伪代码:
//电信
JSONObject result = restTemplateUtils.getHttp(telecomUrl, params, headersMap);
//联通
JSONObject result = restTemplateUtils.getHttp(unicomUrl, params, headersMap);
// 移动
JSONObject result = restTemplateUtils.getHttp(mobileUrl, params, headersMap);
串行化查询,即依次执行每个查询请求,这种做法在某些情况下是必要的,尤其是在不同请求间有依赖关系或资源限制的情况下。然而,当查询独立且可以并行执行时,串行查询存在一些明显的弊端,特别是在高并发和性能敏感的应用场景下。以下是串行化查询的一些主要弊端:
延迟增加:每次查询都需要等待前一个查询完成后才开始执行。这意味着总的响应时间等于各个查询响应时间之和,这可能导致用户感知到的延迟显著增加,尤其是在网络条件不佳或服务器响应慢的情况下。
吞吐量受限:由于每个请求必须等待前一个请求完成,系统的整体吞吐量(单位时间内处理的请求数量)受到限制。在高并发场景下,这可能导致系统无法充分利用其处理能力,从而影响整体性能。
资源浪费:在等待某个查询执行时,CPU和其他系统资源可能处于闲置状态,这降低了资源利用率。特别是在多核处理器环境中,串行执行无法利用多个核心并行处理的能力。
扩展性差:随着查询数量的增加,串行查询的总执行时间将线性增长,这使得系统很难通过简单增加硬件资源来提高性能。在需要处理大量数据或高并发请求的场景下,串行查询的扩展性成为一个瓶颈。
优化方案:并行执行
为了解决这些问题,通常推荐使用并行查询或异步查询的策略,通过使用线程池、异步I/O、并行流处理等技术,可以显著减少总响应时间和提高系统的吞吐量。
例如,在Java中,可以使用CompletableFuture API来并行执行多个HTTP请求,并通过CompletableFuture.allOf().get()来等待所有请求完成,这样可以有效地减少总延迟并提高资源利用率。
执行过程如下,伪代码:
 //电信
 CompletableFuture<JSONObject> telecomFuture = CompletableFuture.supplyAsync(() -> {
    return restTemplateUtils.getHttp(telecomUrl, params, headersMap);
});

 //联通
CompletableFuture<JSONObject> unicomFuture = CompletableFuture.supplyAsync(() -> {
    return restTemplateUtils.getHttp(unicomUrl, params, headersMap);
});

 //移动
CompletableFuture<JSONObject> unicomFuture = CompletableFuture.supplyAsync(() -> {
    return restTemplateUtils.getHttp(mobileUrl, params, headersMap);
});

 CompletableFuture.allOf(telecomFuture,unicomFuture,mobileFuture).get();
上面的方式并没有使用线程池,结合我们之前的文章,可以通过nacos实现一个动态线程池。
继续优化:使用动态线程池
基于 Nacos 配置的动态线程池管理功能,可以根据配置的变化来动态调整线程池的参数,同时监控线程池的状态并动态添加任务到线程池中。
核心代码如下:
import com.alibaba.cloud.nacos.NacosConfigManager;
import com.alibaba.cloud.nacos.NacosConfigProperties;
import com.alibaba.nacos.api.config.listener.Listener;
import com.google.common.util.concurrent.ThreadFactoryBuilder;
import org.springframework.beans.factory.InitializingBean;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.cloud.context.config.annotation.RefreshScope;
import org.springframework.context.annotation.Configuration;

import java.util.concurrent.Executor;
import java.util.concurrent.LinkedBlockingQueue;
import java.util.concurrent.RejectedExecutionHandler;
import java.util.concurrent.ThreadPoolExecutor;
import java.util.concurrent.TimeUnit;

@RefreshScope
@Configuration
public class DynamicThreadPool implements InitializingBean {
    @Value("${core.size}")
    private String coreSize;

    @Value("${max.size}")
    private String maxSize;

    private static ThreadPoolExecutor threadPoolExecutor;

    @Autowired
    private NacosConfigManager nacosConfigManager;

    @Autowired
    private NacosConfigProperties nacosConfigProperties;

    @Override
    public void afterPropertiesSet() throws Exception {
        //按照nacos配置初始化线程池
        threadPoolExecutor = new ThreadPoolExecutor(Integer.parseInt(coreSize), Integer.parseInt(maxSize), 10L, TimeUnit.SECONDS,
                new LinkedBlockingQueue<>(10),
                new ThreadFactoryBuilder().setNameFormat("c_t_%d").build(),
                new RejectedExecutionHandler() {
                    @Override
                    public void rejectedExecution(Runnable r, ThreadPoolExecutor executor) {
                        System.out.println("rejected!");
                    }
                });

        //nacos配置变更监听
        nacosConfigManager.getConfigService().addListener("service-dev.yml", nacosConfigProperties.getGroup(),
                new Listener() {
                    @Override
                    public Executor getExecutor() {
                        return null;
                    }
                    @Override
                    public void receiveConfigInfo(String configInfo) {
                        //配置变更,修改线程池配置
                        System.out.println(configInfo);
                        changeThreadPoolConfig(Integer.parseInt(coreSize), Integer.parseInt(maxSize));
                    }
                });
    }

    /**
     * 打印当前线程池的状态
     */
    public String printThreadPoolStatus() {
        return String.format("core_size:%s,thread_current_size:%s;" +
                        "thread_max_size:%s;queue_current_size:%s,total_task_count:%s", threadPoolExecutor.getCorePoolSize(),
                threadPoolExecutor.getActiveCount(), threadPoolExecutor.getMaximumPoolSize(), threadPoolExecutor.getQueue().size(),
                threadPoolExecutor.getTaskCount());
    }

    /**
     * 给线程池增加任务
     *
     * @param count
     */
    public void dynamicThreadPoolAddTask(int count) {
        for (int i = 0; i < count; i++) {
            int finalI = i;
            threadPoolExecutor.execute(new Runnable() {
                @Override
                public void run() {
                    try {
                        System.out.println(finalI);
                        Thread.sleep(10000);
                    } catch (InterruptedException e) {
                        e.printStackTrace();
                    }
                }
            });
        }
    }

    /**
     * 修改线程池核心参数
     *
     * @param coreSize
     * @param maxSize
     */
    private void changeThreadPoolConfig(int coreSize, int maxSize) {
        threadPoolExecutor.setCorePoolSize(coreSize);
        threadPoolExecutor.setMaximumPoolSize(maxSize);
    }
}
伪代码:
 //电信
 CompletableFuture<JSONObject> telecomFuture = CompletableFuture.supplyAsync(() -> {
    return restTemplateUtils.getHttp(telecomUrl, params, headersMap);
}, DynamicThreadPool.threadPoolExecutor);

 //联通
CompletableFuture<JSONObject> unicomFuture = CompletableFuture.supplyAsync(() -> {
    return restTemplateUtils.getHttp(unicomUrl, params, headersMap);
}, DynamicThreadPool.threadPoolExecutor);

 //移动
CompletableFuture<JSONObject> unicomFuture = CompletableFuture.supplyAsync(() -> {
    return restTemplateUtils.getHttp(mobileUrl, params, headersMap);
}, DynamicThreadPool.threadPoolExecutor);

 CompletableFuture.allOf(telecomFuture,unicomFuture,mobileFuture).get();
至于线程池参数设置多少合适呢?对于IO密集型任务和计算密集型任务,线程池的设置略有不同:
对于IO密集型任务,通常建议设置较大的线程池大小,以便充分利用CPU等资源,同时能够处理大量的IO操作。
可以考虑设置线程池大小为2 * CPU核心数或更大,这样可以充分利用系统资源并提高IO操作的并发处理能力。
对于计算密集型任务,由于任务主要耗费在CPU计算上,因此需要限制线程池的大小,避免过多线程竞争CPU资源而导致性能下降。
建议将线程池的大小设置为CPU核心数加1或2,这样可以充分利用CPU资源而又不至于引起过多的线程切换导致性能损失。
-
IO密集型任务:
对于IO密集型任务,通常建议设置较大的线程池大小,以便充分利用CPU等资源,同时能够处理大量的IO操作。
可以考虑设置线程池大小为2 * CPU核心数或更大,这样可以充分利用系统资源并提高IO操作的并发处理能力。
-
计算密集型任务:
对于计算密集型任务,由于任务主要耗费在CPU计算上,因此需要限制线程池的大小,避免过多线程竞争CPU资源而导致性能下降。
建议将线程池的大小设置为CPU核心数加1或2,这样可以充分利用CPU资源而又不至于引起过多的线程切换导致性能损失。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 32
 0
- 0


 已为社区贡献34条内容

所有评论(0)