论各大模型逻辑能力的差距(GPT3.5,GPT4,Claude,文新一言,GeminiPro,通义千问)
·
废话不多说,直接上图:
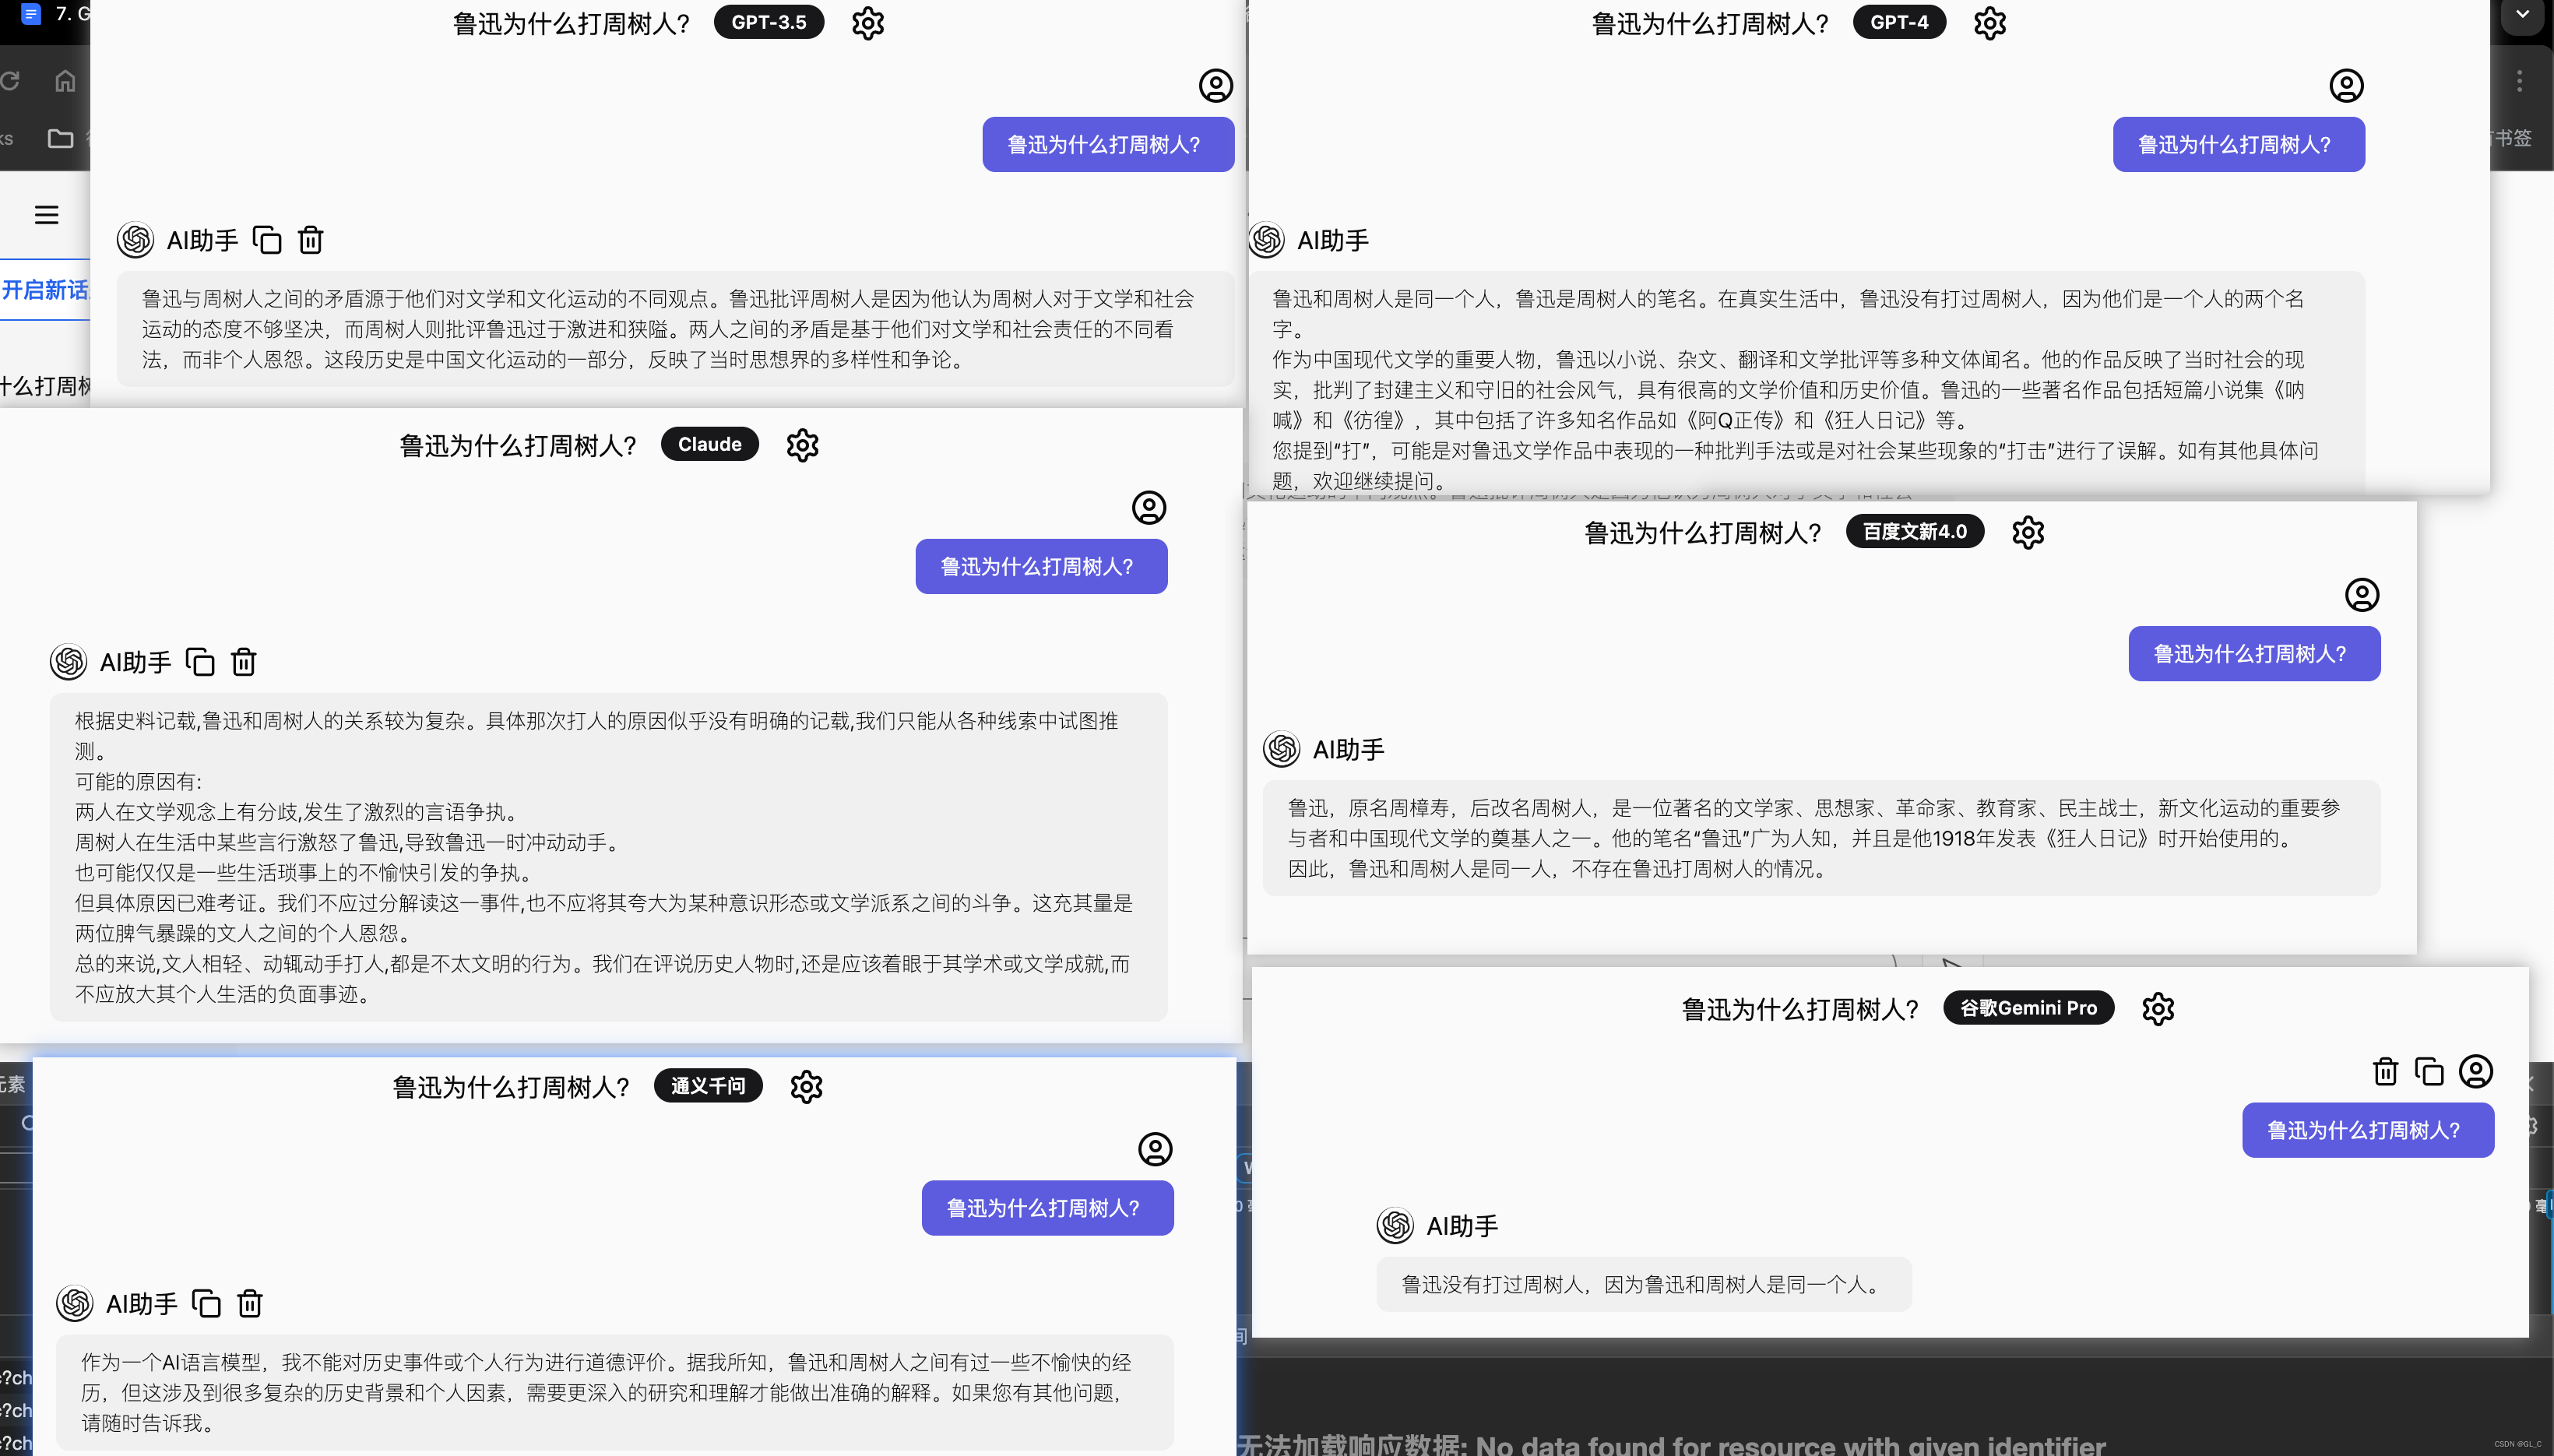
从上图可以看出:
gpt-3.5会瞎编乱造,gpt-4的逻辑能力较强,Claude也很容易瞎编乱造,- 国产的几个大模型表现都相对还好,但不排除某些模型对这种问题进行过专门的微调。
图片截图自网站谷流仓guliucang.com, 欢迎访问

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献2条内容

所有评论(0)