论文浅尝 | Graph2Feat:基于知识蒸馏的归纳链接预测
笔记整理:刘治强,浙江大学硕士生
链接:https://dl.acm.org/doi/10.1145/3543873.3587596
1. 动机
尽管GNN在链路预测任务中表现出较高的准确性,但它并不是设计用于归纳设置下的链路预测。此外,由于对图数据的依赖性,GNN在大规模工业部署中显示出相当高的推理延迟。
尽管由于缺乏对图拓扑的访问,MLP在节点分类任务上的归纳偏差比GNN小得多,但由于其低推理延迟,它们在工业规模应用程序中获得了很高的欢迎。先前的观察结果使得最近的研究人员在节点分类任务中利用从教师GNN到学生MLP的跨模型知识蒸馏。
鉴于在链接预测,特别是归纳链接预测方面的知识蒸馏仍是一个未被探索的领域,本文致力于在转导链接预测和归纳链接预测任务中加速推理。此外,由于链路预测可能涉及对源节点和多个上下文节点类型之间的多种关系进行推理。
2. 方法
提出的框架:Graph2Feat
知识蒸馏:将知识从繁重的教师模型提炼为更轻量级的学生模型。
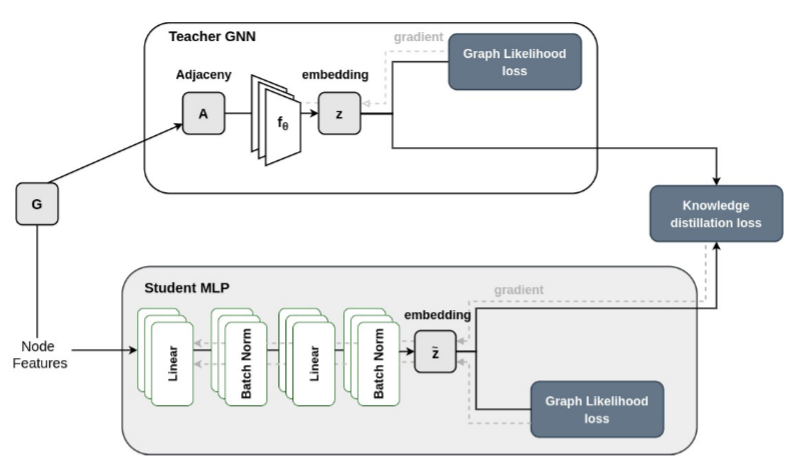
本文从教师GNN模型生成软预测 ,然后通过最小化损失函数 训练学生模型MLP去匹配对应的软预测 。最终得到的学生模型的损失函数为:
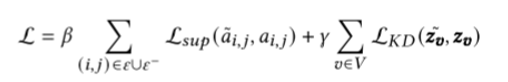
其中, 是学生链路预测损失, 是 , 的相似度得分, , γ,β 是平衡监督损失与KD损失的超参数。
教师模型
对于同质图,本文采用变分图自动编码器作为老师,其中最小化以下损失函数:
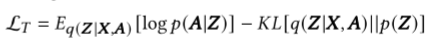
其中, 是实际邻接矩阵与重构邻接矩阵之间的二元交叉熵损失, 计算的是编码器 与 之间的KL散度。
对于异构图,本文使用GraphSAGE作为老师模型。特别地,对于每一种边类型,本文构建一个二部图并直接应用GraphSAGE,然后使用平均聚合对每个节点的结果嵌入进行聚合。损失函数与学生模型的监督链路预测损失 相同。
学生模型
这是一个MLP模型,通常两个线性转换层堆叠在一起。对于异构图,本文对每个节点类型应用一个单独的线性转换如下:
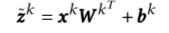
教师模型GNN被预训练,并在训练Graph2Feat时被冻结。在训练结束后,Graph2Feat本质上成为了一个没有访问图拓扑的MLP,但具有GNN模型的归纳偏差和MLP模型的低推理延迟。
3. 实验
数据集:
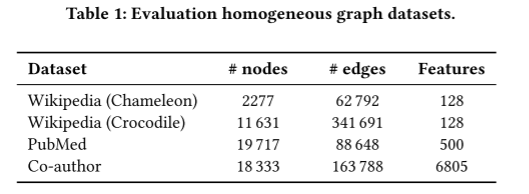
4个同构图数据集:Wikipedia (Chameleon and Crocodile)、PubMed和Co-author。
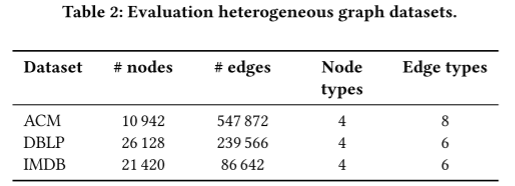
3个异构图数据集:ACM、DBLP、IMDB。
基准模型:
用 训练的GCN,只访问features,用 训练的MLP
随机游走的方法:DeepWalk,Metapath2Vec
SOTA:G2G,DEAL。
同构图的实验:GCN或GraphSage,并用变分图自动编码器作为教师模型。
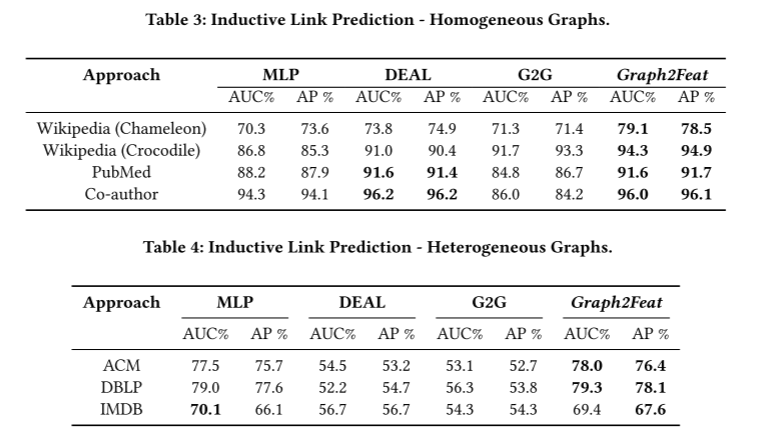
Inductive链路预测结果
随机游走和GNN的方法无法从新节点的邻居进行聚合,不能再归纳式设置下应用。
结论:
1、在同构图的情况下,MLP在所有数据集上表现出相当的性能,而在异构图中表现出更高的性能;这表明设计合理的MLP可以实现与以往研究相媲美的性能。
2、对于异构图,G2G和DEAL表现出较差的性能,因为它们最初是为同质图设计的。
3、成功地提炼知识通常会提高Graph2Feat的性能。此外,引入异构知识(即节点和边缘类型)对提高异构图的嵌入质量起着至关重要的作用。
Transductive链路预测结果
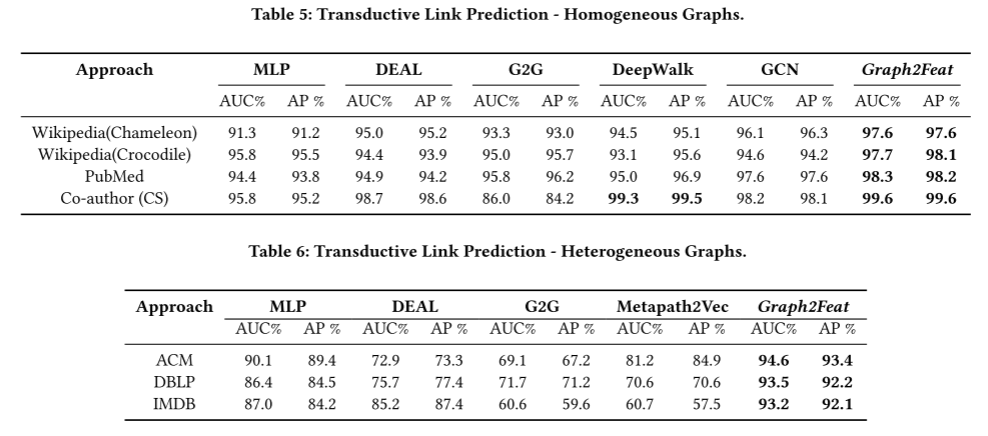
结论:
1、G2G在transductive设置下的Co-author数据集上表现较差。此外,DeepWalk对于超参数比其他方法更敏感。
2、G2G和DEAL在异构图上表现较差,这是因为节点和边类型中缺乏异构知识。虽然Metapath2Vec是为异构网络设计的,但它的性能也很差。
3、对于Graph2Feat,结果显示了在不同类型的图(无论是同构的还是异构的)上具有稳健的性能。因此推断,优先整合节点和边缘类型的信息似乎是高质量节点嵌入的必要条件。其次,从老师GNN中提取关于图结构的知识似乎可以提供更好的性能,使得 Graph2Feat更快地推断。
Q1:在性能和推理时间方面,Graph2Feat与独立的MLPs相比如何?
本文观察到Graph2Feat始终优于MLPs。对于MLP,它具有与基线相竞争的性能,这表明,通过正确的参数集,MLP可以达到与GNN相当的性能水平,特别是在较小的数据集上。
Q2:知识蒸馏对Graph2Feat有好处吗?
知识蒸馏是一种正则化,是教师GNN模型传递归纳式偏差的一种方式。其次,MLPs可以通过知识蒸馏近似特征标签映射函数;最后,基于随机梯度的学习方法可能不能完全做到后者。
Q3:Graph2Feat能在多大程度上加速推理?
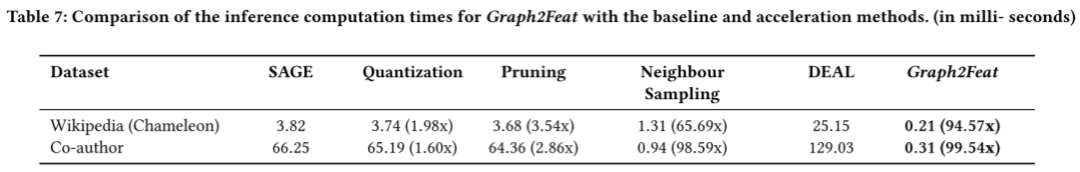
Q4:最后,什么情况下Graph2Feat可能失败?
在节点特征和预测标签(边)之间没有相关性的情况下,MLP和Graph2Feat都不能预测边,但这种情况很罕见。
消融实验
超参数的灵敏度
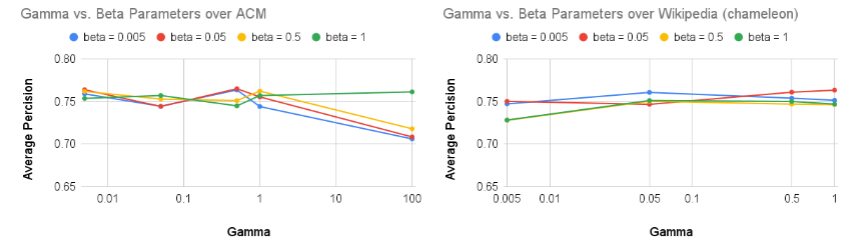
超参数的值可能会对Graph2Feat在异构ACM和同质维基百科图中的性能产生轻微的影响,标准差为1%。
隐藏层尺寸的超参数敏感性
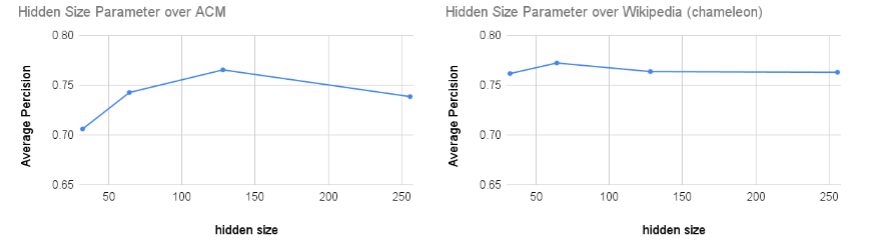
在Wikipedia的例子中,Graph2Feat对隐藏的大小更不敏感,在较小的值64时达到峰值。而在ACM中,Graph2Feat对隐藏大小的增加更加敏感;这是证明,因为同构图比异构图更简单,所以更容易在这样的图上过拟合。
4. 总结
(1)本文提出了一种基于知识蒸馏的半归纳和全归纳链路预测方法Graph2Feat。Graph2Feat是一种通用的方法,可用于同质或异质,以及有向和无向图,正如本文的实验结果所证明的那样。据本文所知,这是第一个利用知识蒸馏在同质和异质图上进行链接预测的工作。
(2)本文评估了在7个真实世界数据集(包括4个同构图和3个异质图)上所提出的链接预测方法,分别在转导、完全和半归纳设置下。结果表明,Graph2Feat在均匀和非均匀图形上的鲁棒性在ROC曲线下面积和平均精度上都超过了最先进的结果。实验表明,与SOTA方法相比,Graph2Feat具有最小的推理时间,与GNN方法相比,Graph2Feat具有100倍的加速度。
(3)最后,本文对超参数值的变化进行了消融研究和讨论,以更好地了解Graph2Feat在不同设置下的预期行为。
OpenKG
OpenKG(中文开放知识图谱)旨在推动以中文为核心的知识图谱数据的开放、互联及众包,并促进知识图谱算法、工具及平台的开源开放。
点击阅读原文,进入 OpenKG 网站。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 11
 0
- 0


 已为社区贡献124条内容

所有评论(0)