设计模式——迭代器模式(附代码示例)
一. 传统方式
以学校院系展示为例,实现在一个页面展示学校的院系组成,一个学校有多个学院,一个学院有多个系。传统方式实现类图如下:
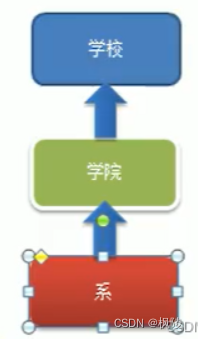
传统方式将学院看做是学校的子类,系是学院的子类,这样实际上是站在组织大小来进行分层次的。实际上我们的要求是在一个页面中展示出学校的院系组成,一个学校有多个学院,一个学院有多个系,而每个院对于系的存储方式各不相同(如数组、集合等),因此这种方案,不能很好实现的实现遍历操作。故引出迭代器模式。
二. 迭代器模式
1. 概念
迭代器模式(Iterator Pattern)是常用的设计模式,属于行为型模式。如果我们的集合元素是用不同的方式实现的,有数组,还有java的集合类,或者还有其他方式,当客户端要遍历这些集合元素的时候就要使用多种遍历方式,而且还会暴露元素的内部结构,可以考虑使用迭代器模式解决。
迭代器模式,提供一种遍历集合元素的统一接口,用一致的方法遍历集合元素,不需要知道集合对象的底层表示,即不暴露其内部的结构。
2. 迭代器原理类图
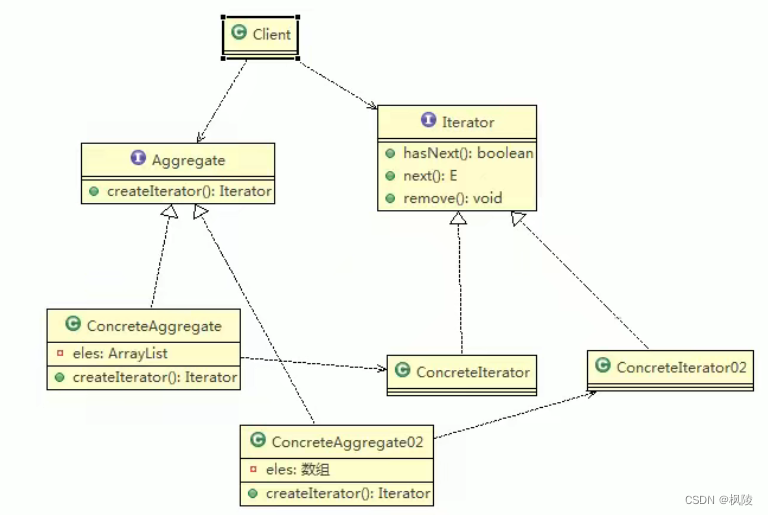
Iterator: 迭代器接口, 是系统提供,含义hasNext, next, remove
ConcreteIterator: 具体的迭代器类,管理迭代
Aggregate: 一个统一的聚合接口,将客户端和具体聚合解耦
ConcreteAggregate: 具体的聚合持有对象集合,并提供一个方法, 返回一个迭代器,该迭代器可以正确遍历集合
Client: 客户端,通过Iterator和Aggregate依赖子类
3. 代码示例
类图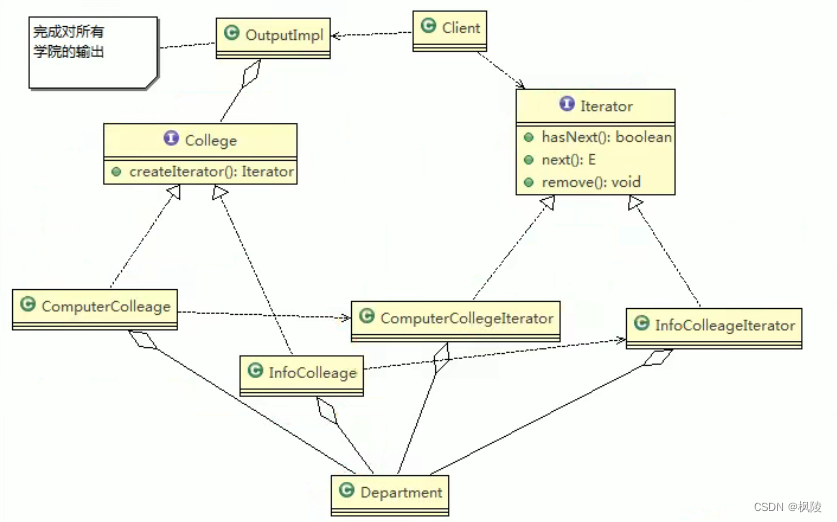
College接口,对学院进行抽象
public interface College {
    public String getName();
    //增加系的方法
    public void addDepartment(String name,String desc);
    //返回一个迭代器,遍历
    public Iterator createIterator();
}
ComputerCollegeIterator类,实现Iterator接口,按数组方式实现hasNext, next, remove
public class ComputerCollegeIterator implements Iterator {
    //需要知道Department是以怎样的方式存放,此处为数组
    Department[] departments;
    int position = 0;

    public ComputerCollegeIterator(Department[] departments) {
        this.departments = departments;
    }

    @Override
    public boolean hasNext() {
        if (position >= departments.length || departments[position] == null) {
            return false;
        }
        return true;
    }

    @Override
    public Object next() {
        Department department = departments[position];
        position++;
        return department;
    }

    //默认空实现
    @Override
    public void remove() {
    }
}
ComputerCollege类,实现College接口,以数组形式存储系
public class ComputerCollege implements College{
    Department[] departments;
    int count = 0;//保存当前数组元素个数

    public ComputerCollege() {
       departments = new Department[5];
       addDepartment("JAVA","JAVA");
       addDepartment("C++","C++");
       addDepartment("Python","Python");
    }

    @Override
    public String getName() {
        return "计算机学院";
    }

    @Override
    public void addDepartment(String name, String desc) {
        Department department = new Department(name, desc);
        departments[count] = department;
        count++;
    }

    @Override
    public Iterator createIterator() {
        return new ComputerCollegeIterator(departments);
    }
}
InfoCollegeIterator类,实现Iterator接口,按集合方式实现hasNext, next, remove
public class InfoCollegeIterator implements Iterator {
    List<Department> departments;
    int position = -1;

    public InfoCollegeIterator(List<Department> departments) {
        this.departments = departments;
    }

    @Override
    public boolean hasNext() {
        if (position >= departments.size()-1) {
            return false;
        }else {
            position++;
            return true;
        }
    }

    @Override
    public Object next() {
        Department department = departments.get(position);
        return department;
    }

    @Override
    public void remove() {

    }
}
InfoCollege类,实现College接口,以集合形式存储系
public class InfoCollege implements College {
    List<Department> departments;

    public InfoCollege() {
        departments = new ArrayList<>();
        addDepartment("信息安全", "信息安全");
        addDepartment("网络安全", "网络安全");
    }

    @Override
    public String getName() {
        return "信息学院";
    }

    @Override
    public void addDepartment(String name, String desc) {
        Department department = new Department(name, desc);
        departments.add(department);
    }

    @Override
    public Iterator createIterator() {
        return new InfoCollegeIterator(departments);
    }
}
OutPutImpl类,提供一个方法, 返回一个迭代器,该迭代器可以正确遍历集合,输出各个院系
public class OutPutImpl {
    //学院集合
    private List<College> collegeList;

    public OutPutImpl(List<College> collegeList) {
        this.collegeList = collegeList;
    }

    //遍历所有学院,然后调用printDepartment 输出各个学院的系
    public void printCollege(){
        Iterator<College> iterator = collegeList.iterator();
        while (iterator.hasNext()){
            College college = iterator.next();
            System.out.println("====="+college.getName()+"=======");
            printDepartment(college.createIterator());
        }

    }

    //输出系
    public void printDepartment(Iterator iterator){
        while (iterator.hasNext()){
            Department next = (Department) iterator.next();
            System.out.println(next.getName());
        }
    }
}
Client类
public class Client {
    public static void main(String[] args) {
        ArrayList<College> colleges = new ArrayList<>();
        ComputerCollege computerCollege = new ComputerCollege();
        InfoCollege infoCollege = new InfoCollege();
        colleges.add(computerCollege);
        colleges.add(infoCollege);

        OutPutImpl outPut = new OutPutImpl(colleges);
        outPut.printCollege();
    }
}
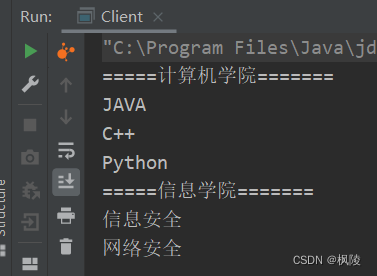
输出结果
三. 总结
1. 优点
提供一个统一的方法遍历对象,客户不用再考虑聚合的类型,使用一种方法就可以遍历对象
隐藏聚合的内部结构,客户端要遍历聚合的时候只能取到迭代器,而不会知道聚合的具体组成。
提供了一种设计思想,就是一个类应该只有一个引起变化的原因(叫做单一责任原则)。在聚合类中,我们把迭代器分开,就是要把管理对象集合和遍历对象集合的责任分开,这样一来集合改变的话,只影响到聚合对象。而如果遍历方式改变的话,只影响到了迭代器。
当要展示一组相似对象,或者遍历一组相同对象时使用,适合使用迭代器模式
2. 缺点
每个聚合对象都要一个迭代器,会生成多个迭代器不好管理类

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献6条内容

所有评论(0)