基于LeNet手写体识别的模型剪枝
基于LeNet手写体识别的模型剪枝
本节主要记录如何通过pytorch中的掩模矩阵对模型进行剪枝,剪枝对象包括卷积层和全连接层,其中卷积层通过l2范数的大小对卷积核进行剪枝,全连接层通过阈值筛选对单个权重进行剪枝,主要参考的代码为https://github.com/mepeichun/Efficient-Neural-Network-Bilibili。
1.剪枝网络的搭建
剪枝之前,首先要对原始的LeNet网络进行训练,得到待剪枝的模型参数,具体的训练过程可以参考笔者的前一篇文章《基于LeNet手写体识别的模型量化》。训练完成后,需要在原网络的基础上搭建剪枝网络:
import torch
from torch import nn
import torch.nn.functional as F

device = 'cuda' if torch.cuda.is_available() else 'cpu'

# 定义带掩模矩阵的卷积层
class MaskedConv2d(nn.Conv2d):
    def __init__(self, in_channels, out_channels, kernel_size, stride=1,
                 padding=0, dilation=1, groups=1, bias=True):
        super(MaskedConv2d, self).__init__(in_channels, out_channels,
                                           kernel_size, stride, padding, dilation, groups, bias)
        self.mask_flag = False

    def set_mask(self, mask):
        self.mask = mask.clone().detach().requires_grad_(False)
        self.weight.data = self.weight.data * self.mask.data
        self.mask_flag = True

    def get_mask(self):
        print(self.mask_flag)
        return self.mask

    # 保存剪枝后的权重
    def save_mask(self):
        self.weight.data = self.weight.data * self.mask.data

    def forward(self, x):
        if self.mask_flag == True:
            weight = self.weight * self.mask
            return F.conv2d(x, weight, self.bias, self.stride,
                            self.padding, self.dilation, self.groups)
        else:
            return F.conv2d(x, self.weight, self.bias, self.stride,
                            self.padding, self.dilation, self.groups)

# 定义带掩模矩阵的全连接层
class MaskedLinear(nn.Linear):
    def __init__(self, in_features, out_features, bias=True):
        super(MaskedLinear, self).__init__(in_features, out_features, bias)
        self.mask_flag = False
        self.mask = None

    def set_mask(self, mask):
        self.mask = mask.clone().detach().requires_grad_(False)
        # print(self.weight.data.size())
        # print("分界线")
        # print(self.mask.data.size())
        self.weight.data = self.weight.data * self.mask.data

        self.mask_flag = True

    def get_mask(self):
        print(self.mask_flag)
        return self.mask

    # 保存剪枝后的权重
    def save_mask(self):
        self.weight.data = self.weight.data * self.mask.data

    def forward(self, x):
        if self.mask_flag:
            weight = self.weight * self.mask
            return F.linear(x, weight, self.bias)
        else:
            return F.linear(x, self.weight, self.bias)

# 定义网络模型
class LeNet(nn.Module):
    # 初始化网络
    def __init__(self):
        super(LeNet, self).__init__()

        self.c1 = MaskedConv2d(in_channels=1, out_channels=6, kernel_size=5, padding=2)
        self.Relu = nn.ReLU()
        self.s2 = nn.AvgPool2d(kernel_size=2, stride=2)
        self.c3 = MaskedConv2d(in_channels=6, out_channels=16, kernel_size=5)
        self.s4 = nn.AvgPool2d(kernel_size=2, stride=2)
        self.c5 = MaskedConv2d(in_channels=16, out_channels=120, kernel_size=5)
        self.flatten = nn.Flatten()
        self.f6 = MaskedLinear(120, 84)
        self.output = MaskedLinear(84, 10)

    def forward(self, x):
        x = self.Relu(self.c1(x))
        x = self.s2(x)
        x = self.Relu(self.c3(x))
        x = self.s4(x)
        x = self.c5(x)
        x = self.flatten(x)
        x = self.f6(x)
        x = self.output(x)
        return x

    def set_linear_masks(self, masks):
        self.f6.set_mask(masks[0])
        self.output.set_mask(masks[1])

    def set_conv_masks(self, masks):
        self.c1.set_mask(torch.from_numpy(masks[0]))
        self.c3.set_mask(torch.from_numpy(masks[1]))
        self.c5.set_mask(torch.from_numpy(masks[2]))

    def save_masks(self):
        self.c1.save_mask()
        self.c3.save_mask()
        self.c5.save_mask()
        self.f6.save_mask()
        self.output.save_mask()
该段代码重写了原始网络的卷积层和全连接层,分别添加了set_mask、get_mask和save_mask函数,其中set_mask用于输入掩模矩阵,get_mask用于读取掩模矩阵,save_mask用于保存乘以掩模矩阵后的权重矩阵。而获取掩模矩阵的方法将在剪枝训练的代码中进行说明。
2.剪枝训练
本文针对卷积层以卷积核为单元进行剪枝,针对全连接层以单个权重为单元进行剪枝,分别采用l2范数和阈值筛选作为剪枝依据:
import torch
from torch import nn
from net_prune import LeNet
from torch.optim import lr_scheduler
from torchvision import datasets, transforms
import os
import matplotlib.pyplot as plt
import numpy as np

# 解决中文显示问题
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False

normalize = transforms.Normalize([0.1307], [0.3081])

# 数据转化为tensor格式
data_transform = transforms.Compose([transforms.ToTensor()])

# 加载训练数据集
train_dataset = datasets.MNIST(root='./data', train=True, transform=data_transform, download=True)
train_dataloader = torch.utils.data.DataLoader(dataset=train_dataset, batch_size=32, shuffle=True)

# 加载测试数据集
test_dataset = datasets.MNIST(root='./data', train=False, transform=data_transform, download=True)
test_dataloader = torch.utils.data.DataLoader(dataset=test_dataset, batch_size=1000, shuffle=True)

device = "cuda" if torch.cuda.is_available() else "cpu"

# 调用net定义的模型
model = LeNet().to(device)

# 定义损失函数(交叉熵)
loss_fn = nn.CrossEntropyLoss()

# 定义一个优化器
optimizer = torch.optim.SGD(model.parameters(), lr=1e-3, momentum=0.9)

# 学习率每隔10轮,变为原来的0.5
lr_scheduler = lr_scheduler.StepLR(optimizer, step_size=10, gamma=0.5)

# 定义构造全连接层掩模矩阵的函数
def weight_prune(model, pruning_perc):
    threshold_list = []
    for p in model.parameters():
        # 选择全连接层
        if len(p.data.size()) == 2:
            weight = p.cpu().data.abs().numpy().flatten()
            threshold = np.percentile(weight, pruning_perc)
            threshold_list.append(threshold)
    # generate mask
    masks = []
    idx = 0
    for p in model.parameters():
        if len(p.data.size()) == 2:
            pruned_inds = p.data.abs() > threshold_list[idx]
            masks.append(pruned_inds.float())
            idx += 1
    return masks

# 定义构造卷积层掩模矩阵的函数
def prune_rate(model, verbose=False):
    total_nb_param = 0
    nb_zero_param = 0
    layer_id = 0
    for parameter in model.parameters():
        # only pruning conv layers
        if len(parameter.data.size()) == 4:
            layer_id += 1
            # 统计总参数
            param_this_layer = 1
            for dim in parameter.data.size():
                param_this_layer *= dim
            total_nb_param += param_this_layer
            # 统计0参数
            zero_param_this_layer = \
                np.count_nonzero(parameter.cpu().data.numpy()==0)
            nb_zero_param += zero_param_this_layer

            if verbose:
                print("Layer {} | {} layer | {:.2f}% parameters pruned" \
                    .format(
                        layer_id,
                        'Conv' if len(parameter.data.size()) == 4 \
                            else 'Linear',
                        100.*zero_param_this_layer/param_this_layer,
                        ))
    pruning_perc = 100.*nb_zero_param/total_nb_param
    if verbose:
        print("Final pruning rate: {:.2f}%".format(pruning_perc))
    return pruning_perc

def arg_nonzero_min(a):
    if not a:
        return
    min_ix, min_v = None, None
    # find the starting value (should be nonzero)
    for i, e in enumerate(a):
        if e != 0:
            min_ix = i
            min_v = e
    if not min_ix:
        print('Warning: all zero')
        return np.inf, np.inf
    # search for the smallest nonzero
    for i, e in enumerate(a):
         if e < min_v and e != 0:
            min_v = e
            min_ix = i
    return min_v, min_ix

def prune_one_filter(model, masks):
    NO_MASKS = False
    # construct masks if there is not yet
    if not masks:
        masks = []
        NO_MASKS = True
    values = []
    for p in model.parameters():

        if len(p.data.size()) == 4: # nasty way of selecting conv layer
            p_np = p.data.cpu().numpy()
            if NO_MASKS:
                masks.append(np.ones(p_np.shape).astype('float32'))
            # find the scaled l2 norm for each filter this layer
            value_this_layer = np.square(p_np).sum(axis=1).sum(axis=1)\
                .sum(axis=1)/(p_np.shape[1]*p_np.shape[2]*p_np.shape[3])
            # normalization (important)
            value_this_layer = value_this_layer / \
                np.sqrt(np.square(value_this_layer).sum())
            min_value, min_ind = arg_nonzero_min(list(value_this_layer))
            values.append([min_value, min_ind])
    assert len(masks) == len(values), "something wrong here"
    values = np.array(values)
    # set mask corresponding to the filter to prune
    to_prune_layer_ind = np.argmin(values[:, 0])
    to_prune_filter_ind = int(values[to_prune_layer_ind, 1])
    masks[to_prune_layer_ind][to_prune_filter_ind] = 0.
    return masks

def filter_prune(model, pruning_perc):
    masks = []
    current_pruning_perc = 0.
    i = 0
    while current_pruning_perc < pruning_perc:
        i = i + 1
        print(f'第"{i}"次卷积层剪枝')
        masks = prune_one_filter(model, masks)
        model.set_conv_masks(masks)
        current_pruning_perc = prune_rate(model, verbose=False)
#         print('{:.2f} pruned'.format(current_pruning_perc))
    return masks

# 定义画图函数
def matplot_loss(train_loss, val_loss):
    plt.plot(train_loss, label='train_loss')
    plt.plot(val_loss, label='val_loss')
    plt.legend(loc='best')
    plt.ylabel('loss')
    plt.xlabel('epoch')
    plt.title("训练集和验证集loss值对比图")
    plt.show()

def matplot_acc(train_acc, val_acc):
    plt.plot(train_acc, label='train_acc')
    plt.plot(val_acc, label='val_acc')
    plt.legend(loc='best')
    plt.ylabel('acc')
    plt.xlabel('epoch')
    plt.title("训练集和验证集acc值对比图")
    plt.show()

# 定义训练函数
def train(dataloader, model, loss_fn, optimizer):
    model.train()
    loss, current, n = 0.0, 0.0, 0
    for batch, (X, y) in enumerate(dataloader):
        # 前向传播
        X, y = X.to(device), y.to(device)
        output = model(X)
        cur_loss = loss_fn(output, y)
        _, pred = torch.max(output, axis=1)

        cur_acc = torch.sum(y == pred)/output.shape[0]

        optimizer.zero_grad()
        cur_loss.backward()
        optimizer.step()

        loss += cur_loss.item()
        current += cur_acc.item()
        n = n + 1

    train_loss = loss / n
    train_acc = current / n
    print("train_loss" + str(train_loss))
    print("train_acc" + str(train_acc))

    return train_loss, train_acc

def val(dataloader, model, loss_fn):
    model.eval()
    loss, current, n = 0.0, 0.0, 0
    with torch.no_grad():
        for X, y in dataloader:
            # 前向传播
            X, y = X.to(device), y.to(device)
            output = model(X)
            cur_loss = loss_fn(output, y)
            _, pred = torch.max(output, axis=1)
            cur_acc = torch.sum(y == pred) / output.shape[0]
            loss += cur_loss.item()
            current += cur_acc.item()
            n = n + 1
            val_loss = loss / n
            val_acc = current / n
            print("val_loss" + str(val_loss))
            print("val_acc" + str(val_acc))

            return val_loss, val_acc

# 量化前验证
model.load_state_dict(torch.load("D:/ws_pytorch/LeNet5/save_model/best_model.pth"))
print("量化前验证")
val(test_dataloader, model, loss_fn)
print("#" * 20)

# 量化后验证
linear_mask = weight_prune(model, 80)
model.set_linear_masks(linear_mask)
conv_mask = filter_prune(model, 80)
model.set_conv_masks(conv_mask)

print("量化后验证")
val(test_dataloader, model, loss_fn)
print("#" * 20)

# 量化后再训练验证
epoch = 20
min_acc = 0
loss_train = []
acc_train = []
loss_val = []
acc_val = []
for t in range(epoch):
    print(f'epoch{t+1}\n------------------')
    train_loss, train_acc = train(train_dataloader, model, loss_fn, optimizer)
    val_loss, val_acc = val(test_dataloader, model, loss_fn)

    loss_train.append(train_loss)
    acc_train.append(train_acc)
    loss_val.append(val_loss)
    acc_val.append(val_acc)

    # 保存最好的模型权重
    if val_acc >= min_acc:
        folder = 'save_model'
        if not os.path.exists(folder):
            os.mkdir(folder)
        min_acc = val_acc
        print('save best model')
        torch.save(model.state_dict(), folder+'/best_prune_model.pth')

    if t == epoch - 1:
        torch.save(model.state_dict(), folder+'/last_prune_model.pth')

matplot_loss(loss_train, loss_val)
matplot_acc(acc_train, acc_val)

model.save_masks()

# 保存模型
folder = 'weight/prune/'
for name in model.state_dict():
    # print("################" + name + "################")
    # print(model.state_dict()[name])
    file = open(folder + name + ".txt", "w")
    file.write(str(model.state_dict()[name]))
    file.close()
其中对全连接层剪枝的函数为weight_prune,通过输入的剪枝百分比计算剪枝阈值,小于阈值的权重设置为0。对卷积层剪枝的函数为filter_prune,实现方法是每次减去所有层中l2范数最小的卷积核,减去后判断是否达到剪枝百分比,如果没有达到就继续剪枝。
上述代码中,分别对量化前、量化后以及量化后再训练的网络进行了验证,结果如下。
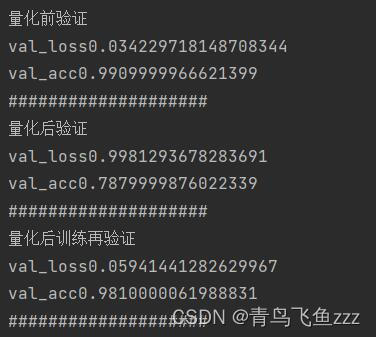
可以看出,网络模型量化80%的权重后,检测精度大大降低,但是对剪枝后的网络进行重新训练,可以很快恢复精度,这是因为剪枝剪掉的部分都是对网络预测值贡献较低的部分。
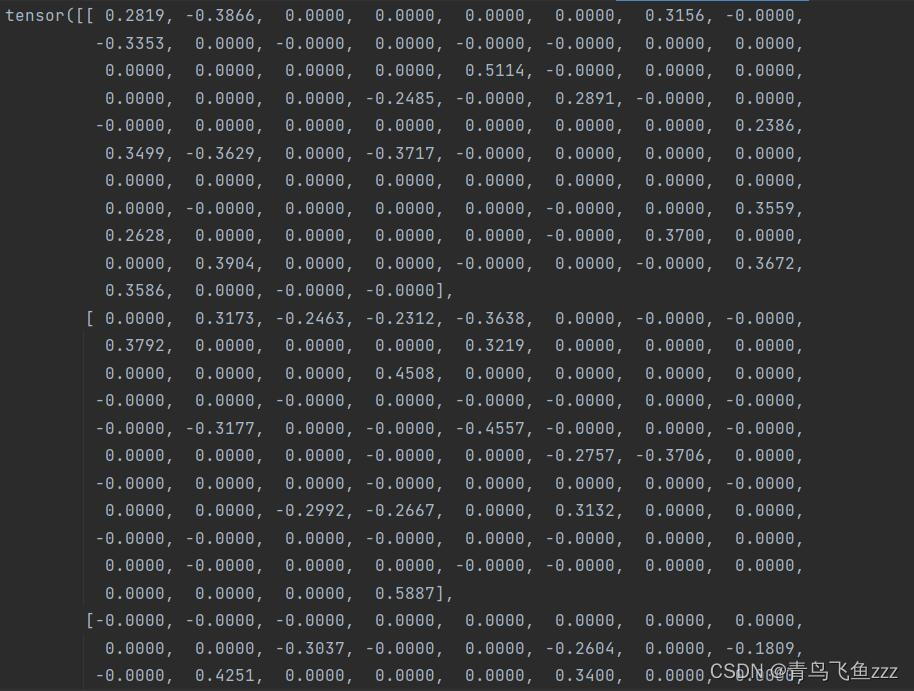
代码中的最后部分对量化后模型中每一层的参数以可读的形式进行了保存,打开特定的路径即可看到量化后的权重,下图显示了输出层的量化后权重,可以发现大量数据变为了0。
3.总结
结合上一篇文章中讲的模型量化,可以对本文中剪枝的结果进行量化测试,附一个测试结果,具体的代码已经在github中更新https://github.com/bird1and1fish/LeNet5。
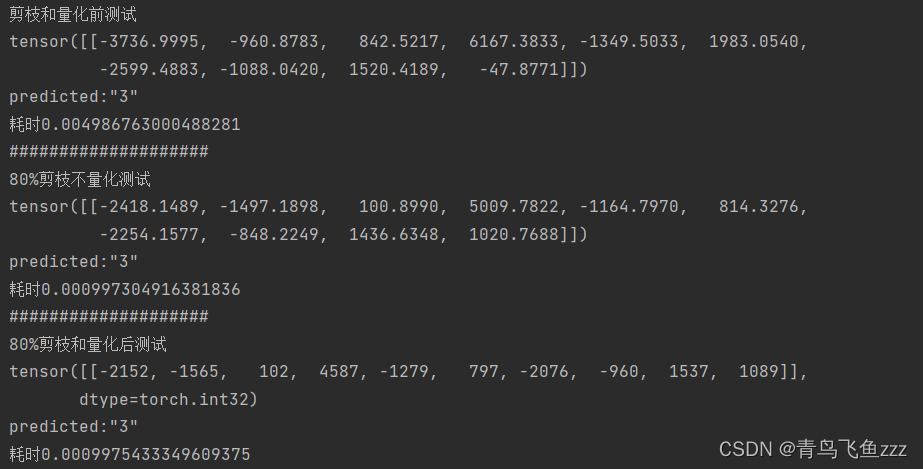
需要注意的是由于量化后的卷积公式为:
o u t = ( ( ∑ k e r n e l i n ( w e i g h t − Z ) + b i a s ∗ g a i n s c a l e > > s h i f t ) ∗ s c a l e ) > > s h i f t out = ((\sum_{kernel}in(weight-Z)+\frac{bias * gain}{scale >> shift}) * scale) >> shift out=((kernel∑in(weight−Z)+scale>>shiftbias∗gain)∗scale)>>shift
因此量化后的数据中,原来被剪枝为0的权重数据并不为0,但是同样可以保证 w e i g h t − Z weight-Z weight−Z的值为0,量化的结果仍然有效。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)