【AcWing 算法基础课】 3、搜索与图论 笔记
第三章 搜索与图论
目录
一道题目做2~3小时是很正常的,甚至做一天都是很正常的,所以一定要耐得住寂寞,每个知识点一定要砸十几个小时。
稠密图(边很多)用邻接矩阵,稀疏图(边很少)用邻接表来存。
无向图是特殊的有向图,也就是a能连上b,b也能连上a。
算法题最求的是在尽量短的时间内实现一个问题,工程化追求的是自己后续好维护。
图论问题主要考抽象,就是如何把一个问题抽象成图。抽象大概只有小学数奥的难度,主要是如何实现。
一般的最短路问题都没有负环,99%,没有负环就用SPFA算法,
正权图:dijkstra,负权图:SPFA
1、深度优先搜索 DFS
是一个非常执着的人,不管往哪条路走,都一定会走到头,走到头才会回溯,但不是回到起点,而是每退一步都会看一看还有没有其他路,有则继续向下走。
从数据结构上来看,DFS 其实是 栈(stack)
从使用空间上来看,DFS往下搜索,只需要记录向下搜索的一条路径就可以了,所以使用空间为 O(n)。
优势:DFS空间上更占优势,但DFS 不具有最短路性质。
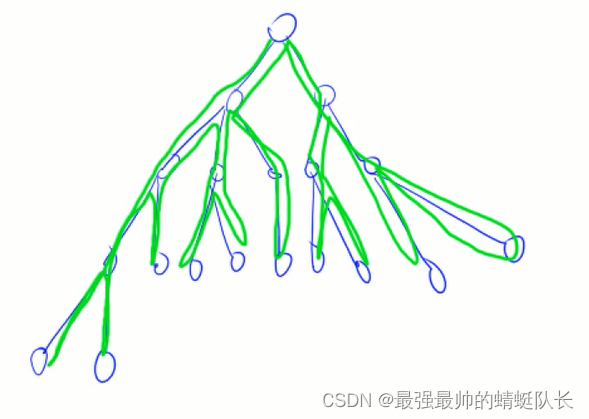
DFS里有两个重要的概念:回溯和剪枝。
最重要的是考虑顺序,DFS俗称暴力搜索,可以画一个树,方便理解。
排列数字(全排列)
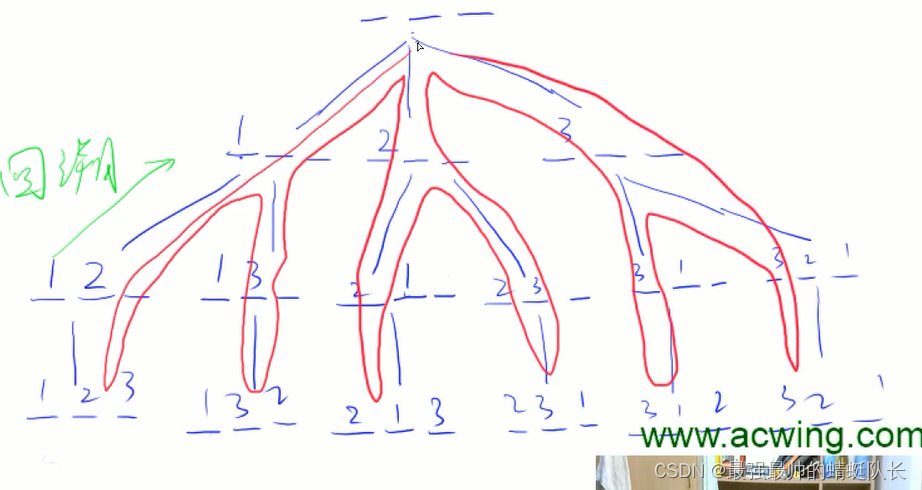
回退的这个过程就叫回溯,回溯时一定要恢复现场。
如果在搜索时,发现这个分支有冲突了,就可以直接停止搜索,可以看成把这个过程给,这就是剪枝。
https://www.acwing.com/solution/content/30988/
n皇后
要注意剪枝,数组长度为n,每个值为在当前第 i 行,皇后的位置,如果已经有两个皇后有冲突,那么可以直接结束搜索,就是剪枝。
https://www.acwing.com/solution/content/30231/
我们抽象出来了题目,每一行只有一个皇后,所以可以枚举每一行的皇后,但如果更原始一点,不知道这个,只能判断当前格子放不放皇后。
DFS最重要的是思路,是顺序。是搜索的最终结果(我感觉的)
2、广度优先搜索 BFS
像一个稳重的人,他每一次都只会扩展一层,只有这一层全部扩展完之后,才会扩展下一层。
从数据结构上来看,BFS 其实是 队列(queue)
从使用空间上来看,BFS每次会搜索一层,所以空间复杂度为指数级,使用空间为 O(n)。
优势:因为 BFS 每次是一层一层往外扩展,所以每次搜索一定是最近的点,所以适合求最短路,但空间上不占优势。
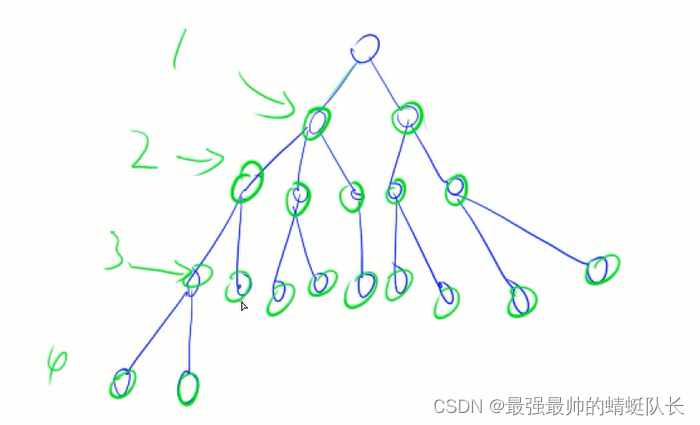
凡是:最小步数、最短距离、最少操作次数,基本都是BFS
DP问题 和 最短路问题是互通的,DP问题是包含最短路问题。
DP问题是没有环的最短路。
不是所有的最短路问题都可以拿最短路来做,只有当所有边的权重都为1的时候才能用BFS,否则都用最短路算法。
DP问题不能用最短路算法,因为其时间复杂度高。
广搜时,使用队列记录当前扩展的点,下次再根据队列中的元素,继续向外扩展。
https://www.acwing.com/solution/content/36520/
https://www.acwing.com/solution/content/15149/
3、树和图的存储
树是一种特殊的图。树是一种无环联通图。
图分为:有向图、无向图。
对于无向图中的边ab,存储两条有向边a->b, b->a。
因此我们可以只考虑有向图的存储。
有向图的存储:
1、邻接矩阵,g[a][b] = a->b 空间:n^2
2、邻接表(用的多)。使用单链表,存储每个点能够到达的位置,次序是无所谓的。
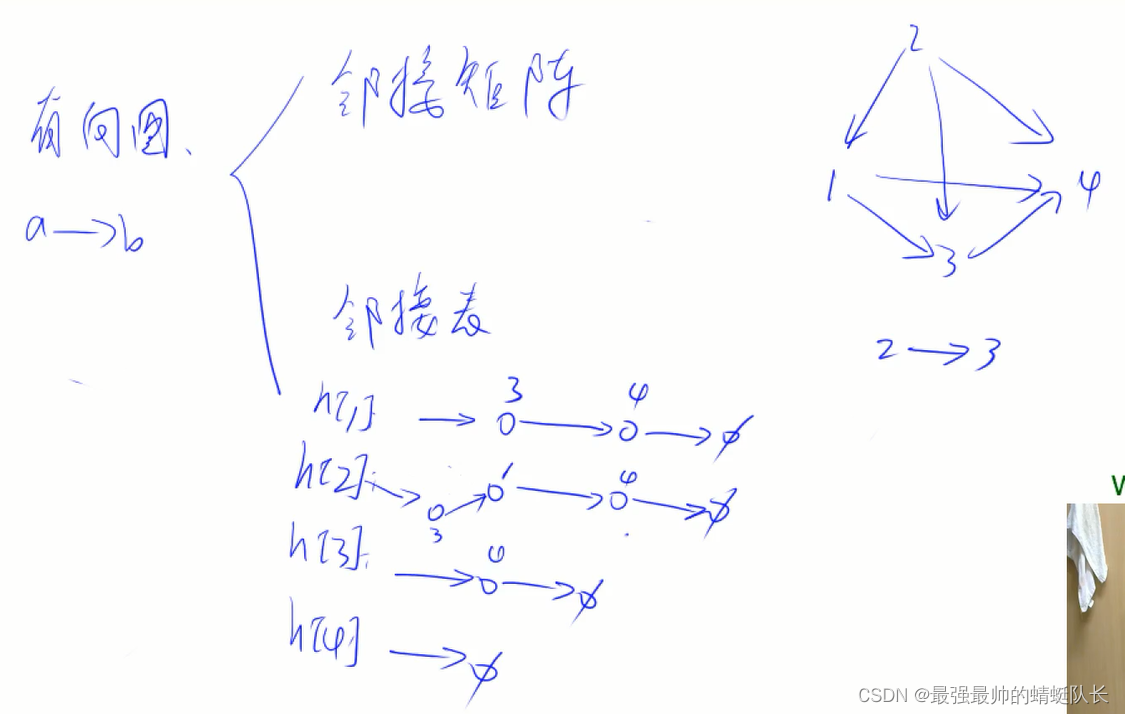
// 对于每个点k,开一个单链表,存储k所有可以走到的点。h[k]存储这个单链表的头结点
int h[N], e[N], ne[N], idx;

// 添加一条边a->b
void add(int a, int b)
{
    e[idx] = b, ne[idx] = h[a], h[a] = idx ++ ;
}

// 初始化
idx = 0;
memset(h, -1, sizeof h);
4、树与图的遍历
广搜是一条路走到黑,广搜是一层层的走
时间复杂度 O(n+m), n 表示点数,m 表示边数
(1)深度优先遍历
int dfs(int u)
{
    st[u] = true; // st[u] 表示点u已经被遍历过

    for (int i = h[u]; i != -1; i = ne[i])
    {
        int j = e[i];
        if (!st[j]) dfs(j);
    }
}
(2) 宽度优先遍历
queue<int> q;
st[1] = true; // 表示1号点已经被遍历过
q.push(1);

while (q.size())
{
    int t = q.front();
    q.pop();

    for (int i = h[t]; i != -1; i = ne[i])
    {
        int j = e[i];
        if (!st[j])
        {
            st[j] = true; // 表示点j已经被遍历过
            q.push(j);
        }
    }
}
4、拓扑排序
图的广搜的经典应用:求拓扑序
有向无环图又被称为拓扑图
没太听懂,可以看这个:
https://www.acwing.com/solution/content/103954/
5、最短路径算法
知识结构图:
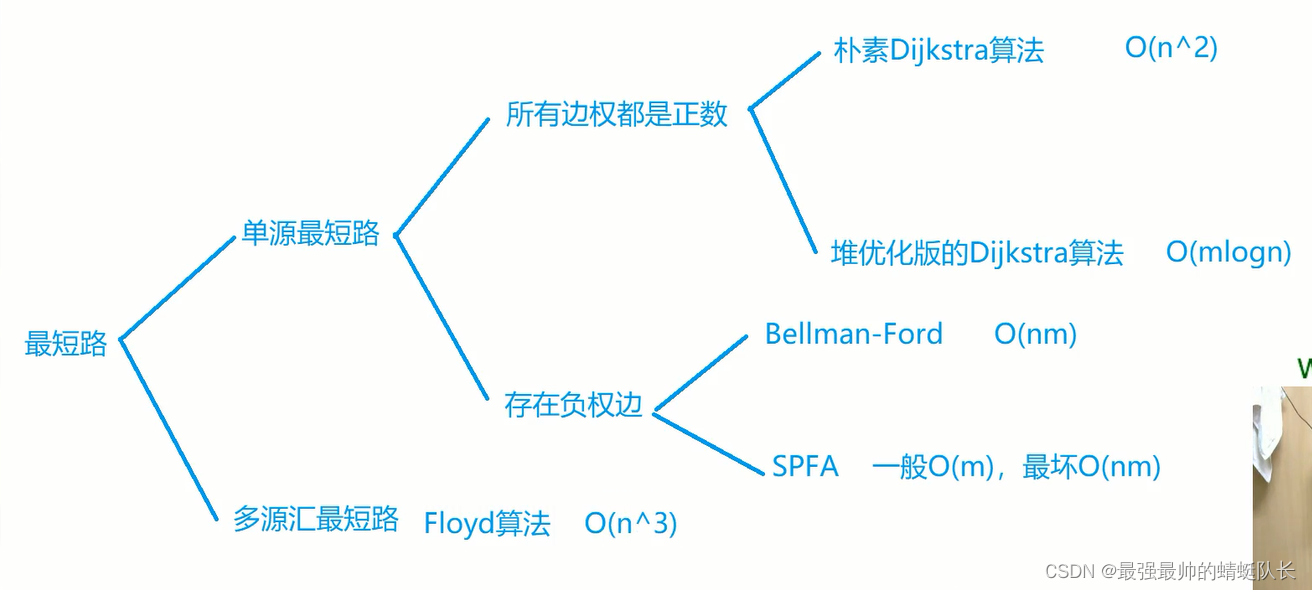
不会考察证明算法的正确性,而要考察建图,如何把原问题抽象成一个最短路问题,如何定义点和边。这个过程是最难的。
前面很多问题,或者后面的数学问题,侧重于原理,侧重于证明。
最短路算法,侧重于抽象,侧重于实现。
(1)朴素dijkstra算法(基于贪心算法)
时间复杂是 O(n^2+m), n 表示点数,m 表示边数。
适合边很多的稠密图。
步骤:
- 第一个点到起点为0,其他点到起点为正无穷(一个很大的数即可)。
- 遍历,每次确定一个点到起点的最短路
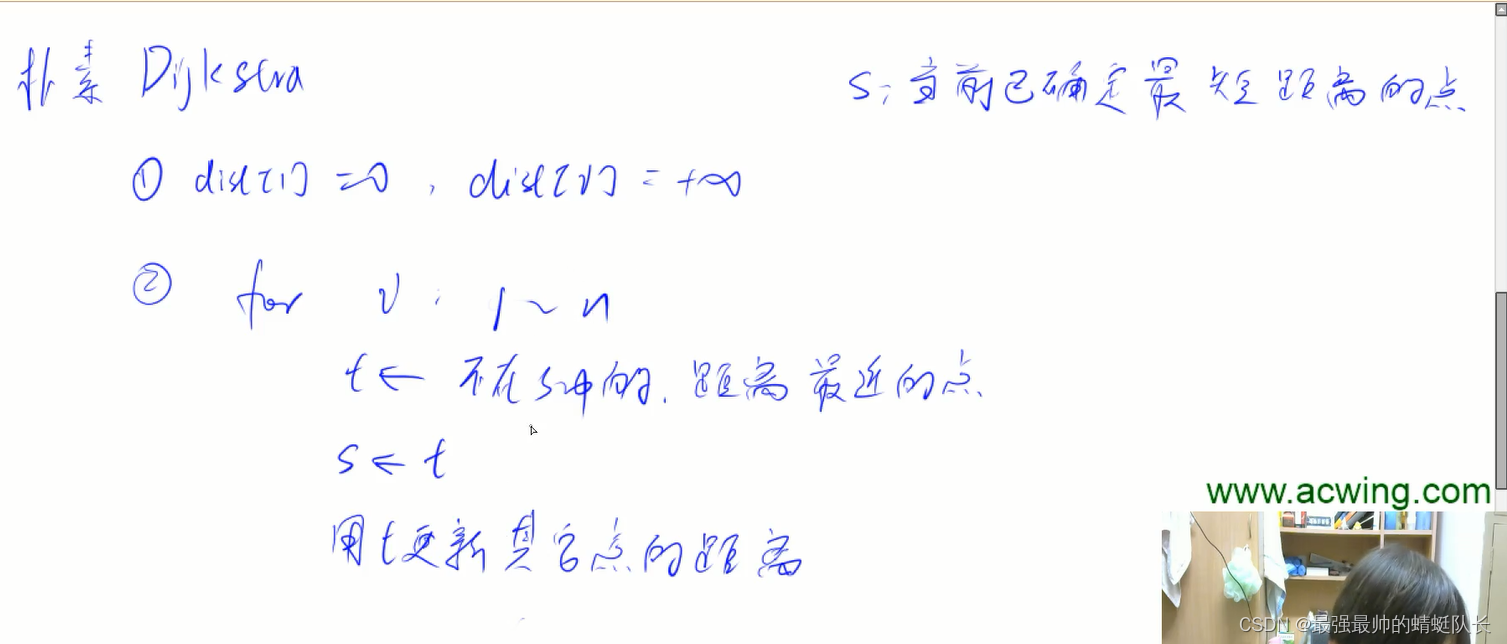
朴素dijkstra算法,边数很多,是个稠密图,稠密图用邻接矩阵存储。
https://www.acwing.com/solution/content/38318/
(2)堆优化版dijkstra
时间复杂度 O(mlogn),n 表示点数,m 表示边数。
如果是一个稀疏图,有10w个点,朴素dijkstra 肯定会超时,
这里面用时最多的是找距离最近的点,也就是求最小值,那么可以用小根堆。
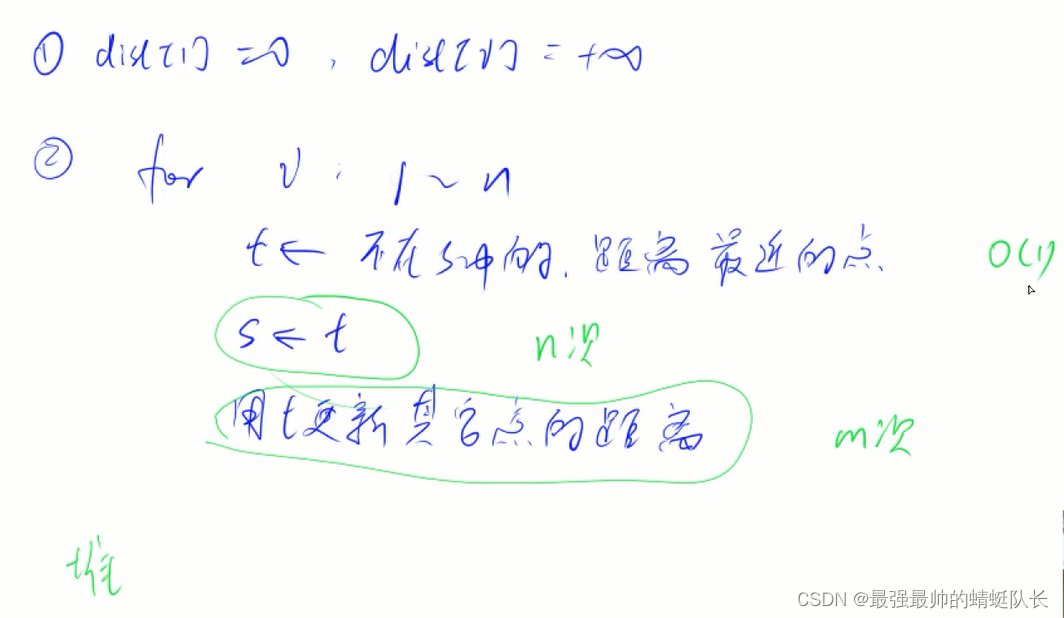
https://www.acwing.com/solution/content/6554/
(3)Bellman-Ford算法(基于离散数学的一些知识)
时间复杂度 O(nm), n 表示点数,m 表示边数
这里外层循环为什么是 n 次。
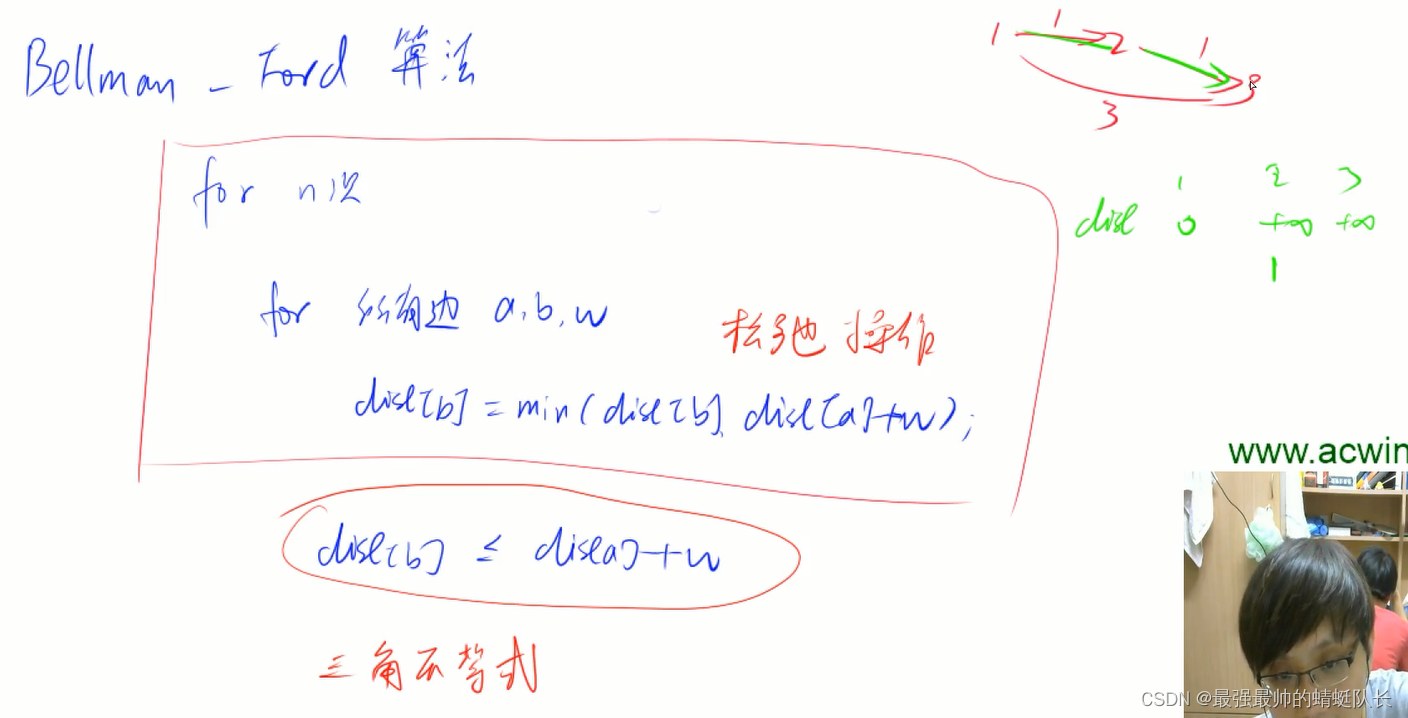
存边方式,随便存,只要能保存就可以
为什么有负环,结果为负无穷。
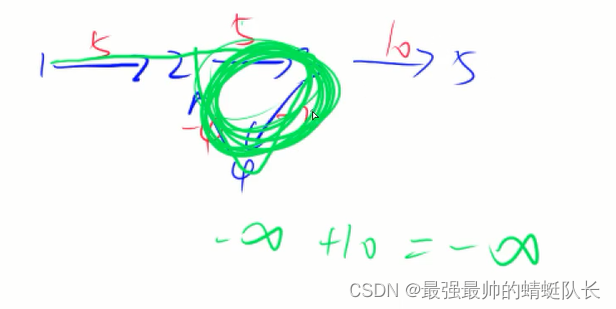
https://www.acwing.com/solution/content/6320/
(4)SPFA 算法(队列优化的Bellman-Ford算法)
时间复杂度 平均情况下 O(m),最坏情况下 O(nm), n 表示点数,m 表示边数
先把起点放到队列中,之后把每一个变小的节点放到队列中,只要队列不空
https://www.acwing.com/solution/content/105508/
(5)SPFA 判断图中是否存在负环
时间复杂度是 O(nm),n 表示点数,m 表示边数
(6)floyd算法(基于动态规划)
时间复杂度是 O(n^3),n 表示点数
6、最小生成树
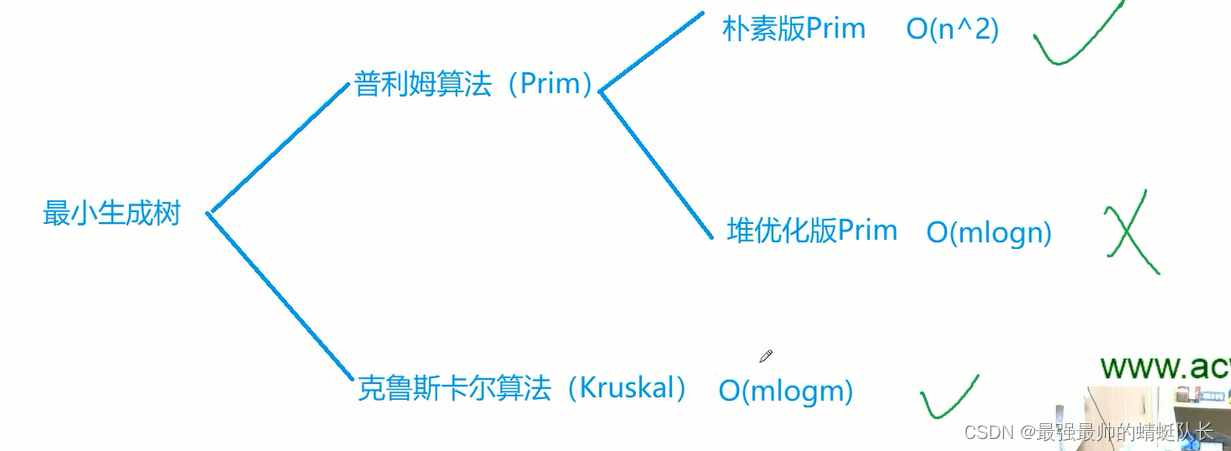
稠密图用 Prim,稀疏图用 Kruskal,堆优化Prim 不常用,它和 Kruskal 都是对应稀疏图,但 Kruskal 代码更清晰,更短。
(1) Prim(普里姆)算法
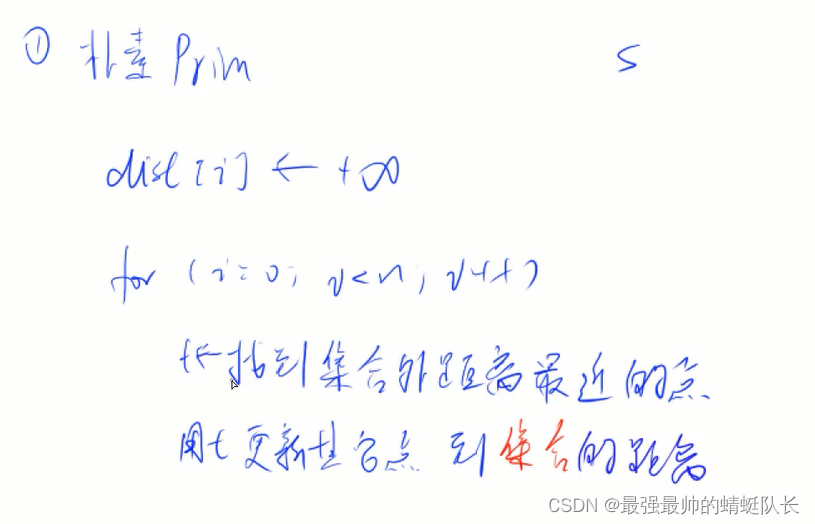
和 dijkstra 算法很像,都是使用贪心的思想,dijkstra 算法是用 t 来更新其他点到起点的距离,prim 是用来更新其他点到集合的距离。
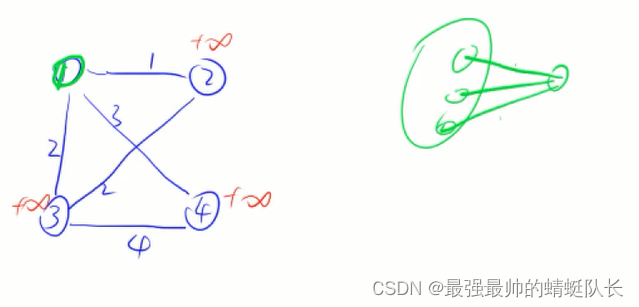
每次找到离集合最近的点,然后更新到集合中。
https://www.acwing.com/solution/content/38312/

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)