数据结构之哈希表
1. 哈希表
不考虑顺序、不考虑Key的比较性,使用哈希表实现映射平均复杂度甚至可以到达
O(1),一个典型的空间换时间,又称散列表。
使用红黑树实现的TreeMap添加、删除和搜索的平均复杂度是O(logn),其特点是key必须具备可比较性且元素分布是顺序的。
但在实际应用中,很多时候存储的元素不具有可比性,key也不需要具备可比性。
1.1 存储方式
根据传入的key计算出相应的hash值作为数组的索引。
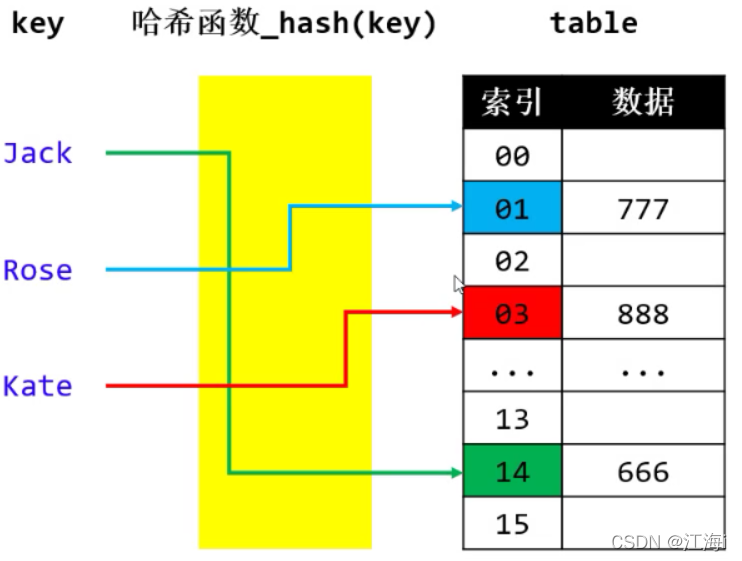
添加、搜索删除的流程都是O(1)。
哈希表内部的数组元素,有时也被称为Bucket(桶),整个数组叫Buckets。
1.2 哈希值
1.2.1 哈希冲突(Hash Collision)及解决方案
也称为哈希碰撞,是两个不同的key,经过哈希值函数计算出相同的结果。
- 开放定址法(Open Addressing):按照一定的规则向其它地址探测,直到遇到空桶。
- 再哈希法(Re-Hashing):设计多个哈希函数。
- 链地址法(Seprarte Chaining):通过链表将同一
index的元素串起来。
1.2.2 JDK1.8 解决方案
JDK1.8 使用 链表 + 红黑树 解决哈希冲突。
使用单向链表将元素穿起来;
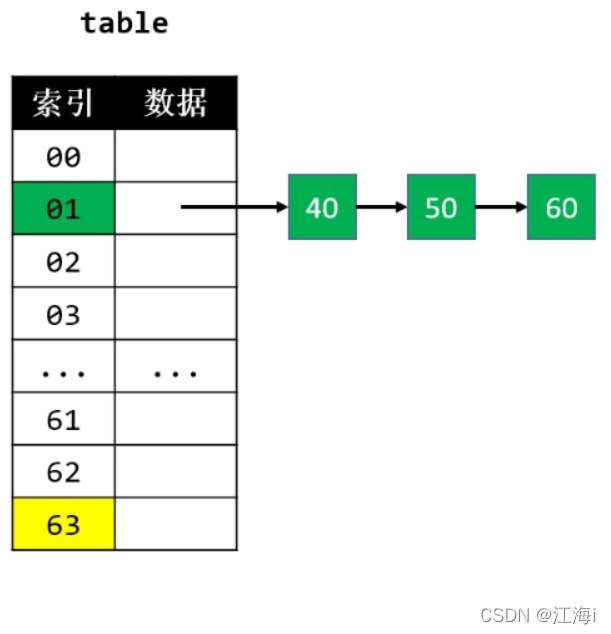
当元素的值超过一定范围,会由单向链表转为红黑树来存储。
默认范围:哈希表容量(桶数量) ≥ 64,单向链表节点数量大于 8 。
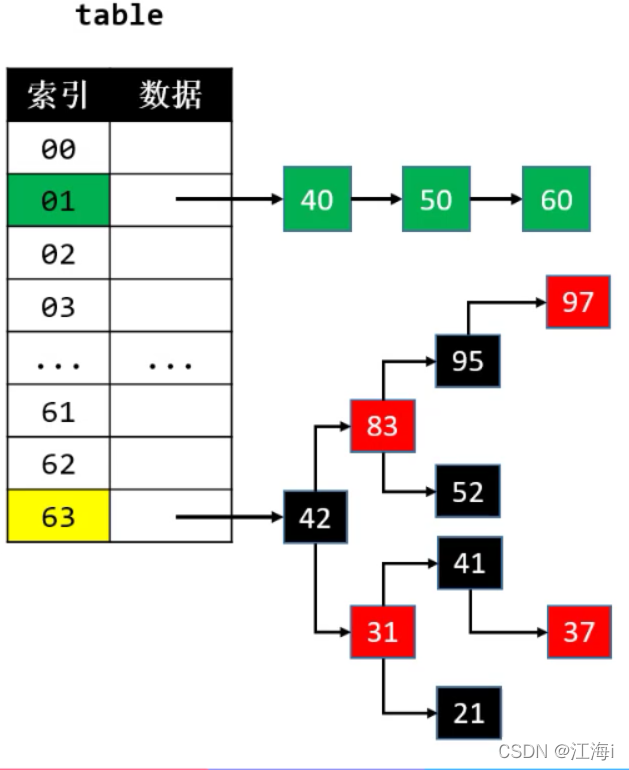
但是当元素数量又少到一定程度时,又会转为单向链表。
1.2.3 哈希函数作用
- 先生成
key对应的整数哈希值; - 使用生成的哈希值与数组的大小进行相关运算,生成一个索引值;
根据数组大小计算索引值时,如果使用
%运算,会导致概率会很低。这里可以使用&运算,但是需要保证数组的长度为 2n 次方。
与运算:1001010 & 1101101 = 1001000,即都是1返回1,否则是0。
例如:表的长度 len = 25 = 100000;len - 1 = 011111;新加入的元素的hash值为:1010101 ;1010101 & 0011111 = 0010101
和一个全是1的二进制数进行与运算结果必然小于表的长度。
1.2.4 基本数据类型和字符串的哈希值
-
Int:值直接当作哈希值; -
Float:将存储的二进制格式转为整数值;int bits = floatToIntBits(floatNum); -
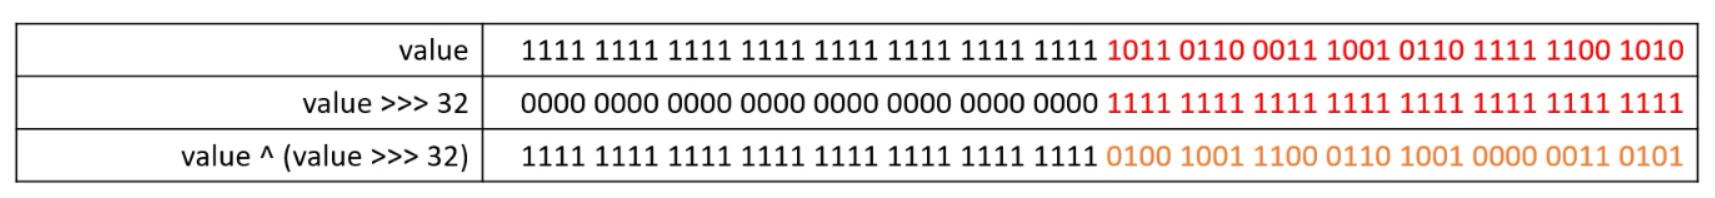
Long:因为long的长度为64,而哈希值类型int为32,因此需要进行转换:(int) (value ^ (value >>> 32));计算方式:实际上就是让高 32 bit 与 低 32 bit 进行异或运算:
-
Double:需要先转为long类型,剩余和long处理相同。long bits = doubleToLongBits(value); -
字符串:本质上字符串是由字符组成,而字符的本质又是一个整数,这就可以使用字符的位数乘以一个数相加的结果。
例如:jack = j * n^3^ + j *n^2^ +... + j *n等价于[ ( j * n + a) * n + c] * n + k。
在JDK中n取31,因为31是奇素数,31 * i可以优化成:(i << 5) - i。
上方计算方法与JDK的实现方式相同。
1.2.5 自定义对象的哈希值
对象的默认哈希值根据对象的内存地址计算出来的。
重写hashCode()方法:计算出所有属性的哈希值,最后再也字符串的方式将所有的哈希值计算出一个全新的哈希值。
/**
 * @Description 自定义对象计算哈希值
 * @date 2022/4/25 15:20
 */
@Data
@AllArgsConstructor
@NoArgsConstructor
public class Person {

    private int age;

    private String name;

    private float weight;

    @Override
    public int hashCode(){
        int hashCode = age;
        hashCode = hashCode * 31 + Float.floatToIntBits(weight);
        hashCode = hashCode * 31 + (name != null ? name.hashCode() : 0);
        return hashCode;
    }
}
1.3 equals()
在hash冲突时(计算出的索引相同),拿到已经存在的key与新的key进行比较,相等就覆盖,不相等就添加到链表最后。该方法就是用来比较key与已经存在的key是否相等。
    /**
     * 比较两个对象是否为同一个对象
     * @param o
     * @return
     */
    @Override
    public boolean equals(Object o) {
        // 如果当前对象和传入的对象内存地址一样,一定是一个对象。
        if (this == o){
            return true;
        }
        // 如果传入的对象为空,获取类型不同,一定不是同一个对象。
        if (o == null || getClass() != o.getClass()) {
            return false;
        }
        // 比较成员变量是否全部相等
        Person person = (Person) o;
        return age == person.age
                && Float.compare(person.weight, weight) == 0
                && Objects.equals(name, person.name);
    }
1.4 代码实现
这里直接使用数组+红黑树实现。 将红黑树的根节点存放到数组中。
1.4.1 节点设计
存储 k - v 形式的红黑树节点
private static class Node<K, V> {
        int hash;
        K key;
        V value;
        boolean color = RED;
        Node<K, V> left;
        Node<K, V> right;
        Node<K, V> parent;
        public Node(K key, V value, Node<K, V> parent) {
            this.key = key;
            int hash = key == null ? 0 : key.hashCode();
            // 根据运算得到哈希值
            this.hash = hash ^ (hash >>> 16);
            this.value = value;
            this.parent = parent;
        }

        public boolean isLeaf() {
            return left == null && right == null;
        }

        public boolean hasTwoChildren() {
            return left != null && right != null;
        }

        public boolean isLeftChild() {
            return parent != null && this == parent.left;
        }

        public boolean isRightChild() {
            return parent != null && this == parent.right;
        }

        public Node<K, V> sibling() {
            if (isLeftChild()) {
                return parent.right;
            }

            if (isRightChild()) {
                return parent.left;
            }
            return null;
        }
    }
1.4.2 成员变量
	// 红黑树节点颜色
    private static final boolean RED = false;
    private static final boolean BLACK = true;

    // 默认长度为 2 的 4 次方
    private static final int DEFAULT_CAPACITY = 1 << 4;


    // 哈希表长度
    private int size;

    // 哈希数组(存放红黑树的根节点)
    private Node<K,V>[] table;
1.4.3 简单方法实现
    public HashMap(){
        table = new Node[DEFAULT_CAPACITY];
    }

    @Override
    public int size() {
        return size;
    }

    @Override
    public boolean isEmpty() {
        return size == 0;
    }

    @Override
    public void clear() {
        if (size == 0){
            return;
        }
        // 清空table
        Arrays.fill(table, null);
        size = 0;
    }
1.4.4 添加
-
计算索引:
/** * 根据 key 计算索引 * @param k * @return 索引 */ private int index(K k){ return hash(k) & (table.length - 1); } /** * 扰动计算 * @param k * @return */ private int hash(K k){ // 如果传入的 k 为空,返回 0 if (k == null){ return 0; } int hash = k.hashCode(); return hash ^ (hash >>> 16); } /** * 返回节点的索引 * @param node * @return 索引 */ private int index(Node<K,V> node){ return (node.hash) & (table.length - 1); } -
查找节点:
	/**
     * 根据 k 传入节点
     * @param k
     * @return
     */
    private Node<K,V> node(K k){
        Node<K, V> root = table[index(k)];
        return root == null ? null : node(root,k);
    }

    /**
     * 递归查找节点
     * @param node
     * @param k
     * @return
     */
    private Node<K,V> node(Node<K,V> node,K k){
        // 获取扰动计算的哈希值
        int newHash = hash(k);
        Node<K,V> resultNode = null;
        int cmp = 0;
        while (node != null){
            K oldK = node.key;
            int oldHash = node.hash;
            if (newHash > oldHash){ // 新节点哈希值大 - 往右找
                node = node.right;
            }else if (oldHash > newHash){ // 新节点哈希值小 - 往左找
                node = node.left;
            }else if(Objects.equals(k,oldK)){ // 哈希相等,equals,直接返回
                return node;
            }else if (oldK != null && k != null // 都不为空,且一种类型,具备可比较性,并且结果不为0
                    && oldK.getClass() == k.getClass()
                    && k instanceof Comparable
                    && (cmp = ((Comparable) k).compareTo(oldK)) != 0) {
                node = cmp > 0 ? node.right : node.left;
            }else if (node.right != null  // 哈希相等,不具可比较性,不equals 扫描左右子树,并且返回的节点不为空
                    && (resultNode = (node(node.right,k))) != null){
                return resultNode;
            }else {
                node = node.left;
            }
        }
        return null;
    }
-
添加:这里的添加就是,比较比较再比较,然后根据计算出的索引,如果相同就存放到根节点红黑树中。
public V put(K k, V v)  {
        int index = index(k);
        // 判断索引位置是否有元素
        Node<K, V> root = table[index];
        if (root == null){ // 没有元素,添加到索引位置,并作为红黑树的根节点
            root = new Node<>(k,v,null);
            table[index] = root;
            size ++;
            // 修复红黑树性质
            afterPut(root);
            return null;
        }
        // 添加的不是第一个节点
        // 找到父节点
        Node<K, V> parent = root;
        Node<K, V> node = root;
        int cmp = 0;
        int newHash = hash(k);
        // 存放扫描结果
        Node<K,V> result = null;
        // 判断是否已经扫描过了
        boolean searched = false;
        do {
            parent = node;
            // 当前索引的 k 和 hash
            K oldK = node.key;
            int oldHash = node.hash;
            if (newHash > oldHash){
                cmp = 1;
            }else if (newHash < oldHash){
                cmp = -1;
            }else if (Objects.equals(k,oldK)){ // 哈希值相同且equals直接覆盖
                cmp = 0;
            }else if (k != null && oldK != null // 可以比较并且比较值不为0
                    && k.getClass() == oldK.getClass()
                    && k instanceof Comparable
                    && (cmp = ((Comparable) k).compareTo(oldK)) != 0){

            }else if (searched){ // 已经扫描过了,没有相同的k,直接内存地址相减。
                cmp = System.identityHashCode(k) - System.identityHashCode(oldK);
            }else {
                // 扫描左右判断,已经存在就覆盖。
                if ((node.left != null && (result = node(node.left,k)) != null)
                        || (node.left != null && (result = node(node.left,k)) != null)){
                    node = result;
                    cmp = 0;
                }else { // 不存在 k
                    searched = true;
                    cmp = System.identityHashCode(k) - System.identityHashCode(oldK);
                }
         	}
            if (cmp > 0) {
                node = node.right;
            } else if (cmp < 0) {
                node = node.left;
            } else { // 相等就把k 和 v 一块覆盖掉
                node.key = k;
                V oldValue = node.value;
                node.value = v;
                return oldValue;
            }
        } while (node != null);
        // 插入到父节点的哪个位置
        Node<K, V> newNode = new Node<>(k, v, parent);
        if (cmp > 0) {
            parent.right = newNode;
        } else {
            parent.left = newNode;
        }
        size++;
        // 新添加节点之后的处理
        afterPut(newNode);
        return null;
    }
1.4.5 get() 和 containsKey()
	public V get(K k) {
        Node<K, V> node = node(k);
        return node == null ? null : node.value;
    }
    public boolean containsKey(K k) {
        return get(k) != null;
    }
1.4.6 remove()
 	public V remove(K k) {
        return remove(node(k));
    }
   private V remove(Node<K,V> node){

        if (node == null){
            return null;
        }
        size--;

        V oldValue = node.value;

        // 判断度为2
        if (node.hasTwoChildren()){
            // 获取后继节点
            Node<K,V> s = successor(node);
            // 后继节点的值覆盖当前节点的值
            node.key = s.key;
            node.value = s.value;
            node.hash = s.hash;
            // 将node指向s节点
            node = s;
        }

        // 获取被删除节点的子节点,如果左子节点为空则获取右子节点;
        // 如果子节点都为空,则表示该节点是叶子节点返回null。
        Node<K,V> relacement = node.left != null ? node.left : node.right;

        // 当前索引中的根节点
        int index = index(node);
        if (relacement != null){ // node 是度为1的节点
            // 更改parent
            relacement.parent = node.parent;
            // 更改parent的left(right)的指向
            if (node.parent == null){ // node是度为1的根节点。
                table[index] = relacement;
            }else if (node == node.parent.left){ // 被删除节点是父节点的左子节点
                node.parent.left = relacement;
            } else { // 被删除节点是父节点的右子节点
                node.parent.right = relacement;
            }
            // 删除之后处理
            afterRemove(relacement);
        }else if(node.parent == null){ // node是叶子节点并且是根节点
            table[index] = null;
            // 删除之后处理
            afterRemove(node);
        }else { //node 是普通叶子节点
            if (node == node.parent.left){ // 当前节点是父节点的右子节点
                node.parent.left = null;
            }else { // 是父节点的左子节点
                node.parent.right = null;
            }

            // 删除之后处理
            afterRemove(node);
        }
        return oldValue;
    }
1.4.6 containsValue()
	public boolean containsValue(V v) {
        if (size == 0){
            return false;
        }
        Queue<Node<K,V>> queue = new LinkedList();
        for (Node<K, V> kvNode : table) {
            if (kvNode == null) {
                continue;
            }
            queue.offer(kvNode);
            while (!queue.isEmpty()) {
                Node<K, V> node = queue.poll();
                if (Objects.equals(v, node.value)) {
                    return true;
                }
                if (node.left != null) {
                    queue.offer(node.left);
                }
                if (node.right != null) {
                    queue.offer(node.right);
                }
            }
        }
        return false;
    }
1.4.8 traversal()
	public void traversal(Visitor<K, V> visitor) {
        if (size == 0 || visitor == null){
            return;
        }
        Queue<Node<K,V>> queue = new LinkedList();
        for (Node<K, V> kvNode : table) {
            if (kvNode == null) {
                continue;
            }
            queue.offer(kvNode);
            while (!queue.isEmpty()) {
                Node<K, V> node = queue.poll();
                if (visitor.visit(node.key,node.value)){
                    return;
                }
                if (node.left != null) {
                    queue.offer(node.left);
                }
                if (node.right != null) {
                    queue.offer(node.right);
                }
            }
        }
    }
1.4.9 扩容
装填因子: 节点总数量 / 哈希表通数组长度,也叫负载因子。在JDK1.8中,如果装填因子超过0.75,就扩容为原来的两倍。
- 新增装填因子全局变量:
	// 装填因子
    private static final float DEFAULT_LOAD_FACTOR = 0.75f;
- 移动节点方法
 	 /**
     * 移动节点
     * @param newNode
     */
    private void moveNode(Node<K, V> newNode){
        // 重置node
        newNode.parent = null;
        newNode.right = null;
        newNode.left = null;
        newNode.color = RED;

        int index = index(newNode.key);
        // 判断索引位置是否有元素
        Node<K, V> root = table[index];
        if (root == null){ // 空桶
            root = new Node<>(newNode.key,newNode.value,null);
            table[index] = root;
            // 修复红黑树性质
            afterPut(root);
            return;
        }
        // 添加的不是第一个节点
        Node<K, V> parent = root;
        Node<K, V> node = root;
        int cmp = 0;
        K newK = newNode.key;
        int newHash = newNode.hash;
        do {
            parent = node;
            // 当前索引的 k 和 hash
            K oldK = node.key;
            int oldHash = node.hash;
            if (newHash > oldHash){
                cmp = 1;
            }else if (newHash < oldHash){
                cmp = -1;
            }else if (newK != null && oldK != null // 可以比较并且比较值不为0
                    && newK.getClass() == oldK.getClass()
                    && newK instanceof Comparable
                    && (cmp = ((Comparable) newK).compareTo(oldK)) != 0){
            }else {
                cmp = System.identityHashCode(newK) - System.identityHashCode(oldK);
            }
            if (cmp > 0) {
                node = node.right;
            } else if (cmp < 0) {
                node = node.left;
            }
        } while (node != null);

        if (cmp > 0) {
            parent.right = newNode;
        } else {
            parent.left = newNode;
        }
        newNode.parent = parent;
        afterPut(newNode);
    }
- 扩容
	 /**
     * 扩容方法
     */
    private void resize(){
        // 装填因子不足够扩容
        if ((size / table.length) <= DEFAULT_LOAD_FACTOR){
            return;
        }
        Node<K, V>[] oldTable = this.table;
        // 容量阔为原先的两倍
        this.table = new Node[this.table.length << 1];
        // 扩容之后,原先的索要么不变,要么变为index + 旧容;
        Queue<Node<K,V>> queue = new LinkedList();
        for (Node<K, V> kvNode : oldTable) {
            if (kvNode == null) {
                continue;
            }
            queue.offer(kvNode);
            while (!queue.isEmpty()) {
                Node<K, V> node = queue.poll();
                if (node.left != null) {
                    queue.offer(node.left);
                }
                if (node.right != null) {
                    queue.offer(node.right);
                }
                // 移动节点
                moveNode(node);
            }
        }
    }
- 在
put开始中调用即可
2. LinkedHashMap
在
HashMap的基础上维护元素的添加顺序,使得遍历的结果是遵从添加顺序的。
2.1 构建节点类
如果想要维护元素的添加顺序,使用维护一个双向的指针是最好的选择。
- 创建
first和last全局变量:因为链表无论如何存储都需要一个头尾节点。
	// 头节点和尾节点
    private LinkedNode<K,V> first;
    private LinkedNode<K,V> last;
-
创建节点类
private static class LinkedNode<K,V> extends Node<K,V>{ LinkedNode<K,V> prev; LinkedNode<K,V> next; public LinkedNode(K key, V value, Node<K, V> parent) { super(key, value, parent); } } -
HashMap新增createNode()接口:因为HashMap中的红黑树保存的是Node节点,无法在LinkedHashMap中使用,添加一个创建节点的方法由子类去实现,可以达到添加子类节点的目的。/** * 创建节点 * @return */ protected Node<K,V> createNode(K key, V value, Node<K, V> parent){ return new Node<>(key,value,parent); } -
修改
HashMap.put()方法中创建节点,使用createNode()实现。 -
LinkedHashMap实现方法:
 	@Override
    protected Node<K, V> createNode(K key, V value, Node<K, V> parent) {
        LinkedNode<K, V> node = new LinkedNode<>(key, value, parent);
        if (first == null){  // 头节点为空时
            first = last = node;
        }else { // 新元素作为最后一个元素
            last.next = node;
            node.prev = last;
            last = node;
        }
        return node;
    }
2.2 修改方法
clear():在父类的基础上,将first和last赋值为空。
    public void clear() {
        super.clear();
        first = null;
        last = null;
    }
traversal():以链表的方式遍历。
	public void traversal(Visitor<K, V> visitor) {
        if (visitor == null){
            return;
        }
        LinkedNode<K, V> node = this.first;
        while (node != null){
            if (visitor.visit(node.key,node.value)){
                return;
            }
            node = node.next;
        }
    }
-
remove():在父类针对红黑树删除的基础上,删除掉链表之间的线。但是再删除度为2的节点时,会由该节点的后继节点来代替该节点,但此时修改链表指向的节点是替换的节点而不是删除的节点,如下图:删除之前:… 52 -> 37 -> 21 -> 31 -> 41
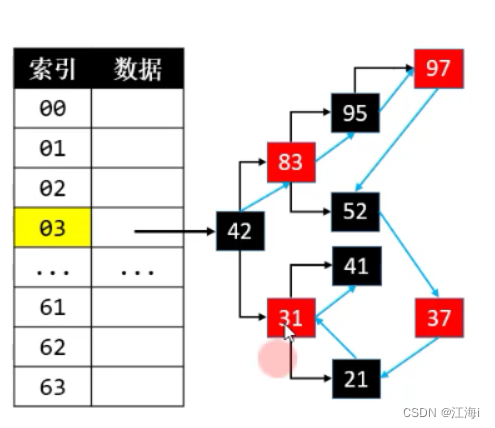
删除31之后:… 52 -> 21 -> 37 -> 41
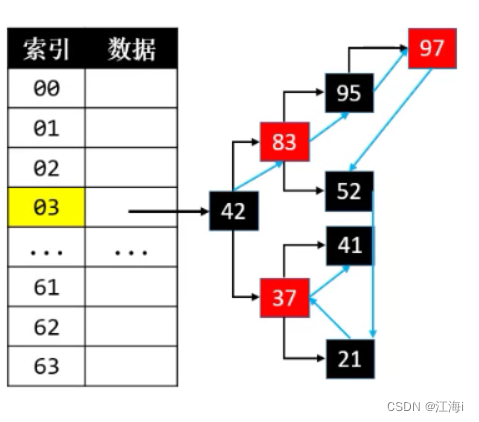
导致21变成了37的前驱节点。发生错误。
新增方法修复链表:
父类新增:/** * 删除之后链表修复,由子类去实现 * @param willNode 想删除的节点 * @param node 真正从内存中删除的节点 */ protected void afterRemoveLinked(Node<K,V> willNode,Node<K,V> node){ }子类实现:
    @Override
    protected void afterRemoveLinked(Node<K,V> willNode, Node<K, V> node) {
        LinkedNode<K, V> linkedWillNode = (LinkedNode<K, V>) willNode;
        LinkedNode<K, V> linkedNode = (LinkedNode<K, V>) node;

        if (linkedWillNode != linkedNode) {
            // 交换linkedWillNode和linkedRemovedNode在链表中的位置
            // 交换prev
            LinkedNode<K, V> tmp = linkedWillNode.prev;
            linkedWillNode.prev = linkedNode.prev;
            linkedNode.prev = tmp;
            if (linkedWillNode.prev == null) {
                first = linkedWillNode;
            } else {
                linkedWillNode.prev.next = linkedWillNode;
            }
            if (linkedNode.prev == null) {
                first = linkedNode;
            } else {
                linkedNode.prev.next = linkedNode;
            }

            // 交换next
            tmp = linkedWillNode.next;
            linkedWillNode.next = linkedNode.next;
            linkedNode.next = tmp;
            if (linkedWillNode.next == null) {
                last = linkedWillNode;
            } else {
                linkedWillNode.next.prev = linkedWillNode;
            }
            if (linkedNode.next == null) {
                last = linkedNode;
            } else {
                linkedNode.next.prev = linkedNode;
            }
        }

        LinkedNode<K, V> prev = linkedNode.prev;
        LinkedNode<K, V> next = linkedNode.next;
        if (prev == null){
            first = next;
        }else {
            prev.next = next;
        }
        if (next == null){
            last = prev;
        }else {
            next.prev = prev;
        }
    }
修改父类
remove(Node<K,V> node):/** * 删除传入节点 * @param node * @return */ protected V remove(Node<K,V> node){ Node<K, V> willNode = node; if (node == null){ return null; } size--; V oldValue = node.value; // 判断度为2 if (node.hasTwoChildren()){ // 获取后继节点 Node<K,V> s = successor(node); // 后继节点的值覆盖当前节点的值 node.key = s.key; node.value = s.value; node.hash = s.hash; // 将node指向s节点 node = s; } // 获取被删除节点的子节点,如果左子节点为空则获取右子节点; // 如果子节点都为空,则表示该节点是叶子节点返回null。 Node<K,V> relacement = node.left != null ? node.left : node.right; // 当前索引中的根节点 int index = index(node); if (relacement != null){ // node 是度为1的节点 // 更改parent relacement.parent = node.parent; // 更改parent的left(right)的指向 if (node.parent == null){ // node是度为1的根节点。 table[index] = relacement; }else if (node == node.parent.left){ // 被删除节点是父节点的左子节点 node.parent.left = relacement; } else { // 被删除节点是父节点的右子节点 node.parent.right = relacement; } // 删除之后处理 afterRemove(relacement); }else if(node.parent == null){ // node是叶子节点并且是根节点 table[index] = null; // 删除之后处理 afterRemove(node); }else { //node 是普通叶子节点 if (node == node.parent.left){ // 当前节点是父节点的右子节点 node.parent.left = null; }else { // 是父节点的左子节点 node.parent.right = null; } // 删除之后处理 afterRemove(node); } afterRemoveLinked(willNode, node); return oldValue; }
3. HashSet和LinkedHashSet
利用哈希表实现set
3.1 HashSet
/**
 * @Description 利用哈希表实现set
 * @date 2022/4/28 17:00
 */
public class HashSet<E> implements Set<E> {

    private HashMap<E,Object> map = new HashMap<>();

    @Override
    public int size() {
        return map.size();
    }

    @Override
    public boolean isEmpty() {
        return map.isEmpty();
    }

    @Override
    public void clear() {
        map.clear();
    }

    @Override
    public boolean contains(E e) {
        return map.containsKey(e);
    }

    @Override
    public void add(E e) {
        map.put(e,null);
    }

    @Override
    public void remove(E e) {
        map.remove(e);
    }

    @Override
    public void traversal(Visitor<E> visitor) {
        map.traversal(new Map.Visitor<E, Object>() {
            @Override
            public boolean visit(E e, Object o) {
                return visitor.visit(e);
            }
        });
    }
}
3.2 LinkedHashSet
/**
 * @Description 利用哈希表实现set
 * @date 2022/4/28 17:00
 */
public class LinkedHashSet<E> implements Set<E> {

    private LinkedHashMap<E,Object> map = new LinkedHashMap<>();

    @Override
    public int size() {
        return map.size();
    }

    @Override
    public boolean isEmpty() {
        return map.isEmpty();
    }

    @Override
    public void clear() {
        map.clear();
    }

    @Override
    public boolean contains(E e) {
        return map.containsKey(e);
    }

    @Override
    public void add(E e) {
        map.put(e,null);
    }

    @Override
    public void remove(E e) {
        map.remove(e);
    }

    @Override
    public void traversal(Visitor<E> visitor) {
        map.traversal(new Map.Visitor<E, Object>() {
            @Override
            public boolean visit(E e, Object o) {
                return visitor.visit(e);
            }
        });
    }
}

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)