mysql的索引略解,二叉树,红黑树,B Tree和B+Tree,回表操作解释
索引
索引是帮助Mysql可以高效获取数据,一种已经排好序的数据结构,即数据存放方式
用二叉树结构做索引的优缺点
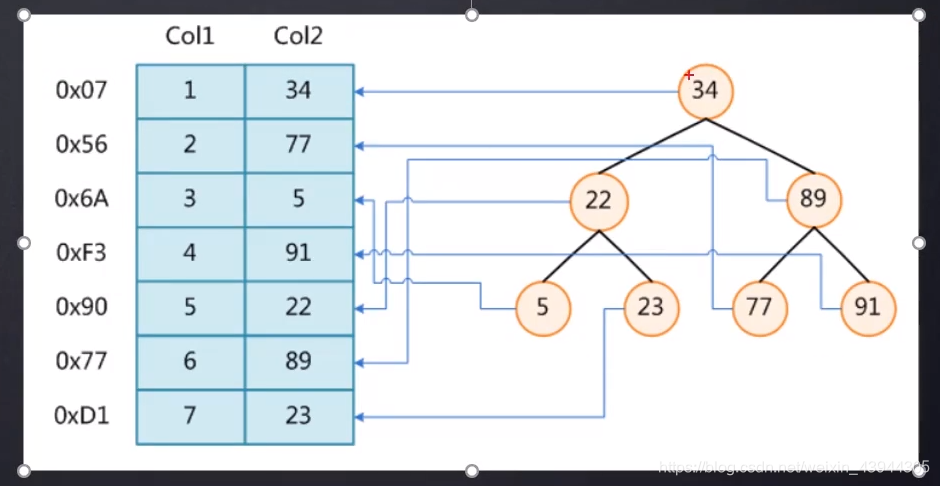
假设有如下一个表t,只有col1和col2两列,将col2设为索引,其索引结构如右边所示,二叉树的右节点的值是大于父节点的,左节点值小于父节点,所以比如查col2=89时,原先没有索引时依次遍历需要6次才能找到,现在有二叉树结构的勾引只需要2次
当找到col2=89时,这个节点保存的是这一行数据的物理磁盘地址,从这可以大致知道这里的二叉树的每个节点其实是一个key-value结构,key是索引字段的值,value是这一行数据的物理磁盘的地址
这里只是举个索引可以加速查找的例子,mysql的索引结构当然不是用的二叉树,而是用的B-TREE
为什么mysql不用二叉树做索引呢,因为存在这样一种情况,demo数据还是上图中的table数据
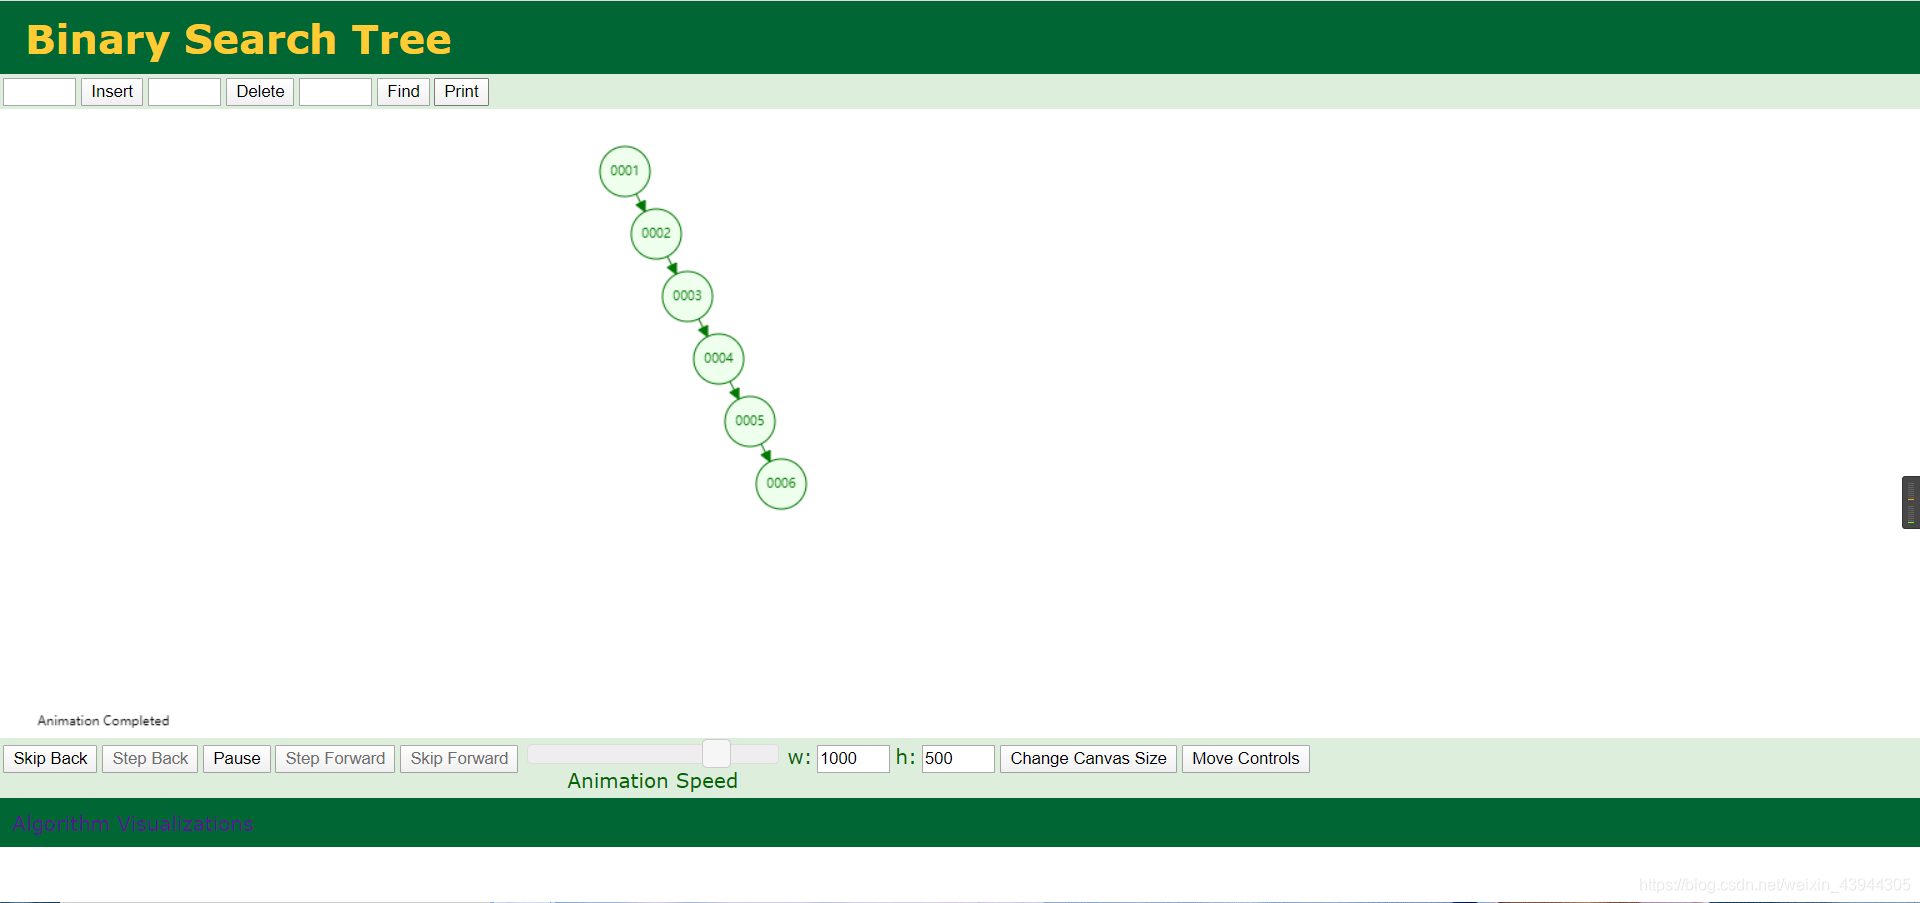
如果将col1作为索引,因为二叉树的右子树的值大于父节点的特性,会形成一个单链表,这样查找数据的时候和没有建索引遍历查询所有表记录的行为是一样的,丝毫没有因为二叉树的结构而加速查找,因为此时其实变成了单链表
分享一个学习网站
https://www.cs.usfca.edu/~galles/visualization/Algorithms.html
ps:在设置完索引后插入数据的时候,其实是先取维护索引字段,维护完之后再去插入这一行数据
用红黑树做索引的优缺点
红黑树也叫自平衡二叉查找树
红黑节点的左旋和右旋,以及增加节点后,树结构的变化规则可以参考这篇博文
https://www.jianshu.com/p/d780ed60874a
看完上篇博文后发现一个问题,有一种现象没解释清楚
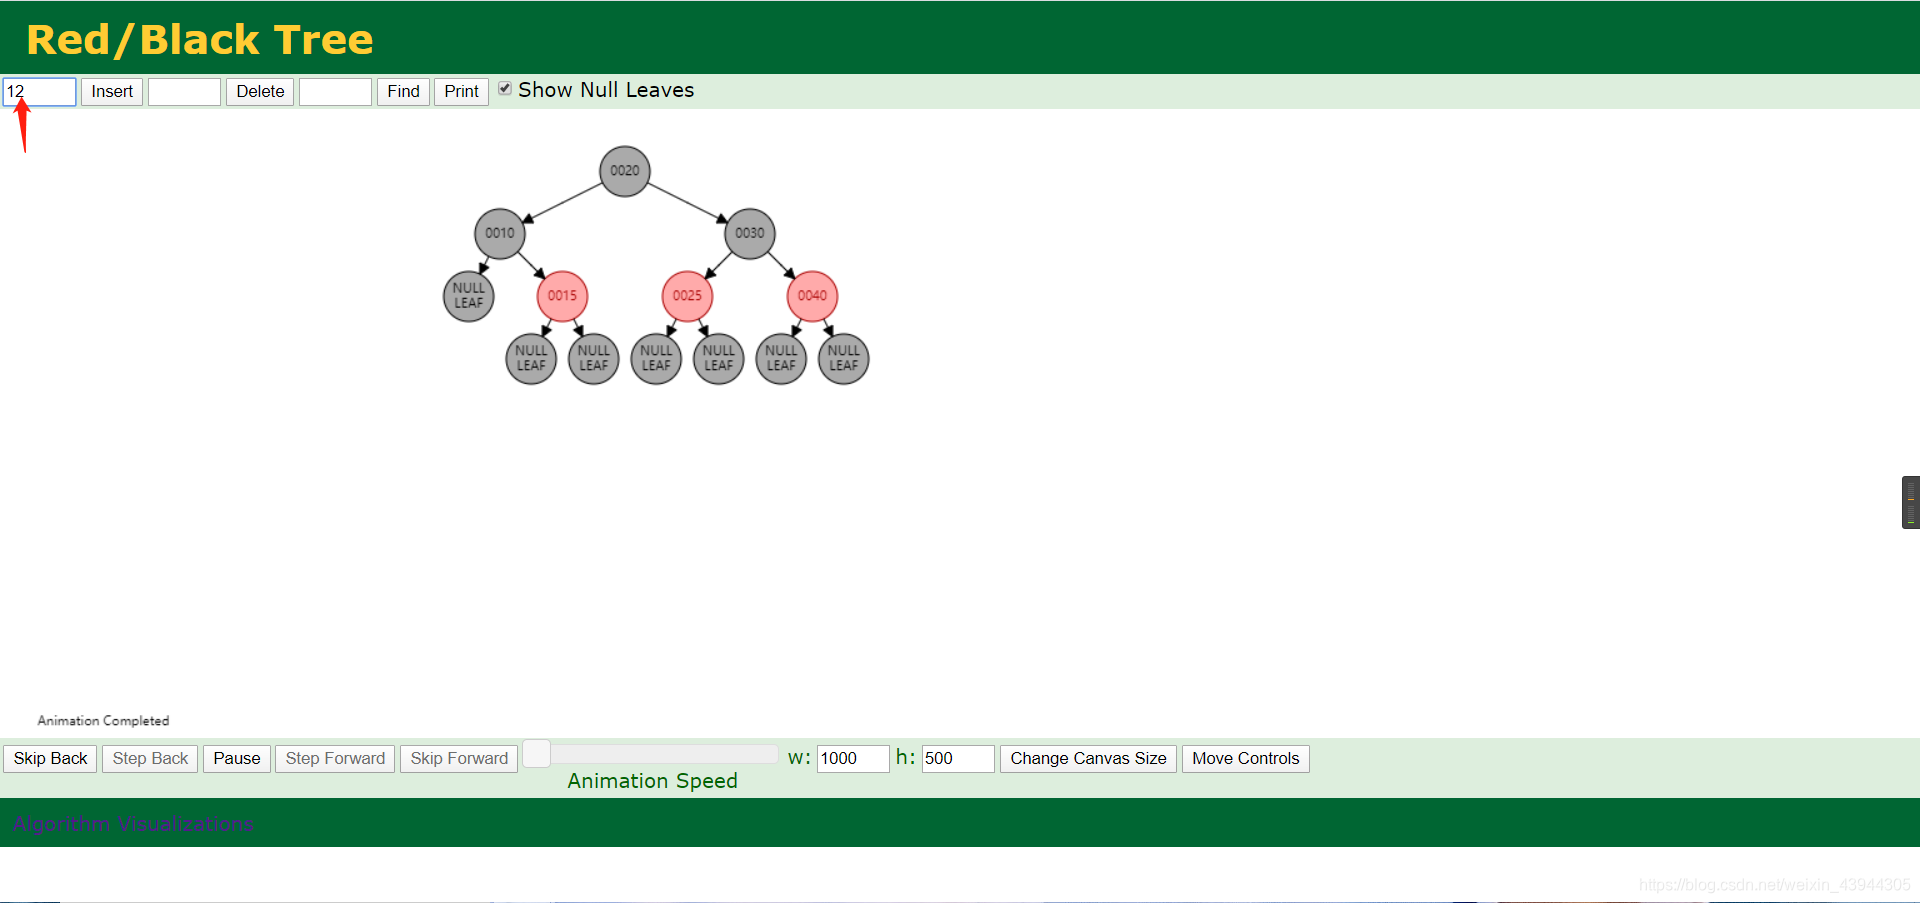
如下图demo所示,再插入一个12节点的值,按照二叉树的原理,这个时候12节点先归于15的左孩子节点,这个时候把空叶子节点展示出来,因为要根据uncle节点来判断做左旋还是右旋嘛.
这个时候uncle节点是黑色,父节点是红色,并且12是父节点的左孩子,父节点是祖父节点的右孩子,这个时候12和15先对换位置,然后把15放到12的右节点处(二叉树的右节点大于父节点规则),之后以10为支点,右旋,12变黑,10成为12的左孩子节点然后变红,15原本就是红色颜色不变
这种情况可以参考这篇博文,里面对于规则以及左旋和右旋后的变色的归纳很是详细
https://zhuanlan.zhihu.com/p/79980618?utm_source=cn.wiz.note
看完后可以在这个网站实际操作,验证一下理解.可以把节点移动速度调慢一点
https://www.cs.usfca.edu/~galles/visualization/RedBlack.html
稍微理解了一下红黑树以及红黑树的规则后我们再来看下图的表结构的col1字段用红黑树做索引的话查询一个值想对于二叉树的提速
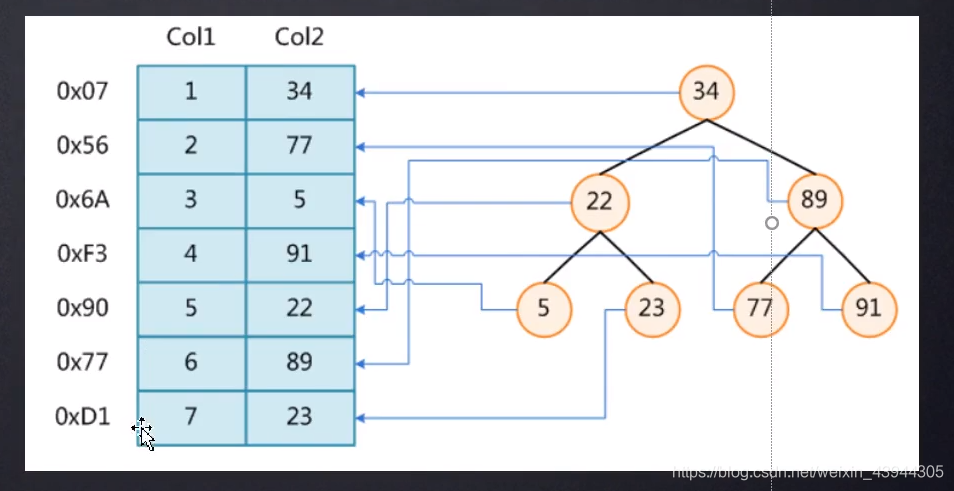
col1索引结构为红黑树查找7的demo
只要查找4次,而二叉树的单链表结构需要遍历查询7次
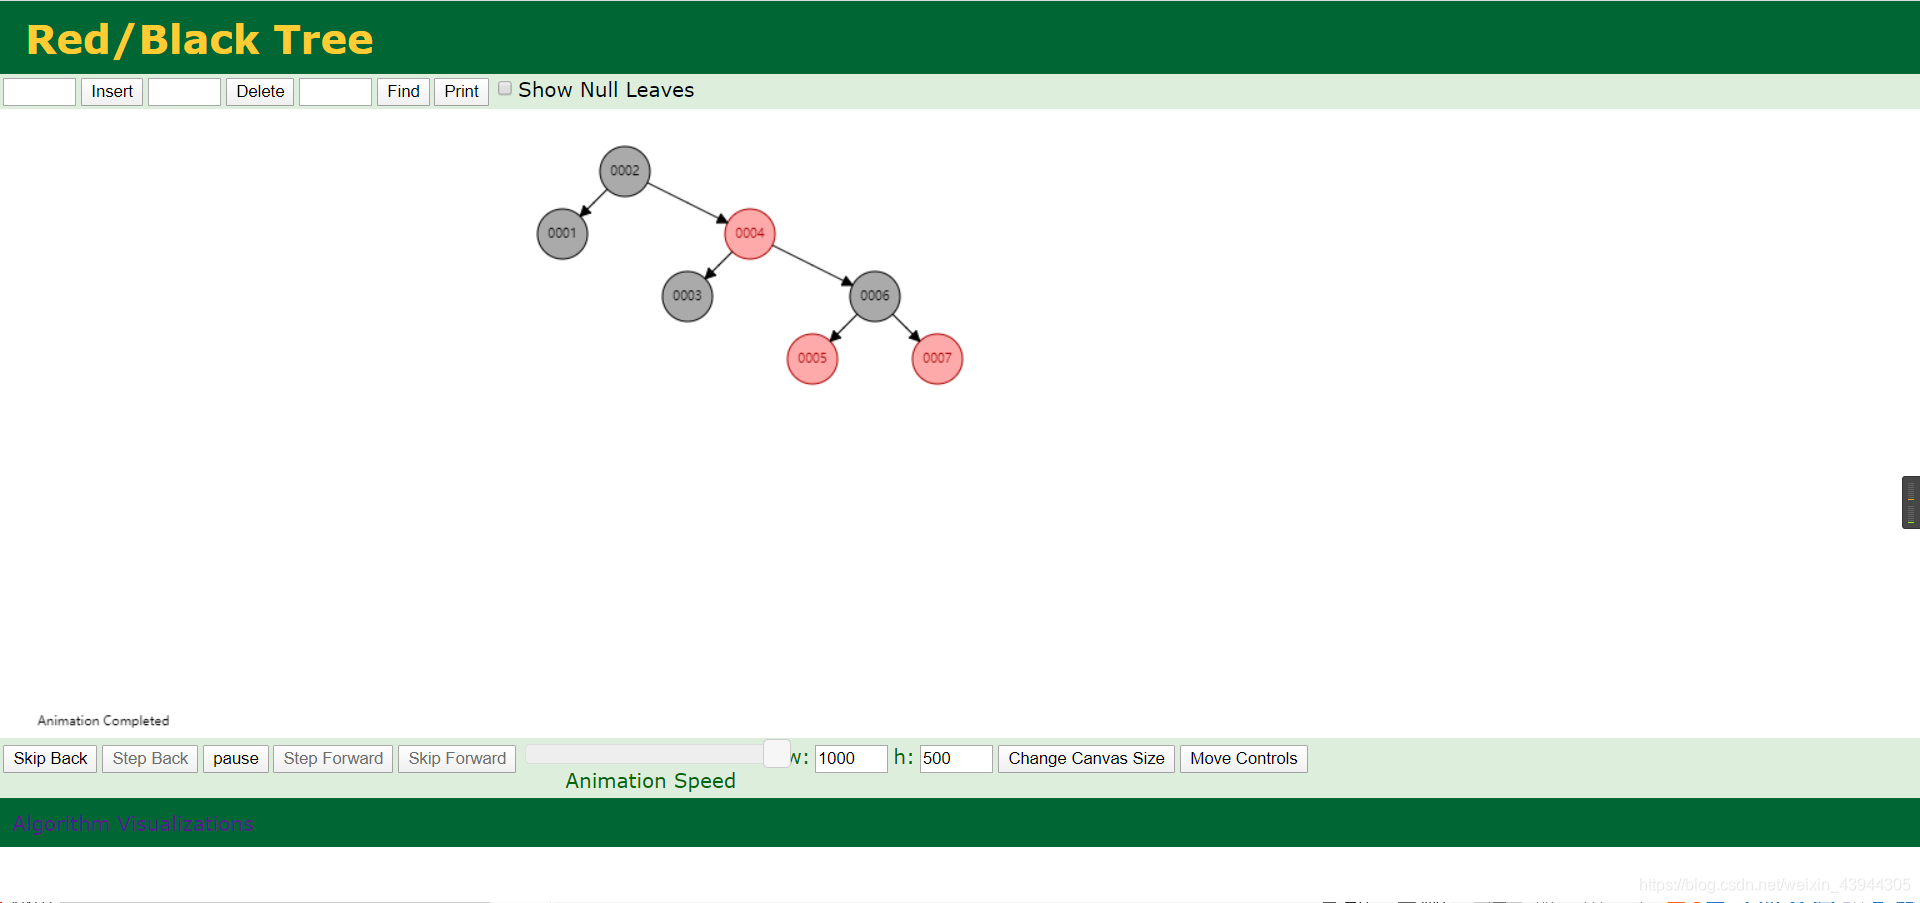
虽然比二叉树要好一点但是如果数据量太大,那么红黑树的查询效率其实也不是很高,也要通过比较查询每个节点,因为它其实也是key-value类型,每个节点是一个key,数据量大的话树的深度也会增加,这样其实就需要比较很多次,效率不高
比红黑树更好的结构,B+Tree结构作为索引的结构
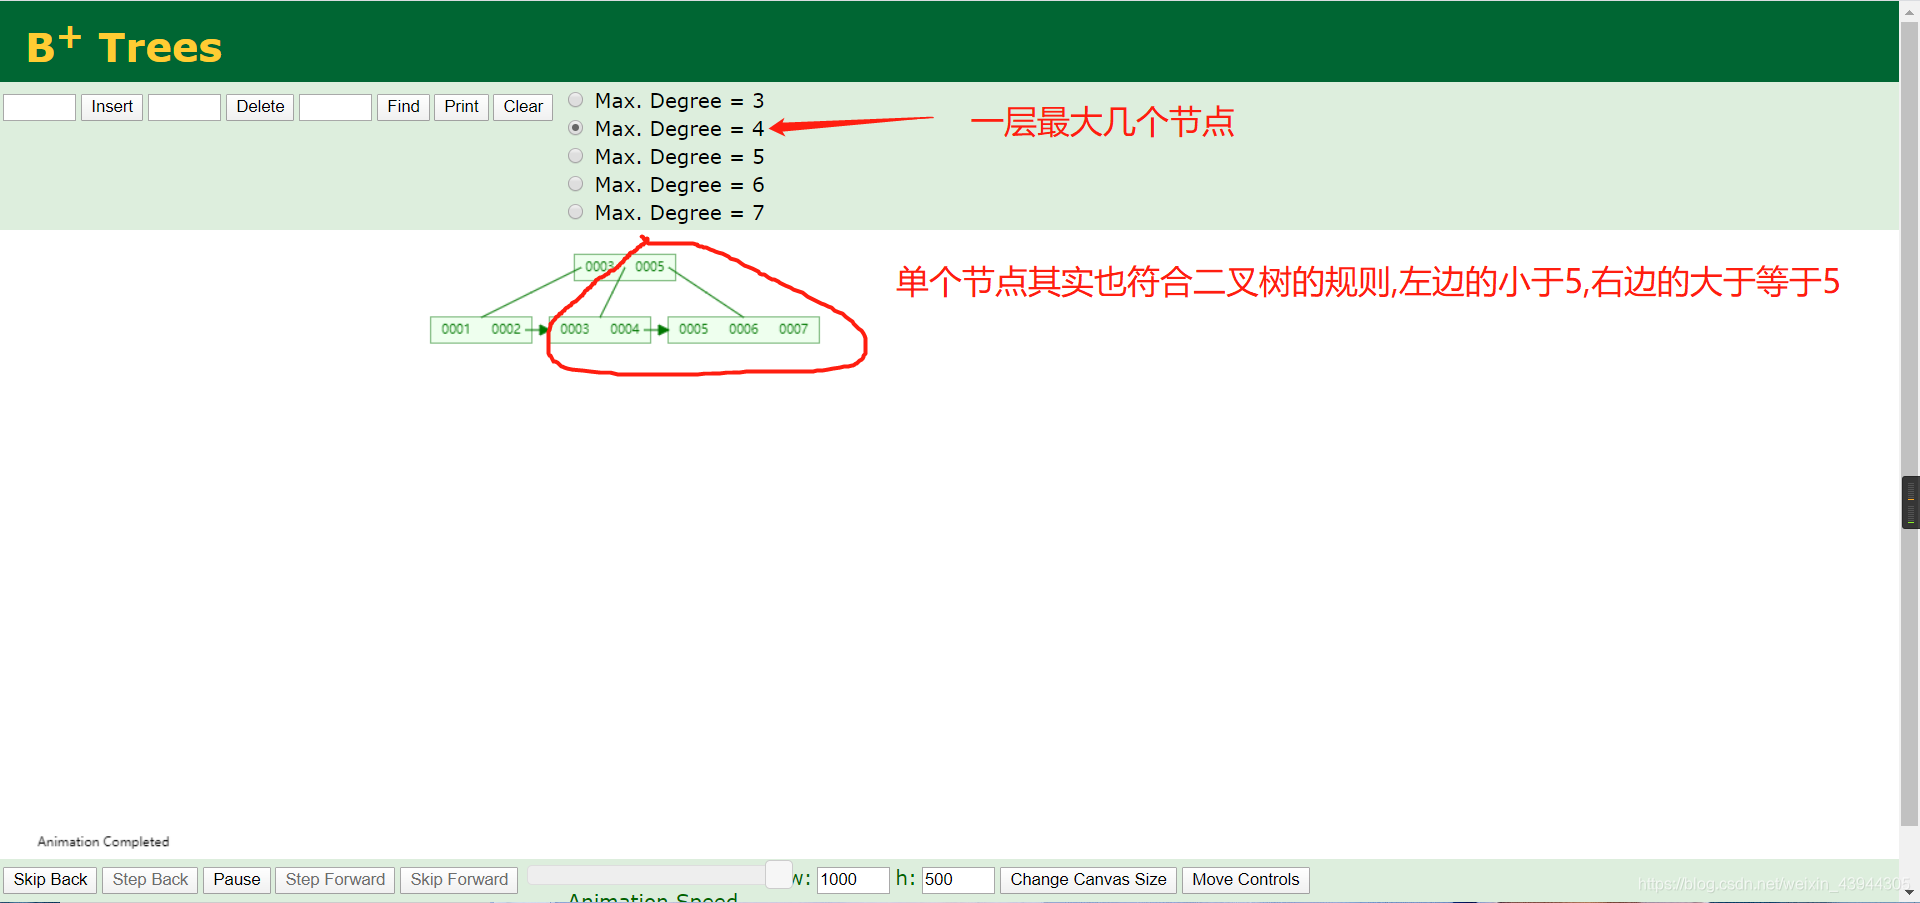
思路是对红黑树进行改造,原本一个节点只有一个key,索引在大数据量下树深度很大,那么如果每个节点存储多个key,那么树的深度就可以缩小很多
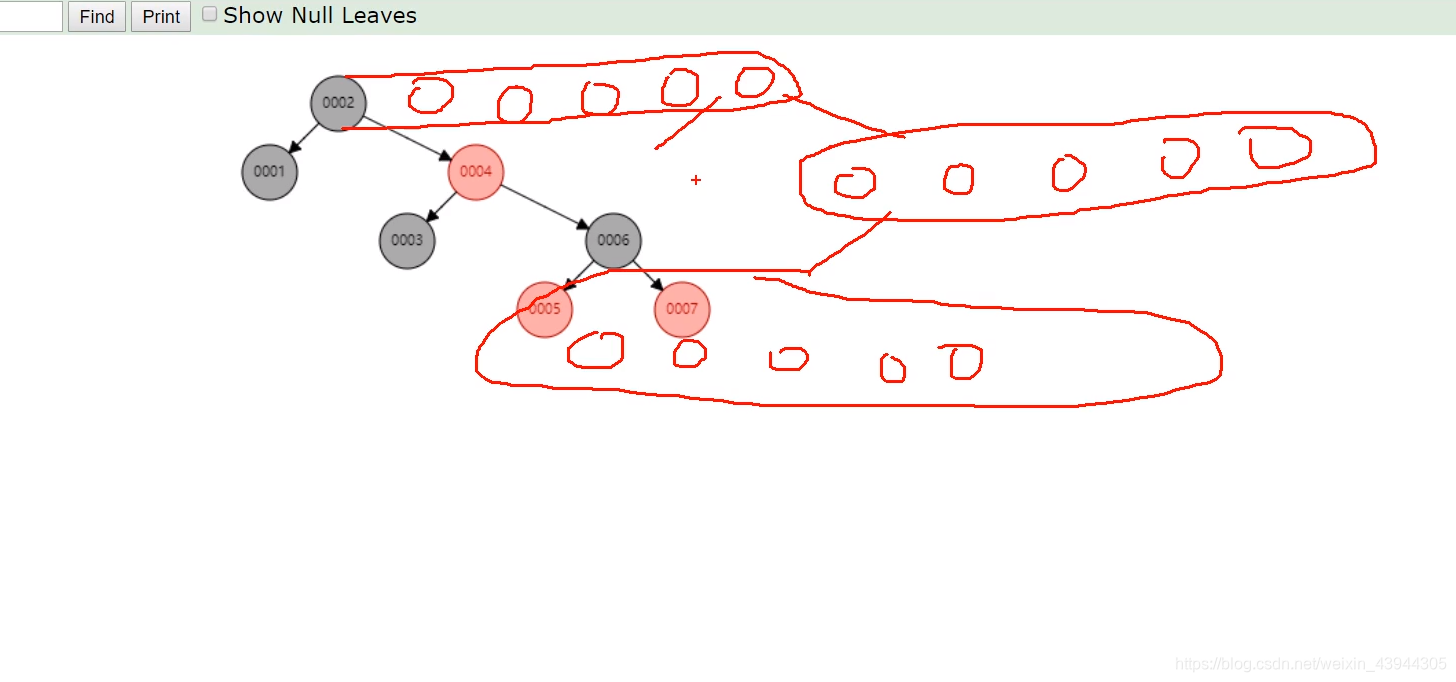
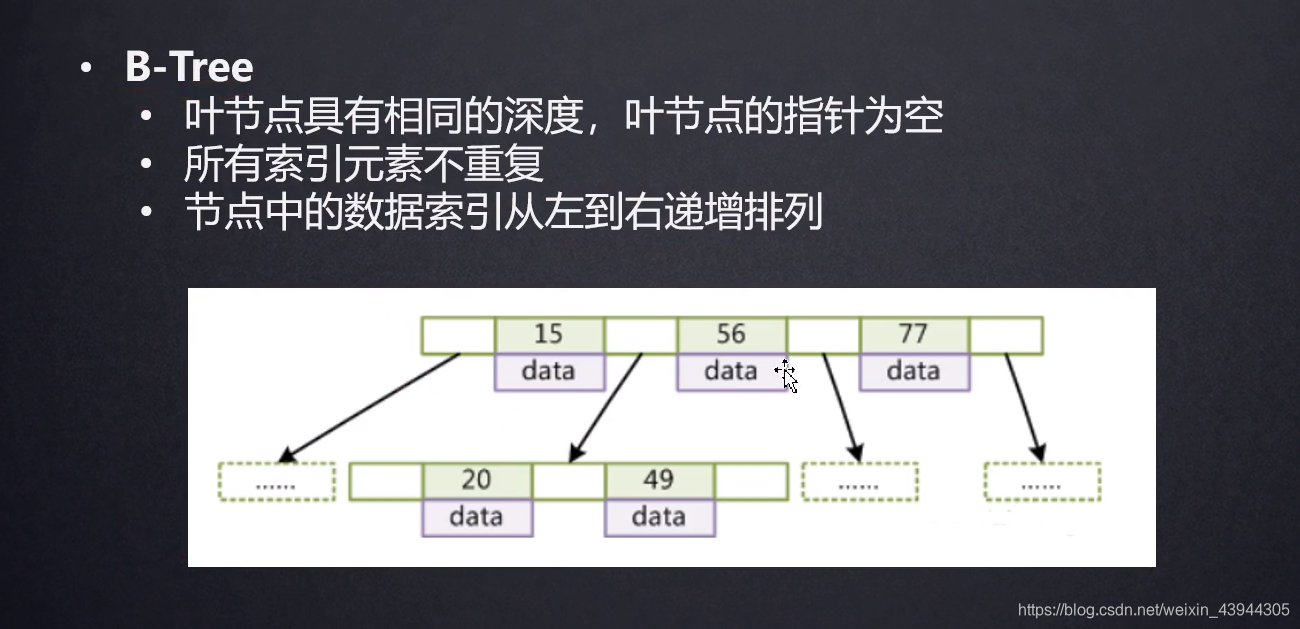
按照上面的思路对红黑树进行改造后,得到的就是B-Tree,这个和红黑树类似,每个节点里放了多个key-value,key就是索引列的值,value就是这一行记录所在的磁盘文件的地址指针
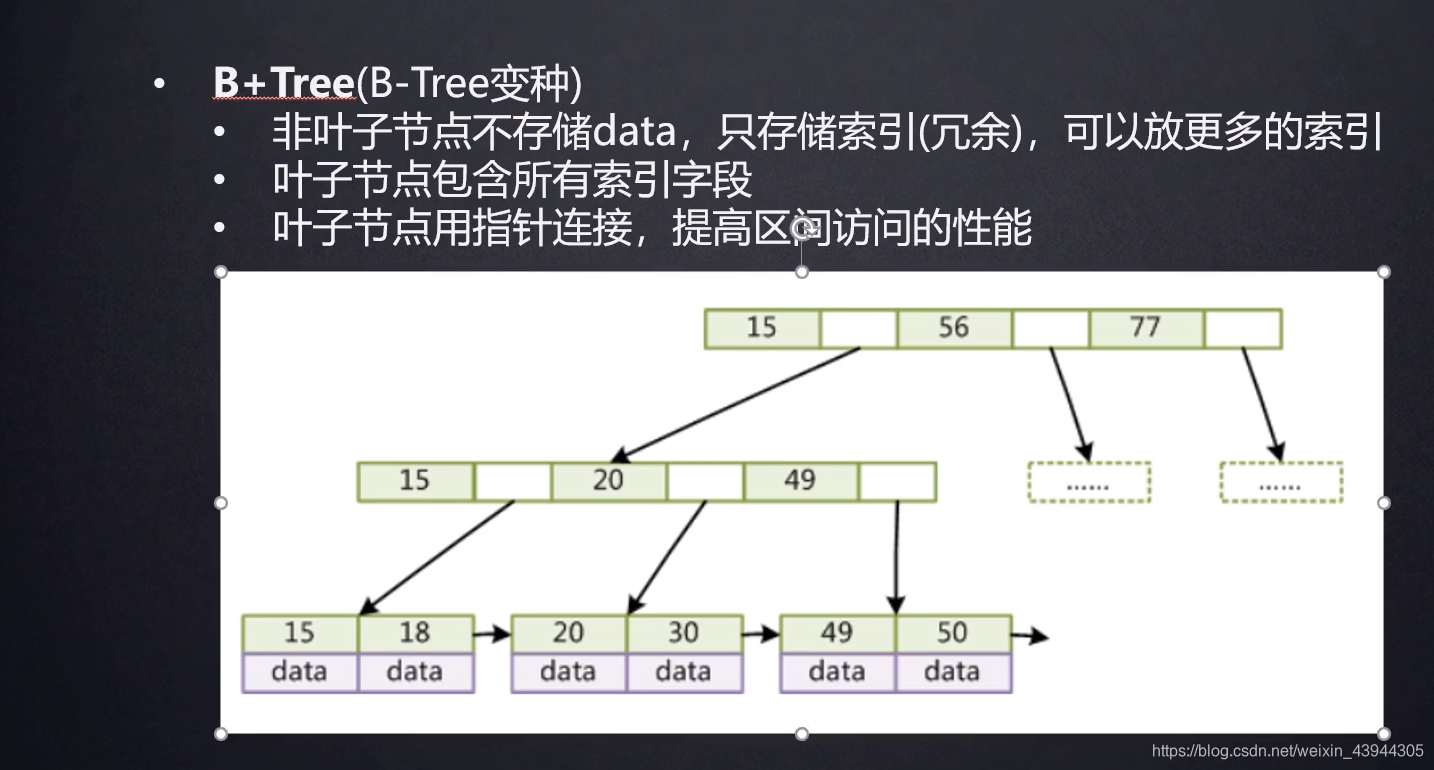
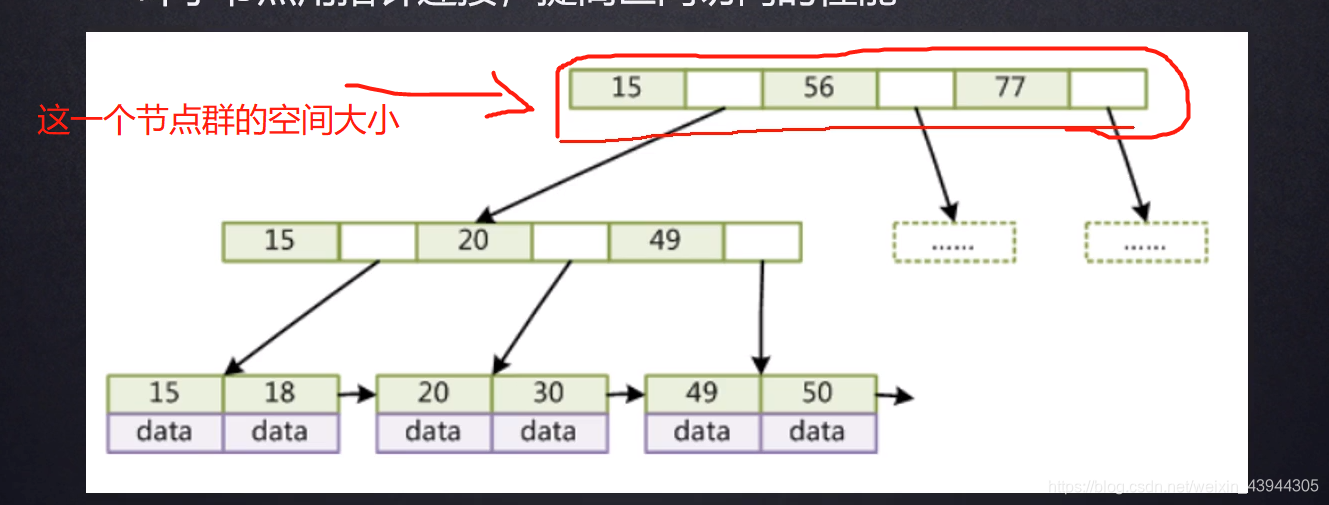
不过Mysql用的是B+Tree其实就是对B-Tree又进行了改造,可以看到B+Tree的每个非叶子节点里只有索引本身和一个指针存储空间,mysql的默认指针存储空间是6字节(Byte),假如索引字段类型是bigint-----8个字节(Byte),那么加起来就占了14个字节,而这一样一个大的索引群节点的空间默认是16K,
相对于B Tree少了索引这个key对应的value,也就是这一行记录的磁盘空间地址data,data都在叶子节点,并且B+Tree的索引时有冗余的,就是有重复的.
这样的话在默认16K大小下,非叶子节点就可以存储更多的索引值,(这里的非叶子节点其实存储的是索引群,即多个索引)
而且B+Tree每个节点群从左到右是递增,叶子节点从左到右他也是递增的
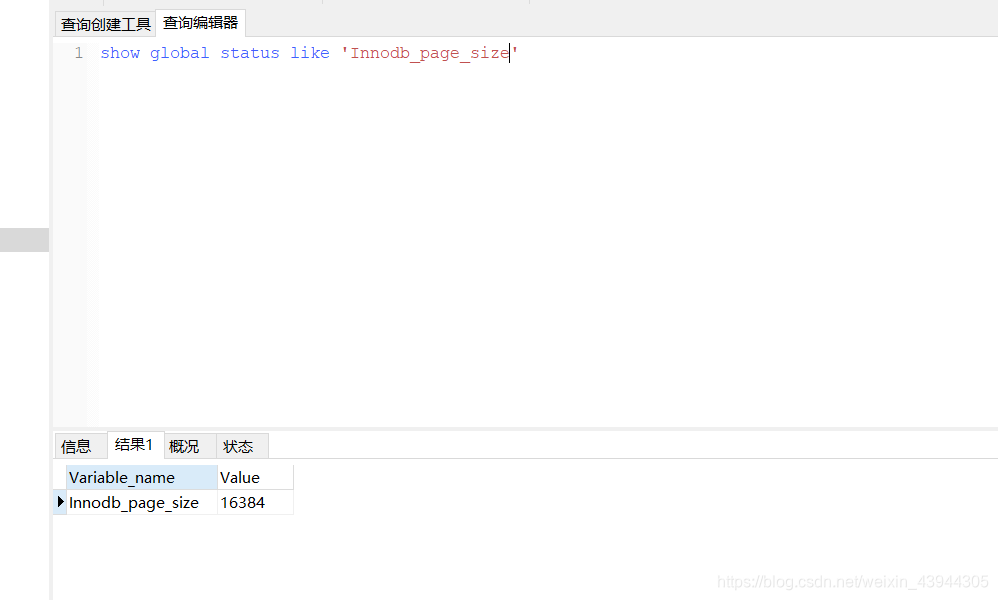
一个索引节点群空间16K的由来
show global status like 'Innodb_page_size';
综上,B+Tree对于B Tree的改造在于把所有的索引的key(索引列值)-value(索引对应的记录的磁盘地址)都放到了叶子结点
demo如下
还是前面开头的那张表结构,col1作为索引,查找col1=7时只要找2次,比二叉树和红黑树都要快
InnoDB索引实现
innodb和myisam都是针对表的
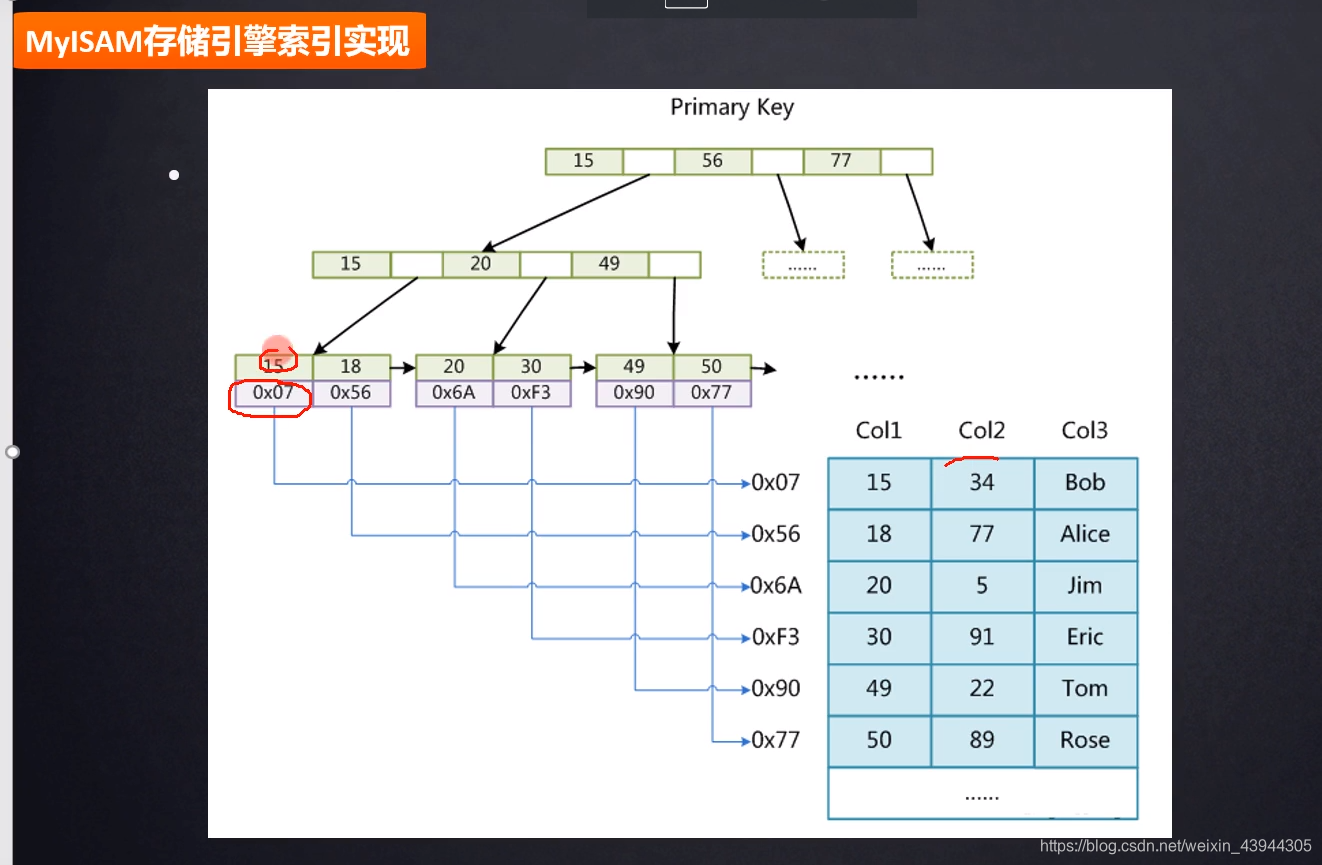
这里为什么要提一下myisam类型的呢,因为索引的存放不同,myisam类型的数据库中的表的索引也是B+Tree结构,但是索引key对应的value是磁盘地址,而Innodb的索引key对应的直接就是这一行记录,除了索引字段
也就是innodb的把索引和数据合并了
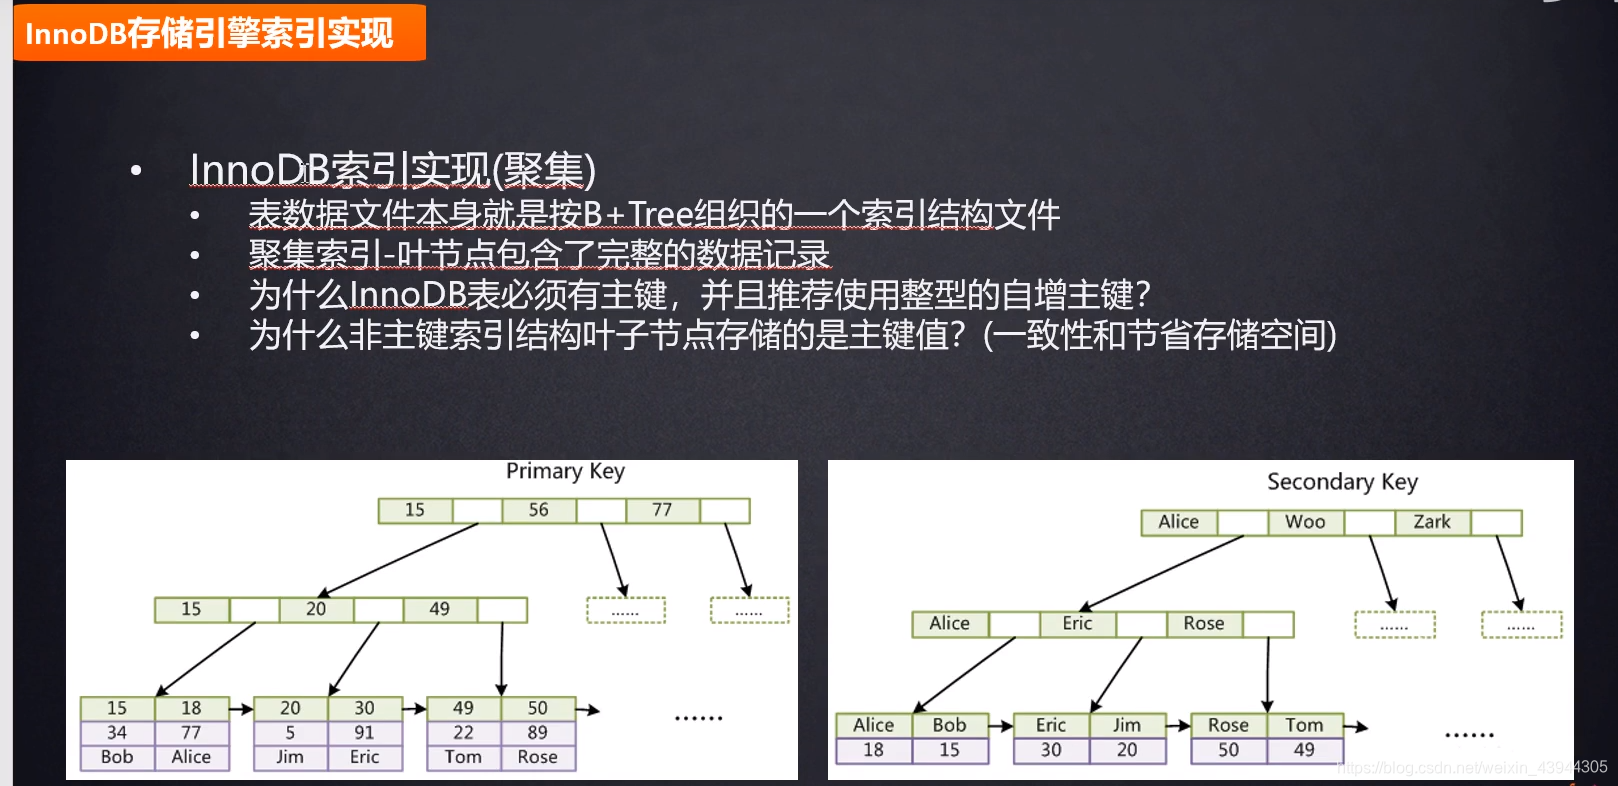
innodb数据库在磁盘中2种文件的含义
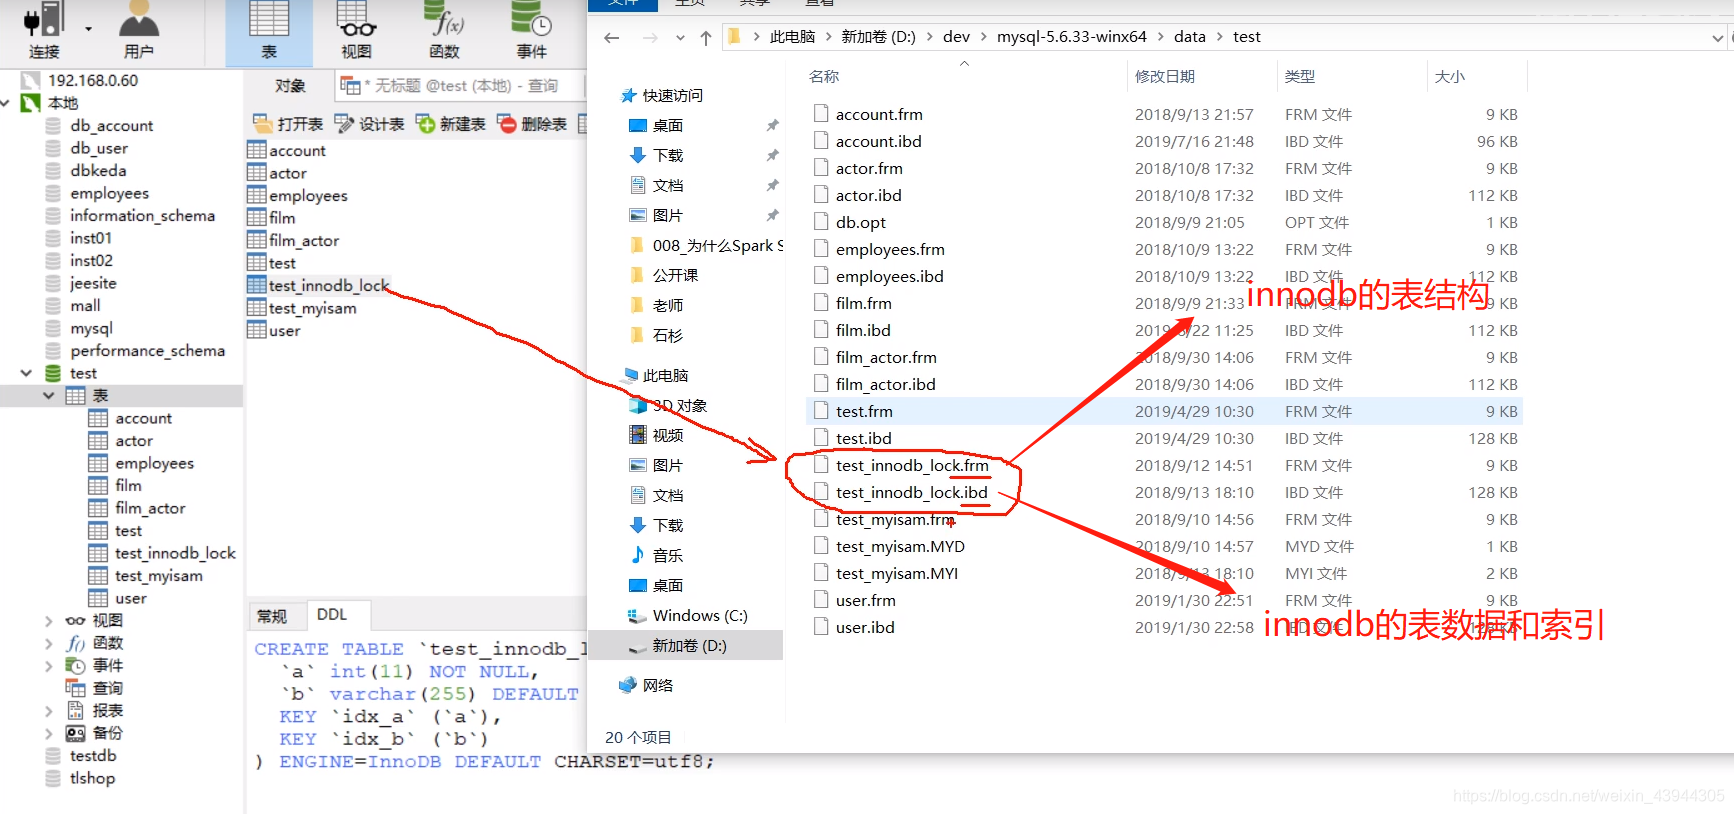
聚集索引和非聚集索引
非聚集(聚簇)索引:索引和数据分开就是非聚集索引
聚集(聚簇)索引:索引和数据聚集在一个文件里
mysql中innodb类型的表如果没有建主键,它首先会自动寻找一个唯一索引来作为主键,如果没有维护唯一索引,那么它会另外维护一个rowid的列作为主键
B+Tree每个节点群从左到右是递增,叶子节点从左到右他也是递增的
Hash哈希结构的索引
将一个字段作为索引,在插入的时候会把这个索引字段的值做一个hash运算得到一个散列值,然后把这个散列值和这一行数据的磁盘地址映射到一个hash表中
即可以这么记录,经过hash运算后获得的散列值可以直接定位这个索引值对应的这一行记录,速度快的飞起,但是平时还是BTree用的多,是因为,hash运算是要确定一个值的
比如:select * from t where col1=11
这个时候拿索引列col1的值11去做hash运算映射获取对应的这一行记录的磁盘空间
但是要是下面这种就没辙了
select * from t where co1 > 11
范围运算的话hash就没辙了,因为没有一个确定的值啊,没法做hash运算,hash对于范围查找的支持是非常差的,如果有大佬了解这个,麻烦指点下我
而B+Tree对于范围查找效率就很高,因为它的叶子节点之间还有指针相连
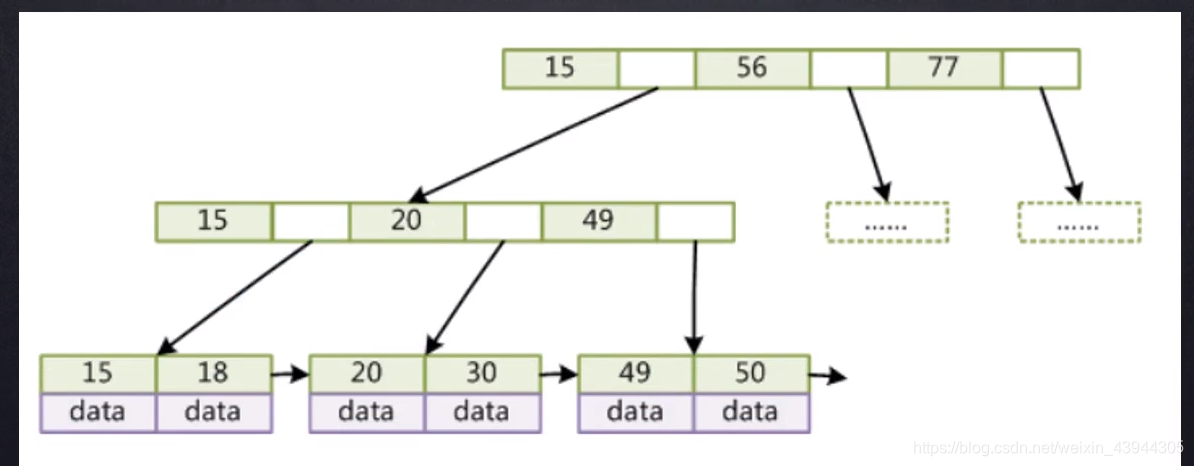
比如下图
查找col1 > 20,先定位20,然后查找大于20的就是取20右边的值放到结果集中,后面的节点都有指针类似链表,就可以顺藤摸瓜一路全部捞出来
这里再提一下没有改造的B Tree,它的叶子节点之间是没有这个指针的,所以它对范围查找也是很弱,因为没有这个指针要找20之后的值只能一次次从根节点开始找
为什么建议用自增的id索引
为什么建议用自增的id索引呢,因为B+Tree如果不是自增的索引,在后插一个较小的值的时候,因为先前已经插入比这个大的值了,按照B+Tree叶子节点的索引值从左到右依次增大的规则,这个时候会做一次再平衡,把值插入进去,而不是直接append到叶子结点之后,这个会引起系统资源开销
Innodb的主键索引和非主键索引
主键索引里存储的直接就是这一行记录,也就是key是主键值,value是这一行记录的其他字段的值,当查找的时候不会回表
但是如果不是主键索引,那么它的value保存的是主键值,也就是在查找的时候先找到这个索引对应的主键值,然后根据主键去回表查找,这里的回表也就是拿到主键索引的值第二次去查表

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献25条内容

所有评论(0)