scrapy 下载器中间件、spider中间件、pipeline(item管道)
下载中间件(英文文档):https://docs.scrapy.org/en/latest/topics/downloader-middleware.html
下载中间件(中文文档):https://docs.scrapy.net.cn/en/latest/topics/downloader-middleware.html
1、scrapy 中间件
中间件是 Scrapy 里面的一个核心概念。使用 中间件 可以在爬虫的请求发起之前或者请求返回之后对数据进行定制化修改,从而开发出适应不同情况的爬虫。
"中间件" 和 "中间人" 只有一字之差,但是它们做的事情非常相似。中间件和中间人都能在中途劫持数据,做一些修改再把数据传递出去。不同点在于,中间件是开发者主动加进去的组件,而中间人是被动的,一般是恶意地加进去的环节。中间件主要用来辅助开发,而中间人却多被用来进行数据的窃取、伪造甚至攻击。
在Scrapy中有两种中间件:下载器中间件(Downloader Middleware)和 爬虫中间件(Spider Middleware)。
下载器中间件的4个方法
每个下载器中间件都是一个 Python 类,它定义了下面定义的一个或多个方法。主要入口点是 from_crawler 类方法,它接收一个 Crawler 实例。例如,Crawler 对象允许您访问 设置。
然后每个下载中间件类必须实现三个方法中的任意 / 全部: process_request、process_response、process_exception,同时不同方法的返回值不同,其产生的效果也不同。
from_crawler(cls, crawler)
如果存在,则调用此类方法以从 Crawler 创建中间件实例。它必须返回中间件的新实例。Crawler 对象提供对所有 Scrapy 核心组件(例如设置和信号)的访问;这是中间件访问它们并将其功能挂接到 Scrapy 的一种方式。参数:crawler(Crawler 对象)——使用此中间件的爬虫
from_crawler(crawler) 是 Scrapy 框架规定的类工厂静态方法,所有中间件(爬虫中间件、下载中间件、管道、扩展)都支持该方法。 作用:
- 框架自动调用,替代无参构造函数
__init__() - 注入核心
Crawler爬虫实例,从而拿到settings、spider、engine、signals、stats等全局资源 - 统一初始化入口,官方推荐标准写法
调用流程
- Crawler 创建实例 → 扫描配置加载组件(管道/中间件) → 执行类.from_crawler(crawler) → 返回组件实例 → 调用实例.__init__()。
- 优先级:
from_crawler先执行,再执行__init__
from_crawler 与 init 的执行顺序 & 传参区别
执行顺序
DemoPipeline.from_crawler(crawler)静态方法执行cls(crawler)触发__init__(self, crawler)- 得到组件实例,加入框架生命周期
两种初始化写法对比
- 写法 1:只用 init(不推荐,拿不到 crawler)
# 缺点:无法直接获取 crawler、settings、signals class DemoPipeline: def __init__(self): # 拿不到全局配置,只能通过 spider.settings 间接拿 pass - 写法 2:from_crawler 注入 crawler(官方标准)。可以提前读取全局配置、绑定信号、初始化统计器,功能完整。
- 3. 如何在不使用 from_crawler 时获取 settings?仅在
process_item/process_request等回调中,通过spider.settings获取,但无法在组件初始化阶段读取配置、绑定信号,局限性很大。ef process_item(self, item, spider): host = spider.settings.get("MYSQL_HOST")
常用信号 signals 搭配 from_crawler,通过 crawler.signals.connect(回调函数, 信号) 绑定生命周期事件,只能在 from_crawler / __init__ 中绑定:
from scrapy import signals

# 常用信号
signals.spider_opened          # 爬虫启动
signals.spider_closed          # 爬虫关闭
signals.item_scraped           # 成功抓取item
signals.item_dropped           # item被过滤丢弃
signals.request_failed         # 请求失败
signals.engine_stopped         # 引擎完全停止
settings 分为全局配置和爬虫自定义配置,通过 crawler 均可读取:
settings.py全局:crawler.settings.get("XXX")- 单个爬虫 custom_settings:
crawler.spidercls.custom_settings.get("XXX")
@classmethod
def from_crawler(cls, crawler):
    # 读取当前爬虫类独有的配置
    spider_custom_cfg = crawler.spidercls.custom_settings
    page_limit = spider_custom_cfg.get("PAGE_LIMIT", 100)
    return cls(page_limit)
使用时注意事项:
- 忘记加 @classmethod from_crawler 必须是类方法,不加会直接报错。
- 在
from_crawler内部写业务逻辑 只做初始化参数传递、信号绑定,业务逻辑放到 process_item /process_request。 - 混淆 crawler 和 spider
- crawler:全局爬虫引擎实例,包含配置、信号、统计
- spider:单个爬虫实例,只在回调函数(process_item)中可用
- 不用 from_crawler,强行在 init 读取配置 无法绑定信号、无法提前初始化全局资源,功能缺失。
Crawler 对象核心属性(最常用)
def from_crawler(cls, crawler):
    # 1. 获取配置 settings.py 所有配置
    settings = crawler.settings
    # 读取自定义配置
    timeout = settings.getint("DOWNLOAD_TIMEOUT", 10)
    api_key = settings.get("MY_API_KEY")

    # 2. 信号系统 signals(解耦爬虫生命周期)
    signals = crawler.signals

    # 3. 统计收集器 stats(爬取数量、失败数、自定义指标)
    stats = crawler.stats
    stats.set_value("custom_count", 0)
    stats.inc_value("request_success")

    # 4. 爬虫引擎 engine(调度器、下载器、爬虫)
    engine = crawler.engine
    scheduler = engine.scheduler

    # 5. 爬虫类(未实例化,是 Spider 类本身)
    spider_cls = crawler.spidercls

    # 实例化当前组件,把 crawler 传入实例供后续使用
    return cls(crawler)
所有组件统一模板,以 pipeline 为例:
import scrapy

class DemoPipeline:
    def __init__(self, crawler):
        # 保存 crawler、settings 到实例
        self.crawler = crawler
        self.settings = crawler.settings
        self.stats = crawler.stats
        self.signals = crawler.signals

        # 绑定信号(爬虫关闭时执行回调)
        self.signals.connect(self.spider_closed, signal=scrapy.signals.spider_closed)

    @classmethod
    def from_crawler(cls, crawler):
        # 固定写法:传入 crawler,返回当前类实例
        return cls(crawler)

    def spider_closed(self, spider):
        # 爬虫结束触发
        print("爬虫结束,总请求成功数:", self.stats.get_value("request_success", 0))

    def process_item(self, item, spider):
        self.stats.inc_value("request_success")
        return item
四大组件中 from_crawler 使用场景对比
Item Pipeline 数据管道。场景:读取自定义配置、统计入库数量、爬虫结束批量提交数据
class MysqlPipeline:
    def __init__(self, crawler):
        self.host = crawler.settings.get("MYSQL_HOST")
        self.stats = crawler.stats

    @classmethod
    def from_crawler(cls, crawler):
        return cls(crawler)
DownloadMiddleware 下载中间件。场景:动态读取代理池配置、全局超时、自定义 UA 池、捕获请求失败统计
class ProxyMiddleware:
    def __init__(self, crawler):
        self.proxy_list = crawler.settings.getlist("PROXY_LIST")

    @classmethod
    def from_crawler(cls, crawler):
        return cls(crawler)

    def process_request(self, request, spider):
        request.meta["proxy"] = self.proxy_list[0]
SpiderMiddleware 爬虫中间件。场景:捕获爬虫产出 item/error、过滤无效 item、信号监听
Extension 扩展(自定义爬虫生命周期插件)。扩展必须实现 from_crawler,扩展是专门用来监听全局信号的组件:
from scrapy import signals

class SpiderStatusExt:
    @classmethod
    def from_crawler(cls, crawler):
        ext = cls()
        crawler.signals.connect(ext.start_spider, signal=signals.spider_opened)
        crawler.signals.connect(ext.close_spider, signal=signals.spider_closed)
        return ext

    def start_spider(self, spider):
        print(f"爬虫 {spider.name} 启动")

    def close_spider(self, spider):
        print(f"爬虫 {spider.name} 关闭")
Spider 的 from_crawler ,这个比较特殊,和中间件 / 管道有区别
- 中间件、Pipeline、扩展:框架内部自动调用它们的
from_crawler,是框架加载组件的入口; - 自定义 Spider:Spider 本身默认不会自动执行
from_crawler。- 普通启动方式
scrapy crawl xxx,Scrapy 底层是直接Spider(name="xxx")实例化,不会走from_crawler; - 只有手动通过 CrawlerProcess / CrawlerRunner 动态创建爬虫、或者重写爬虫加载逻辑时,Spider 的
from_crawler才会生效;
- 普通启动方式
- 作用:给 Spider 注入
crawler对象,提前拿到全局settings、signals、stats,在爬虫实例创建阶段完成初始化、绑定信号、读取配置。
底层源码逻辑,Scrapy 创建爬虫实例源码简化逻辑:
# 框架默认原生逻辑(不调用from_crawler)
spider = spider_cls(name=spider_name, **spider_args)

# 只有手动调用 from_crawler 时才会走这个分支
if hasattr(spider_cls, "from_crawler"):
    spider = spider_cls.from_crawler(crawler)
Spider 中 from_crawler 标准语法
- 装饰器
@classmethod; - 参数
cls, crawler; - 返回爬虫实例
cls(...)。
基础示例
import scrapy
from scrapy import signals

class DemoSpider(scrapy.Spider):
    name = "demo"

    # 自定义爬虫的 from_crawler 类方法
    @classmethod
    def from_crawler(cls, crawler):
        # 1. 创建爬虫实例
        spider = cls()
        # 2. 把 crawler 挂载到爬虫实例,全局可用
        spider.crawler = crawler
        spider.settings = crawler.settings
        spider.stats = crawler.stats
        spider.signals = crawler.signals

        # 绑定生命周期信号(爬虫内全局监听)
        spider.signals.connect(spider.spider_close, signal=signals.spider_closed)
        spider.signals.connect(spider.spider_open, signal=signals.spider_opened)
        return spider

    def spider_open(self):
        """爬虫启动时触发"""
        print(f"爬虫启动,读取全局配置:{self.settings.get('DOWNLOAD_TIMEOUT')}")
        self.stats.set_value("start_time", "2026")

    def spider_close(self):
        """爬虫关闭时触发"""
        print(f"爬虫结束,总抓取条数:{self.stats.get_value('item_count', 0)}")

    def parse(self, response):
        self.stats.inc_value("item_count")
        yield {"data": response.text}
在 Spider 的 from_crawler 中,可以提前拿到所有全局资源,比在 parse 里通过 self.settings 更灵活(parse 只能读取,from_crawler 可以提前初始化、绑定信号):
@classmethod
def from_crawler(cls, crawler):
    spider = cls()
    # 1. 全局配置 settings.py
    spider.timeout = crawler.settings.getint("DOWNLOAD_TIMEOUT", 15)
    spider.proxy_pool = crawler.settings.getlist("PROXY_LIST")
    spider.db_url = crawler.settings.get("MYSQL_URI")

    # 2. 统计器 stats,自定义指标
    spider.stats = crawler.stats

    # 3. 信号系统 signals(核心价值)
    spider.signals = crawler.signals

    # 4. 引擎、调度器、下载器底层对象
    spider.engine = crawler.engine
    spider.scheduler = crawler.engine.scheduler

    # 5. 当前爬虫类配置 custom_settings
    spider.spider_custom_config = crawler.spidercls.custom_settings
    page_max = spider.spider_custom_config.get("MAX_PAGE", 10)
    spider.max_page = page_max

    return spider
两种启动方式对比(关键:什么时候 from_crawler 会执行)
方式 1:命令行 scrapy crawl demo(默认,不会自动调用 from_crawler)。直接实例化 DemoSpider(),跳过 from_crawler。缺点、解决方法:
self.crawler属性不存在,代码里调用self.crawler会报错;- 无法在爬虫初始化阶段绑定信号;
- 只能在 parse、start_requests 中使用内置
self.settings,无法提前读取配置做初始化。 - 解决:命令行启动想要使用
from_crawler,必须借助CrawlerProcess手动构建 crawler 对象,手动调用from_crawler。
方式 2:脚本手动启动(CrawlerProcess / CrawlerRunner,触发 from_crawler)。新建 run.py 运行爬虫,手动调用爬虫的 from_crawler,这是 Spider from_crawler 的标准使用场景:
from scrapy.crawler import CrawlerProcess
from scrapy.utils.project import get_project_settings
from spiders.demo import DemoSpider

def run_spider():
    settings = get_project_settings()
    process = CrawlerProcess(settings)
    # 关键:创建 Crawler 对象,传入爬虫类
    crawler = process.create_crawler(DemoSpider)
    # 手动调用爬虫的 from_crawler 生成爬虫实例
    spider = DemoSpider.from_crawler(crawler)
    # 绑定爬虫到 crawler
    crawler.spider = spider
    process.crawl(crawler)
    process.start()

if __name__ == "__main__":
run_spider()运行:python run.py,此时爬虫的 from_crawler 会完整执行。
场景 1:爬虫启动前初始化数据库连接(推荐写在 from_crawler)
import pymysql
import scrapy
from scrapy import signals

class MysqlSpider(scrapy.Spider):
    name = "mysql_spider"

    @classmethod
    def from_crawler(cls, crawler):
        spider = cls()
        spider.settings = crawler.settings
        spider.signals = crawler.signals
        # 绑定关闭信号,爬虫结束自动关闭数据库
        spider.signals.connect(spider.close_db, signals.spider_closed)
        # 提前初始化数据库连接
        spider.init_db()
        return spider

    def init_db(self):
        host = self.settings.get("MYSQL_HOST")
        user = self.settings.get("MYSQL_USER")
        self.conn = pymysql.connect(host=host, user=user)
        self.cursor = self.conn.cursor()
        print("数据库连接成功")

    def close_db(self):
        self.cursor.close()
        self.conn.close()
        print("数据库连接已关闭")

    def parse(self, response):
        self.cursor.execute("select 1")
场景 2:全局信号监听,捕获请求失败、Item 丢弃
@classmethod
def from_crawler(cls, crawler):
    spider = cls()
    sig = crawler.signals
    sig.connect(spider.item_drop, signals.item_dropped)
    sig.connect(spider.request_fail, signals.request_failed)
    return spider

def item_drop(self, item, exception, spider):
    print(f"丢弃Item:{item}, 原因:{exception}")

def request_fail(self, request, exception, spider):
    print(f"请求失败:{request.url}, 异常:{exception}")
场景 3:动态读取配置,生成起始 URL
@classmethod
def from_crawler(cls, crawler):
    spider = cls()
    # 从settings读取分页数量
    max_page = crawler.settings.getint("SPIDER_MAX_PAGE", 5)
    # 预生成start_urls,覆盖默认属性
    spider.start_urls = [f"https://xxx.com/page/{i}" for i in range(1, max_page+1)]
    return spider
from_crawler 与 init 的执行顺序 & 传参
1. 执行顺序(手动调用 from_crawler 时)
DemoSpider.from_crawler(crawler)执行spider = cls()→ 执行__init__()- 给实例挂载 crawler、settings、绑定信号
- 返回实例
2. 带自定义参数传递
- 爬虫启动时需要传入自定义参数,在
from_crawler透传给__init__:class ParamSpider(scrapy.Spider): name = "param" def __init__(self, keyword, *args, **kwargs): super().__init__(*args, **kwargs) self.keyword = keyword @classmethod def from_crawler(cls, crawler, keyword=None): # 接收外部参数,传给构造函数 spider = cls(keyword=keyword) spider.crawler = crawler return spider
启动时传参:
crawler = process.create_crawler(ParamSpider)
spider = ParamSpider.from_crawler(crawler, keyword="python")
不用 from_crawler 的替代方案。如果只是想在爬虫启动时读取配置、绑定信号,但不想写 from_crawler + 脚本启动,可以直接在 __init__ 中绑定信号,通过 self.crawler(spider 实例自带)获取资源:
class SimpleSpider(scrapy.Spider):
    name = "simple"
    def __init__(self, *args, **kwargs):
        super().__init__(*args, **kwargs)
        # 爬虫实例自带 crawler 属性(scrapy 自动注入)
        sig = self.crawler.signals
        sig.connect(self.open, signals.spider_opened)

    def open(self):
        print(self.settings.get("DOWNLOAD_TIMEOUT"))
完整可运行模板
import scrapy
from scrapy import signals

class BaseSpider(scrapy.Spider):
    name = "base"
    custom_settings = {
        "DOWNLOAD_TIMEOUT": 10
    }

    @classmethod
    def from_crawler(cls, crawler):
        # 创建爬虫实例
        spider = cls()
        # 挂载全局对象
        spider.crawler = crawler
        spider.settings = crawler.settings
        spider.stats = crawler.stats
        spider.signals = crawler.signals

        # 绑定生命周期信号
        spider.signals.connect(spider.on_open, signals.spider_opened)
        spider.signals.connect(spider.on_close, signals.spider_closed)
        spider.signals.connect(spider.on_request_fail, signals.request_failed)
        return spider

    def on_open(self):
        """爬虫启动回调"""
        self.stats.set_value("total_item", 0)
        print(f"爬虫 {self.name} 启动,超时时间:{self.settings.get('DOWNLOAD_TIMEOUT')}")

    def on_close(self):
        """爬虫关闭回调"""
        total = self.stats.get_value("total_item", 0)
        print(f"爬虫结束,共抓取 {total} 条数据")

    def on_request_fail(self, request, exception, spider):
        """请求失败统一捕获"""
        print(f"请求失败 url:{request.url}, error:{str(exception)}")

    def parse(self, response):
        self.stats.inc_value("total_item")
        yield {
            "url": response.url,
            "title": response.css("title::text").get()
        }
还有一种是调用父类的方法,返回一个 spider,属性挂载到 spider 上
class SpiderBase(RedisCrawlSpider):

    MAX_IDLE_TIME = 10

    @classmethod
    def from_crawler(cls, crawler, *args, **kwargs):
        spider = super().from_crawler(crawler, *args, **kwargs)
        # 绑定空闲信号
        crawler.signals.connect(spider.on_idle, signal=signals.spider_idle)
        #################################################################
        return spider

    def on_idle(self) -> None:
        self.crawler.engine.close_spider(self, "redis_no_task")

    def __init__(self, *args, **kwargs):
        super().__init__(*args, **kwargs)
        pass
process_request(request, spider)
参数:
request (Request 对象):正在处理的请求
spider (Spider 对象):该 Request 对应的 spider返回值
- 返回
None:如果返回None,Scrapy 将继续处理此请求,并按权重从小到大继续执行所有其他中间件,直到最终调用适当的下载器处理程序来执行请求(并下载其响应)。- 返回一个
Response对象: 如果返回 Response 对象,Scrapy 将会直接截断请求流程,不再发起真实网络请求。也不会走后续所有中间件的 process_request() 或 process_exception() 方法,它将返回该响应,并立刻反向走所有中间件的process_response,最后丢给 spider。 适用场景:本地缓存、伪造响应、本地读取文件。- 返回一个 Request 对象: 如果返回
Request对象,Scrapy 将停止调用后续中间件的 process_request() 方法,并把新生成的Request丢回引擎,重新完整走一遍中间件链路。 适用场景:302 重定向、登录失效重新请求、更换代理重发。- 抛出异常(如 IgnoreRequest) 终止当前请求,进入同层级中间件的
process_exception异常处理流程。如果它们没有一个处理该异常,则调用请求的 errback 函数(Request.errback)。如果没有代码处理引发的异常,则忽略该异常且不记录该异常(与其他异常不同)。
process_response(request, response, spider)
参数:
request (Request 对象):产生响应的请求
response (Response 对象):被处理的 response
spider (Spider 对象):response 所对应的 spider返回值
- 返回 Response 传给上一个权重更小的中间件继续处理,走完所有中间件后交给 spider。 适用:修改响应文本、替换状态码、补全 cookie。
- 返回 Request 放弃当前响应,新请求丢回引擎重新发起请求。 适用:登录过期跳转、验证码拦截重试。
- 抛出 IgnoreRequest 异常 丢弃本次响应,不会进入 spider,日志记录请求失败。
process_exception(request, exception, spider)
触发时机
- process_request 抛异常
- Downloader 网络报错(超时、连接失败、代理失效、SSL 错误)
参数:
- request (是 Request 对象):产生异常的request
- exception (
Exception对象):抛出的异常- spider (Spider 对象) – request 对应的 spider
返回值:
- 返回 None:异常继续向上传递,后续中间件继续捕获异常,最终请求失败丢弃。执行顺序:和 process_response 一致,逆序执行
- 返回 Response:用自定义响应代替异常,直接走响应链路,交给 spider。
- 返回 Request: 重新放入下载队列,再次完整走一遍所有中间件流程(代理失效切换代理、超时重爬)。
分步 执行 流程
结合权重示例 A (100)、B (300)、C (500)
阶段 1:正向预处理请求(发送网络前)
- Engine 拿到 spider 产出的 Request
- 中间件 A.process_request ()
- 返回 None → 下一步
- 中间件 B.process_request ()
- 返回 None → 下一步
- 中间件 C.process_request ()
- 返回 None → 交给 Downloader 发起真实 HTTP 请求
分支 1:网络正常返回 Response
阶段 2:逆向处理响应(收到数据后)
- 中间件 C.process_response ()
- 中间件 B.process_response ()
- 中间件 A.process_response () 全部处理完成后,Response 传给引擎,再分发到 spider 的 parse 回调。
分支 2:任意环节抛出异常(网络超时 / 主动抛 IgnoreRequest)
阶段 2:逆向异常捕获
- 中间件 C.process_exception ()
- 中间件 B.process_exception ()
- 中间件 A.process_exception ()
- 若任意中间件返回 Response:跳过剩余异常处理,进入逆向 process_response 流程
- 若全部返回 None:请求直接丢弃,日志标记失败,不进入 spider
分支 3:某中间件 process_request 返回 Request
新 Request 重新从头执行整套正向中间件流程(A→B→C),旧请求作废。
分支 4:某中间件 process_request 返回 Response
不再走剩余中间件、不走网络请求,直接逆向执行 C→B→A 的 process_response。
下载器 中间件
作用
Downloader Middleware (下载器中间件) 是 Scrapy 中处理 请求/响应 的 hook(挂钩) 框架。是处于 Scrapy 的 Engine 和 Downloader 之间的处理模块。用于全局更改 Scrapy 的请求和响应。
Spider 发起 Request → 引擎 Engine → 下载中间件(按权重从小到大执行) → Downloader 发起网络请求 → 得到 Response → 下载中间件反向倒序执行 → Engine → Spider parse
执行顺序核心规则
- 发送请求前(process_request):中间件数字越小,越先执行
- 收到响应后(process_response):中间件数字越大,越先执行(逆序)
- 异常捕获(process_exception):和 process_response 同逆序逻辑
示例中间件权重配置:
DOWNLOADER_MIDDLEWARES = {
    'middleware.A': 100,
    'middleware.B': 300,
    'middleware.C': 500,
}- 发送请求,执行顺序:A → B → C
- 接收响应,执行顺序:C → B → A
所以 DownloaderMiddleware 在整个架构中只在两个位置起作用
- Engine 从 Scheduler 获取 Request 发送给 Downloader 时, Request 会先经过中间件,中间件可以对 Request 进行修改,修改完后 Request 会根据中间件的优先级依次发送给下一个中间件,至到所有的中间都对 Request 处理完成后,再把 Request 发送给 Downloader 开始进行真正的网络请求,并获取 响应(Response)
- Downloader 执行 Request 进行真正的网络请求,服务器进行回应,得到 Response。引擎会先把 Response 依次发送给中间件对 Response 进行处理,所有的中间件处理完成后,再把 处理后的 Response 发送给 自己编写的 Spider
DownloderMiddleware 在整个爬虫执行过程中能起到非常重要的作用,功能十分强大。可以修改User-Agent、处理重定向、设置代理、失败重试、设置Cookie 等。
激活 下载器 中间件
要激活下载器中间件组件,可以将 自定义中间件 添加到 DOWNLOADER_MIDDLEWARES 设置中,该设置是一个字典,其键是中间件类路径,其值是中间件顺序。示例:
DOWNLOADER_MIDDLEWARES = {
    'myspider.middlewares.CustomDownloaderMiddleware': 543,
}
添加后,当 scrapy 运行时,会将 DOWNLOADER_MIDDLEWARES 设置与 Scrapy 中定义的 DOWNLOADER_MIDDLEWARES_BASE 进行合并(注意:是和默认的 BASE 进行合并,不是覆盖。 同时项目中的 DOWNLOADER_MIDDLEWARES 失效,也就是不会和项目中的中间件进行合并。 这是大坑。),然后按优先级数值从小到达排序,以获得已启用中间件的最终排序列表:第一个中间件是更接近引擎的中间件。最后一个是更接近下载器的中间件。
优先级是:命令行 > Spider custom_settings > 项目 settings > Scrapy 默认配置
custom_settings 会清除项目级自定义中间件,但最终仍会与 Scrapy 的 DOWNLOADER_MIDDLEWARES_BASE 合并,所以内置中间件还在。
Scrapy 内部相当于:
settings.setdict(
    Spider.custom_settings,
    priority="spider",
)
示例:
项目配置:
CONCURRENT_REQUESTS = 16
DOWNLOAD_DELAY = 1
Spider 配置
custom_settings = {
    "CONCURRENT_REQUESTS": 50,
}
最终结果:
CONCURRENT_REQUESTS = 50  # Spider覆盖
DOWNLOAD_DELAY = 1        # Spider没有设置,继承项目
示例:
项目配置:
DOWNLOADER_MIDDLEWARES = {
    "project.RandomProxy": 740,
    "scrapy.downloadermiddlewares.retry.RetryMiddleware": None,
}
Spider:
custom_settings = {
    "DOWNLOADER_MIDDLEWARES": {
        "spider.CustomMiddleware": 500,
    }
}
最终的项目级字典不是:
{
    "project.RandomProxy": 740,
    "spider.CustomMiddleware": 500,
}
而是:
{
    "spider.CustomMiddleware": 500,
}
Spider 中的整个 DOWNLOADER_MIDDLEWARES 值替换了项目中的同名值。但还有第二层行为:Scrapy 会再把这个结果与内置的 DOWNLOADER_MIDDLEWARES_BASE 合并
所以:
custom_settings = {
    "DOWNLOADER_MIDDLEWARES": {},
}
导致:
- 项目自定义的
RandomProxy消失。 - 项目对默认
RetryMiddleware: None的禁用也消失。 - Scrapy内置中间件依然存在,因为空字典仍会与
DOWNLOADER_MIDDLEWARES_BASE合并。
把空字典注释掉,因此现在会继承项目的全局代理中间件。
总结:
custom_settings 对不同配置名是合并加载;
对同一个配置名是高优先级替换;
同名字典不会与项目字典自动深度合并;
组件字典之后只会与 Scrapy 的 *_BASE 再合并。
优先级 (调用 顺序)
- 对于 process_request:由于 Request 是从 Engine 发送给 Downloader 的,并且优先级数字越小的 Downloader Middleware 越靠近 Engine,所以优先级数字越小的 Dowloader Middleware 的 process_request 方法越先被调用。在 process_request 方法中,当返回值是 Response 对象时,更低优先级的Downloader Middleware 的process_request和process_exception方法不会被继续调用,每个 Downloader Middleware 的 process_response 方法而被依次调用。调用完之后,直接将 Response对象发送给Spider来处理。
- 对于 process_response:由于 Response 是由 Downloder 发送给 Engine的,优先级数字越大的 Downloader Middleware 越靠近 Downloader,所以优先级数字越大的 Downloader Middleware 的 process_response 越先被调用
要确定为中间件分配哪个顺序,可以查看默认的 DOWNLOADER_MIDDLEWARES_BASE 设置,并根据要插入中间件的位置选择一个值。顺序很重要,因为每个中间件执行不同的操作,并且有些中间件可能依赖于应用某些先前的(或后续的)中间件。
如果想禁用内置中间件(在 DOWNLOADER_MIDDLEWARES_BASE 中定义并默认启用),必须在项目的 DOWNLOADER_MIDDLEWARES 设置中定义它,并将其值指定为 None。
# 默认中间件中优先级配置,不需要的中间件可以直接设置为None
DOWNLOADER_MIDDLEWARES_BASE = {
    # Engine side
    "scrapy.downloadermiddlewares.offsite.OffsiteMiddleware": 50,
    "scrapy.downloadermiddlewares.robotstxt.RobotsTxtMiddleware": 100,
    "scrapy.downloadermiddlewares.httpauth.HttpAuthMiddleware": 300,
    "scrapy.downloadermiddlewares.downloadtimeout.DownloadTimeoutMiddleware": 350,
    "scrapy.downloadermiddlewares.defaultheaders.DefaultHeadersMiddleware": 400,
    "scrapy.downloadermiddlewares.useragent.UserAgentMiddleware": 500,
    "scrapy.downloadermiddlewares.retry.RetryMiddleware": 550,
    "scrapy.downloadermiddlewares.redirect.MetaRefreshMiddleware": 580,
    "scrapy.downloadermiddlewares.httpcompression.HttpCompressionMiddleware": 590,
    "scrapy.downloadermiddlewares.redirect.RedirectMiddleware": 600,
    "scrapy.downloadermiddlewares.cookies.CookiesMiddleware": 700,
    "scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware": 750,
    "scrapy.downloadermiddlewares.stats.DownloaderStats": 850,
    "scrapy.downloadermiddlewares.httpcache.HttpCacheMiddleware": 900,
    # Downloader side
}
关闭 scrapy 中间件,激活自定义中间件
DOWNLOADER_MIDDLEWARES = {
    # 1. 关闭不需要的原生中间件,赋值 None
    'scrapy.downloadermiddlewares.useragent.UserAgentMiddleware': None,
    'scrapy.downloadermiddlewares.retry.RetryMiddleware': None,

    # 2. 自定义中间件,按执行顺序从小到大
    # 全局异常捕获(最先执行)
    'myproject.middlewares.GlobalCatchExceptionMiddleware': 100,
    # 随机UA+全套浏览器请求头指纹
    'myproject.middlewares.RandomUAMiddleware': 400,
    # 代理池中间件
    'myproject.middlewares.ProxyMiddleware': 500,
    # 自定义重试中间件(最多重试3次)
    'myproject.middlewares.CustomRetryMiddleware': 550,

    # 原生保留中间件不用写,会自动启用;如需修改权重再填
    # 'scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware': 750,
}
最后,请注意,有些中间件需要通过特定的设置来启用。更多内容请查看相关中间件文档。
三种融合方式(替换 / 新增 / 修改原生权重)
- 完全替换原生中间件(最常用)。原生 UA、Retry 不好用,自己重写:
# 关闭原生 'scrapy.downloadermiddlewares.useragent.UserAgentMiddleware': None, # 启用自定义,对齐原生权重400/500 'myproject.middlewares.RandomUAMiddleware': 400, - 新增自定义中间件,保留原生。例如:只想加代理、异常捕获,不替换官方逻辑,直接新增一行即可。
- 修改原生中间件权重。调整原生中间件执行顺序,例如把代理提前:
'scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware': 300,
各中间件放什么权重最合适
- 全局异常捕获:
100(最先捕获所有异常) - 随机 UA / 完整请求头指纹:
400(替换默认 UA 中间件) - 代理中间件:
500 - 自定义重试中间件:
550(覆盖原生 RetryMiddleware) - Cookie / 缓存处理:
980
请求、响应、异常完整流转顺序演示
发请求 process_request 顺序(从小到大),每一层都可以修改 request
- GlobalCatchExceptionMiddleware(100)
- RandomUAMiddleware(400)
- ProxyMiddleware(500)
- CustomRetryMiddleware(550)
2. 正常返回 response(逆序,从大→小)
- CustomRetryMiddleware(550) → process_response
- ProxyMiddleware(500)
- RandomUAMiddleware(400)
- GlobalCatchExceptionMiddleware(100)
3. 出现异常 process_exception(逆序)
- CustomRetryMiddleware (550) 先捕获异常,判断是否重试
- ProxyMiddleware(500)
- RandomUAMiddleware(400)
- GlobalCatchExceptionMiddleware (100) 最后兜底记录异常
重点
- 指纹 UA 中间件放在 400,覆盖默认 DefaultHeaders,能统一注入全套 sec-ch、Accept 浏览器头,不会出现头冲突。
- 全局异常中间件放 1 ,所有中间件抛出的网络异常最后都会走到这里。
- 不要多个中间件同时修改同一个meta/headers,靠后的会覆盖前面的设置,造成指纹错乱。
- process_exception 返回值规则
return request:重新放入下载队列,再次完整走一遍所有中间件流程
return None:终止该请求,丢弃
raise IgnoreRequest:直接忽略,不记录重试
示例:代理 中间件
开发爬虫时更换代理 IP 是非常常见的情况。通过代理中间件,可以实现爬虫每次访问网站之前都先经过这个类,给请求换新的代理IP,这样就能实现动态改变代理。
scrapy 自带有 代理中间件(HttpProxyMiddleware),源码如下:
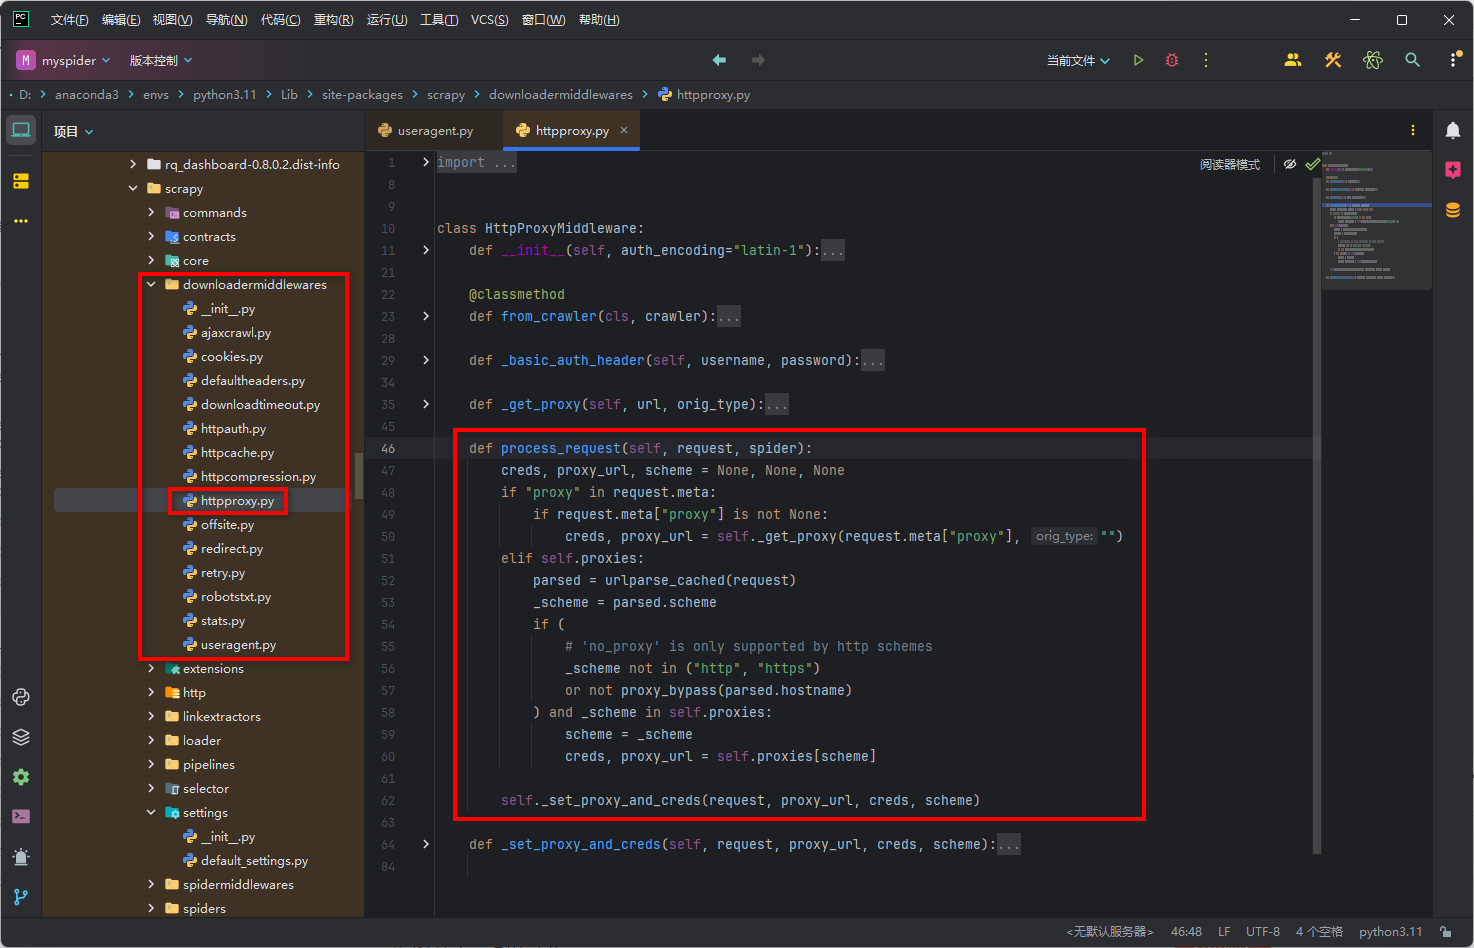
如果不使用系统自带的,也可以自己写一个类实现。创建 Scrapy工程以后,有一个 middlewares.py 文件,里面有一个 SpiderMiddleware(爬虫中间件) 和 DownloaderMiddleware(下载器中间件)。可以看到 中间件其实就是一个Python类。
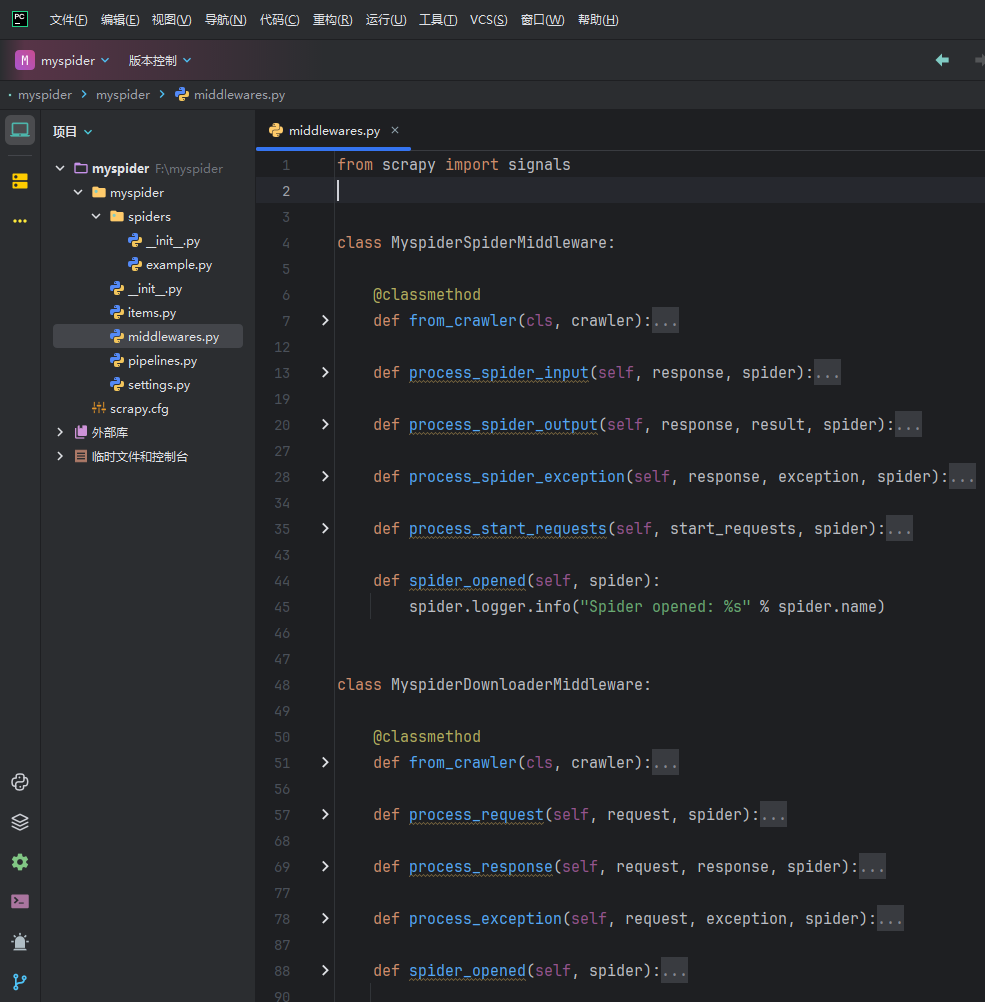
scrapy 自动生成的这个文件名称为 middlewares.py,名字后面的 s 表示复数,说明这个文件里面可以放很多个中间件。
在 middlewares.py 中添加如下代码:
import random
import base64
from scrapy.utils.project import get_project_settings


class CustomProxyMiddleware(object):

    def __init__(self):
        self.settings = get_project_settings()

    def process_request(self, request, spider):
        http_proxy = random.choice(self.settings['PROXIES'])
        request.meta['proxy'] = http_proxy

        # 如果代理服务器需要认证
        proxy_user = "username"
        proxy_pass = "password"
        encoded_user_pass = base64.b64encode(f"{proxy_user}:{proxy_pass}".encode()).decode()
        request.headers['Proxy-Authorization'] = f"Basic {encoded_user_pass}"
打开 setting.py 添加并激活中间件。禁用 scrapy 自带的 "ua、重试、代理" 中间件时只需要将中间件的顺序设为None:
DOWNLOADER_MIDDLEWARES = {
    'myspider.middlewares.CustomProxyMiddleware': 543,
    "scrapy.downloadermiddlewares.useragent.UserAgentMiddleware": None,
    "scrapy.downloadermiddlewares.retry.RetryMiddleware": None,
    "scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware": None,
}

PROXIES = [
    'https://10.10.10.1:8118',
    'https://10.10.10.2:8118',
    'https://10.10.10.3:8118',
]
可以看到 DOWNLOADER_MIDDLEWARES 其实就是一个字典,字典的 Key 就是用点分隔的中间件路径,后面的数字表示这种中间件的顺序。由于中间件是按顺序运行的,因此如果遇到后一个中间件依赖前一个中间件的情况,中间件的顺序就至关重要。
如何确定后面的数字应该怎么写呢?因为生成的 scrapy 工程中默认是 543,所以最简单的办法就是从 543 开始逐渐加 1,这样一般不会出现什么大问题。如果想把中间件做得更专业一点,那就需要知道 scrapy 自带中间件的顺序

数字越小的中间件越先执行(数字越小,越靠近引擎,数字越大越靠近下载器,所以数字越小的,processrequest()优先处理;数字越大的,process_response()优先处理;若需要关闭某个中间件直接设为None即可),例如 Scrapy 自带的第1个中间件 RobotsTxtMiddleware,它的作用是首先查看 settings.py 中 ROBOTSTXT_OBEY 这一项的配置是 True 还是 False。如果是 True,表示要遵守 Robots.txt 协议,它就会检查将要访问的网址能不能被运行访问,如果不被允许访问,那么直接就取消这一次请求,接下来的和这次请求有关的各种操作全部都不需要继续了。
自定义的中间件会被按顺序插入到 Scrapy 自带的中间件中。爬虫会按照从 100~900 的顺序依次运行所有的中间件。直到所有中间件全部运行完成,或者遇到某一个中间件而取消了这次请求。
示例:ua 中间件
Scrapy 自带有 UA 中间件(UserAgentMiddleware),可以自己直接写一个Python类来实现,也可以继承系统的然后重写 process_request 方法。
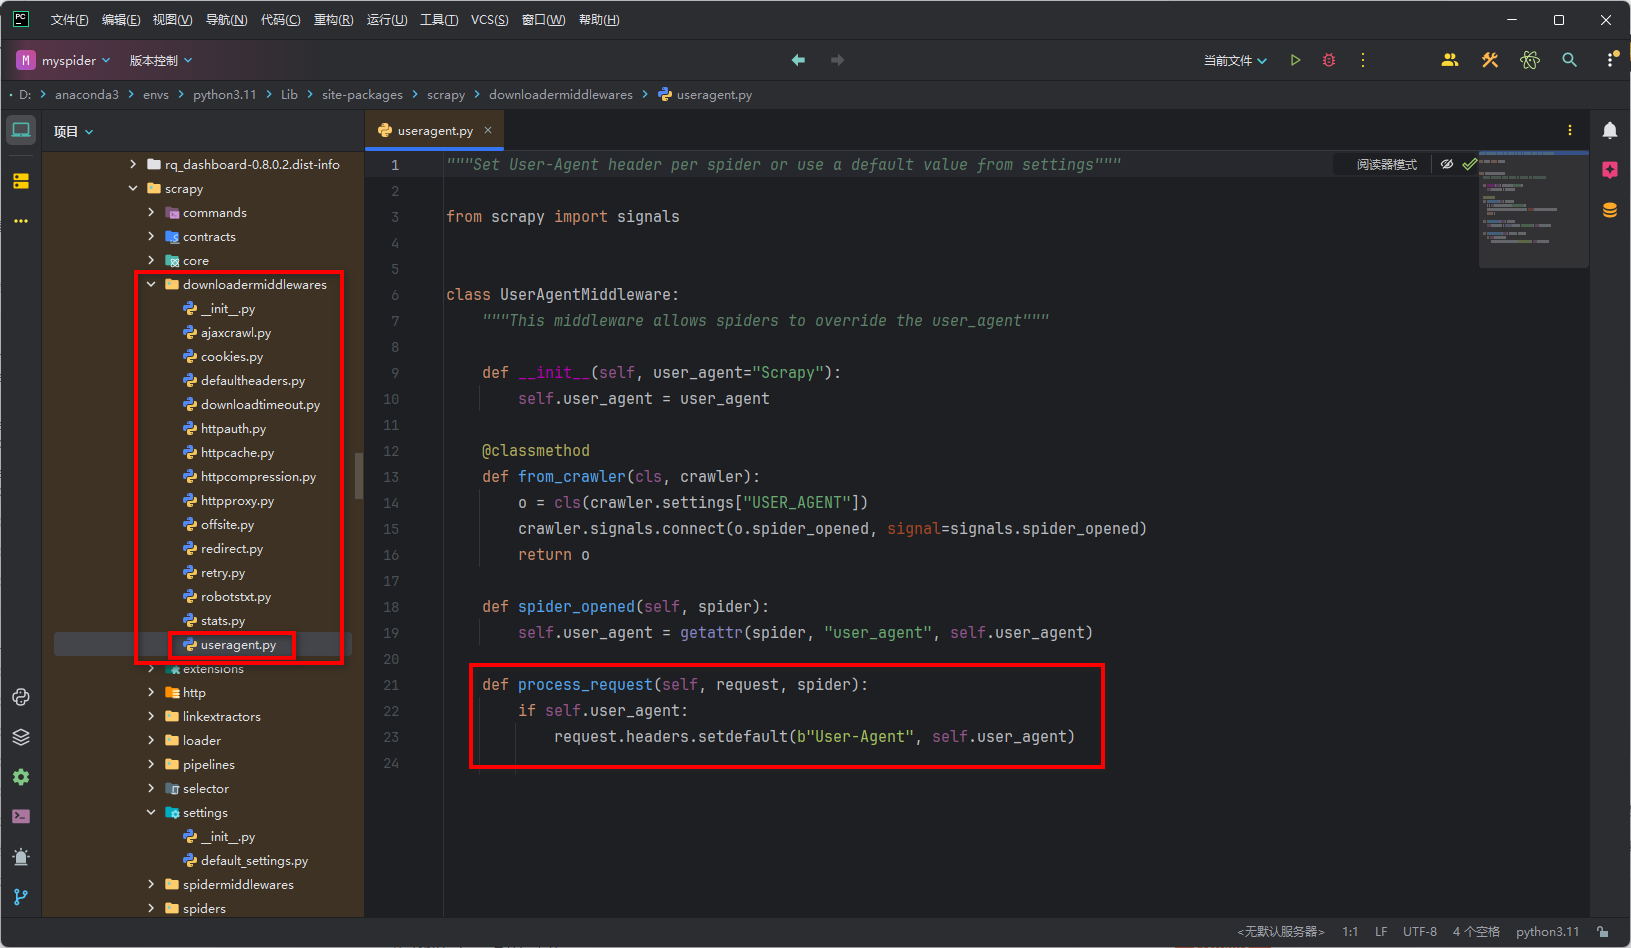
也可以不用系统自带的 ua 中间,
import random
from scrapy.utils.project import get_project_settings


class UAMiddleware(object):

    def process_request(self, request, spider):
        project_settings = get_project_settings()
        ua = random.choice(project_settings['USER_AGENT_LIST'])
        request.headers['User-Agent'] = ua
在 settings.py 设置
DOWNLOADER_MIDDLEWARES = {
   "myspider.middlewares.MyspiderDownloaderMiddleware": 543,
   "myspider.middlewares.UAMiddleware": 544,
}

USER_AGENT_LIST = [
    "Mozilla/5.0 (Windows NT 6.1; rv:2.0.1) Gecko/20100101 Firefox/4.0.1",
    "Mozilla/5.0 (Windows NT 6.1; Win64; x64; rv:2.0.1) Gecko/20100101 Firefox/4.0.1",
    "Mozilla/5.0 (Windows NT 5.1; rv:5.0) Gecko/20100101 Firefox/5.0",
    "Mozilla/5.0 (Windows NT 6.1; WOW64; rv:6.0a2) Gecko/20110622 Firefox/6.0a2",
    "Mozilla/5.0 (Windows NT 6.1; WOW64; rv:7.0.1) Gecko/20100101 Firefox/7.0.1",
    "Mozilla/5.0 (Windows NT 6.1; WOW64; rv:2.0b4pre) Gecko/20100815 Minefield/4.0b4pre",
    "Mozilla/4.0 (compatible; MSIE 5.5; Windows NT 5.0 )",
    "Mozilla/4.0 (compatible; MSIE 5.5; Windows 98; Win 9x 4.90)",
    "Mozilla/5.0 (Windows; U; Windows XP) Gecko MultiZilla/1.6.1.0a",
    "Mozilla/2.02E (Win95; U)",
    "Mozilla/3.01Gold (Win95; I)",
    "Mozilla/4.8 [en] (Windows NT 5.1; U)",
]
第三方库 ua:https://pypi.org/search/?q=fake-useragent
from fake_useragent import UserAgent


class UAMiddleware(object):

    def process_request(self, request, spider):
        ua = UserAgent()
        request.headers['User-Agent'] = ua.random
示例:重试 中间件
重试包括:
- 请求时超时的重试。这个是因为网络问题导致请求失败或者超时。
- 返回的 response 状态码不是 200 时的重试,这个可能因为网站反爬机制,导致返回的状态码不是 200
在某些情况下,少量的数据丢失是无关紧要的,例如在几亿次请求里面失败了十几次,损失微乎其微,没有必要重试。但还有一些情况,每一条请求都至关重要,容不得有一次失败。此时就需要使用中间件来进行重试。
在 Scrapy 中可以通过内置的 RetryMiddleware 来实现重试。在 settings.py 文件中包含以下配置:
# 启用 RetryMiddleware
DOWNLOADER_MIDDLEWARES = {
    'scrapy.downloadermiddlewares.retry.RetryMiddleware': 90,
}

# 设置最大重试次数
RETRY_TIMES = 3  # 默认是重试 2 次,总共请求 3 次

# 定义需要重试的 HTTP 状态码
# 注意:429 Too Many Requests 可以加入重试列表,表示服务器限流。
RETRY_HTTP_CODES = [500, 502, 503, 504, 507, 510, 599, 408, 429]
查看源码
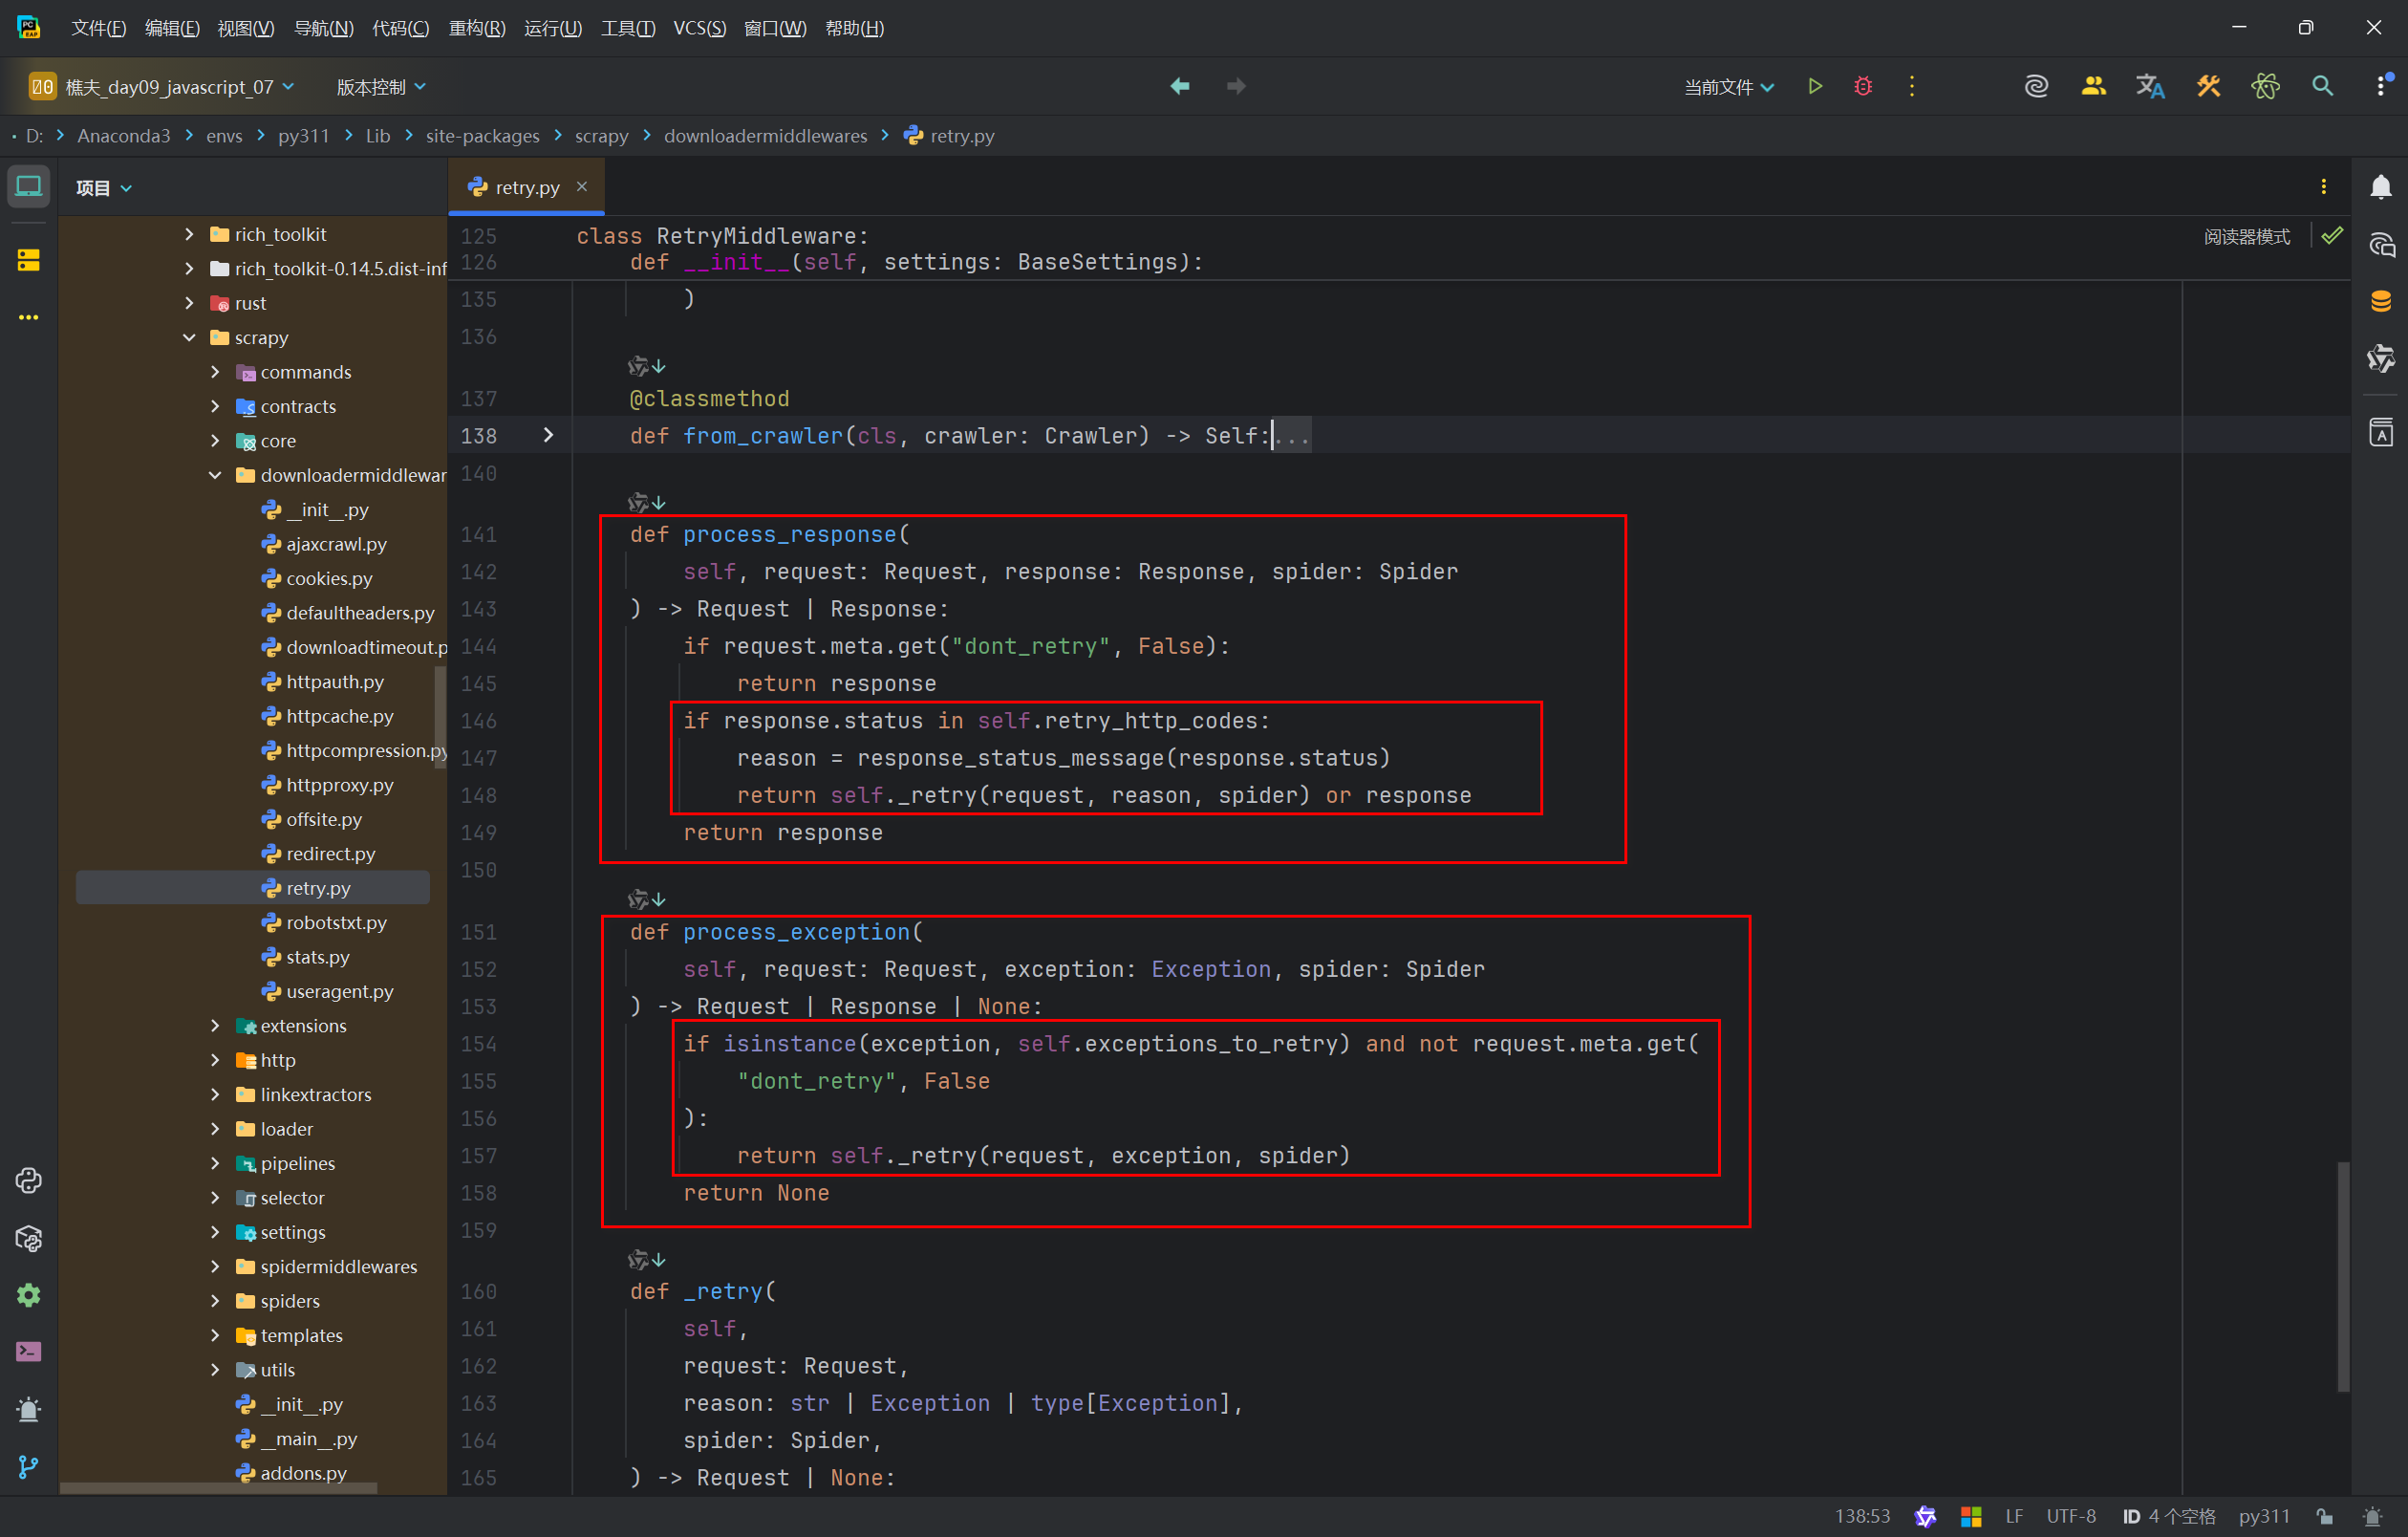
- process_response:处理返回的 response,判断 response.status 是否在 self.retry_http_codes 集合中,这个集合是一个列表,定义在 default_settings.py 文件中:RETRY_HTTP_CODES = [500, 502, 503, 504, 522, 524, 408]。如果在,就进入retry 的逻辑,不在集合中就直接 return response。这样就实现了对返回 http code 异常的 response 的重试了。
- process_exception:处理请求时的异常。例如:超时。
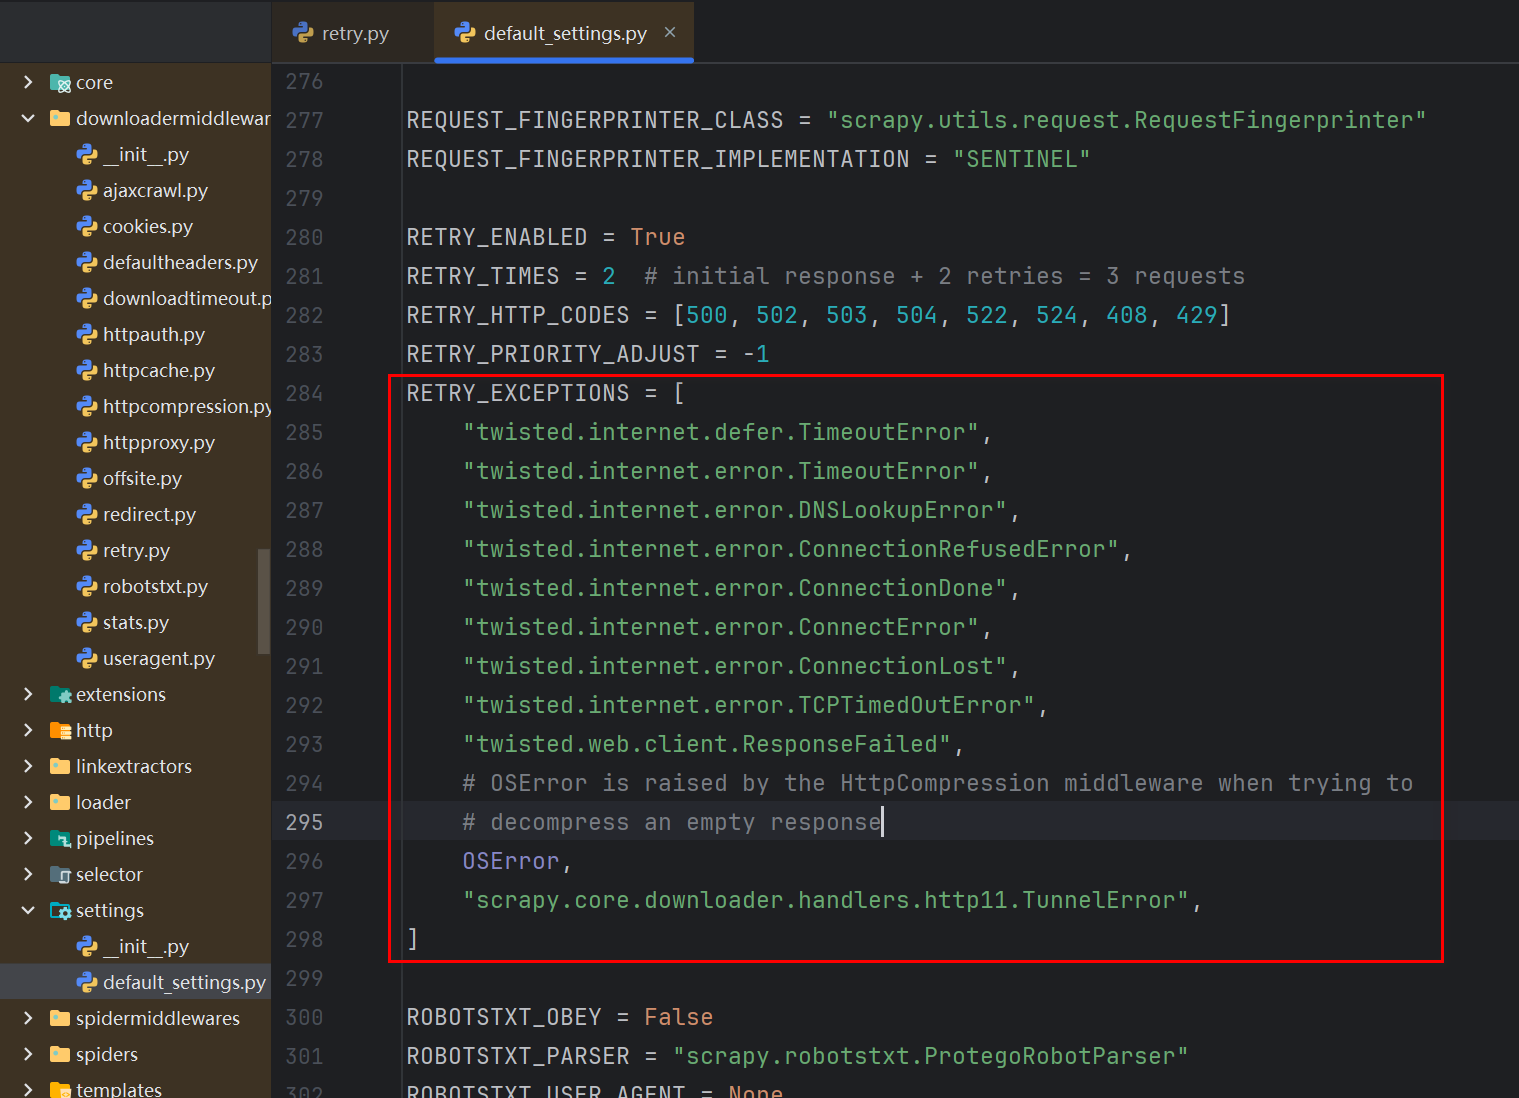
如果想自定义重试中间件,可以通过继承 scrapy 的重试中间件,然后重写 process_response 和 process_exception 即可,
process_response 中处理重试。
class CustomRetryMiddleware(RetryMiddleware):
    def __init__(self, settings):
        super().__init__(settings)

    def process_response(self, request, response, spider):
        # 如果请求失败,并且状态码在重试列表中,则重试
        if response.status in self.retry_http_codes:
            max_retry_times = spider.settings.get('RETRY_TIMES')
            retry_times = request.meta.get("retry_times", 0)
            if retry_times >= max_retry_times:
                task_dict = request.meta.get('task_dict')
                spider.server.sadd(spider.redis_key, json.dumps(task_dict, ensure_ascii=False))
            spider.logger.warning(f'[重试{retry_times + 1}次] ---> {request.url}')
            reason = response_status_message(response.status)
            return self._retry(request, reason, spider) or response

        return super().process_response(request, response, spider)
process_exception 中处理重试
def process_exception(self, request, exception, spider):
    max_retry = 3
    retry_times = request.meta.get("retry_times", 0)

    # 日志省略...

    if retry_times < max_retry:
        return request  # 继续重试
    else:
        logger.error(f"已达到最大重试{max_retry}次,丢弃链接:{request.url}")
        return None
HTTPERROR_ALLOWED_CODES
- HTTPERROR_ALLOWED_CODES:允许状态码
作用:让非 2xx 状态码可以正常进入 parse() 回调;
默认:只放行 200~299;其余状态码直接抛出 HttpError,不会走到你的 parse。
常见组合配置模板
# 最大重试次数
RETRY_TIMES = 3
# 哪些状态码触发重试
RETRY_HTTP_CODES = [500,502,503,504,408,429]
# 重试耗尽后,这些状态码允许进入parse做日志/落库
HTTPERROR_ALLOWED_CODES = [403,404,429,500,502,503,504]
重要坑点
- 3xx 重定向默认被 RedirectMiddleware 自动处理,不会到 parse 想要拿到原始 301/302 响应:
# 请求关闭自动重定向 yield scrapy.Request(url, meta={"dont_redirect": True}) # 同时把301、302加入允许列表 handle_httpstatus_list = [301,302] - 网络异常(超时、连接失败、DNS 错误)≠ HTTP 状态码 这类没有 response 对象,不会被
HTTPERROR_ALLOWED_CODES控制,只能用errback捕获。 - 404、403 默认不会触发重试,如果你希望 403 达到重试上限后存入 Redis,需要把
403,404添加进RETRY_HTTP_CODES - 不要随便开
HTTPERROR_ALLOW_ALL = True大量无效页面涌入 parse,容易引发解析报错,建议白名单指定状态码。
Scrapy 重试耗尽后将失败 URL 存入 Redis 完整方案。新建中间件 middlewares.py
import redis
from scrapy.downloadermiddlewares.retry import RetryMiddleware
from scrapy.utils.response import response_status_message
from scrapy.exceptions import IgnoreRequest

# Redis连接可以抽成单例,这里直接初始化
redis_client = redis.Redis(
    host="127.0.0.1",
    port=6379,
    db=0,
    password="",
    decode_responses=True
)

class RetrySaveFailedRedisMiddleware(RetryMiddleware):
    def _retry(self, request, reason, spider):
        # 获取当前已重试次数
        retry_times = request.meta.get("retry_times", 0) + 1
        max_retry = self.max_retry_times

        # 判断是否达到最大重试上限
        if retry_times > max_retry:
            spider.logger.error(
                f"达到最大重试次数{max_retry},丢弃请求,存入失败队列: {request.url}"
            )
            # 写入redis集合去重 / 列表
            # 集合(自动去重,推荐)
            redis_client.sadd("spider:failed_url_set", request.url)
            # 如果需要有序列表(允许重复)
            # redis_client.rpush("spider:failed_url_list", request.url)
            return None
        return super()._retry(request, reason, spider)
settings.py 配置
# 开启下载中间件,覆盖原生RetryMiddleware
DOWNLOADER_MIDDLEWARES = {
    'your_project_name.middlewares.RetrySaveFailedRedisMiddleware': 550,
    # 关闭原生重试中间件(二选一,推荐直接覆盖)
    'scrapy.downloadermiddlewares.retry.RetryMiddleware': None,
}

# 重试基础配置
RETRY_TIMES = 3  # 最大重试次数
RETRY_HTTP_CODES = [500, 502, 503, 504, 408, 429]

# 允许状态码(重试耗尽后如果你想在parse捕获响应按需处理)
HTTPERROR_ALLOWED_CODES = [429, 500, 502, 503, 504]
进阶优化版本,解决问题:
- Redis 连接写到中间件内部不优雅;
- 支持自定义 redis key;
- 兼容
dont_retry=True的请求不存入失败队列
import redis
from scrapy.downloadermiddlewares.retry import RetryMiddleware

class RetrySaveFailedRedisMiddleware(RetryMiddleware):
    def __init__(self, settings):
        super().__init__(settings)
        self.redis_cli = redis.Redis(
            host=settings.get("REDIS_HOST", "127.0.0.1"),
            port=settings.get("REDIS_PORT", 6379),
            db=settings.get("REDIS_DB", 0),
            password=settings.get("REDIS_PASSWORD", ""),
            decode_responses=True
        )
        self.failed_key = settings.get("REDIS_FAILED_KEY", "spider:failed_url_set")

    @classmethod
    def from_crawler(cls, crawler):
        return cls(crawler.settings)

    def _retry(self, request, reason, spider):
        if request.meta.get("dont_retry", False):
            return None

        retry_times = request.meta.get("retry_times", 0) + 1
        if retry_times > self.max_retry_times:
            spider.logger.warning(f"重试上限 {self.max_retry} 次,保存失败url:{request.url}")
            self.redis_cli.sadd(self.failed_key, request.url)
            return None
        return super()._retry(request, reason, spider)
对应 settings 追加:
REDIS_HOST = "127.0.0.1"
REDIS_PORT = 6379
REDIS_DB = 0
REDIS_PASSWORD = ""
REDIS_FAILED_KEY = "spider:failed_url_set"
示例:处理 所有 异常
上面的重试可以解决 response 状态码不是 200的异常,但是对于 HTTP 请求 error (准确的说是请求超时报错) 需要单独处理。可以创建一个scrapy项目,start_url 中填入一个无效的 url 即可模拟出此类异常。在 RetryMiddleware 中同样提供了对这类异常的处理办法:process_exception
示例:异常处理的中间件模板
from twisted.internet import defer
from twisted.internet.error import TimeoutError, DNSLookupError, \
    ConnectionRefusedError, ConnectionDone, ConnectError, \
    ConnectionLost, TCPTimedOutError
from scrapy.http import HtmlResponse
from twisted.web.client import ResponseFailed
from scrapy.core.downloader.handlers.http11 import TunnelError

class ProcessAllExceptionMiddleware(object):
    ALL_EXCEPTIONS = (defer.TimeoutError, TimeoutError, DNSLookupError,
                      ConnectionRefusedError, ConnectionDone, ConnectError,
                      ConnectionLost, TCPTimedOutError, ResponseFailed,
                      IOError, TunnelError)
    def process_response(self,request,response,spider):
        #捕获状态码为40x/50x的response
        if str(response.status).startswith('4') or str(response.status).startswith('5'):
            #随意封装,直接返回response,spider代码中根据url==''来处理response
            response = HtmlResponse(url='')
            return response
        #其他状态码不处理
        return response
    def process_exception(self,request,exception,spider):
        #捕获几乎所有的异常
        if isinstance(exception, self.ALL_EXCEPTIONS):
            #在日志中打印异常类型
            print('Got exception: %s' % (exception))
            #随意封装一个response,返回给spider
            response = HtmlResponse(url='exception')
            return response
        #打印出未捕获到的异常
        print('not contained exception: %s'%exception)
代码 2:
import logging
from scrapy.exceptions import IgnoreRequest
from twisted.internet.error import (
    ConnectError, ConnectionRefusedError, ConnectionLost,
    TimeoutError, TCPTimedOutError
)
from twisted.web._newclient import ResponseNeverReceived

logger = logging.getLogger("global_exception")


class GlobalCatchExceptionMiddleware:
    """全局捕获所有下载异常中间件"""

    def process_request(self, request, spider):
        """请求发送前无异常,无需处理"""
        return None

    def process_response(self, request, response, spider):
        # 响应正常直接放行
        return response

    def process_exception(self, request, exception, spider):
        """
        所有下载阶段异常都会进入这里
        return None:丢弃该请求
        return request:重新入队重试
        raise IgnoreRequest:主动丢弃
        """
        # 统一分类打印异常
        err_type = type(exception).__name__
        url = request.url
        proxy = request.meta.get("proxy", "无代理")
        retry_times = request.meta.get("retry_times", 0)

        # 区分各类常见网络异常
        if isinstance(exception, (TimeoutError, TCPTimedOutError)):
            err_msg = "请求超时"
        elif isinstance(exception, (ConnectError, ConnectionRefusedError)):
            err_msg = "连接失败/代理不可用"
        elif isinstance(exception, ConnectionLost):
            err_msg = "连接中断"
        elif isinstance(exception, ResponseNeverReceived):
            err_msg = "未收到服务器响应"
        else:
            err_msg = f"未知异常:{str(exception)}"

        # 完整日志输出
        logger.error(
            f"【下载异常】URL: {url}\n"
            f"代理: {proxy} | 已重试次数: {retry_times}\n"
            f"异常类型: {err_type} | 描述: {err_msg}\n"
            f"原始异常详情: {exception}"
        )

        # 可选逻辑1:交给重试中间件处理(返回request会触发重试)
        return request

        # 可选逻辑2:直接丢弃,不再重试
        # return None

        # 可选逻辑3:主动抛出忽略,不再走后续流程
        # raise IgnoreRequest(f"丢弃异常链接:{url}")
spider 代码
class TESTSpider(scrapy.Spider):
    name = 'TEST'
    allowed_domains = ['TTTTT.com']
    start_urls = ['http://www.TTTTT.com/hypernym/?q=']
    custom_settings = {
        'DOWNLOADER_MIDDLEWARES': {
            'scrapy.downloadermiddlewares.useragent.UserAgentMiddleware': None,
            'TESTSpider.middlewares.ProcessAllExceptionMiddleware': 120,
        },
        'DOWNLOAD_DELAY': 1,  # 延时最低为2s
        'AUTOTHROTTLE_ENABLED': True,  # 启动[自动限速]
        'AUTOTHROTTLE_DEBUG': True,  # 开启[自动限速]的debug
        'AUTOTHROTTLE_MAX_DELAY': 10,  # 设置最大下载延时
        'DOWNLOAD_TIMEOUT': 15,
        'CONCURRENT_REQUESTS_PER_DOMAIN': 4  # 限制对该网站的并发请求数
    }
    def parse(self, response):
        if not response.url: #接收到url==''时
            print('500')
            yield TESTItem(key=response.meta['key'], _str=500, alias='')
        elif 'exception' in response.url:
            print('exception')
            yield TESTItem(key=response.meta['key'], _str='EXCEPTION', alias='')
注意:该中间件的 Order_code 不能过大,如果过大就会越接近下载器,就会优先于 RetryMiddleware 处理 response,但这个中间件是用来兜底的,即当一个 response 500 进入中间件链时,需要先经过 retry 中间件处理,不能先由我们写的中间件来处理,它不具有 retry 的功能,接收到 500 的 response 就直接放弃掉该 request 直接 return了,这是不合理的。只有经过 retry 后仍然有异常的 request 才应当由我们写的中间件来处理,这时候你想怎么处理都可以,比如再次 retry、return 一个重新构造的 response。
示例:playwright 中间件
在 Scrapy 中使用 Playwright,可以通过中间件将 Scrapy 的请求和 Playwright 的浏览器自动化相结合。安装:pip install scrapy scrapy-playwright
pypi 搜索关于 playwright 的包:https://pypi.org/search/?q=playwright
在 Scrapy 项目中集成 Playwright。编辑 settings.py 文件,启用 scrapy-playwright 中间件:
# settings.py

DOWNLOADER_MIDDLEWARES = {
    'scrapy_playwright.middleware.PlaywrightMiddleware': 543,
    'scrapy.downloadermiddlewares.useragent.UserAgentMiddleware': None,  # Optional
}

# 如果需要,配置 Playwright 的浏览器选项
PLAYWRIGHT_BROWSER_TYPE = 'chromium'  # 可选值: 'chromium', 'firefox', 'webkit'
在爬虫文件中,使用 scrapy_playwright 的 API 来发起请求。例如:
import scrapy
from scrapy_playwright.page import PageCoroutine

class MySpider(scrapy.Spider):
    name = 'my_spider'
    start_urls = ['https://example.com']

    async def parse(self, response):
        # 提取信息
        title = response.css('title::text').get()
        self.log(f'Title: {title}')

        # 使用 Playwright 页面操作
        page = response.meta['playwright_page']
        await page.click('selector')  # 使用 Playwright 的方法进行交互
        await page.wait_for_selector('new_selector')  # 等待新元素出现

        # 获取新的内容
        new_content = await page.content()
        self.log(f'New Content: {new_content}')

    def start_requests(self):
        for url in self.start_urls:
            yield scrapy.Request(url, self.parse, meta={'playwright': True})
- 在请求中需要将 meta 中的 playwright 设置为 True ,以告知 Scrapy 使用 Playwright。
- 可以通过 response.meta['playwright_page'] 获取当前的 Playwright 页面实例,允许你使用 Playwright 的方法来进行进一步的操作(如点击、输入等)。
- 任何 Playwright 的异步操作都需要使用 await 关键字。
selenium 中间件:https://pypi.org/search/?q=SeleniumMiddleware
示例:cookies 中间件
对于需要登录的网站,可以使用 Cookies 来保持登录状态。cookies 中间件专门用来爬取需要 cookie(例如使用session)的网站。 其追踪了web server发送的cookie,并在之后的 request 都携带 cookies 进行发送。
scrapy 自带的 cookie 中间件,
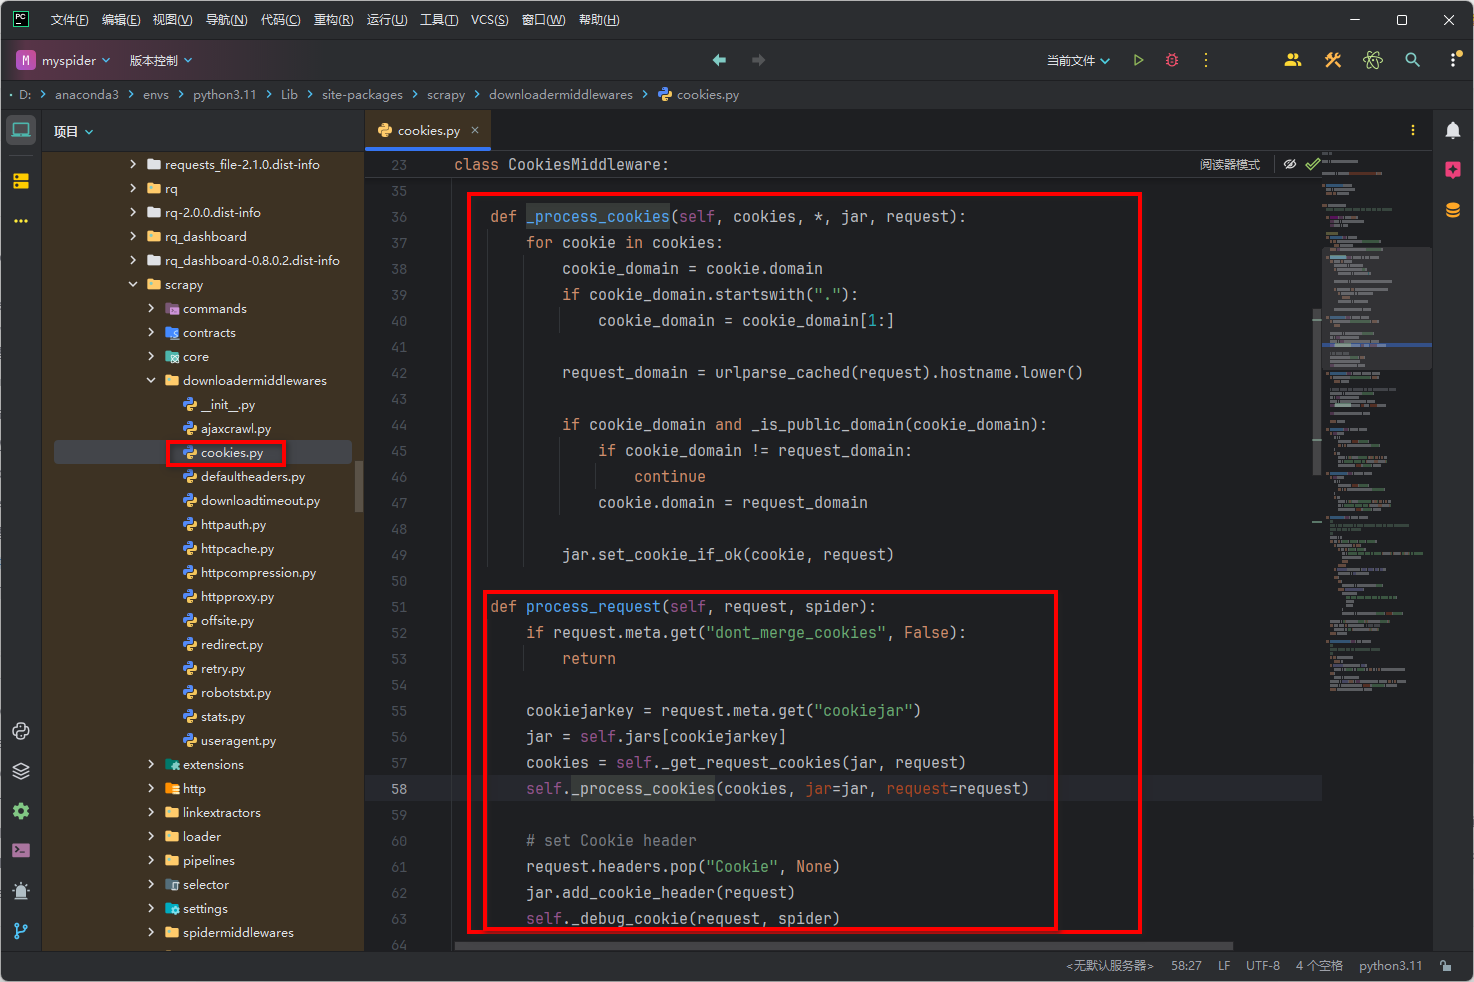
启用自带的 cookies 中间件,需要在 settings.py 中 启用:COOKIES_ENABLED = True
- COOKIES_ENABLED 默认: True。如果为False则cookies 将不会发送给 web server。
- COOKIES_DEBUG 默认: False。如果为 True,则Scrapy将记录所有在request(Cookie 请求头)发送的cookies及response接收到的cookies(Set-Cookie 接收头)。
不想使用自带的cookies中间件时,也可以自定义 Python 类实现 cookies 中间件
class LoginMiddleware(object):

    def process_request(self, request, spider):
        if spider.name == 'loginSpider':
            cookies = '登录的cookies'
            request.cookies = cookies
关于 cookiejar
Scrapy 通过使用 cookiejar 作为 Request meta 的 key 来支持单 spider 追踪多 cookie session。 默认情况下其使用一个 cookie jar(session),不过您可以传递一个标示符来使用多个。
例如 ( yield 的 每个 Request 都 有一个 meta={'cookiejar': i} ,cookiejar 这个字段的 值只是一个标识,只要不为 None 就行,通常 设置为一个整数 。例如 1,或者 True):
for i, url in enumerate(urls):
    yield scrapy.Request(
        url="http://www.example.com",
        meta={'cookiejar': i},
        callback=self.parse_page
    )
需要注意的是 cookiejar meta key不是”黏性的(sticky)”。 您需要在之后的 每个 request 请求中接着传递。例如:
def parse_page(self, response):
    # do some processing
    return scrapy.Request("http://www.example.com/otherpage",
        meta={'cookiejar': response.meta['cookiejar']},
        callback=self.parse_other_page)
示例:请求头 中间件
该中间件通过设置 DEFAULT_REQUEST_HEADERS 来指定的默认请求头
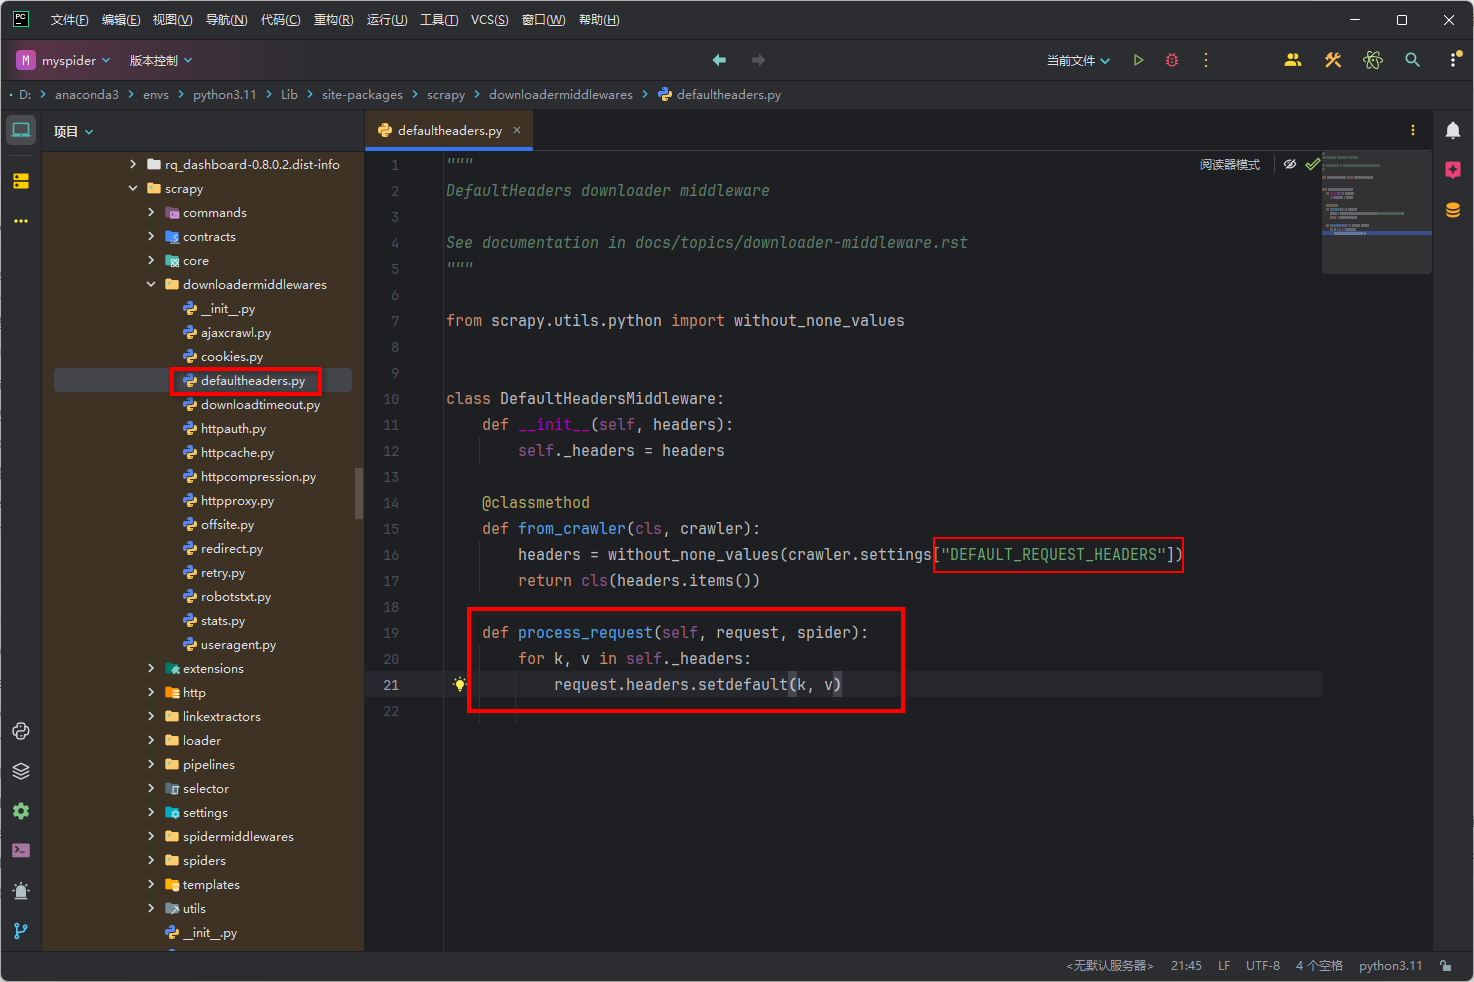
示例:下载超时 中间件
此中间件设置 DOWNLOAD_TIMEOUT 设置或 download_timeout 爬虫属性中指定的请求的下载超时时间。
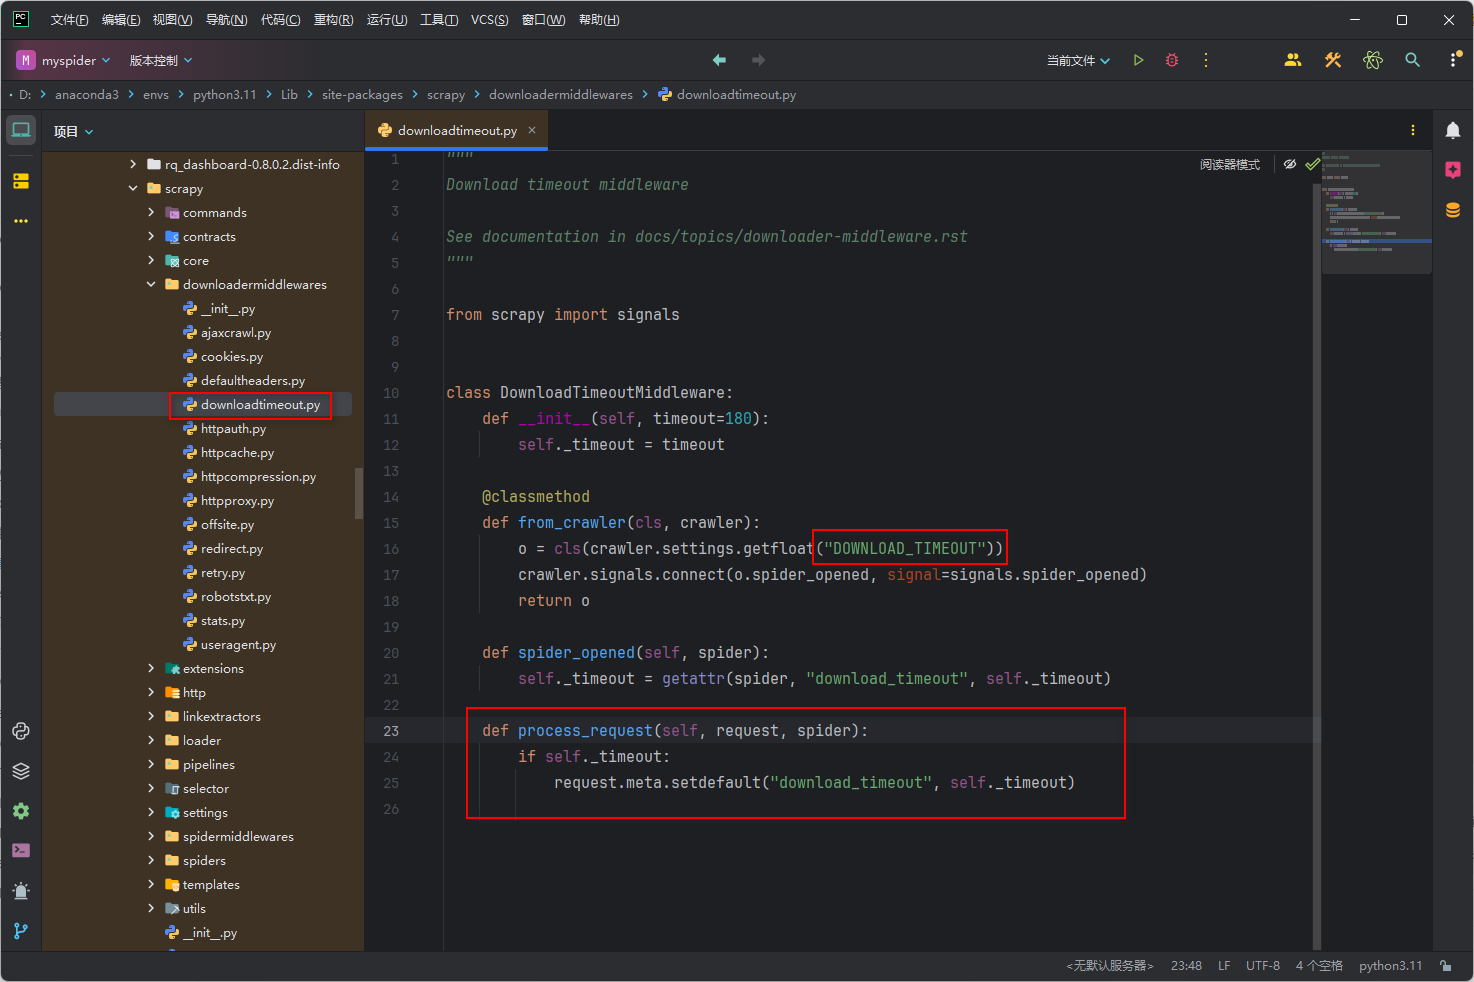
可以在单独设置每个 request 的下载超时,只需要使用 download_timeout 作为 Request.meta 的键设置超时时间。即使禁用了 DownloadTimeoutMiddleware 也支持此操作。
示例:针对特定响应状态码,重新请求
实际爬虫过程中如果请求过于频繁,通常会被临时重定向到登录页面即302,甚至是提示禁止访问即403,因此可以对这些响应执行一次代理请求:
- (1) 参考原生 redirect.py 模块,满足 dont_redirect 或 handle_httpstatus_list 等条件时,直接传递 response
- (2) 不满足条件(1),如果响应状态码为 302 或 403,使用代理重新发起请求
- (3) 使用代理后,如果响应状态码仍为 302 或 403,直接丢弃
my_middlewares.py
from w3lib.url import safe_url_string
from six.moves.urllib.parse import urljoin

from scrapy.exceptions import IgnoreRequest


class MyAutoProxyDownloaderMiddleware(object):

    def __init__(self, settings):
        self.proxy_status = settings.get('PROXY_STATUS', [302, 403])
        # See https://doc.scrapy.org/en/latest/topics/downloader-middleware.html?highlight=proxy#module-scrapy.downloadermiddlewares.httpproxy
        self.proxy_config = settings.get('PROXY_CONFIG', 'http://username:password@some_proxy_server:port')


    @classmethod
    def from_crawler(cls, crawler):
        return cls(
            settings = crawler.settings
        )


    # See /site-packages/scrapy/downloadermiddlewares/redirect.py
    def process_response(self, request, response, spider):
        if (request.meta.get('dont_redirect', False) or
                response.status in getattr(spider, 'handle_httpstatus_list', []) or
                response.status in request.meta.get('handle_httpstatus_list', []) or
                request.meta.get('handle_httpstatus_all', False)):
            return response

        if response.status in self.proxy_status:
            if 'Location' in response.headers:
                location = safe_url_string(response.headers['location'])
                redirected_url = urljoin(request.url, location)
            else:
                redirected_url = ''

            # AutoProxy for first time
            if not request.meta.get('auto_proxy'):
                request.meta.update({'auto_proxy': True, 'proxy': self.proxy_config})
                new_request = request.replace(meta=request.meta, dont_filter=True)
                new_request.priority = request.priority + 2

                spider.log('Will AutoProxy for <{} {}> {}'.format(
                            response.status, request.url, redirected_url))
                return new_request

            # IgnoreRequest for second time
            else:
                spider.logger.warn('Ignoring response <{} {}>: HTTP status code still in {} after AutoProxy'.format(
                                    response.status, request.url, self.proxy_status))
                raise IgnoreRequest

        return response
在 settings.py 配置。注意必须在默认的 RedirectMiddleware 和 HttpProxyMiddleware 之间。
# Enable or disable downloader middlewares
# See https://doc.scrapy.org/en/latest/topics/downloader-middleware.html
DOWNLOADER_MIDDLEWARES = {
    # 'scrapy.downloadermiddlewares.redirect.RedirectMiddleware': 600,
    'my_middlewares.MyAutoProxyDownloaderMiddleware': 601,
    # 'scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware': 750,
}
PROXY_STATUS = [302, 403]
PROXY_CONFIG = 'http://username:password@some_proxy_server:port'
示例:内置 下载器 中间件
内置 下载器 中间件:https://docs.scrapy.net.cn/en/latest/topics/downloader-middleware.html
Scrapy 内置中间件自带固定权重,自定义中间件权重建议穿插在中间区间:
100: DownloadTimeoutMiddleware          # 请求超时控制
200: HttpAuthMiddleware                 # http基础认证
300: DefaultHeadersMiddleware           # 全局默认headers
400: UserAgentMiddleware                # User-Agent
500: RetryMiddleware                    # 请求重试(超时、5xx)
550: RedirectMiddleware                 # 3xx重定向
600: MetaRefreshMiddleware
700: HttpCompressionMiddleware          # gzip解压
750: CookiesMiddleware                  # cookie会话管理
900: HttpProxyMiddleware                # 代理中间件
950: DepthMiddleware                    # 爬取深度限制
1000: HttpClientMiddleware              # 原生http下载器
执行逻辑: 前面 UA、Cookie、重试、代理中间件先处理 request → FakeTlsMiddleware 接管请求,用 curl_cffi 代替原生下载器发送请求 → 响应逆向回传上层中间件。常见踩坑点
- 权重顺序错误 代理中间件权重 900,自定义中间件数字大于 900 时,代理会失效(先执行自定义逻辑,代理后执行覆盖)。 自定义代理 / 指纹中间件权重建议 500~600,在 ProxyMiddleware 之前。
- 返回值混淆 process_request 返回 Response 不会发网络请求;返回 Request 会重新走全套中间件。
- 异常顺序搞反 网络报错时,先执行权重最大的中间件的 process_exception,不是最先执行的那个。
- 多中间件 Cookie 冲突 CookiesMiddleware 权重 750,如果自定义中间件在 750 之后修改 Cookie,会覆盖会话 Cookie。
scrapy 切换 下载器
Scrapy 在爬虫启动初始化阶段就一次性加载、实例化所有下载处理器,存入下载器内部缓存字典 self._handlers;运行时直接修改全局 DOWNLOAD_HANDLERS 不会重新实例化处理器,所以运行中修改crawler.settings["DOWNLOAD_HANDLERS"]设置无效
单请求动态切换不同下载处理器
- 方法 1:主流方案,原理:提前在配置注册多套 handler,中间件动态修改请求 URL 的
scheme(协议头),让下载器根据新 scheme 匹配不同 handler;这是 scrapy-playwright、scrapy-splash 通用实现方案。 - 方法 2:运行时动态替换 scheme 对应的 handler 实例:底层可改,但不推荐 直接操作
downloader._handlers内部缓存,属于私有 API,版本升级容易失效。
关键限制与注意点
DOWNLOAD_HANDLERS设置仅初始化生效 爬虫启动时一次性加载所有 scheme 对应的 handler 类并实例化,运行中修改 settings 字典不会刷新缓存处理器。- 多 handler 资源隔离 浏览器类 handler(playwright/splash)会启动进程 / 连接池,提前注册会占用内存;不需要时可标记
lazy=True延迟实例化Scrapy。 - 中间件执行顺序 修改 scheme 的中间件权重要小于下载处理器调用前的层级(常规 500~600 区间即可)。
- 并发与重试 切换 handler 不会改变并发、延迟配置,两套 handler 各自维护独立连接 / 浏览器池。
选型建议
- 少量请求动态渲染、大部分走原生请求 → 方案 1(改 scheme),行业标准写法;
- 全站需要频繁切换、不想改动 URL → 方案 2(分发代理 handler);
示例:使用 curl_cffi
在 scrapy 中可以使用 curl_cffi 做为下载器,从而代替 scrapy 原生下载器。
scrapy-fake-tls:https://pypi.org/project/scrapy-fake-tls/
安装:pip install scrapy-fake-tls
setting.py 中添加配置
# 使用 Asyncio 反应器,支持异步操作
TWISTED_REACTOR = "twisted.internet.asyncioreactor.AsyncioSelectorReactor"
# 注册自定义下载处理器
DOWNLOAD_HANDLERS = {
    "http": "scrapy_fake_tls.AsyncCurlCffiDownloadHandler",
    "https": "scrapy_fake_tls.AsyncCurlCffiDownloadHandler",
}
# 模拟的浏览器
CURL_CFFI_IMPERSONATE = "chrome"
其他什么都不用变,scrapy 就会使用 curl_cffi 去发请求进行下载。
示例:使用 curl_cffi
在 scrapy 中可以使用 curl_cffi 做为下载器,从而代替 scrapy 原生下载器。
pypi:https://pypi.org/project/scrapy-impersonate/
安装:pip install scrapy-impersonate
scrapy-impersonate是一个Scrapy下载处理程序。该项目集成了 curl_cffi 来执行HTTP请求,因此它可以模拟浏览器的 TLS 签名或 JA3 指纹。用法:
import scrapy


class ImpersonateSpider(scrapy.Spider):
    name = "impersonate_spider"
    custom_settings = {
        "TWISTED_REACTOR": "twisted.internet.asyncioreactor.AsyncioSelectorReactor",
        # 当 USER_AGENT = None 时,curl_cffi 将根据模拟的浏览器自动选择合适的 USER_AGENT
        "USER_AGENT": "",
        "DOWNLOAD_HANDLERS": {
            "http": "scrapy_impersonate.ImpersonateDownloadHandler",
            "https": "scrapy_impersonate.ImpersonateDownloadHandler",
        },
        "DOWNLOADER_MIDDLEWARES": {
            "scrapy_impersonate.RandomBrowserMiddleware": 1000,
        },
    }

    def start_requests(self):
        for _ in range(5):
            yield scrapy.Request(
                "https://tls.browserleaks.com/json",
                dont_filter=True,
            )

    def parse(self, response):
        # ja3_hash: 98cc085d47985d3cca9ec1415bbbf0d1 (chrome133a)
        # ja3_hash: 2d692a4485ca2f5f2b10ecb2d2909ad3 (firefox133)
        # ja3_hash: c11ab92a9db8107e2a0b0486f35b80b9 (chrome124)
        # ja3_hash: 773906b0efdefa24a7f2b8eb6985bf37 (safari15_5)
        # ja3_hash: cd08e31494f9531f560d64c695473da9 (chrome99_android)

        yield {"ja3_hash": response.json()["ja3_hash"]}
用法:通过 meta 传递所需要的参数
yield scrapy.Request(
    "https://tls.browserleaks.com/json",
    dont_filter=True,
    meta={
        "impersonate": browser,
        "impersonate_args": {
            "verify": False,
            "timeout": 10,
        },
    },
)
示例:改 URL scheme
通过修改 URL 的 scheme 从而实现单请求切换 下载器。场景举例
- 普通接口:用默认
httpxhandler(schemehttp/https) - JS 渲染页面:用 playwright handler(自定义 scheme
pw-http/pw-https)
settings.py 注册多套下载处理器,新增自定义 pw-http/pw-https 绑定浏览器处理器
# settings.py
# 保留默认http/https为原生httpx
# 新增自定义scheme,绑定playwright处理器
DOWNLOAD_HANDLERS = {
    # 自定义协议,绑定playwright渲染处理器
    "pw-http": "scrapy_playwright.handler.ScrapyPlaywrightDownloadHandler",
    "pw-https": "scrapy_playwright.handler.ScrapyPlaywrightDownloadHandler",
}

# Playwright基础配置(按需)
PLAYWRIGHT_LAUNCH_OPTIONS = {
    "headless": True,
}
PLAYWRIGHT_MAX_PAGES_PER_CONTEXT = 5

# 注册自定义中间件(后面写的切换scheme中间件)
DOWNLOADER_MIDDLEWARES = {
    "demo.middlewares.SwitchSchemeMiddleware": 540,
}
下载中间件:根据 meta 动态替换请求 scheme
- 请求下发前:识别
meta={"use_render": True},把http→pw-http、https→pw-https - 请求完成后:还原响应 URL 的协议,避免后续解析异常
# middlewares.py
from urllib.parse import urlparse, urlunparse

class SwitchSchemeMiddleware:
    def process_request(self, request, spider):
        # 通过meta标记是否需要浏览器渲染
        need_render = request.meta.get("use_render", False)
        if not need_render:
            # 无需修改,走原生http/https处理器
            return None

        # 拆分url六段结构
        parse_result = urlparse(request.url)
        scheme = parse_result.scheme

        # 替换自定义协议
        if scheme == "http":
            new_scheme = "pw-http"
        elif scheme == "https":
            new_scheme = "pw-https"
        else:
            # 非http链接不处理
            return None

        # 重构新url,仅替换scheme,其余不变
        new_url = urlunparse((
            new_scheme,
            parse_result.netloc,
            parse_result.path,
            parse_result.params,
            parse_result.query,
            parse_result.fragment
        ))
        # 修改request真实url
        request._set_url(new_url)
        return None

    def process_response(self, request, response, spider):
        # 渲染后的响应url带有pw-前缀,必须还原
        parse_result = urlparse(response.url)
        scheme = parse_result.scheme

        if scheme.startswith("pw-"):
            # 去掉pw-,恢复原始http/https
            origin_scheme = scheme.replace("pw-", "")
            restore_url = urlunparse((
                origin_scheme,
                parse_result.netloc,
                parse_result.path,
                parse_result.params,
                parse_result.query,
                parse_result.fragment
            ))
            # 覆盖response的url
            response._set_url(restore_url)
        return response
爬虫中区分 "普通请求 / 渲染请求":只需在 Request 的 meta 添加 use_render=True,中间件自动切换处理器
# spiders/test_spider.py
import scrapy

class TestSpider(scrapy.Spider):
    name = "test_render"

    def start_requests(self):
        # 1. 普通接口,原生httpx下载,不渲染JS
        yield scrapy.Request(
            url="https://httpbin.org/json",
            callback=self.parse_api
        )

        # 2. 动态JS页面,自动切换Playwright处理器
        yield scrapy.Request(
            url="https://spa1.scrape.center/",
            meta={
                "use_render": True,
                "playwright": True,  # scrapy-playwright固定标识
                "playwright_page_methods": [
                    # 等待页面加载完成
                    ("wait_for_timeout", 3000)
                ]
            },
            callback=self.parse_render
        )

    def parse_api(self, response):
        self.logger.info(f"普通接口结果:{response.json()}")

    def parse_render(self, response):
        # 此时response.url已经被中间件还原为https开头
        self.logger.info(f"渲染后页面标题:{response.xpath('//h1/text()').get()}")
方法 2,分发 不同 下载处理器
写一个代理下载处理器,统一接管 http/https,内部根据 request.meta 分发到不同真实 handler。
- 优势:更灵活,不用篡改 URL scheme,仅靠 meta 区分;
- 缺点:全局统一接管,所有 http 请求都会先走分发逻辑。
自定义分发 handler
# downloadhandlers.py
from scrapy.core.downloader.handlers._httpx import HttpxDownloadHandler
from scrapy_playwright.handler import ScrapyPlaywrightDownloadHandler

class DispatchDownloadHandler:
    lazy = False
    def __init__(self, settings):
        # 预实例化两套处理器
        self.http_handler = HttpxDownloadHandler(settings)
        self.pw_handler = ScrapyPlaywrightDownloadHandler(settings)

    def download_request(self, request, spider):
        # 根据meta动态选择执行器
        if request.meta.get("use_pw"):
            return self.pw_handler.download_request(request, spider)
        return self.http_handler.download_request(request, spider)
settings 全局替换 http/https 处理器
DOWNLOAD_HANDLERS = {
    "http": "myproject.downloadhandlers.DispatchDownloadHandler",
    "https": "myproject.downloadhandlers.DispatchDownloadHandler",
}
方法 3,底层直接修改 downloader._handlers
缺点:
- 不推荐,因为
_handlers是私有变量,无版本兼容保证,升级 Scrapy 可能失效; - 已在队列、正在下载的请求不会切换,仅新请求生效;
- 旧 handler 资源(浏览器池、连接池)不会自动释放,易内存泄漏。
爬虫运行中通过 crawler 拿到下载器实例,直接替换缓存内 handler 对象:
# 在spider/中间件/信号里执行
from scrapy_playwright.handler import ScrapyPlaywrightDownloadHandler

def swap_handler(crawler):
    dh = crawler.engine.downloader
    # 实例化新handler
    new_pw_handler = ScrapyPlaywrightDownloadHandler(crawler.settings)
    # 直接覆盖内部缓存
    dh._handlers["https"] = new_pw_handler
    dh._handlers["http"] = new_pw_handler
方法 4:下载中间件
统一拦截所有请求,JS 动态页面自动用 Scrapling 渲染,普通静态页面走原生 Scrapy。全爬虫统一渲染,不想费事,就推荐使用 这个方法。
编写中间件 middlewares.py
from scrapy.http import HtmlResponse
from scrapling import AsyncFetcher

class ScraplingRenderMiddleware:
    def __init__(self):
        self.fetcher = None

    async def process_request(self, request, spider):
        # 自定义开关:meta={"render": True} 才启用渲染
        if not request.meta.get("render"):
            return None  # 交给原生scrapy下载器

        # 单例初始化浏览器
        if not self.fetcher:
            self.fetcher = AsyncFetcher(
                stealthy=True,
                headless=True,
                randomize_fingerprint=True
            )

        # Scrapling渲染页面
        result = await self.fetcher.fetch(
            url=request.url,
            headers=dict(request.headers),
            cookies=request.cookies
        )

        # 将渲染后的html封装为Scrapy Response对象
        return HtmlResponse(
            url=request.url,
            body=result.html.encode("utf-8"),
            encoding="utf-8",
            request=request
        )

    async def spider_closed(self, spider):
        # 爬虫关闭时销毁浏览器进程
        if self.fetcher:
            await self.fetcher.close()
爬虫中使用(只需要加 meta={"render": True})
import scrapy

class DemoSpider(scrapy.Spider):
    name = "render_demo"

    def start_requests(self):
        yield scrapy.Request(
            url="https://动态渲染网站",
            meta={"render": True},  # 开启scrapling渲染
            callback=self.parse
        )

    def parse(self, response):
        # 正常使用scrapy原生xpath/css,无需改动解析代码
        yield {
            "title": response.css("title::text").get()
        }
常用高级配置 Scrapling 参数
fetcher = AsyncFetcher(
    # 反爬核心配置
    stealthy=True,                # 隐藏浏览器特征,绕过检测
    randomize_fingerprint=True,    # 每次请求随机浏览器指纹
    random_user_agent=True,        # 随机UA
    disable_images=True,           # 关闭图片加载,提速省流量

    # 浏览器配置
    headless=True,
    timeout=30000,

    # 代理
    proxy="http://127.0.0.1:7890",

    # 弹窗、验证码自动处理
    auto_wait=True,               # 等待页面完全加载完成
    wait_for_selector="#content", # 等待指定元素出现再返回
)- 中间件统一单例
fetcher,不要每次请求新建浏览器 - 爬虫关闭钩子
spider_closed必须执行close() - 降低并发
CONCURRENT_REQUESTS = 2~4
中间件 2
# middlewares/scrapling_middleware.py
from typing import Optional
import scrapling
from scrapling import Fetcher
from scrapy import signals
from scrapy.http import HtmlResponse, Response
from scrapy.utils.python import to_bytes
import warnings

# 屏蔽ssl、curl_cffi警告
warnings.filterwarnings("ignore")

class ScraplingDownloaderMiddleware:
    def __init__(self, crawler):
        self.crawler = crawler
        # 全局单例fetcher,复用浏览器指纹池,提升性能
        self.fetcher: Optional[Fetcher] = None
        # 读取settings配置
        self.impersonate = crawler.settings.get("SCRAPLING_IMPERSONATE", "chrome124")
        self.timeout = crawler.settings.getint("SCRAPLING_TIMEOUT", 30)
        self.allow_redirects = crawler.settings.getbool("SCRAPLING_REDIRECTS", True)
        self.verify_ssl = crawler.settings.getbool("SCRAPLING_VERIFY_SSL", False)

    @classmethod
    def from_crawler(cls, crawler):
        s = cls(crawler)
        crawler.signals.connect(s.spider_closed, signal=signals.spider_closed)
        return s

    def spider_opened(self, spider):
        # 初始化Scrapling Fetcher
        self.fetcher = Fetcher(
            impersonate=self.impersonate,
            timeout=self.timeout,
            verify=self.verify_ssl,
            auto_cookies=True,
            headless=True
        )
        spider.logger.info(f"Scrapling Fetcher init done, fingerprint: {self.impersonate}")

    def spider_closed(self, spider):
        # 释放资源
        if self.fetcher:
            self.fetcher.close()
            spider.logger.info("Scrapling Fetcher closed")

    def process_request(self, request, spider):
        """拦截Scrapy请求,用Scrapling发送,直接返回Response跳过原生下载器"""
        # 从request.meta读取个性化参数,覆盖全局配置
        meta = request.meta
        req_impersonate = meta.get("scrapling_impersonate", self.impersonate)
        req_timeout = meta.get("scrapling_timeout", self.timeout)
        req_redirect = meta.get("scrapling_redirects", self.allow_redirects)
        req_verify = meta.get("scrapling_verify", self.verify_ssl)
        js_render = meta.get("scrapling_render_js", False)  # 是否渲染JS

        # 组装请求头
        headers = dict(request.headers)
        # 合并cookies
        cookies = {}
        if request.cookies:
            cookies = request.cookies

        try:
            if js_render:
                # JS渲染模式(完整浏览器渲染,适合动态页面)
                resp = self.fetcher.fetch(
                    url=request.url,
                    method=request.method,
                    headers=headers,
                    cookies=cookies,
                    data=request.body if request.body else None,
                    impersonate=req_impersonate,
                    timeout=req_timeout,
                    follow_redirects=req_redirect,
                    verify=req_verify,
                    render_js=True
                )
            else:
                # 普通静态请求(速度更快,无JS渲染)
                resp = self.fetcher.fetch(
                    url=request.url,
                    method=request.method,
                    headers=headers,
                    cookies=cookies,
                    data=request.body if request.body else None,
                    impersonate=req_impersonate,
                    timeout=req_timeout,
                    follow_redirects=req_redirect,
                    verify=req_verify
                )
        except Exception as e:
            spider.logger.error(f"Scrapling fetch failed {request.url} | err: {str(e)}")
            return None  # 交给scrapy重试中间件处理

        # 转换Scrapling Response → Scrapy Response
        body_bytes = to_bytes(resp.text)
        scrapy_resp = HtmlResponse(
            url=resp.url,
            status=resp.status_code,
            headers=resp.headers,
            body=body_bytes,
            encoding=resp.encoding,
            request=request
        )
        # 把scrapling原生对象存入meta,spider中可直接使用scrapling解析API
        scrapy_resp.meta["scrapling_resp"] = resp
        return scrapy_resp

    def process_response(self, request, response, spider):
        return response

    def process_exception(self, request, exception, spider):
        spider.logger.warning(f"Download exception: {exception}, url: {request.url}")
        return None
配置
# settings.py
# 开启下载中间件,优先级小于590(原生下载器优先级590,数字越小越先执行)
DOWNLOADER_MIDDLEWARES = {
    "your_project_name.middlewares.scrapling_middleware.ScraplingDownloaderMiddleware": 100,
}

# Scrapling 全局默认配置
SCRAPLING_IMPERSONATE = "chrome124"
SCRAPLING_TIMEOUT = 30
SCRAPLING_REDIRECTS = True
SCRAPLING_VERIFY_SSL = False  # 解决你之前SSL EOF报错,关闭证书校验

# 并发、重试配置(适配反爬)
CONCURRENT_REQUESTS = 2
DOWNLOAD_DELAY = 1
RETRY_TIMES = 3
spider 中使用
import scrapy

class SkillsSpider(scrapy.Spider):
    name = "skills"
    start_urls = [
        "https://skillsmp.com/api/github-contents?owner=vamseeachanta&repo=workspace-hub"
    ]

    def parse(self, response):
        # 原生scrapy选择器正常使用
        print(response.css("title::text").get())

        # 直接调用scrapling原生解析(更强大,自动反混淆、xpath/css增强)
        scrapling_resp = response.meta["scrapling_resp"]
        # css选择器
        all_links = scrapling_resp.css("a")
        for a in all_links:
            yield {
                "href": a.attrs.get("href"),
                "text": a.text
            }
            # 下发新请求,自动复用scrapling中间件
            yield scrapy.Request(
                url=response.urljoin(a.attrs["href"]),
                callback=self.parse_file
            )

    def parse_file(self, response):
        yield {"file_content": response.text}
动态 JS 页面(开启浏览器渲染)
yield scrapy.Request(
    url="https://xxx动态页面",
    meta={"scrapling_render_js": True},  # 开启JS渲染
    callback=self.parse
)

yield scrapy.Request(
    url="https://skillsmp.com",
    meta={
        "scrapling_impersonate": "firefox125",
        "scrapling_timeout": 45,
        "scrapling_verify": True
    },
    callback=self.parse
)
方法 5:Spider 内部直接调用
在爬虫文件 spiders/xxx.py 中直接创建 Scrapling 实例渲染动态页面
import scrapy
from scrapling import AsyncFetcher  # 异步,适配scrapy异步架构
# 同步版本:from scrapling import Fetcher

class DemoSpider(scrapy.Spider):
    name = "demo"
    start_urls = ["https://需要js渲染的目标网站.com"]

    async def parse(self, response):
        # 初始化Scrapling渲染器(自动随机UA、指纹、无头)
        fetcher = AsyncFetcher(
            headless=True,        # 无头模式
            stealthy=True,        # 开启反爬隐身(关键)
            timeout=30000,
            randomize_fingerprint=True
        )

        # 渲染目标页面,获取完整加载后的DOM
        page = await fetcher.fetch(response.url)

        # Scrapling内置css/xpath选择器,和scrapy语法几乎一致
        title = page.css("h1::text").get()
        items = page.xpath("//div[@class='item']/text()").getall()

        yield {
            "url": response.url,
            "title": title,
            "data": items
        }

        await fetcher.close()  # 释放浏览器资源
爬虫(spider) 中间件
spider middleware:https://docs.scrapy.net.cn/en/latest/topics/spider-middleware.html
作用
爬虫中间件的用法与下载器中间件非常相似,只是它们的作用对象不同。下载器中间件的作用对象是请求request和返回response;爬虫中间件的作用对象是爬虫,更具体地来说,就是写在spiders文件夹下面的各个文件。它们的关系,在Scrapy的数据流图上可以很好地区分开来,如下图所示。

其中,4、5 表示下载器中间件,6、7 表示爬虫中间件。
爬虫中间件 会在以下几种情况被调用。
- 当运行到
yield scrapy.Request()或者yield item的时候,爬虫中间件的process_spider_output()方法被调用。 - 当爬虫本身的代码出现了
Exception的时候,爬虫中间件的process_spider_exception()方法被调用。 - 当爬虫里面的某一个回调函数
parse_xxx()被调用之前,爬虫中间件的process_spider_input()方法被调用。 - 当运行到
start_requests()的时候,爬虫中间件的process_start_requests()方法被调用。
通过上面可知,爬虫中间件 是 Scrapy 爬虫处理机制中的一个钩子框架,你可以将自定义功能插入其中,以处理发送给 爬虫 进行处理的响应,以及处理由爬虫生成请求和项目。
spider Middleware (爬虫中间件) 是处于 Spider 和 Engine 之间的处理模块。当 Downloader 生成 Response 之后,Response 会被发送给 Spider,在发送给 Spider 之前,Response 会首先经过 Spider Middleware的处理,当 Spider 处理生成 Item 和 Request 之后,Item 和 Request 还会经过 Spider Middleware 的处理
总的来说,Spider Middleware 可以用来处理
- 输入给 spider 的 Request
- 输入给 Spider 的 Response
- Spider 输出的 Item
激活 爬虫 中间件
要激活爬虫中间件组件,可以在 SPIDER_MIDDLEWARES 中设置,这是一个字典,其键是中间件类路径,其值是中间件顺序。示例
SPIDER_MIDDLEWARES = {
    "myproject.middlewares.CustomSpiderMiddleware": 543,
}
将 SPIDER_MIDDLEWARES 设置与 Scrapy 中定义的 SPIDER_MIDDLEWARES_BASE 设置(不应被覆盖)合并,然后按顺序排序以获得已启用中间件的最终排序列表:第一个中间件是离引擎最近的一个,最后一个是离爬虫最近的一个。换句话说,每个中间件的 process_spider_input() 方法将按中间件顺序递增(100、200、300,…)调用,每个中间件的 process_spider_output() 方法将按顺序递减调用。
要确定为中间件分配哪个顺序,请参见 SPIDER_MIDDLEWARES_BASE 设置,并根据要插入中间件的位置选择一个值。顺序很重要,因为每个中间件执行不同的操作,并且你的中间件可能依赖于应用某些先前的(或后续的)中间件。
如果你想禁用内置中间件(在 SPIDER_MIDDLEWARES_BASE 中定义,并且默认启用),则必须在项目 SPIDER_MIDDLEWARES 设置中定义它,并将其值指定为 None。例如,如果你想禁用 off-site 中间件
SPIDER_MIDDLEWARES = {
    "myproject.middlewares.CustomSpiderMiddleware": 543,
    "scrapy.spidermiddlewares.offsite.OffsiteMiddleware": None,
}
最后,请记住,某些中间件可能需要通过特定设置启用。有关更多信息,请参阅每个中间件文档。
爬虫 中间件 中的3个方法
- process_spider_exception(self, response, exception, spider):这个方法,它可以返回 None,也可以运行 yield item 语句或者像爬虫的代码一样,使用 yield scrapy.Request() 发起新的请求。如果运行了 yield item 或者 yield scrapy.Request(),程序就会绕过爬虫里面原有的代码。
- process_spider_input(response, spider):在下载器中间件处理完成后,马上要进入某个回调函数 parse_xxx() 前调用。
- process_spider_output(response, result, output):在爬虫运行 yield item 或者 yield scrapy.Request() 的时候调用。在这个方法处理完成以后,数据如果是 item,就会被交给 pipeline;如果是请求,就会被交给调度器,然后下载器中间件才会开始运行。所以在这个方法里面可以进一步对 item 或者 请求 做一些修改。这个方法的参数 result 就是爬虫爬出来的 item 或者scrapy.Request()。由于 yield 得到的是一个生成器,生成器是可以迭代的,所以 result 也是可以迭代的,可以使用 for 循环来把它展开。
对 item 进行处理
def process_spider_output(response, result, spider):
    for item in result:
        if isinstance(item, scrapy.Item):
            # 这里可以对即将被提交给pipeline的item进行各种操作
            print(f'item将会被提交给pipeline')
        yield item
对 请求 进行监控和修改:
def process_spider_output(response, result, spider):
    for request in result:
        if not isinstance(request, scrapy.Item):
            # 这里可以对请求进行各种修改
            print('现在还可以对请求对象进行修改。。。。')
        request.meta['request_start_time'] = time.time()
        yield request
处理 异常 进行处理
示例:当不需要进行重试,但是需要记录是哪一个请求出现了异常,此时就可以在爬虫中间件里面检测异常,然后生成一个只包含标记的 item。还是以抓取 exercise middleware retry 这个练习页的内容为例,但是这一次不进行重试,只记录哪一页出现了问题。先看爬虫的代码,这一次在 meta 中把页数带上,如下图所示。

爬虫里面如果发现了参数错误,就使用 raise 这个关键字人工抛出一个自定义的异常。在实际爬虫开发中,读者也可以在某些地方故意不使用 try ... except 捕获异常,而是让异常直接抛出。例如 XPath 匹配处理的结果,直接读里面的值,不用先判断列表是否为空。这样如果列表为空,就会被抛出一个 IndexError,于是就能让爬虫的流程进入到爬虫中间件的process_spider_exception() 中。
在 items.py 里面创建了一个 ErrorItem 来记录哪一页出现了问题,如下图所示。

接下来,在爬虫中间件中将出错的页面和当前时间存放到ErrorItem里面,并提交给pipeline,保存到MongoDB中,如下图所示。

这样就实现了记录错误页数的功能,方便在后面对错误原因进行分析。由于这里会把 item 提交给 pipeline,所以不要忘记在settings.py 里面打开 pipeline,并配置好 MongoDB。储存错误页数到 MongoDB 的代码如下图所示。

示例:处理 爬虫代码 错误
example.py
import scrapy
from scrapy import cmdline


class ExampleSpider(scrapy.Spider):
    name = 'example'
    start_urls = ['https://httpbin.org/']
    allowed_domains = ['httpbin.org']

    def parse(self, response, **kwargs):
        raise Exception("爬虫代码主动抛出异常")


if __name__ == '__main__':
    cmdline.execute('scrapy crawl example'.split())
    pass
middlewares.py
import traceback

class ExceptionCheckSpider(object):

    def process_spider_exception(self, response, exception, spider):
        msg = f'[{spider.name}] ---> {exception}'
        print(msg)
        print(traceback.print_exc())
        return None
settings.py
SPIDER_MIDDLEWARES = {
   "myspider.middlewares.ExceptionCheckSpider": 543,
}
2、scrapy 的 pipeline
官网文档:https://docs.scrapy.net.cn/en/latest/topics/item-pipeline.html
提取到数据后会组装成 item,然后将 item 发送到 pipeline 中。如果有多个 pipeline 时会根据 pipeline 的优先级依次对 item 进行处理。
scrapy 源码 pipelines 目录下有三个文件:files.py、images.py、media.py 。

scrapy 在这个三个文件中提供了三种不同的 pipeline
- media.py:class MediaPipeline(object):可以下载 媒体
- files.py:class FilesPipeline(MediaPipeline):可以下载文件。FilesPipeline 继承 MediaPipeline
- images.py:class ImagesPipeline(FilesPipeline)。可以下载图片。
每个 pipeline 组件(有时简称为 "项目管道")都是一个 Python 类。它们接收item 并对 item 进行处理,当处理完成后,还可以决定该 item 是否继续传递给其他 pipeline
pipeline 组件 必须实现的方法

process_item(self, item, spider)
每个项目管道组件都必须调用此方法。
参数
返回值:
- 返回一个带数据的dict,
- 返回一个Item (或任何后代类)对象,
- 返回一个Twisted Deferred 或者 raise DropItemexception。丢弃的项目不再由其他管道处理。
open_spider(self, spider)
当爬虫打开时调用此方法。参数:spider (Spider 对象) – 已打开的爬虫
close_spider(self, spider)
当爬虫关闭时调用此方法。参数:spider (Spider 对象) – 已关闭的爬虫
from_crawler(cls, crawler)
如果存在,则调用此类方法从 Crawler 创建管道实例。它必须返回管道的全新实例。Crawler 对象提供对所有 Scrapy 核心组件(如设置和信号)的访问;管道可以通过它来访问这些组件,并将它的功能挂接到 Scrapy。参数:crawler (Crawler 对象) – 使用此管道的爬虫
这个 crawler 很好用,可以直接 crawler.settings 获得参数,也可以搭配信号使用,比如spider_opened 中。但这个 crawler 是怎么来的呢,其实就是传参而已,只不过我们平常习惯使用构造方法 _ init _,而这里是调用classmethod类方法。
scrapy 中的 from_crawler:https://www.jianshu.com/p/e9ec5d7b6204
使用 示例
示例:写入 mongo、mysql
import pymongo
from itemadapter import ItemAdapter


class MongoPipeline:
    collection_name = "scrapy_items"

    def __init__(self, mongo_uri, mongo_db):
        self.mongo_uri = mongo_uri
        self.mongo_db = mongo_db

    @classmethod
    def from_crawler(cls, crawler):
        return cls(
            mongo_uri=crawler.settings.get("MONGO_URI"),
            mongo_db=crawler.settings.get("MONGO_DATABASE", "items"),
        )

    def open_spider(self, spider):
        self.client = pymongo.MongoClient(self.mongo_uri)
        self.db = self.client[self.mongo_db]

    def close_spider(self, spider):
        self.client.close()

    def process_item(self, item, spider):
        self.db[self.collection_name].insert_one(ItemAdapter(item).asdict())
        return item
# -*- coding: utf-8 -*-
# Define your item pipelines here
#
# Don't forget to add your pipeline to the ITEM_PIPELINES setting
# See: http://doc.scrapy.org/en/latest/topics/item-pipeline.html
import pymongo
import pymysql
from scrapy import Request
from scrapy.exceptions import DropItem
from scrapy.pipelines.images import ImagesPipeline
class MongoPipeline(object):
def __init__(self, mongo_uri, mongo_db):
self.mongo_uri = mongo_uri
self.mongo_db = mongo_db
@classmethod
def from_crawler(cls, crawler):
return cls(
mongo_uri=crawler.settings.get('MONGO_URI'),
mongo_db=crawler.settings.get('MONGO_DB')
)
def open_spider(self, spider):
self.client = pymongo.MongoClient(self.mongo_uri)
self.db = self.client[self.mongo_db]
def process_item(self, item, spider):
name = item.collection
self.db[name].insert(dict(item))
return item
def close_spider(self, spider):
self.client.close()
class MysqlPipeline():
def __init__(self, host, database, user, password, port):
self.host = host
self.database = database
self.user = user
self.password = password
self.port = port
@classmethod
def from_crawler(cls, crawler):
return cls(
host=crawler.settings.get('MYSQL_HOST'),
database=crawler.settings.get('MYSQL_DATABASE'),
user=crawler.settings.get('MYSQL_USER'),
password=crawler.settings.get('MYSQL_PASSWORD'),
port=crawler.settings.get('MYSQL_PORT'),
)
def open_spider(self, spider):
self.db = pymysql.connect(self.host, self.user, self.password, self.database, charset='utf8',
port=self.port)
self.cursor = self.db.cursor()
def close_spider(self, spider):
self.db.close()
def process_item(self, item, spider):
print(item['title'])
data = dict(item)
keys = ', '.join(data.keys())
values = ', '.join(['%s'] * len(data))
sql = 'insert into %s (%s) values (%s)' % (item.table, keys, values)
self.cursor.execute(sql, tuple(data.values()))
self.db.commit()
return item
示例:写入 json 文件
这是只是写文件示例,如果真的想要将抓取的 item 存储到 JSON文件中可以使用 Feed 导出。
import json

from itemadapter import ItemAdapter


class JsonWriterPipeline:
    def open_spider(self, spider):
        self.file = open("items.jsonl", "w")

    def close_spider(self, spider):
        self.file.close()

    def process_item(self, item, spider):
        line = json.dumps(ItemAdapter(item).asdict()) + "\n"
        self.file.write(line)
        return item
示例:去重 item
假设 item 具有唯一 ID
from itemadapter import ItemAdapter
from scrapy.exceptions import DropItem


class DuplicatesPipeline:
    def __init__(self):
        self.ids_seen = set()

    def process_item(self, item, spider):
        adapter = ItemAdapter(item)
        if adapter["id"] in self.ids_seen:
            raise DropItem(f"Duplicate item found: {item!r}")
        else:
            self.ids_seen.add(adapter["id"])
            return item
激活 pipeline
要激活项目管道组件,你必须将其类添加到 ITEM_PIPELINES 设置中,如下例所示
ITEM_PIPELINES = {
    "myproject.pipelines.PricePipeline": 300,
    "myproject.pipelines.JsonWriterPipeline": 800,
}
执行顺序:值越低越靠近引擎,就优先执行。值越高则越最后执行。通常值在 0-1000 范围内。
下载图片:ImagesPipeline
使用 scrapy 框架除了可以下载文本,还可以下载图片,scrapy 提供了 ImagePipeline 来下载图片。ImagePipeline 还支持以下特别的功能:
- 1 生成缩略图:通过配置 IMAGES_THUMBS = {'size_name': (width_size,heigh_size),}
- 2 过滤小图片:通过配置 IMAGES_MIN_HEIGHT和IMAGES_MIN_WIDTH 来过滤过小图片。
官网手册:https://docs.scrapy.org/en/latest/topics/media-pipeline.html
ImagePipelines 的工作流程
- 1 在spider中爬取需要下载的图片链接,将其放入 item 中的 image_urls
- 2 spider 将其传送到 pipieline
- 3 当 ImagePipeline 处理时,它会检测是否有 image_urls 字段,如果有的话,会将 url 传递给scrapy 调度器和下载器
- 4 下载完成后会将结果写入 item 的另一个字段 images,images 包含了图片的本地路径,图片校验,和图片的 url
首先查看源码:
"""
Images Pipeline

See documentation in topics/media-pipeline.rst
"""
import functools
import hashlib
import warnings
from contextlib import suppress
from io import BytesIO

from itemadapter import ItemAdapter

from scrapy.exceptions import DropItem, NotConfigured, ScrapyDeprecationWarning
from scrapy.http import Request
from scrapy.http.request import NO_CALLBACK
from scrapy.pipelines.files import FileException, FilesPipeline

# TODO: from scrapy.pipelines.media import MediaPipeline
from scrapy.settings import Settings
from scrapy.utils.misc import md5sum
from scrapy.utils.python import get_func_args, to_bytes


class NoimagesDrop(DropItem):
    """Product with no images exception"""

    def __init__(self, *args, **kwargs):
        warnings.warn(
            "The NoimagesDrop class is deprecated",
            category=ScrapyDeprecationWarning,
            stacklevel=2,
        )
        super().__init__(*args, **kwargs)


class ImageException(FileException):
    """General image error exception"""


class ImagesPipeline(FilesPipeline):
    """Abstract pipeline that implement the image thumbnail generation logic"""

    MEDIA_NAME = "image"

    # Uppercase attributes kept for backward compatibility with code that subclasses
    # ImagesPipeline. They may be overridden by settings.
    MIN_WIDTH = 0
    MIN_HEIGHT = 0
    EXPIRES = 90
    THUMBS = {}
    DEFAULT_IMAGES_URLS_FIELD = "image_urls"
    DEFAULT_IMAGES_RESULT_FIELD = "images"

    def __init__(self, store_uri, download_func=None, settings=None):
        try:
            from PIL import Image

            self._Image = Image
        except ImportError:
            raise NotConfigured(
                "ImagesPipeline requires installing Pillow 4.0.0 or later"
            )

        super().__init__(store_uri, settings=settings, download_func=download_func)

        if isinstance(settings, dict) or settings is None:
            settings = Settings(settings)

        resolve = functools.partial(
            self._key_for_pipe,
            base_class_name="ImagesPipeline",
            settings=settings,
        )
        self.expires = settings.getint(resolve("IMAGES_EXPIRES"), self.EXPIRES)

        if not hasattr(self, "IMAGES_RESULT_FIELD"):
            self.IMAGES_RESULT_FIELD = self.DEFAULT_IMAGES_RESULT_FIELD
        if not hasattr(self, "IMAGES_URLS_FIELD"):
            self.IMAGES_URLS_FIELD = self.DEFAULT_IMAGES_URLS_FIELD

        self.images_urls_field = settings.get(
            resolve("IMAGES_URLS_FIELD"), self.IMAGES_URLS_FIELD
        )
        self.images_result_field = settings.get(
            resolve("IMAGES_RESULT_FIELD"), self.IMAGES_RESULT_FIELD
        )
        self.min_width = settings.getint(resolve("IMAGES_MIN_WIDTH"), self.MIN_WIDTH)
        self.min_height = settings.getint(resolve("IMAGES_MIN_HEIGHT"), self.MIN_HEIGHT)
        self.thumbs = settings.get(resolve("IMAGES_THUMBS"), self.THUMBS)

        self._deprecated_convert_image = None

    @classmethod
    def from_settings(cls, settings):
        s3store = cls.STORE_SCHEMES["s3"]
        s3store.AWS_ACCESS_KEY_ID = settings["AWS_ACCESS_KEY_ID"]
        s3store.AWS_SECRET_ACCESS_KEY = settings["AWS_SECRET_ACCESS_KEY"]
        s3store.AWS_SESSION_TOKEN = settings["AWS_SESSION_TOKEN"]
        s3store.AWS_ENDPOINT_URL = settings["AWS_ENDPOINT_URL"]
        s3store.AWS_REGION_NAME = settings["AWS_REGION_NAME"]
        s3store.AWS_USE_SSL = settings["AWS_USE_SSL"]
        s3store.AWS_VERIFY = settings["AWS_VERIFY"]
        s3store.POLICY = settings["IMAGES_STORE_S3_ACL"]

        gcs_store = cls.STORE_SCHEMES["gs"]
        gcs_store.GCS_PROJECT_ID = settings["GCS_PROJECT_ID"]
        gcs_store.POLICY = settings["IMAGES_STORE_GCS_ACL"] or None

        ftp_store = cls.STORE_SCHEMES["ftp"]
        ftp_store.FTP_USERNAME = settings["FTP_USER"]
        ftp_store.FTP_PASSWORD = settings["FTP_PASSWORD"]
        ftp_store.USE_ACTIVE_MODE = settings.getbool("FEED_STORAGE_FTP_ACTIVE")

        store_uri = settings["IMAGES_STORE"]
        return cls(store_uri, settings=settings)

    def file_downloaded(self, response, request, info, *, item=None):
        return self.image_downloaded(response, request, info, item=item)

    def image_downloaded(self, response, request, info, *, item=None):
        checksum = None
        for path, image, buf in self.get_images(response, request, info, item=item):
            if checksum is None:
                buf.seek(0)
                checksum = md5sum(buf)
            width, height = image.size
            self.store.persist_file(
                path,
                buf,
                info,
                meta={"width": width, "height": height},
                headers={"Content-Type": "image/jpeg"},
            )
        return checksum

    def get_images(self, response, request, info, *, item=None):
        path = self.file_path(request, response=response, info=info, item=item)
        orig_image = self._Image.open(BytesIO(response.body))

        width, height = orig_image.size
        if width < self.min_width or height < self.min_height:
            raise ImageException(
                "Image too small "
                f"({width}x{height} < "
                f"{self.min_width}x{self.min_height})"
            )

        if self._deprecated_convert_image is None:
            self._deprecated_convert_image = "response_body" not in get_func_args(
                self.convert_image
            )
            if self._deprecated_convert_image:
                warnings.warn(
                    f"{self.__class__.__name__}.convert_image() method overridden in a deprecated way, "
                    "overridden method does not accept response_body argument.",
                    category=ScrapyDeprecationWarning,
                )

        if self._deprecated_convert_image:
            image, buf = self.convert_image(orig_image)
        else:
            image, buf = self.convert_image(
                orig_image, response_body=BytesIO(response.body)
            )
        yield path, image, buf

        for thumb_id, size in self.thumbs.items():
            thumb_path = self.thumb_path(
                request, thumb_id, response=response, info=info, item=item
            )
            if self._deprecated_convert_image:
                thumb_image, thumb_buf = self.convert_image(image, size)
            else:
                thumb_image, thumb_buf = self.convert_image(image, size, buf)
            yield thumb_path, thumb_image, thumb_buf

    def convert_image(self, image, size=None, response_body=None):
        if response_body is None:
            warnings.warn(
                f"{self.__class__.__name__}.convert_image() method called in a deprecated way, "
                "method called without response_body argument.",
                category=ScrapyDeprecationWarning,
                stacklevel=2,
            )

        if image.format in ("PNG", "WEBP") and image.mode == "RGBA":
            background = self._Image.new("RGBA", image.size, (255, 255, 255))
            background.paste(image, image)
            image = background.convert("RGB")
        elif image.mode == "P":
            image = image.convert("RGBA")
            background = self._Image.new("RGBA", image.size, (255, 255, 255))
            background.paste(image, image)
            image = background.convert("RGB")
        elif image.mode != "RGB":
            image = image.convert("RGB")

        if size:
            image = image.copy()
            try:
                # Image.Resampling.LANCZOS was added in Pillow 9.1.0
                # remove this try except block,
                # when updating the minimum requirements for Pillow.
                resampling_filter = self._Image.Resampling.LANCZOS
            except AttributeError:
                resampling_filter = self._Image.ANTIALIAS
            image.thumbnail(size, resampling_filter)
        elif response_body is not None and image.format == "JPEG":
            return image, response_body

        buf = BytesIO()
        image.save(buf, "JPEG")
        return image, buf

    def get_media_requests(self, item, info):
        urls = ItemAdapter(item).get(self.images_urls_field, [])
        return [Request(u, callback=NO_CALLBACK) for u in urls]

    def item_completed(self, results, item, info):
        with suppress(KeyError):
            ItemAdapter(item)[self.images_result_field] = [x for ok, x in results if ok]
        return item

    def file_path(self, request, response=None, info=None, *, item=None):
        image_guid = hashlib.sha1(to_bytes(request.url)).hexdigest()
        return f"full/{image_guid}.jpg"

    def thumb_path(self, request, thumb_id, response=None, info=None, *, item=None):
        thumb_guid = hashlib.sha1(to_bytes(request.url)).hexdigest()
        return f"thumbs/{thumb_id}/{thumb_guid}.jpg"
在源码中可以找到 DEFAULT_IMAGES_URLS_FIELD = "image_urls",这个 image_urls 就是 item 中图片的 url 的 地址列表。
示例:爬取 mm131美女图片 http://www.mm131.com/xinggan/
xingan.py
# -*- coding: utf-8 -*-
import scrapy
from happy5.items import Happy5Item
import re

class XinganSpider(scrapy.Spider):
    name = 'xingan'
    allowed_domains = ['www.mm131.com']
    start_urls = ['http://www.mm131.com/xinggan/']

    def parse(self, response):
        every_html = response.xpath('//div[@class="main"]/dl//dd')
        for one_html in every_html[0:-1]:
            item = Happy5Item()
            # 每个图片的链接
            link = one_html.xpath('./a/@href').extract_first()
            # 每个图片的名字
            title = one_html.xpath('./a/img/@alt').extract_first()
            item['title'] = title
            # 进入到每个标题里面
            request = scrapy.Request(url=link, callback=self.parse_one, meta={'item':item})
            yield request

    # 每个人下面的图集
    def parse_one(self, response):
        item = response.meta['item']
        # 找到总页数
        total_page = response.xpath('//div[@class="content-page"]/span[@class="page-ch"]/text()').extract_first()
        num = int(re.findall('(\d+)', total_page)[0])
        # 找到当前页数
        now_num = response.xpath('//div[@class="content-page"]/span[@class="page_now"]/text()').extract_first()
        now_num = int(now_num)
        # 当前页图片的url
        every_pic = response.xpath('//div[@class="content-pic"]/a/img/@src').extract()
        # 当前页的图片url
        item['image_urls'] = every_pic
        # 当前图片的refer
        item['referer'] = response.url
        yield item

        # 如果当前数小于总页数
        if now_num < num:
            if now_num == 1:
                url1 = response.url[0:-5] + '_%d'%(now_num+1) + '.html'
            elif now_num > 1:
                url1 = re.sub('_(\d+)', '_' + str(now_num+1), response.url)
            headers = {
                'referer':self.start_urls[0]
            }
            # 给下一页发送请求
            yield scrapy.Request(url=url1, headers=headers, callback=self.parse_one, meta={'item':item})
items.py
import scrapy


class Happy5Item(scrapy.Item):
    # define the fields for your item here like:
    # name = scrapy.Field()
    image_urls = scrapy.Field()
    images = scrapy.Field()
    title = scrapy.Field()
    referer = scrapy.Field()
pipelines.py
from scrapy.pipelines.images import ImagesPipeline
from scrapy.exceptions import DropItem
from scrapy.http import Request

class Happy5Pipeline(object):
    def process_item(self, item, spider):
        return item

class QiushiImagePipeline(ImagesPipeline):

    # 下载图片时加入referer请求头
    def get_media_requests(self, item, info):
        for image_url in item['image_urls']:
            headers = {'referer':item['referer']}
            yield Request(image_url, meta={'item': item}, headers=headers)
            # 这里把item传过去,因为后面需要用item里面的书名和章节作为文件名

    # 获取图片的下载结果, 控制台查看
    def item_completed(self, results, item, info):
        image_paths = [x['path'] for ok, x in results if ok]
        if not image_paths:
            raise DropItem("Item contains no images")
        return item

    # 修改文件的命名和路径
    def file_path(self, request, response=None, info=None):
        item = request.meta['item']
        image_guid = request.url.split('/')[-1]
        filename = './{}/{}'.format(item['title'], image_guid)
        return filename
settings.py
BOT_NAME = 'happy5'

SPIDER_MODULES = ['happy5.spiders']
NEWSPIDER_MODULE = 'happy5.spiders'


# Crawl responsibly by identifying yourself (and your website) on the user-agent
USER_AGENT = 'Mozilla/5.0 (compatible; MSIE 9.0; Windows NT 6.1; Trident/5.0'

# Obey robots.txt rules
ROBOTSTXT_OBEY = False
ITEM_PIPELINES = {
   # 'scrapy.pipelines.images.ImagesPipeline': 1,
   'happy5.pipelines.QiushiImagePipeline': 2,
}
IMAGES_STORE = 'images'
这种图还是要少看。
示例:爬取 4k壁纸
import scrapy
from scrapy import cmdline
from urllib.parse import urljoin


class ExampleSpider(scrapy.Spider):
    name = 'example'
    start_urls = ['https://www.4kbizhi.com/fengjing/']

    def parse(self, response, **kwargs):
        response = response.replace(body=response.body, encoding='gbk')
        tag_img_list = response.xpath('//a[img]')
        for tag_img in tag_img_list:
            img_src = tag_img.xpath('./@href').extract_first()
            img_title = ''.join(tag_img.xpath('.//text()').extract()).strip()
            item_dict = {
                'img_title': img_title,
                'image_urls': [urljoin('https://www.4kbizhi.com', img_src), ]
            }
            print(item_dict)
            yield item_dict


if __name__ == '__main__':
    cmdline.execute('scrapy crawl example'.split())
    pass
image_urls字段用于存放待下载的图像 URL,而images字段用于存放下载后的图像信息(如文件路径、大小等)。ImagesPipeline会自动处理图像的下载和存储,并将结果填充到images字段中。- 可以通过配置
IMAGES_THUMBS来生成缩略图。
启用 pipeline
# settings.py

# 启用 ImagesPipeline
ITEM_PIPELINES = {
    'scrapy.pipelines.images.ImagesPipeline': 1,
}

# 设置图像存储的目录
IMAGES_STORE = 'path/to/image/directory'  # 替换为你希望保存图像的目录

# 可以根据需要配置图像处理的选项
IMAGES_THUMBS = {
    'small': (50, 50),
    'big': (270, 270),
}
处理下载后的图像。如果你需要在图像下载后进行处理,可以重写 ImagesPipeline 的方法。
from scrapy.pipelines.images import ImagesPipeline


class CustomImagesPipeline(ImagesPipeline):

    def get_media_requests(self, item, info):
        for image_url in item['image_urls']:
            print(f'image_url ---> {image_url}')
            yield scrapy.Request(image_url, dont_filter=True)

    def file_path(self, request, response=None, info=None, *, item=None):
        # 自定义文件名,可以从请求中提取信息来命名文件
        image_guid = request.url.split('/')[-1]
        return f'custom_images/{image_guid}'

    def item_completed(self, results, item, info):
        if results:
            for ok, x in results:
                if ok:
                    # 这里写保存逻辑
                    print(x)
                    pass
        # 处理下载结果
        if 'images' in item:
            item['images'] = [x['path'] for ok, x in results if ok]
        return item
下载 媒体:MediaPipeline
在 Scrapy 中,MediaPipeline 是一个用于处理媒体文件(如图像、音频和视频)下载的管道。使用 MediaPipeline 下载音频和视频文件的过程与下载图像类似
在 settings.py 文件中启用媒体管道并配置相关选项。
# settings.py

ITEM_PIPELINES = {
    'scrapy.pipelines.media.MediaPipeline': 1,
}

# 设置下载的媒体文件存储目录
MEDIA_STORE = 'path/to/media/directory'  # 替换为你希望保存文件的目录

# 配置音频和视频字段
AUDIO_URLS_FIELD = 'audio_urls'  # 存放音频 URL 的字段
AUDIO_RESULT_FIELD = 'audios'      # 存放下载后的音频信息的字段
VIDEO_URLS_FIELD = 'video_urls'    # 存放视频 URL 的字段
VIDEO_RESULT_FIELD = 'videos'       # 存放下载后的视屏信息的字段
在爬虫中填充 audio_urls 和 video_urls 字段。例如:
# spiders/my_spider.py

import scrapy
from myproject.items import MyMediaItem  # 替换为你的项目名

class MySpider(scrapy.Spider):
    name = 'my_spider'
    start_urls = ['https://example.com']

    def parse(self, response):
        item = MyMediaItem()

        # 提取音频和视频 URL。
        item['audio_urls'] = response.css('audio::attr(src)').getall()
        item['video_urls'] = response.css('video::attr(src)').getall()

        yield item
说明
audio_urls和video_urls字段用于存放待下载的音频和视频 URL,而audios和videos字段用于存放下载后的音频和视频信息(如文件路径、大小等)。MediaPipeline会自动处理媒体文件的下载和存储,并将结果填充到相应的字段中。
自定义 MediaPipeline。如果需要自定义 MediaPipeline,可以继承并重写其中的方法。
例如,你可能想在下载后对音频或视频进行处理:
from scrapy.pipelines.media import MediaPipeline

class CustomMediaPipeline(MediaPipeline):
    def item_completed(self, results, item, info):
        if 'audios' in item:
            item['audios'] = [x['path'] for ok, x in results if ok]
        if 'videos' in item:
            item['videos'] = [x['path'] for ok, x in results if ok]
        return item
在 settings.py 中替换默认管道:
ITEM_PIPELINES = {
    'myproject.pipelines.CustomMediaPipeline': 1,
}

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 14
 0
- 0


 已为社区贡献19条内容

所有评论(0)